Door de jaren heen heb ik geleerd dat zelfs de kleinste codewijziging onverwachte gevolgen kan hebben. Wat eerst als een kleine aanpassing lijkt, kan ongemerkt iets breken dat eerst perfect werkte.
Daarom is regressietesten zo belangrijk. Het is in wezen een vangnet dat ervoor zorgt dat vooruitgang niet ten koste gaat van stabiliteit.
In mijn ervaring met data-gedreven projecten, waar modellen, API’s en pipelines constant evolueren, is regressietesten essentieel geweest om consistente, betrouwbare outputs te behouden.
Zonder dit kan zelfs een kleine aanpassing, zoals het tweaken van een transformatiefunctie of het updaten van een package, onverwacht gedrag veroorzaken dat lastig te herleiden is.
Als je nieuw bent met Python of je basiskennis wilt opfrissen voordat je dieper in testen duikt, bekijk dan onze Python Programming-skilltrack.
Wat is regressietesten?
Kort gezegd betekent regressietesten het opnieuw testen van bestaande functionaliteit na codewijzigingen om te bevestigen dat niets is ‘teruggevallen’ naar een kapotte staat.
Hoewel het woord ‘regressie’ wiskundig kan klinken, betekent het in testen eigenlijk ‘een stap terug’.
Telkens wanneer je code wijzigt (zoals het oplossen van een bug of het toevoegen van een feature), bestaat de kans dat de nieuwe wijziging eerder werkende componenten breekt. Daarom hebben we regressietesten nodig.
Regressietesten beantwoordt de volgende cruciale vraag:
Werkt na deze wijziging alles wat eerder werkte nog steeds?
In tegenstelling tot unittesten, die geïsoleerde componenten valideert, of integratietesten, die bekijkt hoe modules samenwerken, neemt regressietesten een bredere, langetermijnblik.
Het zorgt ervoor dat je software release na release stabiel en consistent blijft, zelfs terwijl het evolueert.
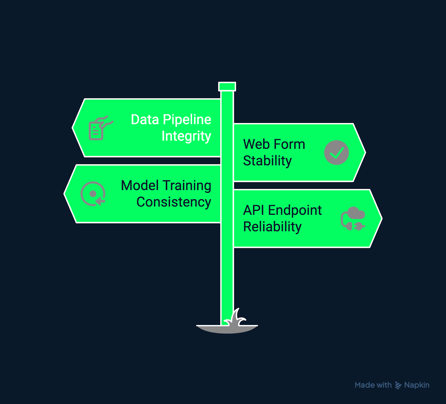
Voorbeelden van regressietesten. Afbeelding door de auteur met Napkin AI.
Bijvoorbeeld:
- De nieuwe transformatielogica van een datapijplijn mag oude outputbestanden niet corrumperen.
- Het updaten van de validatiescript van een webformulier mag bestaande inzendingsflows niet breken.
- Het optimaliseren van een modeltrainingsroutine mag geen eerder gefixte bug in datapreprocessing opnieuw introduceren.
- Het aanpassen van een API-endpoint mag systemen of dashboards stroomafwaarts niet laten falen.
In omgevingen met continue ontwikkeling (vooral Agile en DevOps) fungeert regressietesten als een vangnet waarmee je snel kunt itereren zonder stabiliteit op te offeren.
Het geeft het vertrouwen dat nodig is voor frequente deploys, geautomatiseerde workflows en continuous integration-praktijken.
Waarom regressietesten nuttig is
Regressietesten is een van de meest betrouwbare manieren om te zorgen dat je softwarekwaliteit consistent blijft terwijl je systeem evolueert. Het helpt je deze rimpel-effecten vroeg te detecteren en te voorkomen, wat op zijn beurt stabiliteit en gebruikersvertrouwen behoudt.
Bescherm tegen nieuwe bugs
Nieuwe code brengt vaak onbedoelde neveneffecten met zich mee. Een simpele refactor of dependency-upgrade kan functionaliteit in ver weg gelegen modules breken.
Regressietesten helpt je zulke issues te identificeren voordat ze productie of gebruikers raken. Geautomatiseerde regressiesuites kunnen na elke codepush draaien en conflicten tussen nieuwe en legacylogica blootleggen. Deze vroege feedback bespaart tijd, vermindert debug-overhead en houdt het ontwikkelvertrouwen op peil.
In snel bewegende Agile- of DevOps-teams werkt geautomatiseerde regressie als een vangrail die developers laat innoveren zonder bang te zijn bestaande features te breken.
|
Voordeel
|
Beschrijving
|
Voorbeeld
|
|
Vroege detectie
|
Identificeert bugs kort na nieuwe commits
|
Een nieuwe API-route breekt een bestaande clientaanvraag
|
|
Sneller debuggen
|
Wijst precies aan waar nieuwe logica faalt
|
CI-rapporten linken gefaalde tests aan specifieke modules
|
|
Vertrouwen bij developers
|
Stimuleert frequente, veilige releases
|
Teams deployen continu zonder handmatige checks
|
Voorkom dat defects terugkeren
Een van de meest frustrerende problemen in softwareonderhoud is een oude bug die terugkeert.
Regressietests fungeren als permanente waarborgen (oftewel: zodra een bug is gefikst, zorgt de bijbehorende test ervoor dat hij gefikst blijft en niet opnieuw opduikt).
Na verloop van tijd ontstaat zo een vangnet gebaseerd op de eigen bughistorie van je project.
Deze praktijk in je workflow inbedden betekent dat je testsuite niet alleen nieuwe functionaliteit valideert, maar ook elke fix die eerder is doorgevoerd.
|
Vóór regressietests
|
Na regressietests
|
|
Oude bugs duiken onvoorspelbaar op
|
Gefixte issues blijven blijvend geverifieerd
|
|
Bugfixes leunen op geheugen of documentatie
|
Tests bevestigen eerdere fixes automatisch
|
|
QA-teams herhalen handmatige checks
|
Geautomatiseerde vangrails voorkomen herhaling
|
Behouden van gebruikersvertrouwen
Betrouwbaarheid is ononderhandelbaar, zeker vanuit het perspectief van de gebruiker. Features die de ene dag werken en de volgende dag falen, ondermijnen vertrouwen en tevredenheid.
Regressietesten zorgt voor een consistente ervaring over updates heen, wat het vertrouwen in je product versterkt.
In data-gedreven applicaties betekent deze betrouwbaarheid consistente resultaten en voorspelbaar gedrag, zelfs terwijl modellen, databronnen en API’s evolueren.
|
Toepassingsgebied
|
Wat regressietesten beschermt
|
|
Dashboards
|
Zorgt dat visualisaties correct renderen na backend- of dataschema-updates
|
|
Model-API’s
|
Verifieert dat modelvoorspellingen stabiel en reproduceerbaar blijven
|
|
Datapijplijnen
|
Bevestigt dat data-exports schema- en formaatconsistentie behouden
|
Risico’s beperken
Regressietesten is ook een cruciaal onderdeel van risicomanagement. Zonder dit kunnen onverwachte bugs laat in de releasecyclus doorslippen, met storingen of kostbare rollbacks tot gevolg.
Stabiliteit bij elke iteratie verifiëren helpt je team met vertrouwen te releasen, in de wetenschap dat de functionaliteit niet is aangetast.
|
Met regressietesten
|
Zonder regressietesten
|
|
Voorspelbare, risicovarme releases
|
Regelmatig last-minute bugs en rollbacks
|
|
Zelfverzekerde CI/CD-pijplijnen
|
Schroom bij deployments, handmatige QA-knooppunten
|
|
Continue kwaliteitsborging
|
Brandjes blussen na deployment
|
Typen en technieken voor regressietesten
Regressietesten is geen one-size-fits-all. De juiste aanpak hangt af van factoren zoals de grootte van de codebase, wijzigingsfrequentie en zakelijke impact.
Elk van de volgende methoden balanceert snelheid, dekking en inzet van middelen op een andere manier.
1. Alles hertesten
De eenvoudigste vorm van regressietesten houdt in dat je na een wijziging alle bestaande tests draait.
Hoewel dit garandeert dat niets gemist wordt, wordt het naarmate systemen groeien steeds onpraktischer.
Daarom wordt deze aanpak vaak gebruikt vroeg in de levenscyclus van een project of bij het valideren van een grote refactor.
2. Selectief regressietesten
Selectieve regressie richt zich alleen op de gebieden die direct zijn beïnvloed door recente wijzigingen.
Het gebruikt impactanalyse om afhankelijkheden te bepalen en de testomvang te beperken.
Als bijvoorbeeld een datatransformatiemodule verandert, hoeven gerelateerde tests voor authenticatie of UI-rendering mogelijk niet opnieuw te worden uitgevoerd.
Deze aanpak balanceert nauwkeurigheid met snelheid en berust op goede afhankelijkheidstracking.
3. Geprioriteerd regressietesten
In grote systemen laten tijd en middelen zelden volledige regressiedekking toe.
Geprioriteerd regressietesten rangschikt testcases op belangrijkheid en risiconiveau, zodat kritieke paden (zoals betalingen of authenticatie) als eerste worden geverifieerd.
Tests met lagere prioriteit kunnen later of asynchroon draaien.
De onderstaande tabel schetst typische prioriteitsniveaus, met voorbeelden van gedekte gebieden en hun bijbehorende testfocus.
|
Prioriteitsniveau
|
Voorbeeldgebied
|
Testfocus
|
|
Hoog
|
Betalingsverwerking, authenticatie
|
Mag nooit falen en wordt altijd eerst getest
|
|
Middel
|
Dashboardvisuals, e-mailmeldingen
|
Moet consistent functioneren
|
|
Laag
|
Layout-aanpassingen, tooltips
|
Cosmetisch en minder kritisch tijdens snelle cycli
|
4. De automatiseringsmust
Handmatig regressietesten wordt al snel onhoudbaar naarmate projecten opschalen.
Automatisering daarentegen verandert regressietesten van een trage stap in een manier om sneller en met meer vertrouwen te werken.
Geautomatiseerde suites draaien bij elke build of pull request, geven directe feedback en integreren met CI-tools zoals Jenkins, GitHub Actions of GitLab CI/CD.
Ze maken continue verificatie over omgevingen heen mogelijk, een essentiële vaardigheid voor Agile- en DevOps-teams die willen ‘move fast without breaking things’.
|
Voordeel van automatisering
|
Impact op ontwikkeling
|
|
Continue feedback
|
Snellere identificatie van breaking changes
|
|
Consistente uitvoering
|
Elimineert menselijke fouten in repetitieve tests
|
|
Schaalbaarheid
|
Tests draaien gelijktijdig over omgevingen
|
|
Klaar voor integratie
|
Past direct in CI/CD-workflows
|
De onderstaande tabel geeft een korte overzicht van de belangrijkste regressietesttechnieken die hierboven zijn besproken.
|
Type
|
Beschrijving
|
Pluspunten
|
Minpunten
|
Beste voor
|
|
Alles hertesten
|
Draait alle testcases na elke wijziging
|
Volledige dekking en grondige validatie
|
Zeer tijdrovend en hoge kosten
|
Kleine systemen en baselinetesten
|
|
Selectieve regressie
|
Test alleen getroffen componenten op basis van codewijzigingen
|
Efficiënt en snellere feedback
|
Vereist nauwkeurige afhankelijkheidsmapping
|
Modulaire systemen en frequente releases
|
|
Geprioriteerde regressie
|
Voert tests uit gerangschikt op zakelijke impact
|
Richt zich eerst op kritieke functionaliteit
|
Kan minder kritieke maar relevante gebieden overslaan
|
Tijdgebonden testcycli
|
|
Geautomatiseerde regressie
|
Draait automatisch via CI/CD na codecommits
|
Snel, schaalbaar, herhaalbaar
|
Vereist inrichting en onderhoud
|
Grote of snel evoluerende projecten
|
Een regressiesuite opbouwen en onderhouden
Een regressiesuite opzetten is een doorlopende investering in softwarekwaliteit.
Na verloop van tijd wordt het een van de waardevolste assets in je ontwikkelproces.
De onderstaande afbeelding laat de stappen zien die komen kijken bij het opbouwen en onderhouden van een regressiesuite.
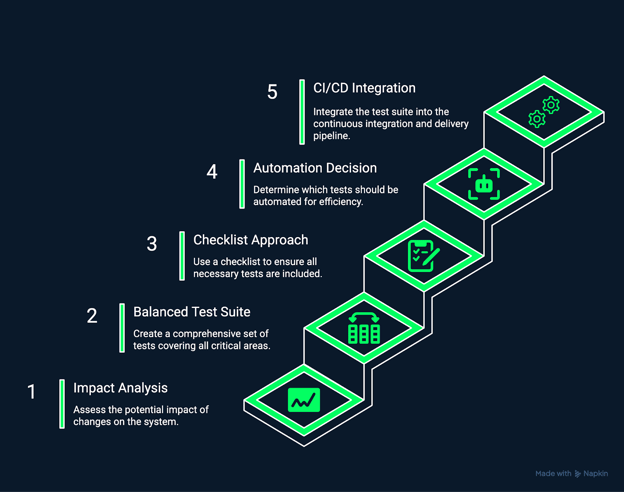
Een regressiesuite opbouwen en onderhouden. Afbeelding door de auteur met Napkin AI.
1. Begin met impactanalyse
Begin met begrijpen welke delen van het systeem door een wijziging zijn beïnvloed.
Het is een goed idee om tools te gebruiken zoals codecoverage-analyzers of dependency graphs om te bepalen welke tests je opnieuw moet draaien.
Geef prioriteit aan modules die interacteren met aangepaste code, gemeenschappelijke datastructuren delen of eerder faalden na soortgelijke updates.
2. Bouw een gebalanceerde testsuite
Ontwikkel een testsuite die kritieke bedrijfsworkflows, essentiële dataprocessen en veelvoorkomende user journeys grondig dekt.
Zorg dat elke test een specifiek doel en een duidelijke scope heeft, en probeer redundantie of overlap te vermijden.
Modulaire, herbruikbare tests maken onderhoud makkelijker naarmate je systeem evolueert.
3. Gebruik een checklistaanpak
Een gestructureerde checklist helpt consistentie en volledigheid te waarborgen bij zowel handmatige als geautomatiseerde regressietesten.
Het vermindert het over het hoofd zien, standaardiseert de uitvoering en bevordert herhaalbare kwaliteitsprocessen.
|
Stap
|
Doel
|
|
Definieer precondities
|
Bepaal systeemstatus en inputdata
|
|
Voer testcase uit
|
Draai de test onder gecontroleerde omstandigheden
|
|
Verifieer uitkomsten
|
Valideer zowel verwachte output als neveneffecten
|
|
Leg resultaten vast
|
Documenteer passes, failures en eventuele anomalieën
|
Deze methode biedt structuur, transparantie en verantwoording, bijzonder nuttig bij het onboarden van nieuwe QA-engineers.
4. Bepaal wat je automatiseert
Niet alle tests moeten worden geautomatiseerd.
Automatiseer stabiele, herhaalbare en veelvoorkomende tests, waaronder die welke missiekritieke workflows of vaak geüpdatete gebieden valideren.
Houd exploratief en gebruikerstestwerk handmatig, omdat menselijk oordeel daar waarde toevoegt.
|
Automatiseer wanneer:
|
Houd handmatig wanneer:
|
|
Scenario’s repetitief en stabiel zijn
|
Scenario’s menselijke interpretatie vereisen
|
|
Testdata voorspelbaar is
|
User experience of UI-gedrag wordt geëvalueerd
|
|
Tests frequent via CI/CD draaien
|
Eenmalige of exploratieve tests worden uitgevoerd
|
5. Integreer met CI/CD
Regressietesten integreren in CI/CD-pijplijnen zorgt dat elke wijziging automatisch wordt geverifieerd.
Configureer builds om te falen als regressietests nieuwe issues detecteren, genereer rapporten voor directe triage en hanteer een “vroeg en vaak testen”-filosofie.
Deze aanpak voorkomt dat regressies zich opstapelen en maakt een echte cultuur van continue kwaliteit mogelijk.
|
Voordeel van CI/CD-integratie
|
Resultaat
|
|
Automatische verificatie na elke commit
|
Vroege detectie van regressies
|
|
Build-foutmeldingen
|
Snelle triage van problematische code
|
|
Continue feedbackloop
|
Consistente kwaliteit bij snelle iteraties
|
Een reeks moderne tools ondersteunt efficiënt en schaalbaar regressietesten.
De juiste tool hangt af van de technologiestack van je project, automatiseringsdoelen en volwassenheidsniveau van het team.
Hieronder staan verschillende breed toegepaste opties die regressieworkflows vereenvoudigen en versnellen.
Katalon Studio
Katalon Studio is een uitgebreid testautomatiseringsplatform dat web-, API-, mobiele en desktoptests ondersteunt.
Het heeft een gebruiksvriendelijke grafische interface en robuuste scriptondersteuning. Daarom wordt het gebruikt door teams die overstappen van handmatig naar geautomatiseerd regressietesten.
Katalon biedt ingebouwde keyword-driven en data-driven testing, slimme objectherkenning en gedetailleerde rapportagedashboards.
Een van de grootste voordelen is toegankelijkheid: testers zonder diepgaande programmeerkennis kunnen visueel complexe testcases ontwerpen, terwijl gevorderde gebruikers gedrag kunnen aanpassen met Groovy of JavaScript.
Het platform integreert naadloos met CI/CD-systemen zoals Jenkins en GitLab, waardoor geautomatiseerde regressieruns bij elke build mogelijk zijn.
Cypress
Cypress is een snel, developer-vriendelijk end-to-end testframework dat speciaal is gebouwd voor moderne webapplicaties. In tegenstelling tot traditionele, op Selenium gebaseerde tools draait Cypress rechtstreeks in de browser, waardoor het webgedrag in realtime kan observeren, aansturen en debuggen.
Deze architectuur levert directe feedback, live herladen en zeer betrouwbare testuitvoering zonder de instabiliteit die browserautomatisering soms teistert.
Het is ideaal voor teams die al frameworks als React, Angular of Vue gebruiken, omdat de JavaScript-syntaxis natuurlijk past in front-end workflows.
Cypress biedt ook rijke debuggingtools, automatische wachttijden en gedetailleerde testlogs met screenshots en video’s—perfect om regressies snel te diagnosticeren.
Testsigma
Testsigma biedt een modern, cloudgebaseerd testautomatiseringsplatform dat natural language processing (NLP) gebruikt om testcases in gewoon Engels te schrijven.
Deze aanpak verlaagt de instapdrempel drastisch, waardoor niet-technische teamleden, zoals QA-analisten of product owners, direct kunnen bijdragen aan de regressietestsuite.
Het ondersteunt web-, mobiele, API- en desktoptests binnen één omgeving, waardoor Agile-teams brede dekking behalen zonder veel code-overhead.
Testsigma schaalt bovendien eenvoudig over browsers, besturingssystemen en devices—waardevol voor teams met meerdere deploymenttargets.
Het integreert naadloos met populaire DevOps-tools en CI/CD-pijplijnen en biedt realtime uitvoering, parallel testen en AI-ondersteund testonderhoud.
Naast deze toonaangevende platformen zijn er andere gespecialiseerde tools die regressieworkflows kunnen aanvullen.
Selenium blijft een basis open-sourcenaam voor browserautomatisering, vooral voor teams die zich comfortabel voelen met frameworks en custom scripts. Playwright, ontwikkeld door Microsoft, biedt vergelijkbare mogelijkheden met snellere uitvoering en bredere cross-browserondersteuning.
Voor mobiel testen breidt Appium automatisering uit naar zowel iOS- als Android-platforms via een uniforme API.
Deze tools vormen samen een robuust ecosysteem voor regressietesten. Elk ondersteunt integratie met CI/CD-pijplijnen, versiebeheersystemen en cloudinfrastructuur.
Veelvoorkomende uitdagingen bij regressietesten
Regressietesten is belangrijk, maar kent ook zijn uitdagingen.
Naarmate systemen evolueren en testsuites groeien, wordt het steeds complexer om snelheid, betrouwbaarheid en nauwkeurigheid te behouden.
Inzicht in veelvoorkomende uitdagingen en hoe je ze aanpakt helpt teams om op de lange termijn efficiënte, impactvolle regressiepraktijken te behouden.
De onderstaande afbeelding toont enkele veelvoorkomende uitdagingen bij regressietesten.
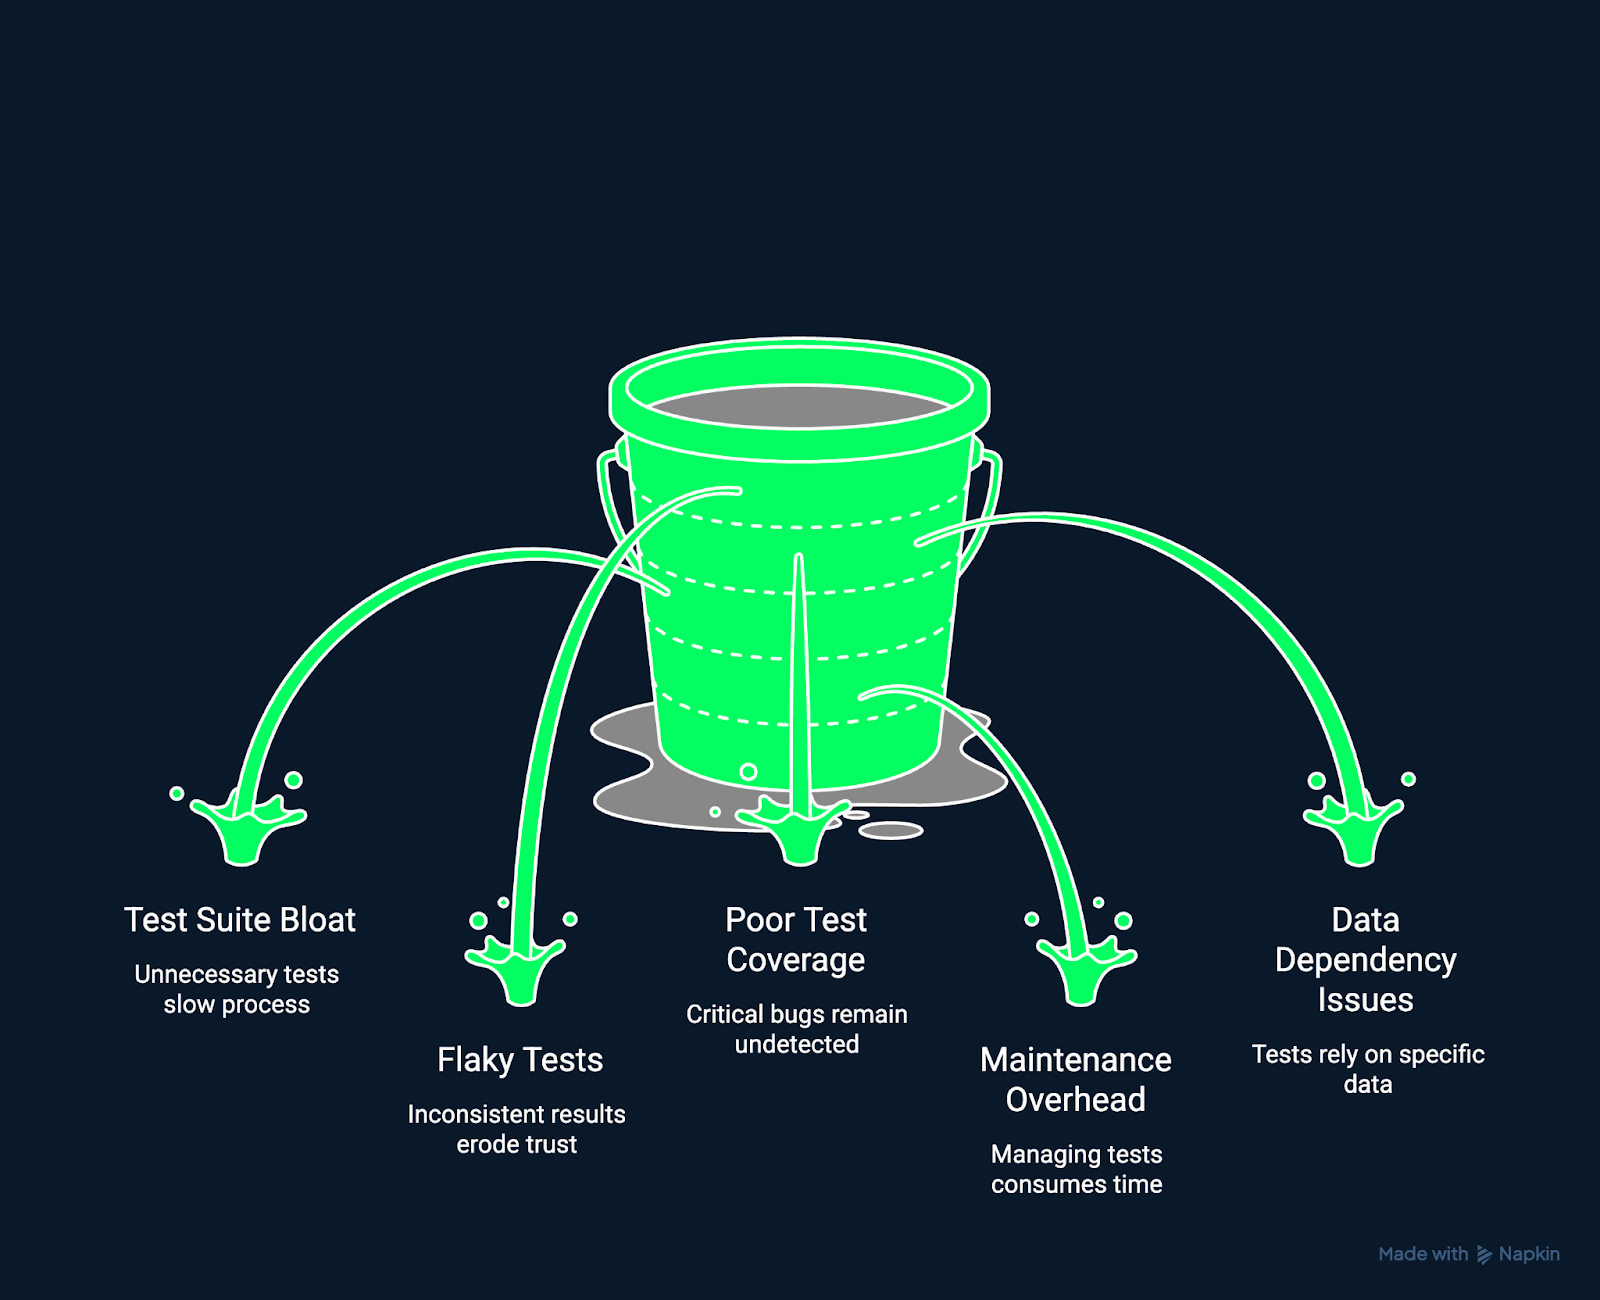
Uitdagingen bij regressietesten. Afbeelding door de auteur met Napkin AI.
Opgezwollen testsuite
Naarmate projecten evolueren, kunnen testcases zich sneller opstapelen dan ze worden herzien. Dit leidt tot opgeblazen suites die langer duren om uit te voeren en redundante of verouderde tests bevatten. Te grote testsuites vertragen feedbackloops en verminderen de testefficiëntie.
De oplossing is om je testsuite regelmatig te auditen en te refactoren. Verwijder verouderde of dubbele tests, consolideer overlappende scenario’s en archiveer historische cases die niet meer relevant zijn.
Flaky tests
Tests die willekeurig falen kunnen developers frustreren. Flaky tests—die inconsistent slagen of falen—kunnen ontstaan door asynchrone operaties of instabiele omgevingen. Ze verminderen het vertrouwen in je testsysteem en verhullen echte regressies.
De oplossing is om testomgevingen te stabiliseren, mockdata te gebruiken in plaats van live calls, en waar nodig expliciete wachttijden of synchronisatie toe te voegen. Houd flaky tests bij en zet ze apart tot ze zijn gefikst om vertrouwen in automatiseringsresultaten te behouden.
Slechte testdekking
Zelfs met uitgebreide tests kunnen kritieke paden ongetest blijven door tijdsdruk of onduidelijk eigenaarschap. Onvoldoende dekking laat regressies onopgemerkt door.
De oplossing is om codecoveragetools en testanalytics te gebruiken om ongeteste gebieden te identificeren. Richt je eerst op modules met hoog risico en hoge impact, en zorg dat nieuwe features vanaf het begin regressietestdekking krijgen.
Hoge onderhoudslast
Geautomatiseerde regressietests kunnen fragiel worden en breken na zelfs kleine UI- of API-updates. Hoge onderhoudskosten ontmoedigen continu testen en vertragen oplevering.
De oplossing is om modulaire, herbruikbare tests te ontwerpen en robuuste elementlocators of API-contracten te gebruiken. Implementeer abstractielagen tussen tests en applicatielogica om herschrijven na updates te minimaliseren.
Problemen met datadependentie
Tests die afhankelijk zijn van live of veranderlijke databronnen kunnen inconsistente resultaten opleveren, waardoor het lastig is echte failures van omgevingsruis te onderscheiden.
De oplossing is om gecontroleerde testdata of mockservices te gebruiken voor voorspelbare, reproduceerbare uitkomsten. Versioneer en documenteer je testdata voor consistentie over omgevingen.
|
Uitdaging
|
Beschrijving
|
Mitigatiestrategie
|
|
Opgezwollen testsuite
|
Testcases stapelen zich in de tijd op en vertragen uitvoering
|
Refactor regelmatig en verwijder redundante tests
|
|
Flaky tests
|
Tests falen af en toe door timing, dependencies of omgevingsinconsistenties
|
Refactor regelmatig en verwijder redundante tests
|
|
Slechte testdekking
|
Sommige kritieke paden worden niet getest door onoplettendheid of tijdgebrek
|
Gebruik codecoveragetools om gaten te identificeren
|
|
Hoge onderhoudslast
|
Geautomatiseerde tests breken na kleine UI- of API-wijzigingen
|
Gebruik modulaire testontwerpen en robuuste selectors
|
|
Datadependentieproblemen
|
Tests leunen op veranderende of live databronnen
|
Gebruik fixtures, mocks of synthetische datasets
|
Als je je begrip van statistische validatie en analytisch testen wilt versterken, probeer dan onze cursus Hypothesis Testing in Python.
Best practices en strategieën voor effectief regressietesten
Sterk regressietesten draait om tests uitvoeren én een duurzaam raamwerk bouwen voor continue kwaliteit.
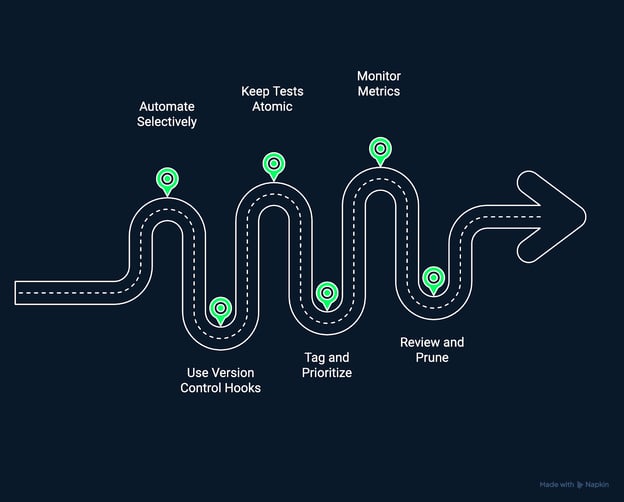
Best practices voor effectief regressietesten. Afbeelding door de auteur met Napkin AI.
Automatiseer vroeg, maar selectief
Automatisering vergroot je testkracht, maar niet alle tests hoeven geautomatiseerd te worden. Begin met het automatiseren van stabiele, waardevolle tests die kernworkflows valideren. Vermijd het automatiseren van vluchtige gebieden totdat de functionaliteit stabiliseert om onderhoudslast te beperken.
Gebruik hooks in versiebeheer
Integreer regressietesten direct in je versiebeheersysteem. Trigger automatische testuitvoeringen bij pull requests of merges om regressies te detecteren voordat wijzigingen in main branches worden samengevoegd. Dit creëert een proactieve, preventieve testaanpak.
Houd tests atomair en onafhankelijk
Elke test moet één gedrag geïsoleerd valideren. Atomische tests maken het makkelijker om failures te diagnosticeren en beperken kettingreacties wanneer één component faalt. Onafhankelijke tests kunnen ook parallel draaien, wat CI/CD-feedbackloops versnelt.
Tag tests op basis van criticaliteit, zoals ‘smoke’, ‘regression’ of ‘performance’. Draai high-impacttests bij elke commit, terwijl bredere suites ’s nachts of vóór release kunnen draaien. Prioritering zorgt dat testen aansluit bij tijdsdruk en bedrijfsrisico.
Monitor testmetrics
Kwantificeer je testprestaties in de tijd. Volg metrics zoals failurerates, uitvoerduur en dekkingsontwikkelingen om knelpunten en verbetermogelijkheden te identificeren. Continue meting houdt je regressietesten wendbaar en accountable.
Beoordeel en snoei regelmatig
Regressietestsuites zijn levende systemen. Verwijder na verloop van tijd verouderde tests, werk verwachtingen bij en pas prioriteiten aan. Een slanke, relevante testsuite levert snellere, nauwkeurigere inzichten met minder ruis.
|
Practice
|
Doel
|
Voorbeeld of uitkomst
|
|
Automatiseer vroeg, maar selectief
|
Richt de inspanning op stabiele, waardevolle tests
|
Verminder onderhoudslast
|
|
Gebruik hooks in versiebeheer
|
Detecteer regressies vóór het mergen van code
|
Draai tests automatisch bij pull requests
|
|
Houd tests atomair en onafhankelijk
|
Vereenvoudig debuggen en maak parallel draaien mogelijk
|
Elke test valideert één specifiek gedrag
|
|
Gebruik testtags en prioritering
|
Zet testresources efficiënt in
|
Kritieke tests draaien bij elke commit
|
|
Monitor testmetrics
|
Volg de gezondheid en efficiëntie van de suite
|
Identificeer trage of flaky gebieden
|
|
Beoordeel en snoei regelmatig
|
Houd de suite snel en relevant
|
Verwijder verouderde of redundante cases
|
Samen vormen deze praktijken de basis van een gezonde regressietestcultuur die snelheid, betrouwbaarheid en onderhoudbaarheid op lange termijn prioriteert.
Wil je je vermogen versterken om onderhoudbare, testbare code te schrijven? Bekijk dan onze cursus Software Engineering Principles in Python.
Conclusie
Onthoud dat naarmate softwaresystemen evolueren en complexer worden, regressietesten een essentieel vangnet wordt voor het behouden van stabiliteit en gebruikersvertrouwen. Elke codewijziging, hoe klein ook, introduceert potentieel risico. Een sterke regressieteststrategie helpt je met vertrouwen updates te leveren en snel te bewegen zonder de software te breken waar je gebruikers op vertrouwen.
Wil je je expertise in softwaretesten verder uitbouwen? Bekijk dan onze cursus Introduction to Testing in Python. Als je robuuste teststrategieën wilt integreren in moderne deploymentpijplijnen, bekijk dan onze cursus CI/CD for Machine Learning.



Door de jaren heen heb ik geleerd dat zelfs de kleinste codewijziging onverwachte gevolgen kan hebben. Wat eerst als een kleine aanpassing lijkt, kan ongemerkt iets breken dat eerst perfect werkte.
Daarom is regressietesten zo belangrijk. Het is in wezen een vangnet dat ervoor zorgt dat vooruitgang niet ten koste gaat van stabiliteit.
In mijn ervaring met data-gedreven projecten, waar modellen, API’s en pipelines constant evolueren, is regressietesten essentieel geweest om consistente, betrouwbare outputs te behouden.
Zonder dit kan zelfs een kleine aanpassing, zoals het tweaken van een transformatiefunctie of het updaten van een package, onverwacht gedrag veroorzaken dat lastig te herleiden is.
Als je nieuw bent met Python of je basiskennis wilt opfrissen voordat je dieper in testen duikt, bekijk dan onze Python Programming-skilltrack.
Wat is regressietesten?
Kort gezegd betekent regressietesten het opnieuw testen van bestaande functionaliteit na codewijzigingen om te bevestigen dat niets is ‘teruggevallen’ naar een kapotte staat.
Hoewel het woord ‘regressie’ wiskundig kan klinken, betekent het in testen eigenlijk ‘een stap terug’.
Telkens wanneer je code wijzigt (zoals het oplossen van een bug of het toevoegen van een feature), bestaat de kans dat de nieuwe wijziging eerder werkende componenten breekt. Daarom hebben we regressietesten nodig.
Regressietesten beantwoordt de volgende cruciale vraag:
Werkt na deze wijziging alles wat eerder werkte nog steeds?
In tegenstelling tot unittesten, die geïsoleerde componenten valideert, of integratietesten, die bekijkt hoe modules samenwerken, neemt regressietesten een bredere, langetermijnblik.
Het zorgt ervoor dat je software release na release stabiel en consistent blijft, zelfs terwijl het evolueert.
Voorbeelden van regressietesten. Afbeelding door de auteur met Napkin AI.
Bijvoorbeeld:
In omgevingen met continue ontwikkeling (vooral Agile en DevOps) fungeert regressietesten als een vangnet waarmee je snel kunt itereren zonder stabiliteit op te offeren.
Het geeft het vertrouwen dat nodig is voor frequente deploys, geautomatiseerde workflows en continuous integration-praktijken.
Waarom regressietesten nuttig is
Regressietesten is een van de meest betrouwbare manieren om te zorgen dat je softwarekwaliteit consistent blijft terwijl je systeem evolueert. Het helpt je deze rimpel-effecten vroeg te detecteren en te voorkomen, wat op zijn beurt stabiliteit en gebruikersvertrouwen behoudt.
Bescherm tegen nieuwe bugs
Nieuwe code brengt vaak onbedoelde neveneffecten met zich mee. Een simpele refactor of dependency-upgrade kan functionaliteit in ver weg gelegen modules breken.
Regressietesten helpt je zulke issues te identificeren voordat ze productie of gebruikers raken. Geautomatiseerde regressiesuites kunnen na elke codepush draaien en conflicten tussen nieuwe en legacylogica blootleggen. Deze vroege feedback bespaart tijd, vermindert debug-overhead en houdt het ontwikkelvertrouwen op peil.
In snel bewegende Agile- of DevOps-teams werkt geautomatiseerde regressie als een vangrail die developers laat innoveren zonder bang te zijn bestaande features te breken.
Voordeel
Beschrijving
Voorbeeld
Vroege detectie
Identificeert bugs kort na nieuwe commits
Een nieuwe API-route breekt een bestaande clientaanvraag
Sneller debuggen
Wijst precies aan waar nieuwe logica faalt
CI-rapporten linken gefaalde tests aan specifieke modules
Vertrouwen bij developers
Stimuleert frequente, veilige releases
Teams deployen continu zonder handmatige checks
Voorkom dat defects terugkeren
Een van de meest frustrerende problemen in softwareonderhoud is een oude bug die terugkeert.
Regressietests fungeren als permanente waarborgen (oftewel: zodra een bug is gefikst, zorgt de bijbehorende test ervoor dat hij gefikst blijft en niet opnieuw opduikt).
Na verloop van tijd ontstaat zo een vangnet gebaseerd op de eigen bughistorie van je project.
Deze praktijk in je workflow inbedden betekent dat je testsuite niet alleen nieuwe functionaliteit valideert, maar ook elke fix die eerder is doorgevoerd.
Vóór regressietests
Na regressietests
Oude bugs duiken onvoorspelbaar op
Gefixte issues blijven blijvend geverifieerd
Bugfixes leunen op geheugen of documentatie
Tests bevestigen eerdere fixes automatisch
QA-teams herhalen handmatige checks
Geautomatiseerde vangrails voorkomen herhaling
Behouden van gebruikersvertrouwen
Betrouwbaarheid is ononderhandelbaar, zeker vanuit het perspectief van de gebruiker. Features die de ene dag werken en de volgende dag falen, ondermijnen vertrouwen en tevredenheid.
Regressietesten zorgt voor een consistente ervaring over updates heen, wat het vertrouwen in je product versterkt.
In data-gedreven applicaties betekent deze betrouwbaarheid consistente resultaten en voorspelbaar gedrag, zelfs terwijl modellen, databronnen en API’s evolueren.
Toepassingsgebied
Wat regressietesten beschermt
Dashboards
Zorgt dat visualisaties correct renderen na backend- of dataschema-updates
Model-API’s
Verifieert dat modelvoorspellingen stabiel en reproduceerbaar blijven
Datapijplijnen
Bevestigt dat data-exports schema- en formaatconsistentie behouden
Risico’s beperken
Regressietesten is ook een cruciaal onderdeel van risicomanagement. Zonder dit kunnen onverwachte bugs laat in de releasecyclus doorslippen, met storingen of kostbare rollbacks tot gevolg.
Stabiliteit bij elke iteratie verifiëren helpt je team met vertrouwen te releasen, in de wetenschap dat de functionaliteit niet is aangetast.
Met regressietesten
Zonder regressietesten
Voorspelbare, risicovarme releases
Regelmatig last-minute bugs en rollbacks
Zelfverzekerde CI/CD-pijplijnen
Schroom bij deployments, handmatige QA-knooppunten
Continue kwaliteitsborging
Brandjes blussen na deployment
Typen en technieken voor regressietesten
Regressietesten is geen one-size-fits-all. De juiste aanpak hangt af van factoren zoals de grootte van de codebase, wijzigingsfrequentie en zakelijke impact.
Elk van de volgende methoden balanceert snelheid, dekking en inzet van middelen op een andere manier.
1. Alles hertesten
De eenvoudigste vorm van regressietesten houdt in dat je na een wijziging alle bestaande tests draait.
Hoewel dit garandeert dat niets gemist wordt, wordt het naarmate systemen groeien steeds onpraktischer.
Daarom wordt deze aanpak vaak gebruikt vroeg in de levenscyclus van een project of bij het valideren van een grote refactor.
2. Selectief regressietesten
Selectieve regressie richt zich alleen op de gebieden die direct zijn beïnvloed door recente wijzigingen.
Het gebruikt impactanalyse om afhankelijkheden te bepalen en de testomvang te beperken.
Als bijvoorbeeld een datatransformatiemodule verandert, hoeven gerelateerde tests voor authenticatie of UI-rendering mogelijk niet opnieuw te worden uitgevoerd.
Deze aanpak balanceert nauwkeurigheid met snelheid en berust op goede afhankelijkheidstracking.
3. Geprioriteerd regressietesten
In grote systemen laten tijd en middelen zelden volledige regressiedekking toe.
Geprioriteerd regressietesten rangschikt testcases op belangrijkheid en risiconiveau, zodat kritieke paden (zoals betalingen of authenticatie) als eerste worden geverifieerd.
Tests met lagere prioriteit kunnen later of asynchroon draaien.
De onderstaande tabel schetst typische prioriteitsniveaus, met voorbeelden van gedekte gebieden en hun bijbehorende testfocus.
Prioriteitsniveau
Voorbeeldgebied
Testfocus
Hoog
Betalingsverwerking, authenticatie
Mag nooit falen en wordt altijd eerst getest
Middel
Dashboardvisuals, e-mailmeldingen
Moet consistent functioneren
Laag
Layout-aanpassingen, tooltips
Cosmetisch en minder kritisch tijdens snelle cycli
4. De automatiseringsmust
Handmatig regressietesten wordt al snel onhoudbaar naarmate projecten opschalen.
Automatisering daarentegen verandert regressietesten van een trage stap in een manier om sneller en met meer vertrouwen te werken.
Geautomatiseerde suites draaien bij elke build of pull request, geven directe feedback en integreren met CI-tools zoals Jenkins, GitHub Actions of GitLab CI/CD.
Ze maken continue verificatie over omgevingen heen mogelijk, een essentiële vaardigheid voor Agile- en DevOps-teams die willen ‘move fast without breaking things’.
Voordeel van automatisering
Impact op ontwikkeling
Continue feedback
Snellere identificatie van breaking changes
Consistente uitvoering
Elimineert menselijke fouten in repetitieve tests
Schaalbaarheid
Tests draaien gelijktijdig over omgevingen
Klaar voor integratie
Past direct in CI/CD-workflows
De onderstaande tabel geeft een korte overzicht van de belangrijkste regressietesttechnieken die hierboven zijn besproken.
Type
Beschrijving
Pluspunten
Minpunten
Beste voor
Alles hertesten
Draait alle testcases na elke wijziging
Volledige dekking en grondige validatie
Zeer tijdrovend en hoge kosten
Kleine systemen en baselinetesten
Selectieve regressie
Test alleen getroffen componenten op basis van codewijzigingen
Efficiënt en snellere feedback
Vereist nauwkeurige afhankelijkheidsmapping
Modulaire systemen en frequente releases
Geprioriteerde regressie
Voert tests uit gerangschikt op zakelijke impact
Richt zich eerst op kritieke functionaliteit
Kan minder kritieke maar relevante gebieden overslaan
Tijdgebonden testcycli
Geautomatiseerde regressie
Draait automatisch via CI/CD na codecommits
Snel, schaalbaar, herhaalbaar
Vereist inrichting en onderhoud
Grote of snel evoluerende projecten
Een regressiesuite opbouwen en onderhouden
Een regressiesuite opzetten is een doorlopende investering in softwarekwaliteit.
Na verloop van tijd wordt het een van de waardevolste assets in je ontwikkelproces.
De onderstaande afbeelding laat de stappen zien die komen kijken bij het opbouwen en onderhouden van een regressiesuite.
Een regressiesuite opbouwen en onderhouden. Afbeelding door de auteur met Napkin AI.
1. Begin met impactanalyse
Begin met begrijpen welke delen van het systeem door een wijziging zijn beïnvloed.
Het is een goed idee om tools te gebruiken zoals codecoverage-analyzers of dependency graphs om te bepalen welke tests je opnieuw moet draaien.
Geef prioriteit aan modules die interacteren met aangepaste code, gemeenschappelijke datastructuren delen of eerder faalden na soortgelijke updates.
2. Bouw een gebalanceerde testsuite
Ontwikkel een testsuite die kritieke bedrijfsworkflows, essentiële dataprocessen en veelvoorkomende user journeys grondig dekt.
Zorg dat elke test een specifiek doel en een duidelijke scope heeft, en probeer redundantie of overlap te vermijden.
Modulaire, herbruikbare tests maken onderhoud makkelijker naarmate je systeem evolueert.
3. Gebruik een checklistaanpak
Een gestructureerde checklist helpt consistentie en volledigheid te waarborgen bij zowel handmatige als geautomatiseerde regressietesten.
Het vermindert het over het hoofd zien, standaardiseert de uitvoering en bevordert herhaalbare kwaliteitsprocessen.
Stap
Doel
Definieer precondities
Bepaal systeemstatus en inputdata
Voer testcase uit
Draai de test onder gecontroleerde omstandigheden
Verifieer uitkomsten
Valideer zowel verwachte output als neveneffecten
Leg resultaten vast
Documenteer passes, failures en eventuele anomalieën
Deze methode biedt structuur, transparantie en verantwoording, bijzonder nuttig bij het onboarden van nieuwe QA-engineers.
4. Bepaal wat je automatiseert
Niet alle tests moeten worden geautomatiseerd.
Automatiseer stabiele, herhaalbare en veelvoorkomende tests, waaronder die welke missiekritieke workflows of vaak geüpdatete gebieden valideren.
Houd exploratief en gebruikerstestwerk handmatig, omdat menselijk oordeel daar waarde toevoegt.
Automatiseer wanneer:
Houd handmatig wanneer:
Scenario’s repetitief en stabiel zijn
Scenario’s menselijke interpretatie vereisen
Testdata voorspelbaar is
User experience of UI-gedrag wordt geëvalueerd
Tests frequent via CI/CD draaien
Eenmalige of exploratieve tests worden uitgevoerd
5. Integreer met CI/CD
Regressietesten integreren in CI/CD-pijplijnen zorgt dat elke wijziging automatisch wordt geverifieerd.
Configureer builds om te falen als regressietests nieuwe issues detecteren, genereer rapporten voor directe triage en hanteer een “vroeg en vaak testen”-filosofie.
Deze aanpak voorkomt dat regressies zich opstapelen en maakt een echte cultuur van continue kwaliteit mogelijk.
Voordeel van CI/CD-integratie
Resultaat
Automatische verificatie na elke commit
Vroege detectie van regressies
Build-foutmeldingen
Snelle triage van problematische code
Continue feedbackloop
Consistente kwaliteit bij snelle iteraties
Tools voor regressietesten
Een reeks moderne tools ondersteunt efficiënt en schaalbaar regressietesten.
De juiste tool hangt af van de technologiestack van je project, automatiseringsdoelen en volwassenheidsniveau van het team.
Hieronder staan verschillende breed toegepaste opties die regressieworkflows vereenvoudigen en versnellen.
Katalon Studio
Katalon Studio is een uitgebreid testautomatiseringsplatform dat web-, API-, mobiele en desktoptests ondersteunt.
Het heeft een gebruiksvriendelijke grafische interface en robuuste scriptondersteuning. Daarom wordt het gebruikt door teams die overstappen van handmatig naar geautomatiseerd regressietesten.
Katalon biedt ingebouwde keyword-driven en data-driven testing, slimme objectherkenning en gedetailleerde rapportagedashboards.
Een van de grootste voordelen is toegankelijkheid: testers zonder diepgaande programmeerkennis kunnen visueel complexe testcases ontwerpen, terwijl gevorderde gebruikers gedrag kunnen aanpassen met Groovy of JavaScript.
Het platform integreert naadloos met CI/CD-systemen zoals Jenkins en GitLab, waardoor geautomatiseerde regressieruns bij elke build mogelijk zijn.
Cypress
Cypress is een snel, developer-vriendelijk end-to-end testframework dat speciaal is gebouwd voor moderne webapplicaties. In tegenstelling tot traditionele, op Selenium gebaseerde tools draait Cypress rechtstreeks in de browser, waardoor het webgedrag in realtime kan observeren, aansturen en debuggen.
Deze architectuur levert directe feedback, live herladen en zeer betrouwbare testuitvoering zonder de instabiliteit die browserautomatisering soms teistert.
Het is ideaal voor teams die al frameworks als React, Angular of Vue gebruiken, omdat de JavaScript-syntaxis natuurlijk past in front-end workflows.
Cypress biedt ook rijke debuggingtools, automatische wachttijden en gedetailleerde testlogs met screenshots en video’s—perfect om regressies snel te diagnosticeren.
Testsigma
Testsigma biedt een modern, cloudgebaseerd testautomatiseringsplatform dat natural language processing (NLP) gebruikt om testcases in gewoon Engels te schrijven.
Deze aanpak verlaagt de instapdrempel drastisch, waardoor niet-technische teamleden, zoals QA-analisten of product owners, direct kunnen bijdragen aan de regressietestsuite.
Het ondersteunt web-, mobiele, API- en desktoptests binnen één omgeving, waardoor Agile-teams brede dekking behalen zonder veel code-overhead.
Testsigma schaalt bovendien eenvoudig over browsers, besturingssystemen en devices—waardevol voor teams met meerdere deploymenttargets.
Het integreert naadloos met populaire DevOps-tools en CI/CD-pijplijnen en biedt realtime uitvoering, parallel testen en AI-ondersteund testonderhoud.
Aanvullende tools
Naast deze toonaangevende platformen zijn er andere gespecialiseerde tools die regressieworkflows kunnen aanvullen.
Selenium blijft een basis open-sourcenaam voor browserautomatisering, vooral voor teams die zich comfortabel voelen met frameworks en custom scripts. Playwright, ontwikkeld door Microsoft, biedt vergelijkbare mogelijkheden met snellere uitvoering en bredere cross-browserondersteuning.
Voor mobiel testen breidt Appium automatisering uit naar zowel iOS- als Android-platforms via een uniforme API.
Deze tools vormen samen een robuust ecosysteem voor regressietesten. Elk ondersteunt integratie met CI/CD-pijplijnen, versiebeheersystemen en cloudinfrastructuur.
Veelvoorkomende uitdagingen bij regressietesten
Regressietesten is belangrijk, maar kent ook zijn uitdagingen.
Naarmate systemen evolueren en testsuites groeien, wordt het steeds complexer om snelheid, betrouwbaarheid en nauwkeurigheid te behouden.
Inzicht in veelvoorkomende uitdagingen en hoe je ze aanpakt helpt teams om op de lange termijn efficiënte, impactvolle regressiepraktijken te behouden.
De onderstaande afbeelding toont enkele veelvoorkomende uitdagingen bij regressietesten.
Uitdagingen bij regressietesten. Afbeelding door de auteur met Napkin AI.
Opgezwollen testsuite
Naarmate projecten evolueren, kunnen testcases zich sneller opstapelen dan ze worden herzien. Dit leidt tot opgeblazen suites die langer duren om uit te voeren en redundante of verouderde tests bevatten. Te grote testsuites vertragen feedbackloops en verminderen de testefficiëntie.
De oplossing is om je testsuite regelmatig te auditen en te refactoren. Verwijder verouderde of dubbele tests, consolideer overlappende scenario’s en archiveer historische cases die niet meer relevant zijn.
Flaky tests
Tests die willekeurig falen kunnen developers frustreren. Flaky tests—die inconsistent slagen of falen—kunnen ontstaan door asynchrone operaties of instabiele omgevingen. Ze verminderen het vertrouwen in je testsysteem en verhullen echte regressies.
De oplossing is om testomgevingen te stabiliseren, mockdata te gebruiken in plaats van live calls, en waar nodig expliciete wachttijden of synchronisatie toe te voegen. Houd flaky tests bij en zet ze apart tot ze zijn gefikst om vertrouwen in automatiseringsresultaten te behouden.
Slechte testdekking
Zelfs met uitgebreide tests kunnen kritieke paden ongetest blijven door tijdsdruk of onduidelijk eigenaarschap. Onvoldoende dekking laat regressies onopgemerkt door.
De oplossing is om codecoveragetools en testanalytics te gebruiken om ongeteste gebieden te identificeren. Richt je eerst op modules met hoog risico en hoge impact, en zorg dat nieuwe features vanaf het begin regressietestdekking krijgen.
Hoge onderhoudslast
Geautomatiseerde regressietests kunnen fragiel worden en breken na zelfs kleine UI- of API-updates. Hoge onderhoudskosten ontmoedigen continu testen en vertragen oplevering.
De oplossing is om modulaire, herbruikbare tests te ontwerpen en robuuste elementlocators of API-contracten te gebruiken. Implementeer abstractielagen tussen tests en applicatielogica om herschrijven na updates te minimaliseren.
Problemen met datadependentie
Tests die afhankelijk zijn van live of veranderlijke databronnen kunnen inconsistente resultaten opleveren, waardoor het lastig is echte failures van omgevingsruis te onderscheiden.
De oplossing is om gecontroleerde testdata of mockservices te gebruiken voor voorspelbare, reproduceerbare uitkomsten. Versioneer en documenteer je testdata voor consistentie over omgevingen.
Uitdaging
Beschrijving
Mitigatiestrategie
Opgezwollen testsuite
Testcases stapelen zich in de tijd op en vertragen uitvoering
Refactor regelmatig en verwijder redundante tests
Flaky tests
Tests falen af en toe door timing, dependencies of omgevingsinconsistenties
Refactor regelmatig en verwijder redundante tests
Slechte testdekking
Sommige kritieke paden worden niet getest door onoplettendheid of tijdgebrek
Gebruik codecoveragetools om gaten te identificeren
Hoge onderhoudslast
Geautomatiseerde tests breken na kleine UI- of API-wijzigingen
Gebruik modulaire testontwerpen en robuuste selectors
Datadependentieproblemen
Tests leunen op veranderende of live databronnen
Gebruik fixtures, mocks of synthetische datasets
Als je je begrip van statistische validatie en analytisch testen wilt versterken, probeer dan onze cursus Hypothesis Testing in Python.
Best practices en strategieën voor effectief regressietesten
Sterk regressietesten draait om tests uitvoeren én een duurzaam raamwerk bouwen voor continue kwaliteit.
Best practices voor effectief regressietesten. Afbeelding door de auteur met Napkin AI.
Automatiseer vroeg, maar selectief
Automatisering vergroot je testkracht, maar niet alle tests hoeven geautomatiseerd te worden. Begin met het automatiseren van stabiele, waardevolle tests die kernworkflows valideren. Vermijd het automatiseren van vluchtige gebieden totdat de functionaliteit stabiliseert om onderhoudslast te beperken.
Gebruik hooks in versiebeheer
Integreer regressietesten direct in je versiebeheersysteem. Trigger automatische testuitvoeringen bij pull requests of merges om regressies te detecteren voordat wijzigingen in main branches worden samengevoegd. Dit creëert een proactieve, preventieve testaanpak.
Houd tests atomair en onafhankelijk
Elke test moet één gedrag geïsoleerd valideren. Atomische tests maken het makkelijker om failures te diagnosticeren en beperken kettingreacties wanneer één component faalt. Onafhankelijke tests kunnen ook parallel draaien, wat CI/CD-feedbackloops versnelt.
Gebruik testtags en prioritering
Tag tests op basis van criticaliteit, zoals ‘smoke’, ‘regression’ of ‘performance’. Draai high-impacttests bij elke commit, terwijl bredere suites ’s nachts of vóór release kunnen draaien. Prioritering zorgt dat testen aansluit bij tijdsdruk en bedrijfsrisico.
Monitor testmetrics
Kwantificeer je testprestaties in de tijd. Volg metrics zoals failurerates, uitvoerduur en dekkingsontwikkelingen om knelpunten en verbetermogelijkheden te identificeren. Continue meting houdt je regressietesten wendbaar en accountable.
Beoordeel en snoei regelmatig
Regressietestsuites zijn levende systemen. Verwijder na verloop van tijd verouderde tests, werk verwachtingen bij en pas prioriteiten aan. Een slanke, relevante testsuite levert snellere, nauwkeurigere inzichten met minder ruis.
Practice
Doel
Voorbeeld of uitkomst
Automatiseer vroeg, maar selectief
Richt de inspanning op stabiele, waardevolle tests
Verminder onderhoudslast
Gebruik hooks in versiebeheer
Detecteer regressies vóór het mergen van code
Draai tests automatisch bij pull requests
Houd tests atomair en onafhankelijk
Vereenvoudig debuggen en maak parallel draaien mogelijk
Elke test valideert één specifiek gedrag
Gebruik testtags en prioritering
Zet testresources efficiënt in
Kritieke tests draaien bij elke commit
Monitor testmetrics
Volg de gezondheid en efficiëntie van de suite
Identificeer trage of flaky gebieden
Beoordeel en snoei regelmatig
Houd de suite snel en relevant
Verwijder verouderde of redundante cases
Samen vormen deze praktijken de basis van een gezonde regressietestcultuur die snelheid, betrouwbaarheid en onderhoudbaarheid op lange termijn prioriteert.
Wil je je vermogen versterken om onderhoudbare, testbare code te schrijven? Bekijk dan onze cursus Software Engineering Principles in Python.
Conclusie
Onthoud dat naarmate softwaresystemen evolueren en complexer worden, regressietesten een essentieel vangnet wordt voor het behouden van stabiliteit en gebruikersvertrouwen. Elke codewijziging, hoe klein ook, introduceert potentieel risico. Een sterke regressieteststrategie helpt je met vertrouwen updates te leveren en snel te bewegen zonder de software te breken waar je gebruikers op vertrouwen.
Wil je je expertise in softwaretesten verder uitbouwen? Bekijk dan onze cursus Introduction to Testing in Python. Als je robuuste teststrategieën wilt integreren in moderne deploymentpijplijnen, bekijk dan onze cursus CI/CD for Machine Learning.