Nel corso degli anni ho imparato che anche la modifica di codice più piccola può avere conseguenze inaspettate. Quello che all’inizio sembra un cambiamento minimo può, senza far rumore, rompere qualcosa che funzionava perfettamente.
Per questo i test di regressione sono importanti. Sono, in sostanza, una rete di sicurezza che assicura che il progresso non avvenga a scapito della stabilità.
Nella mia esperienza con progetti data-driven, in cui modelli, API e pipeline evolvono costantemente, i test di regressione sono stati fondamentali per mantenere output coerenti e affidabili.
Senza di essi, anche piccoli aggiustamenti come ritoccare una funzione di trasformazione o aggiornare un pacchetto possono innescare comportamenti inaspettati difficili da rintracciare.
Se sei alle prime armi con Python o vuoi ripassare le basi prima di approfondire il testing, da un’occhiata al nostro skill track Python Programming.
Che cos’è il regression testing?
In breve, il regression testing significa ri-testare funzionalità esistenti dopo modifiche al codice per confermare che nulla sia “regredito” a uno stato non funzionante.
Anche se la parola “regressione” può sembrare matematica, nel testing indica in realtà “un passo indietro”.
Ogni volta che modifichi il codice (che si tratti di correggere un bug o aggiungere una funzionalità), c’è la possibilità che la novità rompa componenti che prima funzionavano, ed è per questo che servono i test di regressione.
Il regression testing risponde alla seguente domanda cruciale:
Dopo questa modifica, tutto ciò che prima funzionava funziona ancora?
A differenza dei test unitari, che validano componenti isolati, o dei test di integrazione, che verificano come i moduli lavorano insieme, il regression testing adotta una prospettiva più ampia e di lungo periodo.
Garantisce che il tuo software resti stabile e coerente release dopo release, anche mentre evolve.
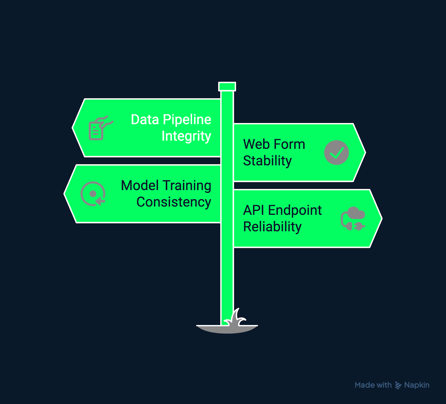
Esempi di regression testing. Immagine dell’autore realizzata con Napkin AI.
Per esempio:
- La nuova logica di trasformazione di una data pipeline non dovrebbe corrompere i vecchi file di output.
- L’aggiornamento dello script di validazione di un form web non dovrebbe rompere i flussi di invio esistenti.
- Ottimizzare una routine di training del modello non dovrebbe reintrodurre un bug precedentemente corretto nel preprocessing dei dati.
- Modificare un endpoint API non dovrebbe causare errori nei sistemi a valle o nelle dashboard.
Negli ambienti di sviluppo continui (soprattutto Agile e DevOps), il regression testing agisce come una rete di sicurezza che ti permette di iterare rapidamente senza sacrificare la stabilità.
Supporta la fiducia necessaria per deployment frequenti, workflow automatizzati e pratiche di integrazione continua.
Perché il regression testing è utile
Il regression testing è uno dei modi più affidabili per garantire che la qualità del software resti costante mentre il sistema evolve. Aiuta a rilevare e prevenire presto questi effetti a catena, salvaguardando stabilità e fiducia degli utenti.
Proteggiti da nuovi bug
Il codice nuovo spesso porta con sé effetti collaterali involontari. Un semplice refactoring o l’aggiornamento di una dipendenza può rompere funzionalità in moduli lontani.
Il regression testing aiuta a identificare questi problemi prima che incidano sulla produzione o sugli utenti. Suite di regressione automatizzate possono essere eseguite dopo ogni push di codice, mettendo in evidenza conflitti tra la nuova logica e quella legacy. Questo feedback precoce ti fa risparmiare tempo, riduce il carico di debugging e mantiene alta la fiducia nello sviluppo.
Nei team Agile o DevOps in rapida evoluzione, l’automazione della regressione funge da guardrail che consente agli sviluppatori di innovare senza la paura di rompere funzionalità consolidate.
|
Vantaggio
|
Descrizione
|
Esempio
|
|
Rilevamento precoce
|
Identifica i bug subito dopo i nuovi commit
|
Una nuova route API interrompe una richiesta client esistente
|
|
Debug più rapido
|
Individua esattamente dove fallisce la nuova logica
|
I report della CI collegano i test falliti a moduli specifici
|
|
Fiducia degli sviluppatori
|
Favorisce release frequenti e sicure
|
I team distribuiscono continuamente senza controlli manuali
|
Impedisci il ritorno dei difetti
Uno dei problemi più frustranti nella manutenzione software è vedere tornare un vecchio bug.
I test di regressione agiscono come salvaguardie permanenti (cioè, una volta corretto un bug, il relativo test assicura che resti risolto e non si ripresenti).
Col tempo, questo crea una rete di sicurezza basata sulla storia dei bug del tuo progetto.
Integrare questa pratica nel tuo workflow significa che la suite di test valida non solo le nuove funzionalità, ma anche ogni fix implementato in passato.
|
Prima dei test di regressione
|
Dopo i test di regressione
|
|
Vecchi bug riappaiono in modo imprevedibile
|
I problemi corretti restano verificati in modo permanente
|
|
Le correzioni si basano su memoria o documentazione
|
I test confermano automaticamente i fix precedenti
|
|
I team QA ripetono controlli manuali
|
Guardie automatizzate evitano recidive
|
Mantieni la fiducia degli utenti
L’affidabilità non è negoziabile, soprattutto dal punto di vista dell’utente. Funzionalità che un giorno funzionano e il giorno dopo no minano fiducia e soddisfazione.
Il regression testing assicura un’esperienza coerente tra gli aggiornamenti, rafforzando la fiducia nel tuo prodotto.
Nelle applicazioni data-driven, questa affidabilità significa mantenere risultati coerenti e comportamenti prevedibili, anche mentre modelli, fonti dati e API evolvono.
|
Area applicativa
|
Cosa protegge il regression testing
|
|
Dashboard
|
Garantisce che le visualizzazioni si rendano correttamente dopo aggiornamenti del backend o dello schema dei dati
|
|
API dei modelli
|
Verifica che le predizioni dei modelli restino stabili e riproducibili
|
|
Data pipeline
|
Conferma che gli export dei dati preservino coerenza di schema e formato
|
Mitiga il rischio
Il regression testing è anche una parte cruciale della gestione del rischio. Senza di esso, bug inattesi possono sfuggire nelle fasi finali del ciclo di rilascio, causando outage o costosi rollback.
Verificare la stabilità a ogni iterazione aiuta il team a rilasciare con fiducia, sapendo che le modifiche non hanno compromesso le funzionalità.
|
Con regression testing
|
Senza regression testing
|
|
Rilasci prevedibili e a basso rischio
|
Bug e rollback dell’ultimo minuto frequenti
|
|
Pipeline CI/CD affidabili
|
Deployment esitanti, colli di bottiglia nel QA manuale
|
|
Assicurazione qualità continua
|
“Spegnere incendi” dopo il rilascio
|
Tipi e tecniche di regression testing
Il regression testing non è uguale per tutti. L’approccio giusto dipende da fattori come dimensione del codebase, frequenza dei cambiamenti e impatto sul business.
Ognuno dei metodi seguenti bilancia in modo diverso velocità, copertura e costi di risorse.
1. Retest all
La forma più semplice di regression testing consiste nell’eseguire tutti i test esistenti dopo una modifica.
Pur assicurando di non tralasciare nulla, diventa via via meno praticabile man mano che i sistemi crescono.
Perciò questo approccio è spesso usato nelle prime fasi di vita di un progetto o quando si valida un refactoring importante.
2. Regression testing selettivo
La regressione selettiva prende di mira solo le aree direttamente interessate dalle modifiche recenti.
Utilizza analisi d’impatto per determinare le dipendenze e limitare il perimetro dei test.
Per esempio, se cambia un modulo di trasformazione dati, potrebbe non essere necessario rieseguire i test correlati ad autenticazione o rendering della UI.
Questo approccio bilancia precisione e velocità e si basa su un buon tracciamento delle dipendenze.
3. Regression testing prioritizzato
Nei sistemi di grandi dimensioni, tempo e risorse raramente consentono una copertura completa della regressione.
Il regression testing prioritizzato ordina i casi di test per importanza e livello di rischio, assicurando che i percorsi critici (come pagamenti o autenticazione) siano verificati per primi.
I test a priorità più bassa possono essere eseguiti in seguito o in modo asincrono.
La tabella seguente riporta i tipici livelli di priorità, con esempi delle aree coperte e del relativo focus di test.
|
Livello di priorità
|
Area di esempio
|
Focus dei test
|
|
Alta
|
Elaborazione pagamenti, autenticazione
|
Non deve mai fallire ed è testata per prima
|
|
Media
|
Visual della dashboard, notifiche email
|
Dovrebbe funzionare in modo coerente
|
|
Bassa
|
Aggiustamenti di layout, tooltip
|
Cosmetici e meno critici nei cicli rapidi
|
4. L’imperativo dell’automazione
Il regression testing manuale diventa rapidamente insostenibile man mano che i progetti scalano.
L’automazione, invece, trasforma il regression testing da un passaggio lento a un modo per lavorare più velocemente e con più fiducia.
Suite automatizzate vengono eseguite a ogni build o pull request, forniscono feedback immediato e si integrano con strumenti CI come Jenkins, GitHub Actions o GitLab CI/CD.
Consentono una verifica continua tra ambienti, una capacità essenziale per i team Agile e DevOps che puntano a “muoversi in fretta senza rompere le cose”.
|
Vantaggio dell’automazione
|
Impatto sullo sviluppo
|
|
Feedback continuo
|
Identificazione più rapida delle modifiche che rompono
|
|
Esecuzione coerente
|
Elimina l’errore umano nei test ripetitivi
|
|
Scalabilità
|
I test girano in parallelo su più ambienti
|
|
Pronta per l’integrazione
|
Si integra direttamente nei workflow CI/CD
|
La tabella seguente fornisce una panoramica rapida delle principali tecniche di regression testing trattate sopra.
|
Tipo
|
Descrizione
|
Pro
|
Contro
|
Ideale per
|
|
Retest-all
|
Esegue tutti i casi di test dopo ogni modifica
|
Copertura completa e validazione approfondita
|
Molto dispendioso in tempo e costi elevati
|
Sistemi piccoli e test di base
|
|
Regression selettiva
|
Testa solo i componenti interessati dalle modifiche al codice
|
Efficiente e con feedback più rapido
|
Richiede mappatura accurata delle dipendenze
|
Sistemi modulari e release frequenti
|
|
Regression prioritaria
|
Esegue test ordinati per impatto sul business
|
Si concentra prima sulle funzionalità critiche
|
Potrebbe tralasciare aree meno critiche ma rilevanti
|
Cicli di test a tempo limitato
|
|
Regression automatizzata
|
Gira automaticamente via CI/CD dopo i commit
|
Veloce, scalabile, ripetibile
|
Richiede setup e manutenzione
|
Progetti grandi o in rapida evoluzione
|
Creare e mantenere una suite di regressione
Creare una suite di regressione è un investimento continuo nella qualità del software.
Col tempo, diventa uno degli asset più preziosi del tuo processo di sviluppo.
L’immagine seguente mostra i passaggi per costruire e mantenere una suite di regressione.
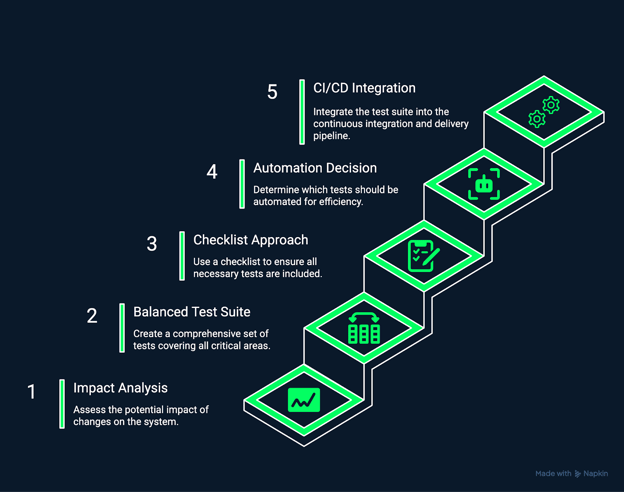
Creare e mantenere una suite di regressione. Immagine dell’autore realizzata con Napkin AI.
1. Parti dall’analisi d’impatto
Inizia comprendendo quali parti del sistema sono interessate da una modifica.
È una buona idea usare strumenti come analizzatori di code coverage o grafi di dipendenze per determinare quali test rieseguire.
Dai priorità ai moduli che interagiscono con il codice modificato, condividono strutture dati comuni o hanno già fallito dopo aggiornamenti simili.
2. Costruisci una suite di test bilanciata
Sviluppa una suite che copra a fondo i workflow critici di business, i processi dati essenziali e i percorsi utente più comuni.
Assicurati che ogni test abbia uno scopo e un perimetro specifici, cercando di evitare ridondanze o sovrapposizioni.
Test modulari e riutilizzabili semplificano la manutenzione man mano che il sistema evolve.
3. Usa un approccio a checklist
Una checklist strutturata aiuta a garantire coerenza e completezza sia nei test di regressione manuali che in quelli automatizzati.
Riduce le sviste, standardizza l’esecuzione e promuove processi di quality assurance ripetibili.
|
Passo
|
Scopo
|
|
Definisci le precondizioni
|
Stabilisci lo stato del sistema e i dati di input
|
|
Esegui il caso di test
|
Esegui il test in condizioni controllate
|
|
Verifica gli esiti
|
Valida sia l’output atteso sia gli effetti collaterali
|
|
Registra i risultati
|
Documenta successi, fallimenti e anomalie
|
Questo metodo fornisce struttura, trasparenza e accountability, particolarmente utile per inserire nuovi QA engineer.
4. Decidi cosa automatizzare
Non tutti i test dovrebbero essere automatizzati.
Automatizza i test stabili, ripetibili e ad alta frequenza, inclusi quelli che validano workflow mission-critical o aree aggiornate spesso.
Mantieni manuali i test esplorativi e di usabilità, dove il giudizio umano aggiunge valore.
|
Automatizza quando:
|
Mantieni manuale quando:
|
|
Gli scenari sono ripetitivi e stabili
|
Gli scenari richiedono interpretazione umana
|
|
I dati di test sono prevedibili
|
Si valuta l’esperienza utente o il comportamento della UI
|
|
I test girano spesso via CI/CD
|
Si eseguono test una tantum o esplorativi
|
5. Integra con CI/CD
Integrare il regression testing nelle pipeline CI/CD assicura che ogni modifica venga verificata automaticamente.
Configura le build in modo che falliscano se i test di regressione rilevano nuovi problemi, genera report per il triage immediato e adotta la filosofia “testare presto, testare spesso”.
Questo approccio impedisce l’accumulo di regressioni e abilita una vera cultura della qualità continua.
|
Beneficio dell’integrazione CI/CD
|
Risultato
|
|
Verifica automatica dopo ogni commit
|
Rilevamento precoce delle regressioni
|
|
Avvisi di build fallita
|
Triage rapido del codice problematico
|
|
Ciclo di feedback continuo
|
Qualità coerente attraverso iterazioni rapide
|
Strumenti per il regression testing
Una gamma di strumenti moderni supporta un regression testing efficiente e scalabile.
Lo strumento giusto dipende dallo stack tecnologico del progetto, dagli obiettivi di automazione e dal livello di maturità del team.
Di seguito alcune opzioni ampiamente adottate che semplificano e accelerano i workflow di regressione.
Katalon Studio
Katalon Studio è una piattaforma completa di automazione dei test che supporta test web, API, mobile e desktop.
Ha un’interfaccia grafica intuitiva e solide capacità di scripting. Per questo è utilizzata dai team che passano dal testing manuale alla regressione automatizzata.
Katalon offre test basati su keyword e sui dati integrati, riconoscimento intelligente degli oggetti e dashboard di reportistica dettagliati.
Uno dei suoi maggiori vantaggi è l’accessibilità: i tester senza una profonda esperienza di programmazione possono progettare visivamente casi di test complessi, mentre gli utenti avanzati possono personalizzare il comportamento usando Groovy o JavaScript.
La piattaforma si integra perfettamente con sistemi CI/CD come Jenkins e GitLab, abilitando esecuzioni automatizzate di regressione a ogni build.
Cypress
Cypress è un framework di end-to-end testing veloce e developer-friendly, progettato per le applicazioni web moderne. A differenza dei tradizionali strumenti basati su Selenium, Cypress gira direttamente nel browser, permettendogli di osservare, controllare e fare debug del comportamento web in tempo reale.
Questa architettura offre feedback immediato, live reloading ed esecuzione dei test altamente affidabile, senza l’instabilità che talvolta affligge l’automazione del browser.
È ideale per i team che già usano framework come React, Angular o Vue, poiché la sintassi in JavaScript si integra naturalmente nei workflow di sviluppo front-end.
Cypress fornisce anche ricchi strumenti di debug, attese automatiche e log di test dettagliati con screenshot e video, perfetti per diagnosticare rapidamente le regressioni.
Testsigma
Testsigma offre una piattaforma moderna di automazione dei test basata sul cloud che utilizza il natural language processing (NLP) per scrivere casi di test in inglese naturale.
Questo approccio riduce drasticamente la barriera d’ingresso, consentendo a membri non tecnici del team, come QA analyst o product owner, di contribuire direttamente alla suite di test di regressione.
Supporta test web, mobile, API e desktop in un ambiente unificato, aiutando i team Agile a raggiungere un’ampia copertura senza un pesante carico di coding.
Testsigma scala facilmente su browser, sistemi operativi e dispositivi, particolarmente utile per i team che gestiscono molteplici target di deployment.
Si integra senza soluzione di continuità con i più diffusi strumenti DevOps e pipeline CI/CD, offrendo esecuzione in tempo reale, test in parallelo e manutenzione dei test assistita dall’AI.
Strumenti aggiuntivi
Oltre a queste piattaforme leader, altri strumenti specializzati possono integrare i workflow di regression testing.
Selenium rimane un’opzione open-source fondamentale per l’automazione del browser, in particolare per i team a loro agio con framework e script personalizzati. Playwright, sviluppato da Microsoft, offre capacità simili con esecuzione più veloce e maggiore supporto cross-browser.
Per i test mobile, strumenti come Appium estendono l’automazione a piattaforme iOS e Android tramite un’API unificata.
Questi strumenti formano un ecosistema robusto per il regression testing. Ognuno supporta l’integrazione con pipeline CI/CD, sistemi di controllo versione e infrastrutture cloud.
Sfide comuni nel regression testing
Il regression testing è importante, ma presenta delle difficoltà.
Con l’evoluzione dei sistemi e la crescita delle suite di test, mantenere velocità, affidabilità e accuratezza diventa sempre più complesso.
Capire le sfide comuni e come affrontarle aiuta i team a sostenere nel tempo pratiche di regressione efficienti e ad alto impatto.
L’immagine seguente mostra alcune delle sfide comuni nel regression testing.
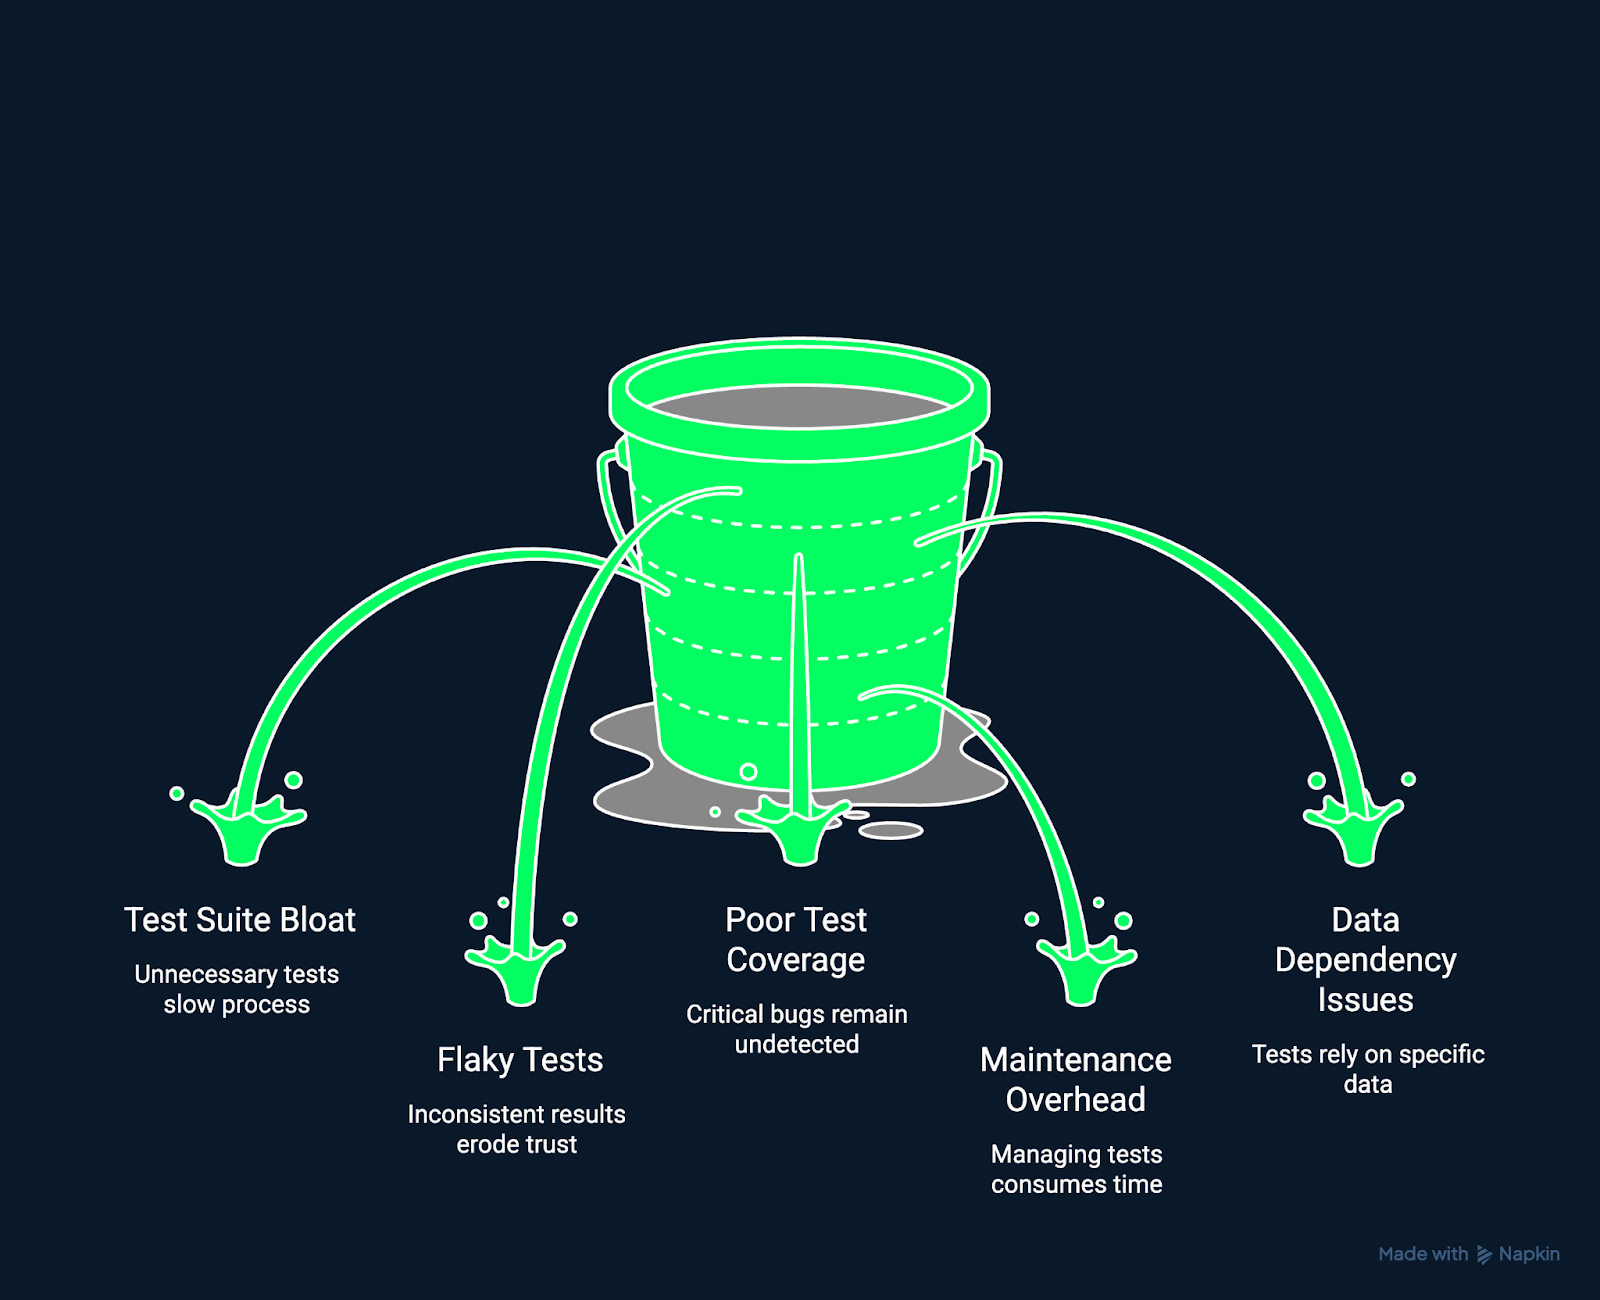
Sfide nel regression testing. Immagine dell’autore realizzata con Napkin AI.
Gonfiore della suite di test
Con l’evoluzione dei progetti, i casi di test possono accumularsi più velocemente di quanto vengano revisionati. Questo porta a suite gonfie, più lente da eseguire e contenenti test ridondanti o obsoleti. Suite troppo grandi rallentano i cicli di feedback e riducono l’efficienza del testing.
La soluzione è revisionare e rifattorizzare regolarmente la suite di test. Rimuovi test obsoleti o duplicati, consolida scenari sovrapposti e archivia i casi storici che non si applicano più.
Test instabili (flaky)
Test che falliscono in modo casuale possono frustrare gli sviluppatori. I test “flaky”, che passano o falliscono in modo incoerente, possono derivare da operazioni asincrone o ambienti instabili. Riducendo la fiducia nel sistema di test, oscurano le vere regressioni.
La soluzione è stabilizzare gli ambienti di test, usare dati mock invece di chiamate live e aggiungere attese esplicite o sincronizzazione quando necessario. Traccia e isola i test flaky finché non vengono corretti, per preservare la fiducia nei risultati dell’automazione.
Copertura di test insufficiente
Anche con test estesi, percorsi critici possono restare non testati a causa della pressione del tempo o di ownership poco chiara. Una copertura insufficiente consente alle regressioni di passare inosservate.
La soluzione è utilizzare strumenti di code coverage e test analytics per identificare le aree non testate. Concentrati prima sulla copertura dei moduli ad alto rischio e impatto e assicurati che le nuove funzionalità includano test di regressione fin dall’inizio.
Sovraccarico di manutenzione
I test di regressione automatizzati possono diventare fragili, rompendosi anche dopo piccoli aggiornamenti alla UI o alle API. Costi di manutenzione elevati scoraggiano il testing continuo e rallentano la delivery.
La soluzione è progettare test modulari e riutilizzabili e usare locator di elementi o contratti API robusti. Implementa layer di astrazione tra test e logica applicativa per minimizzare le riscritture dopo gli aggiornamenti.
Problemi di dipendenza dai dati
Test che si basano su fonti dati live o mutevoli possono produrre risultati incoerenti, rendendo difficile distinguere tra veri fallimenti e rumore ambientale.
La soluzione è usare dati di test controllati o servizi mock per garantire esiti prevedibili e riproducibili. Versiona e documenta i tuoi dati di test per la coerenza tra ambienti.
|
Sfida
|
Descrizione
|
Strategia di mitigazione
|
|
Gonfiore della suite di test
|
I casi di test si accumulano nel tempo, rallentando l’esecuzione
|
Rifattorizza regolarmente e rimuovi test ridondanti
|
|
Test instabili (flaky)
|
I test falliscono a intermittenza per timing, dipendenze o inconsistenze ambientali
|
Rifattorizza regolarmente e rimuovi test ridondanti
|
|
Copertura insufficiente
|
Alcuni percorsi critici non sono testati per sviste o mancanza di tempo
|
Usa strumenti di code coverage per individuare i gap
|
|
Sovraccarico di manutenzione
|
I test automatici si rompono dopo piccoli cambiamenti a UI o API
|
Usa design modulare dei test e selector robusti
|
|
Problemi di dipendenza dai dati
|
I test dipendono da fonti dati live o variabili
|
Usa fixture, mock o dataset sintetici
|
Se vuoi rafforzare la tua comprensione della validazione statistica e del testing analitico, prova il nostro corso Hypothesis Testing in Python.
Best practice e strategie per un regression testing efficace
Un solido regression testing significa tanto eseguire test quanto costruire un framework sostenibile per la qualità continua.
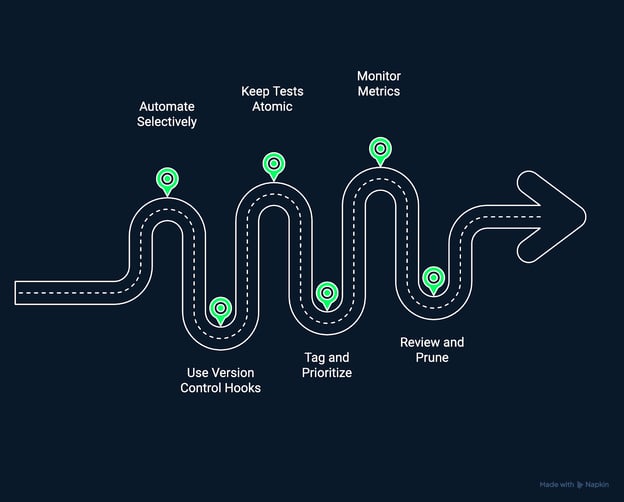
Best practice per un regression testing efficace. Immagine dell’autore realizzata con Napkin AI.
Automatizza presto, ma in modo selettivo
L’automazione amplifica la potenza dei test, ma non tutto deve essere automatizzato. Inizia automatizzando i test stabili e ad alto valore che validano i workflow core. Evita di automatizzare aree volatili finché la funzionalità non si stabilizza, per ridurre l’onere di manutenzione.
Usa hook del controllo versione
Integra il regression testing direttamente nel tuo sistema di controllo versione. Attiva esecuzioni automatiche dei test su pull request o merge per rilevare le regressioni prima che le modifiche entrino nei branch principali. Questo crea un approccio di testing proattivo e preventivo.
Mantieni i test atomici e indipendenti
Ogni test dovrebbe validare un singolo comportamento in isolamento. I test atomici semplificano la diagnosi dei fallimenti e riducono gli effetti a cascata quando un componente fallisce. Test indipendenti possono anche essere eseguiti in parallelo, accelerando i cicli di feedback della CI/CD.
Usa tagging e prioritizzazione dei test
Tagga i test in base alla criticità, per esempio “smoke”, “regression” o “performance”. Esegui i test ad alto impatto a ogni commit, mentre le suite più ampie possono girare di notte o prima del rilascio. La prioritizzazione assicura che il testing sia allineato ai vincoli di tempo e al rischio di business.
Monitora le metriche dei test
Quantifica nel tempo le prestazioni del testing. Traccia metriche come tasso di fallimento, durata dell’esecuzione e andamento della copertura per individuare colli di bottiglia e opportunità di miglioramento. La misurazione continua mantiene il regression testing agile e responsabile.
Rivedi e pota regolarmente
Le suite di test di regressione sono sistemi viventi. Nel tempo, rimuovi i test obsoleti, aggiorna le aspettative e aggiusta le priorità. Una suite snella e pertinente fornisce insight più rapidi e accurati con meno rumore.
|
Pratica
|
Scopo
|
Esempio o risultato
|
|
Automatizza presto, ma selettivamente
|
Concentra lo sforzo su test stabili e ad alto valore
|
Riduci il carico di manutenzione
|
|
Usa hook del controllo versione
|
Rileva le regressioni prima del merge del codice
|
Esegui i test automaticamente sulle pull request
|
|
Mantieni i test atomici e indipendenti
|
Semplifica il debugging e abilita esecuzioni in parallelo
|
Ogni test valida un comportamento specifico
|
|
Usa tagging e prioritizzazione
|
Allocare in modo efficiente le risorse di test
|
I test critici girano a ogni commit
|
|
Monitora le metriche dei test
|
Tracciare salute ed efficienza della suite
|
Individua aree lente o instabili
|
|
Rivedi e pota regolarmente
|
Mantieni la suite veloce e pertinente
|
Rimuovi casi obsoleti o ridondanti
|
Queste pratiche insieme costituiscono le basi di una sana cultura di regression testing, che dà priorità a velocità, affidabilità e manutenibilità a lungo termine.
Per rafforzare la tua capacità di scrivere codice manutenibile e testabile, dai un’occhiata al nostro corso Software Engineering Principles in Python.
Conclusione
Ricorda che, man mano che i sistemi software evolvono e crescono in complessità, il regression testing diventa una salvaguardia essenziale per mantenere stabilità e fiducia degli utenti. Ogni modifica al codice, per quanto piccola, introduce un rischio potenziale. Una forte strategia di regression testing può aiutarti a rilasciare aggiornamenti con fiducia e muoverti velocemente senza rompere il software su cui contano i tuoi utenti.
Per continuare a costruire la tua competenza nel software testing, esplora il nostro corso Introduction to Testing in Python. Se vuoi integrare strategie di testing robuste nelle pipeline di deployment moderne, dai un’occhiata al corso CI/CD for Machine Learning.








Nel corso degli anni ho imparato che anche la modifica di codice più piccola può avere conseguenze inaspettate. Quello che all’inizio sembra un cambiamento minimo può, senza far rumore, rompere qualcosa che funzionava perfettamente.
Per questo i test di regressione sono importanti. Sono, in sostanza, una rete di sicurezza che assicura che il progresso non avvenga a scapito della stabilità.
Nella mia esperienza con progetti data-driven, in cui modelli, API e pipeline evolvono costantemente, i test di regressione sono stati fondamentali per mantenere output coerenti e affidabili.
Senza di essi, anche piccoli aggiustamenti come ritoccare una funzione di trasformazione o aggiornare un pacchetto possono innescare comportamenti inaspettati difficili da rintracciare.
Se sei alle prime armi con Python o vuoi ripassare le basi prima di approfondire il testing, da un’occhiata al nostro skill track Python Programming.
Che cos’è il regression testing?
In breve, il regression testing significa ri-testare funzionalità esistenti dopo modifiche al codice per confermare che nulla sia “regredito” a uno stato non funzionante.
Anche se la parola “regressione” può sembrare matematica, nel testing indica in realtà “un passo indietro”.
Ogni volta che modifichi il codice (che si tratti di correggere un bug o aggiungere una funzionalità), c’è la possibilità che la novità rompa componenti che prima funzionavano, ed è per questo che servono i test di regressione.
Il regression testing risponde alla seguente domanda cruciale:
Dopo questa modifica, tutto ciò che prima funzionava funziona ancora?
A differenza dei test unitari, che validano componenti isolati, o dei test di integrazione, che verificano come i moduli lavorano insieme, il regression testing adotta una prospettiva più ampia e di lungo periodo.
Garantisce che il tuo software resti stabile e coerente release dopo release, anche mentre evolve.
Esempi di regression testing. Immagine dell’autore realizzata con Napkin AI.
Per esempio:
Negli ambienti di sviluppo continui (soprattutto Agile e DevOps), il regression testing agisce come una rete di sicurezza che ti permette di iterare rapidamente senza sacrificare la stabilità.
Supporta la fiducia necessaria per deployment frequenti, workflow automatizzati e pratiche di integrazione continua.
Perché il regression testing è utile
Il regression testing è uno dei modi più affidabili per garantire che la qualità del software resti costante mentre il sistema evolve. Aiuta a rilevare e prevenire presto questi effetti a catena, salvaguardando stabilità e fiducia degli utenti.
Proteggiti da nuovi bug
Il codice nuovo spesso porta con sé effetti collaterali involontari. Un semplice refactoring o l’aggiornamento di una dipendenza può rompere funzionalità in moduli lontani.
Il regression testing aiuta a identificare questi problemi prima che incidano sulla produzione o sugli utenti. Suite di regressione automatizzate possono essere eseguite dopo ogni push di codice, mettendo in evidenza conflitti tra la nuova logica e quella legacy. Questo feedback precoce ti fa risparmiare tempo, riduce il carico di debugging e mantiene alta la fiducia nello sviluppo.
Nei team Agile o DevOps in rapida evoluzione, l’automazione della regressione funge da guardrail che consente agli sviluppatori di innovare senza la paura di rompere funzionalità consolidate.
Vantaggio
Descrizione
Esempio
Rilevamento precoce
Identifica i bug subito dopo i nuovi commit
Una nuova route API interrompe una richiesta client esistente
Debug più rapido
Individua esattamente dove fallisce la nuova logica
I report della CI collegano i test falliti a moduli specifici
Fiducia degli sviluppatori
Favorisce release frequenti e sicure
I team distribuiscono continuamente senza controlli manuali
Impedisci il ritorno dei difetti
Uno dei problemi più frustranti nella manutenzione software è vedere tornare un vecchio bug.
I test di regressione agiscono come salvaguardie permanenti (cioè, una volta corretto un bug, il relativo test assicura che resti risolto e non si ripresenti).
Col tempo, questo crea una rete di sicurezza basata sulla storia dei bug del tuo progetto.
Integrare questa pratica nel tuo workflow significa che la suite di test valida non solo le nuove funzionalità, ma anche ogni fix implementato in passato.
Prima dei test di regressione
Dopo i test di regressione
Vecchi bug riappaiono in modo imprevedibile
I problemi corretti restano verificati in modo permanente
Le correzioni si basano su memoria o documentazione
I test confermano automaticamente i fix precedenti
I team QA ripetono controlli manuali
Guardie automatizzate evitano recidive
Mantieni la fiducia degli utenti
L’affidabilità non è negoziabile, soprattutto dal punto di vista dell’utente. Funzionalità che un giorno funzionano e il giorno dopo no minano fiducia e soddisfazione.
Il regression testing assicura un’esperienza coerente tra gli aggiornamenti, rafforzando la fiducia nel tuo prodotto.
Nelle applicazioni data-driven, questa affidabilità significa mantenere risultati coerenti e comportamenti prevedibili, anche mentre modelli, fonti dati e API evolvono.
Area applicativa
Cosa protegge il regression testing
Dashboard
Garantisce che le visualizzazioni si rendano correttamente dopo aggiornamenti del backend o dello schema dei dati
API dei modelli
Verifica che le predizioni dei modelli restino stabili e riproducibili
Data pipeline
Conferma che gli export dei dati preservino coerenza di schema e formato
Mitiga il rischio
Il regression testing è anche una parte cruciale della gestione del rischio. Senza di esso, bug inattesi possono sfuggire nelle fasi finali del ciclo di rilascio, causando outage o costosi rollback.
Verificare la stabilità a ogni iterazione aiuta il team a rilasciare con fiducia, sapendo che le modifiche non hanno compromesso le funzionalità.
Con regression testing
Senza regression testing
Rilasci prevedibili e a basso rischio
Bug e rollback dell’ultimo minuto frequenti
Pipeline CI/CD affidabili
Deployment esitanti, colli di bottiglia nel QA manuale
Assicurazione qualità continua
“Spegnere incendi” dopo il rilascio
Tipi e tecniche di regression testing
Il regression testing non è uguale per tutti. L’approccio giusto dipende da fattori come dimensione del codebase, frequenza dei cambiamenti e impatto sul business.
Ognuno dei metodi seguenti bilancia in modo diverso velocità, copertura e costi di risorse.
1. Retest all
La forma più semplice di regression testing consiste nell’eseguire tutti i test esistenti dopo una modifica.
Pur assicurando di non tralasciare nulla, diventa via via meno praticabile man mano che i sistemi crescono.
Perciò questo approccio è spesso usato nelle prime fasi di vita di un progetto o quando si valida un refactoring importante.
2. Regression testing selettivo
La regressione selettiva prende di mira solo le aree direttamente interessate dalle modifiche recenti.
Utilizza analisi d’impatto per determinare le dipendenze e limitare il perimetro dei test.
Per esempio, se cambia un modulo di trasformazione dati, potrebbe non essere necessario rieseguire i test correlati ad autenticazione o rendering della UI.
Questo approccio bilancia precisione e velocità e si basa su un buon tracciamento delle dipendenze.
3. Regression testing prioritizzato
Nei sistemi di grandi dimensioni, tempo e risorse raramente consentono una copertura completa della regressione.
Il regression testing prioritizzato ordina i casi di test per importanza e livello di rischio, assicurando che i percorsi critici (come pagamenti o autenticazione) siano verificati per primi.
I test a priorità più bassa possono essere eseguiti in seguito o in modo asincrono.
La tabella seguente riporta i tipici livelli di priorità, con esempi delle aree coperte e del relativo focus di test.
Livello di priorità
Area di esempio
Focus dei test
Alta
Elaborazione pagamenti, autenticazione
Non deve mai fallire ed è testata per prima
Media
Visual della dashboard, notifiche email
Dovrebbe funzionare in modo coerente
Bassa
Aggiustamenti di layout, tooltip
Cosmetici e meno critici nei cicli rapidi
4. L’imperativo dell’automazione
Il regression testing manuale diventa rapidamente insostenibile man mano che i progetti scalano.
L’automazione, invece, trasforma il regression testing da un passaggio lento a un modo per lavorare più velocemente e con più fiducia.
Suite automatizzate vengono eseguite a ogni build o pull request, forniscono feedback immediato e si integrano con strumenti CI come Jenkins, GitHub Actions o GitLab CI/CD.
Consentono una verifica continua tra ambienti, una capacità essenziale per i team Agile e DevOps che puntano a “muoversi in fretta senza rompere le cose”.
Vantaggio dell’automazione
Impatto sullo sviluppo
Feedback continuo
Identificazione più rapida delle modifiche che rompono
Esecuzione coerente
Elimina l’errore umano nei test ripetitivi
Scalabilità
I test girano in parallelo su più ambienti
Pronta per l’integrazione
Si integra direttamente nei workflow CI/CD
La tabella seguente fornisce una panoramica rapida delle principali tecniche di regression testing trattate sopra.
Tipo
Descrizione
Pro
Contro
Ideale per
Retest-all
Esegue tutti i casi di test dopo ogni modifica
Copertura completa e validazione approfondita
Molto dispendioso in tempo e costi elevati
Sistemi piccoli e test di base
Regression selettiva
Testa solo i componenti interessati dalle modifiche al codice
Efficiente e con feedback più rapido
Richiede mappatura accurata delle dipendenze
Sistemi modulari e release frequenti
Regression prioritaria
Esegue test ordinati per impatto sul business
Si concentra prima sulle funzionalità critiche
Potrebbe tralasciare aree meno critiche ma rilevanti
Cicli di test a tempo limitato
Regression automatizzata
Gira automaticamente via CI/CD dopo i commit
Veloce, scalabile, ripetibile
Richiede setup e manutenzione
Progetti grandi o in rapida evoluzione
Creare e mantenere una suite di regressione
Creare una suite di regressione è un investimento continuo nella qualità del software.
Col tempo, diventa uno degli asset più preziosi del tuo processo di sviluppo.
L’immagine seguente mostra i passaggi per costruire e mantenere una suite di regressione.
Creare e mantenere una suite di regressione. Immagine dell’autore realizzata con Napkin AI.
1. Parti dall’analisi d’impatto
Inizia comprendendo quali parti del sistema sono interessate da una modifica.
È una buona idea usare strumenti come analizzatori di code coverage o grafi di dipendenze per determinare quali test rieseguire.
Dai priorità ai moduli che interagiscono con il codice modificato, condividono strutture dati comuni o hanno già fallito dopo aggiornamenti simili.
2. Costruisci una suite di test bilanciata
Sviluppa una suite che copra a fondo i workflow critici di business, i processi dati essenziali e i percorsi utente più comuni.
Assicurati che ogni test abbia uno scopo e un perimetro specifici, cercando di evitare ridondanze o sovrapposizioni.
Test modulari e riutilizzabili semplificano la manutenzione man mano che il sistema evolve.
3. Usa un approccio a checklist
Una checklist strutturata aiuta a garantire coerenza e completezza sia nei test di regressione manuali che in quelli automatizzati.
Riduce le sviste, standardizza l’esecuzione e promuove processi di quality assurance ripetibili.
Passo
Scopo
Definisci le precondizioni
Stabilisci lo stato del sistema e i dati di input
Esegui il caso di test
Esegui il test in condizioni controllate
Verifica gli esiti
Valida sia l’output atteso sia gli effetti collaterali
Registra i risultati
Documenta successi, fallimenti e anomalie
Questo metodo fornisce struttura, trasparenza e accountability, particolarmente utile per inserire nuovi QA engineer.
4. Decidi cosa automatizzare
Non tutti i test dovrebbero essere automatizzati.
Automatizza i test stabili, ripetibili e ad alta frequenza, inclusi quelli che validano workflow mission-critical o aree aggiornate spesso.
Mantieni manuali i test esplorativi e di usabilità, dove il giudizio umano aggiunge valore.
Automatizza quando:
Mantieni manuale quando:
Gli scenari sono ripetitivi e stabili
Gli scenari richiedono interpretazione umana
I dati di test sono prevedibili
Si valuta l’esperienza utente o il comportamento della UI
I test girano spesso via CI/CD
Si eseguono test una tantum o esplorativi
5. Integra con CI/CD
Integrare il regression testing nelle pipeline CI/CD assicura che ogni modifica venga verificata automaticamente.
Configura le build in modo che falliscano se i test di regressione rilevano nuovi problemi, genera report per il triage immediato e adotta la filosofia “testare presto, testare spesso”.
Questo approccio impedisce l’accumulo di regressioni e abilita una vera cultura della qualità continua.
Beneficio dell’integrazione CI/CD
Risultato
Verifica automatica dopo ogni commit
Rilevamento precoce delle regressioni
Avvisi di build fallita
Triage rapido del codice problematico
Ciclo di feedback continuo
Qualità coerente attraverso iterazioni rapide
Strumenti per il regression testing
Una gamma di strumenti moderni supporta un regression testing efficiente e scalabile.
Lo strumento giusto dipende dallo stack tecnologico del progetto, dagli obiettivi di automazione e dal livello di maturità del team.
Di seguito alcune opzioni ampiamente adottate che semplificano e accelerano i workflow di regressione.
Katalon Studio
Katalon Studio è una piattaforma completa di automazione dei test che supporta test web, API, mobile e desktop.
Ha un’interfaccia grafica intuitiva e solide capacità di scripting. Per questo è utilizzata dai team che passano dal testing manuale alla regressione automatizzata.
Katalon offre test basati su keyword e sui dati integrati, riconoscimento intelligente degli oggetti e dashboard di reportistica dettagliati.
Uno dei suoi maggiori vantaggi è l’accessibilità: i tester senza una profonda esperienza di programmazione possono progettare visivamente casi di test complessi, mentre gli utenti avanzati possono personalizzare il comportamento usando Groovy o JavaScript.
La piattaforma si integra perfettamente con sistemi CI/CD come Jenkins e GitLab, abilitando esecuzioni automatizzate di regressione a ogni build.
Cypress
Cypress è un framework di end-to-end testing veloce e developer-friendly, progettato per le applicazioni web moderne. A differenza dei tradizionali strumenti basati su Selenium, Cypress gira direttamente nel browser, permettendogli di osservare, controllare e fare debug del comportamento web in tempo reale.
Questa architettura offre feedback immediato, live reloading ed esecuzione dei test altamente affidabile, senza l’instabilità che talvolta affligge l’automazione del browser.
È ideale per i team che già usano framework come React, Angular o Vue, poiché la sintassi in JavaScript si integra naturalmente nei workflow di sviluppo front-end.
Cypress fornisce anche ricchi strumenti di debug, attese automatiche e log di test dettagliati con screenshot e video, perfetti per diagnosticare rapidamente le regressioni.
Testsigma
Testsigma offre una piattaforma moderna di automazione dei test basata sul cloud che utilizza il natural language processing (NLP) per scrivere casi di test in inglese naturale.
Questo approccio riduce drasticamente la barriera d’ingresso, consentendo a membri non tecnici del team, come QA analyst o product owner, di contribuire direttamente alla suite di test di regressione.
Supporta test web, mobile, API e desktop in un ambiente unificato, aiutando i team Agile a raggiungere un’ampia copertura senza un pesante carico di coding.
Testsigma scala facilmente su browser, sistemi operativi e dispositivi, particolarmente utile per i team che gestiscono molteplici target di deployment.
Si integra senza soluzione di continuità con i più diffusi strumenti DevOps e pipeline CI/CD, offrendo esecuzione in tempo reale, test in parallelo e manutenzione dei test assistita dall’AI.
Strumenti aggiuntivi
Oltre a queste piattaforme leader, altri strumenti specializzati possono integrare i workflow di regression testing.
Selenium rimane un’opzione open-source fondamentale per l’automazione del browser, in particolare per i team a loro agio con framework e script personalizzati. Playwright, sviluppato da Microsoft, offre capacità simili con esecuzione più veloce e maggiore supporto cross-browser.
Per i test mobile, strumenti come Appium estendono l’automazione a piattaforme iOS e Android tramite un’API unificata.
Questi strumenti formano un ecosistema robusto per il regression testing. Ognuno supporta l’integrazione con pipeline CI/CD, sistemi di controllo versione e infrastrutture cloud.
Sfide comuni nel regression testing
Il regression testing è importante, ma presenta delle difficoltà.
Con l’evoluzione dei sistemi e la crescita delle suite di test, mantenere velocità, affidabilità e accuratezza diventa sempre più complesso.
Capire le sfide comuni e come affrontarle aiuta i team a sostenere nel tempo pratiche di regressione efficienti e ad alto impatto.
L’immagine seguente mostra alcune delle sfide comuni nel regression testing.
Sfide nel regression testing. Immagine dell’autore realizzata con Napkin AI.
Gonfiore della suite di test
Con l’evoluzione dei progetti, i casi di test possono accumularsi più velocemente di quanto vengano revisionati. Questo porta a suite gonfie, più lente da eseguire e contenenti test ridondanti o obsoleti. Suite troppo grandi rallentano i cicli di feedback e riducono l’efficienza del testing.
La soluzione è revisionare e rifattorizzare regolarmente la suite di test. Rimuovi test obsoleti o duplicati, consolida scenari sovrapposti e archivia i casi storici che non si applicano più.
Test instabili (flaky)
Test che falliscono in modo casuale possono frustrare gli sviluppatori. I test “flaky”, che passano o falliscono in modo incoerente, possono derivare da operazioni asincrone o ambienti instabili. Riducendo la fiducia nel sistema di test, oscurano le vere regressioni.
La soluzione è stabilizzare gli ambienti di test, usare dati mock invece di chiamate live e aggiungere attese esplicite o sincronizzazione quando necessario. Traccia e isola i test flaky finché non vengono corretti, per preservare la fiducia nei risultati dell’automazione.
Copertura di test insufficiente
Anche con test estesi, percorsi critici possono restare non testati a causa della pressione del tempo o di ownership poco chiara. Una copertura insufficiente consente alle regressioni di passare inosservate.
La soluzione è utilizzare strumenti di code coverage e test analytics per identificare le aree non testate. Concentrati prima sulla copertura dei moduli ad alto rischio e impatto e assicurati che le nuove funzionalità includano test di regressione fin dall’inizio.
Sovraccarico di manutenzione
I test di regressione automatizzati possono diventare fragili, rompendosi anche dopo piccoli aggiornamenti alla UI o alle API. Costi di manutenzione elevati scoraggiano il testing continuo e rallentano la delivery.
La soluzione è progettare test modulari e riutilizzabili e usare locator di elementi o contratti API robusti. Implementa layer di astrazione tra test e logica applicativa per minimizzare le riscritture dopo gli aggiornamenti.
Problemi di dipendenza dai dati
Test che si basano su fonti dati live o mutevoli possono produrre risultati incoerenti, rendendo difficile distinguere tra veri fallimenti e rumore ambientale.
La soluzione è usare dati di test controllati o servizi mock per garantire esiti prevedibili e riproducibili. Versiona e documenta i tuoi dati di test per la coerenza tra ambienti.
Sfida
Descrizione
Strategia di mitigazione
Gonfiore della suite di test
I casi di test si accumulano nel tempo, rallentando l’esecuzione
Rifattorizza regolarmente e rimuovi test ridondanti
Test instabili (flaky)
I test falliscono a intermittenza per timing, dipendenze o inconsistenze ambientali
Rifattorizza regolarmente e rimuovi test ridondanti
Copertura insufficiente
Alcuni percorsi critici non sono testati per sviste o mancanza di tempo
Usa strumenti di code coverage per individuare i gap
Sovraccarico di manutenzione
I test automatici si rompono dopo piccoli cambiamenti a UI o API
Usa design modulare dei test e selector robusti
Problemi di dipendenza dai dati
I test dipendono da fonti dati live o variabili
Usa fixture, mock o dataset sintetici
Se vuoi rafforzare la tua comprensione della validazione statistica e del testing analitico, prova il nostro corso Hypothesis Testing in Python.
Best practice e strategie per un regression testing efficace
Un solido regression testing significa tanto eseguire test quanto costruire un framework sostenibile per la qualità continua.
Best practice per un regression testing efficace. Immagine dell’autore realizzata con Napkin AI.
Automatizza presto, ma in modo selettivo
L’automazione amplifica la potenza dei test, ma non tutto deve essere automatizzato. Inizia automatizzando i test stabili e ad alto valore che validano i workflow core. Evita di automatizzare aree volatili finché la funzionalità non si stabilizza, per ridurre l’onere di manutenzione.
Usa hook del controllo versione
Integra il regression testing direttamente nel tuo sistema di controllo versione. Attiva esecuzioni automatiche dei test su pull request o merge per rilevare le regressioni prima che le modifiche entrino nei branch principali. Questo crea un approccio di testing proattivo e preventivo.
Mantieni i test atomici e indipendenti
Ogni test dovrebbe validare un singolo comportamento in isolamento. I test atomici semplificano la diagnosi dei fallimenti e riducono gli effetti a cascata quando un componente fallisce. Test indipendenti possono anche essere eseguiti in parallelo, accelerando i cicli di feedback della CI/CD.
Usa tagging e prioritizzazione dei test
Tagga i test in base alla criticità, per esempio “smoke”, “regression” o “performance”. Esegui i test ad alto impatto a ogni commit, mentre le suite più ampie possono girare di notte o prima del rilascio. La prioritizzazione assicura che il testing sia allineato ai vincoli di tempo e al rischio di business.
Monitora le metriche dei test
Quantifica nel tempo le prestazioni del testing. Traccia metriche come tasso di fallimento, durata dell’esecuzione e andamento della copertura per individuare colli di bottiglia e opportunità di miglioramento. La misurazione continua mantiene il regression testing agile e responsabile.
Rivedi e pota regolarmente
Le suite di test di regressione sono sistemi viventi. Nel tempo, rimuovi i test obsoleti, aggiorna le aspettative e aggiusta le priorità. Una suite snella e pertinente fornisce insight più rapidi e accurati con meno rumore.
Pratica
Scopo
Esempio o risultato
Automatizza presto, ma selettivamente
Concentra lo sforzo su test stabili e ad alto valore
Riduci il carico di manutenzione
Usa hook del controllo versione
Rileva le regressioni prima del merge del codice
Esegui i test automaticamente sulle pull request
Mantieni i test atomici e indipendenti
Semplifica il debugging e abilita esecuzioni in parallelo
Ogni test valida un comportamento specifico
Usa tagging e prioritizzazione
Allocare in modo efficiente le risorse di test
I test critici girano a ogni commit
Monitora le metriche dei test
Tracciare salute ed efficienza della suite
Individua aree lente o instabili
Rivedi e pota regolarmente
Mantieni la suite veloce e pertinente
Rimuovi casi obsoleti o ridondanti
Queste pratiche insieme costituiscono le basi di una sana cultura di regression testing, che dà priorità a velocità, affidabilità e manutenibilità a lungo termine.
Per rafforzare la tua capacità di scrivere codice manutenibile e testabile, dai un’occhiata al nostro corso Software Engineering Principles in Python.
Conclusione
Ricorda che, man mano che i sistemi software evolvono e crescono in complessità, il regression testing diventa una salvaguardia essenziale per mantenere stabilità e fiducia degli utenti. Ogni modifica al codice, per quanto piccola, introduce un rischio potenziale. Una forte strategia di regression testing può aiutarti a rilasciare aggiornamenti con fiducia e muoverti velocemente senza rompere il software su cui contano i tuoi utenti.
Per continuare a costruire la tua competenza nel software testing, esplora il nostro corso Introduction to Testing in Python. Se vuoi integrare strategie di testing robuste nelle pipeline di deployment moderne, dai un’occhiata al corso CI/CD for Machine Learning.