
Cursus
Introductie tot LLM’s in Python
3 uur
37K
Ben je ooit tegen geheugenproblemen aangelopen tijdens het fijn-afstemmen van modellen, of duurt het proces eindeloos voordat het klaar is? Als je op zoek bent naar een efficiëntere en snellere oplossing dan de Transformers-bibliotheek voor het fijn-afstemmen van large language models (LLM’s), dan ben je hier aan het juiste adres!
In deze tutorial verkennen we hoe je het Llama 3.1 3B-model kunt fijn-afstemmen met slechts 9 GB VRAM, met snelheden die 2x hoger liggen dan traditionele Transformers-methoden. We behandelen ook snelle inferentie, het converteren van het model naar vLLM-compatibele en GGUF-bestandsindelingen, en hoe je het opgeslagen model met slechts een paar regels code naadloos naar de Hugging Face Hub pusht.
Als deze concepten nieuw voor je zijn, volg dan zeker de cursus Master Large Language Models (LLMs) Concepts om een stevige basis te leggen voordat je in het fijn-afstemmen duikt.
Afbeelding door auteur
Unsloth AI is een Python-framework ontworpen voor snel fijn-afstemmen en het benaderen van large language models. Het biedt een eenvoudige API en levert prestaties die 2x sneller zijn dan Transformers.
De Llama-3.1-variant benaderen met Unsloth is vrij simpel. We laden niet het 16-bit model, maar de 4-bit versie die op Hugging Face beschikbaar is om GPU-geheugen te besparen en sneller te kunnen infereren.
%%capture
%pip install unslothFastLanguageModel. from transformers import TextStreamer
from unsloth import FastLanguageModel
model, tokenizer = FastLanguageModel.from_pretrained(
model_name = "unsloth/Meta-Llama-3.1-8B-bnb-4bit"
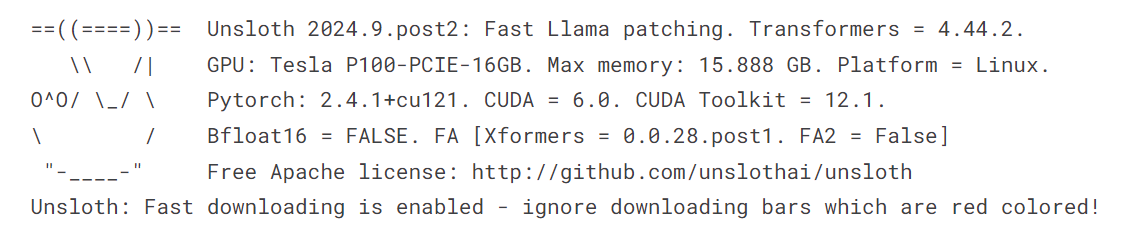
)
FastLanguageModel.for_inference(model)prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context. Write a response that appropriately completes the request.
### Instruction:
{}
### Input:
{}
### Response:
{}"""
inputs = tokenizer(
[
prompt_style.format(
"You are a professional machine learning engineer",
"How would you deal with NaN validation loss?",
"",
)
],
return_tensors="pt",
).to("cuda")
text_streamer = TextStreamer(tokenizer)
_ = model.generate(**inputs, streamer=text_streamer, max_new_tokens=128)
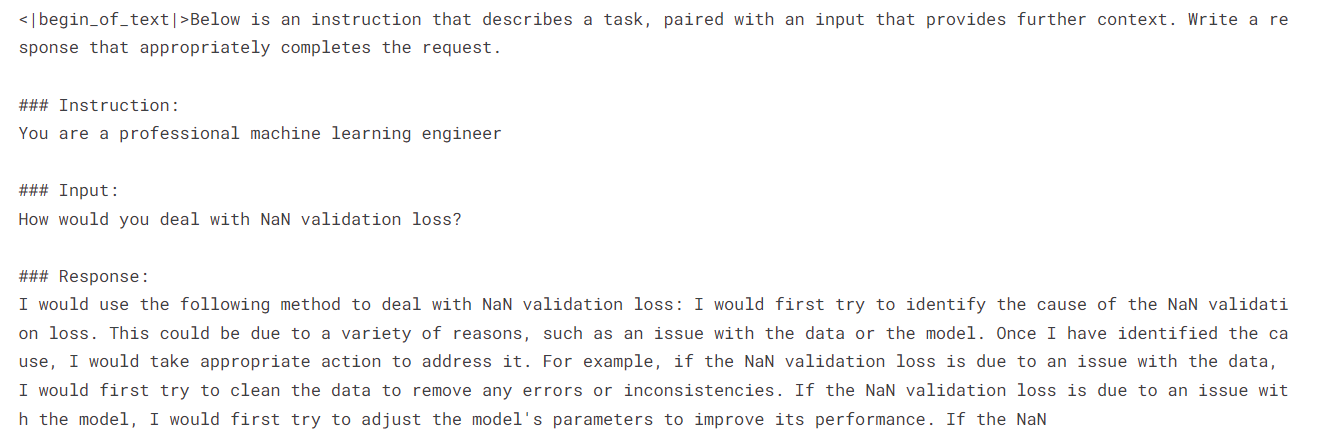
We kregen een bruikbaar antwoord over hoe je met NaN validation loss omgaat.
Heb je moeite om de bovenstaande code op Kaggle te draaien? Bekijk dan dit voorbeeldnotebook: LLM’s benaderen met Unsloth.
Door de cursus Introduction to LLMs in Python te volgen, leer je de basis van Transformer-architectuur: hoe je die bouwt, fijn-afstemt en evalueert. Dit is je toegangspoort tot LLM-fijn-afstemmen met Python.
In deze gids leren we hoe je Llama 3.1 fijn-afstemt op de lighteval/MATH-dataset met Unsloth. De dataset bestaat uit algebraproblemen met oplossingen in markdown-indeling. De hele dataset is in vijf moeilijkheidsniveaus verdeeld.
Om deze gids beter te begrijpen, raad ik aan de theorie achter elke stap van het fijn-afstemmen van LLM’s te leren via An Introductory Guide to Fine-Tuning LLMs. Neem een paar minuten om de gids door te nemen; dat helpt bij het begrijpen van dit proces.
We gebruiken een Kaggle-notebook als cloud-IDE en moeten het notebook instellen voordat we met het model of de data werken.
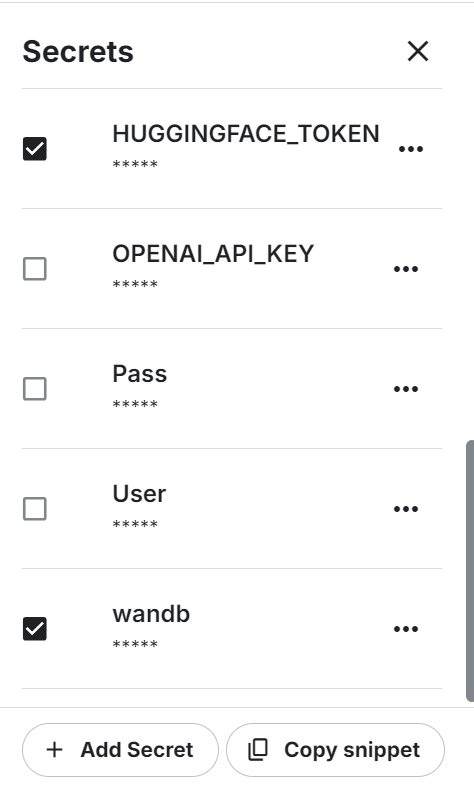
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(hf_token)import wandb
wb_token = user_secrets.get_secret("wandb")
wandb.login(key=wb_token)
run = wandb.init(
project='Fine-tune Llama-3.1-8B-bnb-4bit on Math Dataset',
job_type="training",
anonymous="allow"
)Net als in de model-inferentie-sectie laden we de 4-bit gequantiseerde versie van het Llama 3.1-model met een maximale sequentielengte van 2048 en None als data type.
from unsloth import FastLanguageModel
import torch

max_seq_length = 2048
dtype = None

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "unsloth/Meta-Llama-3.1-8B-bnb-4bit",
    max_seq_length = max_seq_length,
    dtype = dtype
)Vervolgens laden en verwerken we de dataset. Daarvoor maken we eerst een promptstijl die ons helpt de gewenste resultaten te krijgen.
De promptstijl bevat een system prompt, een instructie en een placeholder voor input en response.
prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context. Write a response that appropriately completes the request.

### Instruction:
You are a math genius who can solve any level of algebraic problems. Please answer the following math question.

### Input:
{}

### Response:
{}"""
Maak daarna de functie die de promptstijl gebruikt om de wiskundeproblemen en oplossingen in te voeren en om te zetten naar de juiste tekst. Voeg zeker EOS_TOKEN toe om herhaling te voorkomen.
EOS_TOKEN = tokenizer.eos_token # Must add EOS_TOKEN
def formatting_prompts_func(examples):
    inputs       = examples["problem"]
    outputs      = examples["solution"]
    texts = []
    for input, output in zip(inputs, outputs):
        text = prompt_style.format(input, output) + EOS_TOKEN
        texts.append(text)
    return { "text" : texts, }
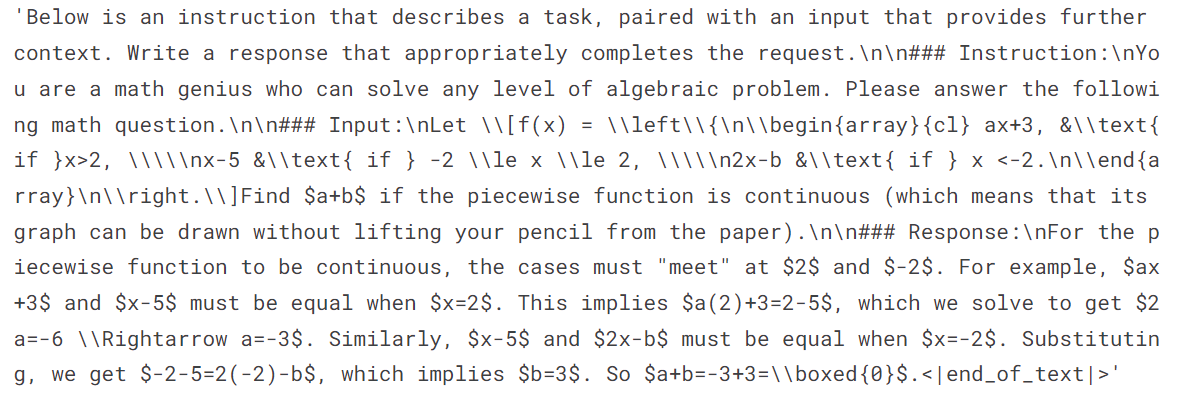
Laad 500 samples uit de dataset, pas de functie formatting_prompts_func toe op de dataset en bekijk het eerste sample uit de tekstkolom.
from datasets import load_dataset

dataset = load_dataset("lighteval/MATH", split="train[0:500]", trust_remote_code=True)
dataset = dataset.map(
    formatting_prompts_func,
    batched=True,
)
dataset["text"][0]
De tekst bevat een system prompt, een instructie, een algebravraag en de oplossing van dat probleem.
We voegen LoRA (Low-Rank Adapter) toe aan het model met behulp van de lineaire modules uit het basismodel.
model = FastLanguageModel.get_peft_model(
    model,
    r=16,
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],
    lora_alpha=16,
    lora_dropout=0,
    bias="none",

    use_gradient_checkpointing="unsloth",
    random_state=3407,
    use_rslora=False,
    loftq_config=None,
)
Stel de trainer in met het model, de tokenizer, de maximale sequentielengte en de trainingsargumenten. Dit lijkt sterk op het instellen van een trainer met de Transformers- en TRL-bibliotheek.
from trl import SFTTrainer
from transformers import TrainingArguments
from unsloth import is_bfloat16_supported

trainer = SFTTrainer(
    model = model,
    tokenizer = tokenizer,
    train_dataset = dataset,
    dataset_text_field = "text",
    max_seq_length = max_seq_length,
    dataset_num_proc = 2,
    args = TrainingArguments(
        per_device_train_batch_size = 2,
        gradient_accumulation_steps = 4,
        warmup_steps = 5,
        max_steps = 60,
        learning_rate = 2e-4,
        fp16 = not is_bfloat16_supported(),
        bf16 = is_bfloat16_supported(),
        logging_steps = 1,
        optim = "adamw_8bit",
        weight_decay = 0.01,
        lr_scheduler_type = "linear",
        seed = 3407,
        output_dir = "outputs",
    ),
)Het trainen van het model duurde bijna 19 minuten, wat indrukwekkend is. De training loss nam bij elke stap aanzienlijk af.
trainer_stats = trainer.train()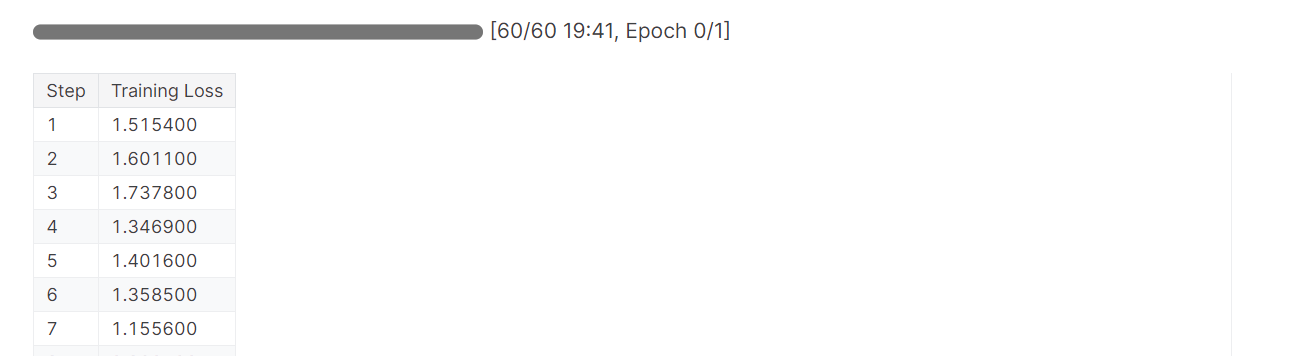
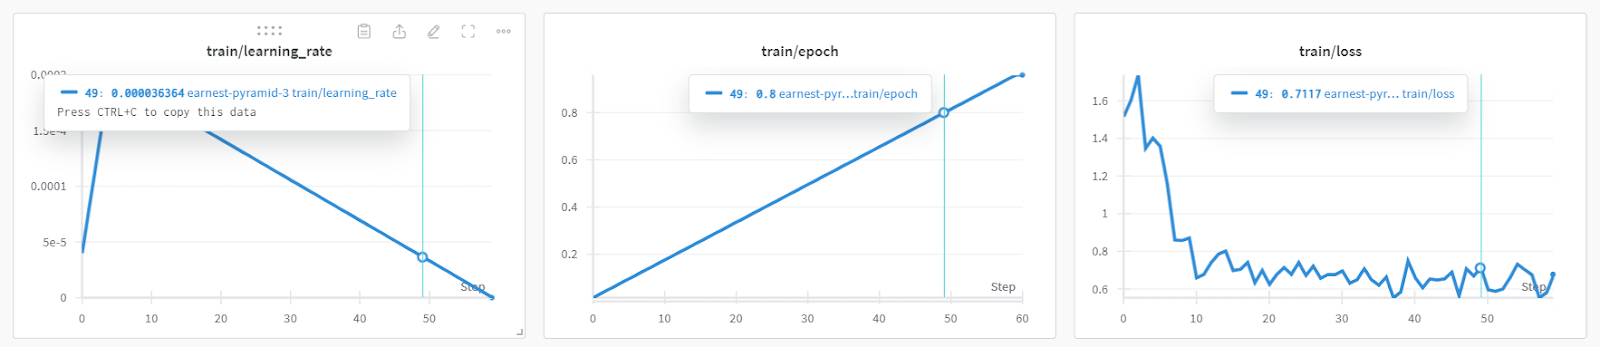
Gedetailleerde modelprestaties en hardwaremetrics kun je bekijken via het Weights & Biases-dashboard.
Je kunt ook torch en trainer_stats gebruiken om je eigen rapport te genereren.
used_memory = round(torch.cuda.max_memory_reserved() / 1024 / 1024 / 1024, 3)
used_memory_for_lora = round(used_memory - start_gpu_memory, 3)
used_percentage = round(used_memory         /max_memory*100, 3)
lora_percentage = round(used_memory_for_lora/max_memory*100, 3)
print(f"{trainer_stats.metrics['train_runtime']} seconds used for training.")
print(f"{round(trainer_stats.metrics['train_runtime']/60, 2)} minutes used for training.")
print(f"Peak reserved memory = {used_memory} GB.")
print(f"Peak reserved memory for training = {used_memory_for_lora} GB.")
print(f"Peak reserved memory % of max memory = {used_percentage} %.")
print(f"Peak reserved memory for training % of max memory = {lora_percentage} %.")
Het model is in 20 minuten getraind en het piekgereserveerde geheugen voor training was circa 3,7 GB. Dat is relatief laag vergeleken met de traditionele methode, waarbij je het volledige model laadt, quantized en vervolgens fijn-afstemt. In dat geval heb je minstens 15 GB GPU-geheugen nodig.
1207.5478 seconds used for training.
20.13 minutes used for training.
Peak reserved memory = 9.73 GB.
Peak reserved memory for training = 3.746 GB.
Peak reserved memory % of max memory = 61.241 %.
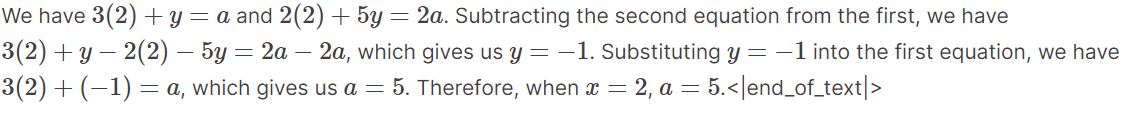
Peak reserved memory for training % of max memory = 23.578 %.Om het model na het fijn-afstemmen te testen, moeten we snelle inferentie activeren. Vervolgens voeren we een voorbeeld-algebravraag uit de dataset in de promptstijl in en zetten die om naar tokens. Daarna gebruiken we het model om de response te genereren en decoderen we de output om de tekst te tonen.
De gegenereerde tekst was in Markdown-indeling, maar we hebben die geconverteerd om de tekst met correcte wiskundige vergelijkingen weer te geven.
from IPython.display import display, Markdown

FastLanguageModel.for_inference(model)
inputs = tokenizer(
    [
        prompt_style.format(
            "If the system of equations \begin{align*} 3x+y&=a,\\ 2x+5y&=2a, \end{align*} has a solution $(x,y)$ when $x=2$, compute $a$.",
            "",
        )
    ],
    return_tensors="pt",
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=250,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs)
Markdown(response[0].split("\n\n### Response:")[1])
Zoals we zien sluit de gegenereerde response aan bij de dataset en geeft die ons de oplossingen voor de algebraproblemen.
Laten we ons fijn-afgestemde model opslaan en naar de Hugging Face Hub pushen, zodat je het eenvoudig kunt delen of deployen.
new_model_online = "kingabzpro/Llama-3.1-8B-MATH"
new_model_local = "Llama-3.1-8B-MATH"
model.save_pretrained(new_model_local) # Local saving
tokenizer.save_pretrained(new_model_local) # Local saving
De volgende code maakt een nieuwe repository op Hugging Face en pusht vervolgens de LoRA en de tokenizer met de metadata.
model.push_to_hub(new_model_online) # Online saving
tokenizer.push_to_hub(new_model_online) # Online saving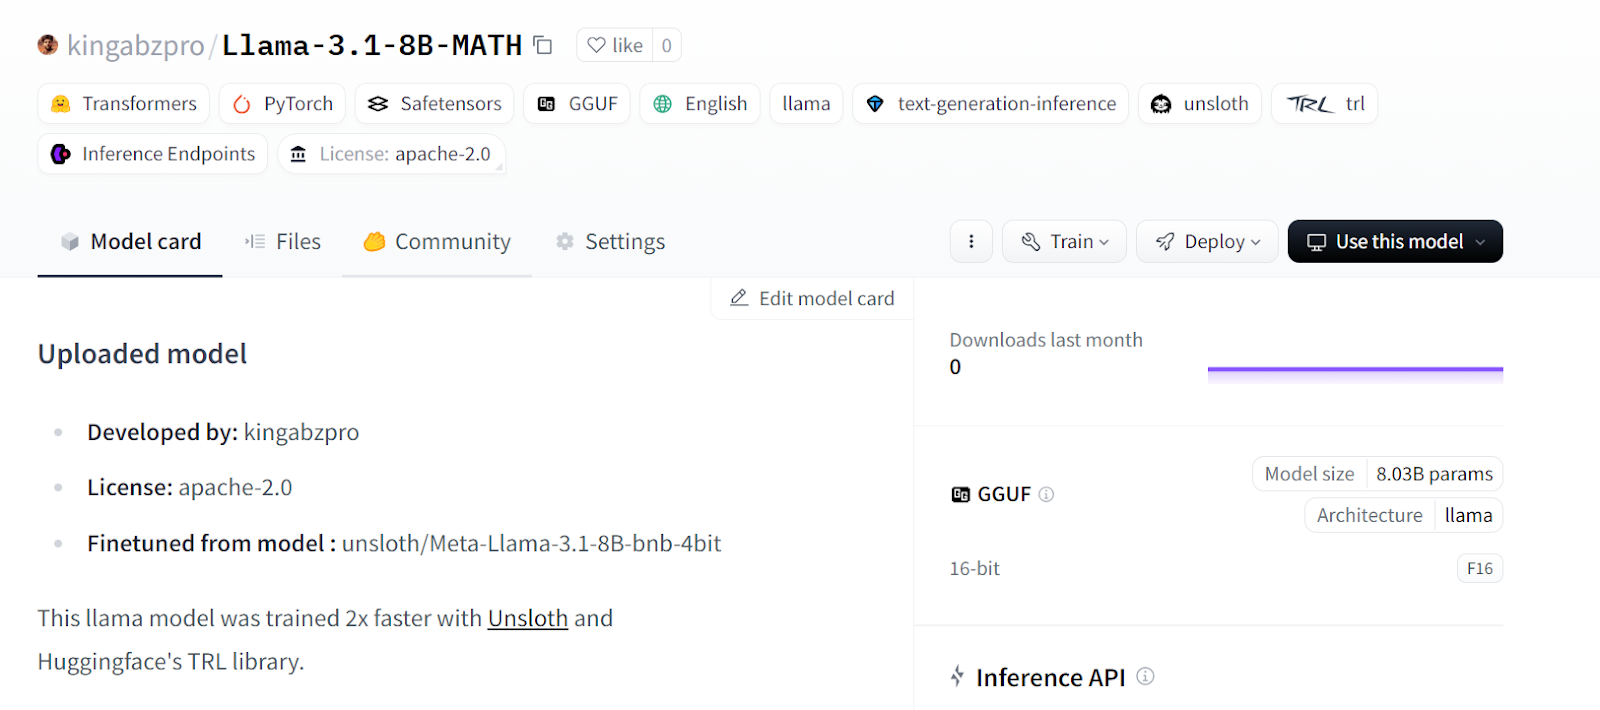
Bron: kingabzpro/Llama-3.1-8B-MATH
Loop je tegen problemen aan bij het fijn-afstemmen van de LLM met Unsloth? Raadpleeg dan het Fine-tuning LLMs using Unsloth Kaggle-notebook. Het bevat stabiele code die je zelf kunt draaien om de resultaten te reproduceren.
De volgende stap in je AI-reis is LLM’s gebruiken om effectieve AI-toepassingen te bouwen. Meer informatie vind je in de tutorial How to Build LLM Applications with LangChain.
Het mergen van de LoRa met het basismodel vereist extra VRAM en lokale opslag. Om limieten te vermijden, maken we een nieuw Kaggle-notebook met de P100 GPU als accelerator. We activeren ook de Hugging Face API om toegang te krijgen tot de API-sleutel.
%%capture
%pip install unslothfrom huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(hf_token)from unsloth import FastLanguageModel
new_model_name = "kingabzpro/Llama-3.1-8B-MATH"
model, tokenizer = FastLanguageModel.from_pretrained(
model_name = new_model_name, # YOUR MODEL YOU USED FOR TRAINING
max_seq_length = 2048,
dtype = None,
load_in_4bit = True,
)
FastLanguageModel.for_inference(model); 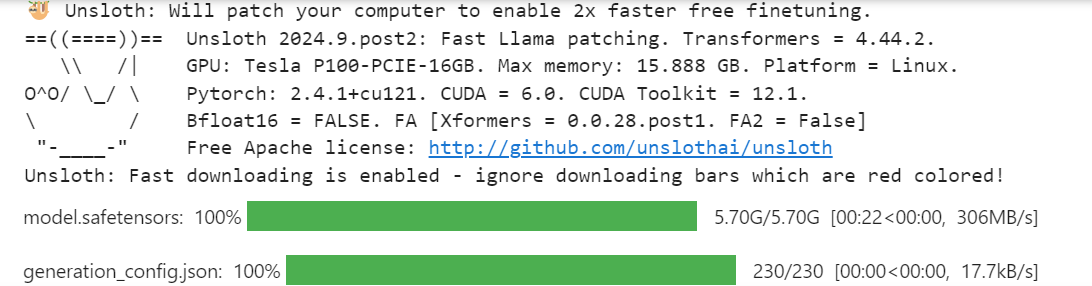
prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context. Write a response that appropriately completes the request.

### Instruction:
You are a math genius who can solve any level of algebraic problem. Please answer the following math question.

### Input:
{}

### Response:
{}"""from IPython.display import display, Markdown
inputs = tokenizer(
[
prompt_style.format(
"Solve the equation $|y-6| + 2y = 9$ for $y$.", # input
"", # output - leave this blank for generation!
)
],
return_tensors="pt",
).to("cuda")
outputs = model.generate(
input_ids=inputs.input_ids,
attention_mask=inputs.attention_mask,
max_new_tokens=250,
pad_token_id=tokenizer.eos_token_id,
)
response = tokenizer.batch_decode(outputs)
Markdown(response[0].split("\n\n### Response:")[1])
Het model werkt perfect en is klaar om met het basismodel gemerged te worden.
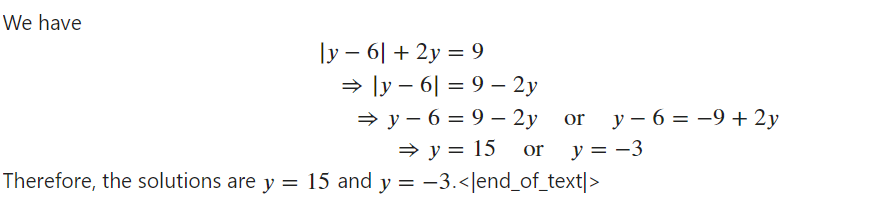
working-map biedt slechts 20 GB, wat niet genoeg is om het volledige model te mergen en te pushen. Door een andere map in de rootdirectory aan te maken, krijgen we toegang tot 60 GB tijdelijke opslag.%mkdir ../temp
%cd /kaggle/tempmodel.push_to_hub_merged(new_model_name, tokenizer, save_method = "merged_16bit")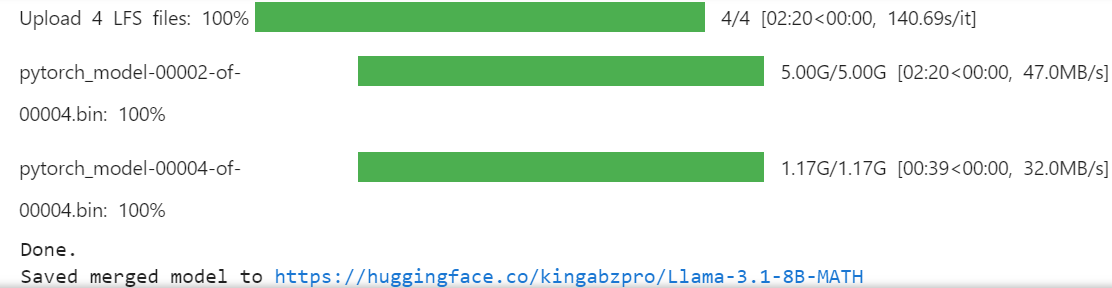
model.push_to_hub_gguf(new_model_name, tokenizer, quantization_method = "q4_k_m")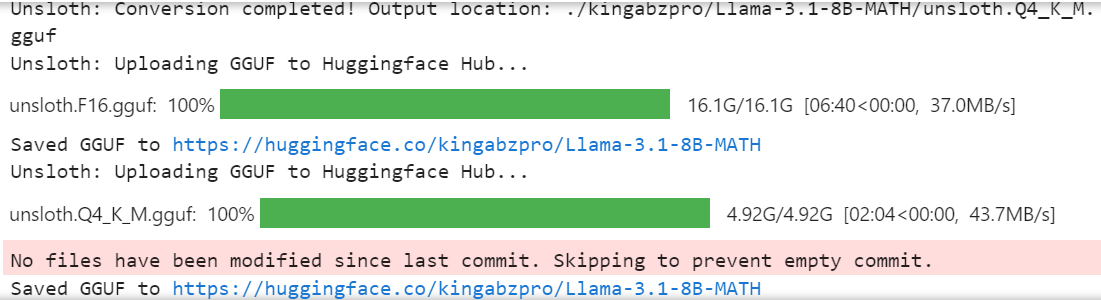
Het volledige 16-bit model, de adapter en de gequantiseerde GGUF-bestanden staan in je modelrepository. Om het fijn-afgestemde model lokaal te gebruiken, download je gewoon het gequantiseerde GGUF-bestand en gebruik je het met Jan, Misty, GPT4ALL of Ollama.
Volg de tutorial Fine-tuning Llama 3.2 and Using It Locally: A Step-by-Step Guide om te leren hoe je het Llama 3.2-model fijn-afstemt op een klantenservicedataset, het model merge’t en exporteert naar de Hugging Face Hub, en het fijn-afgestemde model converteert naar GGUF-formaat zodat je het lokaal met de Jan-applicatie kunt gebruiken.
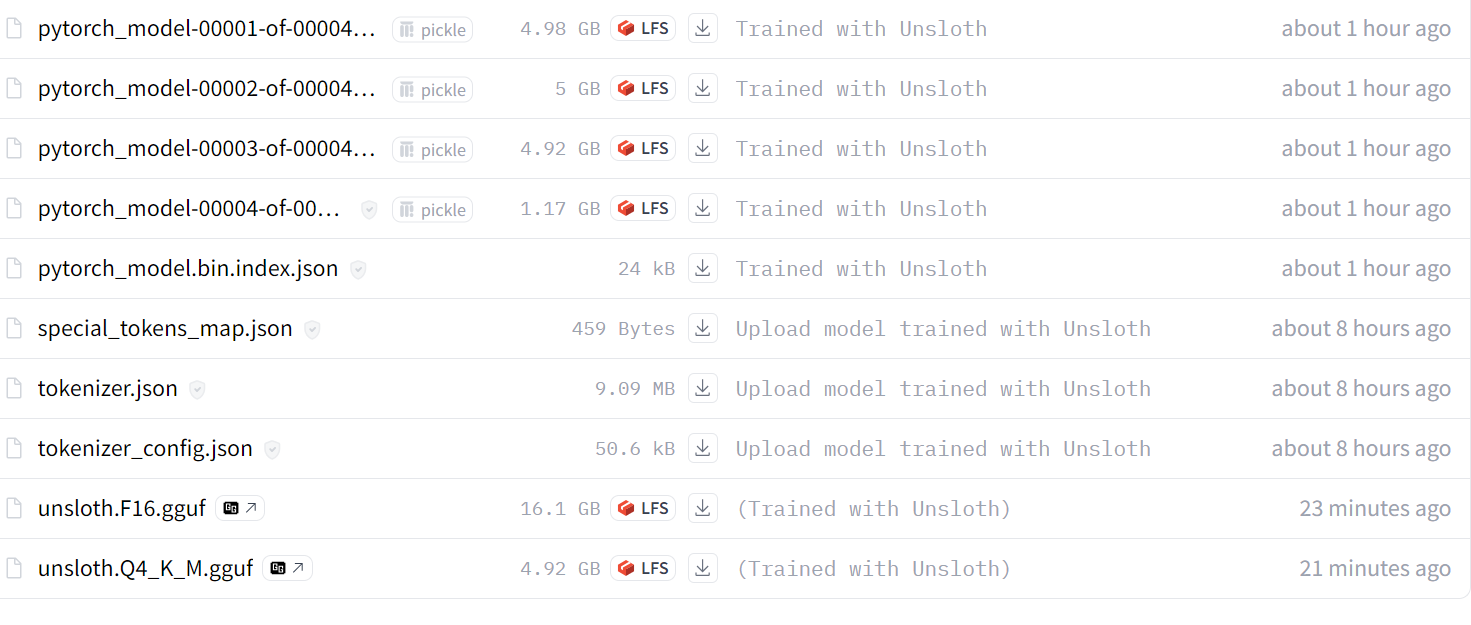
Bron: kingabzpro/Llama-3.1-8B-MATH
Heb je problemen bij het laden en mergen van de LoRA met het basismodel, bekijk dan het Merging LoRA Adopter with Unsloth Kaggle-notebook voor extra hulp.
Ik raad je ook aan de blog 12 LLM Projects For All Levels te lezen. Deze bevat een lijst met LLM-projecten voor beginners, intermediate studenten, afstudeerders en experts.
In deze tutorial hebben we geleerd hoe je het Llama 3.1 3B-model effectief kunt fijn-afstemmen met weinig rekenresources en snelheden behaalt die 2x hoger liggen dan traditionele methoden.
We hebben ook geleerd hoe je snelle model-inferentie draait, de LoRA met het basismodel merge’t en die naar de Hugging Face Hub pusht.
Daarnaast hebben we het model omgezet naar het llama.cpp-formaat en gequantized, zodat het fijn-afgestemde model eenvoudig lokaal op een laptop gebruikt kan worden met Jan- of GPT4ALL-apps.
Om de prestaties te verbeteren, raden we aan het model op de volledige dataset fijn te stemmen, de hyperparameters te optimaliseren en aan de promptstijl te werken. Ook na het fijn-afstemmen kun je de prestaties van AI-toepassingen op veel manieren verbeteren met function calling en RAG-pijplijnen.
Leer welke oplossing beter is voor jouw specifieke cases met de gids RAG vs Fine-Tuning: A Comprehensive Tutorial with Practical Example. Deze bevat voorbeeldcode om op je eigen dataset te proberen en de resultaten te vergelijken.
Topcursussen over LLM’s
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

