
Khóa học
Nhập môn LLMs trong Python
3 giờ
37K
Bạn đã từng gặp vấn đề về bộ nhớ khi tinh chỉnh mô hình hoặc thấy quá trình này mất quá nhiều thời gian để hoàn thành chưa? Nếu bạn đang tìm kiếm một giải pháp hiệu quả và nhanh hơn so với thư viện Transformers để tinh chỉnh các mô hình ngôn ngữ lớn (LLM), bạn đã đến đúng nơi!
Trong hướng dẫn này, chúng ta sẽ khám phá cách tinh chỉnh mô hình Llama 3.1 3B chỉ với 9GB VRAM, đạt tốc độ nhanh gấp 2 lần so với phương pháp Transformers truyền thống. Chúng ta cũng sẽ đề cập cách suy luận nhanh, chuyển đổi mô hình sang định dạng tương thích vLLM và GGUF, và đẩy mô hình đã lưu lên Hugging Face Hub chỉ với vài dòng mã.
Nếu bạn mới làm quen với các khái niệm này, hãy nhớ tham gia khóa Nắm vững các khái niệm về Mô hình Ngôn ngữ Lớn (LLMs) để xây dựng nền tảng vững chắc trước khi bắt tay vào tinh chỉnh.
Hình ảnh của Tác giả
Unsloth AI là một framework Python được thiết kế để tinh chỉnh nhanh và truy cập các mô hình ngôn ngữ lớn. Nó cung cấp API đơn giản và hiệu năng nhanh gấp 2 lần so với Transformers.
Truy cập mô hình Llama-3.1 bằng Unsloth khá đơn giản. Chúng ta sẽ không tải mô hình 16-bit. Thay vào đó, chúng ta sẽ tải phiên bản 4-bit có trên Hugging Face để tiết kiệm bộ nhớ GPU và tăng tốc suy luận.
%%capture
%pip install unslothFastLanguageModel. from transformers import TextStreamer
from unsloth import FastLanguageModel
model, tokenizer = FastLanguageModel.from_pretrained(
model_name = "unsloth/Meta-Llama-3.1-8B-bnb-4bit"
)
FastLanguageModel.for_inference(model)prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context. Write a response that appropriately completes the request.
### Instruction:
{}
### Input:
{}
### Response:
{}"""
inputs = tokenizer(
[
prompt_style.format(
"You are a professional machine learning engineer",
"How would you deal with NaN validation loss?",
"",
)
],
return_tensors="pt",
).to("cuda")
text_streamer = TextStreamer(tokenizer)
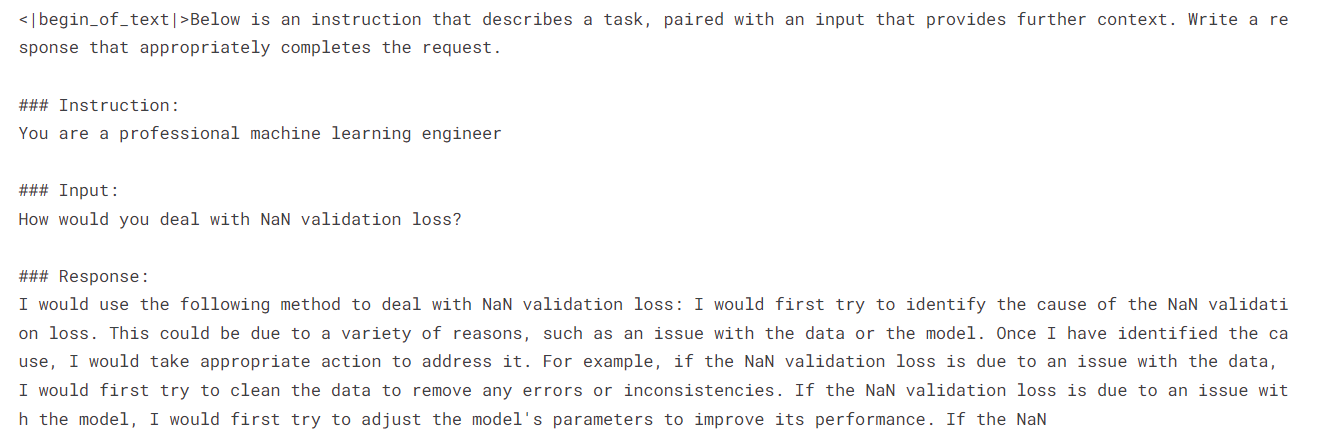
_ = model.generate(**inputs, streamer=text_streamer, max_new_tokens=128)
Chúng ta đã nhận được phản hồi tích cực về cách xử lý NaN validation loss.
Nếu bạn gặp khó khăn khi chạy đoạn mã trên trong Kaggle, đây là Notebook mẫu: Truy cập LLM bằng Unsloth.
Bằng cách tham gia khóa Giới thiệu về LLM trong Python, bạn sẽ học những điều cơ bản về kiến trúc Transformer, bao gồm cách xây dựng, tinh chỉnh và đánh giá. Đây là cánh cổng đưa bạn vào thế giới tinh chỉnh LLM bằng Python.
Trong hướng dẫn này, chúng ta sẽ học cách tinh chỉnh Llama 3.1 trên bộ dữ liệu lighteval/MATH bằng Unsloth. Bộ dữ liệu gồm các bài toán đại số với lời giải ở định dạng markdown. Toàn bộ dữ liệu được chia thành năm cấp độ độ khó.
Để hiểu rõ hơn hướng dẫn này, tôi khuyến nghị bạn tìm hiểu lý thuyết đằng sau từng bước trong quá trình tinh chỉnh LLM bằng cách đọc Hướng dẫn nhập môn về tinh chỉnh LLM. Hãy dành vài phút xem lại hướng dẫn, điều này sẽ giúp bạn nắm bắt quy trình.
Chúng tôi dùng notebook Kaggle như một IDE đám mây và cần thiết lập notebook trước khi làm việc với mô hình hoặc dữ liệu.
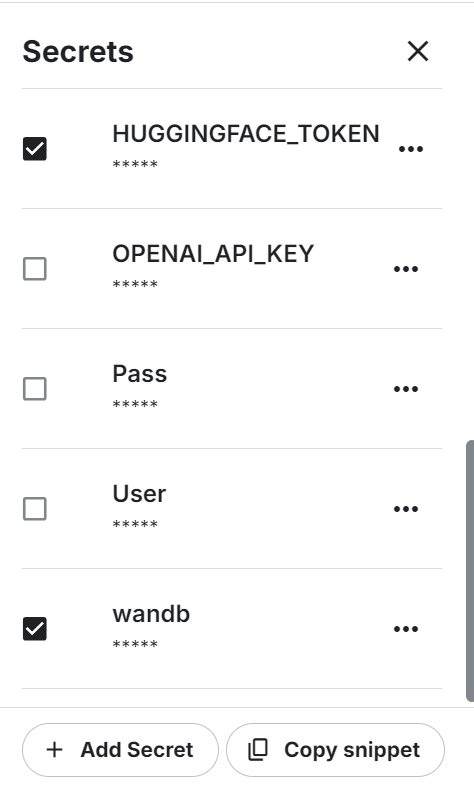
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(hf_token)import wandb
wb_token = user_secrets.get_secret("wandb")
wandb.login(key=wb_token)
run = wandb.init(
project='Fine-tune Llama-3.1-8B-bnb-4bit on Math Dataset',
job_type="training",
anonymous="allow"
)Giống như phần suy luận mô hình, chúng ta sẽ tải phiên bản lượng tử hóa 4-bit của Llama 3.1 với độ dài chuỗi tối đa 2048 và kiểu dữ liệu None.
from unsloth import FastLanguageModel
import torch

max_seq_length = 2048
dtype = None

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "unsloth/Meta-Llama-3.1-8B-bnb-4bit",
    max_seq_length = max_seq_length,
    dtype = dtype
)Tiếp theo, chúng ta sẽ tải và xử lý bộ dữ liệu. Trước hết, cần tạo một phong cách prompt để giúp thu được kết quả mong muốn.
Phong cách prompt bao gồm system prompt, instruction và chỗ trống cho input và response.
prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context. Write a response that appropriately completes the request.

### Instruction:
You are a math genius who can solve any level of algebraic problems. Please answer the following math question.

### Input:
{}

### Response:
{}"""
Sau đó, tạo hàm sử dụng phong cách prompt để đưa các bài toán và lời giải vào, chuyển chúng thành văn bản phù hợp. Hãy nhớ thêm EOS_TOKEN để tránh lặp lại không mong muốn.
EOS_TOKEN = tokenizer.eos_token # Must add EOS_TOKEN
def formatting_prompts_func(examples):
    inputs       = examples["problem"]
    outputs      = examples["solution"]
    texts = []
    for input, output in zip(inputs, outputs):
        text = prompt_style.format(input, output) + EOS_TOKEN
        texts.append(text)
    return { "text" : texts, }
Tải 500 mẫu từ bộ dữ liệu, áp dụng hàm formatting_prompts_func cho bộ dữ liệu và xem mẫu đầu tiên ở cột text.
from datasets import load_dataset

dataset = load_dataset("lighteval/MATH", split="train[0:500]", trust_remote_code=True)
dataset = dataset.map(
    formatting_prompts_func,
    batched=True,
)
dataset["text"][0]
Văn bản gồm system prompt, instruction, câu hỏi bài toán đại số và lời giải cho bài toán đó.
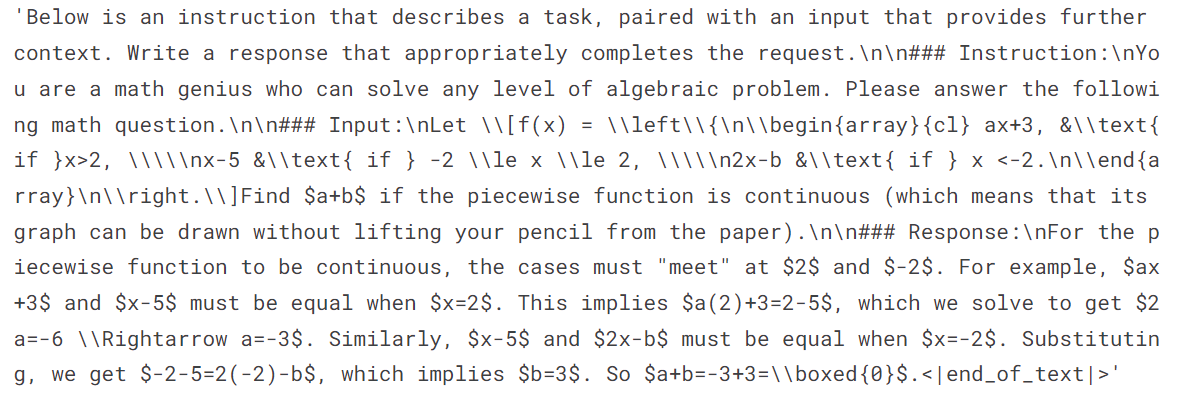
Chúng ta thêm LoRA (Low-Rank Adapter) vào mô hình bằng các module tuyến tính từ mô hình gốc.
model = FastLanguageModel.get_peft_model(
    model,
    r=16,
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],
    lora_alpha=16,
    lora_dropout=0,
    bias="none",

    use_gradient_checkpointing="unsloth",
    random_state=3407,
    use_rslora=False,
    loftq_config=None,
)
Thiết lập trainer với mô hình, tokenizer, độ dài chuỗi tối đa và các tham số huấn luyện. Phần này khá giống với thiết lập trainer bằng thư viện Transformers và TRL.
from trl import SFTTrainer
from transformers import TrainingArguments
from unsloth import is_bfloat16_supported

trainer = SFTTrainer(
    model = model,
    tokenizer = tokenizer,
    train_dataset = dataset,
    dataset_text_field = "text",
    max_seq_length = max_seq_length,
    dataset_num_proc = 2,
    args = TrainingArguments(
        per_device_train_batch_size = 2,
        gradient_accumulation_steps = 4,
        warmup_steps = 5,
        max_steps = 60,
        learning_rate = 2e-4,
        fp16 = not is_bfloat16_supported(),
        bf16 = is_bfloat16_supported(),
        logging_steps = 1,
        optim = "adamw_8bit",
        weight_decay = 0.01,
        lr_scheduler_type = "linear",
        seed = 3407,
        output_dir = "outputs",
    ),
)Thời gian huấn luyện mô hình mất gần 19 phút, khá ấn tượng. Training loss giảm đáng kể theo từng bước.
trainer_stats = trainer.train()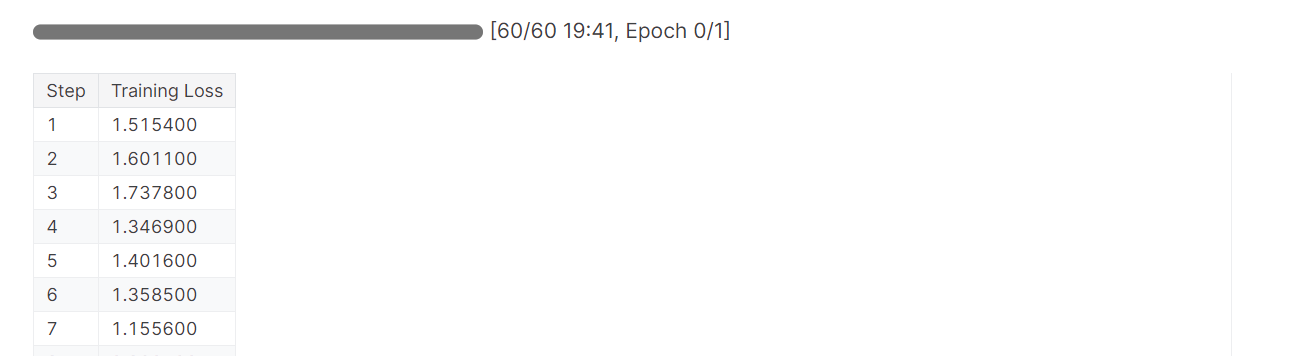
Bạn có thể xem chi tiết hiệu năng mô hình và chỉ số phần cứng trên bảng điều khiển Weights & Biases.
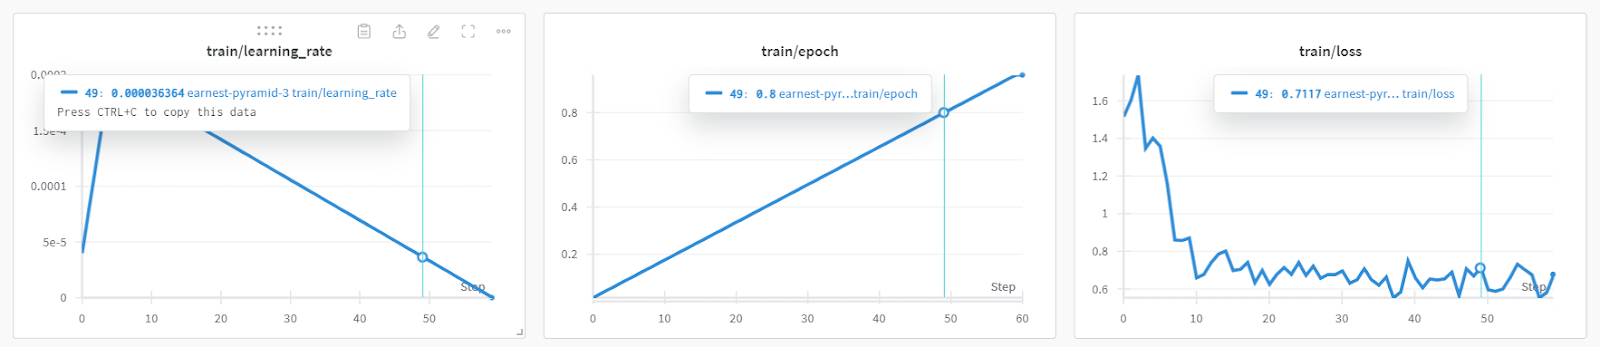
Bạn cũng có thể dùng torch và trainer_stats để tạo báo cáo của riêng bạn.
used_memory = round(torch.cuda.max_memory_reserved() / 1024 / 1024 / 1024, 3)
used_memory_for_lora = round(used_memory - start_gpu_memory, 3)
used_percentage = round(used_memory         /max_memory*100, 3)
lora_percentage = round(used_memory_for_lora/max_memory*100, 3)
print(f"{trainer_stats.metrics['train_runtime']} seconds used for training.")
print(f"{round(trainer_stats.metrics['train_runtime']/60, 2)} minutes used for training.")
print(f"Peak reserved memory = {used_memory} GB.")
print(f"Peak reserved memory for training = {used_memory_for_lora} GB.")
print(f"Peak reserved memory % of max memory = {used_percentage} %.")
print(f"Peak reserved memory for training % of max memory = {lora_percentage} %.")
Mô hình được huấn luyện trong 20 phút và đỉnh bộ nhớ dành cho huấn luyện khoảng 3.7 GB. Đây là mức thấp so với phương pháp truyền thống, vốn tải toàn bộ mô hình, lượng tử hóa rồi mới tinh chỉnh. Khi đó sẽ cần ít nhất 15 GB bộ nhớ GPU.
1207.5478 seconds used for training.
20.13 minutes used for training.
Peak reserved memory = 9.73 GB.
Peak reserved memory for training = 3.746 GB.
Peak reserved memory % of max memory = 61.241 %.
Peak reserved memory for training % of max memory = 23.578 %.Để kiểm thử mô hình sau khi tinh chỉnh, chúng ta cần kích hoạt suy luận nhanh. Tiếp theo, đưa một câu hỏi đại số mẫu từ bộ dữ liệu vào phong cách prompt và chuyển đổi thành token. Sau đó dùng mô hình để tạo phản hồi và giải mã đầu ra để hiển thị văn bản.
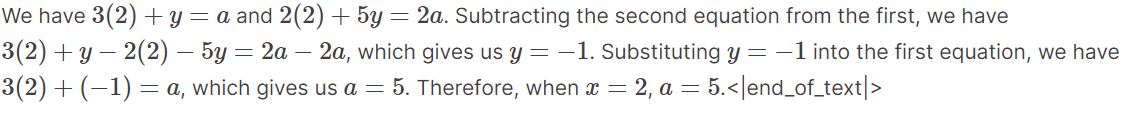
Văn bản tạo ra ở định dạng Markdown, nhưng chúng ta đã chuyển đổi để hiển thị phương trình toán học đúng định dạng.
from IPython.display import display, Markdown

FastLanguageModel.for_inference(model)
inputs = tokenizer(
    [
        prompt_style.format(
            "If the system of equations \begin{align*} 3x+y&=a,\\ 2x+5y&=2a, \end{align*} has a solution $(x,y)$ when $x=2$, compute $a$.",
            "",
        )
    ],
    return_tensors="pt",
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=250,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs)
Markdown(response[0].split("\n\n### Response:")[1])
Như ta thấy, phản hồi tạo ra phù hợp với bộ dữ liệu và cung cấp lời giải cho các bài toán đại số.
Hãy lưu mô hình đã tinh chỉnh và đẩy nó lên Hugging Face Hub để bạn có thể dễ dàng chia sẻ hoặc triển khai.
new_model_online = "kingabzpro/Llama-3.1-8B-MATH"
new_model_local = "Llama-3.1-8B-MATH"
model.save_pretrained(new_model_local) # Local saving
tokenizer.save_pretrained(new_model_local) # Local saving
Đoạn mã sau sẽ tạo một kho mới trên Hugging Face rồi đẩy LoRA và tokenizer kèm metadata.
model.push_to_hub(new_model_online) # Online saving
tokenizer.push_to_hub(new_model_online) # Online saving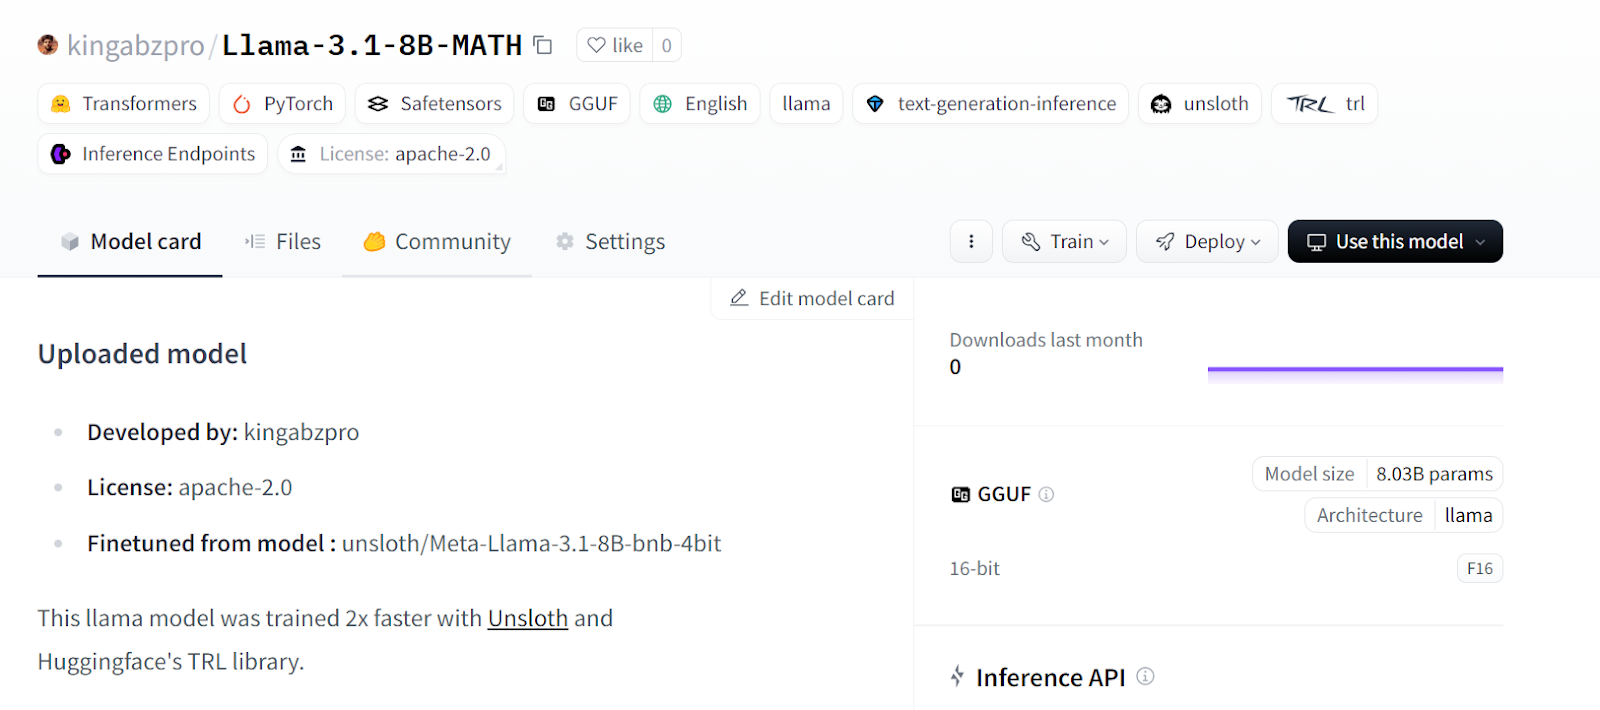
Nguồn: kingabzpro/Llama-3.1-8B-MATH
Nếu bạn gặp vấn đề khi tinh chỉnh LLM bằng Unsloth, vui lòng tham khảo Fine-tuning LLMs using Unsloth trên Kaggle. Notebook này chứa mã ổn định mà bạn có thể tự chạy để tái lập kết quả.
Bước tiếp theo trong hành trình AI của bạn là dùng LLM để phát triển các ứng dụng AI hiệu quả. Bạn có thể tìm hiểu thêm qua hướng dẫn Cách xây dựng ứng dụng LLM với LangChain.
Gộp LoRA với mô hình gốc cần thêm VRAM và bộ nhớ cục bộ. Để tránh vượt giới hạn, chúng ta sẽ tạo một notebook Kaggle mới với GPU P100 làm accelerator. Chúng ta cũng sẽ kích hoạt Hugging Face API để truy cập API key.
%%capture
%pip install unslothfrom huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(hf_token)from unsloth import FastLanguageModel
new_model_name = "kingabzpro/Llama-3.1-8B-MATH"
model, tokenizer = FastLanguageModel.from_pretrained(
model_name = new_model_name, # YOUR MODEL YOU USED FOR TRAINING
max_seq_length = 2048,
dtype = None,
load_in_4bit = True,
)
FastLanguageModel.for_inference(model); 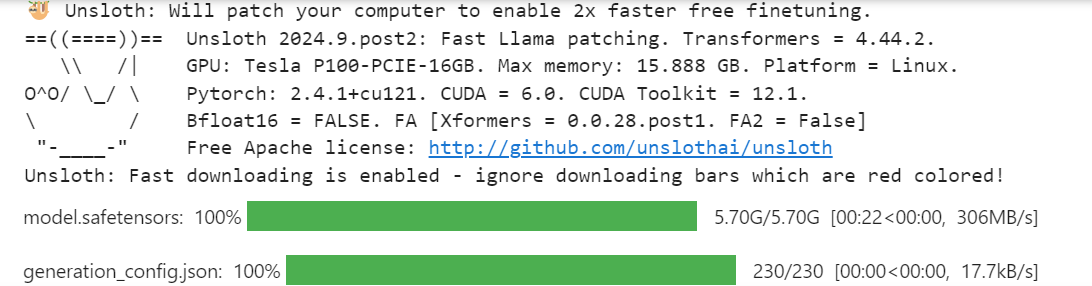
prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context. Write a response that appropriately completes the request.

### Instruction:
You are a math genius who can solve any level of algebraic problem. Please answer the following math question.

### Input:
{}

### Response:
{}"""from IPython.display import display, Markdown
inputs = tokenizer(
[
prompt_style.format(
"Solve the equation $|y-6| + 2y = 9$ for $y$.", # input
"", # output - leave this blank for generation!
)
],
return_tensors="pt",
).to("cuda")
outputs = model.generate(
input_ids=inputs.input_ids,
attention_mask=inputs.attention_mask,
max_new_tokens=250,
pad_token_id=tokenizer.eos_token_id,
)
response = tokenizer.batch_decode(outputs)
Markdown(response[0].split("\n\n### Response:")[1])
Mô hình hoạt động hoàn hảo và sẵn sàng để gộp với mô hình gốc.
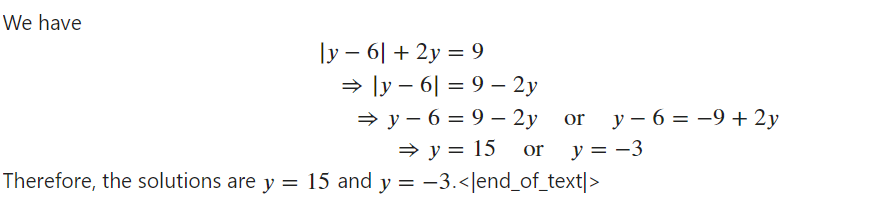
working của Kaggle chỉ có 20 GB, không đủ để gộp và đẩy mô hình đầy đủ. Tạo thư mục khác ở thư mục gốc cho phép truy cập 60 GB bộ nhớ tạm.%mkdir ../temp
%cd /kaggle/tempmodel.push_to_hub_merged(new_model_name, tokenizer, save_method = "merged_16bit")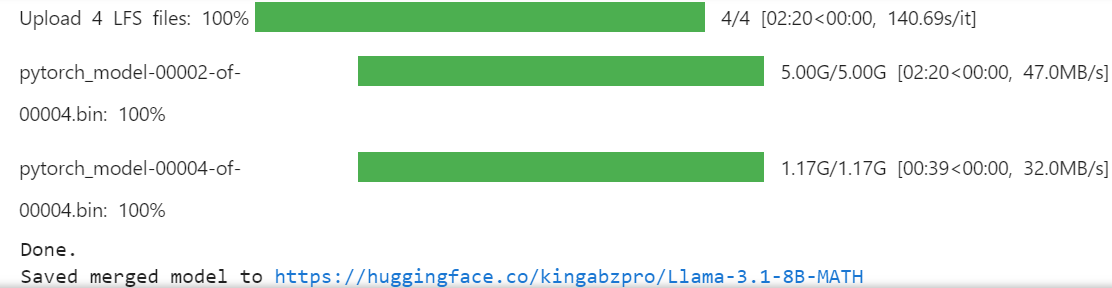
model.push_to_hub_gguf(new_model_name, tokenizer, quantization_method = "q4_k_m")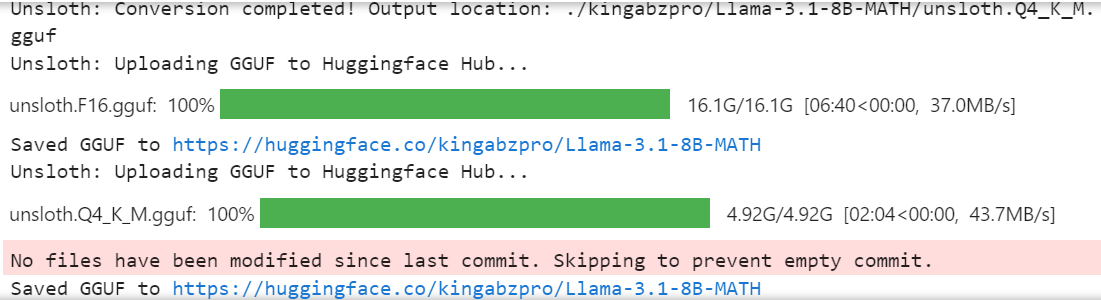
Mô hình 16-bit đầy đủ, adapter và các tệp GGUF đã lượng tử hóa hiện có trong kho mô hình của bạn. Để dùng mô hình đã tinh chỉnh trên máy cục bộ, chỉ cần tải tệp GGUF đã lượng tử hóa và bắt đầu sử dụng với Jan, Misty, GPT4ALL hoặc Ollama.
Hãy theo dõi hướng dẫn Tinh chỉnh Llama 3.2 và sử dụng cục bộ: Hướng dẫn từng bước để học cách tinh chỉnh mô hình Llama 3.2 trên dữ liệu hỗ trợ khách hàng, gộp và xuất mô hình lên Hugging Face Hub, và chuyển mô hình đã tinh chỉnh sang định dạng GGUF để dùng cục bộ với ứng dụng Jan.
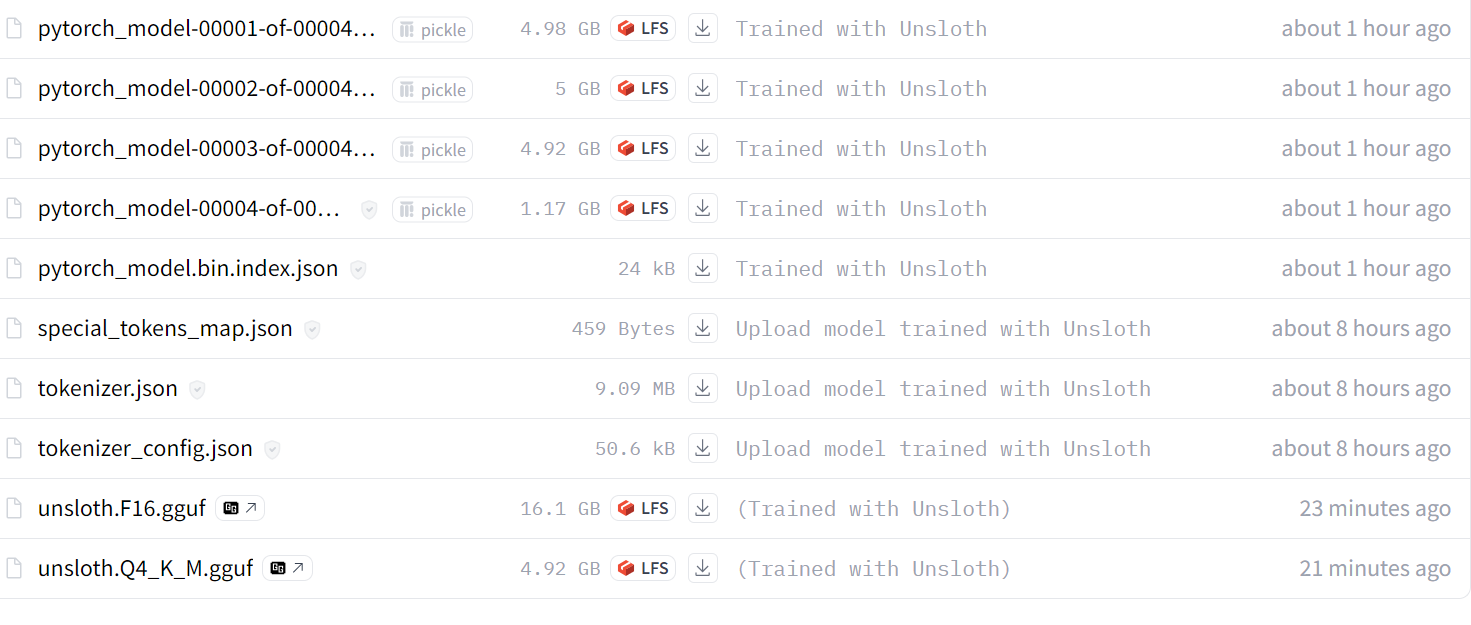
Nguồn: kingabzpro/Llama-3.1-8B-MATH
Nếu bạn gặp vấn đề khi tải và gộp LoRA với mô hình gốc, vui lòng xem Merging LoRA Adopter with Unsloth trên Kaggle để được hỗ trợ thêm.
Tôi cũng khuyến nghị bạn đọc blog 12 dự án LLM cho mọi cấp độ. Bài viết bao gồm danh sách dự án LLM cho người mới bắt đầu, trình độ trung cấp, sinh viên năm cuối và chuyên gia.
Trong hướng dẫn này, chúng ta đã học cách tinh chỉnh hiệu quả mô hình Llama 3.1 3B với tài nguyên tính toán thấp và đạt tốc độ nhanh gấp 2 lần so với phương pháp truyền thống.
Chúng ta cũng đã học cách chạy suy luận nhanh, gộp LoRA với mô hình gốc và đẩy lên Hugging Face hub.
Ngoài ra, chúng ta đã chuyển đổi mô hình sang định dạng llama.cpp và lượng tử hóa để có thể dễ dàng sử dụng cục bộ trên laptop bằng các ứng dụng Jan hoặc GPT4ALL.
Để cải thiện hiệu năng mô hình, chúng tôi khuyến nghị tinh chỉnh trên toàn bộ bộ dữ liệu, tối ưu siêu tham số và trau chuốt phong cách prompt. Ngay cả sau khi tinh chỉnh, bạn vẫn có thể nâng cao hiệu quả ứng dụng AI theo nhiều cách bằng function calling và các pipeline RAG.
Tìm hiểu giải pháp nào phù hợp hơn cho trường hợp cụ thể của bạn qua hướng dẫn RAG vs Fine-Tuning: Hướng dẫn toàn diện kèm ví dụ thực tế. Bài viết kèm mã mẫu để bạn thử trên tập dữ liệu của mình và so sánh kết quả.
Các khóa học LLM hàng đầu
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
