
Cursus
Introductie tot Python
4 uur
7M
Geheugenefficiënte classes schrijven in Python is noodzakelijk voor het ontwikkelen van robuuste applicaties die goed presteren onder verschillende systeembeperkingen. Efficiënt geheugengebruik versnelt de uitvoeringstijd van applicaties en verbetert de schaalbaarheid doordat er minder resources worden verbruikt, wat vooral belangrijk is in omgevingen met beperkte geheugencapaciteit.
In dit artikel maak ik je wegwijs in de basis van geheugenbeheer in Python en presenteer ik verschillende praktische technieken voor het schrijven van geheugenefficiënte classes. Of je nu complexe systemen bouwt of eenvoudige scripts, deze inzichten helpen je om schonere en efficiëntere Python-code te schrijven.
Het geheugenbeheersysteem van Python is geavanceerd en ontworpen om ontwikkeling te vereenvoudigen door de complexiteit van geheugenoperaties af te handelen. Dit systeem is nodig om ervoor te zorgen dat Python-applicaties efficiënt draaien.
De private heap staat centraal in het geheugenbeheer van Python. Hier worden alle Python-objecten en datastructuren opgeslagen. Programmeurs hebben geen directe toegang tot deze private heap; ze werken met objecten via het geheugenbeheersysteem van Python.
Het geheugenbeheersysteem gebruikt:
Python hanteert een dubbele aanpak voor garbage collection:
Inzicht in en optimalisatie van geheugengebruik zijn cruciaal om de prestaties van applicaties op peil te houden.
Python biedt verschillende tools voor memory profiling, die verder gaan dan standaarddebugging en ontwikkelaars helpen om inefficiënties in het geheugen op te sporen en op te lossen:
We gebruiken de bibliotheek pympler in deze tutorial, en je kunt die installeren met de pip-pakketmanager in je terminal:
pip install pymplerJe kunt meer lezen over memory profiling in onze tutorial — Introductie tot Memory Profiling in Python.
Nu we de basis van geheugenbeheer in Python begrijpen, bekijken we een paar geavanceerde technieken voor het schrijven van geheugenefficiënte classes.
__slots__In Python heeft elke klasse-instantie een woordenboek genaamd __dict__ om instantievariabelen op te slaan. Hoewel dit dynamische toewijzing van nieuwe variabelen mogelijk maakt, kan het leiden tot aanzienlijke geheugenoverhead, vooral wanneer je veel instantieobjecten maakt. Door __slots__ te definiëren, vertel je Python om ruimte toe te wijzen voor een vaste set attributen, waardoor de dynamische dictionary overbodig wordt.
Het gebruik van __slots__ heeft twee primaire voordelen:
__slots__ is sneller dan via een woordenboek, dankzij directe opzoeking zonder de hashtabel-bewerkingen die bij dictionary-toegang horen.Neem een eenvoudige klasse die een punt in een tweedimensionale ruimte voorstelt:
class PointWithoutSlots:
   def __init__(self, x, y):
       self.x = x
       self.y = y

class PointWithSlots:
   __slots__ = ('x', 'y')
   def __init__(self, x, y):
       self.x = x
       self.y = y
In de klasse PointWithoutSlots heeft elke instantie een __dict__ om de attributen x en y op te slaan, terwijl de klasse PointWithSlots dat niet heeft, wat resulteert in minder geheugen per instantie.
Om het verschil in geheugengebruik te illustreren, maken we duizend punten en meten we het totale geheugen met het pakket pympler:
from pympler import asizeof

points_without_slots = [PointWithoutSlots(i, i) for i in range(1000)]
points_with_slots = [PointWithSlots(i, i) for i in range(1000)]

print("Total memory (without __slots__):", asizeof.asizeof(points_without_slots))
print("Total memory (with __slots__):", asizeof.asizeof(points_with_slots))
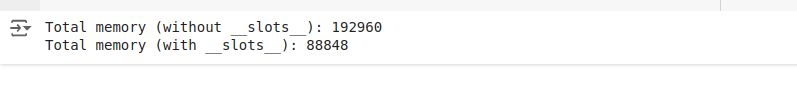
De output die we zien is:
Geheugenvergelijking met en zonder slots
De output laat doorgaans zien dat de instantie van PointWithSlots minder geheugen verbruikt dan PointWithoutSlots, wat de effectiviteit van __slots__ aantoont in het verlagen van de geheugenoverhead per instantie.
__slots__Hoewel __slots__ gunstig zijn voor geheugenoptimalisatie, kennen ze enkele beperkingen:
__slots__ is gedefinieerd, kun je niet dynamisch nieuwe attributen aan instanties toevoegen.__slots__ wordt overgeërfd, moet de subklasse ook __slots__ definiëren om te blijven profiteren van de geheugenoptimalisatie, wat het klassenontwerp kan compliceren. Ondanks deze beperkingen is het gebruik van __slots__ een krachtig hulpmiddel voor ontwikkelaars die het geheugengebruik in Python-applicaties willen optimaliseren, met name in omgevingen met strikte geheugeneisen of waar het aantal instanties zeer hoog is.
Geheugenefficiënte ontwerppatronen zijn architecturale oplossingen die helpen om geheugengebruik en -beheer in Python-applicaties te optimaliseren.
Twee bijzonder effectieve patronen voor geheugenefficiëntie in klassenontwerp zijn de Flyweight- en Singleton-patronen. Correct toegepast in situaties met talrijke instantieobjecten of gedeelde data kunnen deze patronen het geheugengebruik drastisch verlagen.
Het Flyweight-patroon werkt door gemeenschappelijke delen van de staat te delen tussen meerdere objecten in plaats van alle data in elk object te bewaren, wat de totale geheugendruk aanzienlijk vermindert.
Stel een klasse voor die grafische cirkels in een tekenapplicatie representeert, waarbij elke cirkel een kleur, straal en coördinaten heeft. Met het Flyweight-patroon kunnen kleur en straal, die waarschijnlijk door veel cirkels gedeeld worden, in gedeelde objecten worden opgeslagen:
class Circle:
   # Flyweight object
   def __init__(self, color):
       self.color = color
   def draw(self, radius, x, y):
       print(f"Drawing a {self.color} circle with radius {radius} at ({x},{y})")

class CircleFactory:
   # Factory to manage Flyweight objects
   _circles = {}
   @classmethod
   def get_circle(cls, color):
       if not cls._circles.get(color):
           cls._circles[color] = Circle(color)
       return cls._circles[color]
In dit voorbeeld delen meerdere cirkelinstanties het Circle-object uit de CircleFactory op basis van kleur, zodat kleurdata slechts één keer wordt opgeslagen en het geheugen efficiënter wordt gebruikt.
Laten we deze klasse gebruiken om instanties te maken en te begrijpen hoe geheugen wordt bespaard.
import sys

factory = CircleFactory()
circle1 = factory.get_circle("Red")
circle2 = factory.get_circle("Red")
circle3 = factory.get_circle("Blue")

print("Memory address of circle1:", id(circle1))
print("Memory address of circle2:", id(circle2))
print("Memory address of circle3:", id(circle3))
print ("-----------------------------")
print("Memory used by circle1:", sys.getsizeof(circle1))
print("Memory used by circle2:", sys.getsizeof(circle2))
print("Memory used by circle3:", sys.getsizeof(circle3))
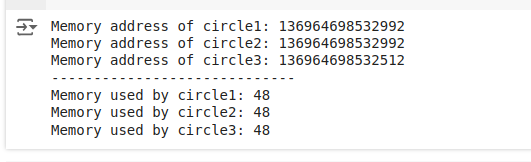
De output die we zien is:
Geheugengebruik voor flyweight-ontwerppatroon
We zien dat circle1 en circle2 hetzelfde geheugenadres hebben, wat betekent dat ze inderdaad hetzelfde object zijn (dezelfde instantie voor de kleur “Red”). circle3 heeft een ander geheugenadres omdat het een cirkel met een andere kleur (“Blue”) representeert.
circle1 en circle2 dezelfde instantie laten zien dat de CircleFactory de Circle-instantie met succes tussen deze twee deelde. Hier ontstaat de geheugenefficiëntie: als je duizend rode cirkels in je applicatie had met het Flyweight-patroon, zouden ze allemaal één enkele Circle-instantie voor de kleur delen, in plaats van elk een eigen aparte Circle-instantie te hebben, wat aanzienlijk geheugen bespaart.
Het Singleton-patroon zorgt ervoor dat een klasse slechts één instantie heeft en biedt een globaal toegangspunt. Dit patroon is handig voor het beheren van configuraties of gedeelde resources in een applicatie, waardoor geheugenoverhead wordt verminderd doordat gedeelde resources of configuratiedata niet op meerdere plaatsen worden gedupliceerd.
Bekijk deze Database-klasse:
class Database:
   _instance = None
   def __new__(cls):
       if cls._instance is None:
           cls._instance = super(Database, cls).__new__(cls)
           # Initialize any attributes of the instance here
       return cls._instance
   def connect(self):
       # method to simulate database connection
       return "Connection established"
In deze implementatie zorgt de klasse Database ervoor dat, ongeacht hoe vaak je instantieert, er slechts één gedeelde instantie wordt gebruikt, wat geheugen bespaart door meerdere identieke objecten te vermijden.
We kunnen dit controleren met de volgende code:
db1 = Database()
print(db1.connect())
db2 = Database()
print(db1 is db2)
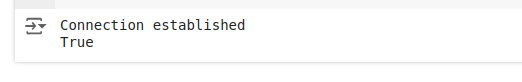
De output is als volgt:
Instantiecreatie voor singleton-ontwerppatroon
De “True”-output geeft aan dat de variabelen db1 en db2 naar dezelfde instantie verwijzen.
Deze patronen laten zien hoe doordacht ontwerp de geheugenefficiëntie aanzienlijk kan verbeteren. Door geschikte ontwerppatronen te kiezen en te implementeren, kunnen ontwikkelaars hun Python-applicaties slanker en performanter maken.
De keuze van het juiste ingebouwde datatype in Python kan een grote invloed hebben op geheugenefficiëntie. Ingebouwde types zijn geoptimaliseerd voor prestaties en geheugengebruik dankzij hun interne implementaties in de Python-interpreter.
Door hun unieke eigenschappen kunnen tuples en sets in specifieke gevallen geheugenefficiënter zijn dan lijsten en woordenboeken.
Tuples gebruiken over het algemeen minder geheugen dan lijsten omdat ze een vaste grootte hebben en niet kunnen worden gewijzigd zodra ze zijn gemaakt. Hierdoor kan Python hun opslag in het geheugen optimaliseren. Voor classes die data behandelen die na creatie niet hoeft te worden aangepast, zijn tuples een uitstekende keuze.
Bekijk twee eenvoudige Polygoon-classes die respectievelijk tuples en lijsten gebruiken om waarden op te slaan:
class PolygonWithTuple:
   def __init__(self, points):
       self.points = tuple(points)  # Storing points as a tuple
   def display_points(self):
       return self.points

class PolygonWithList:
   def __init__(self, points):
       self.points = list(points)  # Storing points as a list
   def display_points(self):
       return self.points
We kunnen instanties van beide classes maken om het geheugengebruik te vergelijken:
from pympler import asizeof

points = [(1, 2), (3, 4), (5, 6), (7, 8)]

# Creating instances of each class
polygon_tuple = PolygonWithTuple(points)
polygon_list = PolygonWithList(points)

# Memory usage comparison using pympler
print("Total memory used by Polygon with Tuple:", asizeof.asizeof(polygon_tuple))
print("Total memory used by Polygon with List:", asizeof.asizeof(polygon_list))
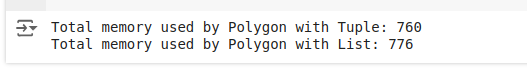
De output die we krijgen is:
Geheugenvergelijking voor tuples en lijsten
Deze output laat zien dat de tuple doorgaans minder geheugen gebruikt dan de lijst, waardoor de klasse PolygonWithTuple geheugenefficiënter is voor het opslaan van vaste, onveranderlijke data zoals geometrische coördinaten.
In Python zijn generators een krachtig hulpmiddel om geheugen efficiënt te beheren, vooral bij het werken met grote datasets.
Generators laten data één item per keer verwerken en laden op elk moment alleen wat nodig is in het geheugen. Deze methode van luie evaluatie is nuttig in applicaties waar grote hoeveelheden data worden verwerkt, maar slechts een klein deel tegelijk nodig is, waardoor de totale geheugendruk afneemt.
Stel een applicatie voor die een grote dataset met gebruikersrecords moet verwerken, zoals het berekenen van de gemiddelde leeftijd van gebruikers. In plaats van alle records in een lijst te laden (wat veel geheugen kan verbruiken), kan een generator één record per keer verwerken.
def process_records(file_name):
   """Generator that yields user ages from a file one at a time."""
   with open(file_name, 'r') as file:
       for line in file:
           user_data = line.strip().split(',')
           yield int(user_data[1])

def average_age(file_name):
   """Calculate the average age from user records."""
   total_age = 0
   count = 0
   for age in process_records(file_name):
       total_age += age
       count += 1
   return total_age / count if count else 0

print("Average Age:", average_age('user_data.csv'))
In dit voorbeeld leest de generatorfunctie process_records() één voor één regels uit een bestand, zet de relevante data om in een geheel getal en yieldt die. Dit betekent dat er op elk moment slechts de data van één regel in het geheugen staat, wat het geheugengebruik minimaliseert. De functie average_age() consumeert de generator en telt leeftijd en aantal op zonder ooit de volledige dataset tegelijk in het geheugen nodig te hebben.
Door de aanpak van luie evaluatie te gebruiken, kunnen we geheugen besparen en de responsiviteit en schaalbaarheid van applicaties verbeteren.
Circulaire verwijzingen ontstaan wanneer twee of meer objecten naar elkaar verwijzen. Dit kan subtiel gebeuren met structuren zoals lijsten, woordenboeken of complexere klassen waarin instanties naar elkaar verwijzen, waardoor een lus ontstaat.
Zoals we zagen bij de basis van geheugenbeheer heeft Python een extra garbage collector om circulaire verwijzingen te detecteren en op te ruimen. Vertrouwen op dit mechanisme kan echter leiden tot verhoogd geheugengebruik en inefficiënties:
Denk aan een typische usecase in een boomstructuur waarbij elke node een verwijzing naar zijn kinderen en optioneel naar zijn ouder bijhoudt. Deze ouder-kind-koppeling kan gemakkelijk circulaire verwijzingen creëren.
class TreeNode:
   def __init__(self, value, parent=None):
       self.value = value
       self.parent = parent
       self.children = []
   def add_child(self, child):
       child.parent = self  # Set parent reference
       self.children.append(child)

root = TreeNode("root")
child = TreeNode("child1", root)
root.add_child(child)
In dit voorbeeld verwijst de root naar het child via de children-lijst, en het child verwijst naar de root via het attribuut parent. Deze opzet kan zonder verdere interventie al een circulaire verwijzing creëren.
Zwakke verwijzingen zijn een effectieve manier om circulaire verwijzingen te doorbreken of te voorkomen zonder de hele datastructuur te herontwerpen.
De module weakref van Python maakt een verwijzing naar een object mogelijk die de referentietelling niet verhoogt. Deze zwakke verwijzing voorkomt niet dat het gerefereerde object wordt opgeruimd door de garbage collector, waardoor geheugenlekken door circulaire verwijzingen worden voorkomen.
Zo kunnen we de eerdere klasse aanpassen om zwakke verwijzingen te gebruiken:
import weakref

class TreeNode:
   def __init__(self, value, parent=None):
       self.value = value
       self.parent = weakref.ref(parent) if parent else None
       self.children = []
   def add_child(self, child):
       child.parent = weakref.ref(self)
       self.children.append(child)
root = TreeNode("root")
child = TreeNode("child1", root)
root.add_child(child)
In deze klasse is het parent-attribuut nu een zwakke verwijzing naar de oudernode. Dit betekent dat de oudernode kan worden opgeruimd door de garbage collector, zelfs als de kindnode nog bestaat, zolang er geen andere sterke verwijzingen naar de ouder zijn.
Deze aanpak voorkomt efficiënt de geheugenlekken die doorgaans samenhangen met circulaire verwijzingen in dergelijke structuren.
Dit artikel introduceerde de basis van geheugenbeheer in Python en presenteerde vijf geavanceerde technieken voor het schrijven van geheugenefficiënte classes, met praktische voorbeelden en geheugenvergelijkingen. We hopen dat je deze technieken en best practices toepast in je projecten om schaalbare en efficiënte applicaties te bouwen.
We raden je aan om onze Python Programming-track te bekijken, waarin software-engineeringprincipes en objectgeoriënteerd programmeren aan bod komen, inclusief efficiënte Python-code schrijven.
Leer meer over Python met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

