
Corso
Introduzione a Python
4 ore
7.1M
Scrivere classi efficienti in termini di memoria in Python è fondamentale per sviluppare applicazioni robuste che si comportano bene sotto vari vincoli di sistema. Un uso efficiente della memoria accelera l’esecuzione dell’applicazione e ne migliora la scalabilità consumando meno risorse, cosa particolarmente importante in ambienti con memoria limitata.
In questo articolo ti introdurrò ai fondamenti della gestione della memoria in Python e presenterò diverse tecniche pratiche per scrivere classi efficienti. Che tu stia creando sistemi complessi o semplici script, questi spunti ti aiuteranno a scrivere codice Python più pulito ed efficiente.
Il sistema di gestione della memoria di Python è sofisticato e progettato per semplificare lo sviluppo gestendo la complessità delle operazioni di memoria. Questo sistema è necessario per garantire che le applicazioni Python siano efficienti.
Al centro della gestione della memoria di Python c’è l’heap privato, dove sono archiviati tutti gli oggetti e le strutture dati Python. Gli sviluppatori non possono accedere direttamente a questo heap privato; interagiscono con gli oggetti tramite il sistema di gestione della memoria di Python.
Il sistema di gestione della memoria utilizza:
Python adotta un duplice approccio alla garbage collection:
Comprendere e ottimizzare l’uso della memoria è essenziale per mantenere le prestazioni dell’applicazione.
Python offre diversi strumenti per il memory profiling, che forniscono informazioni oltre il debugging standard e aiutano a individuare e risolvere inefficienze nella gestione della memoria:
In questo tutorial useremo la libreria pympler, che puoi installare con il package manager pip dal terminale:
pip install pymplerPuoi approfondire il memory profiling con il nostro tutorial — Introduzione al memory profiling in Python.
Dopo aver visto le basi della gestione della memoria in Python, esaminiamo alcune tecniche avanzate per scrivere classi efficienti.
__slots__In Python, ogni istanza di classe ha un dizionario chiamato __dict__ per memorizzare le variabili d’istanza. Sebbene ciò consenta l’assegnazione dinamica di nuove variabili, può comportare un notevole overhead di memoria, soprattutto quando si creano molte istanze. Definendo __slots__, dici a Python di allocare spazio per un set fisso di attributi, eliminando la necessità del dizionario dinamico.
Usare __slots__ ha due vantaggi principali:
__slots__ è più rapido rispetto all’accesso tramite dizionario grazie al lookup diretto, che evita le operazioni sulla tabella hash tipiche dei dizionari.Consideriamo una semplice classe che rappresenta un punto in uno spazio bidimensionale:
class PointWithoutSlots:
   def __init__(self, x, y):
       self.x = x
       self.y = y

class PointWithSlots:
   __slots__ = ('x', 'y')
   def __init__(self, x, y):
       self.x = x
       self.y = y
Nella classe PointWithoutSlots ogni istanza ha un __dict__ per memorizzare gli attributi x e y, mentre la classe PointWithSlots no, con conseguente minor memoria usata per istanza.
Per illustrare la differenza d’uso di memoria, creiamo mille punti e misuriamo la memoria totale con il pacchetto pympler:
from pympler import asizeof

points_without_slots = [PointWithoutSlots(i, i) for i in range(1000)]
points_with_slots = [PointWithSlots(i, i) for i in range(1000)]

print("Total memory (without __slots__):", asizeof.asizeof(points_without_slots))
print("Total memory (with __slots__):", asizeof.asizeof(points_with_slots))
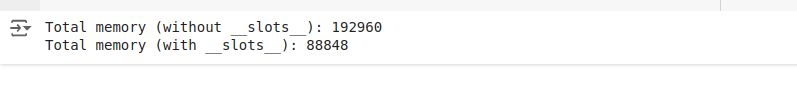
L’output che vediamo è:
Confronto della memoria con e senza slots
Tipicamente l’output mostra che l’istanza di PointWithSlots consuma meno memoria di PointWithoutSlots, dimostrando l’efficacia di __slots__ nel ridurre l’overhead di memoria per istanza.
__slots__Sebbene __slots__ siano utili per l’ottimizzazione della memoria, presentano alcune limitazioni:
__slots__, non puoi aggiungere dinamicamente nuovi attributi alle istanze.__slots__ viene ereditata, la sottoclasse deve definire a sua volta gli __slots__ per continuare a beneficiare dell’ottimizzazione, il che può complicare il design.Nonostante queste limitazioni, l’uso di __slots__ è uno strumento potente per chi vuole ottimizzare l’uso della memoria nelle applicazioni Python, soprattutto in ambienti con vincoli stringenti o con un numero molto elevato di istanze.
I design pattern efficienti in memoria sono soluzioni architetturali che aiutano a ottimizzare l’uso e la gestione della memoria nelle applicazioni Python.
Due pattern particolarmente efficaci per l’efficienza nella progettazione di classi sono Flyweight e Singleton. Se implementati correttamente in scenari che coinvolgono numerose istanze o dati condivisi, possono ridurre drasticamente il consumo di memoria.
Il pattern Flyweight funziona condividendo parti comuni dello stato tra più oggetti, invece di mantenere tutti i dati in ogni oggetto, riducendo così in modo significativo l’impronta di memoria complessiva.
Considera una classe che rappresenta cerchi grafici in un’app di disegno in cui ogni cerchio ha un colore, un raggio e delle coordinate. Usando il pattern Flyweight, colore e raggio, probabilmente condivisi da molti cerchi, possono essere memorizzati in oggetti condivisi:
class Circle:
   # Flyweight object
   def __init__(self, color):
       self.color = color
   def draw(self, radius, x, y):
       print(f"Drawing a {self.color} circle with radius {radius} at ({x},{y})")

class CircleFactory:
   # Factory to manage Flyweight objects
   _circles = {}
   @classmethod
   def get_circle(cls, color):
       if not cls._circles.get(color):
           cls._circles[color] = Circle(color)
       return cls._circles[color]
In questo esempio, più istanze di cerchio condividono l’oggetto Circle dalla CircleFactory in base al colore, garantendo un uso più efficiente della memoria memorizzando il colore una sola volta.
Usiamo questa classe per creare istanze e capire come si risparmia memoria.
import sys

factory = CircleFactory()
circle1 = factory.get_circle("Red")
circle2 = factory.get_circle("Red")
circle3 = factory.get_circle("Blue")

print("Memory address of circle1:", id(circle1))
print("Memory address of circle2:", id(circle2))
print("Memory address of circle3:", id(circle3))
print ("-----------------------------")
print("Memory used by circle1:", sys.getsizeof(circle1))
print("Memory used by circle2:", sys.getsizeof(circle2))
print("Memory used by circle3:", sys.getsizeof(circle3))
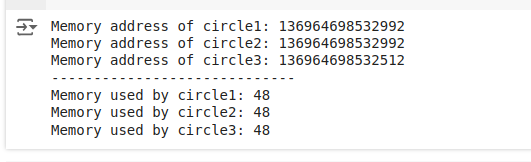
L’output che vediamo è:
Uso della memoria per il design pattern flyweight
Possiamo vedere che circle1 e circle2 hanno lo stesso indirizzo di memoria, il che significa che sono lo stesso oggetto (condividono la stessa istanza per il colore “Red”). circle3 ha un indirizzo diverso perché rappresenta un cerchio con colore differente (“Blue”).
circle1 e circle2 essendo la stessa istanza dimostra che la CircleFactory ha condiviso con successo l’istanza di Circle tra i due. Qui sta l’efficienza: se avessi mille cerchi rossi nell’app usando Flyweight, condividerebbero tutti un’unica istanza di Circle per il colore, invece di averne una separata ciascuno, risparmiando così molta memoria.
Il pattern Singleton assicura che una classe abbia una sola istanza e fornisce un punto di accesso globale ad essa. È utile per gestire configurazioni o risorse condivise nell’applicazione, riducendo l’overhead di memoria evitando la duplicazione di risorse o dati di configurazione.
Considera questa classe Database:
class Database:
   _instance = None
   def __new__(cls):
       if cls._instance is None:
           cls._instance = super(Database, cls).__new__(cls)
           # Initialize any attributes of the instance here
       return cls._instance
   def connect(self):
       # method to simulate database connection
       return "Connection established"
In questa implementazione, Database garantisce che, indipendentemente da quante volte venga istanziata, venga usata un’unica istanza condivisa, risparmiando memoria evitando oggetti identici multipli.
Possiamo verificarlo con il seguente codice:
db1 = Database()
print(db1.connect())
db2 = Database()
print(db1 is db2)
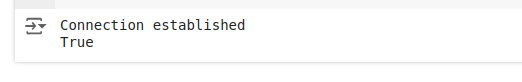
L’output è il seguente:
Creazione di istanze per il design pattern singleton
L’output “True” indica che le variabili db1 e db2 si riferiscono alla stessa istanza.
Questi pattern mostrano come un design accurato possa migliorare sensibilmente l’efficienza della memoria. Scegliendo e implementando i pattern appropriati, puoi ottimizzare le tue applicazioni Python per essere più snelle e performanti.
La scelta del tipo di dato built-in in Python può incidere in modo significativo sull’efficienza della memoria. I tipi integrati sono ottimizzati per prestazioni e uso della memoria grazie alla loro implementazione interna nell’interprete Python.
Per esempio, grazie alle loro proprietà, tuple e set possono essere più efficienti in memoria rispetto a liste e dizionari in casi d’uso specifici.
Le tuple in genere usano meno memoria delle liste perché hanno dimensione fissa e non possono essere modificate dopo la creazione, permettendo a Python di ottimizzarne lo storage. Per classi che gestiscono dati che non devono essere modificati dopo la creazione, le tuple sono un’ottima scelta.
Considera due semplici classi Polygon che usano rispettivamente tuple e liste per memorizzare i valori:
class PolygonWithTuple:
   def __init__(self, points):
       self.points = tuple(points)  # Storing points as a tuple
   def display_points(self):
       return self.points

class PolygonWithList:
   def __init__(self, points):
       self.points = list(points)  # Storing points as a list
   def display_points(self):
       return self.points
Possiamo creare istanze di entrambe le classi per confrontare l’uso di memoria:
from pympler import asizeof

points = [(1, 2), (3, 4), (5, 6), (7, 8)]

# Creating instances of each class
polygon_tuple = PolygonWithTuple(points)
polygon_list = PolygonWithList(points)

# Memory usage comparison using pympler
print("Total memory used by Polygon with Tuple:", asizeof.asizeof(polygon_tuple))
print("Total memory used by Polygon with List:", asizeof.asizeof(polygon_list))
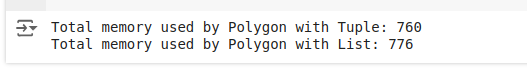
L’output che otteniamo è:
Confronto della memoria per tuple e liste
Questo output dimostra che la tupla in genere usa meno memoria della lista, rendendo la classe PolygonWithTuple più efficiente per memorizzare dati fissi e immutabili come le coordinate geometriche.
In Python, i generatori sono uno strumento potente per gestire la memoria in modo efficiente, soprattutto con dataset di grandi dimensioni.
I generatori permettono di elaborare i dati un elemento alla volta, caricando in memoria solo ciò che serve in quel momento. Questo approccio di valutazione lazy è utile quando si gestiscono grandi volumi di dati ma si processano piccole porzioni alla volta, riducendo l’impronta complessiva.
Considera un’applicazione che deve elaborare un grande dataset di record utente, ad esempio calcolando l’età media. Invece di caricare tutti i record in una lista (che potrebbe consumare molta memoria), un generatore può processare un record alla volta.
def process_records(file_name):
   """Generator that yields user ages from a file one at a time."""
   with open(file_name, 'r') as file:
       for line in file:
           user_data = line.strip().split(',')
           yield int(user_data[1])

def average_age(file_name):
   """Calculate the average age from user records."""
   total_age = 0
   count = 0
   for age in process_records(file_name):
       total_age += age
       count += 1
   return total_age / count if count else 0

print("Average Age:", average_age('user_data.csv'))
In questo esempio, la funzione generatore process_records() legge il file una riga alla volta, converte i dati rilevanti in intero e li produce. Ciò significa che in memoria è presente solo una riga alla volta, minimizzando l’uso di memoria. La funzione average_age() consuma il generatore accumulando totale e conteggio senza dover mai tenere l’intero dataset in memoria.
Così, adottando la valutazione lazy, possiamo risparmiare memoria e aumentare reattività e scalabilità delle applicazioni.
I riferimenti circolari si verificano quando due o più oggetti si referenziano a vicenda. Questo può accadere in modo sottile con strutture come liste, dizionari o definizioni di classi più complesse, in cui le istanze mantengono riferimenti reciproci creando un ciclo.
Come visto nei fondamenti, Python ha un garbage collector aggiuntivo per rilevare e pulire i riferimenti circolari. Tuttavia, fare affidamento su questo meccanismo può portare a un maggiore uso di memoria e inefficienze:
Considera un caso tipico di una struttura ad albero in cui ogni nodo mantiene un riferimento ai figli e, opzionalmente, al genitore. Questo collegamento genitore-figlio può facilmente creare riferimenti circolari.
class TreeNode:
   def __init__(self, value, parent=None):
       self.value = value
       self.parent = parent
       self.children = []
   def add_child(self, child):
       child.parent = self  # Set parent reference
       self.children.append(child)

root = TreeNode("root")
child = TreeNode("child1", root)
root.add_child(child)
In questo esempio, la radice root fa riferimento al child tramite la lista children, e il child fa riferimento alla root tramite l’attributo parent. Questa configurazione può creare un riferimento circolare senza ulteriori interventi.
I riferimenti deboli sono un modo efficace per interrompere o prevenire riferimenti circolari senza ridisegnare l’intera struttura dati.
Il modulo weakref di Python consente un riferimento a un oggetto che non incrementa il suo conteggio dei riferimenti. Questo riferimento debole non impedisce che l’oggetto venga garbage-collected, prevenendo le perdite di memoria associate ai riferimenti circolari.
Ecco come possiamo modificare la classe precedente per usare riferimenti deboli:
import weakref

class TreeNode:
   def __init__(self, value, parent=None):
       self.value = value
       self.parent = weakref.ref(parent) if parent else None
       self.children = []
   def add_child(self, child):
       child.parent = weakref.ref(self)
       self.children.append(child)
root = TreeNode("root")
child = TreeNode("child1", root)
root.add_child(child)
In questa classe, l’attributo parent è ora un riferimento debole al nodo genitore. Ciò significa che il nodo genitore può essere garbage-collected anche se il nodo figlio esiste ancora, purché non ci siano altri riferimenti forti al genitore.
Questo approccio previene in modo efficace i problemi di memory leak tipici dei riferimenti circolari in strutture di questo tipo.
Questo articolo ha introdotto i fondamenti della gestione della memoria in Python e presentato cinque tecniche avanzate per scrivere classi efficienti, con esempi pratici e confronti di memoria. Speriamo che tu possa adottare queste tecniche e best practice nei tuoi progetti per creare applicazioni scalabili ed efficienti.
Ti invitiamo a dare un’occhiata al nostro percorso Python Programming, che copre principi di ingegneria del software e programmazione a oggetti, incluso scrivere codice Python efficiente.
Approfondisci Python con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



