
Khóa học
Nhập môn Python
4 giờ
7.1M
Viết các lớp tối ưu bộ nhớ trong Python là điều cần thiết để phát triển ứng dụng vững chắc hoạt động tốt dưới nhiều ràng buộc hệ thống. Sử dụng bộ nhớ hiệu quả giúp tăng tốc độ chạy và cải thiện khả năng mở rộng nhờ tiêu thụ ít tài nguyên hơn, đặc biệt quan trọng trong môi trường có dung lượng bộ nhớ hạn chế.
Trong bài viết này, tôi sẽ giới thiệu các nguyên lý cơ bản về quản lý bộ nhớ trong Python và trình bày những kỹ thuật thực tiễn để viết các lớp tối ưu bộ nhớ. Dù bạn đang xây dựng hệ thống phức tạp hay các script đơn giản, những hiểu biết này sẽ giúp bạn viết mã Python gọn gàng và hiệu quả hơn.
Hệ thống quản lý bộ nhớ của Python rất tinh vi và được thiết kế để đơn giản hóa phát triển bằng cách xử lý sự phức tạp của các thao tác bộ nhớ. Hệ thống này cần thiết để đảm bảo ứng dụng Python chạy hiệu quả.
Heap riêng tư là trung tâm của quản lý bộ nhớ trong Python. Đây là nơi lưu trữ tất cả đối tượng và cấu trúc dữ liệu của Python. Lập trình viên không thể truy cập trực tiếp vào heap này; thay vào đó, họ tương tác với đối tượng thông qua hệ thống quản lý bộ nhớ của Python.
Hệ thống quản lý bộ nhớ sử dụng:
Python áp dụng cách tiếp cận kép cho việc thu gom rác:
Hiểu và tối ưu hóa việc sử dụng bộ nhớ rất quan trọng để duy trì hiệu năng ứng dụng.
Python cung cấp nhiều công cụ profiling bộ nhớ, mang lại góc nhìn vượt ra ngoài gỡ lỗi tiêu chuẩn, giúp nhà phát triển xác định và khắc phục điểm kém hiệu quả về bộ nhớ:
Chúng ta sẽ dùng thư viện pympler trong hướng dẫn này, bạn có thể cài đặt bằng trình quản lý gói pip trên terminal:
pip install pymplerBạn có thể đọc thêm về profiling bộ nhớ trong hướng dẫn — Giới thiệu về Memory Profiling trong Python.
Giờ khi đã nắm các kiến thức cơ bản về quản lý bộ nhớ trong Python, hãy xem một số kỹ thuật nâng cao để viết các lớp tối ưu bộ nhớ.
__slots__Trong Python, mỗi thể hiện lớp có một từ điển gọi là __dict__ để lưu biến thể hiện. Điều này cho phép gán biến mới một cách linh hoạt, nhưng có thể gây chi phí bộ nhớ đáng kể, nhất là khi tạo nhiều thể hiện lớp. Bằng cách định nghĩa __slots__, bạn yêu cầu Python cấp chỗ cho một tập thuộc tính cố định, loại bỏ nhu cầu dùng từ điển động.
Dùng __slots__ mang lại hai lợi ích chính:
__slots__ nhanh hơn so với qua từ điển nhờ tra cứu trực tiếp, bỏ qua thao tác bảng băm trong truy cập dictionary.Xét một lớp đơn giản biểu diễn điểm trong không gian hai chiều:
class PointWithoutSlots:
   def __init__(self, x, y):
       self.x = x
       self.y = y

class PointWithSlots:
   __slots__ = ('x', 'y')
   def __init__(self, x, y):
       self.x = x
       self.y = y
Trong lớp PointWithoutSlots, mỗi thể hiện có một __dict__ để lưu thuộc tính x và y, trong khi lớp PointWithSlots thì không, dẫn đến ít bộ nhớ hơn cho mỗi thể hiện.
Để minh họa khác biệt về bộ nhớ, hãy tạo một nghìn điểm và đo tổng bộ nhớ dùng bằng gói pympler:
from pympler import asizeof

points_without_slots = [PointWithoutSlots(i, i) for i in range(1000)]
points_with_slots = [PointWithSlots(i, i) for i in range(1000)]

print("Total memory (without __slots__):", asizeof.asizeof(points_without_slots))
print("Total memory (with __slots__):", asizeof.asizeof(points_with_slots))
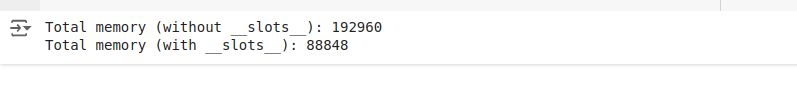
Kết quả đầu ra như sau:
So sánh bộ nhớ với và không dùng slots
Kết quả thường cho thấy thể hiện của PointWithSlots dùng ít bộ nhớ hơn so với PointWithoutSlots, chứng minh hiệu quả của __slots__ trong việc giảm chi phí bộ nhớ cho mỗi thể hiện.
__slots__Mặc dù __slots__ hữu ích cho tối ưu bộ nhớ, chúng cũng có một số hạn chế:
__slots__, bạn không thể thêm thuộc tính mới cho thể hiện một cách động.__slots__ được kế thừa, lớp con cũng phải định nghĩa __slots__ để tiếp tục hưởng lợi tối ưu bộ nhớ, điều này có thể làm thiết kế lớp phức tạp hơn. Bất chấp các hạn chế, sử dụng __slots__ là công cụ mạnh để tối ưu bộ nhớ trong ứng dụng Python, đặc biệt khi môi trường bị ràng buộc bộ nhớ nghiêm ngặt hoặc số lượng thể hiện rất lớn.
Các mẫu thiết kế tối ưu bộ nhớ là giải pháp kiến trúc giúp tối ưu việc sử dụng và quản lý bộ nhớ trong ứng dụng Python.
Hai mẫu đặc biệt hiệu quả cho thiết kế lớp là Flyweight và Singleton. Khi triển khai đúng trong bối cảnh có nhiều thể hiện lớp hoặc dữ liệu dùng chung, chúng có thể cắt giảm mạnh mức tiêu thụ bộ nhớ.
Mẫu Flyweight hoạt động bằng cách chia sẻ phần trạng thái chung giữa nhiều đối tượng thay vì giữ toàn bộ dữ liệu trong từng đối tượng, nhờ đó giảm đáng kể dấu chân bộ nhớ tổng thể.
Xem lớp biểu diễn hình tròn đồ họa trong ứng dụng vẽ, mỗi hình tròn có màu, bán kính và tọa độ. Với Flyweight, màu và bán kính — vốn có thể dùng chung cho nhiều hình tròn — được lưu trong các đối tượng dùng chung:
class Circle:
   # Flyweight object
   def __init__(self, color):
       self.color = color
   def draw(self, radius, x, y):
       print(f"Drawing a {self.color} circle with radius {radius} at ({x},{y})")

class CircleFactory:
   # Factory to manage Flyweight objects
   _circles = {}
   @classmethod
   def get_circle(cls, color):
       if not cls._circles.get(color):
           cls._circles[color] = Circle(color)
       return cls._circles[color]
Trong ví dụ này, nhiều thể hiện hình tròn chia sẻ đối tượng Circle từ CircleFactory dựa trên màu, đảm bảo bộ nhớ được dùng hiệu quả hơn bằng cách chỉ lưu dữ liệu màu một lần.
Hãy dùng lớp này để tạo thể hiện và xem cách tiết kiệm bộ nhớ.
import sys

factory = CircleFactory()
circle1 = factory.get_circle("Red")
circle2 = factory.get_circle("Red")
circle3 = factory.get_circle("Blue")

print("Memory address of circle1:", id(circle1))
print("Memory address of circle2:", id(circle2))
print("Memory address of circle3:", id(circle3))
print ("-----------------------------")
print("Memory used by circle1:", sys.getsizeof(circle1))
print("Memory used by circle2:", sys.getsizeof(circle2))
print("Memory used by circle3:", sys.getsizeof(circle3))
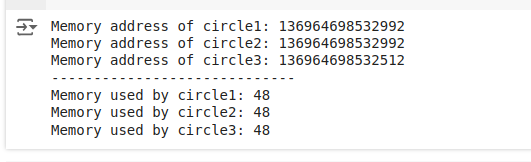
Kết quả đầu ra như sau:
Mức sử dụng bộ nhớ cho mẫu thiết kế flyweight
Ta thấy circle1 và circle2 có cùng địa chỉ bộ nhớ, nghĩa là chúng thực sự là cùng một đối tượng (dùng chung thể hiện cho màu “Red”). circle3 có địa chỉ khác vì nó là hình tròn màu khác (“Blue”).
circle1 và circle2 là cùng một thể hiện cho thấy CircleFactory đã chia sẻ thành công thể hiện Circle giữa hai đối tượng này. Đây là chỗ hiệu quả bộ nhớ phát huy: nếu có một nghìn hình tròn màu đỏ dùng Flyweight, tất cả sẽ dùng chung một thể hiện Circle cho màu, thay vì mỗi cái có một thể hiện riêng, từ đó tiết kiệm đáng kể bộ nhớ.
Mẫu Singleton đảm bảo một lớp chỉ có duy nhất một thể hiện và cung cấp điểm truy cập toàn cục tới nó. Mẫu này hữu ích để quản lý cấu hình hoặc tài nguyên dùng chung trong toàn ứng dụng, giảm chi phí bộ nhớ bằng cách tránh nhân bản tài nguyên/cấu hình ở nhiều nơi.
Xem lớp Database sau:
class Database:
   _instance = None
   def __new__(cls):
       if cls._instance is None:
           cls._instance = super(Database, cls).__new__(cls)
           # Initialize any attributes of the instance here
       return cls._instance
   def connect(self):
       # method to simulate database connection
       return "Connection established"
Trong triển khai này, lớp Database đảm bảo dù được khởi tạo bao nhiêu lần, chỉ một thể hiện chung được dùng, tiết kiệm bộ nhớ bằng cách tránh tạo nhiều đối tượng giống hệt nhau.
Ta có thể kiểm tra bằng đoạn mã sau:
db1 = Database()
print(db1.connect())
db2 = Database()
print(db1 is db2)
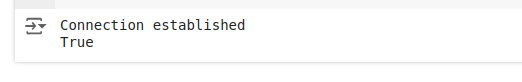
Kết quả đầu ra như sau:
Tạo thể hiện cho mẫu thiết kế singleton
Kết quả “True” cho biết biến db1 và db2 cùng tham chiếu tới một thể hiện.
Những mẫu trên cho thấy thiết kế cẩn trọng có thể cải thiện đáng kể hiệu quả bộ nhớ. Bằng cách lựa chọn và triển khai mẫu phù hợp, nhà phát triển có thể tối ưu ứng dụng Python gọn nhẹ và hiệu năng hơn.
Chọn đúng kiểu dữ liệu dựng sẵn trong Python có thể ảnh hưởng lớn tới hiệu quả bộ nhớ. Các kiểu dựng sẵn được tối ưu cho hiệu năng và bộ nhớ nhờ cách hiện thực bên trong trình thông dịch Python.
Ví dụ, do đặc tính riêng, tuple và set có thể tiết kiệm bộ nhớ hơn list và dictionary cho một số trường hợp dùng cụ thể.
Tuple thường dùng ít bộ nhớ hơn list vì chúng có kích thước cố định và không thể thay đổi sau khi tạo, cho phép Python tối ưu lưu trữ trong bộ nhớ. Với các lớp xử lý dữ liệu không cần chỉnh sửa sau khi tạo, tuple là lựa chọn tuyệt vời.
Xem hai lớp Polygon đơn giản, một dùng tuple và một dùng list để lưu giá trị:
class PolygonWithTuple:
   def __init__(self, points):
       self.points = tuple(points)  # Storing points as a tuple
   def display_points(self):
       return self.points

class PolygonWithList:
   def __init__(self, points):
       self.points = list(points)  # Storing points as a list
   def display_points(self):
       return self.points
Ta có thể tạo thể hiện của cả hai lớp để so sánh mức sử dụng bộ nhớ:
from pympler import asizeof

points = [(1, 2), (3, 4), (5, 6), (7, 8)]

# Creating instances of each class
polygon_tuple = PolygonWithTuple(points)
polygon_list = PolygonWithList(points)

# Memory usage comparison using pympler
print("Total memory used by Polygon with Tuple:", asizeof.asizeof(polygon_tuple))
print("Total memory used by Polygon with List:", asizeof.asizeof(polygon_list))
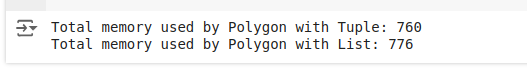
Kết quả đầu ra như sau:
So sánh bộ nhớ giữa tuples và lists
Kết quả cho thấy tuple thường dùng ít bộ nhớ hơn list, khiến lớp PolygonWithTuple hiệu quả hơn cho dữ liệu cố định, không thay đổi như tọa độ hình học.
Trong Python, generator là công cụ mạnh để quản lý bộ nhớ hiệu quả, nhất là khi làm việc với tập dữ liệu lớn.
Generator cho phép xử lý dữ liệu từng phần tử một, chỉ nạp những gì cần thiết vào bộ nhớ tại mỗi thời điểm. Cách đánh giá lười này hữu ích khi xử lý lượng dữ liệu lớn nhưng chỉ cần xử lý từng phần nhỏ, từ đó giảm dấu chân bộ nhớ tổng thể.
Giả sử một ứng dụng cần xử lý tập dữ liệu lớn về hồ sơ người dùng, như tính tuổi trung bình. Thay vì nạp toàn bộ hồ sơ vào list (có thể tiêu tốn nhiều bộ nhớ), một generator có thể xử lý từng bản ghi một.
def process_records(file_name):
   """Generator that yields user ages from a file one at a time."""
   with open(file_name, 'r') as file:
       for line in file:
           user_data = line.strip().split(',')
           yield int(user_data[1])

def average_age(file_name):
   """Calculate the average age from user records."""
   total_age = 0
   count = 0
   for age in process_records(file_name):
       total_age += age
       count += 1
   return total_age / count if count else 0

print("Average Age:", average_age('user_data.csv'))
Trong ví dụ này, hàm generator process_records() đọc file từng dòng, chuyển dữ liệu liên quan thành số nguyên và yield. Điều này nghĩa là tại mỗi thời điểm chỉ giữ một dòng dữ liệu trong bộ nhớ, giảm thiểu sử dụng bộ nhớ. Hàm average_age() tiêu thụ generator, cộng dồn tổng tuổi và số lượng mà không cần nạp toàn bộ dữ liệu vào bộ nhớ cùng lúc.
Nhờ cách đánh giá lười, ta có thể tiết kiệm bộ nhớ và tăng độ phản hồi cũng như khả năng mở rộng cho ứng dụng.
Tham chiếu vòng xảy ra khi hai hoặc nhiều đối tượng tham chiếu lẫn nhau. Điều này có thể xuất hiện tinh vi với các cấu trúc như list, dictionary, hoặc các định nghĩa lớp phức tạp nơi các thể hiện giữ tham chiếu đến nhau, tạo thành vòng lặp.
Như đã thấy ở phần cơ bản, Python có bộ thu gom rác bổ sung để phát hiện và dọn dẹp tham chiếu vòng. Tuy nhiên, phụ thuộc vào cơ chế này có thể dẫn đến tăng sử dụng bộ nhớ và kém hiệu quả:
Xem trường hợp sử dụng điển hình trong cấu trúc dạng cây, nơi mỗi nút có thể giữ tham chiếu đến con và tùy chọn tham chiếu đến cha. Liên kết cha–con này dễ tạo tham chiếu vòng.
class TreeNode:
   def __init__(self, value, parent=None):
       self.value = value
       self.parent = parent
       self.children = []
   def add_child(self, child):
       child.parent = self  # Set parent reference
       self.children.append(child)

root = TreeNode("root")
child = TreeNode("child1", root)
root.add_child(child)
Trong ví dụ này, root tham chiếu child qua danh sách children, và child tham chiếu root qua thuộc tính parent. Thiết lập này có thể tạo tham chiếu vòng mà không cần thêm thao tác nào nữa.
Weak reference là cách hiệu quả để phá vỡ hoặc ngăn tham chiếu vòng mà không cần thiết kế lại toàn bộ cấu trúc dữ liệu.
Mô-đun weakref của Python cho phép tạo tham chiếu đến đối tượng mà không tăng số đếm tham chiếu. Tham chiếu yếu này không ngăn đối tượng được thu gom rác, từ đó tránh rò rỉ bộ nhớ do tham chiếu vòng.
Dưới đây là cách sửa lớp trước đó để dùng weak reference:
import weakref

class TreeNode:
   def __init__(self, value, parent=None):
       self.value = value
       self.parent = weakref.ref(parent) if parent else None
       self.children = []
   def add_child(self, child):
       child.parent = weakref.ref(self)
       self.children.append(child)
root = TreeNode("root")
child = TreeNode("child1", root)
root.add_child(child)
Trong lớp này, thuộc tính parent giờ là weak reference tới nút cha. Nghĩa là nút cha có thể được thu gom rác ngay cả khi nút con còn tồn tại, miễn là không có tham chiếu mạnh nào khác tới cha.
Cách tiếp cận này ngăn hiệu quả các vấn đề rò rỉ bộ nhớ thường thấy với tham chiếu vòng trong cấu trúc như vậy.
Bài viết đã giới thiệu các nguyên lý quản lý bộ nhớ trong Python và trình bày năm kỹ thuật nâng cao để viết các lớp tối ưu bộ nhớ, kèm ví dụ thực tiễn và so sánh bộ nhớ. Hy vọng bạn sẽ áp dụng những kỹ thuật và thực hành tốt này vào dự án để xây dựng ứng dụng có khả năng mở rộng và hiệu quả.
Chúng tôi khuyến khích bạn khám phá lộ trình Python Programming, bao quát nguyên tắc kỹ thuật phần mềm và lập trình hướng đối tượng, bao gồm viết mã Python hiệu quả.
Tìm hiểu thêm về Python với các khóa học này!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
