
Cours
Introduction à Python
4 h
7.1M
Écrire des classes économes en mémoire en Python est essentiel pour développer des applications robustes, performantes et adaptées à des contraintes systèmes variées. Une utilisation efficace de la mémoire accélère l’exécution et améliore la scalabilité en consommant moins de ressources, un point clé dans les environnements à mémoire limitée.
Dans cet article, je vous présente les fondamentaux de la gestion mémoire en Python et différentes techniques pratiques pour écrire des classes économes en mémoire. Que vous développiez des systèmes complexes ou de simples scripts, ces bonnes pratiques vous aideront à produire un code Python plus propre et plus efficace.
Le système de gestion mémoire de Python est sophistiqué et simplifie le développement en prenant en charge la complexité des opérations mémoire. Ce mécanisme est indispensable pour garantir que les applications Python tournent efficacement.
Au cœur de la gestion mémoire de Python se trouve le tas privé (private heap), où sont stockés tous les objets et structures de données. Les programmeurs n’y accèdent pas directement : ils manipulent les objets via le système de gestion mémoire de Python.
Ce système repose notamment sur :
Python combine deux approches pour le ramasse-miettes :
Comprendre et optimiser la consommation mémoire est crucial pour préserver les performances d’une application.
Python propose plusieurs outils de profilage mémoire, qui vont au‑delà du débogage standard et aident à repérer les inefficiences :
Nous utiliserons la bibliothèque pympler dans ce tutoriel. Installez‑la avec pip dans votre terminal :
pip install pymplerPour aller plus loin : Introduction au profilage mémoire en Python.
Maintenant que nous avons vu les bases, examinons des techniques avancées pour écrire des classes économes en mémoire.
__slots__En Python, chaque instance possède un dictionnaire __dict__ pour stocker ses variables d’instance. Cette flexibilité a un coût mémoire important lorsque l’on crée de nombreuses instances. En définissant __slots__, vous demandez à Python d’allouer un ensemble fixe d’attributs, supprimant le besoin du dictionnaire dynamique.
L’usage de __slots__ apporte deux bénéfices majeurs :
__slots__ est plus direct et évite les opérations de table de hachage propres aux dictionnaires.Considérons une classe simple représentant un point en deux dimensions :
class PointWithoutSlots:
   def __init__(self, x, y):
       self.x = x
       self.y = y

class PointWithSlots:
   __slots__ = ('x', 'y')
   def __init__(self, x, y):
       self.x = x
       self.y = y
Dans la classe PointWithoutSlots, chaque instance possède un __dict__ pour stocker les attributs x et y, tandis que PointWithSlots n’en a pas, ce qui réduit la mémoire utilisée par instance.
Pour illustrer la différence, créons mille points et mesurons la mémoire totale avec pympler :
from pympler import asizeof

points_without_slots = [PointWithoutSlots(i, i) for i in range(1000)]
points_with_slots = [PointWithSlots(i, i) for i in range(1000)]

print("Total memory (without __slots__):", asizeof.asizeof(points_without_slots))
print("Total memory (with __slots__):", asizeof.asizeof(points_with_slots))
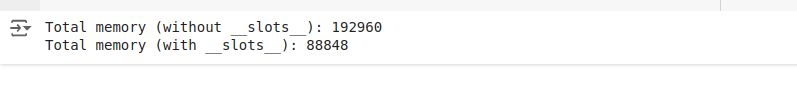
La sortie obtenue est :
Comparaison de l’utilisation mémoire avec et sans slots
On constate généralement que les instances de PointWithSlots consomment moins de mémoire que celles de PointWithoutSlots, ce qui illustre l’efficacité de __slots__ pour réduire le surcoût mémoire par instance.
__slots__Bien que bénéfiques, les __slots__ présentent des limites :
__slots__ est héritée, la sous‑classe doit aussi définir ses __slots__ pour conserver le gain mémoire, ce qui peut compliquer la conception.Malgré ces limites, __slots__ reste un levier puissant pour optimiser la mémoire, notamment dans des contextes à fortes contraintes ou avec un très grand nombre d’instances.
Certains design patterns favorisent une meilleure utilisation et gestion de la mémoire en Python.
Deux patterns particulièrement efficaces pour la conception orientée classes sont Flyweight et Singleton. Bien utilisés dans des scénarios comportant de nombreuses instances ou des données partagées, ils réduisent drastiquement l’empreinte mémoire.
Flyweight consiste à partager les parties communes de l’état entre plusieurs objets plutôt que de dupliquer ces données dans chaque objet, réduisant significativement l’empreinte mémoire globale.
Prenons une application de dessin où chaque cercle possède une couleur, un rayon et des coordonnées. Avec Flyweight, la couleur et le rayon, souvent partagés, peuvent être stockés dans des objets communs :
class Circle:
   # Flyweight object
   def __init__(self, color):
       self.color = color
   def draw(self, radius, x, y):
       print(f"Drawing a {self.color} circle with radius {radius} at ({x},{y})")

class CircleFactory:
   # Factory to manage Flyweight objects
   _circles = {}
   @classmethod
   def get_circle(cls, color):
       if not cls._circles.get(color):
           cls._circles[color] = Circle(color)
       return cls._circles[color]
Ici, plusieurs cercles partagent l’objet Circle fourni par la CircleFactory selon la couleur : la donnée « couleur » n’est stockée qu’une seule fois.
Créons quelques instances pour observer l’économie mémoire.
import sys

factory = CircleFactory()
circle1 = factory.get_circle("Red")
circle2 = factory.get_circle("Red")
circle3 = factory.get_circle("Blue")

print("Memory address of circle1:", id(circle1))
print("Memory address of circle2:", id(circle2))
print("Memory address of circle3:", id(circle3))
print ("-----------------------------")
print("Memory used by circle1:", sys.getsizeof(circle1))
print("Memory used by circle2:", sys.getsizeof(circle2))
print("Memory used by circle3:", sys.getsizeof(circle3))
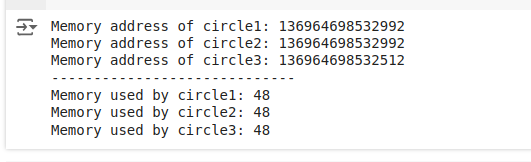
La sortie obtenue est :
Utilisation mémoire pour le pattern Flyweight
On voit que circle1 et circle2 partagent la même adresse mémoire : ils correspondent au même objet (instance partagée pour « Red »). circle3 a une adresse différente car il s’agit d’une autre couleur (« Blue »).
circle1 et circle2 étant la même instance, la CircleFactory partage bien l’objet Circle. Avec mille cercles rouges, une seule instance porterait la couleur, au lieu d’en dupliquer mille : économie mémoire substantielle.
Singleton garantit qu’une classe ne possède qu’une seule instance et offre un point d’accès global. Idéal pour des configurations ou ressources partagées, il évite de répliquer des objets identiques et réduit ainsi le surcoût mémoire.
Considérez la classe Database suivante :
class Database:
   _instance = None
   def __new__(cls):
       if cls._instance is None:
           cls._instance = super(Database, cls).__new__(cls)
           # Initialize any attributes of the instance here
       return cls._instance
   def connect(self):
       # method to simulate database connection
       return "Connection established"
Ici, quelle que soit la façon dont vous l’instanciez, une seule instance partagée est utilisée, ce qui évite de dupliquer des objets identiques en mémoire.
Vérifions :
db1 = Database()
print(db1.connect())
db2 = Database()
print(db1 is db2)
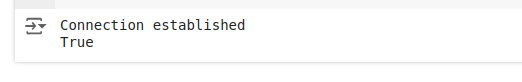
La sortie est :
Création d’instance pour le pattern Singleton
La valeur « True » indique que les variables db1 et db2 référencent la même instance.
Ces patterns montrent comment un design réfléchi peut améliorer sensiblement l’efficacité mémoire. En choisissant et en implémentant les bons patterns, vous rendez vos applications Python plus sobres et performantes.
Le choix du type intégré approprié en Python peut avoir un impact majeur sur l’efficacité mémoire. Les types intégrés sont optimisés en performance et en mémoire par l’interpréteur.
Selon les cas d’usage, les tuples et les ensembles peuvent être plus économes que les listes et les dictionnaires.
Les tuples utilisent généralement moins de mémoire que les listes grâce à leur taille fixe et immuable, ce qui permet des optimisations internes. Pour des classes manipulant des données figées après création, les tuples sont un excellent choix.
Voici deux classes Polygon, l’une stockant les points dans un tuple, l’autre dans une liste :
class PolygonWithTuple:
   def __init__(self, points):
       self.points = tuple(points)  # Storing points as a tuple
   def display_points(self):
       return self.points

class PolygonWithList:
   def __init__(self, points):
       self.points = list(points)  # Storing points as a list
   def display_points(self):
       return self.points
Créons des instances pour comparer la mémoire utilisée :
from pympler import asizeof

points = [(1, 2), (3, 4), (5, 6), (7, 8)]

# Creating instances of each class
polygon_tuple = PolygonWithTuple(points)
polygon_list = PolygonWithList(points)

# Memory usage comparison using pympler
print("Total memory used by Polygon with Tuple:", asizeof.asizeof(polygon_tuple))
print("Total memory used by Polygon with List:", asizeof.asizeof(polygon_list))
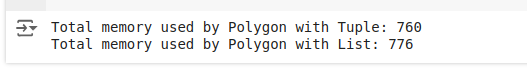
La sortie est :
Comparaison mémoire pour les tuples et les listes
Cette sortie montre que le tuple utilise généralement moins de mémoire que la liste, ce qui rend la classe PolygonWithTuple plus économe pour des données fixes comme des coordonnées.
En Python, les générateurs sont un atout majeur pour gérer la mémoire, surtout avec de gros volumes de données.
Ils traitent les données élément par élément, en ne chargeant en mémoire que ce qui est nécessaire à l’instant T. Cette évaluation « lazy » est idéale quand on manipule beaucoup de données mais qu’on n’en traite qu’une petite partie à la fois.
Supposons une application qui doit calculer l’âge moyen d’utilisateurs à partir d’un gros fichier. Plutôt que de charger toutes les lignes dans une liste (gourmand en mémoire), utilisons un générateur pour traiter chaque enregistrement à la volée.
def process_records(file_name):
   """Generator that yields user ages from a file one at a time."""
   with open(file_name, 'r') as file:
       for line in file:
           user_data = line.strip().split(',')
           yield int(user_data[1])

def average_age(file_name):
   """Calculate the average age from user records."""
   total_age = 0
   count = 0
   for age in process_records(file_name):
       total_age += age
       count += 1
   return total_age / count if count else 0

print("Average Age:", average_age('user_data.csv'))
Ici, la fonction génératrice process_records() lit le fichier ligne par ligne, extrait l’âge et le produit. Une seule ligne est donc en mémoire à un instant donné. La fonction average_age() consomme ce flux sans jamais charger l’ensemble du jeu de données.
Grâce à cette évaluation paresseuse, vous économisez de la mémoire et améliorez la réactivité et la scalabilité de vos applications.
Les références circulaires surviennent lorsque deux objets (ou plus) se référencent mutuellement. Cela peut se produire avec des listes, des dictionnaires ou des classes où des instances se pointent les unes les autres.
Comme vu plus haut, Python dispose d’un collecteur cyclique pour détecter et nettoyer ces cycles. Mais s’en remettre à lui peut engendrer des inefficiences :
Prenons une structure d’arbre où chaque nœud référence ses enfants et éventuellement son parent. Ce lien parent‑enfant forme facilement des cycles.
class TreeNode:
   def __init__(self, value, parent=None):
       self.value = value
       self.parent = parent
       self.children = []
   def add_child(self, child):
       child.parent = self  # Set parent reference
       self.children.append(child)

root = TreeNode("root")
child = TreeNode("child1", root)
root.add_child(child)
Ici, root référence child via la liste children, et child référence root via son attribut parent : un cycle potentiel.
Les références faibles (weak references) permettent de rompre/prévenir les cycles sans refondre la structure.
Le module weakref permet de référencer un objet sans augmenter son compteur de références. L’objet référencé peut donc être collecté, évitant les fuites liées aux cycles.
Voici une version modifiée utilisant des références faibles :
import weakref

class TreeNode:
   def __init__(self, value, parent=None):
       self.value = value
       self.parent = weakref.ref(parent) if parent else None
       self.children = []
   def add_child(self, child):
       child.parent = weakref.ref(self)
       self.children.append(child)
root = TreeNode("root")
child = TreeNode("child1", root)
root.add_child(child)
L’attribut parent devient une référence faible : le nœud parent peut être collecté dès qu’aucune autre référence forte ne le retient.
Cette approche prévient efficacement les fuites mémoire liées aux références circulaires.
Nous avons passé en revue les fondamentaux de la gestion mémoire en Python et cinq techniques avancées pour écrire des classes économes en mémoire, avec des exemples concrets et des comparaisons. Adoptez ces pratiques pour concevoir des applications plus efficaces et facilement scalables.
Nous vous invitons à découvrir notre parcours Python Programming, qui couvre les principes d’ingénierie logicielle et la programmation orientée objet, ainsi que l’écriture d’un code Python efficace.
Approfondissez Python avec ces cours !
Cours
Cours
Cours
Tutoriel
Derrick Mwiti
10 min
Tutoriel
Stephen Gruppetta
12 min
Tutoriel
Kurtis Pykes
15 min
Tutoriel
Sejal Jaiswal
24 min
Tutoriel
Moez Ali
6 min
Tutoriel
Abid Ali Awan
7 min