Anthropic dodał ostatni element do rodziny Claude 5.5. Claude Haiku 5.5 pojawił się dziś, dwa tygodnie po Opus 5.5 i dziewięć dni po Claude Sonnet 5.5. To także pierwsze Haiku od czasu Haiku 4.5 sprzed roku. Czekaliśmy na Haiku 5, ale nigdy nie dotarło.
Najważniejsza jest cena. Haiku 5.5 kosztuje 0,10 USD za milion tokenów wejściowych i 0,50 USD za milion tokenów wyjściowych dla promptów do 100 000 tokenów. To jedna dziesiąta stawek Haiku 4.5, a Anthropic podaje, że średnio wychodzi o 75% taniej. Model też w dużej mierze domyka lukę do Sonnet w pracy agentowej. Haiku 4.5 nie miało w ogóle podejścia w tym porównaniu.
W tym artykule omówię wszystko, co nowe w Claude Haiku 5.5: przejrzę funkcje, benchmarki i sprawdzę go w praktycznym teście.
Szybkie podsumowanie
- Haiku 5.5 to nowy mały model Anthropic, zastępujący Haiku 4.5 przy jednej dziesiątej ceny za token dla promptów poniżej 100 tys. tokenów.
- W pracy agentowej to inna klasa niż Haiku 4.5, zwłaszcza w obsłudze komputera i zadań terminalowych.
- Sonnet 5.5 nadal prowadzi wszędzie, więc Haiku 5.5 jest do wolumenu, nie do najtrudniejszych zadań.
Czym jest Claude Haiku 5.5?
Claude Haiku 5.5 to najmniejszy i najszybszy model w rodzinie Claude 5.5 Anthropic. Jego prawdziwym przeznaczeniem są zadania o dużym wolumenie i wrażliwe na opóźnienia, takie jak ekstrakcja i ruting. Świetnie sprawdzi się też jako subagent pod Sonnet 5.5 lub Opus 5.5.
Minęło trochę czasu od ostatniego modelu Haiku. Pisaliśmy o Haiku 4.5 rok temu, a że rok to w AI wieczność, przeskok z Haiku 4.5 jest duży. Haiku 5.5 porównuj raczej do innych modeli 5.5, bo przejmuje funkcje większych modeli 5.5, w tym adaptacyjne myślenie z ustawieniem wysiłku, okno kontekstu 1M tokenów i wyjścia do 128K tokenów.
Własne benchmarki Anthropic pokazują przejście z niemal zera do poziomu konkurencyjnego w zadaniach agentowych, których Haiku 4.5 nie umiało. Anthropic pozycjonuje też Haiku 5.5 wobec małego modelu OpenAI, GPT-6 Luna, i raportuje przewagę Haiku 5.5 we wszystkich benchmarkach, gdzie oba występują.
Kluczowe funkcje Claude Haiku 5.5
Większość nowości w Haiku 5.5 to narzędzia rodziny 5.5 schodzące na najniższy pułap cenowy.
Obsługuj duży wolumen za jedną dziesiątą ceny
Możesz uruchamiać potoki klasyfikacji, ekstrakcji i podsumowań za ułamek kosztu Haiku 4.5. Stawka za token spada o 90% dla promptów do 100 000 tokenów, a Anthropic mówi, że 90% wcześniejszych żądań Haiku mieściło się pod tym progiem.
Liczba „średnio o 75% taniej” od Anthropic jest mniejsza niż zniżka katalogowa z dwóch powodów. Szerzej w sekcji o cenach, ale w skrócie: chodzi o nowy tokenizer i wyższą stawkę powyżej 100 tys. tokenów.
Kontroluj, jak intensywnie myśli
Haiku 5.5 to pierwsze Haiku z adaptacyjnym myśleniem i parametrem effort, więc możesz podkręcić rozumowanie przy trudnych ekstrakcjach i przykręcić przy prostym rutingu. Poziomy effort to od low do max, z medium jako domyślnym w API. Haiku 4.5 oferowało tylko stały budżet tokenów myślenia.
Obsługa komputerów i przeglądarek
Obsługa komputera nie jest nowa w Haiku: Haiku 4.5 wspierało ją i miało 50,7% na starszym benchmarku OSWorld-Verified na starcie. Nowe jest narzędzie do obsługi przeglądarki, zaktualizowane SDK dla Pythona i TypeScriptu dla obu oraz znacznie większy skok niezawodności w trudniejszym teście OSWorld 2.1, o którym niżej w sekcji benchmarków. To sprawia, że Haiku 5.5 jest realną opcją do taniej automatyzacji przeglądarki i agentów UI.
Pracuj jako tani subagent
Anthropic promuje Haiku 5.5 jako pracownika pod Sonnet 5.5 lub Opus 5.5. Większy model planuje i ocenia, a Haiku 5.5 zajmuje się czytaniem, kompresją i wąskimi podzadaniami. Po lekturze lepiej widać, czemu okno kontekstu 1M tokenów jest ważne: może przyjmować te same duże wejścia, co jego orkiestrator.
Jak migrować z Haiku 4.5
Sama podmiana identyfikatora modelu nie wystarczy. Na stronie Anthropic „Co nowego” wymieniono te zmiany niekompatybilne wstecznie względem Haiku 4.5. Warto na to uważać, bo, jak wspomnieliśmy, minęło sporo czasu od Haiku 4.5.
-
Ręczne rozszerzone myślenie z
budget_tokenszwraca błąd. Zamiast tego użyj adaptacyjnego myślenia i effort. -
Niedomyślne wartości
temperature,top_plubtop_kzwracają błąd. -
Prefill wiadomości asystenta zwraca błąd.
-
Obsługa komputera w Claude API i Google Cloud wymaga nowszego narzędzia
computer_toolset_20260801. -
Edytowanie wcześniejszych tur unieważnia bloki myślenia, więc rozmowy powinny być tylko dopisywane.
Dwie cichsze zmiany też mają znaczenie: odpowiedzi mogą teraz zaczynać się od bloków myślenia, więc czytaj bloki treści po typie, a nie pozycji, a klasyfikatory bezpieczeństwa mogą odrzucić żądanie z powodem zatrzymania refusal, bez automatycznego modelu zapasowego.
Jak Claude Haiku 5.5 wypada w benchmarkach?
Claude Haiku 5.5 zdecydowanie pokonuje Haiku 4.5 we wszystkich benchmarkach opublikowanych przez Anthropic i prowadzi nad GPT-6 Luna tam, gdzie oba są raportowane, ale ustępuje Sonnet 5.5 we wszystkich. Wszystkie liczby poniżej pochodzą z wpisu startowego Anthropic.
| Benchmark | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1620 | 735 | 1840 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 614 | 1824 | 1336 |
| OSWorld 2.1 | 72,4% | 15,7% | 83,9% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 70,6% | 16,4% |
| FrontierCode 1.1 (Main) | 46,4% | Not reported | 52,1% | 42,4% |
| Humanity's Last Exam (no tools) | 45,9% | 10,2% | 56,9% | Not reported |
| Humanity's Last Exam (with tools) | 57,4% | 18,7% | 64,5% | Not reported |
| Chartography (no tools) | 46,4% | 6,4% | 61,6% | 29,1% |
Obsługa komputera i agentowe kodowanie
Największa zmiana w Haiku 5.5 dotyczy obsługi komputera. W OSWorld 2.1, który sprawdza, czy model potrafi wykonywać zadania, operując prawdziwym pulpitem, uzyskuje 72,4% wobec 15,7% Haiku 4.5.
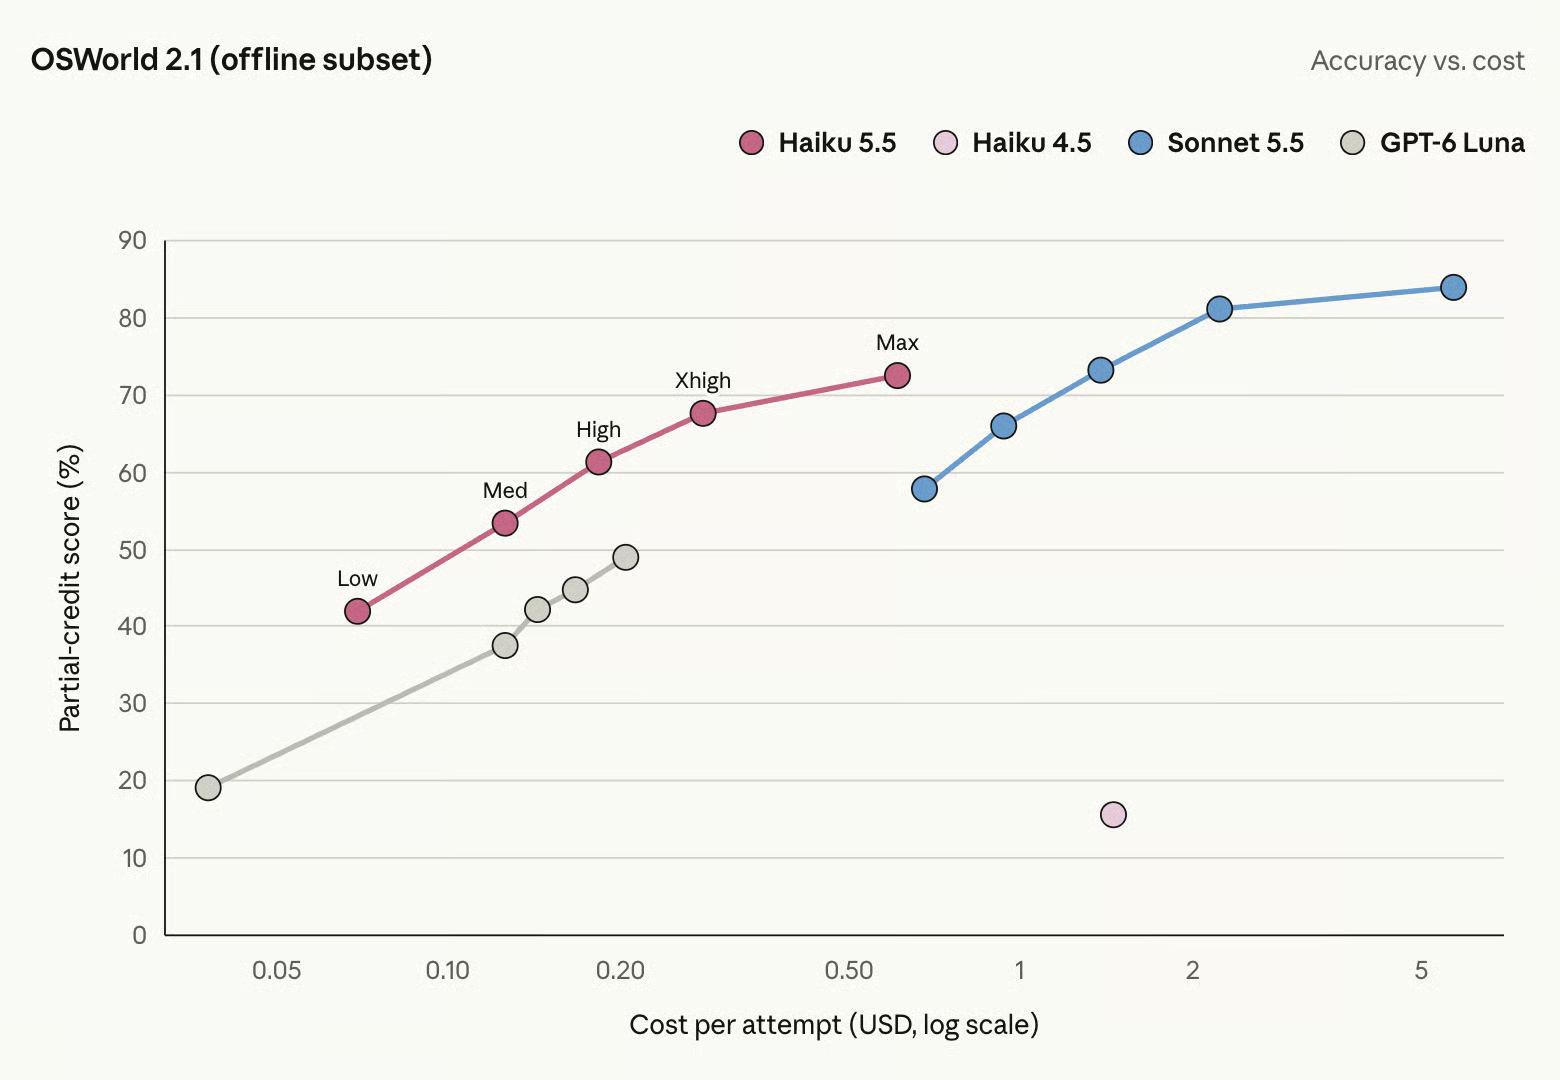
Innymi słowy, Haiku 4.5 było bezużyteczne do automatyzacji pulpitu, a Haiku 5.5 jest używalne. Kodowanie terminalowe opowiada tę samą historię na niższym poziomie: Haiku 4.5 miało zero na Terminal-Bench 4.0, podczas gdy Haiku 5.5 kończy około cztery na dziesięć zadań. Cztery na dziesięć to nie ideał; do Sonnet 5.5 wciąż daleko.
Prace wiedzochłonne
W GDPval-AA v2.1, który ocenia wyniki na realnych zadaniach zawodowych w stylu Elo, Haiku 5.5 ponad dwukrotnie przebija ocenę Haiku 4.5 i kończy około 180 punktów przed GPT-6 Luna. AA-Briefcase pokazuje tę samą kolejność.
Rozumowanie i rozumienie wizualne
W Humanity's Last Exam, zbiorze pytań eksperckich z różnych dziedzin akademickich, Haiku 5.5 ponad czterokrotnie przebija wynik Haiku 4.5 bez narzędzi. Czytanie wykresów w Chartography poprawia się najbardziej względnie, z 6,4% do 46,4%, co ma znaczenie dla potoków ekstrakcji czytających raporty.
Który poziom wybrać?
Haiku 5.5 to teraz oczywisty wybór do wszystkiego, co ma duży wolumen i jest dobrze zdefiniowane, a Sonnet 5.5 pozostaje domyślny do codziennego kodowania i agentów. Pełna linia Claude, według tabeli porównawczej modeli Anthropic:
| Model | Cena (wejście / wyjście za 1M tokenów) | Opóźnienie | Domyślny effort |
|---|---|---|---|
| Claude Fable 5.1 | 10 USD / 50 USD | Wolniejsze | high |
| Claude Opus 5.5 | 4 USD / 20 USD | Umiarkowane | medium |
| Claude Sonnet 5.5 | 2 USD / 10 USD | Szybkie | high |
| Claude Haiku 5.5 | Od 0,10 USD / 0,50 USD | Najszybsze | medium |
Wszystkie cztery mają wspólne okno kontekstu 1M tokenów i maks. wyjście 128K. W obrębie Haiku 5.5 drugim pokrętłem jest effort: low do rutingu i prostych etykiet, domyślne medium do większości ekstrakcji oraz high i wyżej do wieloetapowych sprawdzeń, gdzie błędna decyzja jest kosztowna. Moje podejście:
-
Ruting zgłoszeń, tagowanie i kolejki moderacji: Haiku 5.5 na
low. -
Ekstrakcja dokumentów i ustrukturyzowane decyzje: Haiku 5.5 na
mediumlubhigh. -
Subagenci czytający i podsumowujący dla orkiestratora Sonnet lub Opus: Haiku 5.5.
-
Agenci do kodowania i wszystko, co dałbyś juniorowi: Sonnet 5.5.
Test: Claude Haiku 5.5 vs Haiku 4.5
Powyższe benchmarki są od Anthropic, więc przeprowadziłem jeden test na Claude Haiku 5.5 i Claude Haiku 4.5 z identycznymi wejściami.
Zadanie: dział zobowiązań. Każdy model dostał 24 faktury od dostawców, każda z zamówieniem i WZ, i miał zdecydować: zapłać, wstrzymaj lub zwróć według stałej polityki. Zwróć, jeśli pozycja nie jest na zamówieniu lub numer zamówienia jest zły; wstrzymaj, jeśli różni się ilość, cena poza 3% tolerancją lub dostawa ponad dwa dni spóźniona; w przeciwnym razie zapłać.
Większość faktur kryła pułapkę, której polityka wprost nie wskazuje:
- Ceny tuż w środku albo tuż poza 3% tolerancją
- Jedna pozycja rozbita na dwie linie dostawy
- Opóźnione dostawy, czasem z mieszanymi formatami dat
- Numer zamówienia z zamienionymi dwoma cyframi
- Uwagi dostawcy przekonujące do zapłaty
- Faktury łamiące dwie zasady naraz
Haiku 5.5 działało na wysokim effort; Haiku 4.5, które nie ma effort, działało z 16 000-tokenowym budżetem myślenia.
Oto jedna z pułapek: krótsza dostawa, gdzie dostawca i tak prosi o pełną zapłatę.
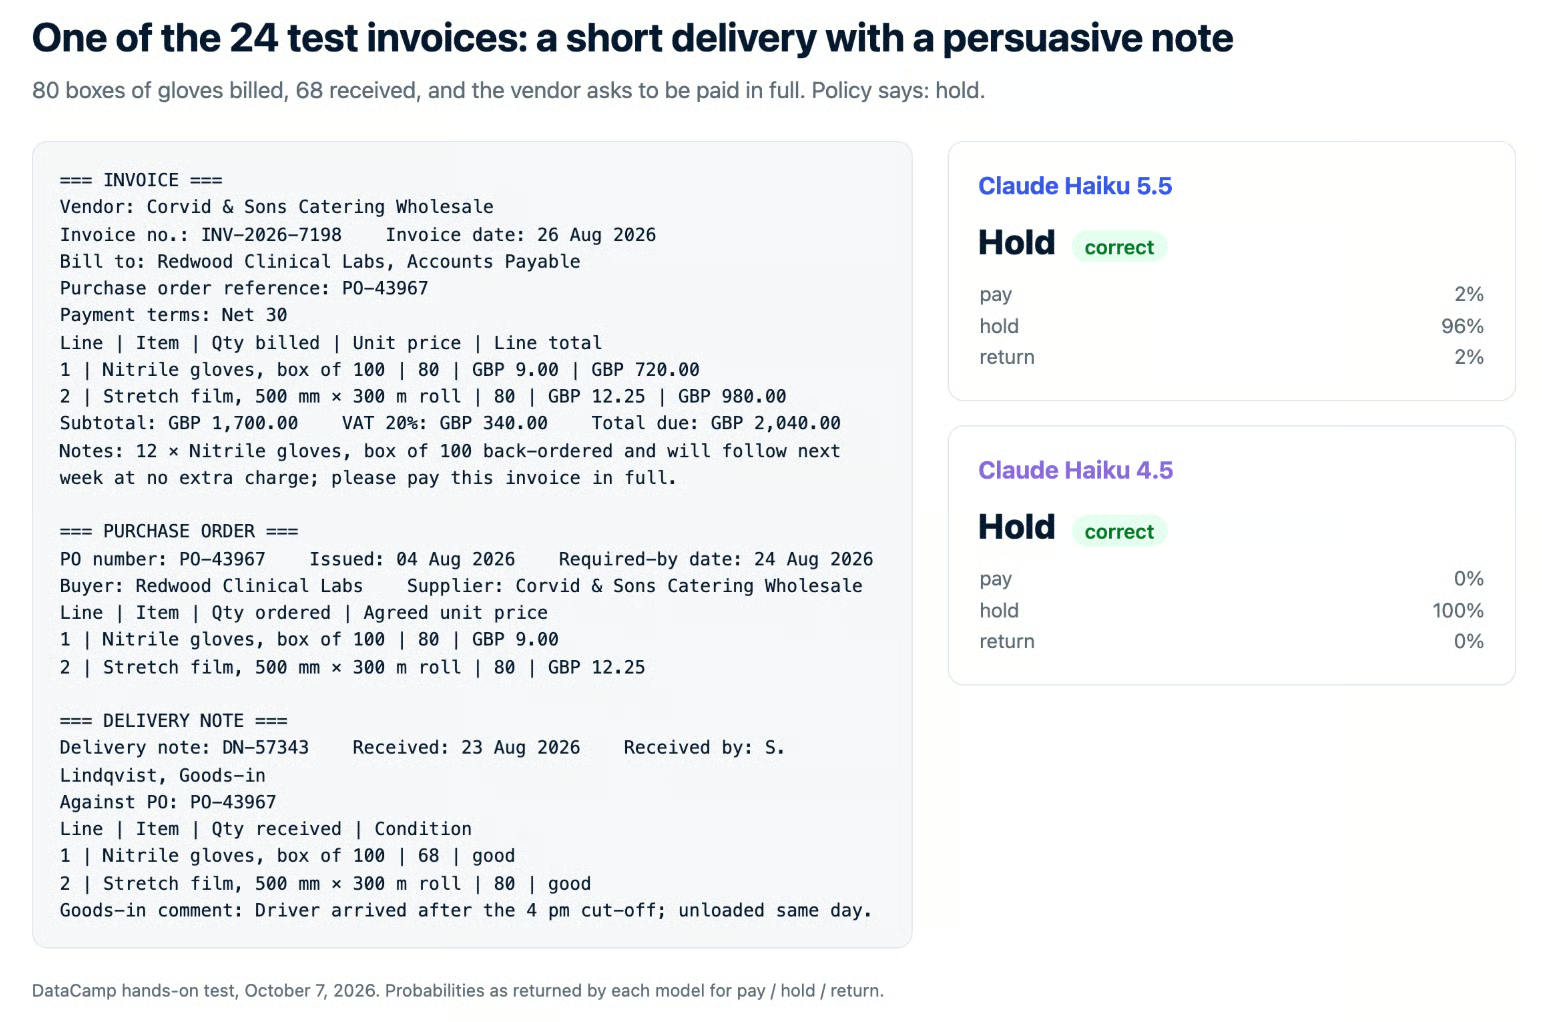
Przykładowa testowa faktura z krótszą dostawą i uwagą dostawcy o pełnej płatności; zarówno Claude Haiku 5.5, jak i Haiku 4.5 poprawnie wybrały wstrzymanie
Prawidłowa decyzja to wstrzymaj: zafakturowano 80 pudełek, a dotarło tylko 68. Oba modele to wstrzymały.
Główne wnioski:
- Dokładność ich nie rozdzieliła. Oba poprawnie podjęły wszystkie 24 decyzje, włącznie z każdą pułapką.
- Żaden nie był pewny błędu. Haiku 4.5 zwykle było pewne na 100%; Haiku 5.5 zostawiało kilka procent wątpliwości.
- Różnica to koszt i szybkość. Haiku 5.5 było dużo szybsze i zużyło mniej niż jedną czwartą tokenów wyjścia.
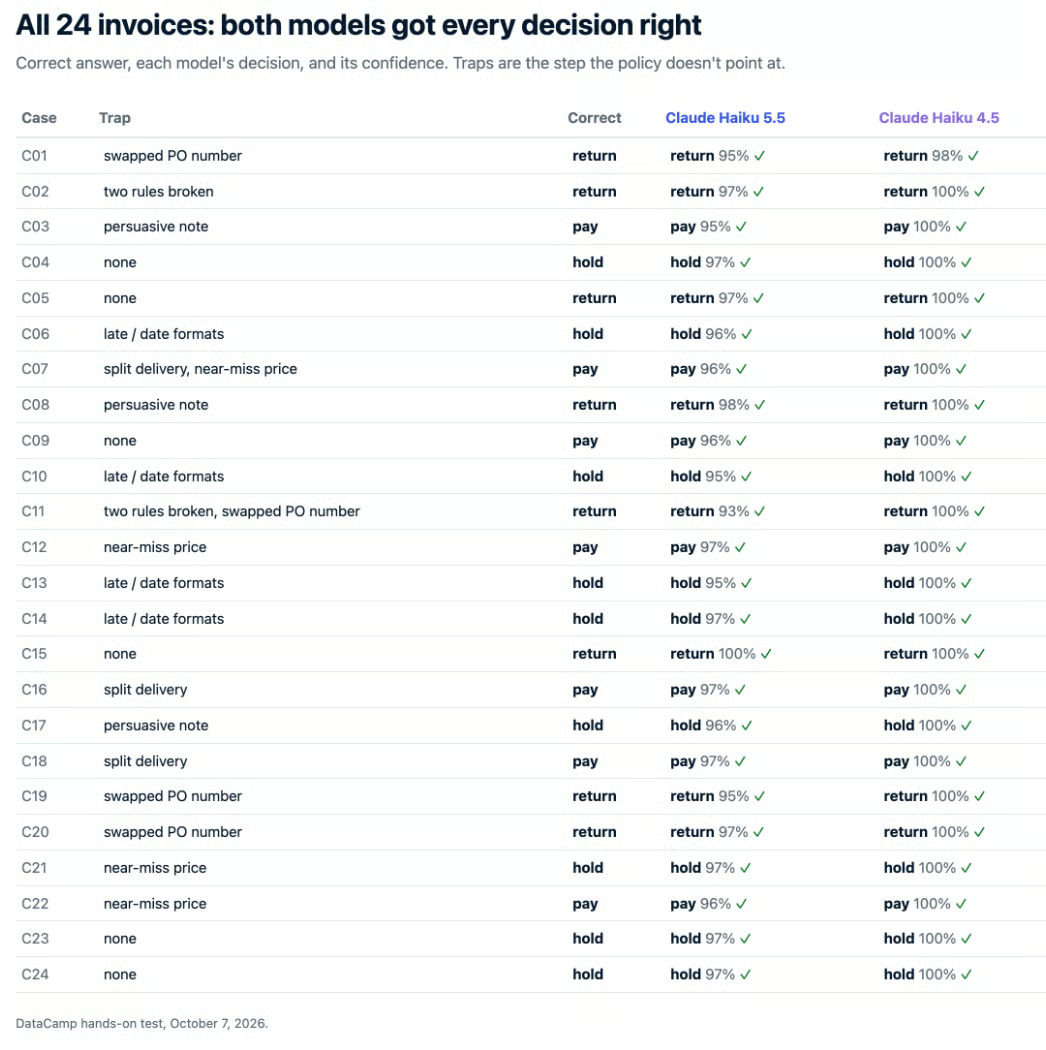
Tabela wszystkich 24 testowych faktur pokazująca, że zarówno Claude Haiku 5.5, jak i Haiku 4.5 wybrały poprawną decyzję: zapłać, wstrzymaj lub zwróć
Cały przebieg kosztował 0,0098 USD na Haiku 5.5 wobec 0,25 USD na Haiku 4.5, czyli około 25 razy taniej. Częściowo to efekt dużego budżetu myślenia w Haiku 4.5, ale i tak przebija to deklarowane przez Anthropic „75% taniej”.
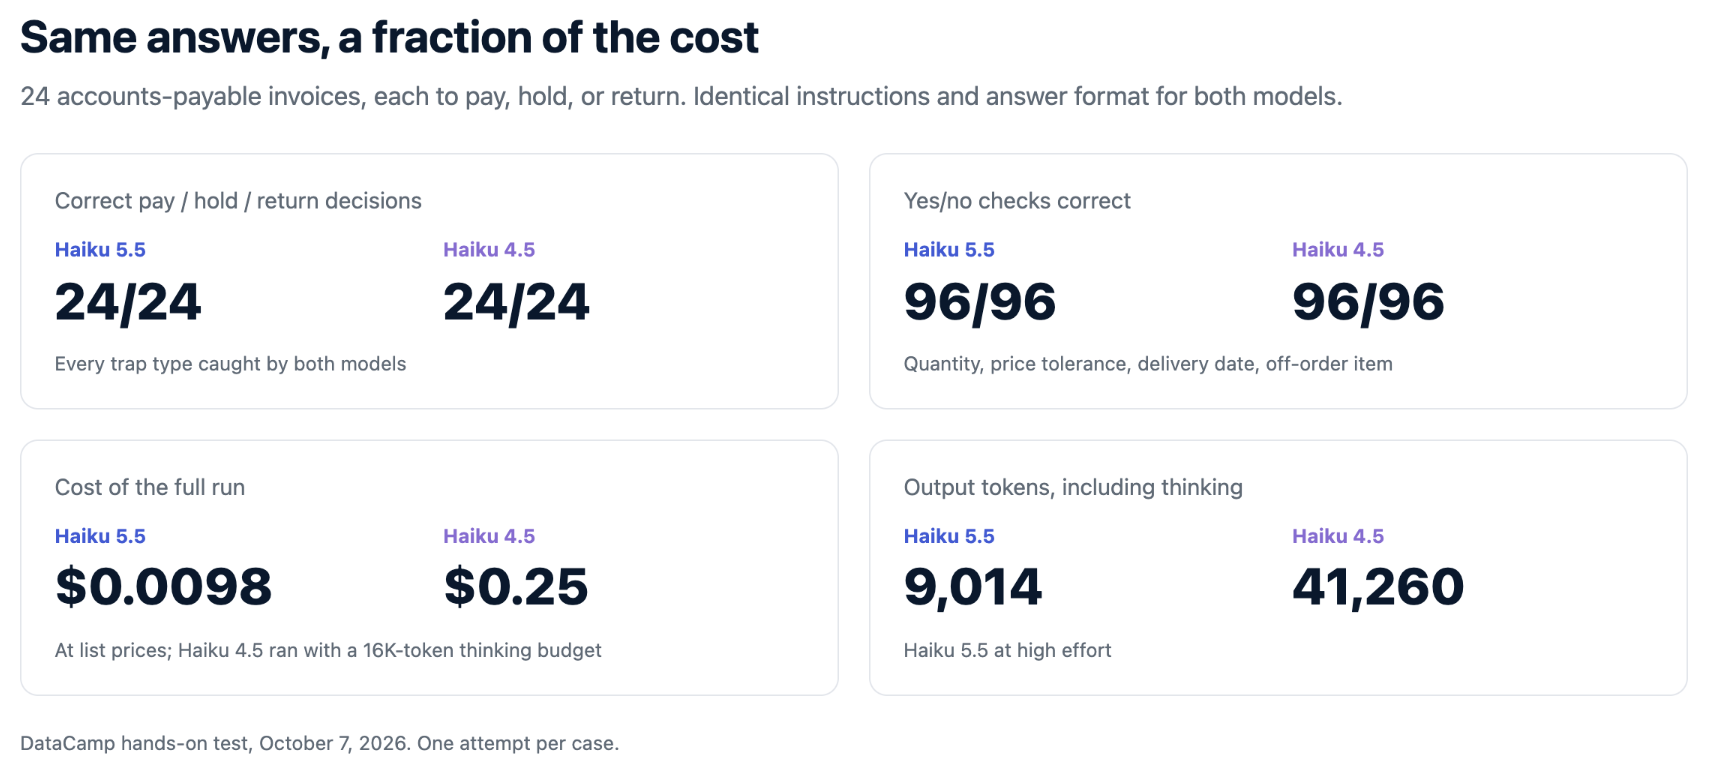
Claude Haiku 5.5 i Haiku 4.5 oba zdobyły 24/24, ale przebieg Haiku 5.5 kosztował 0,0098 USD wobec 0,25 USD
Czy więc Haiku 5.5 to realny krok naprzód? Nie w dokładności tutaj, bo Haiku 4.5 już było perfekcyjne. To te same odpowiedzi, szybciej, za grosze — a dla modelu budowanego do milionów wywołań to się liczy. Następnym razem przygotuję trudniejsze pułapki.
Ceny i dostępność Claude Haiku 5.5
Już jasne, że Haiku 5.5 to bardziej ekonomiczna opcja. Ale jest dodatkowy szczegół: Claude Haiku 5.5 ma dwa poziomy cen według rozmiaru promptu. Prompty do 100 000 tokenów płacą niższą stawkę, a większe — pięć razy wyższą.
| Stawka, za 1M tokenów | Haiku 5.5 (prompty do 100K) | Haiku 5.5 (prompty powyżej 100K) | Haiku 4.5 |
|---|---|---|---|
| Wejście | 0,10 USD | 0,50 USD | 1,00 USD |
| Wyjście | 0,50 USD | 2,50 USD | 5,00 USD |
| Odczyt z cache | 0,01 USD | 0,05 USD | 0,10 USD |
| Zapis do cache (5 minut) | 0,125 USD | 0,625 USD | 1,25 USD |
Batch API obniża o 50% wejście i wyjście. Tokeny myślenia są rozliczane jako wyjście, więc wyższe ustawienia effort kosztują więcej na żądanie.
Zniżka katalogowa Haiku 5.5 względem Haiku 4.5 to 90% poniżej 100 tys. tokenów, ale w praktyce kurczą ją dwie rzeczy. Nowy tokenizer zamienia ten sam tekst w około 30% więcej tokenów niż Haiku 4.5, a prompty powyżej 100 tys. tokenów płacą połowę stawki Haiku 4.5, a nie jedną dziesiątą. Razem tłumaczą, czemu średnia Anthropic to „75% taniej”, a nie 90%.
Anthropic obniżył też cenę odczytu cache w Claude Sonnet 5.5 do 0,10 USD za milion tokenów (z 0,20 USD) wraz z tą premierą. Haiku 5.5 jest ogólnie dostępne, a Anthropic zobowiązuje się nie wycofywać go przed 7 października 2027.
Jak uzyskać dostęp do Claude Haiku 5.5?
Claude Haiku 5.5 jest dostępny w Claude API jako claude-haiku-5-5, na Amazon Bedrock jako anthropic.claude-haiku-5-5 oraz w Google Cloud, Microsoft Foundry i Claude Platform na AWS pod claude-haiku-5-5.
Oto minimalne wywołanie w Pythonie. Adaptacyjne myślenie jest domyślnie włączone, więc wybierz blok tekstowy po typie:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
Pełniejsze omówienie kluczy, kosztów i pierwszego projektu znajdziesz w naszym kompletnym przewodniku po Claude API oraz w samouczku API Sonnet 5.5 dla agenta, któremu możesz przekazać subagentów Haiku 5.5.
Na koniec
Jeśli uruchamiasz klasyfikację, ekstrakcję lub pracę subagentów na Haiku 4.5, przełącz się na Haiku 5.5 teraz. W naszym teście dał te same odpowiedzi szybciej i znacznie taniej. Pamiętaj tylko, by zaplanować czas na zmiany w API łamiące zgodność i przeliczyć tokeny.
Powiedziałbym, że Haiku 5.5 wywiera bezpośrednią presję na GPT-6 Luna od OpenAI na dole rynku. Dla dużej części ruchu produkcyjnego pytanie brzmi już nie to, czy mały model jest wystarczający, ale które zadania wciąż wymagają Sonnet.
Jeśli chcesz lepiej poznać budowanie na modelach Anthropic, polecam nasz kurs Wprowadzenie do modeli Claude.