Anthropic ha completado la familia Claude 5.5 con su última incorporación. Claude Haiku 5.5 llegó hoy, dos semanas después de Opus 5.5 y nueve días después de Claude Sonnet 5.5. También es el primer Haiku desde Haiku 4.5 hace un año. Esperamos Haiku 5, pero nunca llegó.
El gran titular es el precio. Haiku 5.5 cuesta 0,10 $ por millón de tokens de entrada y 0,50 $ por millón de tokens de salida para prompts de hasta 100.000 tokens. Es una décima parte de las tarifas de Haiku 4.5, y Anthropic afirma que, de media, sale un 75% más barato. Además, reduce gran parte de la distancia con Sonnet en trabajo agentivo. Haiku 4.5 ni siquiera entraba en esa conversación.
En este artículo, cubro todo lo nuevo de Claude Haiku 5.5: sus funciones, un repaso a los benchmarks y una prueba práctica para ponerlo a prueba.
La lectura rápida
- Haiku 5.5 es el nuevo modelo pequeño de Anthropic y sustituye a Haiku 4.5 con un precio por token diez veces menor para prompts de menos de 100.000 tokens.
- En trabajo agentivo, sobre todo uso del ordenador y tareas de terminal, juega en otra liga respecto a Haiku 4.5.
- Sonnet 5.5 sigue por delante en todo, así que Haiku 5.5 es para volumen, no para tus tareas más difíciles.
¿Qué es Claude Haiku 5.5?
Claude Haiku 5.5 es el modelo más pequeño y rápido de la familia Claude 5.5 de Anthropic. Su objetivo real es manejar cargas de alto volumen y baja latencia como extracción y enrutado. También encaja perfecto como subagente bajo Sonnet 5.5 u Opus 5.5.
Ha pasado tiempo desde el último Haiku. Escribimos sobre Haiku 4.5 hace un año, y en IA un año es una eternidad, así que el salto es notable. Haiku 5.5 se compara mejor con los otros 5.5 porque hereda sus funciones: pensamiento adaptativo con un ajuste de esfuerzo, una ventana de contexto de 1M de tokens y salidas de hasta 128K tokens.
Los propios benchmarks de Anthropic muestran que pasa de casi cero a ser competitivo en tareas agentivas que Haiku 4.5 no podía abordar. Anthropic también posiciona Haiku 5.5 frente al modelo pequeño de OpenAI, GPT-6 Luna, y reporta a Haiku 5.5 por delante en todos los benchmarks donde ambos aparecen.
Funciones clave de Claude Haiku 5.5
Casi todo lo nuevo en Haiku 5.5 es el arsenal de la familia 5.5 aterrizando en el peldaño más barato.
Ejecuta grandes volúmenes por una décima parte del precio
Puedes ejecutar canalizaciones de clasificación, extracción y resumen por una fracción de lo que costaba Haiku 4.5. La tarifa por token cae un 90% para prompts de hasta 100.000 tokens, y Anthropic dice que el 90% de las solicitudes previas de Haiku entran en ese rango.
La cifra de "75% más barato de media" de Anthropic es menor que el descuento de tarifa por dos motivos. Lo detallo en la sección de precios, pero en resumen: hay un tokenizador nuevo y una tarifa superior por encima de 100K tokens.
Controla cuánto "piensa"
Haiku 5.5 es el primer Haiku con pensamiento adaptativo y el parámetro de esfuerzo, así podrás subir el razonamiento para extracciones complicadas y bajarlo para enrutados sencillos. El esfuerzo va de low a max, con medium como valor predeterminado en la API. Haiku 4.5 solo ofrecía un presupuesto fijo de tokens de pensamiento.
Maneja ordenadores y navegadores
El uso del ordenador no es nuevo en Haiku: Haiku 4.5 lo soportaba y marcó un 50,7% en el viejo benchmark OSWorld-Verified en su lanzamiento. La novedad es una herramienta de uso de navegador, SDKs actualizados de Python y TypeScript para ambos, y un salto notable de fiabilidad en la prueba más exigente OSWorld 2.1, que cubro más abajo en los benchmarks. Esto hace de Haiku 5.5 una opción realista para automatizar navegadores y agentes de interfaz a bajo coste.
Trabaja como subagente barato
Anthropic propone Haiku 5.5 como ejecutor bajo Sonnet 5.5 u Opus 5.5. El modelo mayor planifica y evalúa, y Haiku 5.5 se encarga de la lectura, la compactación y las subtareas acotadas. Tras leer esto, se entiende mejor por qué importa la ventana de 1M de tokens: ahora puede ingerir las mismas entradas grandes que ve su orquestador.
Cómo migrar desde Haiku 4.5
No basta con cambiar el ID del modelo. La página de novedades de Anthropic lista estos cambios incompatibles con Haiku 4.5. Conviene prestarles atención porque, como decíamos, ha pasado tiempo desde Haiku 4.5.
-
El pensamiento extendido manual con
budget_tokensdevuelve un error. Usa pensamiento adaptativo y esfuerzo en su lugar. -
Valores no predeterminados de
temperature,top_potop_kdevuelven un error. -
El pre-relleno de mensajes del asistente devuelve un error.
-
El uso del ordenador en la API de Claude y Google Cloud requiere la herramienta más reciente
computer_toolset_20260801. -
Editar turnos previos invalida los bloques de pensamiento, así que las conversaciones deberían ser solo de anexado.
Dos cambios más discretos también importan: las respuestas ahora pueden empezar con bloques de pensamiento, así que debes leer los bloques por tipo y no por posición; y los clasificadores de seguridad pueden rechazar una solicitud con el motivo de parada refusal, sin modelo de respaldo automático.
¿Cómo rinde Claude Haiku 5.5 en los benchmarks?
Claude Haiku 5.5 supera por mucho a Haiku 4.5 en todos los benchmarks publicados por Anthropic y se sitúa por delante de GPT-6 Luna allí donde ambos aparecen, aunque queda por detrás de Sonnet 5.5 en todos. Todas las cifras siguientes proceden del post de lanzamiento de Anthropic.
| Benchmark | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1620 | 735 | 1840 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 614 | 1824 | 1336 |
| OSWorld 2.1 | 72,4% | 15,7% | 83,9% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 70,6% | 16,4% |
| FrontierCode 1.1 (Main) | 46,4% | No reportado | 52,1% | 42,4% |
| Humanity's Last Exam (sin herramientas) | 45,9% | 10,2% | 56,9% | No reportado |
| Humanity's Last Exam (con herramientas) | 57,4% | 18,7% | 64,5% | No reportado |
| Chartography (sin herramientas) | 46,4% | 6,4% | 61,6% | 29,1% |
Uso del ordenador y programación agentiva
El uso del ordenador es donde más cambia Haiku 5.5. En OSWorld 2.1, que evalúa si un modelo puede completar tareas operando un escritorio real, marca un 72,4% frente al 15,7% de Haiku 4.5.
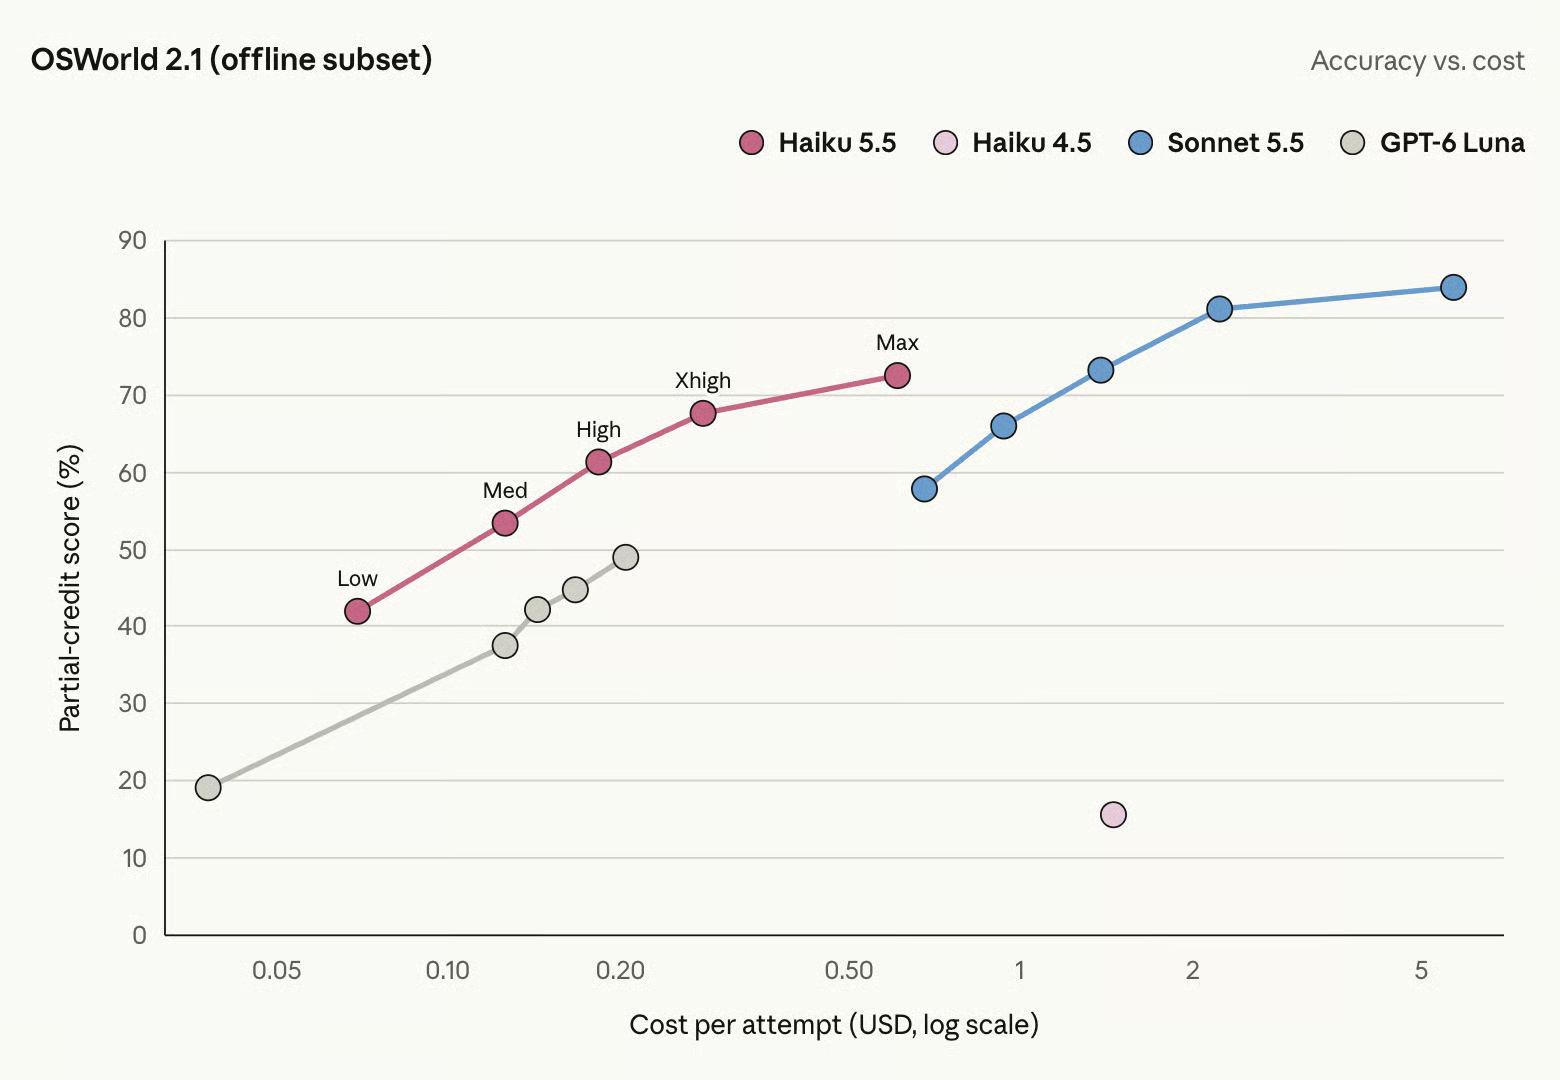
En otras palabras, Haiku 4.5 era inútil para automatizar el escritorio, pero Haiku 5.5 es utilizable. En terminal ocurre lo mismo a menor nivel: Haiku 4.5 sacó cero en Terminal-Bench 4.0, mientras que Haiku 5.5 completa alrededor de cuatro de cada diez tareas. Cuatro de cada diez no es perfecto; todavía queda lejos de Sonnet 5.5.
Trabajo del conocimiento
En GDPval-AA v2.1, que puntúa entregables profesionales reales con un sistema tipo Elo, Haiku 5.5 más que duplica la puntuación de Haiku 4.5 y queda unos 180 puntos por encima de GPT-6 Luna. AA-Briefcase muestra el mismo orden.
Razonamiento y comprensión visual
En Humanity's Last Exam, un conjunto de preguntas de nivel experto en distintas áreas académicas, Haiku 5.5 más que cuadruplica la puntuación de Haiku 4.5 sin herramientas. La lectura de gráficos en Chartography mejora aún más en términos relativos, del 6,4% al 46,4%, clave para canalizaciones de extracción que leen informes.
¿Qué nivel deberías usar?
Haiku 5.5 es ahora la elección obvia para todo lo que sea de alto volumen y bien definido, mientras que Sonnet 5.5 sigue siendo el predeterminado para la programación diaria y agentes. El catálogo completo de Claude, según la tabla comparativa de modelos de Anthropic:
| Modelo | Precio (entrada / salida por 1M de tokens) | Latencia | Esfuerzo predeterminado |
|---|---|---|---|
| Claude Fable 5.1 | 10 $ / 50 $ | Más lenta | high |
| Claude Opus 5.5 | 4 $ / 20 $ | Moderada | medium |
| Claude Sonnet 5.5 | 2 $ / 10 $ | Rápida | high |
| Claude Haiku 5.5 | Desde 0,10 $ / 0,50 $ | La más rápida | medium |
Los cuatro comparten ventana de contexto de 1M de tokens y salida máxima de 128K. Dentro de Haiku 5.5, el esfuerzo es el segundo ajuste: low para enrutado y etiquetas simples, el medium predeterminado para la mayoría de extracciones, y high o más para comprobaciones en varios pasos donde un error sale caro. Mi planteamiento:
-
Enrutado de tickets, etiquetado y colas de moderación: Haiku 5.5 en
low. -
Extracción de documentos y decisiones estructuradas: Haiku 5.5 en
mediumohigh. -
Subagentes que leen y resumen para un orquestador Sonnet u Opus: Haiku 5.5.
-
Agentes de codificación y cualquier cosa que encargarías a un perfil junior: Sonnet 5.5.
Prueba: Claude Haiku 5.5 vs. Haiku 4.5
Los benchmarks anteriores son de Anthropic, así que ejecuté una prueba con Claude Haiku 5.5 y Claude Haiku 4.5 con entradas idénticas.
La tarea: actuar como cuentas a pagar. Cada modelo recibió 24 facturas de proveedores, cada una con su orden de compra y albarán, y debía decidir pagar, retener o devolver según una política fija. Devolver si hay un artículo no incluido en la orden o el número de orden es incorrecto; retener si hay una cantidad, un precio fuera del 3% de tolerancia o una entrega con más de dos días de retraso; si no, pagar.
La mayoría de facturas escondían una trampa que la política no explicita:
- Precios justo dentro o fuera del 3% de tolerancia
- Un artículo dividido en dos líneas de entrega
- Entregas tardías, algunas con formatos de fecha mixtos
- Un número de orden con dos dígitos intercambiados
- Notas del proveedor presionando para pagar
- Facturas que incumplen dos reglas a la vez
Haiku 5.5 se ejecutó con esfuerzo alto; Haiku 4.5, que no tiene ajuste de esfuerzo, usó un presupuesto de 16.000 tokens de pensamiento.
Aquí tienes una de las trampas: una entrega corta donde el proveedor pide que se pague igualmente el total.
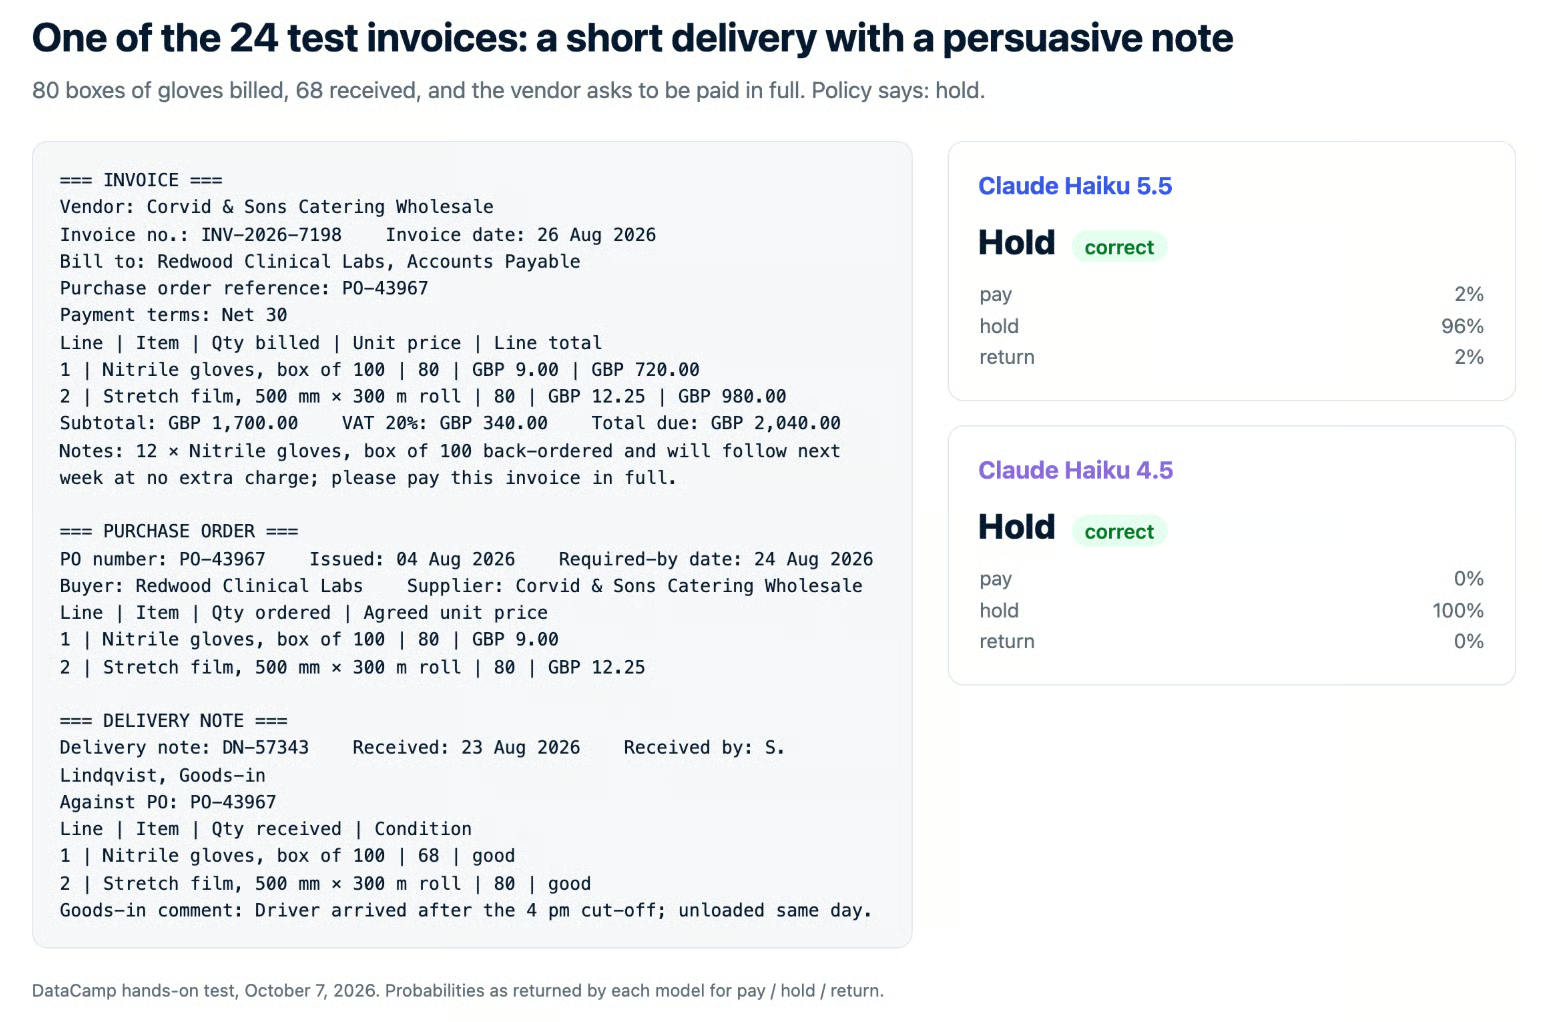
Factura de ejemplo con entrega corta y una nota del proveedor pidiendo el pago completo; tanto Claude Haiku 5.5 como Haiku 4.5 respondieron correctamente retener
La decisión correcta es retener: se facturaron 80 cajas, pero solo llegaron 68. Ambos modelos la retuvieron.
Conclusiones principales:
- La precisión no los diferenció. Ambos acertaron las 24 decisiones, incluidas todas las trampas.
- Ninguno fue rotundamente erróneo. Haiku 4.5 solía estar al 100% de confianza; Haiku 5.5 mantuvo algunos puntos de duda.
- La diferencia estuvo en coste y velocidad. Haiku 5.5 fue mucho más rápido y usó menos de una cuarta parte de los tokens de salida.
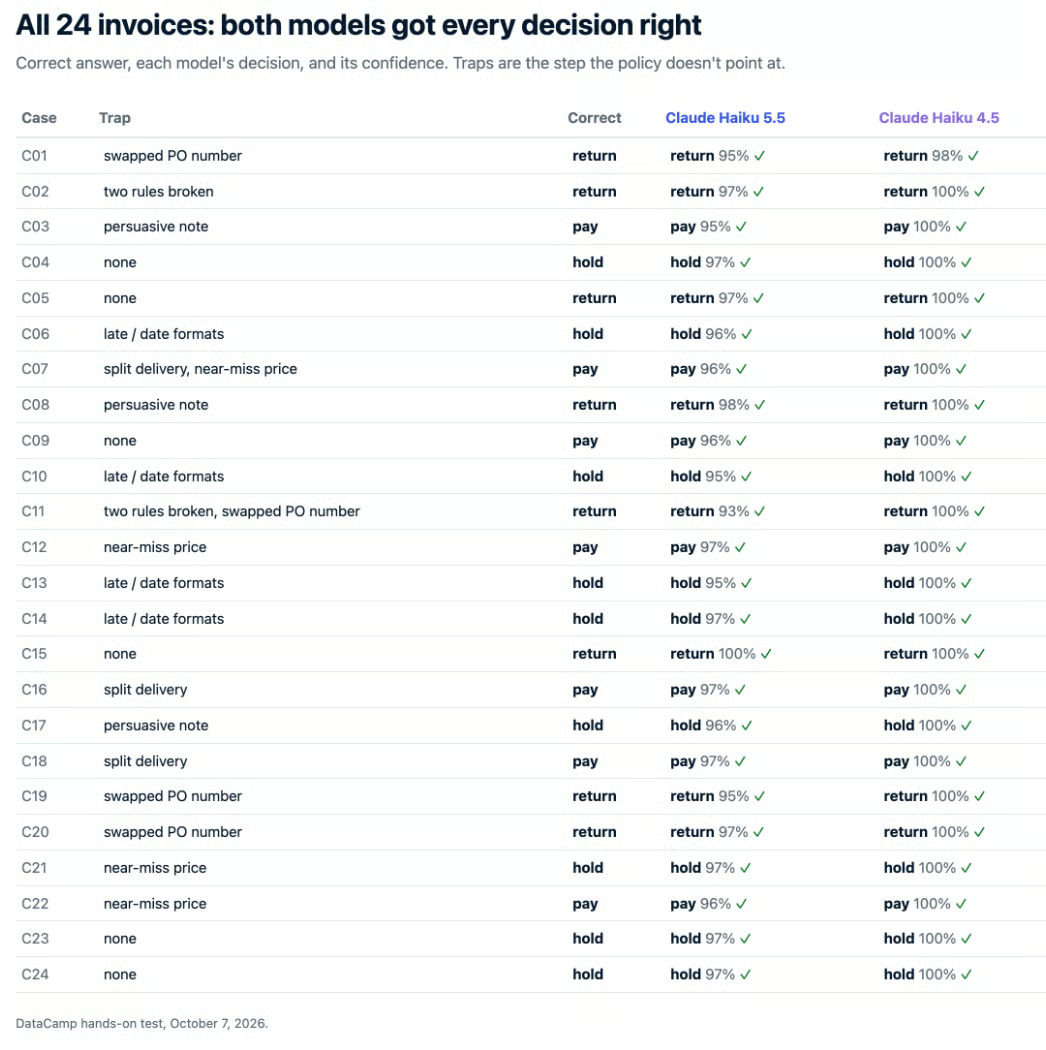
Tabla con las 24 facturas de prueba mostrando que tanto Claude Haiku 5.5 como Haiku 4.5 eligieron correctamente pagar, retener o devolver
La ejecución completa costó 0,0098 $ en Haiku 5.5 frente a 0,25 $ en Haiku 4.5, unas 25 veces más barato. Parte se debe al gran presupuesto de pensamiento de Haiku 4.5, pero aun así mejora el "75% más barato" de Anthropic.
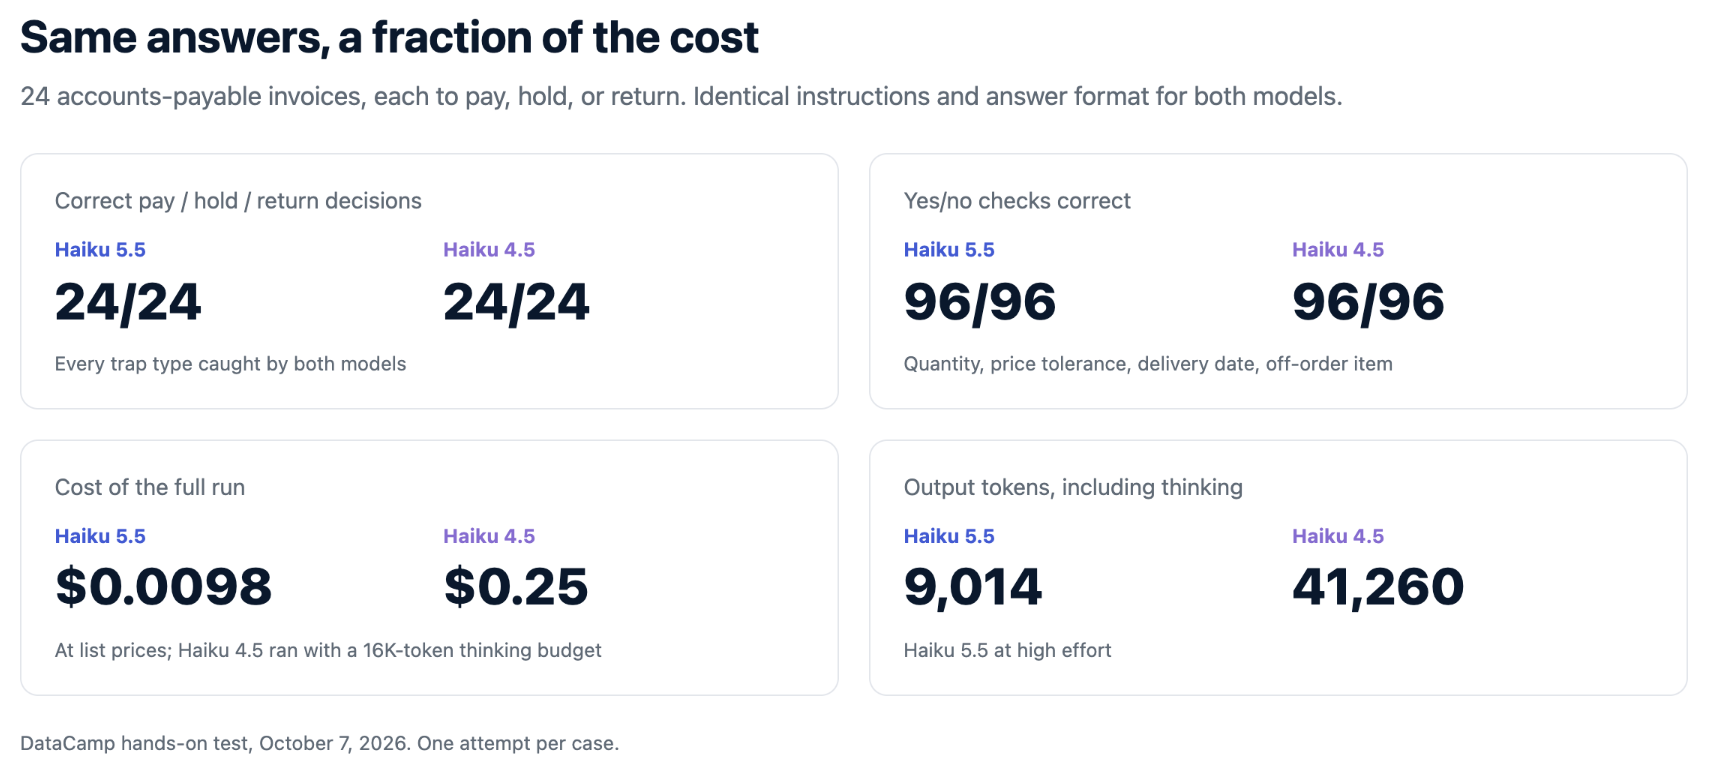
Claude Haiku 5.5 y Haiku 4.5 hicieron 24/24, pero la ejecución con Haiku 5.5 costó 0,0098 $ frente a 0,25 $
Entonces, ¿es Haiku 5.5 un verdadero avance? No en precisión aquí, porque Haiku 4.5 ya fue perfecto. Son las mismas respuestas, más rápido y por céntimos; para un modelo pensado para ejecutarse millones de veces, eso es lo que cuenta. La próxima vez pondré trampas más duras.
Precios y disponibilidad de Claude Haiku 5.5
Ya ha quedado claro que Haiku 5.5 es la opción más económica. Pero aquí va el detalle: Claude Haiku 5.5 tiene dos niveles de precio según el tamaño del prompt. Los prompts de hasta 100.000 tokens pagan la tarifa baja, y los mayores pagan cinco veces más.
| Tarifa, por 1M de tokens | Haiku 5.5 (prompts hasta 100K) | Haiku 5.5 (prompts de más de 100K) | Haiku 4.5 |
|---|---|---|---|
| Entrada | 0,10 $ | 0,50 $ | 1,00 $ |
| Salida | 0,50 $ | 2,50 $ | 5,00 $ |
| Lectura de caché | 0,01 $ | 0,05 $ | 0,10 $ |
| Escritura de caché (5 minutos) | 0,125 $ | 0,625 $ | 1,25 $ |
La Batch API aplica un 50% de descuento en entrada y salida. Los tokens de pensamiento se facturan como salida, así que los ajustes de mayor esfuerzo encarecen cada solicitud.
El descuento teórico de Haiku 5.5 frente a Haiku 4.5 es del 90% por debajo de 100K tokens, pero en la práctica se reduce por dos motivos. El nuevo tokenizador convierte el mismo texto en aproximadamente un 30% más de tokens que Haiku 4.5, y los prompts por encima de 100K tokens pagan la mitad de la tarifa de Haiku 4.5 en lugar de una décima parte. En conjunto, explican por qué la media de Anthropic es "75% más barato" y no 90%.
Anthropic también redujo el precio de lectura de caché de Claude Sonnet 5.5 a 0,10 $ por millón de tokens, desde 0,20 $, junto a este lanzamiento. Haiku 5.5 está disponible de forma general, y Anthropic se compromete a no retirarlo antes del 7 de octubre de 2027.
¿Cómo acceder a Claude Haiku 5.5?
Claude Haiku 5.5 está disponible en la API de Claude como claude-haiku-5-5, en Amazon Bedrock como anthropic.claude-haiku-5-5, y en Google Cloud, Microsoft Foundry y Claude Platform on AWS como claude-haiku-5-5.
Aquí tienes una llamada mínima en Python. El pensamiento adaptativo viene activado por defecto, así que selecciona el bloque de texto por tipo:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
Para un recorrido completo por claves, costes y tu primer proyecto, consulta nuestra guía completa de la Claude API, y nuestro tutorial de la API de Sonnet 5.5 para un agente al que podrías delegar subagentes Haiku 5.5.
Conclusiones
Si ya ejecutas clasificación, extracción o trabajo de subagentes con Haiku 4.5, pásate a Haiku 5.5 ya. En nuestra prueba, dio las mismas respuestas, más rápido y mucho más barato. Solo recuerda reservar tiempo para los cambios incompatibles de la API y volver a contar tus tokens.
Diría que Haiku 5.5 mete presión directa sobre GPT-6 Luna de OpenAI en la gama baja del mercado. Para mucho tráfico en producción, la pregunta ya no es si un modelo pequeño es suficiente, sino qué trabajos siguen necesitando Sonnet.
Si te interesa aprender más sobre cómo construir con los modelos de Anthropic, te recomiendo nuestro curso Introduction to Claude Models.