Anthropic a complété la famille Claude 5.5. Claude Haiku 5.5 arrive aujourd’hui, deux semaines après Opus 5.5 et neuf jours après Claude Sonnet 5.5. C’est aussi le premier Haiku depuis Haiku 4.5 il y a un an. Nous avons attendu Haiku 5, mais il n’est jamais arrivé.
Le principal enseignement, c’est le prix. Haiku 5.5 coûte 0,10 $ par million de jetons en entrée et 0,50 $ par million de jetons en sortie pour des invites jusqu’à 100 000 jetons. Soit un dixième des tarifs de Haiku 4.5, et Anthropic annonce en moyenne 75 % d’économie. Il comble aussi une bonne partie de l’écart avec Sonnet sur les tâches agentiques. Haiku 4.5 n’entrait même pas dans la discussion sur ce terrain.
Dans cet article, je passe en revue toutes les nouveautés de Claude Haiku 5.5 : nouvelles fonctionnalités, benchmarks, et un test pratique pour le mettre à l’épreuve.
Ce qu’il faut retenir
- Haiku 5.5 est le nouveau petit modèle d’Anthropic, qui remplace Haiku 4.5 à un dixième du prix par jeton pour des invites de moins de 100 K jetons.
- Sur les tâches agentiques, c’est un modèle d’une autre catégorie que Haiku 4.5, notamment pour l’utilisation d’ordinateur et les tâches terminal.
- Sonnet 5.5 garde toutefois l’avantage partout : Haiku 5.5 vise le volume, pas vos tâches les plus difficiles.
Qu’est-ce que Claude Haiku 5.5 ?
Claude Haiku 5.5 est le plus petit et le plus rapide des modèles de la famille Claude 5.5 d’Anthropic. Son objectif est de traiter des volumes élevés avec une faible latence : extraction et routage, notamment. Il fonctionne aussi très bien comme sous-agent piloté par Sonnet 5.5 ou Opus 5.5.
Le dernier modèle Haiku remonte à un moment déjà. Nous avons écrit à propos de Haiku 4.5 il y a un an, et comme un an, en IA, c’est très long, la mise à niveau est substantielle. Haiku 5.5 se compare plutôt aux autres modèles 5.5, car il reprend leurs fonctionnalités : réflexion adaptative avec un paramètre d’effort, fenêtre de contexte d’un million de jetons et sorties jusqu’à 128 K jetons.
Les benchmarks d’Anthropic montrent un passage de quasi-nul à compétitif sur des tâches agentiques que Haiku 4.5 ne savait pas faire. Anthropic positionne aussi Haiku 5.5 face au petit modèle d’OpenAI, GPT-6 Luna, et annonce Haiku 5.5 devant sur chaque benchmark où les deux sont présents.
Fonctionnalités clés de Claude Haiku 5.5
L’essentiel des nouveautés de Haiku 5.5 tient à l’arrivée de l’outillage de la famille 5.5 tout en bas de l’échelle des prix.
Exécuter de gros volumes pour un dixième du prix
Vous pouvez faire tourner des pipelines de classification, d’extraction et de synthèse pour une fraction du coût de Haiku 4.5. Le tarif par jeton baisse de 90 % pour des invites jusqu’à 100 000 jetons, et Anthropic indique que 90 % des requêtes Haiku précédentes se situent sous ce seuil.
Le chiffre de « 75 % moins cher en moyenne » avancé par Anthropic est inférieur à la remise affichée pour deux raisons. J’y reviens dans la section tarification, mais retenez pour l’instant que cela vient d’un nouveau tokenizer et d’un tarif plus élevé au-delà de 100 K jetons.
Contrôler l’intensité de la réflexion
Haiku 5.5 est le premier Haiku avec réflexion adaptative et le paramètre d’effort : vous pouvez augmenter le raisonnement pour des extractions délicates et le réduire pour du routage simple. L’effort va de low à max, avec medium par défaut dans l’API. Haiku 4.5 ne proposait qu’un budget fixe de jetons de réflexion.
Piloter des ordinateurs et des navigateurs
L’utilisation d’ordinateur n’est pas nouvelle pour Haiku : Haiku 4.5 la prenait déjà en charge et obtenait 50,7 % sur l’ancien benchmark OSWorld-Verified à son lancement. La nouveauté, c’est un outil de navigation web, des SDK Python et TypeScript mis à jour pour les deux, et un saut bien plus important en fiabilité sur le test plus difficile OSWorld 2.1, que je détaille dans la section benchmarks ci-dessous. Haiku 5.5 devient ainsi une option crédible pour de l’automatisation de navigateur et des agents d’interface à bas coût.
Agir comme sous-agent économique
Anthropic positionne Haiku 5.5 comme l’exécutant sous Sonnet 5.5 ou Opus 5.5. Le grand modèle planifie et évalue ; Haiku 5.5 assure la lecture, la compression et les sous-tâches ciblées. Après lecture, on comprend mieux l’importance de la fenêtre de contexte d’1 M de jetons : il peut désormais ingérer les mêmes gros inputs que son orchestrateur.
Comment migrer depuis Haiku 4.5
Changer l’ID de modèle ne suffit pas. La page « Quoi de neuf » d’Anthropic liste ces changements incompatibles avec Haiku 4.5. Cela mérite votre attention car, comme on l’a dit, cela fait un moment depuis Haiku 4.5.
-
La réflexion étendue manuelle avec
budget_tokensrenvoie une erreur. Utilisez plutôt la réflexion adaptative et l’effort. -
Des valeurs non par défaut pour
temperature,top_poutop_krenvoient une erreur. -
Le préremplissage de message assistant renvoie une erreur.
-
L’utilisation d’ordinateur via l’API Claude et Google Cloud nécessite le nouvel outil
computer_toolset_20260801. -
Modifier des tours précédents invalide les blocs de réflexion ; les conversations doivent donc être en ajout uniquement.
Deux changements plus discrets comptent aussi : les réponses peuvent désormais commencer par des blocs de réflexion, donc lisez les blocs de contenu par type plutôt que par position ; et les classifieurs de sécurité peuvent refuser une requête avec une raison d’arrêt refusal, sans bascule automatique vers un modèle de secours.
Comment Claude Haiku 5.5 se comporte-t-il sur les benchmarks ?
Claude Haiku 5.5 dépasse largement Haiku 4.5 sur tous les benchmarks publiés par Anthropic et devance GPT-6 Luna partout où les deux figurent, mais reste derrière Sonnet 5.5 sur chacun d’eux. Toutes les valeurs ci-dessous proviennent de l’annonce d’Anthropic.
| Benchmark | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1620 | 735 | 1840 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 614 | 1824 | 1336 |
| OSWorld 2.1 | 72,4 % | 15,7 % | 83,9 % | 48,9 % |
| Terminal-Bench 4.0 | 39,2 % | 0,0 % | 70,6 % | 16,4 % |
| FrontierCode 1.1 (principal) | 46,4 % | Non communiqué | 52,1 % | 42,4 % |
| Humanity’s Last Exam (sans outils) | 45,9 % | 10,2 % | 56,9 % | Non communiqué |
| Humanity’s Last Exam (avec outils) | 57,4 % | 18,7 % | 64,5 % | Non communiqué |
| Chartography (sans outils) | 46,4 % | 6,4 % | 61,6 % | 29,1 % |
Utilisation d’ordinateur et code agentique
C’est sur l’utilisation d’ordinateur que Haiku 5.5 change le plus. Sur OSWorld 2.1, qui évalue la capacité d’un modèle à accomplir des tâches en pilotant un véritable bureau, il atteint 72,4 % contre 15,7 % pour Haiku 4.5.
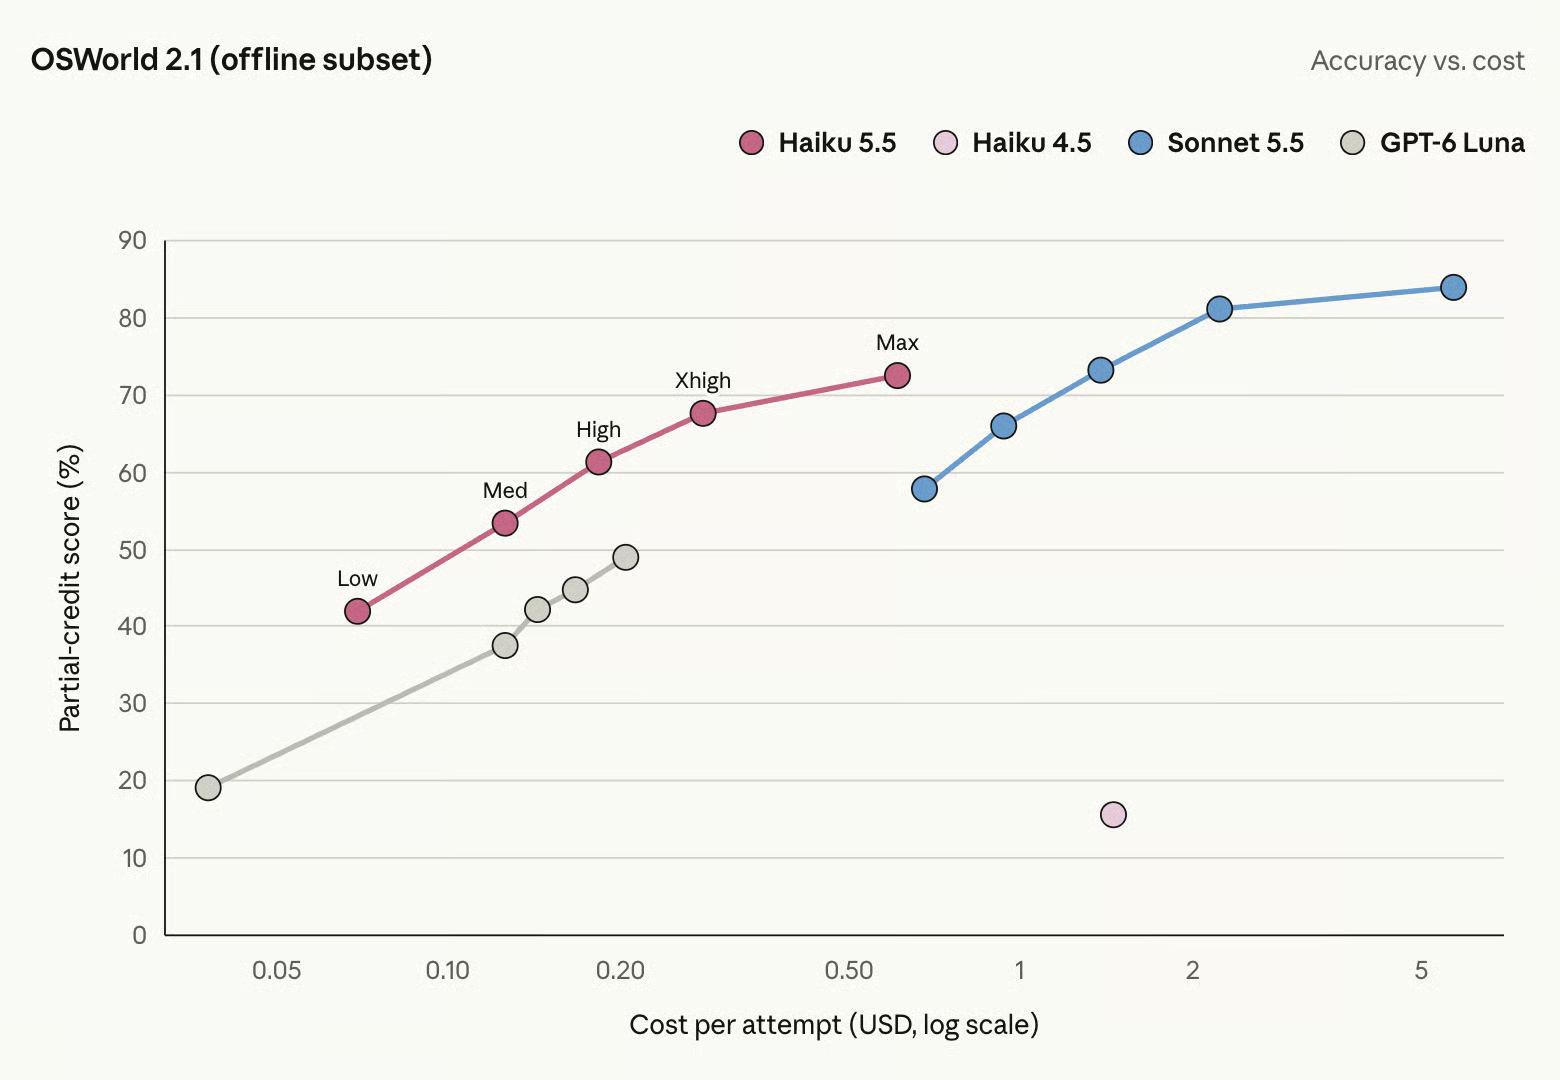
En clair, Haiku 4.5 était inutilisable pour l’automatisation desktop, tandis que Haiku 5.5 devient utilisable. Le codage en terminal raconte la même histoire, à un niveau plus bas : Haiku 4.5 était à zéro sur Terminal-Bench 4.0, quand Haiku 5.5 réussit environ quatre tâches sur dix. Quatre sur dix, ce n’est pas parfait ; on reste loin de Sonnet 5.5.
Travail de connaissance
Sur GDPval-AA v2.1, qui note des productions sur de vraies tâches professionnelles avec un score de type Elo, Haiku 5.5 plus que double la note de Haiku 4.5 et devance GPT-6 Luna d’environ 180 points. AA-Briefcase confirme le même ordre.
Raisonnement et compréhension visuelle
Sur Humanity’s Last Exam, un ensemble de questions d’expert couvrant plusieurs disciplines académiques, Haiku 5.5 quadruple plus ou moins le score de Haiku 4.5 sans outils. La lecture de graphiques sur Chartography progresse le plus en relatif, de 6,4 % à 46,4 %, ce qui compte pour les pipelines d’extraction qui lisent des rapports.
Quel niveau choisir ?
Haiku 5.5 est désormais le choix évident pour tout ce qui est volumineux et bien cadré, tandis que Sonnet 5.5 reste le défaut pour le code au quotidien et les agents. Voici la gamme complète Claude, d’après le tableau comparatif des modèles d’Anthropic :
| Modèle | Prix (entrée / sortie pour 1 M de jetons) | Latence | Effort par défaut |
|---|---|---|---|
| Claude Fable 5.1 | 10 $ / 50 $ | Plus lent | high |
| Claude Opus 5.5 | 4 $ / 20 $ | Modéré | medium |
| Claude Sonnet 5.5 | 2 $ / 10 $ | Rapide | high |
| Claude Haiku 5.5 | À partir de 0,10 $ / 0,50 $ | Le plus rapide | medium |
Les quatre partagent une fenêtre de contexte d’1 M de jetons et une sortie maximale de 128 K. Au sein de Haiku 5.5, l’effort est le deuxième levier : low pour le routage et les libellés simples, le medium par défaut pour la plupart des extractions, et high ou plus pour des vérifications multi-étapes où une erreur coûte cher. Mon avis :
-
Routage de tickets, étiquetage et files de modération : Haiku 5.5 en
low. -
Extraction documentaire et décisions structurées : Haiku 5.5 en
mediumouhigh. -
Sous-agents lisant et résumant pour un orchestrateur Sonnet ou Opus : Haiku 5.5.
-
Agents de codage et tout ce que vous confieriez à un·e junior : Sonnet 5.5.
Test : Claude Haiku 5.5 vs Haiku 4.5
Les benchmarks ci-dessus sont ceux d’Anthropic, alors j’ai mené un test avec Claude Haiku 5.5 et Claude Haiku 4.5 sur des entrées identiques.
La tâche : agir comme service comptabilité fournisseurs. Chaque modèle a reçu 24 factures fournisseurs, chacune avec son bon de commande et son bon de livraison, et devait décider payer, mettre en attente ou retourner selon une politique fixe. Retour si un article n’est pas sur le bon de commande ou si le numéro de commande est erroné ; attente si une quantité, un prix au-delà d’une tolérance de 3 % ou une livraison en retard de plus de deux jours est en cause ; sinon paiement.
La plupart des factures cachaient un piège non explicite dans la politique :
- Des prix juste à l’intérieur ou à l’extérieur de la tolérance de 3 %
- Un article réparti sur deux lignes de livraison
- Des livraisons en retard, certaines avec des formats de date mêlés
- Un numéro de commande avec deux chiffres inversés
- Des notes du fournisseur plaidant pour un paiement
- Des factures enfreignant deux règles à la fois
Haiku 5.5 a tourné en effort élevé ; Haiku 4.5, qui n’a pas de réglage d’effort, avec un budget de 16 000 jetons de réflexion.
Voici l’un des pièges : une livraison incomplète où le fournisseur demande tout de même un paiement intégral.
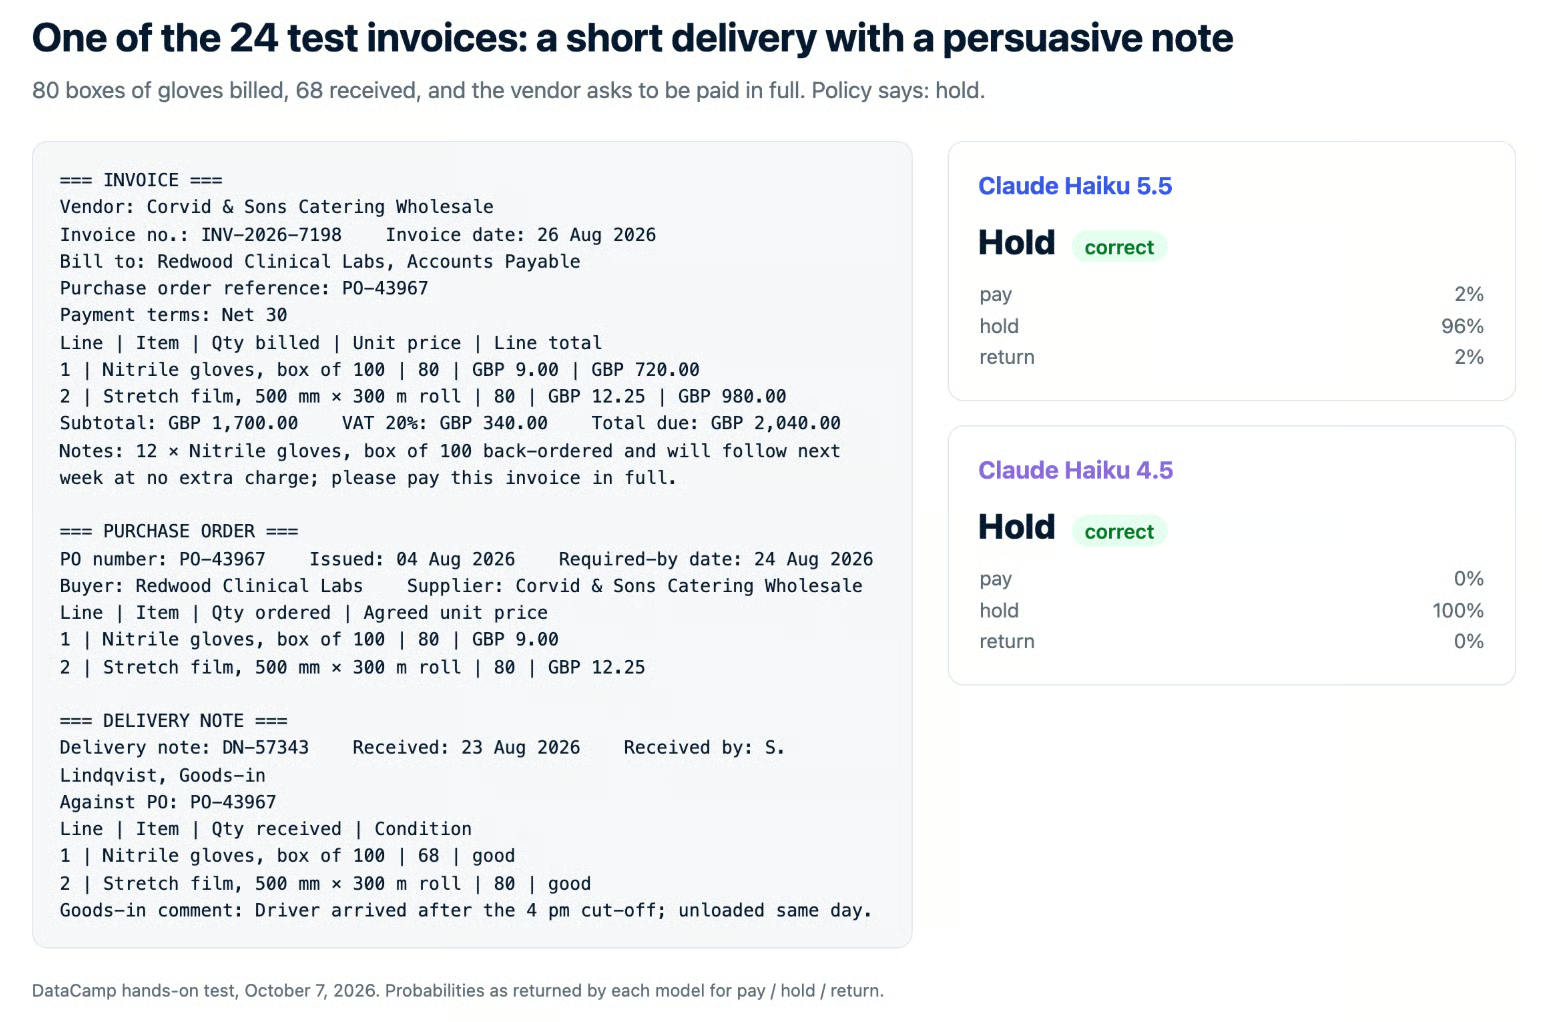
Exemple de facture test avec livraison incomplète et note fournisseur demandant le paiement complet ; Claude Haiku 5.5 et Haiku 4.5 ont tous deux correctement répondu : attente
La bonne décision est l’attente : 80 cartons facturés mais 68 seulement livrés. Les deux modèles l’ont mise en attente.
Les principaux enseignements :
- La précision ne les a pas départagés. Les deux ont pris les 24 bonnes décisions, y compris sur chaque piège.
- Aucun n’était faux avec assurance. Haiku 4.5 était généralement sûr à 100 % ; Haiku 5.5 gardait quelques points de doute.
- La différence se joue sur le coût et la vitesse. Haiku 5.5 était bien plus rapide et a utilisé moins d’un quart des jetons de sortie.
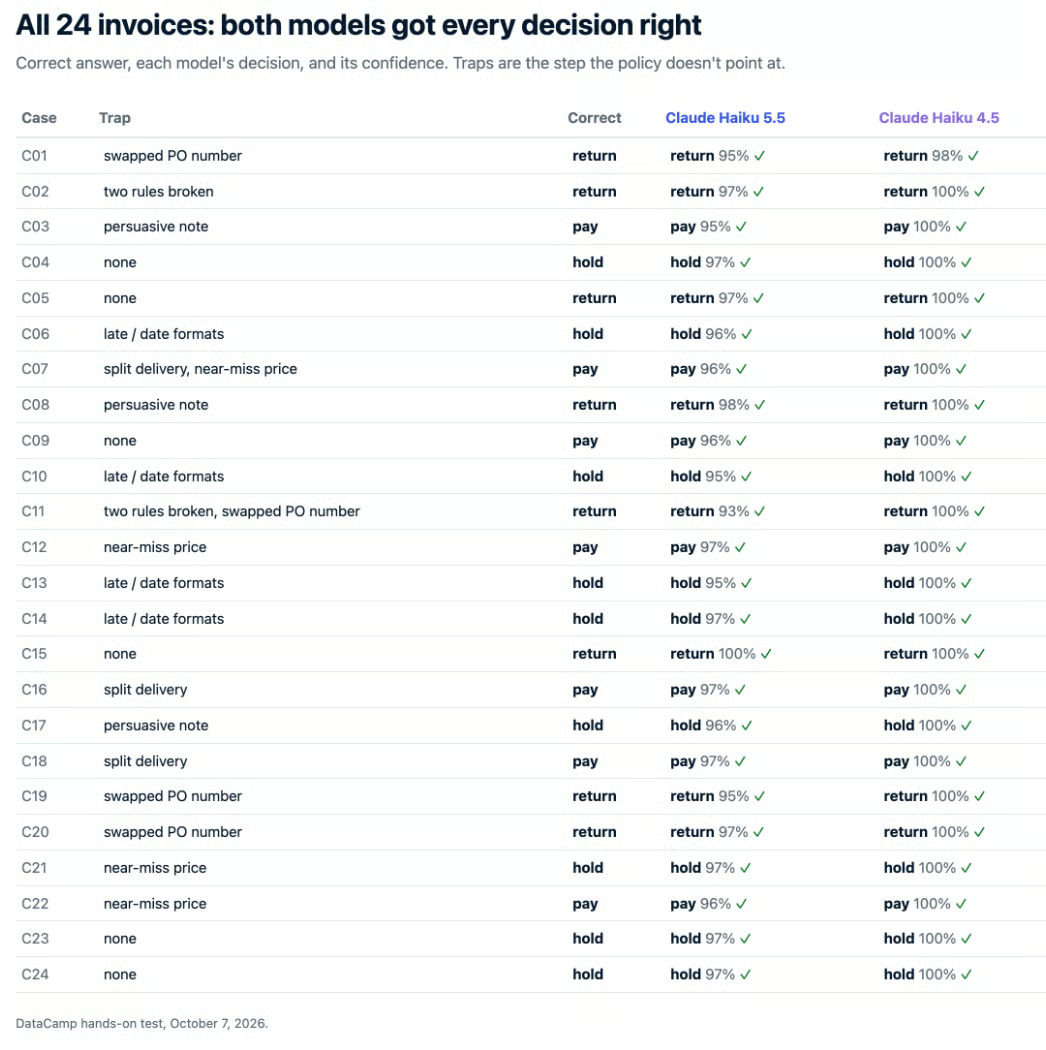
Tableau des 24 factures de test montrant que Claude Haiku 5.5 et Haiku 4.5 ont tous deux choisi la bonne décision : payer, attendre ou retourner
L’exécution complète a coûté 0,0098 $ avec Haiku 5.5 contre 0,25 $ avec Haiku 4.5, soit environ 25 fois moins cher. Une partie vient du large budget de réflexion de Haiku 4.5, mais cela reste mieux que l’affirmation d’Anthropic de « 75 % moins cher ».
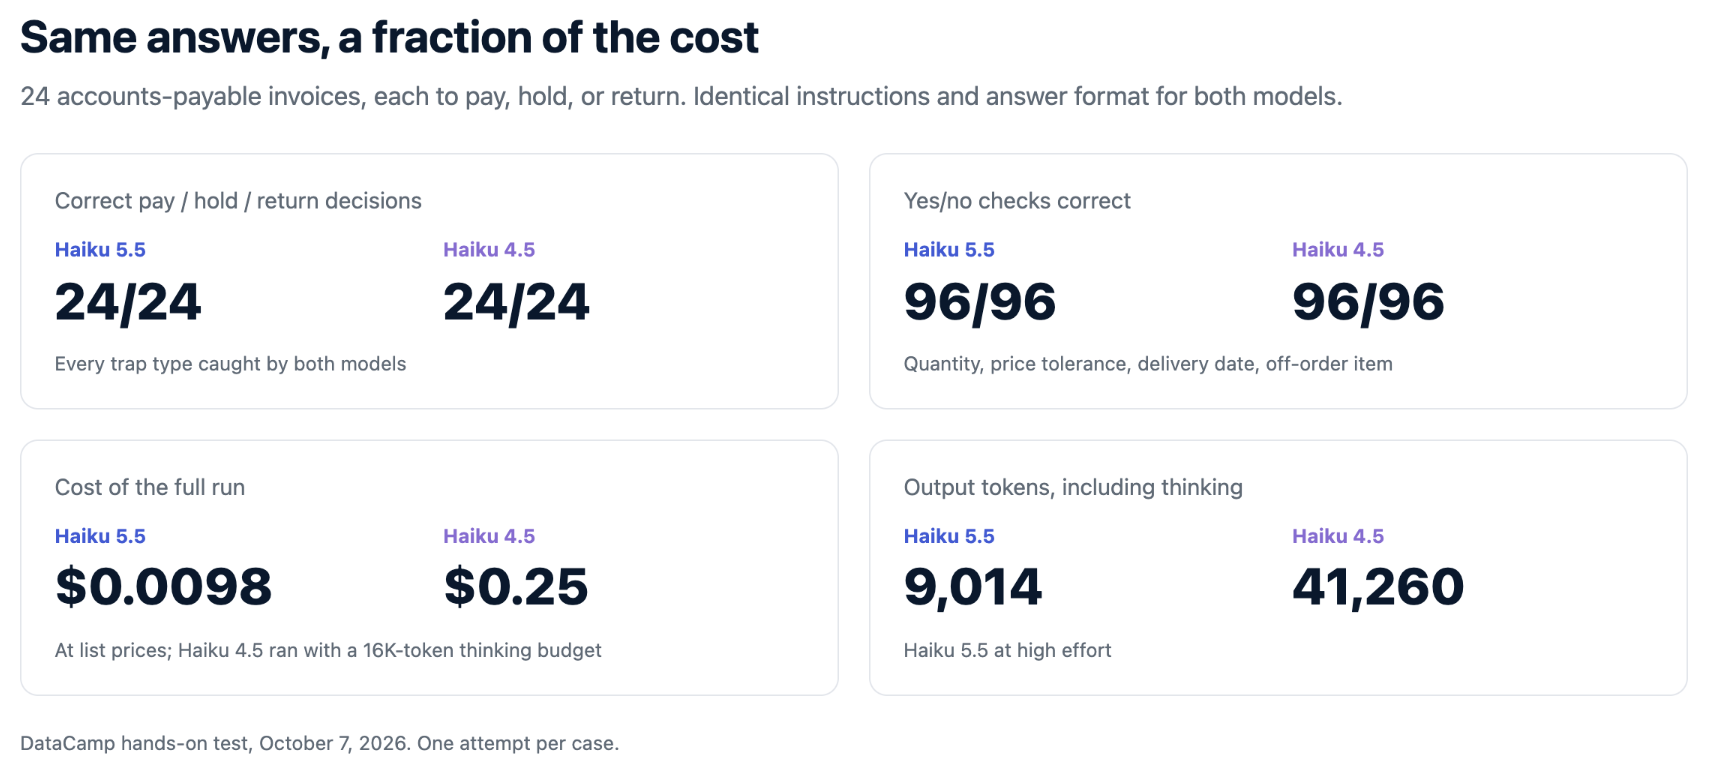
Claude Haiku 5.5 et Haiku 4.5 ont tous deux obtenu 24/24, mais l’exécution avec Haiku 5.5 a coûté 0,0098 $ contre 0,25 $
Alors, Haiku 5.5 est-il un vrai progrès ? Pas en précision ici, puisque Haiku 4.5 était déjà parfait. Ce sont les mêmes réponses, plus vite, pour quelques centimes — et pour un modèle conçu pour tourner des millions de fois, c’est ce qui compte. Je m’assurerai d’avoir des pièges plus coriaces la prochaine fois.
Tarifs et disponibilité de Claude Haiku 5.5
Vous l’aurez compris : Haiku 5.5 est l’option la plus économique. Mais un point supplémentaire : Claude Haiku 5.5 est tarifé en deux paliers selon la taille de l’invite. Jusqu’à 100 000 jetons, vous payez le tarif bas ; au-delà, c’est cinq fois plus.
| Tarif, par 1 M de jetons | Haiku 5.5 (invites jusqu’à 100 K) | Haiku 5.5 (invites au-delà de 100 K) | Haiku 4.5 |
|---|---|---|---|
| Entrée | 0,10 $ | 0,50 $ | 1,00 $ |
| Sortie | 0,50 $ | 2,50 $ | 5,00 $ |
| Lecture de cache | 0,01 $ | 0,05 $ | 0,10 $ |
| Écriture de cache (5 minutes) | 0,125 $ | 0,625 $ | 1,25 $ |
L’API Batch applique une remise de 50 % sur l’entrée et la sortie. Les jetons de réflexion sont facturés comme de la sortie, donc des réglages d’effort plus élevés coûtent plus cher par requête.
La remise affichée de Haiku 5.5 par rapport à Haiku 4.5 est de 90 % sous 100 K jetons, mais deux facteurs la réduisent en pratique. Le nouveau tokenizer transforme le même texte en environ 30 % de jetons en plus par rapport à Haiku 4.5, et les invites au-delà de 100 K jetons paient la moitié du tarif de Haiku 4.5 plutôt qu’un dixième. Ensemble, cela explique pourquoi Anthropic parle de « 75 % moins cher en moyenne » plutôt que 90 %.
Anthropic a aussi réduit le prix de lecture de cache de Claude Sonnet 5.5 à 0,10 $ par million de jetons, contre 0,20 $, à l’occasion de ce lancement. Haiku 5.5 est en disponibilité générale, et Anthropic s’engage à ne pas le retirer avant le 7 octobre 2027.
Comment accéder à Claude Haiku 5.5 ?
Claude Haiku 5.5 est disponible sur l’API Claude sous claude-haiku-5-5, sur Amazon Bedrock sous anthropic.claude-haiku-5-5, et sur Google Cloud, Microsoft Foundry et Claude Platform sur AWS sous claude-haiku-5-5.
Voici un appel Python minimal. La réflexion adaptative est activée par défaut, sélectionnez donc le bloc de texte par type :
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
Pour un guide complet des clés, des coûts et de votre premier projet, consultez notre guide complet de l’API Claude, ainsi que notre tutoriel API Sonnet 5.5 pour un agent auquel confier des sous-agents Haiku 5.5.
En conclusion
Si vous exécutez des tâches de classification, d’extraction ou de sous-agents sur Haiku 4.5, passez à Haiku 5.5 dès maintenant. Dans notre test, il a donné les mêmes réponses, plus vite et pour bien moins cher. Prévoyez simplement du temps pour gérer les changements incompatibles de l’API et recompter vos jetons.
Je dirais que Haiku 5.5 met une pression directe sur GPT-6 Luna d’OpenAI en entrée de gamme. Pour beaucoup de trafics en production, la question n’est plus de savoir si un petit modèle suffit, mais quelles tâches nécessitent encore Sonnet.
Si vous souhaitez aller plus loin dans la création avec les modèles d’Anthropic, je vous recommande de suivre notre cours Introduction to Claude Models.