Sześć dni po tym, jak Anthropic umieścił Claude Opus 5.5 na szczycie swojej oferty, model ze średniej półki zniwelował większość różnic za połowę ceny. Claude Sonnet 5.5 wygrywa z Opus 5.5 w jednym benchmarku i traci do niego tylko kilka punktów w pozostałych, utrzymując jednocześnie ceny Sonnet 5.
Widzieliśmy już ten schemat. Claude Sonnet 5 zadebiutował, zbliżając się do agentowych benchmarków Opus 4.8 ułamkiem kosztu. Wcześniej Sonnet 4.6 znalazł się w zasięgu Opus 4.6 na podobnych warunkach. Za każdym razem model ze średniej półki pojawia się kilka dni lub tygodni po flagowcu i niweluje większość różnic za połowę ceny.
Tak z zewnątrz wygląda logarytmiczna krzywa skalowania. Wydajność rośnie mniej więcej wraz z logarytmem mocy obliczeniowej, więc koszt rośnie mniej więcej wykładniczo wraz z wydajnością. Model flagowy siedzi na szczycie tej krzywej, gdzie płaci się dużo za ostatnie kilka punktów. Tańszy model zbudowany kilka tygodni później, korzystając z tych samych postępów u podstaw, musi sięgnąć po niższy punkt na krzywej, żeby wyglądać prawie tak samo dobrze. Innymi słowy, większość wartości krzywej wciąż da się uzyskać tanio, a tylko końcowy odcinek jest drogi.
Warto to rozłożyć na czynniki pierwsze, bo czołowe firmy robią trochę magii PR‑owej i brandingowej.
TL;DR
- Sonnet 5.5 to nowy model ze średniej półki Anthropic, zastępujący Sonnet 5 w tej samej cenie.
- Największy zysk to agentowe kodowanie w terminalu, gdzie faktycznie wyprzedza teraz Opus 5.5.
- W pracy wiedzo‑wej i obsłudze komputera plasuje się tuż za Opus 5.5 przy połowie ceny za token.
- Ustaw go jako domyślny model Claude, a Opus 5.5 zostaw do zadań otwartych, wymagających większej dozy osądu.
Czym jest Claude Sonnet 5.5?
Dokumentacja modelu Anthropic opisuje Claude Sonnet 5.5 jako „najlepsze połączenie szybkości i inteligencji” w bieżącej ofercie. To model ze średniej półki w rodzinie Claude 5.5 Anthropic, pozycjonowany między flagowym Claude Opus 5.5 a nadchodzącym Claude Haiku 5.5. (Będziemy informować o Haiku 5.5, choć Haiku 5 nigdy nie dotarł.)
W porównaniu z Sonnet 5 skok jest większy, niż sugeruje połówkowy numer wersji. To niespodzianką nie jest, skoro widzieliśmy, że różnica między Opus 5.5 a Opus 5 była większa od oczekiwanej.
Jeśli chodzi o post ogłoszeniowy – Anthropic raportuje wzrosty we wszystkich opublikowanych benchmarkach, z największymi skokami w kodowaniu terminalowym, odczycie wykresów i ewaluacjach pracy wiedzo‑wej.
Co ciekawe, Anthropic podaje, że ten Sonnet jako pierwszy pokonał Pokémon Red, pracując wyłącznie na zrzutach ekranu. Brzmi nietypowo, ale to test, którego Anthropic używa jako proxy dla pracy długohoryzontalnej i rozumienia obrazów.
Opus 5.5 pozostaje – jak podaje firma – wyraźnie silniejszy w złożonych, otwartych zadaniach wymagających trwałego osądu. Ale Sonnet 5.5 to model do zadań, w których wiadomo, jak wygląda „gotowe” – i to jest użyteczna heurystyka.
Kluczowe funkcje Claude Sonnet 5.5
Większość nowości w Sonnet 5.5 dotyczy wykonywania tej samej pracy szybciej i z mniejszą liczbą tokenów, plus kilka zmian, które użytkownicy API muszą uwzględnić w planach.
Wyniki bliskie Opus w codziennych zadaniach przy szybkości Sonnet
Możesz powierzyć Sonnet 5.5 pracę, która wcześniej prosiła się o Opus, i dostać ją szybciej z powrotem. Anthropic podaje, że generowanie wyjścia jest o ponad 30% szybsze niż w Sonnet 5, a model zużywa mniej tokenów na zadanie – „do 30% mniej na zadanie” – to cytowana wartość.
Wczesni testerzy, cytowani w poście ogłoszeniowym, potwierdzają to własnymi liczbami:
- Base44 raportuje 3,6 iteracji na build aplikacji z Sonnet 5.5 wobec 7,7 z Opus 5.
- Box odnotował obciążenia działające 2,4× szybciej przy 12% mniejszej łącznej liczbie tokenów.
- Zendesk zmierzył 20% szybsze przetwarzanie zgłoszeń.
- Slack raportuje około 14% mniej tokenów wyjściowych.
To cytaty klientów wyselekcjonowane przez dostawcę. Mimo to widać wzorzec: mniej iteracji i mniej tokenów, co – obok stawki za token – ma znaczenie dla twojego rachunku.
Uruchamiaj agentów kodujących w terminalu i na pulpicie
Sonnet 5.5 jest zbudowany do pracy jako agent: uruchamia polecenia shell, naprawia błędy w całym repo i obsługuje pulpit na podstawie zrzutów ekranu. Od startu działa w Claude Code, a Anthropic opisuje jego użycie komputera jako zbliżone do Opus 5.5.
Praktyczna konsekwencja dla wielu osób jest taka, że Sonnet 5.5 to teraz wiarygodny domyślny wybór do sesji Claude Code i pętli agentowych, które sam budujesz z naszym przewodnikiem po Claude API.
Twórz dopracowane dokumenty, slajdy i interfejsy
Anthropic wskazuje „wyczulone oko do designu” jako mocną stronę Sonnet 5.5. W praktyce powinno to oznaczać lepiej wyglądające interfejsy użytkownika, gdy prosisz o dopracowanie frontendu, oraz bardziej wykończone rezultaty, gdy prosisz o slajdy, arkusze czy długie dokumenty.
To twierdzenie projektowe najbardziej wymaga niezależnej weryfikacji. Najtrudniej je zbenchmarkować, a post ogłoszeniowy podpiera je wyłącznie cytatami klientów.
Oczekuj zabezpieczeń przy pracy z bezpieczeństwem i biologią
Sonnet 5.5 to pierwszy model Sonnet uruchomiony z zabezpieczeniami cyberbezpieczeństwa podobnymi do tych w Opus 5.5. Gdy żądanie zostanie sklasyfikowane jako praca bezpieczeństwa wyższego ryzyka, zapytanie spada do Sonnet 5. Zabezpieczenia biologiczne są takie same jak w Sonnet 5 i Anthropic podaje, że większość prac z zakresu oprogramowania i nauk przyrodniczych pozostanie bez wpływu.
To także pierwszy Sonnet, który wysyła się z klasyfikatorami blokującymi ekstrakcję rozumowania, a bloki myślenia są teraz powiązane z kontem i rozmową, które je wytworzyły. Jeśli uruchamiasz narzędzia bezpieczeństwa, przetestuj swoje prompty przed przełączeniem potoku.
Przenieś się z Sonnet 5 z kilkoma zmianami w kodzie
Podmiana ID modelu to nie wszystko. Dokumentacja Anthropic wymienia pięć zmian niezgodnych wstecz dla kodu już działającego na Sonnet 5:
-
Adaptacyjne myślenie jest domyślnie włączone, a najniższe ustawienie to
between_tools, które wyłącza myślenie wstępne. -
Wymuszone użycie narzędzia zwraca błąd.
-
Bloki myślenia są powiązane z modelem i rozmową, które je wytworzyły.
-
Starsze narzędzie do obsługi komputera
computer_20251124jest odrzucane w Claude API i Google Cloud. -
Narzędzie advisor nie akceptuje już Opus 4.8, Opus 4.7 ani Sonnet 5 jako doradców.
Jest też cichsza zmiana: tekst między wywołaniami narzędzi wraca teraz w blokach thinking. Aplikacja strumieniująca tekst do użytkowników zamilknie między wywołaniami narzędzi, dopóki nie zaktualizujesz ustawienia display. Ustawienie temperature, top_p lub top_k na wartość inną niż domyślna także zwraca błąd 400. To konkretne rzeczy, na które możesz trafić.
Jak Claude Sonnet 5.5 wypada w benchmarkach?
Claude Sonnet 5.5 wygrywa z Sonnet 5 we wszystkich opublikowanych przez Anthropic benchmarkach, pokonuje Opus 5.5 w kodowaniu terminalowym i traci do Opus 5.5 o kilka punktów wszędzie indziej. W starciu z GPT-6 Sol od OpenAI prowadzi w ewaluacjach pracy wiedzo‑wej i odczytu wykresów, ale przegrywa na FrontierCode. Wszystkie poniższe liczby pochodzą z posta ogłoszeniowego Anthropic.
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 10,3% | 66,4% | Brak danych |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | Brak danych |
| FrontierCode 1.1 (Main) | 46,2% (max effort) | 42,4% | 54,4% | 49,3% (52,1% przy xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (z narzędziami) | 64,5% | 54,9% | 67,7% | Brak danych |
| OSWorld 2.1 | 80,1% | 57,0% | 81,8% | Brak danych |
| Chartography (bez narzędzi) | 61,6% | 15,6% | 64,4% | 53,6% |
Tabela opowiada prostą historię: duży skok generacyjny względem Sonnet 5 i niemal remis z Opus 5.5. Zobaczmy, co każdy obszar znaczy dla twojej pracy.
Agentowe kodowanie
Terminal-Bench 4.0 to miejsce, gdzie Sonnet 5.5 się wyróżnia. Zdobywa 70,6%, wobec 10,3% dla Sonnet 5 i przed 66,4% Opus 5.5. Benchmark mierzy, czy model potrafi zrealizować prawdziwe zadania w środowisku wiersza poleceń, takie jak wieloetapowe workflow shell, więc blisko mapuje się na to, jak używany jest Claude Code.
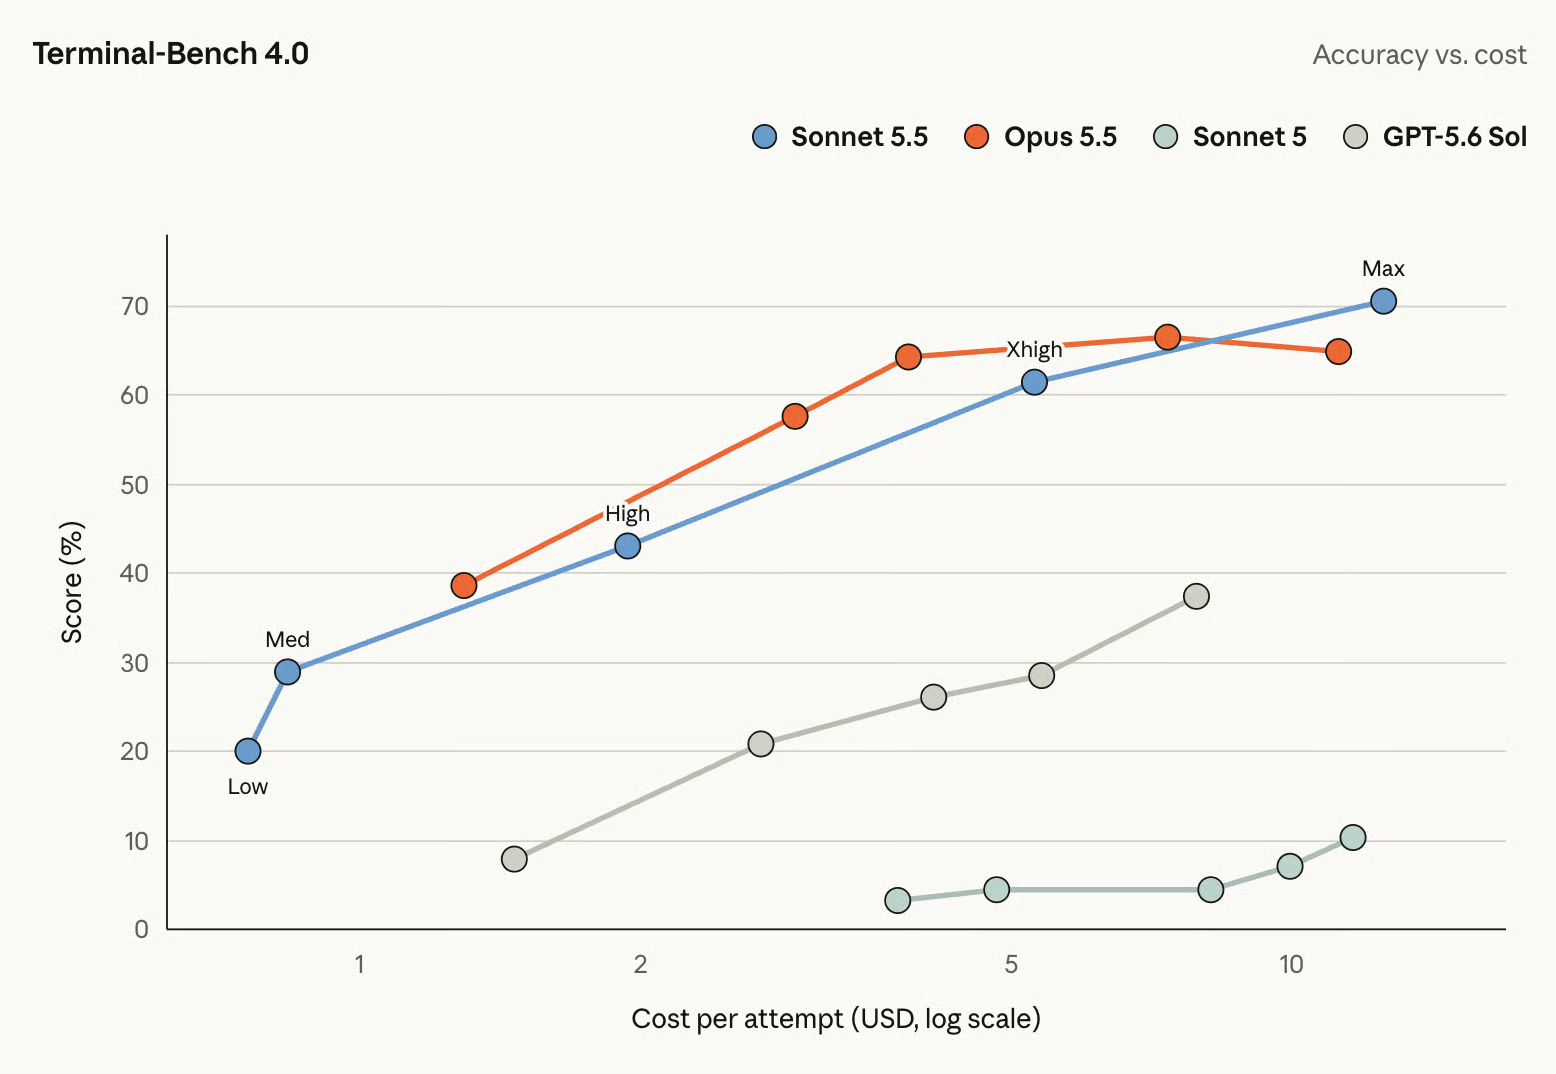
Skok o 60 punktów w jednym wydaniu to spora rzadkość. Reszta obrazu kodowania jest mniej dramatyczna.
Praca wiedzo‑wa
W GDPval-AA v2.1, który ocenia wyjścia modeli w ekonomicznie wartościowych zadaniach z realnych zawodów w skali Elo, Sonnet 5.5 zdobywa 1844. To 2 punkty za Opus 5.5 i niemal 400 przed Sonnet 5.
Dla zespołów używających Claude do raportów, analiz i dokumentów biznesowych to najprzydatniejszy wynik w tabeli. W takiej pracy dodatkowy koszt Opus 5.5 kupuje tylko niewiele.
Rozumowanie i rozumienie wizualne
Chartography, test czytania i rozumowania na wykresach bez narzędzi, pokazuje największy względny wzrost: Sonnet 5.5 ma 61,6% wobec 15,6% Sonnet 5. To zgrywa się z twierdzeniami Anthropic o lepszym rozumieniu obrazów.
Obsługa komputera
W OSWorld 2.1, który mierzy, czy model potrafi zrealizować zadania, obsługując prawdziwy system operacyjny pulpitu, Sonnet 5.5 osiąga 80,1%, z 57,0% w Sonnet 5 i w granicach 2 punktów od Opus 5.5.
Który tier wybrać?
Dla większości deweloperów Sonnet 5.5 powinien teraz być domyślnym modelem Claude. Opus 5.5 zasługuje na wyższą cenę tylko wtedy, gdy zadanie jest na tyle otwarte, że wąskim gardłem jest osąd, a nie szybkość.
Aktualna oferta, zgodnie z tabelą porównawczą modeli Anthropic, wygląda tak. Wszystkie cztery modele poza Haiku 4.5 mają okno kontekstu 1M tokenów i maksymalne wyjście 128K.
| Model | Cena (wejście/wyjście za 1M tokenów) | Opóźnienie | Najlepszy do |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Wolniejszy | Praca z najwyższej półki, gdzie możliwości liczą się bardziej niż koszt |
| Claude Opus 5.5 | $4 / $20 | Średnie | Złożone, otwarte zadania wymagające trwałego osądu |
| Claude Sonnet 5.5 | $2 / $10 | Szybki | Dobrze zdefiniowane kodowanie, agenci i praca nad dokumentami |
| Claude Haiku 4.5 | $1 / $5 | Najszybszy | Zadania o dużej skali i wrażliwe na koszt |
W ramach Sonnet 5.5 drugim pokrętłem jest ustawienie effort. Anthropic skalibrował pięć poziomów: low, medium, high, xhigh i max. Niższe faworyzują szybkość i koszt, a wyższe pozwalają modelowi dłużej rozumować i sprawdzać własną pracę. Domyślnie to medium w aplikacjach Claude i Claude Code oraz high w API.
Jeden szczegół z posta ogłoszeniowego zmienia sposób, w jaki bym go używał: przy low lub medium Sonnet 5.5 pobija najlepszy wynik Sonnet 5 w kilku benchmarkach za około jedną dziesiątą kosztu na zadanie. Podsumowując:
-
Poprawki błędów, refaktory i sesje Claude Code: Sonnet 5.5 przy domyślnym effort.
-
Wysokoprzepustowe pętle agentów i potoki: Sonnet 5.5 na
lowlubmedium, a effort podnoś tylko przy porażkach. -
Trudne problemy kodowe z jasną specyfikacją: Sonnet 5.5 na
xhighlubmaxzanim zapłacisz za Opus. -
Niejasne, wielodniowe projekty: Opus 5.5.
Testowanie Claude Sonnet 5.5: praktyczne przykłady
Powyższe benchmarki są od Anthropic, więc uruchomiłem jedno zadanie builda na Claude Sonnet 5.5 i Claude Sonnet 5 z identycznym promptem i identycznymi narzędziami.
Zadanie: zamienić zestaw danych FiveThirtyEight recent college grads (173 kierunki w USA, CC BY 4.0) w jednoplikowy dashboard HTML, który pomoże przyszłemu studentowi porównać kategorie pod kątem zarobków i zatrudnienia oraz znaleźć najlepiej i najgorzej opłacane kierunki.
Prawdziwy test jest w danych, które mają kilka cech, o których prompt nie wspomina:
- Najlepiej zarabiający, Petroleum Engineering, ma tylko 36 respondentów ankiety, a 76 z 173 kierunków ma mniej niż 100
- Rozkład zarobków jest skośny, więc pojedynczy słupek mediany ukrywa duże rozrzuty
- Jeden kierunek, Food Science, ma puste pola liczebności
- Kolumny typów pracy nie sumują się do liczby osób zatrudnionych
Zauważenie tych kwestii to sedno testu. Test sonduje twierdzenia Anthropic o „wyczulonym oku do designu”.
Najważniejsze wnioski:
- Tylko Sonnet 5.5 dostarczył działający dashboard. Sonnet 5 podlinkował plik Chart.js, którego nie ma na cdnjs (URL zwraca 404), więc biblioteka nigdy się nie załadowała, a każdy panel, w tym zwykłe tabele, renderował się pusty. Sonnet 5.5 także sprawdza, czy jego biblioteka wykresów się załadowała, i utrzymuje działanie tabel, jeśli się nie załadowała.
- Sonnet 5.5 wychwycił pułapkę małej próby, w większości. Oznacza kierunki z mniej niż 30 respondentami jako „traktuj ostrożnie” i dodaje filtr minimalnej liczby respondentów. Jego widok domyślny stawia Petroleum Engineering na #1 bez ostrzeżenia.
- Sonnet 5 i tak by to przegapił. Jego kod czyta kolumny liczebności próby i zakresu płac, po czym nigdy ich nie używa i szereguje kierunki wyłącznie po medianie.
- Mniejsze pułapki nie zaskoczyły nikogo. Oba poradziły sobie explicite z pustym wierszem Food Science, a Sonnet 5.5 wyliczył udział pracy „college job” bez sugerowania, że kolumny pracy sumują się do całkowitego zatrudnienia.
Oto dashboard Sonnet 5.5 z filtrem ustawionym na kierunki z co najmniej 100 respondentami.
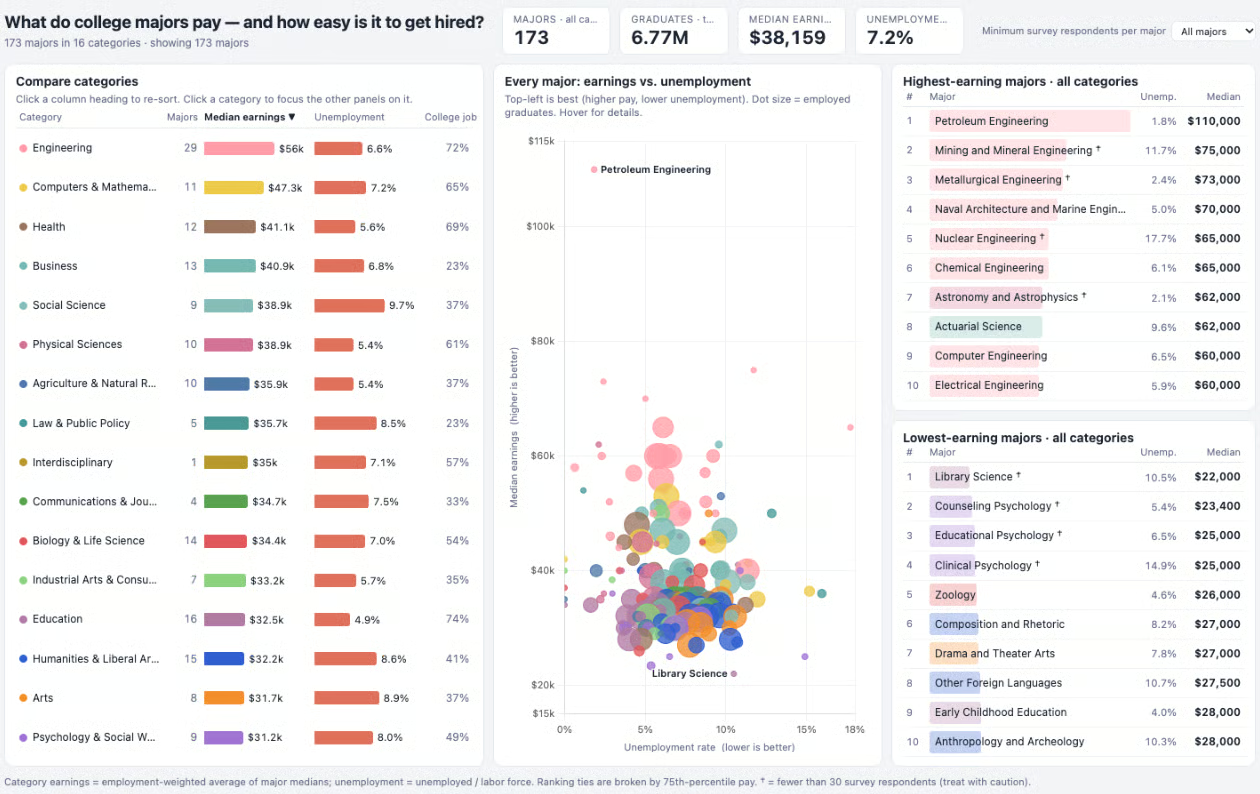
Oceniłem dashboard Sonnet 5.5 na 4 na 5 za uczciwe obchodzenie się z danymi, 5 za użyteczność analityczną i 4 za jakość wykresów i layoutu. Pustą stronę Sonnet 5 dołączam poniżej.
Dlaczego więc Sonnet 5 zawiódł? Problem w tym, że dashboard potrzebował biblioteki wykresów. Sonnet 5 poprosił cdnjs o wersję, której nie hostuje. Dostał więc błąd „404”. Bez biblioteki kod Sonnet 5 się wywrócił: „Chart is not defined.” Najwyraźniej Sonnet 5 napisał stronę tak, że wszystko, nawet zwykłe tabele tekstowe, wykonywało się po tym kroku i nie potrafił złapać błędu.
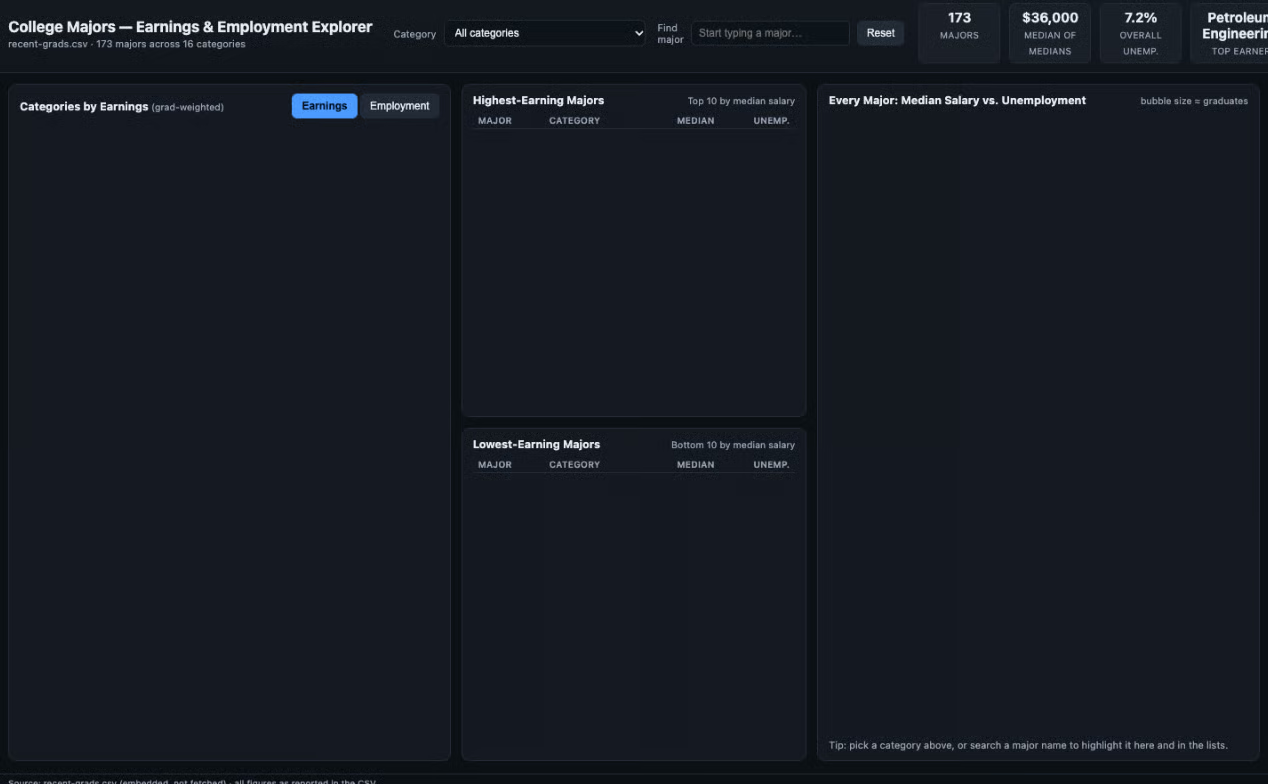
Koszt na uruchomienie był zasadniczo identyczny: $0,56 dla Sonnet 5.5 i $0,57 dla Sonnet 5. Sonnet 5.5 też skończył pracę szybciej.
Czy więc Sonnet 5.5 to realny krok naprzód? W tym zadaniu – tak. Sonnet 5.5 dostarczył działający dashboard i ostrzega o cienkich danych, a Sonnet 5 dostarczył pustą stronę.
Ceny i dostępność Claude Sonnet 5.5
Claude Sonnet 5.5 kosztuje $2 za milion tokenów wejściowych i $10 za milion tokenów wyjściowych w API, bez zmian względem Sonnet 5 i za połowę ceny Opus 5.5. Anthropic raportuje mniej tokenów na zadanie, co obniżyłoby efektywny koszt pracy, mimo że stawka jest płaska. W naszym teście praktycznym jednak oba modele kosztowały mniej więcej tyle samo, by dokończyć zadanie.
| Typ tokenów | Cena za 1M tokenów |
|---|---|
| Wejście | $2 |
| Wyjście | $10 |
| Cache write (5 minut) | $2,50 |
| Cache write (1 godzina) | $4 |
| Cache read | $0,20 |
Batch API obniża o 50% zarówno wejście, jak i wyjście. Minimalny prompt do keszowania to 512 tokenów, a w Batch API model może zwrócić do 300K tokenów wyjściowych z nagłówkiem beta output-300k-2026-03-24.
Sonnet 5.5 jest ogólnie dostępny, nie w podglądzie, z opcją braku retencji danych. Anthropic zobowiązuje się nie wycofywać go przed 28 września 2027.
Jak uzyskać dostęp do Claude Sonnet 5.5?
Możesz używać Claude Sonnet 5.5 już dziś w aplikacjach Claude, w Claude Code i przez API z ID modelu claude-sonnet-5-5. Jest też dostępny na Amazon Bedrock jako anthropic.claude-sonnet-5-5 oraz w Google Cloud, Microsoft Foundry i Claude Platform na AWS pod claude-sonnet-5-5.
Oto minimalne wywołanie w Pythonie. Adaptacyjne myślenie jest domyślnie włączone, więc odpowiedź może zawierać bloki thinking przed tekstem:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Dla prawdziwego przejścia przez klucze, koszty i pierwszy projekt zajrzyj do naszego kompletnego przewodnika po Claude API. Jeśli budujesz agentów, dobrym kolejnym krokiem jest nasz tutorial o budowaniu Claude Managed Agents. Wkrótce opublikujemy też tutorial API dla Claude Sonnet 5.5.
Na koniec
Anthropic stawia na to, że większość płatnej pracy, w tym większość pracy agentów kodujących, będzie działać na tym nowym modelu ze średniej półki. To też wywiera bezpośrednią presję na GPT-6 Sol od OpenAI, który zostaje w tyle w liczbach Anthropic dla pracy wiedzo‑wej.
Na twoim miejscu już bym się przełączył, jeśli jesteś na Sonnet 5, ale zaktualizuj się w kwestii zmian w API. Opus 5.5 zostaw do projektów, w których model musi zdecydować, co zbudować.
Jeśli chcesz dowiedzieć się więcej o tworzeniu z modelami Anthropic, polecam nasz kurs Introduction to Claude Models.