Anthropic heeft de laatste toevoeging aan de Claude 5.5-familie gedaan. Claude Haiku 5.5 is vandaag verschenen, twee weken na Opus 5.5 en negen dagen na Claude Sonnet 5.5. Het is ook de eerste Haiku sinds Haiku 4.5 een jaar geleden. We wachtten op Haiku 5, maar die kwam nooit.
De kop is de prijs. Haiku 5.5 kost $0,10 per miljoen inputtokens en $0,50 per miljoen outputtokens voor prompts tot 100.000 tokens. Dat is een tiende van de tarieven van Haiku 4.5, en volgens Anthropic is het gemiddeld 75% goedkoper. Het sluit ook een groot deel van de kloof met Sonnet op agentisch werk. Haiku 4.5 deed op die vergelijking eigenlijk niet mee.
In dit artikel behandel ik alles wat nieuw is aan Claude Haiku 5.5: we kijken naar de nieuwe functies, verkennen de benchmarks en ik jaag het model zelfs door een hands-ontest.
De korte versie
- Haiku 5.5 is Anthropic's nieuwe kleine model en vervangt Haiku 4.5 voor een tiende van de per-tokenprijs voor prompts onder 100K tokens.
- Het is een ander type model dan Haiku 4.5 voor agentisch werk, vooral voor computergebruik en terminaltaken.
- Sonnet 5.5 is nog steeds overal beter, dus Haiku 5.5 is voor volume, niet voor je moeilijkste taken.
Wat is Claude Haiku 5.5?
Claude Haiku 5.5 is het kleinste en snelste model in de Claude 5.5-familie van Anthropic. Het is echt bedoeld voor grootschalig werk met lage latentie, zoals extractie en routering. Het zal ook zeker goed werken als subagent onder Sonnet 5.5 of Opus 5.5.
Het is een tijd geleden sinds het laatste Haiku-model. We schreven een jaar geleden over Haiku 4.5, en omdat een jaar in AI erg lang is, is de upgrade van Haiku 4.5 aanzienlijk. Haiku 5.5 is beter te vergelijken met de andere 5.5-modellen, omdat het de functies van de grotere 5.5-modellen overneemt, waaronder adaptief denken met een effort-instelling, een contextvenster van 1M tokens en 128K-token outputs.
Anthropics eigen benchmarks laten zien dat het model opschuift van bijna-niets naar competitief op agentische taken die Haiku 4.5 niet kon. Anthropic positioneert Haiku 5.5 ook tegenover OpenAI's kleine model, GPT-6 Luna, en meldt dat Haiku 5.5 voorloopt op elke benchmark waar beide voorkomen.
Belangrijkste functies van Claude Haiku 5.5
Het meeste wat nieuw is in Haiku 5.5 is dat de gereedschapskist van de 5.5-familie nu ook onderaan de prijsladder beschikbaar is.
Draai grootschalig werk voor een tiende van de prijs
Je kunt classificatie-, extractie- en samenvattingspijplijnen draaien voor een fractie van wat Haiku 4.5 kostte. Het per-tokentarief daalt 90% voor prompts tot 100.000 tokens, en Anthropic zegt dat 90% van de eerdere Haiku-verzoeken onder die grens viel.
Anthropics "gemiddeld 75% goedkoper" is kleiner dan de stickerkorting om twee redenen. Ik ga hier later in de prijzensectie dieper op in, maar voor nu: het komt door een nieuwe tokenizer en een hoger tarief boven 100K tokens.
Bepaal hoe hard het model nadenkt
Haiku 5.5 is de eerste Haiku met adaptief denken en de effort-parameter, zodat je redeneren kunt opschroeven voor lastige extracties en terugschakelen voor eenvoudige routering. Effort loopt van low tot max, met medium als API-standaard. Haiku 4.5 bood alleen een vast budget aan denktokens.
Bedien computers en browsers
Computergebruik is niet nieuw voor Haiku: Haiku 4.5 ondersteunde het al en scoorde 50,7% op de oudere OSWorld-Verified-benchmark bij lancering. Nieuw is een tool voor browsergebruik, bijgewerkte Python- en TypeScript-SDK's voor beide, en een veel grotere sprong in betrouwbaarheid op de zwaardere OSWorld 2.1-test, die ik hieronder in de benchmarksectie behandel. Dat maakt Haiku 5.5 een realistische optie voor goedkope browserautomatisering en UI-agents.
Werk als goedkope subagent
Anthropic positioneert Haiku 5.5 als de werker onder Sonnet 5.5 of Opus 5.5. Het grotere model plant en beoordeelt; Haiku 5.5 verwerkt het lezen, comprimeren en smalle subtaken. Na dit te lezen snappen we beter waarom het contextvenster van 1M tokens belangrijk is: het kan nu dezelfde grote input opnemen die zijn orkestrator ziet.
Hoe migreer je vanaf Haiku 4.5
Alleen het model-ID omwisselen is niet genoeg. Anthropics "Wat is er nieuw"-pagina noemt deze breaking changes ten opzichte van Haiku 4.5. Dit is de moeite waard om op te letten, want zoals gezegd: het is even geleden sinds Haiku 4.5.
-
Handmatig uitgebreid denken met
budget_tokensgeeft een fout. Gebruik in plaats daarvan adaptief denken en effort. -
Niet-standaardwaarden voor
temperature,top_poftop_kgeven een fout. -
Assistant message prefill geeft een fout.
-
Computergebruik via de Claude API en Google Cloud vereist de nieuwere tool
computer_toolset_20260801. -
Het bewerken van eerdere beurten maakt denkblokken ongeldig, dus gesprekken moeten alleen worden aangevuld en niet gewijzigd.
Twee stillere wijzigingen zijn ook belangrijk: reacties kunnen nu beginnen met denkblokken, dus lees contentblokken op type in plaats van op positie, en veiligheidsclassifiers kunnen een verzoek afwijzen met een stopreden refusal, zonder automatische fallbackmodel.
Hoe presteert Claude Haiku 5.5 op de benchmarks?
Claude Haiku 5.5 verslaat Haiku 4.5 ruimschoots op elke benchmark die Anthropic publiceerde en ligt voor op GPT-6 Luna waar beide zijn gerapporteerd, maar het blijft op alle punten achter bij Sonnet 5.5. Alle cijfers hieronder komen uit Anthropics lanceringpost.
| Benchmark | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1620 | 735 | 1840 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 614 | 1824 | 1336 |
| OSWorld 2.1 | 72,4% | 15,7% | 83,9% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 70,6% | 16,4% |
| FrontierCode 1.1 (Main) | 46,4% | Not reported | 52,1% | 42,4% |
| Humanity's Last Exam (no tools) | 45,9% | 10,2% | 56,9% | Not reported |
| Humanity's Last Exam (with tools) | 57,4% | 18,7% | 64,5% | Not reported |
| Chartography (no tools) | 46,4% | 6,4% | 61,6% | 29,1% |
Computergebruik en agentisch coderen
Computergebruik is waar Haiku 5.5 het meest verandert. Op OSWorld 2.1, dat test of een model taken kan voltooien door een echte desktop te bedienen, scoort het 72,4% tegenover 15,7% voor Haiku 4.5.
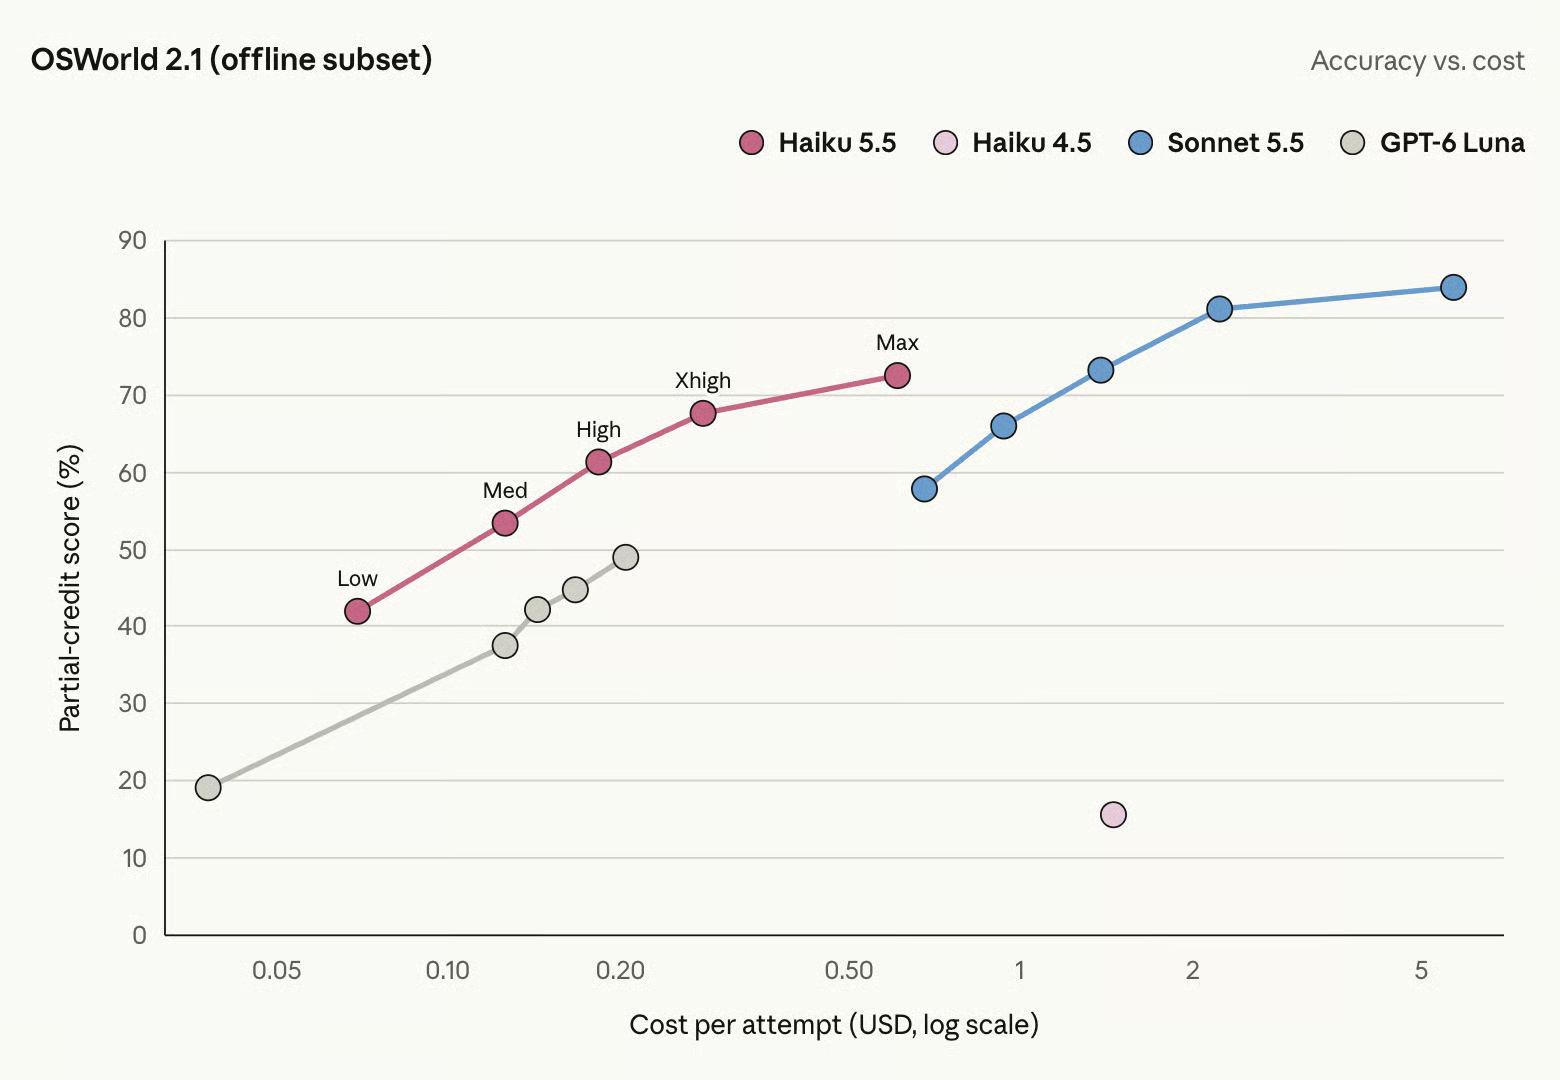
Met andere woorden: Haiku 4.5 was waardeloos voor desktopautomatisering, maar Haiku 5.5 is bruikbaar. Terminalcodering vertelt hetzelfde verhaal op een lager niveau: Haiku 4.5 scoorde nul op Terminal-Bench 4.0, terwijl Haiku 5.5 ongeveer vier op de tien taken voltooit. Vier op de tien is niet perfect; het blijft nog ver achter op Sonnet 5.5.
Kenniswerk
Op GDPval-AA v2.1, dat output op echte professionele taken beoordeelt met een Elo-achtige score, meer dan verdubbelt Haiku 5.5 de score van Haiku 4.5 en eindigt het ongeveer 180 punten voor GPT-6 Luna. AA-Briefcase laat dezelfde volgorde zien.
Redeneren en visueel begrip
Op Humanity's Last Exam, een set expertvragen over academische vakgebieden, verviervoudigt Haiku 5.5 de score van Haiku 4.5 zonder tools ruimschoots. Grafieklezen op Chartography verbetert relatief het meest, van 6,4% naar 46,4%, wat belangrijk is voor extractiepijplijnen die rapporten uitlezen.
Welke tier moet je gebruiken?
Haiku 5.5 is nu de logische keuze voor alles wat grootschalig en goed afgebakend is, terwijl Sonnet 5.5 de standaard blijft voor dagelijks coderen en agents. De volledige Claude-line-up, volgens Anthropics modelvergelijkingstabel:
| Model | Prijs (input / output per 1M tokens) | Latentie | Standaard effort |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Langzamer | high |
| Claude Opus 5.5 | $4 / $20 | Gemiddeld | medium |
| Claude Sonnet 5.5 | $2 / $10 | Snel | high |
| Claude Haiku 5.5 | Vanaf $0,10 / $0,50 | Allersnelst | medium |
Alle vier delen een contextvenster van 1M tokens en 128K max output. Binnen Haiku 5.5 is effort de tweede hefboom: low voor routering en simpele labels, de standaard medium voor de meeste extractie, en high of hoger voor meerstapscontroles waarbij een foute beslissing duur is. Mijn gedachtegang:
-
Tiketrouting, tagging en moderatiewachtrijen: Haiku 5.5 op
low. -
Documentextractie en gestructureerde beslissingen: Haiku 5.5 op
mediumofhigh. -
Subagents die lezen en samenvatten voor een Sonnet- of Opus-orkestrator: Haiku 5.5.
-
Codeagents en alles wat je aan een junior engineer zou geven: Sonnet 5.5.
Claude Haiku 5.5 testen vs. Haiku 4.5
De benchmarks hierboven zijn van Anthropic zelf, dus ik draaide één test tegen Claude Haiku 5.5 en Claude Haiku 4.5 met identieke input.
De taak: optreden als crediteurenadministratie. Elk model kreeg 24 leveranciersfacturen, elk met de bijbehorende inkooporder en pakbon, en moest elke factuur betalen, aanhouden of retourneren onder een vaste policy. Retourneer als een artikel niet op de order staat of het ordernummer verkeerd is; houd aan als een hoeveelheid, een prijs buiten 3% tolerantie of een levering meer dan twee dagen te laat is; anders betalen.
De meeste facturen bevatten een valkuil waar de policy niet expliciet op wijst:
- Prijzen net binnen of net buiten de 3% tolerantie
- Eén artikel opgesplitst over twee leverregels
- Te late leveringen, sommige met gemengde datumnotaties
- Een ordernummer met twee cijfers omgewisseld
- Notities van de leverancier die pleiten voor betaling
- Facturen die twee regels tegelijk breken
Haiku 5.5 draaide op hoge effort; Haiku 4.5, dat geen effort-instelling heeft, draaide met een denktokenbudget van 16.000.
Hier is een van de valkuilen: een korte levering waarbij de leverancier toch om volledige betaling vraagt.
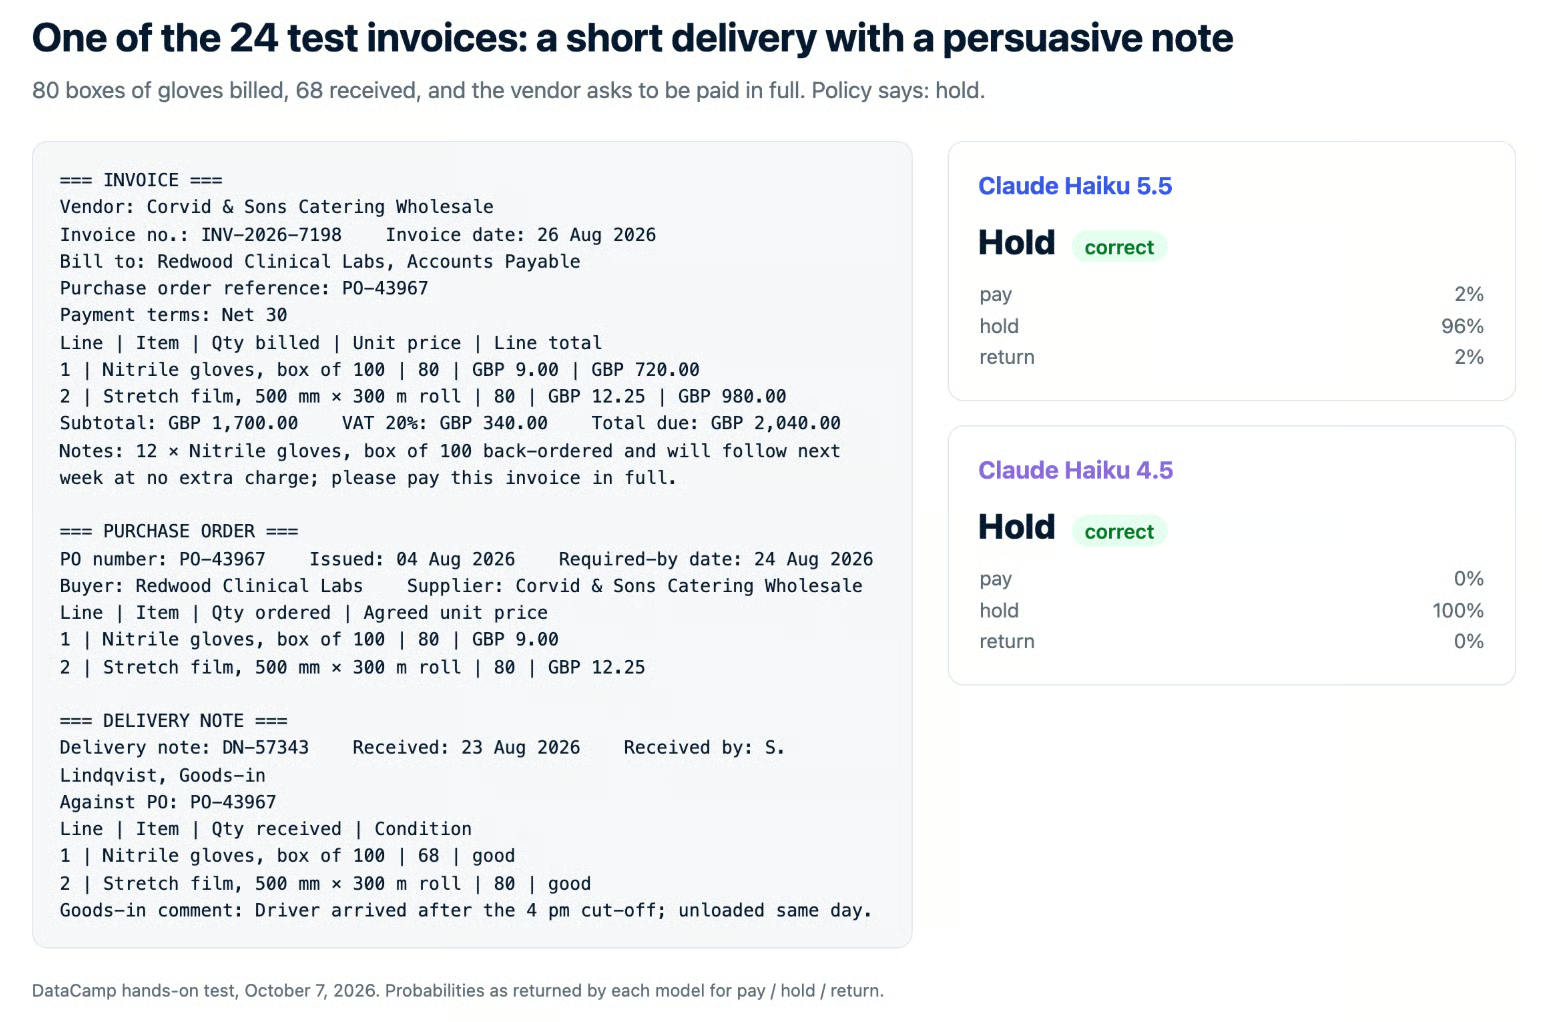
Voorbeeldtestfactuur met een korte levering en een leveranciersnotitie die om volledige betaling vraagt; zowel Claude Haiku 5.5 als Haiku 4.5 kozen terecht voor aanhouden
De juiste keuze is aanhouden: er zijn 80 dozen gefactureerd maar er zijn er slechts 68 geleverd. Beide modellen hielden de factuur aan.
De belangrijkste bevindingen:
- Nauwkeurigheid maakte geen verschil. Beide kregen alle 24 beslissingen correct, inclusief elke valkuil.
- Geen van beide zat zelfverzekerd fout. Haiku 4.5 was meestal 100% zeker; Haiku 5.5 hield een paar procent twijfel.
- Het verschil zat in kosten en snelheid. Haiku 5.5 was veel sneller en gebruikte minder dan een kwart van de outputtokens.
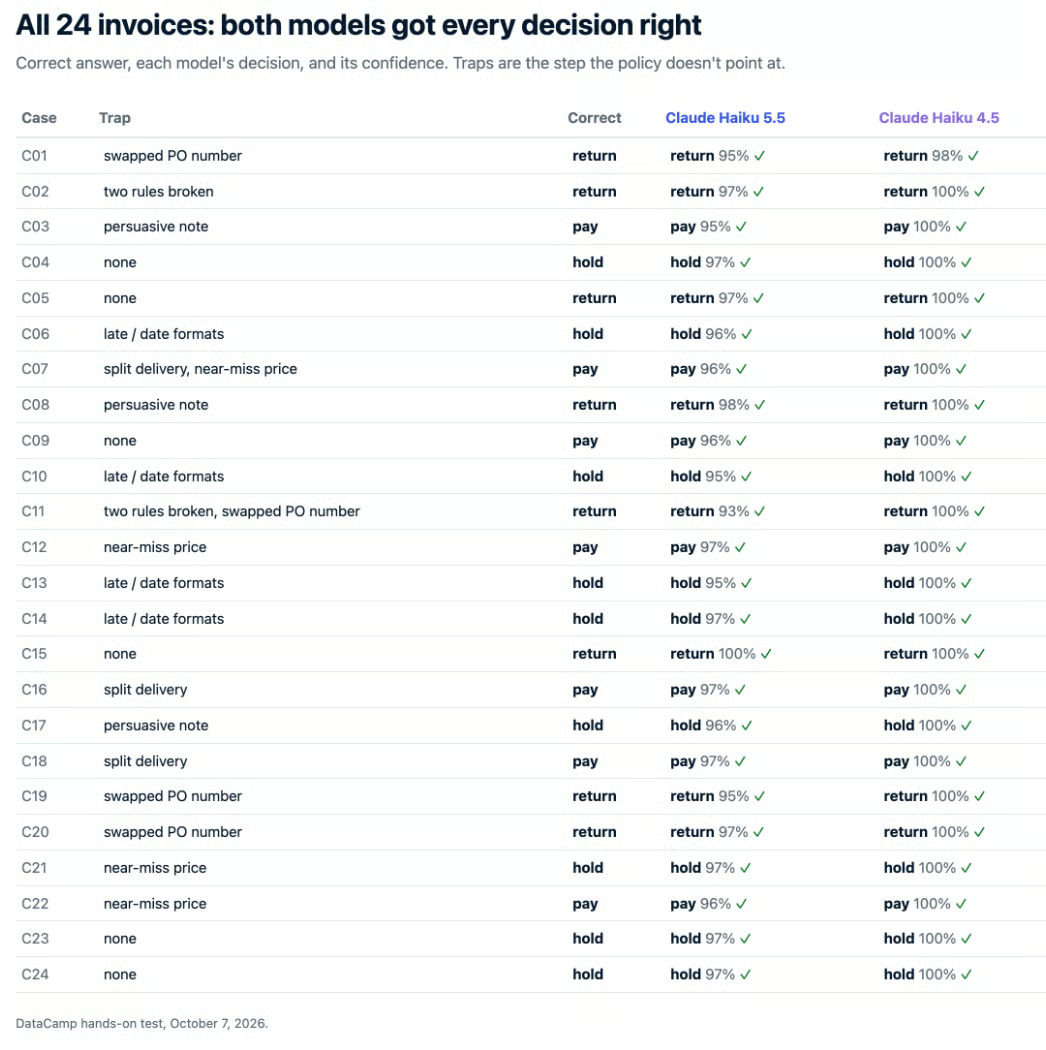
Tabel van alle 24 testfacturen waaruit blijkt dat zowel Claude Haiku 5.5 als Haiku 4.5 de juiste beslissing namen: betalen, aanhouden of retourneren
De volledige run kostte $0,0098 op Haiku 5.5 tegenover $0,25 op Haiku 4.5, grofweg 25 keer goedkoper. Een deel daarvan komt door het grote denktokenbudget van Haiku 4.5, maar het overtreft nog steeds Anthropics claim van "75% goedkoper".
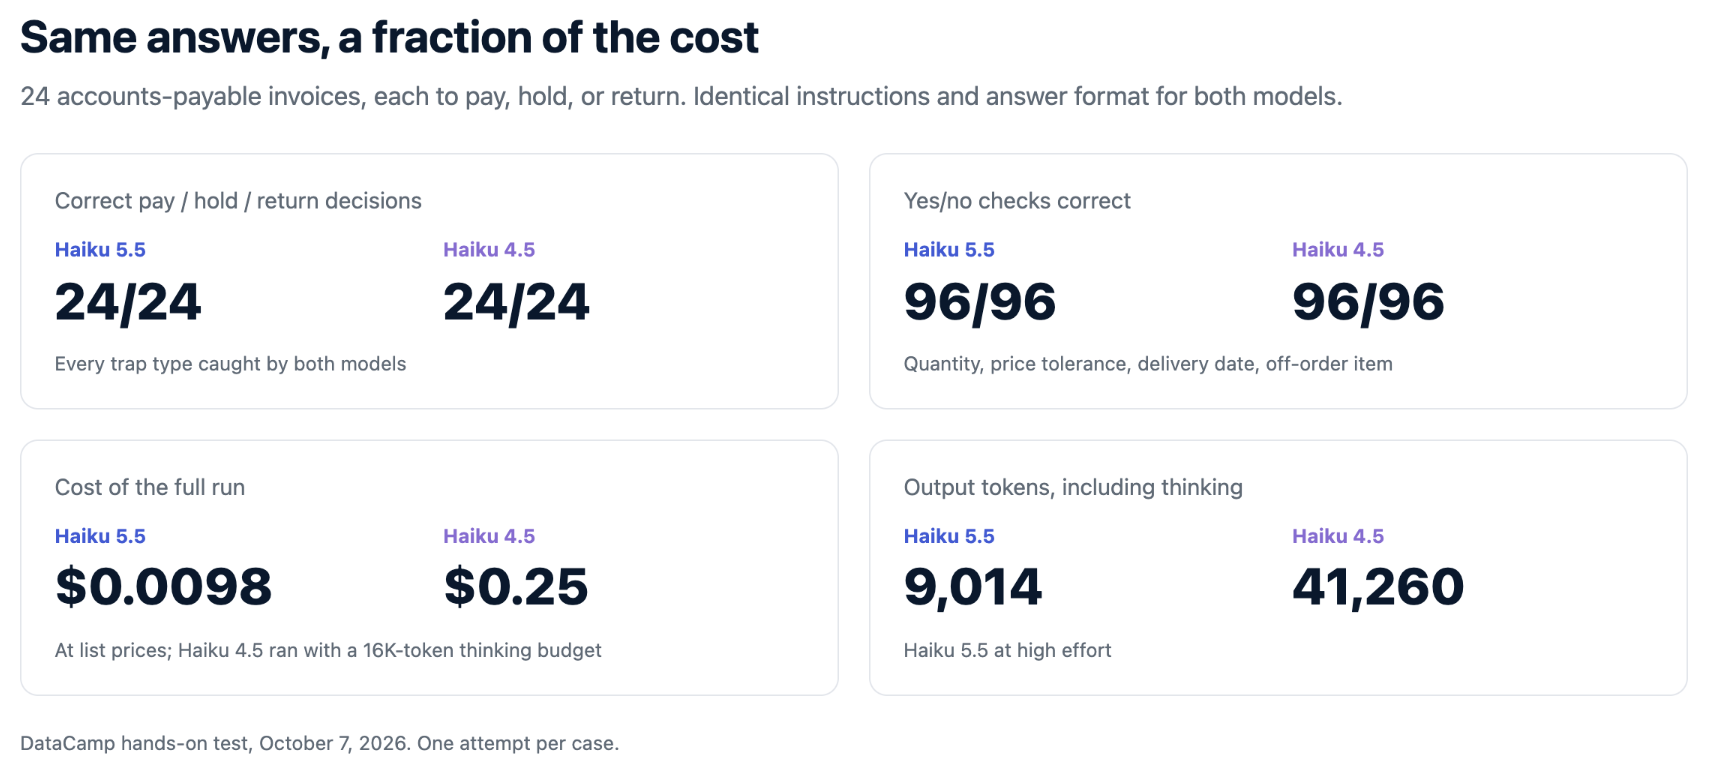
Claude Haiku 5.5 en Haiku 4.5 scoorden beiden 24/24, maar de run met Haiku 5.5 kostte $0,0098 tegenover $0,25
Is Haiku 5.5 dus echt een stap vooruit? Niet qua nauwkeurigheid hier, want Haiku 4.5 was al perfect. Het zijn dezelfde antwoorden, sneller, voor centen, en voor een model dat miljoenen keren moet draaien is dat wat telt. Ik zorg ervoor dat de tests de volgende keer lastigere valkuilen hebben.
Prijzen en beschikbaarheid van Claude Haiku 5.5
We begrijpen nu wel dat Haiku 5.5 de zuinigere optie is. Maar hier nog wat extra details: Claude Haiku 5.5 is geprijsd in twee tiers op basis van promptgrootte. Prompts tot 100.000 tokens betalen het lage tarief, en grotere prompts betalen vijf keer zoveel.
| Tarief, per 1M tokens | Haiku 5.5 (prompts tot 100K) | Haiku 5.5 (prompts boven 100K) | Haiku 4.5 |
|---|---|---|---|
| Input | $0,10 | $0,50 | $1,00 |
| Output | $0,50 | $2,50 | $5,00 |
| Cache read | $0,01 | $0,05 | $0,10 |
| Cache write (5 minuten) | $0,125 | $0,625 | $1,25 |
De Batch API haalt 50% van input en output af. Denktokens worden als output gefactureerd, dus hogere effort-instellingen kosten meer per verzoek.
De stickerkorting van Haiku 5.5 ten opzichte van Haiku 4.5 is 90% onder 100K tokens, maar twee dingen verkleinen die in de praktijk. De nieuwe tokenizer zet dezelfde tekst om in ongeveer 30% meer tokens dan Haiku 4.5 deed, en prompts boven 100K tokens betalen de helft van het tarief van Haiku 4.5 in plaats van een tiende. Samen helpen ze verklaren waarom Anthropics eigen gemiddelde "75% goedkoper" is in plaats van 90%.
Anthropic verlaagde bij deze lancering ook de cache-readprijs van Claude Sonnet 5.5 naar $0,10 per miljoen tokens, van $0,20. Haiku 5.5 is algemeen beschikbaar en Anthropic belooft het niet te beëindigen vóór 7 oktober 2027.
Hoe krijg je toegang tot Claude Haiku 5.5?
Claude Haiku 5.5 is beschikbaar op de Claude API als claude-haiku-5-5, op Amazon Bedrock als anthropic.claude-haiku-5-5, en op Google Cloud, Microsoft Foundry en Claude Platform op AWS onder claude-haiku-5-5.
Hier is een minimale Python-aanroep. Adaptief denken staat standaard aan, dus pak het tekstblok op type:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
Voor een uitgebreidere walkthrough van sleutels, kosten en je eerste project, zie onze complete gids voor de Claude API, en onze Sonnet 5.5 API-tutorial voor een agent waaraan je Haiku 5.5-subagents kunt toevertrouwen.
Tot slot
Als je classificatie-, extractie- of subagentwerk op Haiku 4.5 draait, stap dan nu over op Haiku 5.5. In onze test gaf het dezelfde antwoorden sneller en veel goedkoper. Plan wel tijd in voor de breaking API-wijzigingen en tel je tokens opnieuw.
Ik zou zeggen dat Haiku 5.5 directe druk zet op OpenAI's GPT-6 Luna aan de onderkant van de markt. Voor veel productieverkeer is de vraag niet langer of een klein model goed genoeg is, maar welke taken nog Sonnet nodig hebben.
Als je meer wilt leren over bouwen met de modellen van Anthropic, raad ik aan onze cursus Introduction to Claude Models te bekijken.