A Anthropic fez a última adição à família Claude 5.5. O Claude Haiku 5.5 chegou hoje, duas semanas depois do Opus 5.5 e nove dias após o Claude Sonnet 5.5. Também é o primeiro Haiku desde o Haiku 4.5, há um ano. Aguardamos o Haiku 5, mas ele nunca chegou.
O grande destaque é o preço. O Haiku 5.5 custa US$ 0,10 por milhão de tokens de entrada e US$ 0,50 por milhão de tokens de saída para prompts de até 100.000 tokens. É um décimo das tarifas do Haiku 4.5, e a Anthropic diz que fica, em média, 75% mais barato. Ele também reduz boa parte da diferença em tarefas agentivas em relação ao Sonnet. O Haiku 4.5 nem entrava nessa conversa.
Neste artigo, vou cobrir tudo o que há de novo no Claude Haiku 5.5: os novos recursos, os benchmarks e um teste prático para ver o modelo em ação.
Resumo rápido
- O Haiku 5.5 é o novo modelo pequeno da Anthropic, substituindo o Haiku 4.5 a um décimo do preço por token para prompts abaixo de 100 mil tokens.
- Em trabalho agentivo, é outra categoria em relação ao Haiku 4.5, especialmente em uso de computador e tarefas de terminal.
- O Sonnet 5.5 ainda lidera em tudo; o Haiku 5.5 é para volume, não para os desafios mais difíceis.
O que é o Claude Haiku 5.5?
O Claude Haiku 5.5 é o menor e mais rápido modelo da família Claude 5.5 da Anthropic. Seu foco é trabalho de alto volume e baixa latência, como extração e roteamento. Ele também deve funcionar muito bem como subagente sob o Sonnet 5.5 ou o Opus 5.5.
Faz tempo desde o último Haiku. Escrevemos sobre o Haiku 4.5 há um ano, e como um ano é uma eternidade em IA, o salto do Haiku 4.5 é grande. O Haiku 5.5 se compara melhor aos outros 5.5 porque herda os recursos dos modelos maiores: raciocínio adaptativo com nível de esforço, janela de contexto de 1M de tokens e saídas de até 128K tokens.
Os próprios benchmarks da Anthropic mostram a evolução de quase zero para competitivo em tarefas agentivas que o Haiku 4.5 não conseguia fazer. A Anthropic também posiciona o Haiku 5.5 contra o modelo pequeno da OpenAI, o GPT-6 Luna, e relata o Haiku 5.5 à frente em todos os benchmarks em que ambos aparecem.
Principais recursos do Claude Haiku 5.5
O que mais chama atenção no Haiku 5.5 é a caixa de ferramentas da linha 5.5 chegando ao patamar de preço mais baixo.
Rode alto volume por um décimo do preço
Você pode executar pipelines de classificação, extração e sumarização por uma fração do custo do Haiku 4.5. A tarifa por token cai 90% para prompts de até 100.000 tokens, e a Anthropic diz que 90% dos pedidos anteriores de Haiku ficam abaixo desse limite.
O número de "75% mais barato em média" da Anthropic é menor que o desconto de vitrine por dois motivos. Vou detalhar isso na seção de preços, mas, por ora, saiba que é por causa de um tokenizador novo e de uma tarifa maior acima de 100K tokens.
Controle o quanto ele pensa
O Haiku 5.5 é o primeiro Haiku com raciocínio adaptativo e o parâmetro de esforço, para você aumentar o raciocínio em extrações difíceis e reduzir em roteamentos simples. O esforço vai de low a max, com medium como padrão na API. O Haiku 4.5 oferecia apenas um orçamento fixo de tokens de raciocínio.
Operação de computadores e navegadores
O uso de computador não é novo no Haiku: o Haiku 4.5 já suportava e marcou 50,7% no benchmark OSWorld-Verified antigo no lançamento. A novidade é uma ferramenta de uso de navegador, SDKs atualizados de Python e TypeScript para ambos e um salto muito maior de confiabilidade no OSWorld 2.1, mais difícil, que eu cubro na seção de benchmarks abaixo. Isso torna o Haiku 5.5 uma opção viável para automação de navegador barata e agentes de interface.
Atue como subagente econômico
A Anthropic posiciona o Haiku 5.5 como o "faz-tudo" sob o Sonnet 5.5 ou o Opus 5.5. O modelo maior planeja e avalia, e o Haiku 5.5 cuida da leitura, compactação e subtarefas específicas. Depois de ler isso, fica mais claro por que a janela de 1M de tokens importa: ele consegue receber as mesmas grandes entradas que o orquestrador vê.
Como migrar do Haiku 4.5
Trocar o ID do modelo não basta. A página "O que há de novo" da Anthropic lista estas quebras de compatibilidade em relação ao Haiku 4.5. Vale prestar atenção porque, como dissemos, já faz um tempo desde o Haiku 4.5.
-
O pensamento estendido manual com
budget_tokensretorna erro. Use raciocínio adaptativo e esforço. -
Valores não padrão de
temperature,top_poutop_kretornam erro. -
Prefill de mensagem do assistente retorna erro.
-
O uso de computador na Claude API e no Google Cloud exige a ferramenta mais recente
computer_toolset_20260801. -
Editar turnos anteriores invalida blocos de raciocínio, então conversas devem ser apenas de append.
Duas mudanças mais sutis também importam: as respostas agora podem começar com blocos de raciocínio, então leia blocos de conteúdo pelo tipo e não pela posição; e os classificadores de segurança podem recusar um pedido com o motivo de parada refusal, sem fallback automático para outro modelo.
Como o Claude Haiku 5.5 se sai nos benchmarks?
O Claude Haiku 5.5 supera o Haiku 4.5 por ampla margem em todos os benchmarks publicados pela Anthropic e lidera o GPT-6 Luna onde ambos são reportados, mas fica atrás do Sonnet 5.5 em todos eles. Todos os números abaixo vêm do post de lançamento da Anthropic.
| Benchmark | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1620 | 735 | 1840 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 614 | 1824 | 1336 |
| OSWorld 2.1 | 72,4% | 15,7% | 83,9% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 70,6% | 16,4% |
| FrontierCode 1.1 (Main) | 46,4% | Not reported | 52,1% | 42,4% |
| Humanity's Last Exam (sem ferramentas) | 45,9% | 10,2% | 56,9% | Not reported |
| Humanity's Last Exam (com ferramentas) | 57,4% | 18,7% | 64,5% | Not reported |
| Chartography (sem ferramentas) | 46,4% | 6,4% | 61,6% | 29,1% |
Uso de computador e codificação agentiva
Uso de computador é onde o Haiku 5.5 mais muda. No OSWorld 2.1, que testa se um modelo conclui tarefas operando um desktop real, ele marca 72,4% contra 15,7% do Haiku 4.5.
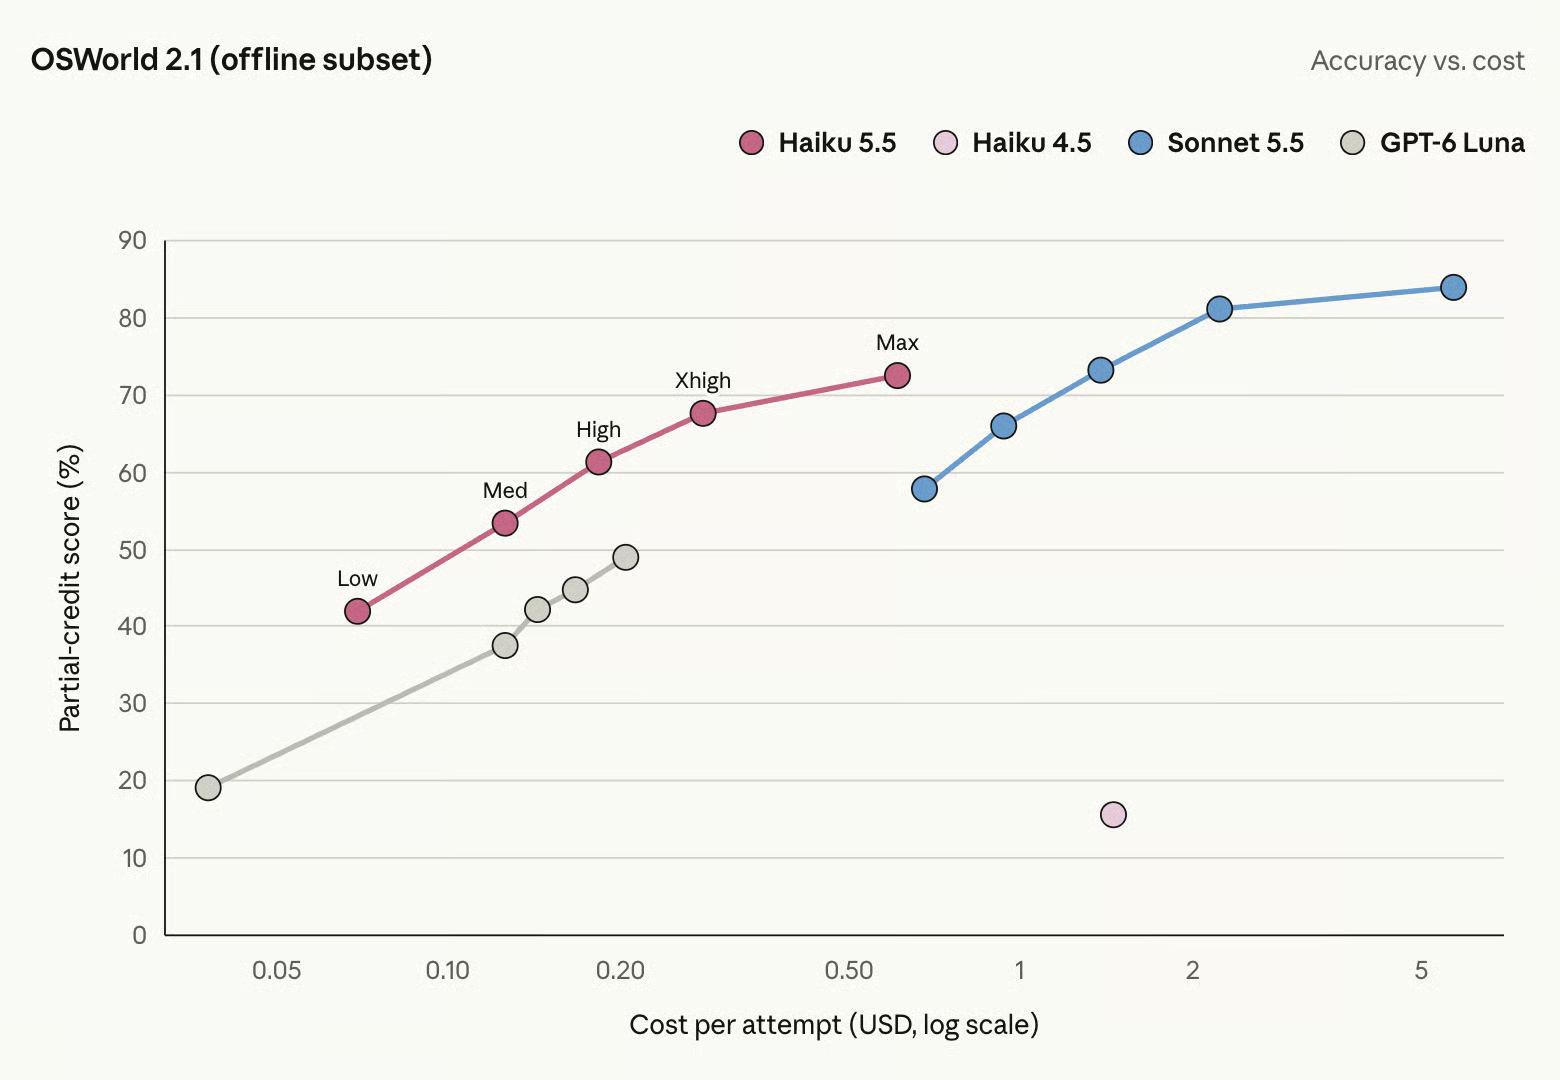
Em outras palavras, o Haiku 4.5 era inútil para automação de desktop, mas o Haiku 5.5 é utilizável. No terminal, a história se repete em outro nível: o Haiku 4.5 marcou zero no Terminal-Bench 4.0, enquanto o Haiku 5.5 conclui cerca de quatro em cada dez tarefas. Quatro em dez não é perfeito; ainda fica bem abaixo do Sonnet 5.5.
Trabalho de conhecimento
No GDPval-AA v2.1, que avalia saídas em tarefas profissionais reais com uma pontuação no estilo Elo, o Haiku 5.5 mais que dobra a nota do Haiku 4.5 e termina cerca de 180 pontos à frente do GPT-6 Luna. O AA-Briefcase mostra a mesma ordem.
Raciocínio e visão
No Humanity's Last Exam, um conjunto de perguntas de nível especialista em áreas acadêmicas, o Haiku 5.5 mais que quadruplica a pontuação do Haiku 4.5 sem ferramentas. A leitura de gráficos no Chartography melhora proporcionalmente ainda mais, de 6,4% para 46,4%, o que é essencial para pipelines de extração que leem relatórios.
Qual nível usar?
O Haiku 5.5 agora é a escolha óbvia para tarefas de alto volume e bem definidas, enquanto o Sonnet 5.5 segue como padrão para o dia a dia em código e agentes. A linha completa do Claude, segundo a tabela de comparação da Anthropic:
| Modelo | Preço (entrada / saída por 1M de tokens) | Latência | Esforço padrão |
|---|---|---|---|
| Claude Fable 5.1 | US$ 10 / US$ 50 | Mais lenta | high |
| Claude Opus 5.5 | US$ 4 / US$ 20 | Moderada | medium |
| Claude Sonnet 5.5 | US$ 2 / US$ 10 | Rápida | high |
| Claude Haiku 5.5 | A partir de US$ 0,10 / US$ 0,50 | Mais rápida | medium |
Os quatro compartilham janela de contexto de 1M de tokens e saída máxima de 128K. Dentro do Haiku 5.5, o esforço é o segundo ajuste: low para roteamento e rótulos simples; medium (padrão) para a maior parte das extrações; e high ou acima para checagens em várias etapas, quando um erro custa caro. Minha sugestão:
-
Roteamento de tickets, tagging e filas de moderação: Haiku 5.5 em
low. -
Extração de documentos e decisões estruturadas: Haiku 5.5 em
mediumouhigh. -
Subagentes que leem e fazem sumarização para um orquestrador Sonnet ou Opus: Haiku 5.5.
-
Agentes de código e qualquer coisa que você passaria para um engenheiro júnior: Sonnet 5.5.
Testando o Claude Haiku 5.5 vs. Haiku 4.5
Os benchmarks acima são da própria Anthropic, então rodei um teste com o Claude Haiku 5.5 e o Claude Haiku 4.5 com entradas idênticas.
A tarefa: atuar como contas a pagar. Cada modelo recebeu 24 faturas de fornecedores, cada uma com seu pedido de compra e nota de entrega, e teve que pagar, segurar (hold) ou devolver cada uma sob uma política fixa. Devolver se um item não estiver no pedido ou se o número do pedido estiver errado; segurar se houver divergência de quantidade, preço além de 3% de tolerância ou entrega com mais de dois dias de atraso; caso contrário, pagar.
A maioria das faturas escondia uma armadilha que a política não destaca:
- Preços no limite interno ou externo da tolerância de 3%
- Um item dividido em duas linhas de entrega
- Entregas atrasadas, algumas com formatos de data mistos
- Um número de pedido com dois dígitos trocados
- Observações do fornecedor pedindo pagamento
- Faturas quebrando duas regras ao mesmo tempo
O Haiku 5.5 rodou em esforço alto; o Haiku 4.5, que não tem ajuste de esforço, usou um orçamento de 16.000 tokens de raciocínio.
Aqui vai uma das armadilhas: uma entrega com falta, em que o fornecedor pede pagamento integral mesmo assim.
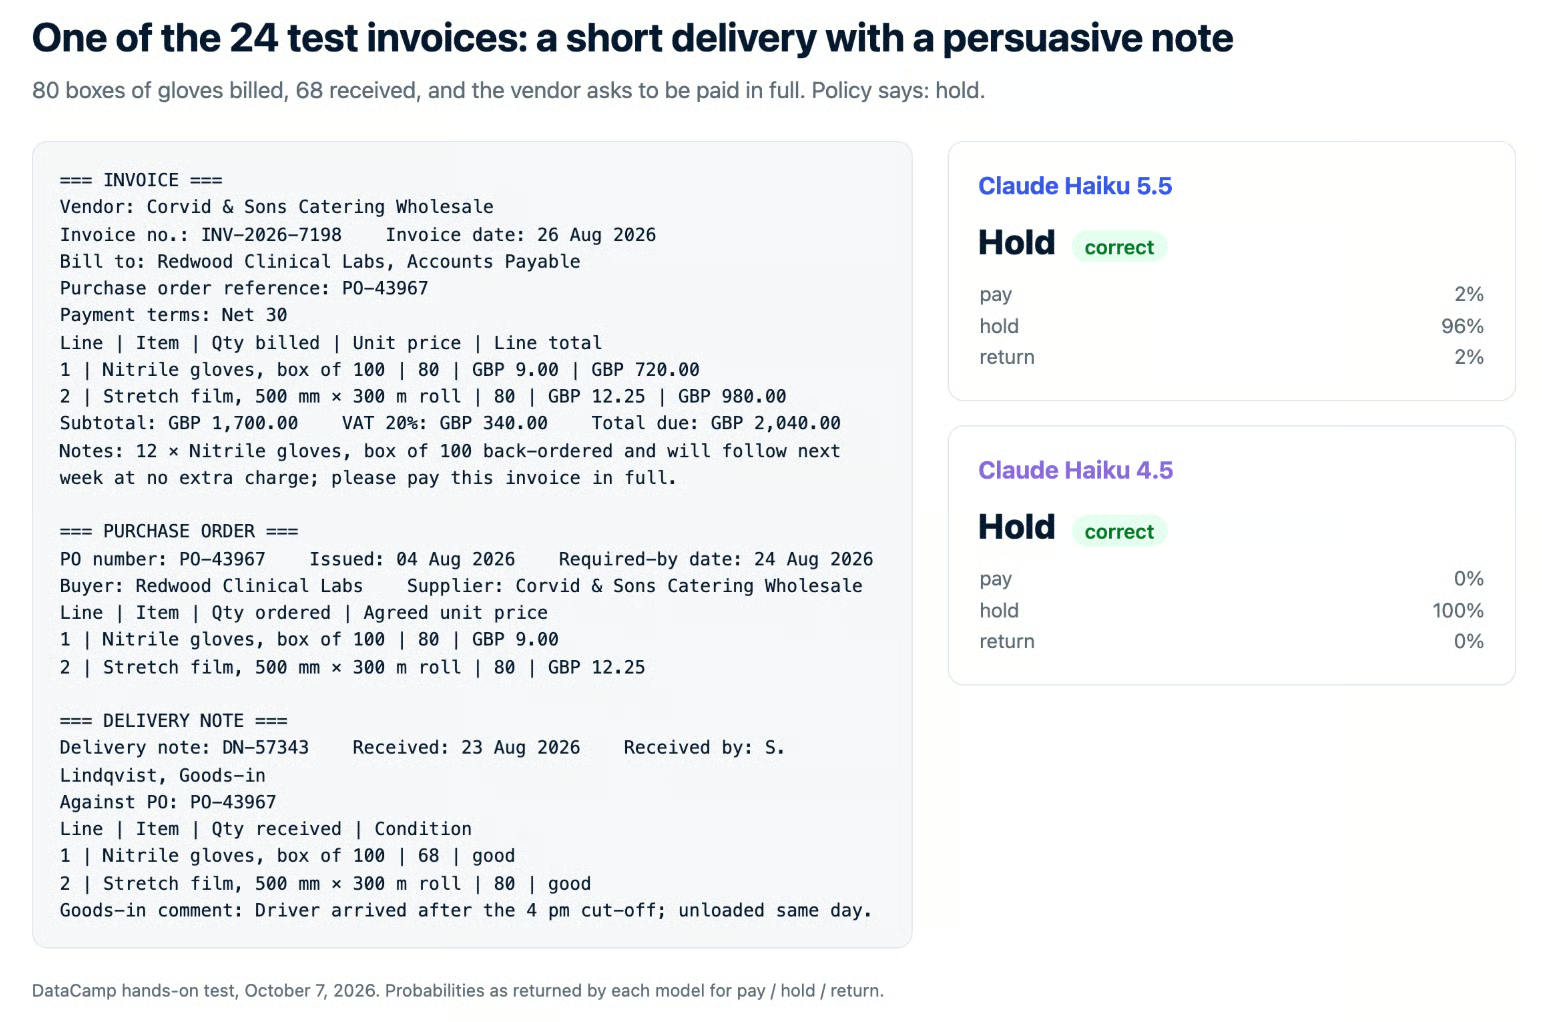
Fatura de exemplo com entrega menor e nota do fornecedor pedindo pagamento integral; tanto o Claude Haiku 5.5 quanto o Haiku 4.5 responderam corretamente por hold
A decisão certa é segurar: 80 caixas foram faturadas, mas apenas 68 chegaram. Ambos os modelos seguraram.
Principais achados:
- Acurácia não diferenciou. Ambos acertaram as 24 decisões, incluindo todas as armadilhas.
- Nenhum estava confiante e errado. O Haiku 4.5 geralmente estava 100% certo; o Haiku 5.5 manteve alguns pontos percentuais de dúvida.
- A diferença foi custo e velocidade. O Haiku 5.5 foi muito mais rápido e usou menos de um quarto dos tokens de saída.
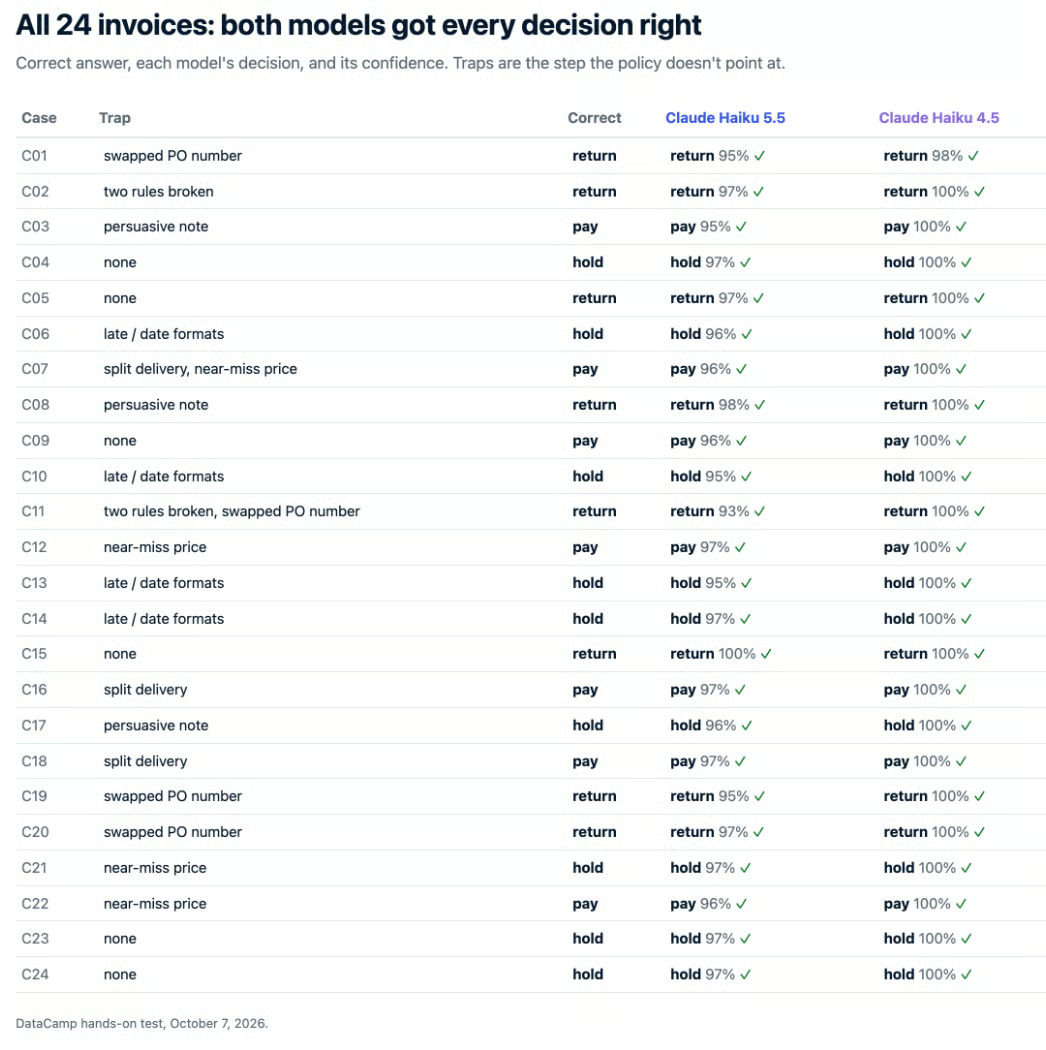
Tabela com as 24 faturas de teste mostrando que tanto o Claude Haiku 5.5 quanto o Haiku 4.5 decidiram corretamente entre pagar, segurar ou devolver
A execução completa custou US$ 0,0098 no Haiku 5.5 contra US$ 0,25 no Haiku 4.5, cerca de 25 vezes mais barato. Parte disso vem do grande orçamento de raciocínio do Haiku 4.5, mas ainda assim supera a afirmação de "75% mais barato" da Anthropic.
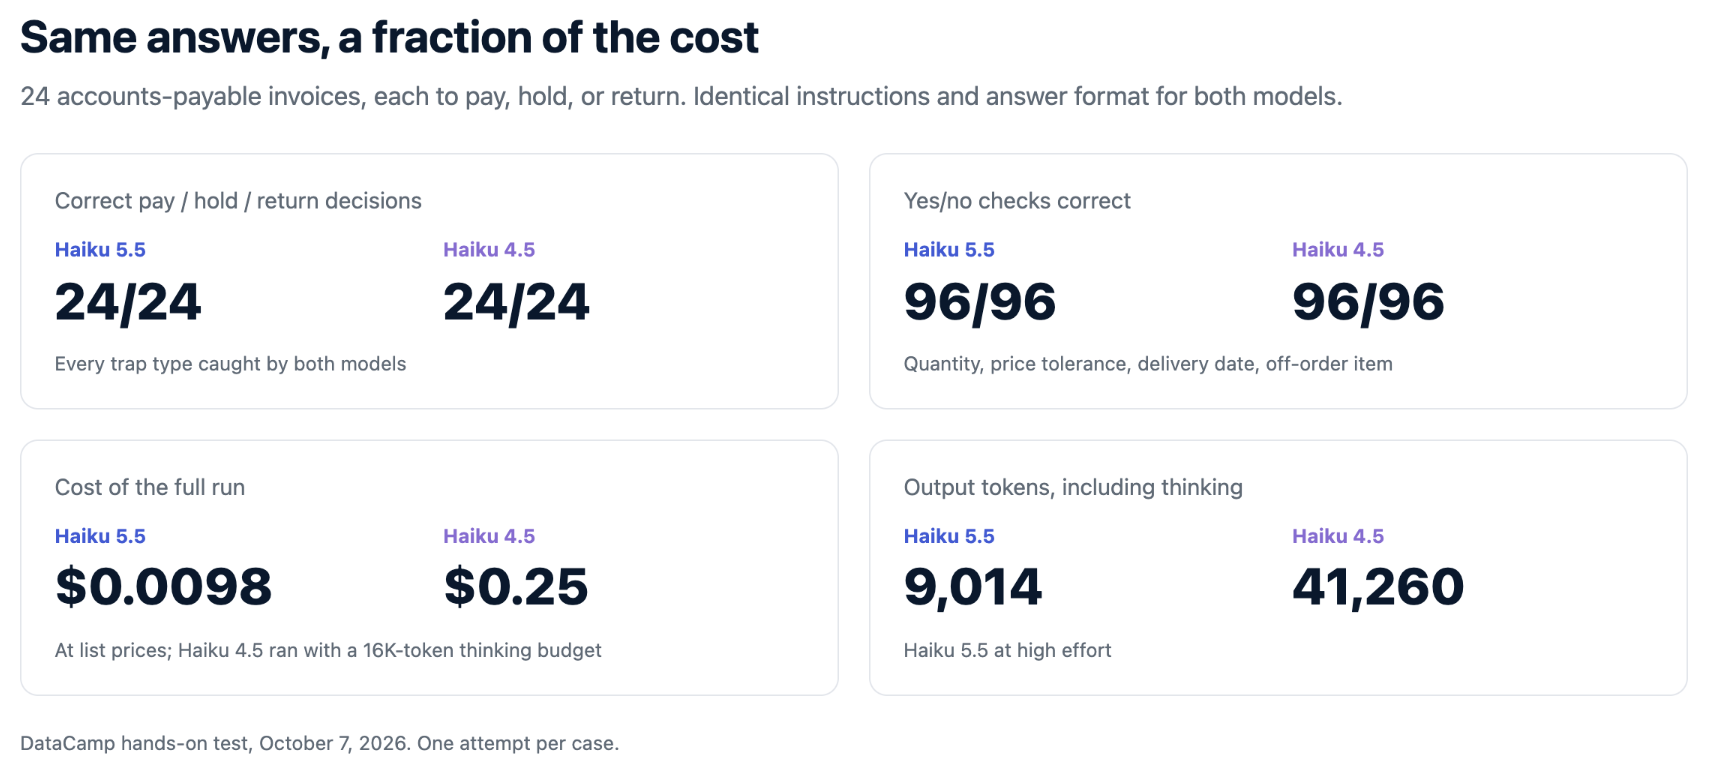
Claude Haiku 5.5 e Haiku 4.5 marcaram 24/24, mas a execução do Haiku 5.5 custou US$ 0,0098 contra US$ 0,25
Então, o Haiku 5.5 é um avanço real? Não em acurácia aqui, já que o Haiku 4.5 já foi perfeito. São as mesmas respostas, mais rápido, por centavos — e para um modelo feito para rodar milhões de vezes, é isso que importa. Vou deixar os testes com armadilhas mais difíceis da próxima vez.
Preços e disponibilidade do Claude Haiku 5.5
Já deu para notar que o Haiku 5.5 é a opção mais econômica. Mas tem um detalhe adicional: o Claude Haiku 5.5 tem dois níveis de preço conforme o tamanho do prompt. Prompts de até 100.000 tokens pagam a tarifa baixa, e prompts maiores pagam cinco vezes mais.
| Tarifa, por 1M de tokens | Haiku 5.5 (prompts até 100K) | Haiku 5.5 (prompts acima de 100K) | Haiku 4.5 |
|---|---|---|---|
| Entrada | US$ 0,10 | US$ 0,50 | US$ 1,00 |
| Saída | US$ 0,50 | US$ 2,50 | US$ 5,00 |
| Leitura de cache | US$ 0,01 | US$ 0,05 | US$ 0,10 |
| Gravação de cache (5 minutos) | US$ 0,125 | US$ 0,625 | US$ 1,25 |
A Batch API dá 50% de desconto em entrada e saída. Tokens de raciocínio são cobrados como saída, então níveis de esforço mais altos custam mais por requisição.
O desconto de vitrine do Haiku 5.5 em relação ao Haiku 4.5 é de 90% abaixo de 100K tokens, mas duas coisas o reduzem na prática. O novo tokenizador transforma o mesmo texto em cerca de 30% mais tokens do que o Haiku 4.5 fazia, e prompts acima de 100K tokens pagam metade da tarifa do Haiku 4.5, e não um décimo. Juntas, essas razões explicam por que a própria média da Anthropic é de "75% mais barato" e não 90%.
A Anthropic também reduziu o preço de leitura de cache do Claude Sonnet 5.5 para US$ 0,10 por milhão de tokens, de US$ 0,20, junto com este lançamento. O Haiku 5.5 está geralmente disponível, e a Anthropic se compromete a não descontinuá-lo antes de 7 de outubro de 2027.
Como obter acesso ao Claude Haiku 5.5?
O Claude Haiku 5.5 está disponível na Claude API como claude-haiku-5-5, na Amazon Bedrock como anthropic.claude-haiku-5-5, e no Google Cloud, Microsoft Foundry e Claude Platform na AWS como claude-haiku-5-5.
Aqui vai uma chamada mínima em Python. O raciocínio adaptativo vem ativado por padrão, então selecione o bloco de texto pelo tipo:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
Para um passo a passo completo de chaves, custos e seu primeiro projeto, veja nosso guia completo da Claude API e nosso tutorial da API do Sonnet 5.5 para um agente ao qual você pode delegar subagentes Haiku 5.5.
Considerações finais
Se você roda classificação, extração ou trabalho de subagentes no Haiku 4.5, migre para o Haiku 5.5 agora. No nosso teste, ele deu as mesmas respostas, mais rápido e muito mais barato. Só lembre de reservar tempo para as mudanças de API que quebram compatibilidade e de recontar seus tokens.
Eu diria que o Haiku 5.5 coloca pressão direta sobre o GPT-6 Luna da OpenAI no segmento de entrada. Para muito tráfego em produção, a pergunta deixou de ser se um modelo pequeno é bom o suficiente para virar qual trabalho ainda precisa do Sonnet.
Se você quer aprender mais sobre como construir com os modelos da Anthropic, recomendo nosso curso Introduction to Claude Models.