Anthropic ha completato la famiglia Claude 5.5. Oggi è arrivato Claude Haiku 5.5, due settimane dopo Opus 5.5 e nove giorni dopo Claude Sonnet 5.5. È anche il primo Haiku dopo Haiku 4.5 di un anno fa. Abbiamo atteso Haiku 5, ma non è mai arrivato.
La notizia principale è il prezzo. Haiku 5.5 costa $0,10 per milione di token in input e $0,50 per milione di token in output per prompt fino a 100.000 token. È un decimo delle tariffe di Haiku 4.5, e Anthropic afferma che in media è il 75% più economico. Inoltre colma gran parte del divario con Sonnet sul lavoro agentico. Su quel confronto, Haiku 4.5 non era nemmeno in discussione.
In questo articolo vedremo tutte le novità di Claude Haiku 5.5, tra funzionalità inedite, benchmark, e un test pratico per metterlo alla prova.
Il sunto rapido
- Haiku 5.5 è il nuovo modello piccolo di Anthropic, sostituisce Haiku 4.5 a un decimo del prezzo per token per prompt sotto i 100K token.
- Nel lavoro agentico è di tutt’altra categoria rispetto a Haiku 4.5, soprattutto per l’uso del computer e i task da terminale.
- Sonnet 5.5 resta comunque davanti ovunque: Haiku 5.5 serve per il volume, non per i compiti più duri.
Che cos’è Claude Haiku 5.5?
Claude Haiku 5.5 è il modello più piccolo e veloce della famiglia Claude 5.5 di Anthropic. Il suo vero scopo è gestire lavoro ad alto volume e sensibile alla latenza, come estrazione e instradamento. Funziona anche benissimo come subagent sotto Sonnet 5.5 o Opus 5.5.
È passato un po’ dall’ultimo modello Haiku. Abbiamo scritto di Haiku 4.5 un anno fa, e visto che un anno nell’IA è tantissimo, l’upgrade è consistente. Haiku 5.5 va confrontato con gli altri modelli 5.5 perché eredita le loro funzionalità: ragionamento adattivo con impostazione dell’effort, finestra di contesto da 1M di token e output da 128K token.
I benchmark di Anthropic mostrano un passaggio da quasi zero a competitivo nei task agentici che Haiku 4.5 non riusciva a fare. Anthropic posiziona anche Haiku 5.5 contro il modello piccolo di OpenAI, GPT-6 Luna, e riporta Haiku 5.5 davanti in ogni benchmark in cui compaiono entrambi.
Le principali funzionalità di Claude Haiku 5.5
La gran parte delle novità in Haiku 5.5 è costituita dalla cassetta degli attrezzi della serie 5.5 che arriva in fondo alla scala dei prezzi.
Esegui lavoro ad alto volume a un decimo del prezzo
Puoi far girare pipeline di classificazione, estrazione e sintesi a una frazione del costo di Haiku 4.5. La tariffa per token scende del 90% per prompt fino a 100.000 token, e Anthropic afferma che il 90% delle richieste Haiku precedenti rientrava sotto quella soglia.
La cifra del "75% più economico in media" di Anthropic è inferiore allo sconto nominale per due motivi. Ne parlerò meglio nella sezione prezzi, ma per ora sappi che dipende da un nuovo tokenizer e da una tariffa più alta oltre i 100K token.
Controlla quanto a fondo ragiona
Haiku 5.5 è il primo Haiku con ragionamento adattivo e parametro di effort, così puoi alzare il ragionamento per estrazioni complesse e abbassarlo per instradamenti semplici. L’effort va da low a max, con medium come default dell’API. Haiku 4.5 offriva solo un budget fisso di token di ragionamento.
Opera computer e browser
L’uso del computer non è nuovo per Haiku: Haiku 4.5 lo supportava e al lancio segnava il 50,7% sul vecchio benchmark OSWorld-Verified. La novità è uno strumento per l’uso del browser, SDK Python e TypeScript aggiornati per entrambi e un salto di affidabilità molto maggiore sul più impegnativo test OSWorld 2.1, che tratto nella sezione benchmark qui sotto. Questo rende Haiku 5.5 un’opzione concreta per automazioni browser economiche e agent UI.
Lavora come subagent economico
Anthropic propone Haiku 5.5 come operaio sotto Sonnet 5.5 o Opus 5.5. Il modello più grande pianifica e valuta, e Haiku 5.5 gestisce lettura, compattazione e sotto-task mirati. Dopo averlo letto, è più chiaro perché la finestra di contesto da 1M di token è importante: ora può ricevere gli stessi input enormi visti dall’orchestratore.
Come migrare da Haiku 4.5
Non basta cambiare l’ID del modello. La pagina “Novità” di Anthropic elenca queste modifiche breaking rispetto a Haiku 4.5. Vale la pena farci attenzione perché, come detto, è passato un bel po’ da Haiku 4.5.
-
Il ragionamento esteso manuale con
budget_tokensrestituisce un errore. Usa invece ragionamento adattivo ed effort. -
Valori non predefiniti di
temperature,top_potop_krestituiscono un errore. -
Il prefill del messaggio dell’assistente restituisce un errore.
-
L’uso del computer su Claude API e Google Cloud richiede il tool più recente
computer_toolset_20260801. -
Modificare turni precedenti invalida i blocchi di ragionamento, quindi le conversazioni dovrebbero essere solo in append.
Contano anche due cambiamenti più silenziosi: le risposte ora possono iniziare con blocchi di ragionamento, quindi leggi i blocchi di contenuto per tipo e non per posizione; inoltre i classificatori di sicurezza possono rifiutare una richiesta con un motivo di stop refusal, senza fallback automatico a un altro modello.
Come va Claude Haiku 5.5 nei benchmark?
Claude Haiku 5.5 supera Haiku 4.5 di largo margine in ogni benchmark pubblicato da Anthropic e precede GPT-6 Luna ovunque compaiano entrambi, ma sta dietro a Sonnet 5.5 in tutti. Tutti i dati qui sotto provengono dal post di lancio di Anthropic.
| Benchmark | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1620 | 735 | 1840 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 614 | 1824 | 1336 |
| OSWorld 2.1 | 72,4% | 15,7% | 83,9% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 70,6% | 16,4% |
| FrontierCode 1.1 (Main) | 46,4% | Not reported | 52,1% | 42,4% |
| Humanity's Last Exam (no tools) | 45,9% | 10,2% | 56,9% | Not reported |
| Humanity's Last Exam (with tools) | 57,4% | 18,7% | 64,5% | Not reported |
| Chartography (no tools) | 46,4% | 6,4% | 61,6% | 29,1% |
Uso del computer e coding agentico
L’uso del computer è dove Haiku 5.5 cambia di più. Su OSWorld 2.1, che testa se un modello sa completare task operando un desktop reale, segna il 72,4% contro il 15,7% di Haiku 4.5.
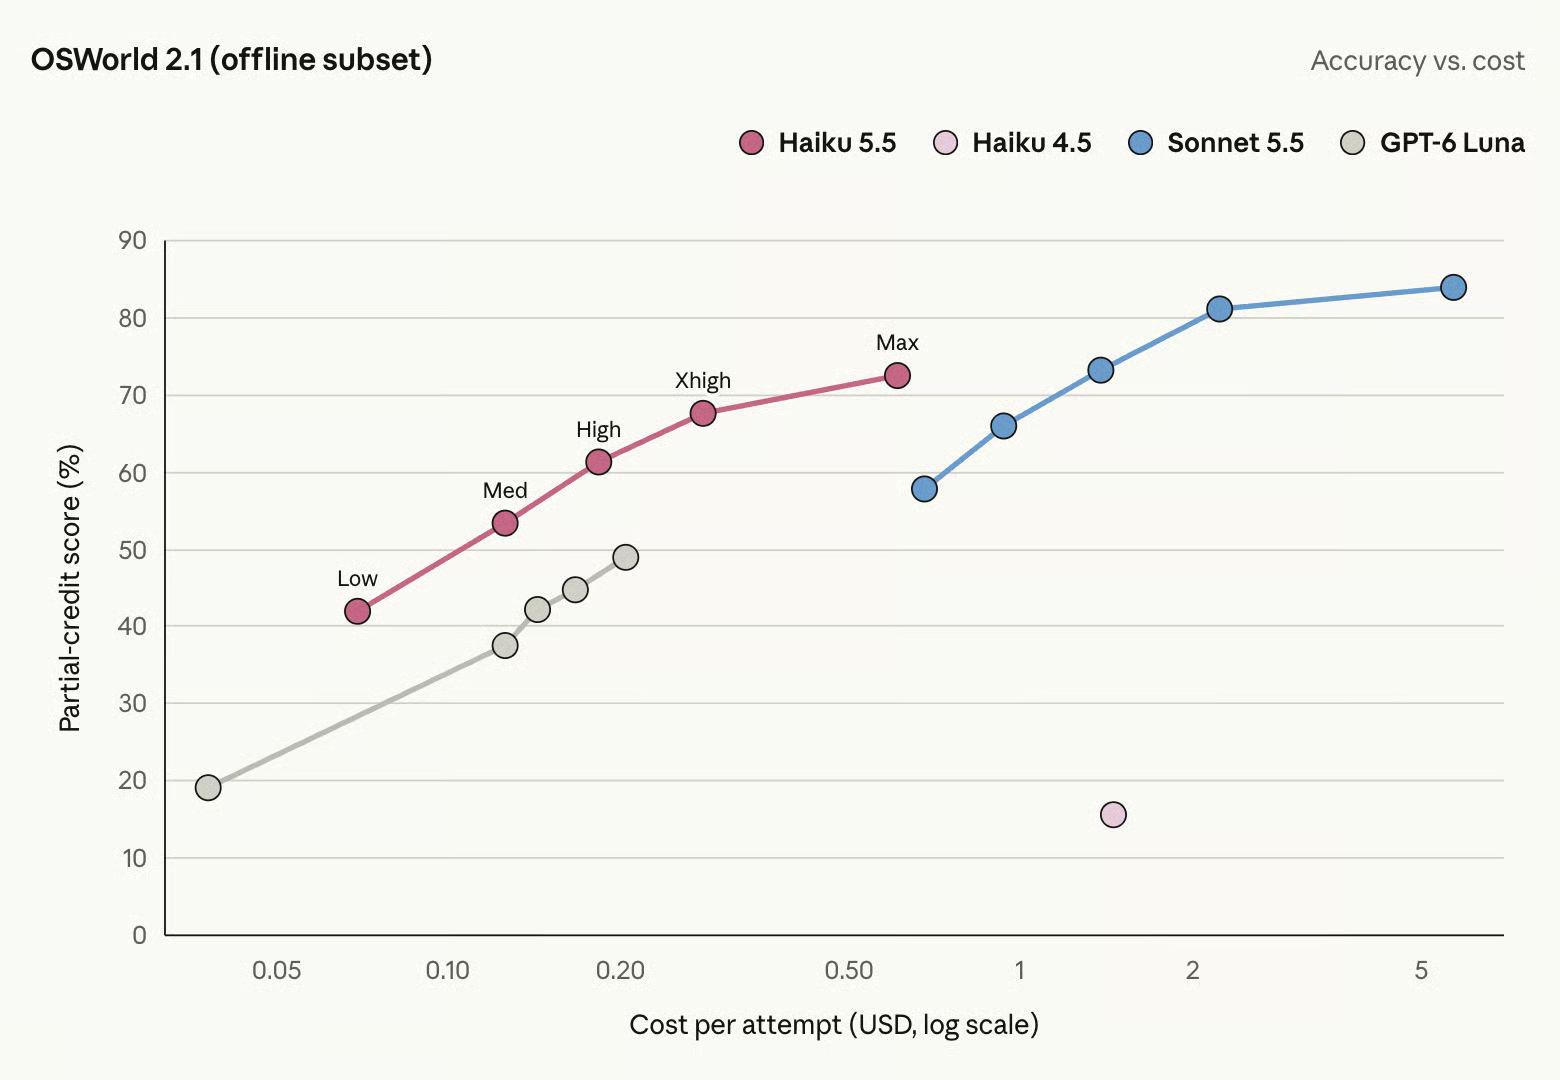
In altre parole, Haiku 4.5 era inutile per l’automazione desktop, ma Haiku 5.5 è utilizzabile. Il coding da terminale racconta la stessa storia a un livello più basso: Haiku 4.5 segnava zero su Terminal-Bench 4.0, mentre Haiku 5.5 completa circa quattro task su dieci. Quattro su dieci non è perfetto; resta ben sotto Sonnet 5.5.
Lavoro di conoscenza
Su GDPval-AA v2.1, che valuta l’output su compiti professionali reali con un punteggio in stile Elo, Haiku 5.5 più che raddoppia il punteggio di Haiku 4.5 e finisce circa 180 punti davanti a GPT-6 Luna. AA-Briefcase mostra lo stesso ordine.
Ragionamento e comprensione visiva
Su Humanity's Last Exam, una serie di domande di livello esperto in vari campi accademici, Haiku 5.5 più che quadruplica il punteggio di Haiku 4.5 senza strumenti. La lettura di grafici su Chartography migliora di più in termini relativi, dal 6,4% al 46,4%, cosa importante per pipeline di estrazione che leggono report.
Quale livello dovresti usare?
Haiku 5.5 è ora la scelta ovvia per tutto ciò che è ad alto volume e ben definito, mentre Sonnet 5.5 resta il default per coding quotidiano e agent. La lineup completa di Claude, secondo la tabella di confronto dei modelli di Anthropic:
| Model | Price (input / output per 1M tokens) | Latency | Default effort |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Slower | high |
| Claude Opus 5.5 | $4 / $20 | Moderate | medium |
| Claude Sonnet 5.5 | $2 / $10 | Fast | high |
| Claude Haiku 5.5 | From $0.10 / $0.50 | Fastest | medium |
Tutti e quattro condividono una finestra di contesto da 1M di token e output massimo da 128K. All’interno di Haiku 5.5, l’effort è la seconda leva: low per instradamento ed etichette semplici, il default medium per la maggior parte delle estrazioni, e high o superiore per controlli multi-step dove un errore costa caro. La mia linea guida:
-
Instradamento ticket, tagging e code di moderazione: Haiku 5.5 a
low. -
Estrazione da documenti e decisioni strutturate: Haiku 5.5 a
mediumohigh. -
Subagent che leggono e sintetizzano per un orchestratore Sonnet o Opus: Haiku 5.5.
-
Agent di coding e qualsiasi cosa affideresti a un junior: Sonnet 5.5.
Test: Claude Haiku 5.5 vs Haiku 4.5
I benchmark sopra sono di Anthropic, quindi ho eseguito un test contro Claude Haiku 5.5 e Claude Haiku 4.5 con input identici.
Il compito: agire come contabilità fornitori. Ogni modello ha ricevuto 24 fatture di fornitori, ciascuna con il proprio ordine d’acquisto e bolla di consegna, e doveva decidere se pagare, mettere in attesa o restituire ciascuna in base a una policy fissa. Restituisci se un articolo non è nell’ordine o il numero d’ordine è sbagliato; metti in attesa se c’è discrepanza su quantità, prezzo oltre il 3% di tolleranza o consegna in ritardo di oltre due giorni; altrimenti paga.
La maggior parte delle fatture nascondeva una trappola che la policy non indica esplicitamente:
- Prezzi appena dentro o fuori la tolleranza del 3%
- Un articolo diviso su due righe di consegna
- Consegne in ritardo, alcune con formati di data misti
- Un numero d’ordine con due cifre invertite
- Note del fornitore che spingono per il pagamento
- Fatture che infrangono due regole insieme
Haiku 5.5 ha girato con effort alto; Haiku 4.5, che non ha impostazione di effort, con un budget di 16.000 token di ragionamento.
Ecco una delle trappole: una consegna corta in cui il fornitore chiede comunque il pagamento completo.
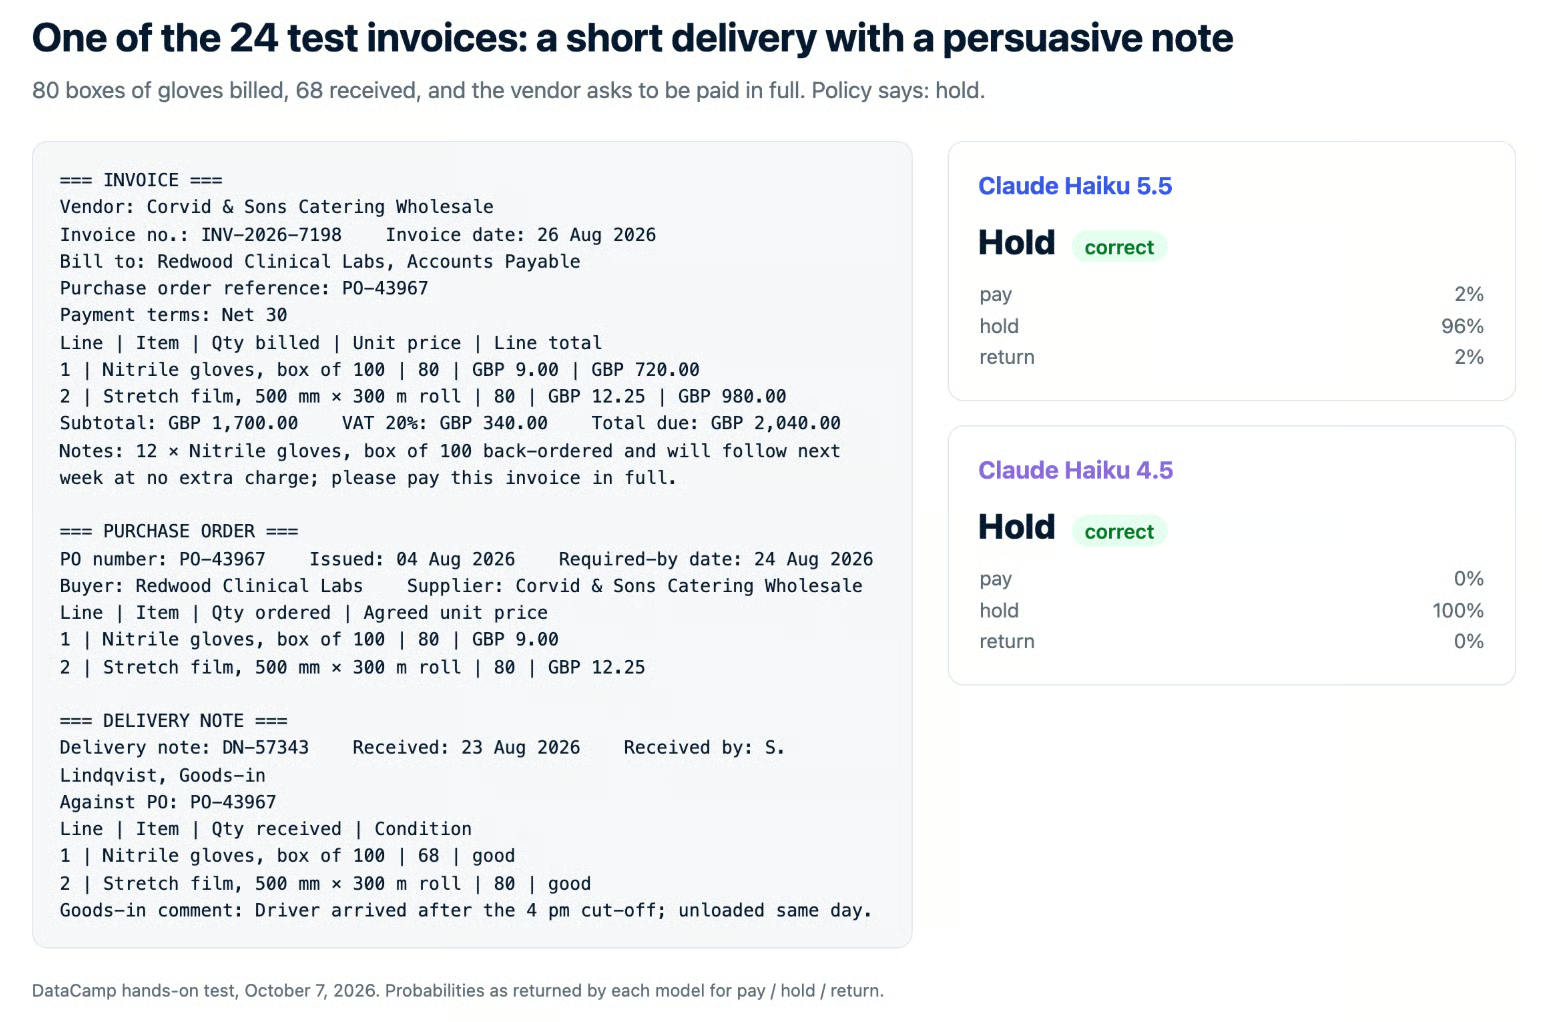
Esempio di fattura di test con consegna corta e nota del fornitore che chiede il pagamento completo; sia Claude Haiku 5.5 sia Haiku 4.5 hanno risposto correttamente “hold”
La decisione giusta è hold: sono stati fatturati 80 scatole ma ne sono arrivate solo 68. Entrambi i modelli l’hanno messa in attesa.
I principali risultati:
- L’accuratezza non li ha separati. Entrambi hanno azzeccato tutte le 24 decisioni, incluse tutte le trappole.
- Nessuno era sicuro e sbagliato. Haiku 4.5 era di solito sicuro al 100%; Haiku 5.5 lasciava qualche punto percentuale di dubbio.
- La differenza era costo e velocità. Haiku 5.5 è stato molto più veloce e ha usato meno di un quarto dei token in output.
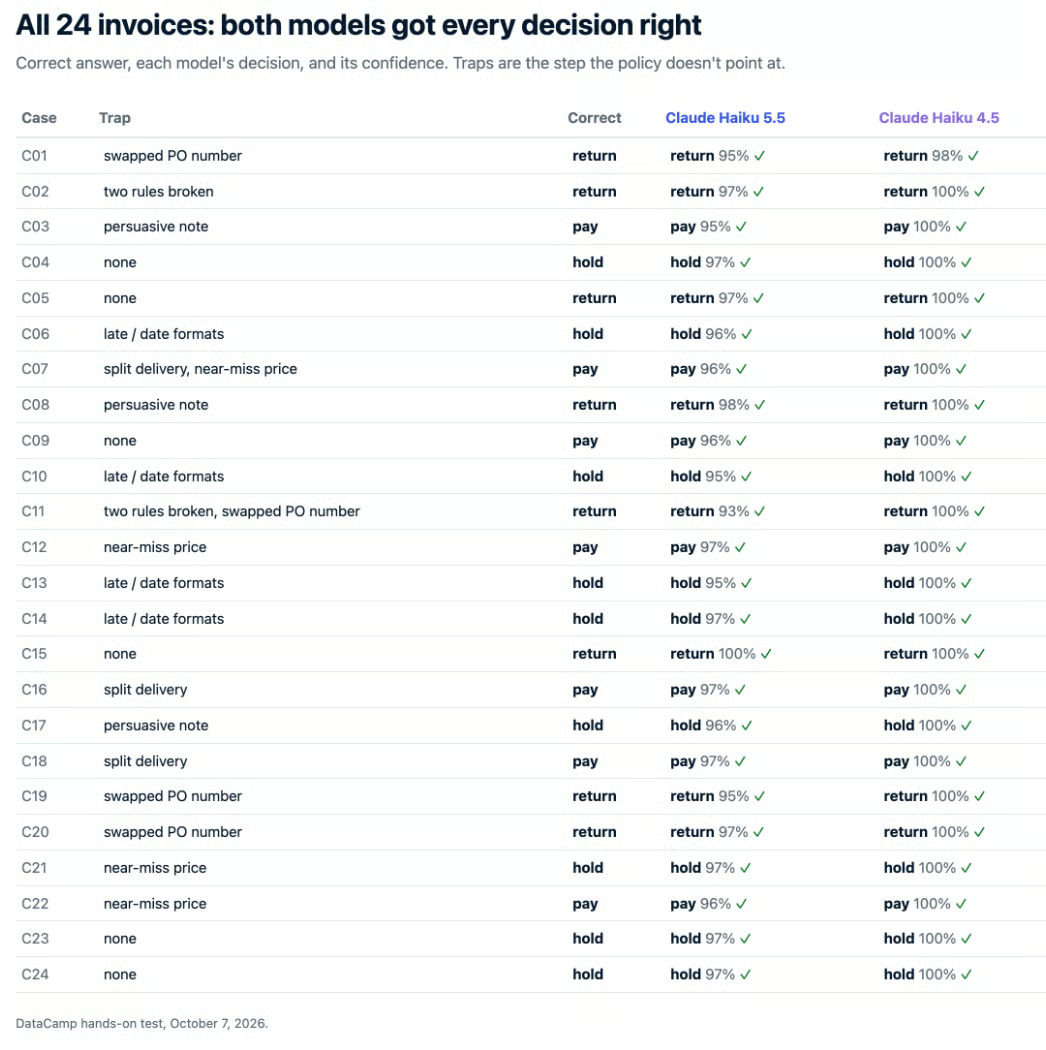
Tabella di tutte le 24 fatture di test che mostra come sia Claude Haiku 5.5 sia Haiku 4.5 abbiano scelto la decisione corretta tra paga, metti in attesa o restituisci
L’intera esecuzione è costata $0,0098 su Haiku 5.5 contro $0,25 su Haiku 4.5, circa 25 volte meno. In parte dipende dal grande budget di ragionamento di Haiku 4.5, ma supera comunque il claim di Anthropic del “75% più economico”.
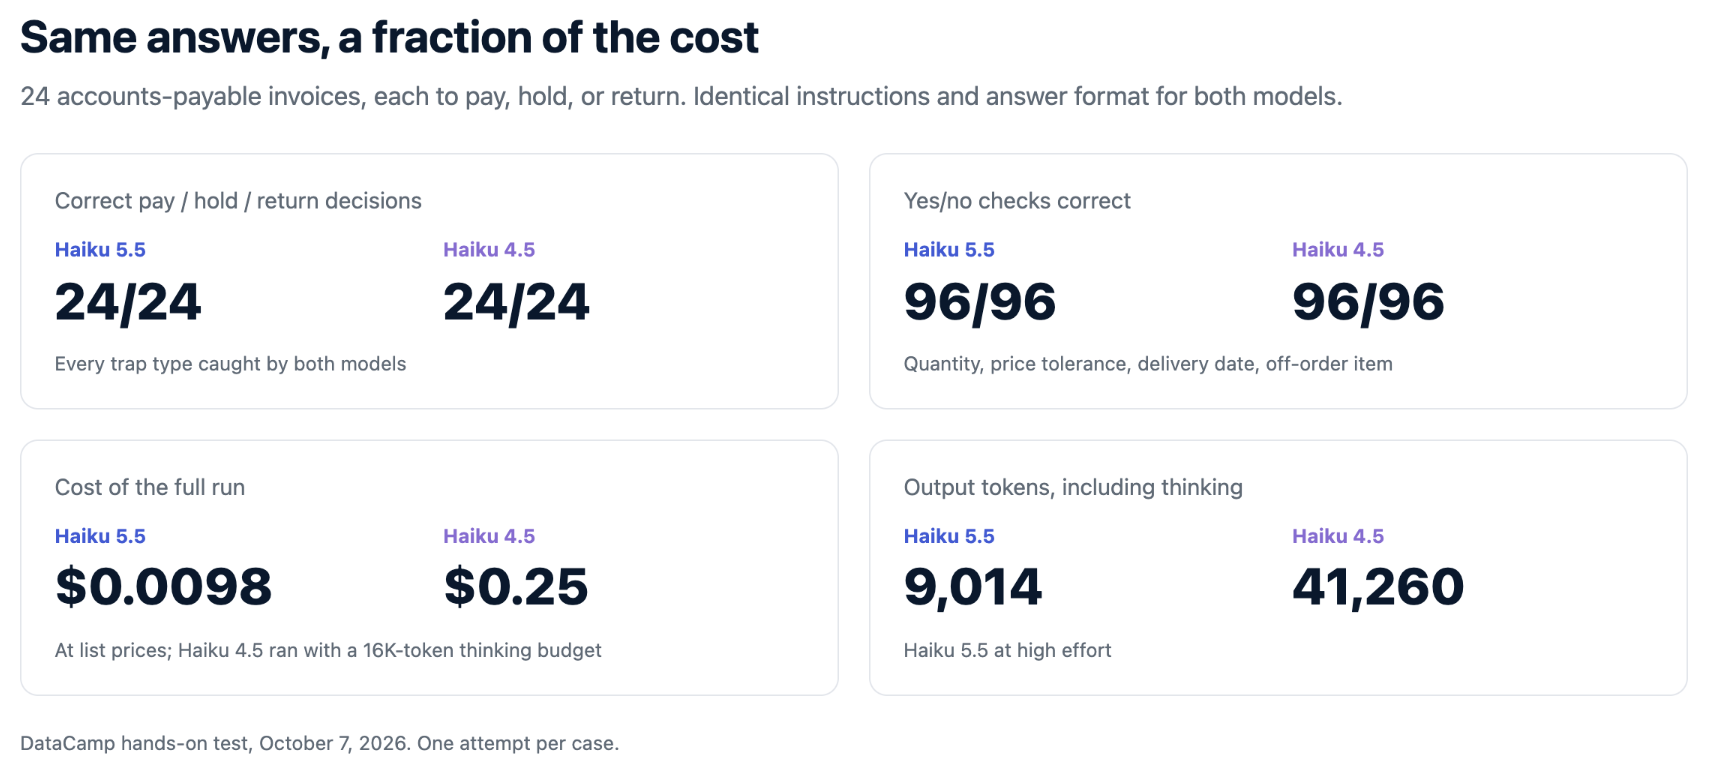
Sia Claude Haiku 5.5 sia Haiku 4.5 hanno totalizzato 24/24, ma l’esecuzione di Haiku 5.5 è costata $0,0098 contro $0,25
Quindi Haiku 5.5 è davvero un passo avanti? Non in accuratezza qui, dato che Haiku 4.5 era già perfetto. Sono le stesse risposte, più veloci, a pochi centesimi: per un modello pensato per girare milioni di volte, è questo che conta. La prossima volta renderò le trappole del test più difficili.
Prezzi e disponibilità di Claude Haiku 5.5
È chiaro ormai che Haiku 5.5 è l’opzione più economica. Ma ecco un dettaglio in più: Claude Haiku 5.5 ha un prezzo in due livelli in base alla dimensione del prompt. I prompt fino a 100.000 token pagano la tariffa bassa, quelli più grandi pagano cinque volte tanto.
| Rate, per 1M tokens | Haiku 5.5 (prompts up to 100K) | Haiku 5.5 (prompts over 100K) | Haiku 4.5 |
|---|---|---|---|
| Input | $0.10 | $0.50 | $1.00 |
| Output | $0.50 | $2.50 | $5.00 |
| Cache read | $0.01 | $0.05 | $0.10 |
| Cache write (5-minute) | $0.125 | $0.625 | $1.25 |
La Batch API sconta del 50% input e output. I token di ragionamento sono fatturati come output, quindi impostazioni di effort più alte costano di più per richiesta.
Lo sconto nominale di Haiku 5.5 rispetto a Haiku 4.5 è del 90% sotto i 100K token, ma due fattori lo riducono nella pratica. Il nuovo tokenizer trasforma lo stesso testo in circa il 30% di token in più rispetto a Haiku 4.5, e i prompt oltre 100K token pagano metà della tariffa di Haiku 4.5 invece di un decimo. Insieme aiutano a spiegare perché la media dichiarata da Anthropic sia “75% più economico” invece del 90%.
Anthropic ha anche ridotto il prezzo di cache-read di Claude Sonnet 5.5 a $0,10 per milione di token, da $0,20, in concomitanza con questo lancio. Haiku 5.5 è generalmente disponibile e Anthropic si impegna a non ritirarlo prima del 7 ottobre 2027.
Come ottenere accesso a Claude Haiku 5.5?
Claude Haiku 5.5 è disponibile sulla Claude API come claude-haiku-5-5, su Amazon Bedrock come anthropic.claude-haiku-5-5 e su Google Cloud, Microsoft Foundry e Claude Platform su AWS come claude-haiku-5-5.
Ecco una chiamata Python minimale. Il ragionamento adattivo è attivo per default, quindi prendi il blocco di testo per tipo:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
Per una guida completa a chiavi, costi e al tuo primo progetto, vedi la nostra guida completa alla Claude API e il nostro tutorial sull’API di Sonnet 5.5 per un agent a cui potresti affidare subagent Haiku 5.5.
Pensieri finali
Se esegui classificazione, estrazione o lavoro da subagent su Haiku 4.5, passa a Haiku 5.5 ora. Nel nostro test ha dato le stesse risposte, più velocemente e a un costo molto inferiore. Ricorda solo di pianificare tempo per le modifiche breaking all’API e per ricalcolare i token.
Direi che Haiku 5.5 mette pressione diretta su GPT-6 Luna di OpenAI nella fascia bassa del mercato. Per molto traffico in produzione, la domanda non è più se un modello piccolo sia “abbastanza buono”, ma quali lavori richiedano ancora Sonnet.
Se vuoi approfondire come costruire con i modelli di Anthropic, ti consiglio il nostro corso Introduzione ai modelli Claude.