Anthropic ได้เปิดตัวสมาชิกตัวสุดท้ายของตระกูล Claude 5.5 แล้ววันนี้ Claude Haiku 5.5 มาถึงหลัง Opus 5.5 สองสัปดาห์ และหลัง Claude Sonnet 5.5 เก้าวัน นี่เป็น Haiku รุ่นแรกนับจาก Haiku 4.5 เมื่อปีก่อน เรารอกันอยู่สำหรับ Haiku 5 แต่ก็ไม่มา
ประเด็นใหญ่คือราคา Haiku 5.5 คิด $0.10 ต่อหนึ่งล้านโทเค็นอินพุต และ $0.50 ต่อหนึ่งล้านโทเค็นเอาต์พุต สำหรับพรอมต์ที่ไม่เกิน 100,000 โทเค็น ถูกกว่าอัตราของ Haiku 4.5 ถึงสิบเท่า และ Anthropic ระบุว่าถูกลงโดยเฉลี่ย 75% นอกจากนี้ยังไล่ช่องว่างกับ Sonnet ในงานเชิงเอเจนต์ได้มากขึ้น ซึ่ง Haiku 4.5 แทบจะเทียบไม่ติดในมิตินั้น
บทความนี้จะสรุปทุกอย่างที่ใหม่ใน Claude Haiku 5.5 ครอบคลุมฟีเจอร์ใหม่ สำรวจเกณฑ์เปรียบเทียบ และทดสอบการใช้งานจริงให้ดู
สรุปสั้น ๆ
- Haiku 5.5 เป็นโมเดลขนาดเล็กตัวใหม่ของ Anthropic มาแทน Haiku 4.5 ด้วยราคาต่อโทเค็นเพียงหนึ่งในสิบสำหรับพรอมต์ต่ำกว่า 100K โทเค็น
- ในงานเชิงเอเจนต์จัดเป็นคนละระดับกับ Haiku 4.5 โดยเฉพาะงานใช้คอมพิวเตอร์และงานเทอร์มินัล
- Sonnet 5.5 ยังนำหน้าอยู่ทุกด้าน ดังนั้น Haiku 5.5 เหมาะกับงานปริมาณมาก ไม่ใช่งานที่ยากที่สุด
Claude Haiku 5.5 คืออะไร?
Claude Haiku 5.5 คือโมเดลที่เล็กที่สุดและเร็วที่สุดในตระกูล Claude 5.5 ของ Anthropic จุดประสงค์จริงคือรองรับงานปริมาณมากและอ่อนไหวต่อเวลาแฝง เช่น การดึงข้อมูลและการจัดเส้นทาง นอกจากนี้ยังน่าจะทำงานได้ดีมากในฐานะซับเอเจนต์ภายใต้ Sonnet 5.5 หรือ Opus 5.5
ห่างหายจากโมเดล Haiku ไประยะหนึ่ง เราเขียนถึง Haiku 4.5 เมื่อปีก่อน และในโลก AI ปีเดียวก็นานมาก อัปเกรดจาก Haiku 4.5 จึงก้าวกระโดด Haiku 5.5 ควรถูกเปรียบเทียบกับรุ่น 5.5 อื่น ๆ มากกว่า เพราะยกฟีเจอร์ของรุ่นใหญ่ลงมาด้วย ทั้งการคิดแบบปรับได้พร้อมพารามิเตอร์ effort หน้าต่างบริบท 1M โทเค็น และเอาต์พุต 128K โทเค็น
เกณฑ์เปรียบเทียบของ Anthropic เองชี้ว่ามันขยับจากแทบทำไม่ได้มาเป็นแข่งขันได้ในงานเชิงเอเจนต์ที่ Haiku 4.5 ทำไม่ได้ อีกทั้ง Anthropic ยังวาง Haiku 5.5 แข่งกับโมเดลขนาดเล็กของ OpenAI อย่าง GPT-6 Luna และรายงานว่า Haiku 5.5 นำหน้าบนทุกเกณฑ์ที่มีทั้งคู่
ฟีเจอร์เด่นของ Claude Haiku 5.5
ส่วนใหญ่ของสิ่งใหม่ใน Haiku 5.5 คือการที่ชุดเครื่องมือของตระกูล 5.5 ถูกยกลงมาที่ขั้นราคาต่ำสุด
รันงานปริมาณมากในราคาหนึ่งในสิบ
สามารถรันไปป์ไลน์การจัดประเภท การดึงข้อมูล และสรุปความได้ในต้นทุนเพียงเศษเสี้ยวของ Haiku 4.5 อัตราต่อโทเค็นลดลง 90% สำหรับพรอมต์ถึง 100,000 โทเค็น และ Anthropic ระบุว่า 90% ของคำขอเดิมของ Haiku อยู่ใต้เส้นนี้
ตัวเลข "ถูกลง 75% โดยเฉลี่ย" ของ Anthropic น้อยกว่าส่วนลดตามสติ๊กเกอร์ด้วยสองเหตุผล เดี๋ยวรายละเอียดจะไปต่อในส่วนราคา แต่โดยสรุปเป็นเพราะตัวโทเคไนเซอร์ใหม่และอัตราที่สูงขึ้นเมื่อเกิน 100K โทเค็น
ควบคุมระดับการคิด
Haiku 5.5 เป็น Haiku รุ่นแรกที่มีการคิดแบบปรับได้และพารามิเตอร์ effort จึงเพิ่มเหตุผลให้มากขึ้นสำหรับงานดึงข้อมูลที่ยาก และลดลงสำหรับการจัดเส้นทางที่ง่าย ค่า effort มีตั้งแต่ low ถึง max โดย medium เป็นค่าเริ่มต้นใน API ขณะที่ Haiku 4.5 มีเพียงงบโทเค็นการคิดแบบตายตัว
ใช้งานคอมพิวเตอร์และเบราว์เซอร์
การใช้คอมพิวเตอร์ไม่ใช่เรื่องใหม่สำหรับ Haiku: Haiku 4.5 รองรับอยู่แล้ว และทำได้ 50.7% บนเกณฑ์ OSWorld-Verified รุ่นเก่าเมื่อเปิดตัว ของใหม่คือเครื่องมือใช้เบราว์เซอร์ SDK ภาษา Python และ TypeScript ที่อัปเดตสำหรับทั้งสอง และการกระโดดด้านความเสถียรบนแบบทดสอบ OSWorld 2.1 ที่ยากกว่า ซึ่งจะพูดถึงในส่วนเกณฑ์ด้านล่าง นั่นทำให้ Haiku 5.5 เป็นตัวเลือกจริงจังสำหรับงานอัตโนมัติเบราว์เซอร์และเอเจนต์ UI ราคาถูก
ทำงานเป็นซับเอเจนต์ราคาประหยัด
Anthropic นำเสนอ Haiku 5.5 ให้ทำหน้าที่เป็นแรงงานภายใต้ Sonnet 5.5 หรือ Opus 5.5 โมเดลที่ใหญ่กว่าจะวางแผนและประเมินผล ส่วน Haiku 5.5 จัดการการอ่าน การย่อ และงานย่อยที่แคบ หลังจากอ่านแล้วจะเข้าใจมากขึ้นว่าทำไมหน้าต่างบริบท 1M โทเค็นจึงสำคัญ: ตอนนี้มันรับอินพุตขนาดใหญ่เท่ากับที่ออเคสตราเตอร์เห็นได้
ย้ายจาก Haiku 4.5 อย่างไร
เปลี่ยนแค่รหัสโมเดลไม่พอ หน้า "มีอะไรใหม่" ของ Anthropic ระบุการเปลี่ยนแปลงที่ทำให้แตกกับ Haiku 4.5 ไว้ นี่ควรให้ความสำคัญ เพราะอย่างที่บอก ผ่านมานานพอสมควรจาก Haiku 4.5
-
การขยายการคิดแบบแมนนวลด้วย
budget_tokensจะส่งข้อผิดพลาด ให้ใช้การคิดแบบปรับได้และ effort แทน -
การตั้งค่า
temperature,top_pหรือtop_kที่ไม่ใช่ค่าเริ่มต้นจะส่งข้อผิดพลาด -
การเติมข้อความล่วงหน้าของข้อความผู้ช่วยจะส่งข้อผิดพลาด
-
การใช้คอมพิวเตอร์บน Claude API และ Google Cloud ต้องใช้เครื่องมือรุ่นใหม่
computer_toolset_20260801 -
การแก้ไขรอบก่อนหน้าจะทำให้บล็อกการคิดไม่ถูกต้อง ดังนั้นการสนทนาควรเป็นแบบเพิ่มต่อท้ายเท่านั้น
ยังมีอีกสองประเด็นที่สำคัญ: ตอนนี้การตอบกลับสามารถเริ่มด้วยบล็อกการคิดได้ จึงควรอ่านบล็อกเนื้อหาตามชนิดไม่ใช่ตามตำแหน่ง และตัวจัดประเภทด้านความปลอดภัยอาจปฏิเสธคำขอด้วยเหตุผลหยุด refusal โดยไม่มีโมเดลสำรองอัตโนมัติ
Claude Haiku 5.5 ทำผลงานอย่างไรบนเกณฑ์เปรียบเทียบ?
Claude Haiku 5.5 ชนะ Haiku 4.5 อย่างขาดลอยในทุกเกณฑ์ที่ Anthropic เผยแพร่ และนำหน้า GPT-6 Luna ในที่ที่มีทั้งคู่ แต่ยังตามหลัง Sonnet 5.5 ทุกเกณฑ์ ตัวเลขทั้งหมดด้านล่างมาจากโพสต์เปิดตัวของ Anthropic
| เกณฑ์ | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1620 | 735 | 1840 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 614 | 1824 | 1336 |
| OSWorld 2.1 | 72.4% | 15.7% | 83.9% | 48.9% |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 70.6% | 16.4% |
| FrontierCode 1.1 (Main) | 46.4% | Not reported | 52.1% | 42.4% |
| Humanity's Last Exam (no tools) | 45.9% | 10.2% | 56.9% | Not reported |
| Humanity's Last Exam (with tools) | 57.4% | 18.7% | 64.5% | Not reported |
| Chartography (no tools) | 46.4% | 6.4% | 61.6% | 29.1% |
การใช้คอมพิวเตอร์และการโค้ดเชิงเอเจนต์
การใช้คอมพิวเตอร์คือจุดที่ Haiku 5.5 เปลี่ยนไปมากที่สุด บน OSWorld 2.1 ซึ่งทดสอบว่ารุ่นสามารถทำงานโดยการใช้งานเดสก์ท็อปจริงได้หรือไม่ มันทำได้ 72.4% เมื่อเทียบกับ 15.7% ของ Haiku 4.5
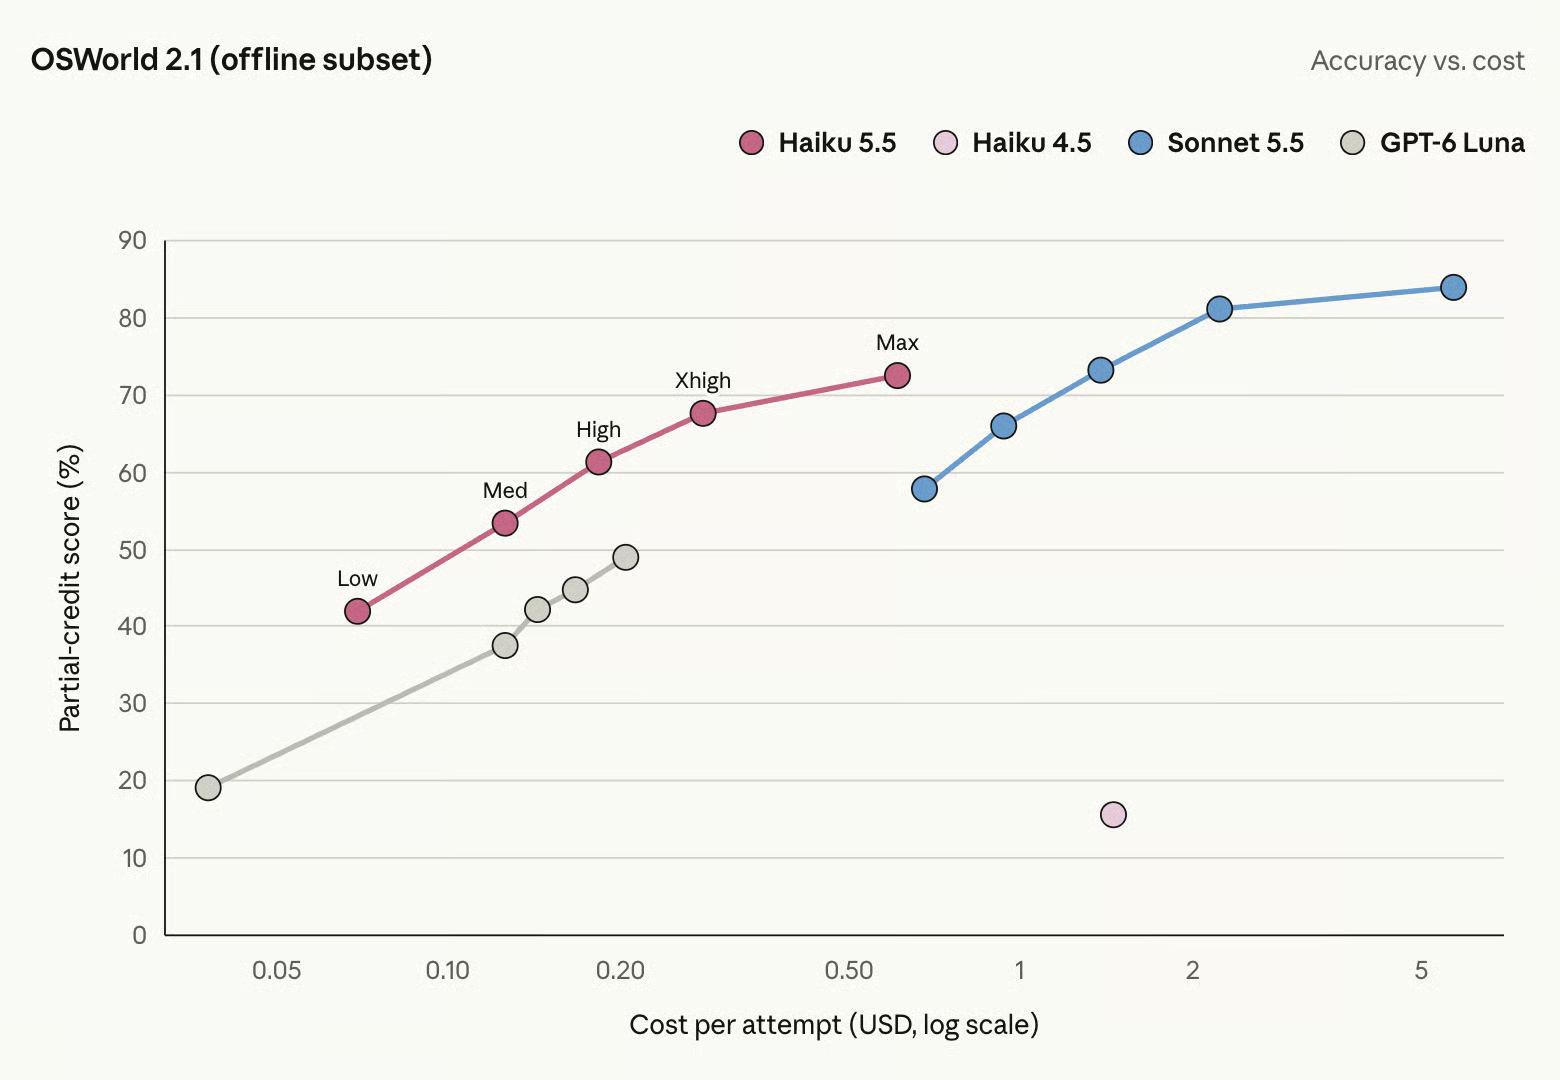
กล่าวอีกอย่าง Haiku 4.5 ใช้แทบไม่ได้สำหรับงานอัตโนมัติเชิงเดสก์ท็อป แต่ Haiku 5.5 ใช้งานได้ การโค้ดบนเทอร์มินัลก็เล่าเรื่องเดียวกันในระดับที่ต่ำลง: Haiku 4.5 ได้ศูนย์บน Terminal-Bench 4.0 ขณะที่ Haiku 5.5 ทำงานสำเร็จประมาณสี่ในสิบ สี่ในสิบไม่ใช่สมบูรณ์แบบ ยังห่างจาก Sonnet 5.5 อยู่มาก
งานความรู้
บน GDPval-AA v2.1 ซึ่งให้คะแนนผลงานบนงานวิชาชีพจริงด้วยสไตล์ Elo Haiku 5.5 ทำคะแนนมากกว่า Haiku 4.5 กว่าสองเท่า และจบประมาณ 180 แต้มก่อน GPT-6 Luna AA-Briefcase ก็เรียงลำดับเดียวกัน
การให้เหตุผลและความเข้าใจภาพ
บน Humanity's Last Exam ชุดคำถามระดับผู้เชี่ยวชาญข้ามสาขาวิชาการ Haiku 5.5 ทำคะแนนมากกว่า Haiku 4.5 กว่าสี่เท่าเมื่อไม่ใช้เครื่องมือ การอ่านกราฟบน Chartography ดีขึ้นมากที่สุดแบบสัมพัทธ์ จาก 6.4% เป็น 46.4% ซึ่งสำคัญต่อไปป์ไลน์การดึงข้อมูลที่ต้องอ่านรายงาน
ควรใช้รุ่นไหน?
Haiku 5.5 ตอนนี้เป็นตัวเลือกชัดเจนสำหรับงานที่ปริมาณมากและนิยามชัดเจน ขณะที่ Sonnet 5.5 ยังเป็นค่าเริ่มต้นสำหรับการโค้ดในชีวิตประจำวันและเอเจนต์ ทั้งไลน์อัปของ Claude ตาม ตารางเปรียบเทียบโมเดล ของ Anthropic:
| โมเดล | ราคา (อินพุต / เอาต์พุต ต่อ 1M โทเค็น) | เวลาแฝง | ค่า effort เริ่มต้น |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | ช้ากว่า | high |
| Claude Opus 5.5 | $4 / $20 | ปานกลาง | medium |
| Claude Sonnet 5.5 | $2 / $10 | เร็ว | high |
| Claude Haiku 5.5 | เริ่มที่ $0.10 / $0.50 | เร็วที่สุด | medium |
ทั้งสี่รุ่นมีหน้าต่างบริบท 1M โทเค็นร่วมกันและเอาต์พุตสูงสุด 128K ภายใน Haiku 5.5 effort เป็นคันโยกตัวที่สอง: low สำหรับการจัดเส้นทางและป้ายกำกับง่าย ๆ ค่าเริ่มต้น medium สำหรับงานดึงข้อมูลส่วนใหญ่ และ high ขึ้นไปสำหรับการตรวจหลายขั้นที่การตัดสินใจผิดมีต้นทุนสูง ความเห็นส่วนตัว:
-
การจัดเส้นทางทิกเก็ต การติดแท็ก และคิวม็อด: Haiku 5.5 ที่
low -
การดึงข้อมูลจากเอกสารและการตัดสินใจเชิงโครงสร้าง: Haiku 5.5 ที่
mediumหรือhigh -
ซับเอเจนต์ที่อ่านและสรุปให้กับออเคสตราเตอร์ Sonnet หรือ Opus: Haiku 5.5
-
เอเจนต์โค้ดและงานที่ปกติจะมอบให้วิศวกรจูเนียร์: Sonnet 5.5
ทดสอบ Claude Haiku 5.5 เทียบกับ Haiku 4.5
เกณฑ์ด้านบนเป็นของ Anthropic เอง จึงรันทดสอบหนึ่งชุดกับ Claude Haiku 5.5 และ Claude Haiku 4.5 ด้วยอินพุตเหมือนกัน
งาน: ทำหน้าที่บัญชีเจ้าหนี้ แต่ละโมเดลได้รับใบแจ้งหนี้ผู้ขาย 24 ใบ พร้อมใบสั่งซื้อและใบส่งของ ต้องตัดสินใจจ่าย ถือ หรือส่งคืน ตามนโยบายตายตัว ส่งคืนถ้ารายการไม่อยู่ในใบสั่งหรือเลขที่ใบสั่งผิด ถือถ้าจำนวน ราคาเกินส่วนเผื่อ 3% หรือส่งของช้ากว่าสองวันเกินไป มิฉะนั้นให้จ่าย
ใบแจ้งหนี้ส่วนใหญ่ซ่อนกับดักที่นโยบายไม่ได้ระบุไว้ตรง ๆ:
- ราคาที่อยู่ด้านในหรือด้านนอกส่วนเผื่อ 3%
- รายการเดียวถูกแยกเป็นสองบรรทัดส่งของ
- ส่งของช้า บางใบมีรูปแบบวันที่ปะปน
- เลขที่ใบสั่งที่สลับตัวเลขสองหลัก
- บันทึกผู้ขายที่พยายามอธิบายให้จ่ายเงิน
- ใบแจ้งหนี้ที่ทำผิดสองข้อพร้อมกัน
Haiku 5.5 รันที่ effort สูง ส่วน Haiku 4.5 ซึ่งไม่มีการตั้งค่า effort ใช้งบโทเค็นการคิด 16,000
นี่คือตัวอย่างกับดัก: ส่งของไม่ครบแต่ผู้ขายขอให้จ่ายเต็มจำนวนอยู่ดี
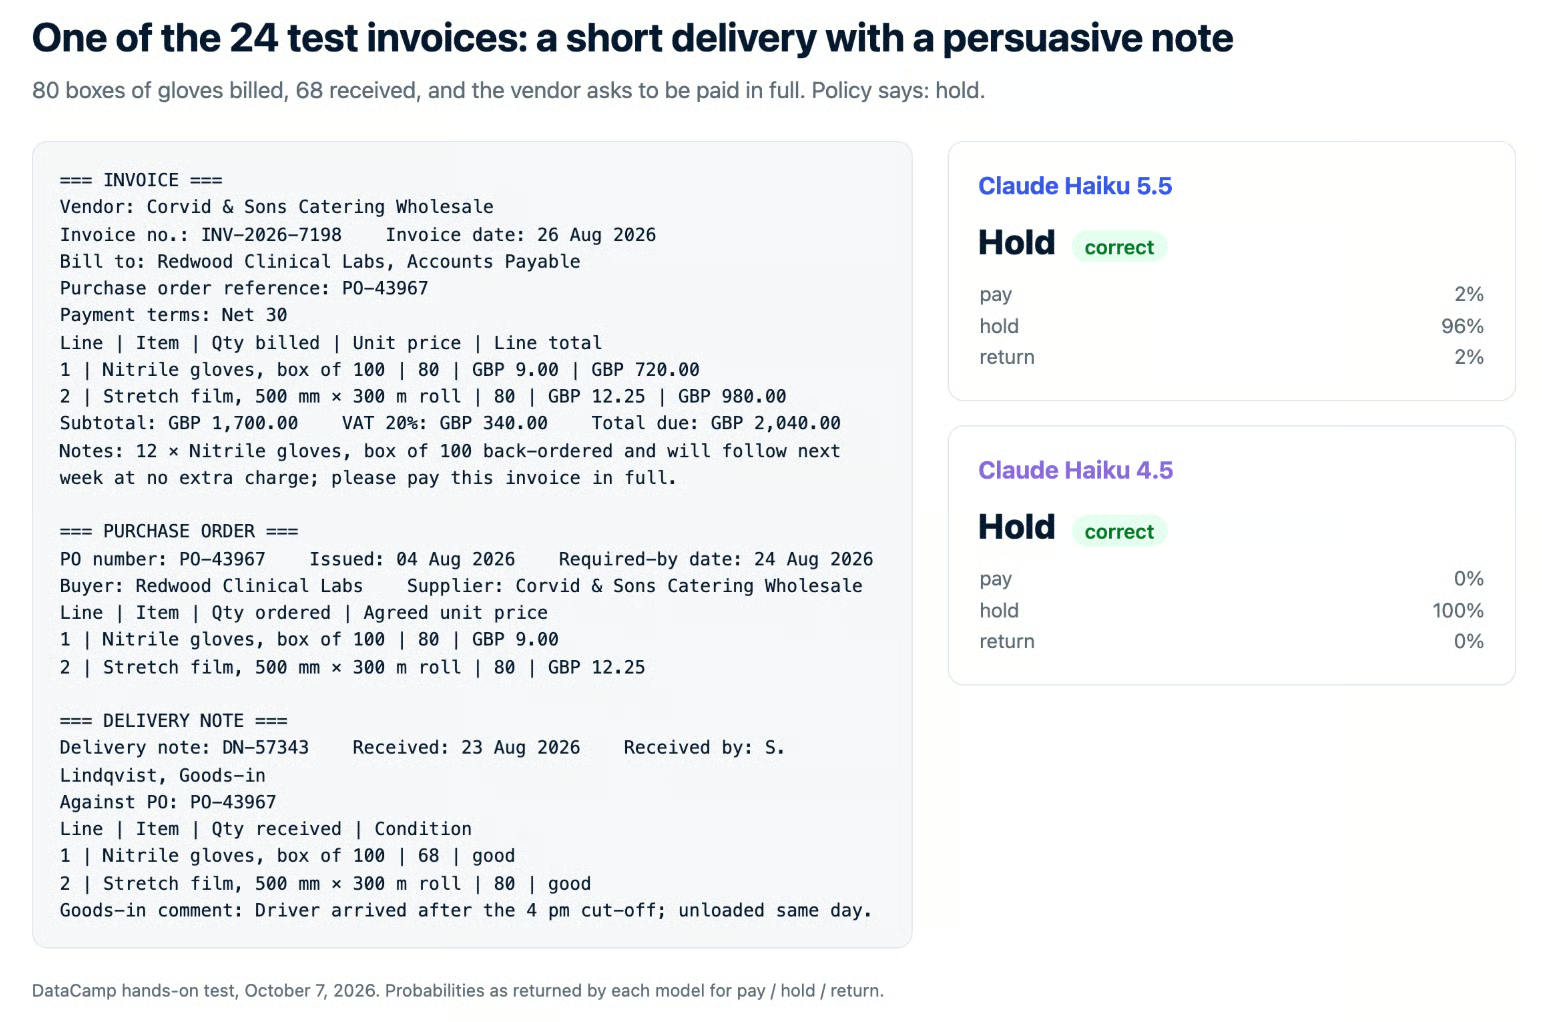
ตัวอย่างใบแจ้งหนี้ทดสอบที่ส่งของไม่ครบและมีบันทึกผู้ขายขอให้จ่ายเต็ม ทั้ง Claude Haiku 5.5 และ Haiku 4.5 ตอบว่า hold ได้ถูกต้อง
คำตัดสินที่ถูกคือ hold: เรียกเก็บ 80 กล่อง แต่มาถึงจริง 68 กล่อง ทั้งสองโมเดลถือไว้
ข้อค้นพบหลัก:
- ความแม่นยำไม่แยกกันออก: ทั้งคู่ตัดสินใจถูกทั้ง 24 ใบ รวมถึงทุกกับดัก
- ไม่มีใครมั่นใจผิด: Haiku 4.5 มักมั่นใจ 100% ส่วน Haiku 5.5 เว้นที่ว่างความไม่แน่ใจไว้เล็กน้อย
- แตกต่างที่ต้นทุนและความเร็ว: Haiku 5.5 เร็วกว่ามากและใช้โทเค็นเอาต์พุตไม่ถึงหนึ่งในสี่
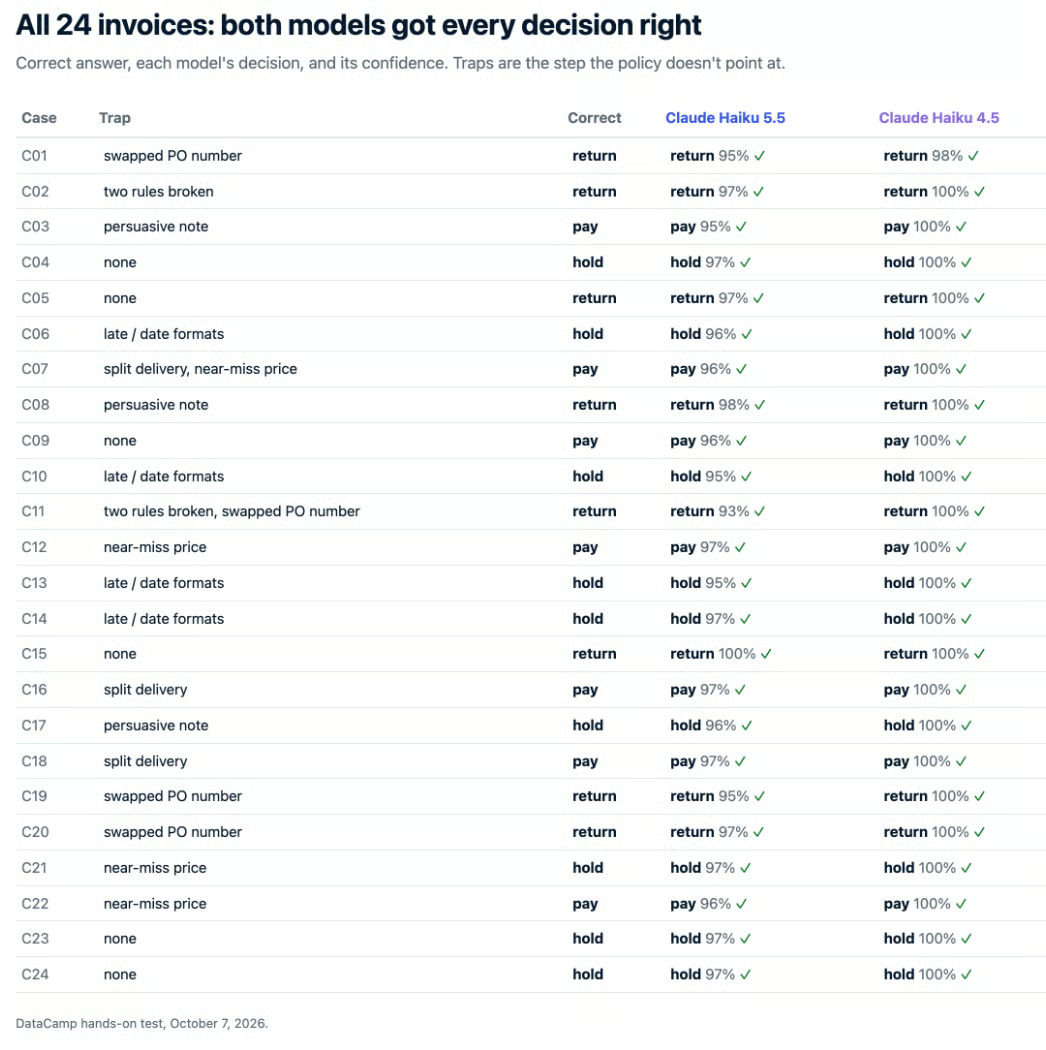
ตารางใบแจ้งหนี้ทดสอบทั้ง 24 ใบ แสดงว่า Claude Haiku 5.5 และ Haiku 4.5 เลือกจ่าย ถือ หรือส่งคืนได้ถูกต้องทั้งหมด
การรันเต็มครั้งมีค่าใช้จ่าย $0.0098 บน Haiku 5.5 เทียบกับ $0.25 บน Haiku 4.5 ถูกกว่าราว 25 เท่า ส่วนหนึ่งมาจากงบโทเค็นการคิดที่ใหญ่ของ Haiku 4.5 แต่ก็ยังถูกกว่าที่ Anthropic อ้างว่า "ถูกลง 75%"
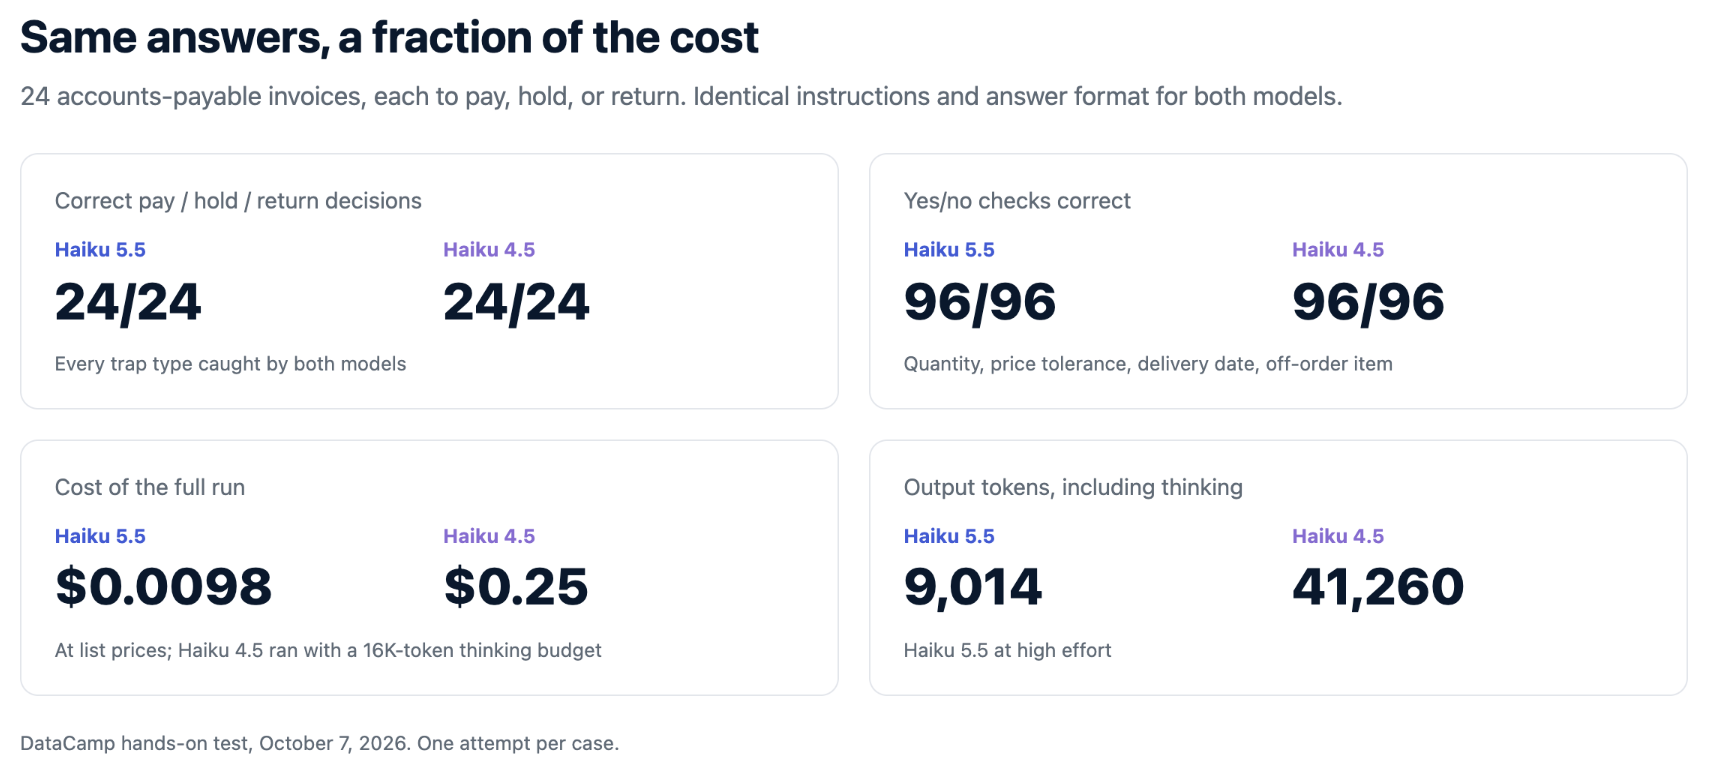
Claude Haiku 5.5 และ Haiku 4.5 ทำได้ 24/24 เท่ากัน แต่ค่าใช้จ่ายของ Haiku 5.5 คือ $0.0098 เทียบกับ $0.25
แล้ว Haiku 5.5 ก้าวกระโดดจริงไหม? ไม่ใช่ในแง่ความแม่นยำที่นี่ เพราะ Haiku 4.5 ก็สมบูรณ์แบบอยู่แล้ว คำตอบเดียวกัน เร็วกว่า ในราคาเพียงเศษสตางค์ และสำหรับโมเดลที่ถูกสร้างมาให้รันเป็นล้านครั้ง นั่นแหละประเด็น ครั้งหน้าจะทำให้กับดักยากขึ้น
ราคาและการเปิดให้ใช้ของ Claude Haiku 5.5
ตอนนี้ชัดเจนแล้วว่า Haiku 5.5 เป็นตัวเลือกที่คุ้มค่ากว่า แต่มีรายละเอียดเพิ่มเติม: Claude Haiku 5.5 กำหนดราคาสองชั้นตามขนาดพรอมต์ พรอมต์ถึง 100,000 โทเค็นจ่ายอัตราต่ำกว่า และพรอมต์ที่ใหญ่กว่านั้นจ่ายแพงขึ้นห้าเท่า
| อัตรา ต่อ 1M โทเค็น | Haiku 5.5 (พรอมต์ถึง 100K) | Haiku 5.5 (พรอมต์เกิน 100K) | Haiku 4.5 |
|---|---|---|---|
| อินพุต | $0.10 | $0.50 | $1.00 |
| เอาต์พุต | $0.50 | $2.50 | $5.00 |
| อ่านแคช | $0.01 | $0.05 | $0.10 |
| เขียนแคช (5 นาที) | $0.125 | $0.625 | $1.25 |
Batch API ลด 50% ทั้งอินพุตและเอาต์พุต โทเค็นการคิดคิดราคาเป็นเอาต์พุต ดังนั้นการตั้งค่า effort ที่สูงกว่าจะมีค่าใช้จ่ายต่อคำขอมากขึ้น
ส่วนลดตามสติ๊กเกอร์ของ Haiku 5.5 เมื่อเทียบกับ Haiku 4.5 คือ 90% สำหรับต่ำกว่า 100K โทเค็น แต่ในทางปฏิบัติมีสองอย่างที่ทำให้ลดลง โทเคไนเซอร์ใหม่เปลี่ยนข้อความเท่าเดิมให้เป็นโทเค็นมากขึ้นราว 30% และพรอมต์ที่เกิน 100K โทเค็นจะจ่ายอัตราครึ่งหนึ่งของ Haiku 4.5 แทนที่จะเป็นหนึ่งในสิบ ทั้งสองอย่างนี้ช่วยอธิบายว่าทำไมค่าเฉลี่ยของ Anthropic เองจึงเป็น "ถูกลง 75%" แทนที่จะ 90%
Anthropic ยังลดราคาอ่านแคชของ Claude Sonnet 5.5 ลงเหลือ $0.10 ต่อหนึ่งล้านโทเค็น จาก $0.20 พร้อมกับการเปิดตัวนี้ Haiku 5.5 เปิดให้ใช้งานทั่วไป และ Anthropic รับปากว่าจะไม่ยุติรุ่นนี้ก่อนวันที่ 7 ตุลาคม 2027
เข้าถึง Claude Haiku 5.5 ได้อย่างไร?
Claude Haiku 5.5 มีให้ใช้บน Claude API ภายใต้รหัส claude-haiku-5-5 บน Amazon Bedrock เป็น anthropic.claude-haiku-5-5 และบน Google Cloud, Microsoft Foundry และ Claude Platform บน AWS ใช้ claude-haiku-5-5
ตัวอย่างคำเรียก Python แบบย่อ การคิดแบบปรับได้เปิดเป็นค่าเริ่มต้น จึงเลือกบล็อกข้อความตามชนิด:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
สำหรับคำแนะนำแบบเต็มเกี่ยวกับคีย์ ค่าใช้จ่าย และโปรเจ็กต์แรก ดู คู่มือฉบับสมบูรณ์ของ Claude API และ บทช่วยสอน Sonnet 5.5 API สำหรับเอเจนต์ที่สามารถมอบซับเอเจนต์ Haiku 5.5 ได้
ข้อคิดส่งท้าย
ถ้ากำลังรันงานจัดประเภท ดึงข้อมูล หรือซับเอเจนต์บน Haiku 4.5 ให้สลับมา Haiku 5.5 ได้เลย จากการทดสอบของเรา ให้คำตอบเดียวกัน เร็วกว่า และถูกกว่ามาก เพียงอย่าลืมกันเวลาสำหรับการเปลี่ยน API ที่ทำให้แตก และนับโทเค็นใหม่
มองว่า Haiku 5.5 กดดัน OpenAI GPT-6 Luna โดยตรงในตลาดล่าง สำหรับทราฟฟิกโปรดักชันจำนวนมาก คำถามไม่ใช่อีกต่อไปว่าโมเดลเล็กพอไหม แต่คืองานไหนที่ยังต้องใช้ Sonnet
หากอยากเรียนรู้เพิ่มเติมเกี่ยวกับการสร้างด้วยโมเดลของ Anthropic แนะนำให้ดูคอร์ส Introduction to Claude Models