Anthropic a făcut ultima completare la familia Claude 5.5. Claude Haiku 5.5 a sosit azi, la două săptămâni după Opus 5.5 și la nouă zile după Claude Sonnet 5.5. Este și primul Haiku de la Haiku 4.5 de acum un an. Am așteptat Haiku 5, dar nu a mai venit.
Elementul principal este prețul. Haiku 5.5 costă 0,10 $ per milion de tokeni de intrare și 0,50 $ per milion de tokeni de ieșire pentru prompturi de până la 100.000 de tokeni. Asta înseamnă o zecime din tarifele lui Haiku 4.5, iar Anthropic spune că ajunge, în medie, cu 75% mai ieftin. De asemenea, reduce mult din diferența față de Sonnet la munca agentică. Haiku 4.5 nici nu intra în discuție la această comparație.
În acest articol, acopăr tot ce e nou la Claude Haiku 5.5: noile funcții, benchmarkurile și îl pun la treabă într-un test hands-on.
Pe scurt
- Haiku 5.5 este noul model mic al Anthropic, înlocuindu-l pe Haiku 4.5 la o zecime din prețul per token pentru prompturi sub 100K tokeni.
- Este o altă clasă de model față de Haiku 4.5 la munca agentică, în special pentru utilizarea computerului și sarcini în terminal.
- Sonnet 5.5 tot îl depășește peste tot, deci Haiku 5.5 e pentru volum, nu pentru cele mai grele sarcini ale tale.
Ce este Claude Haiku 5.5?
Claude Haiku 5.5 este cel mai mic și cel mai rapid model din familia Claude 5.5 a Anthropic. Scopul lui real este munca cu volum mare și sensibilă la latență, precum extragerea și rutarea. Va merge, de asemenea, foarte bine ca subagent sub Sonnet 5.5 sau Opus 5.5.
A trecut ceva timp de la ultimul model Haiku. Am scris despre Haiku 4.5 acum un an, iar cum un an în AI e mult, upgrade-ul de la Haiku 4.5 este substanțial. Haiku 5.5 se compară corect cu celelalte modele 5.5 pentru că preia funcțiile modelelor mai mari 5.5, inclusiv gândire adaptivă cu setarea de efort, o fereastră de context de 1M tokeni și ieșiri de 128K tokeni.
Benchmarkurile proprii ale Anthropic arată o trecere de la aproape zero la competitiv pe sarcini agentice pe care Haiku 4.5 nu le putea face. Anthropic poziționează, de asemenea, Haiku 5.5 față de modelul mic al OpenAI, GPT-6 Luna, și raportează că Haiku 5.5 este în față la fiecare benchmark unde apar amândouă.
Funcții cheie ale Claude Haiku 5.5
Majoritatea noutăților din Haiku 5.5 înseamnă că trusa de instrumente a familiei 5.5 ajunge la baza scării de preț.
Rulează volum mare la o zecime din preț
Poți rula pipeline-uri de clasificare, extragere și rezumare la o fracțiune din costul lui Haiku 4.5. Tariful per token scade cu 90% pentru prompturi de până la 100.000 de tokeni, iar Anthropic spune că 90% din cererile anterioare pentru Haiku se încadrau sub acest prag.
Cifra Anthropic „cu 75% mai ieftin în medie” este mai mică decât discountul de listă din două motive. Revin la asta în secțiunea de prețuri, dar pe scurt, e din cauza unui tokenizer nou și a unui tarif mai mare peste 100K tokeni.
Controlează cât de intens gândește
Haiku 5.5 este primul Haiku cu gândire adaptivă și parametrul de efort, astfel încât poți crește raționamentul pentru extrageri dificile și îl poți reduce pentru rutare simplă. Efortul merge de la low la max, cu medium ca implicit în API. Haiku 4.5 oferea doar un buget fix de tokeni de gândire.
Operare pe computere și în browsere
Utilizarea computerului nu e nouă pentru Haiku: Haiku 4.5 o suporta și a obținut 50,7% pe vechiul benchmark OSWorld-Verified la lansare. Noutatea este un instrument pentru utilizarea browserului, SDK-uri Python și TypeScript actualizate pentru ambele, și un salt mult mai mare în fiabilitate pe testul mai greu OSWorld 2.1, pe care îl acopăr în secțiunea de benchmarkuri de mai jos. Asta face din Haiku 5.5 o opțiune realistă pentru automatizare de browser ieftină și agenți UI.
Lucrează ca subagent ieftin
Anthropic poziționează Haiku 5.5 ca muncitorul de sub Sonnet 5.5 sau Opus 5.5. Modelul mai mare planifică și evaluează, iar Haiku 5.5 se ocupă de citire, compactare și sub-sarcini înguste. După ce am citit asta, înțelegem mai bine de ce fereastra de context de 1M tokeni e importantă: poate acum primi aceleași intrări mari pe care le vede orchestratorul.
Cum migrezi de la Haiku 4.5
Nu e suficient să schimbi ID-ul modelului. Pagina „Ce e nou” a Anthropic listează aceste schimbări incompatibile cu Haiku 4.5. Merită atenție, fiindcă, cum ziceam, a trecut ceva timp de la Haiku 4.5.
-
Gândirea extinsă manual cu
budget_tokensreturnează o eroare. Folosește în schimb gândirea adaptivă și efortul. -
Valorile non-implicite pentru
temperature,top_psautop_kreturnează o eroare. -
Prefill pentru mesajul asistentului returnează o eroare.
-
Utilizarea computerului pe Claude API și Google Cloud necesită instrumentul mai nou
computer_toolset_20260801. -
Editarea tururilor anterioare invalidează blocurile de gândire, deci conversațiile ar trebui să fie doar în regim de adăugare.
Două schimbări mai discrete contează și ele: răspunsurile pot începe acum cu blocuri de gândire, deci citește blocurile de conținut după tip, nu după poziție, iar clasificatorii de siguranță pot refuza o cerere cu un motiv de oprire refusal, fără model de fallback automat.
Cum se descurcă Claude Haiku 5.5 la benchmarkuri?
Claude Haiku 5.5 îl depășește clar pe Haiku 4.5 la fiecare benchmark publicat de Anthropic și conduce în fața GPT-6 Luna oriunde apar amândouă, dar rămâne în urma lui Sonnet 5.5 la toate. Toate cifrele de mai jos vin din articolul de lansare al Anthropic.
| Benchmark | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1620 | 735 | 1840 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 614 | 1824 | 1336 |
| OSWorld 2.1 | 72,4% | 15,7% | 83,9% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 70,6% | 16,4% |
| FrontierCode 1.1 (Main) | 46,4% | Not reported | 52,1% | 42,4% |
| Humanity's Last Exam (fără unelte) | 45,9% | 10,2% | 56,9% | Not reported |
| Humanity's Last Exam (cu unelte) | 57,4% | 18,7% | 64,5% | Not reported |
| Chartography (fără unelte) | 46,4% | 6,4% | 61,6% | 29,1% |
Utilizarea computerului și coding agentic
Utilizarea computerului este zona unde Haiku 5.5 se schimbă cel mai mult. Pe OSWorld 2.1, care testează dacă un model poate finaliza sarcini operând un desktop real, obține 72,4% față de 15,7% la Haiku 4.5.
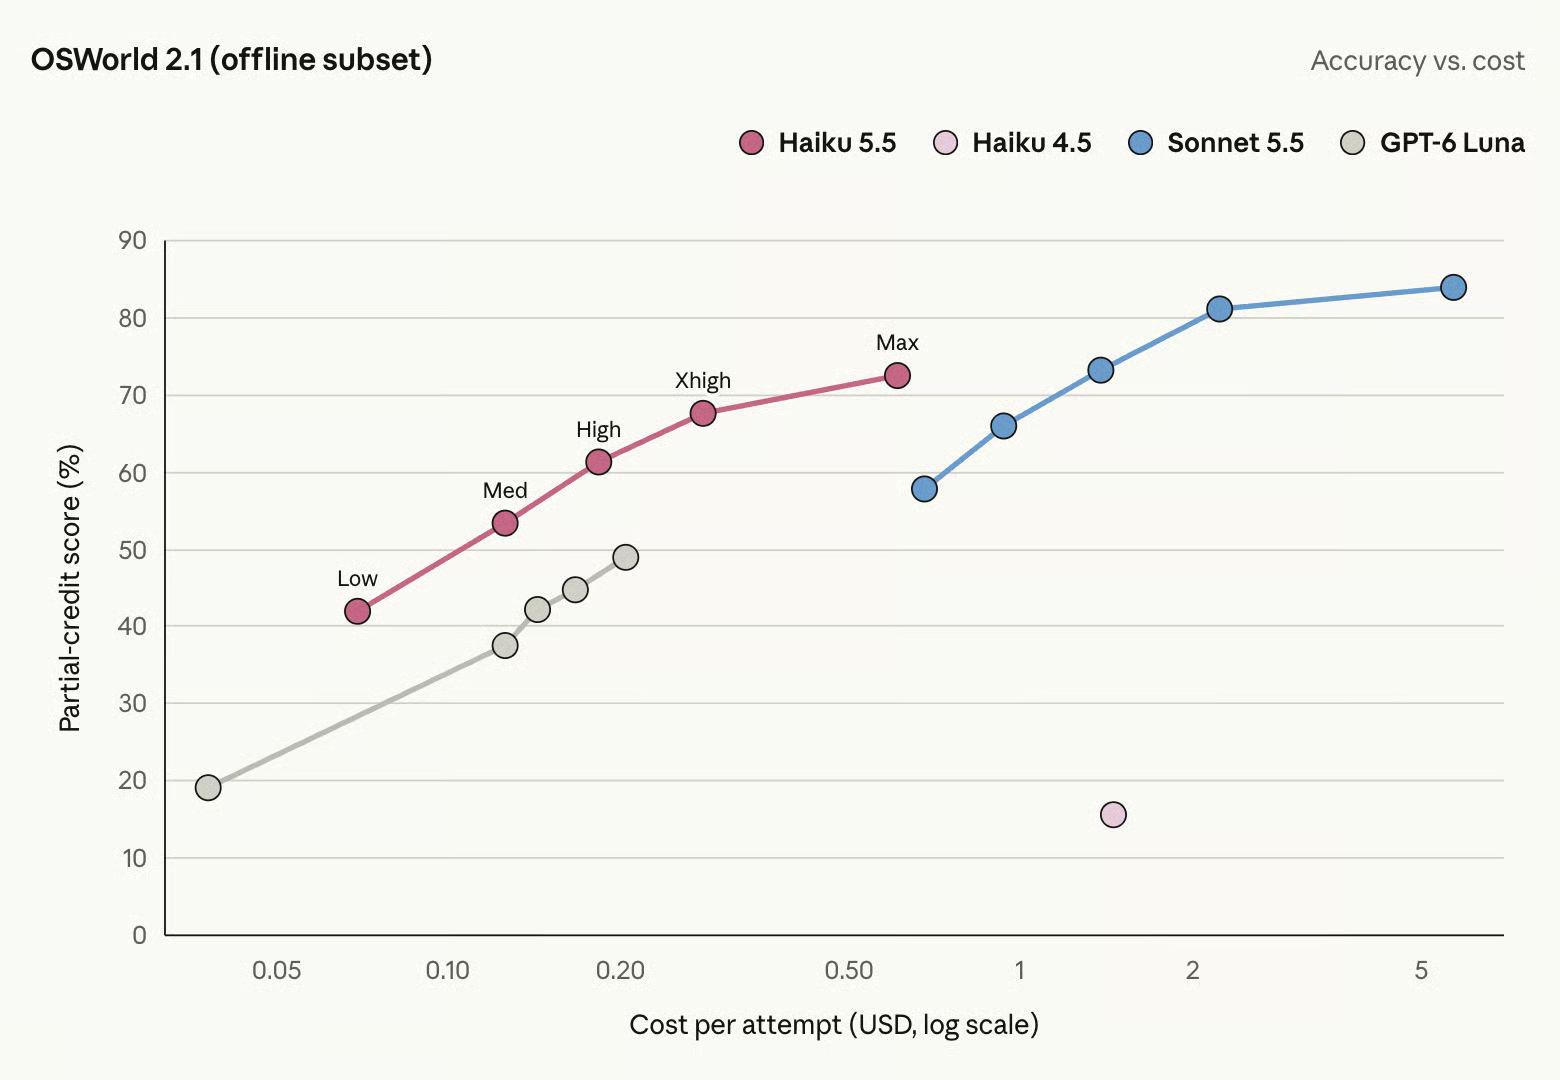
Cu alte cuvinte, Haiku 4.5 era inutil la automatizarea desktop, dar Haiku 5.5 este utilizabil. Programarea în terminal spune aceeași poveste la un nivel mai jos: Haiku 4.5 a obținut zero la Terminal-Bench 4.0, în timp ce Haiku 5.5 finalizează cam patru din zece sarcini. Patru din zece nu e perfect; e încă departe de Sonnet 5.5.
Muncă de cunoaștere
Pe GDPval-AA v2.1, care evaluează ieșirea pe sarcini profesionale reale cu un scor de tip Elo, Haiku 5.5 mai mult decât dublează ratingul lui Haiku 4.5 și termină cu aproximativ 180 de puncte înaintea lui GPT-6 Luna. AA-Briefcase arată aceeași ordine.
Raționament și înțelegere vizuală
La Humanity's Last Exam, un set de întrebări la nivel de expert din domenii academice, Haiku 5.5 își mărește de peste patru ori scorul față de Haiku 4.5 fără unelte. Citirea de diagrame pe Chartography se îmbunătățește cel mai mult în termeni relativi, de la 6,4% la 46,4%, lucru important pentru pipeline-urile de extragere care citesc rapoarte.
Ce nivel ar trebui să folosești?
Haiku 5.5 este acum alegerea evidentă pentru orice e cu volum mare și bine definit, în timp ce Sonnet 5.5 rămâne implicitul pentru programare de zi cu zi și agenți. Întregul portofoliu Claude, conform tabelului de comparație a modelelor al Anthropic:
| Model | Preț (intrare / ieșire per 1M tokeni) | Latență | Efort implicit |
|---|---|---|---|
| Claude Fable 5.1 | 10 $ / 50 $ | Mai lent | high |
| Claude Opus 5.5 | 4 $ / 20 $ | Moderat | medium |
| Claude Sonnet 5.5 | 2 $ / 10 $ | Rapid | high |
| Claude Haiku 5.5 | De la 0,10 $ / 0,50 $ | Cel mai rapid | medium |
Toate patru au în comun o fereastră de context de 1M tokeni și un maxim de ieșire de 128K. În cadrul Haiku 5.5, efortul este a doua manetă: low pentru rutare și etichete simple, implicitul medium pentru majoritatea extragerilor și high sau mai sus pentru verificări în mai mulți pași unde o decizie greșită e costisitoare. Cum văd eu:
-
Rutarea tichetelor, etichetare și cozi de moderare: Haiku 5.5 la
low. -
Extragere din documente și decizii structurate: Haiku 5.5 la
mediumsauhigh. -
Subagenți care citesc și rezumă pentru un orchestrator Sonnet sau Opus: Haiku 5.5.
-
Agenți de programare și orice ai da unui inginer junior: Sonnet 5.5.
Testarea Claude Haiku 5.5 vs. Haiku 4.5
Benchmarkurile de mai sus sunt ale Anthropic, așa că am rulat un test împotriva Claude Haiku 5.5 și Claude Haiku 4.5 cu intrări identice.
Sarcina: acționează ca accounts payable. Fiecare model a primit 24 de facturi de la furnizori, fiecare cu comanda de achiziție și avizul de însoțire, și a trebuit să plătească, să pună în așteptare sau să returneze fiecare în baza unei politici fixe. Returnează dacă un articol nu e pe comandă sau numărul comenzii e greșit; pune în așteptare dacă există o cantitate diferită, un preț dincolo de toleranța de 3% sau o livrare cu mai mult de două zile întârziere; altfel plătește.
Majoritatea facturilor ascundeau o capcană pe care politica nu o evidențiază:
- Prețuri chiar la limita sau puțin în afara toleranței de 3%
- Un articol împărțit pe două linii de livrare
- Livrări întârziate, unele cu formate de dată amestecate
- Un număr de comandă cu două cifre inversate
- Note ale furnizorului care pledează pentru plată
- Facturi care încalcă două reguli simultan
Haiku 5.5 a rulat la efort ridicat; Haiku 4.5, care nu are setare de efort, a rulat cu un buget de gândire de 16.000 de tokeni.
Iată una dintre capcane: o livrare scurtă în care furnizorul cere oricum plata integrală.
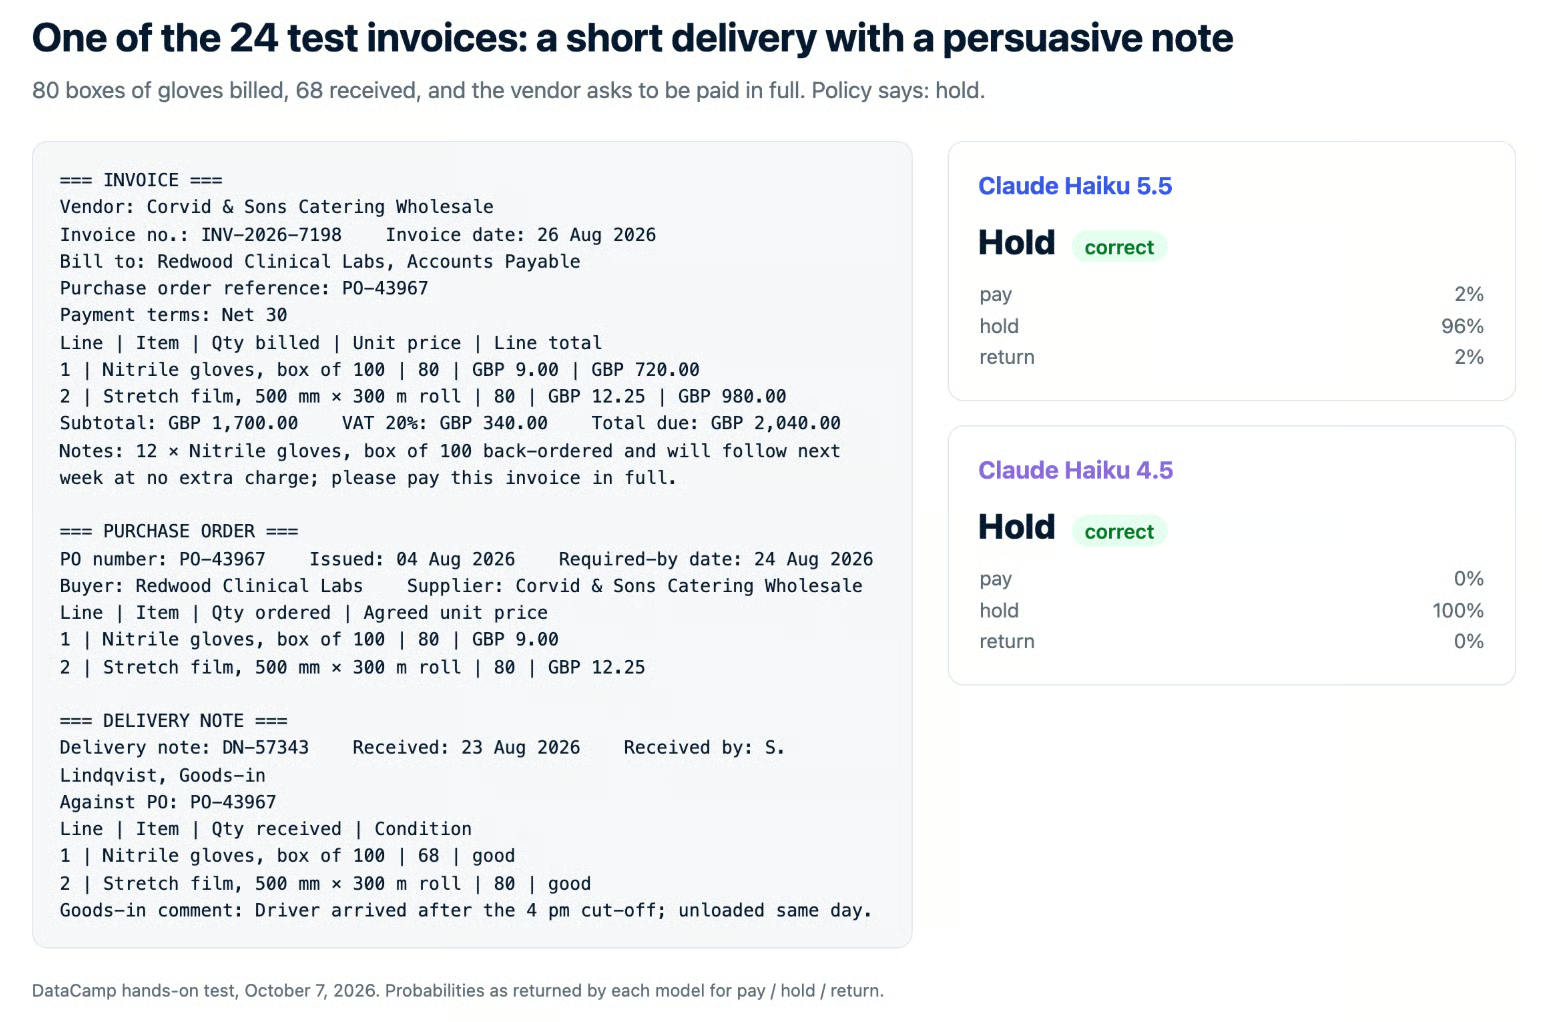
Exemplu de factură de test cu o livrare mai mică și o notă a furnizorului care cere plata integrală; atât Claude Haiku 5.5 cât și Haiku 4.5 au răspuns corect: pune în așteptare
Decizia corectă este așteptare: s-au facturat 80 de cutii, dar au sosit doar 68. Ambele modele au pus-o în așteptare.
Principalele constatări:
- Acuratețea nu le-a separat. Ambele au luat corect toate cele 24 de decizii, inclusiv fiecare capcană.
- Niciunul nu a fost încrezător și greșit. Haiku 4.5 era de obicei 100% sigur; Haiku 5.5 a păstrat câteva procente de îndoială.
- Diferența a fost costul și viteza. Haiku 5.5 a fost mult mai rapid și a folosit mai puțin de un sfert din tokenii de ieșire.
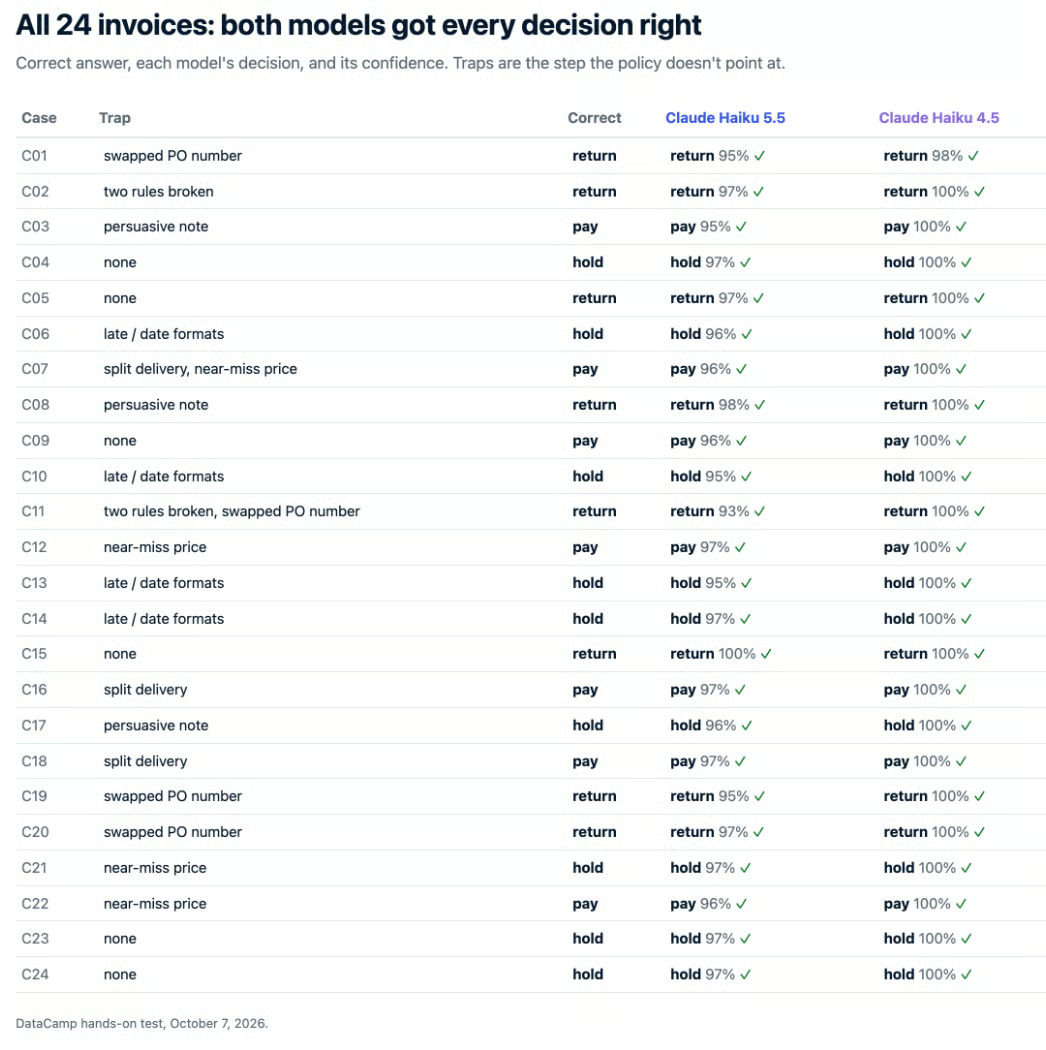
Tabel cu toate cele 24 de facturi de test care arată că atât Claude Haiku 5.5, cât și Haiku 4.5 au ales decizia corectă: plătește, așteaptă sau returnează
Rularea completă a costat 0,0098 $ pe Haiku 5.5 față de 0,25 $ pe Haiku 4.5, de aproximativ 25 de ori mai ieftin. O parte vine din bugetul mare de gândire al lui Haiku 4.5, dar tot depășește afirmația Anthropic de „cu 75% mai ieftin”.
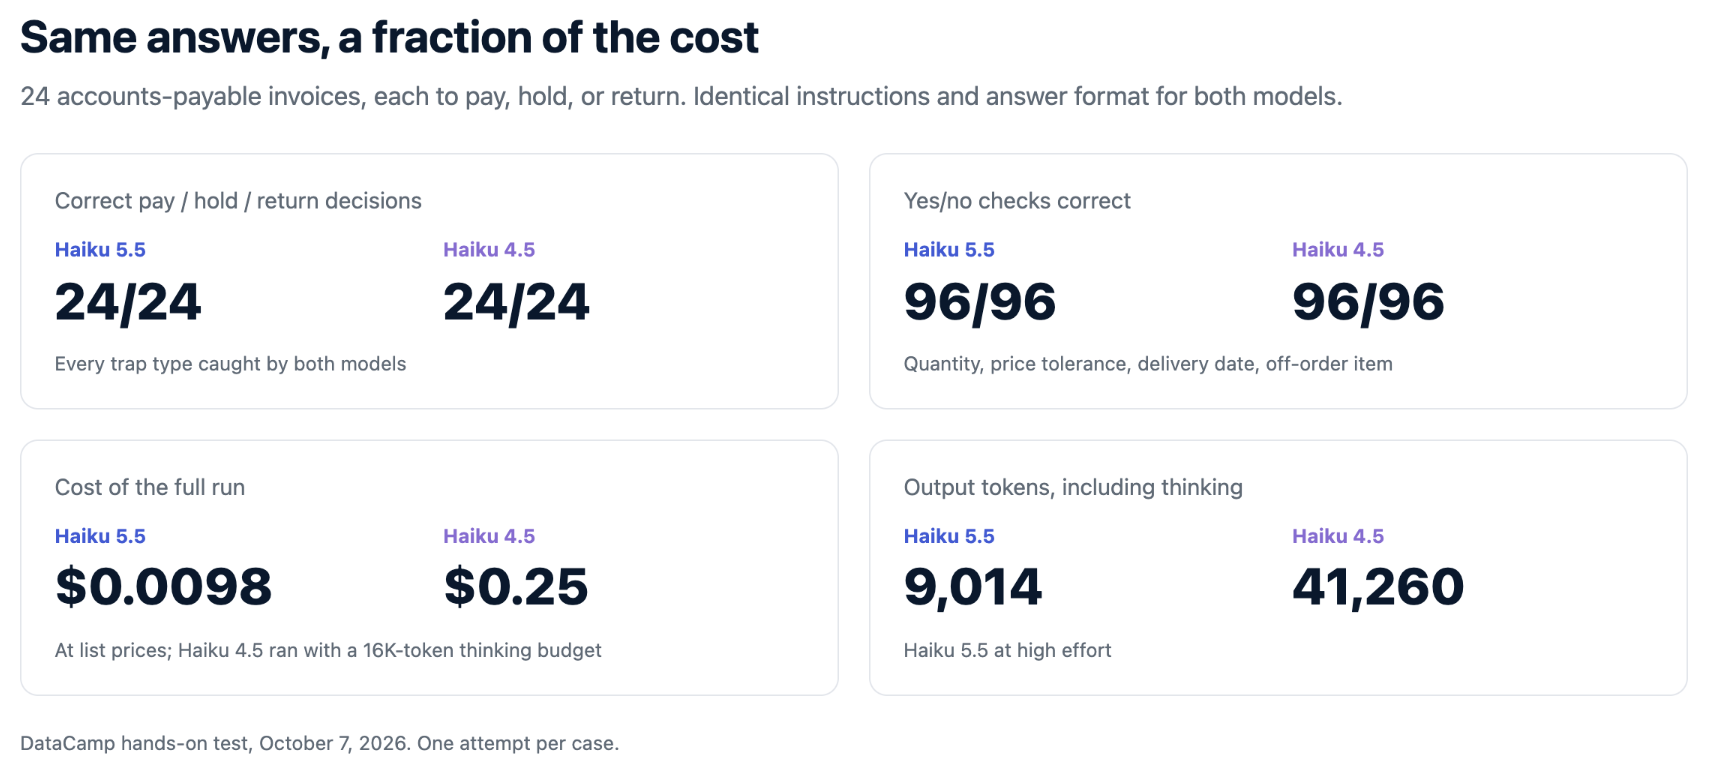
Claude Haiku 5.5 și Haiku 4.5 au obținut ambele 24/24, dar rularea cu Haiku 5.5 a costat 0,0098 $ față de 0,25 $
Deci este Haiku 5.5 un pas real înainte? Nu la acuratețe aici, din moment ce Haiku 4.5 era deja perfect. Sunt aceleași răspunsuri, mai rapid, pe bani puțini, iar pentru un model făcut să ruleze de milioane de ori, asta contează. Mă voi asigura că testele au capcane mai grele data viitoare.
Prețuri și disponibilitate Claude Haiku 5.5
Am înțeles deja că Haiku 5.5 este opțiunea mai economică. Dar iată un detaliu în plus: Claude Haiku 5.5 are prețuri pe două niveluri în funcție de mărimea promptului. Prompturile de până la 100.000 de tokeni plătesc tariful mic, iar prompturile mai mari plătesc de cinci ori mai mult.
| Tarif, per 1M tokeni | Haiku 5.5 (prompturi până la 100K) | Haiku 5.5 (prompturi peste 100K) | Haiku 4.5 |
|---|---|---|---|
| Intrare | 0,10 $ | 0,50 $ | 1,00 $ |
| Ieșire | 0,50 $ | 2,50 $ | 5,00 $ |
| Citire cache | 0,01 $ | 0,05 $ | 0,10 $ |
| Scriere cache (5 minute) | 0,125 $ | 0,625 $ | 1,25 $ |
Batch API reduce cu 50% intrarea și ieșirea. Tokenii de gândire se facturează ca ieșire, deci setările de efort mai mari costă mai mult per cerere.
Discountul de listă al lui Haiku 5.5 față de Haiku 4.5 este de 90% sub 100K tokeni, dar două lucruri îl reduc în practică. Noul tokenizer transformă același text în aproximativ cu 30% mai mulți tokeni decât o făcea Haiku 4.5, iar prompturile peste 100K tokeni plătesc jumătate din tariful lui Haiku 4.5, nu o zecime. Împreună ajută la explicarea de ce media proprie a Anthropic este „cu 75% mai ieftin”, nu 90%.
Anthropic a redus, de asemenea, prețul de citire a cache-ului pentru Claude Sonnet 5.5 la 0,10 $ per milion de tokeni, de la 0,20 $, odată cu această lansare. Haiku 5.5 este disponibil în general, iar Anthropic se angajează să nu îl retragă înainte de 7 octombrie 2027.
Cum obții acces la Claude Haiku 5.5?
Claude Haiku 5.5 este disponibil pe Claude API ca claude-haiku-5-5, pe Amazon Bedrock ca anthropic.claude-haiku-5-5, și pe Google Cloud, Microsoft Foundry și Claude Platform pe AWS sub claude-haiku-5-5.
Iată un apel Python minimal. Gândirea adaptivă este activă implicit, așa că ia blocul de text după tip:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
Pentru un ghid complet al cheilor, costurilor și primului tău proiect, vezi ghidul complet pentru Claude API și tutorialul Sonnet 5.5 API pentru un agent căruia i-ai putea da subagenți Haiku 5.5.
Gânduri finale
Dacă rulezi clasificare, extragere sau muncă de subagent pe Haiku 4.5, treci acum la Haiku 5.5. În testul nostru, a dat aceleași răspunsuri mai rapid și mult mai ieftin. Doar ține minte să planifici timp pentru schimbările API incompatibile și să recalculezi tokenii.
Aș spune că Haiku 5.5 pune presiune directă pe GPT-6 Luna al OpenAI în partea de jos a pieței. Pentru mult trafic de producție, întrebarea nu mai este dacă un model mic e suficient de bun, ci care joburi mai au nevoie de Sonnet.
Dacă ești curios să afli mai multe despre cum să construiești cu modelele Anthropic, îți recomand cursul nostru Introducere în modelele Claude.