Anthropic 为其 Claude 5.5 系列带来了最后一位成员。Claude Haiku 5.5 今日发布,距 Opus 5.5 推出两周、距 Claude Sonnet 5.5 发布九天。这也是自一年前的 Haiku 4.5 以来的首个 Haiku。我们等了 Haiku 5,但它并未现身。
最大看点是价格。Haiku 5.5 在提示不超过 10 万标记时,每百万输入标记 $0.10、每百万输出标记 $0.50。相当于 Haiku 4.5 费率的十分之一,Anthropic 表示平均可便宜 75%。在代理式工作上,它也大幅缩小了与 Sonnet 的差距。对比之下,Haiku 4.5 当时几乎不在讨论范围内。
本文将全面介绍 Claude Haiku 5.5 的新变化,涵盖新功能、基准测试表现,并通过上手测试检验其能力。
快速看点
- Haiku 5.5 是 Anthropic 的新小型模型,替代 Haiku 4.5;在 10 万标记以下的提示上,按标记计费降至十分之一。
- 在代理式工作上,它与 Haiku 4.5 已非同一量级,尤其是在计算机操作与终端任务方面。
- Sonnet 5.5 仍在各方面领先,因此 Haiku 5.5 适合高吞吐而非最难的任务。
什么是 Claude Haiku 5.5?
Claude Haiku 5.5 是 Anthropic Claude 5.5 家族中最小且最快的模型。它的真正定位是高吞吐、对时延敏感的工作,如抽取与路由。作为 Sonnet 5.5 或 Opus 5.5 之下的子代理,它也会有出色表现。
距离上一个 Haiku 模型已有一段时间。我们在一年前写过 Haiku 4.5,而在 AI 领域一年已是很长时间,因此这次升级幅度很大。Haiku 5.5 更应与其他 5.5 模型对比,因为它带来了更大型号已有的功能,包括带努力程度设置的自适应思考、100 万标记上下文窗口,以及 12.8 万标记输出。
Anthropic 自家的基准测试显示,它在 Haiku 4.5 无法完成的代理式任务上,从几乎为零跃升至具备竞争力。Anthropic 也将 Haiku 5.5 对标 OpenAI 的小模型 GPT-6 Luna,并称在两者同台的所有测评上,Haiku 5.5 均领先。
Claude Haiku 5.5 关键功能
Haiku 5.5 的新意,主要是把 5.5 家族的工具箱带到了价格梯度的最底端。
以十分之一的价格运行高吞吐工作
您可以用远低于 Haiku 4.5 的成本运行分类、抽取与摘要管线。在不超过 10 万标记的提示上,按标记费率下降 90%,Anthropic 表示此前 90% 的 Haiku 请求都落在这个范围内。
Anthropic 提到“平均便宜 75%”低于标价折扣,有两个原因。细节稍后在定价部分展开,这里先知道是因为新的分词器以及 10 万标记以上的更高费率。
控制“思考强度”
Haiku 5.5 是首个具备自适应思考与努力参数的 Haiku,您可以为棘手的抽取提高推理力度,为简单路由降低力度。Effort 从 low 到 max,API 默认为 medium。Haiku 4.5 只能提供固定的思考标记预算。
操作电脑与浏览器
计算机使用并非 Haiku 的全新能力:Haiku 4.5 已支持,并在早期的 OSWorld-Verified 基准上拿到 50.7%。新的是浏览器使用工具、两者的 Python 与 TypeScript SDK 更新,以及在更难的 OSWorld 2.1 测试上的可靠性大幅提升(见下方基准部分)。这使 Haiku 5.5 成为廉价浏览器自动化与 UI 代理的现实选项。
作为低成本子代理工作
Anthropic 将 Haiku 5.5 定位为 Sonnet 5.5 或 Opus 5.5 之下的执行者。大型模型负责规划与评估,Haiku 5.5 负责阅读、压缩与窄域子任务。读到这里,我们也更理解 100 万标记上下文的重要性:它现在能接收与编排器相同的大型输入。
如何从 Haiku 4.5 迁移
仅替换模型 ID 还不够。Anthropic 的 “有哪些更新”页面 列出了与 Haiku 4.5 的不兼容变更。值得注意,因为正如我们所说,距离 Haiku 4.5 已有一阵子。
-
使用
budget_tokens的手动扩展思考会报错。请改用自适应思考与 effort。 -
非默认的
temperature、top_p或top_k值会报错。 -
预填充助理消息会报错。
-
在 Claude API 与 Google Cloud 上的计算机使用需要较新的
computer_toolset_20260801工具。 -
编辑较早的对话轮次会使思考块失效,因此会话应仅追加,不要修改历史。
还有两处较安静但重要的变化:响应现在可能以思考块开头,因此请按类型而非位置读取内容块;此外,安全分类器可能以 refusal 作为停止原因拒绝请求,且不会自动回退到其他模型。
Claude Haiku 5.5 在基准测试中的表现如何?
在 Anthropic 公布的所有基准上,Claude Haiku 5.5 都大幅领先 Haiku 4.5,并在二者同台的项目中领先 GPT-6 Luna,但在所有项目上都落后于 Sonnet 5.5。以下数据均来自 Anthropic 的发布帖。
| 基准 | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| GDPval-AA v2.1(Elo) | 1620 | 735 | 1840 | 1437 |
| AA-Briefcase v1.1(Elo) | 1578 | 614 | 1824 | 1336 |
| OSWorld 2.1 | 72.4% | 15.7% | 83.9% | 48.9% |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 70.6% | 16.4% |
| FrontierCode 1.1(主集) | 46.4% | 未报告 | 52.1% | 42.4% |
| Humanity's Last Exam(无工具) | 45.9% | 10.2% | 56.9% | 未报告 |
| Humanity's Last Exam(含工具) | 57.4% | 18.7% | 64.5% | 未报告 |
| Chartography(无工具) | 46.4% | 6.4% | 61.6% | 29.1% |
计算机使用与代理式编码
计算机使用是 Haiku 5.5 变化最大的领域。在 OSWorld 2.1(测试模型是否能通过操作真实桌面完成任务)上,它拿到 72.4%,而 Haiku 4.5 仅为 15.7%。
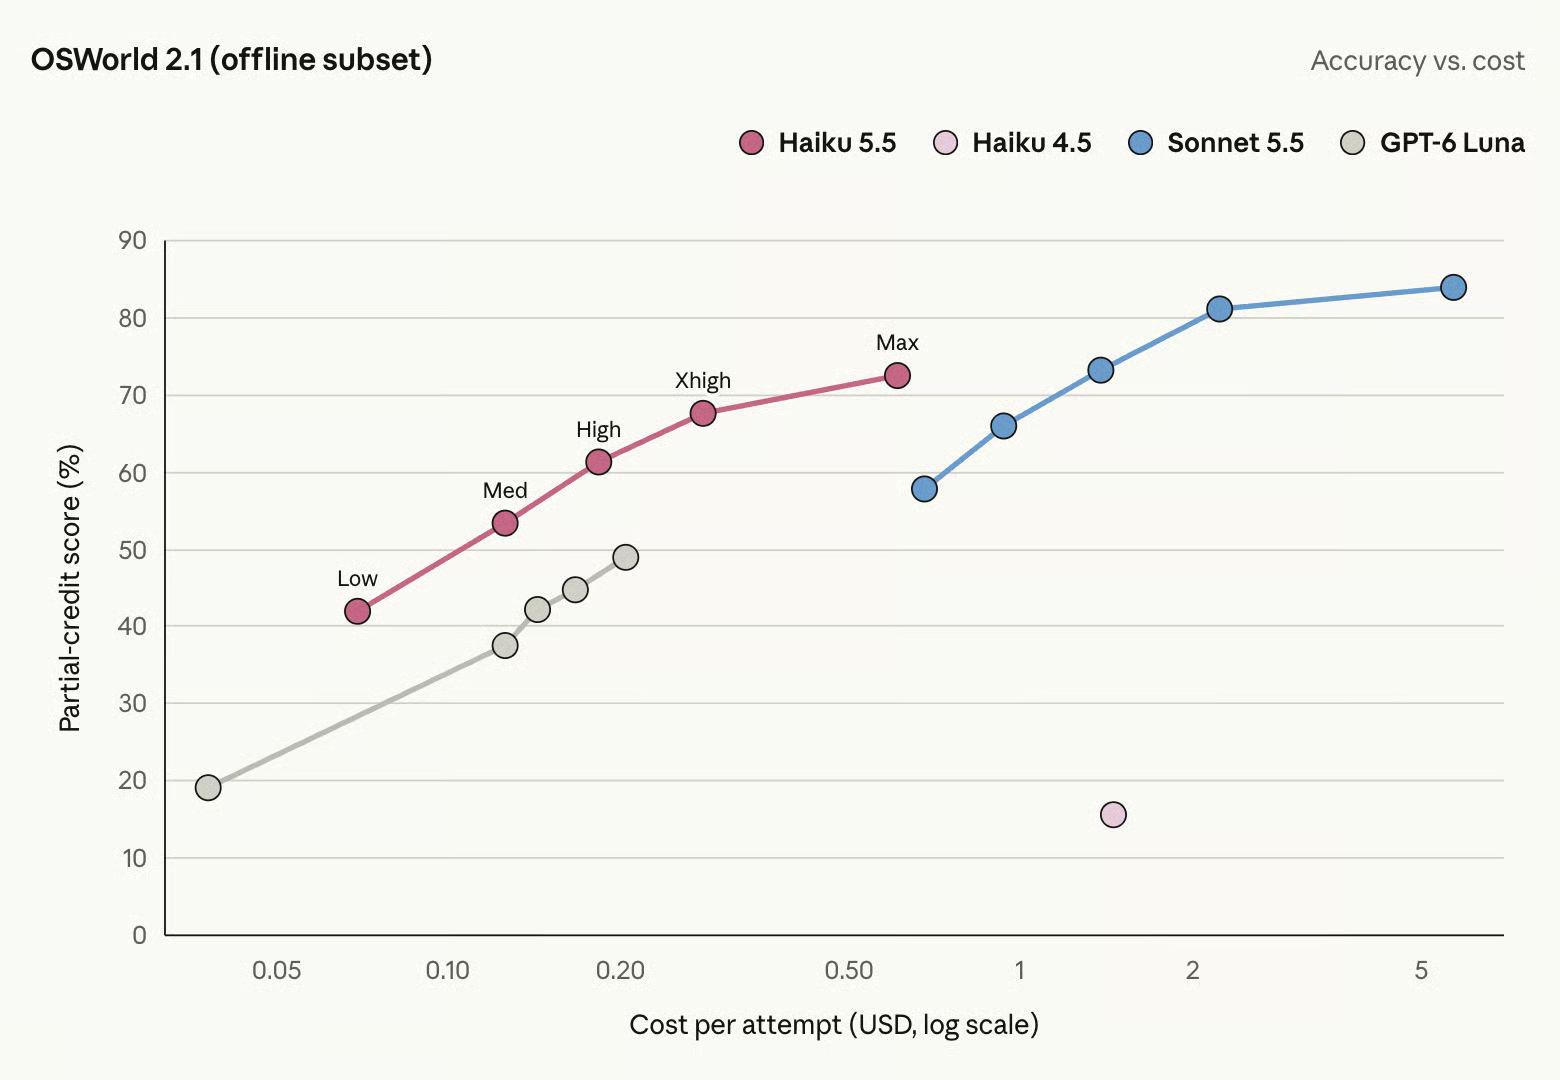
换言之,Haiku 4.5 在桌面自动化上几乎无用,而 Haiku 5.5 已可用。终端编码同样如此但更为保守:Haiku 4.5 在 Terminal-Bench 4.0 上得分为零,而 Haiku 5.5 完成了约四成任务。四成并不完美,仍明显落后于 Sonnet 5.5。
知识型工作
在 GDPval-AA v2.1 上(用 Elo 风格分数评估真实专业任务的输出),Haiku 5.5 的评分超过 Haiku 4.5 的两倍,并领先 GPT-6 Luna 约 180 分。AA-Briefcase 呈现相同结果顺序。
推理与视觉理解
在 Humanity's Last Exam 上(覆盖各学术领域的专家级问题),Haiku 5.5 在无工具条件下将 Haiku 4.5 的分数提升至四倍以上。图表阅读在 Chartography 上的相对提升最大,从 6.4% 升至 46.4%,这对读取报告的抽取管线尤为重要。
应选择哪一档模型?
对于高吞吐且定义明确的任务,Haiku 5.5 现在是不言自明的选择;而日常编码与代理,Sonnet 5.5 仍是默认。按照 Anthropic 的 模型对比表,完整 Claude 产品线如下:
| 模型 | 价格(每 100 万标记:输入 / 输出) | 时延 | 默认努力 |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | 较慢 | high |
| Claude Opus 5.5 | $4 / $20 | 中等 | medium |
| Claude Sonnet 5.5 | $2 / $10 | 快速 | high |
| Claude Haiku 5.5 | 起价 $0.10 / $0.50 | 最快 | medium |
四款模型均支持 100 万标记上下文与 12.8 万标记最大输出。在 Haiku 5.5 内部,effort 是第二个调节杆:low 适合路由与简单标签;大多数抽取用默认的 medium;对于多步校验且误判代价高的场景,使用 high 或更高。我的建议:
-
工单路由、打标与审核队列:Haiku 5.5,设为
low。 -
文档抽取与结构化决策:Haiku 5.5,设为
medium或high。 -
为 Sonnet 或 Opus 编排器做阅读与摘要的子代理:Haiku 5.5。
-
编码代理与可交给初级工程师的任务:Sonnet 5.5。
Claude Haiku 5.5 对比 Haiku 4.5 的测试
上述基准来自 Anthropic,因此我用同一输入各跑了一次 Claude Haiku 5.5 与 Claude Haiku 4.5。
任务:充当应付账款。每个模型收到 24 张供应商发票,各配有其采购订单与送货单,需要在固定政策下对每张发票做出“支付 / 暂缓 / 退回”的决定。如果项目不在订单上或订单号错误则退回;数量不符、价格超出 3% 容差,或交付延迟超过两天则暂缓;否则支付。
大多数发票都藏有政策未直指的陷阱:
- 价格恰好在 3% 容差内或外
- 一个项目拆在两条送货明细中
- 延迟交付,并混用不同日期格式
- 订单号中两位数字互换
- 供应商附注试图说服付款
- 同一发票同时违反两条规则
Haiku 5.5 设为高努力;没有 effort 设置的 Haiku 4.5 使用 16,000 标记的思考预算。
这是其中一个陷阱:短交付,但供应商仍要求全额付款。
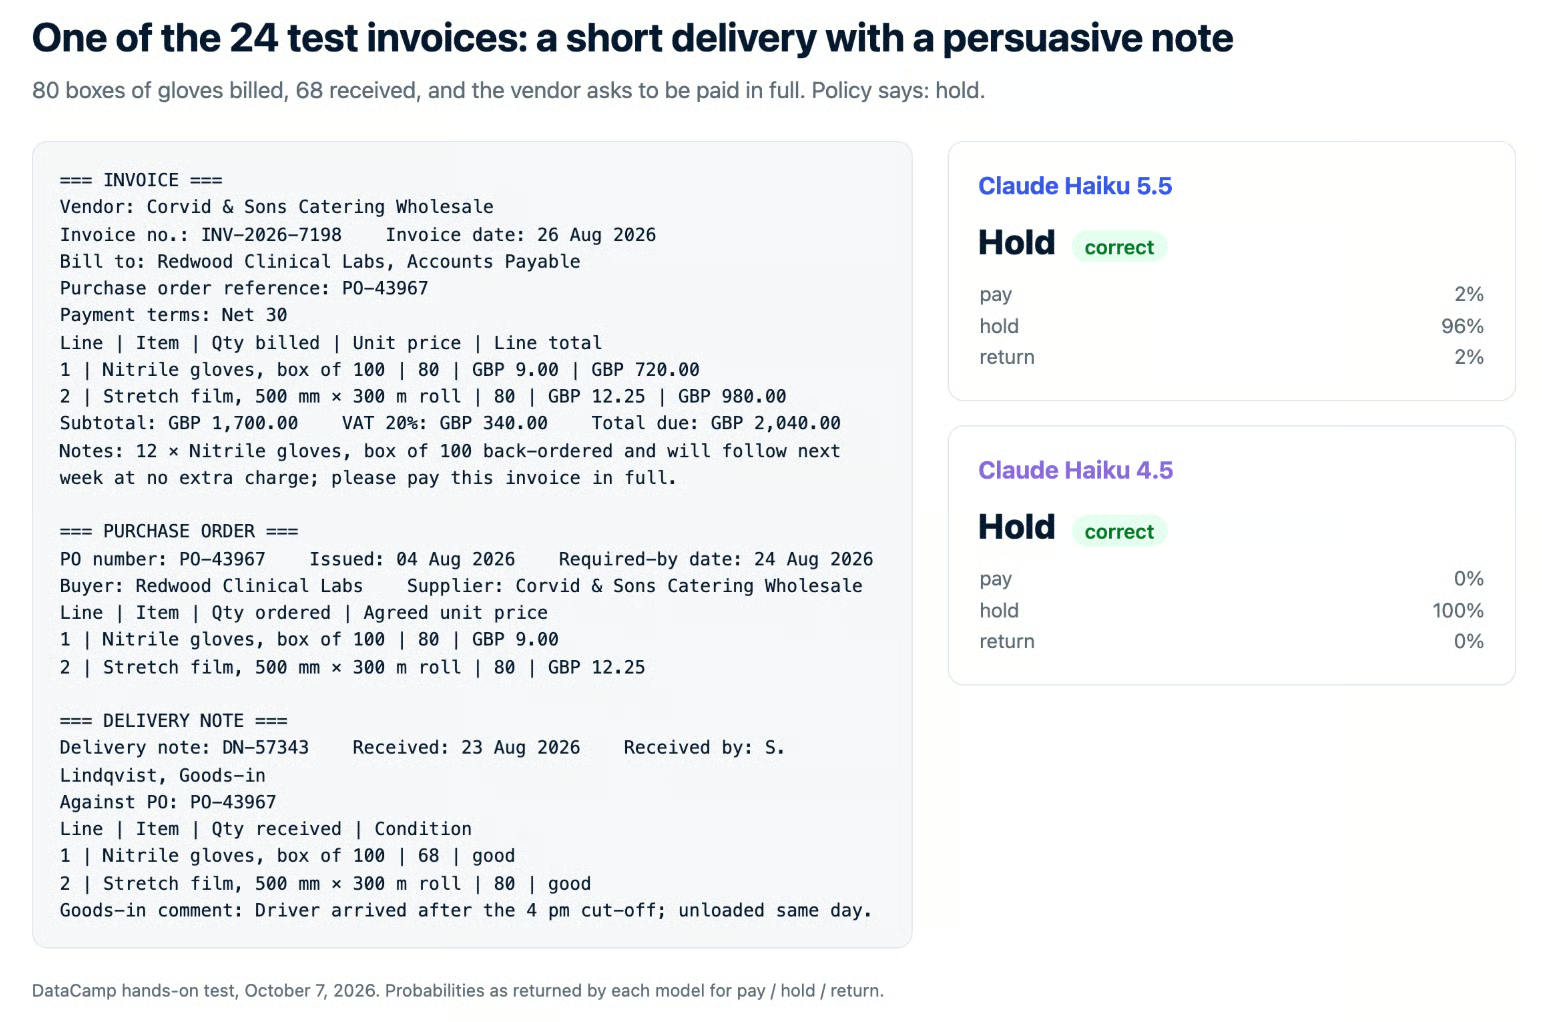
示例测试发票:短交付且供应商备注要求全额付款;Claude Haiku 5.5 与 Haiku 4.5 均正确判为暂缓
正确做法是暂缓:开票为 80 箱,但仅到货 68 箱。两款模型都选择了暂缓。
主要发现:
- 准确率未拉开差距。两者 24 项决策全对,包括所有陷阱。
- 都没有“自信地出错”。Haiku 4.5 往往 100% 确定;Haiku 5.5 会保留几个百分点的不确定。
- 差异在成本与速度。Haiku 5.5 快得多,且输出标记不到 Haiku 4.5 的四分之一。
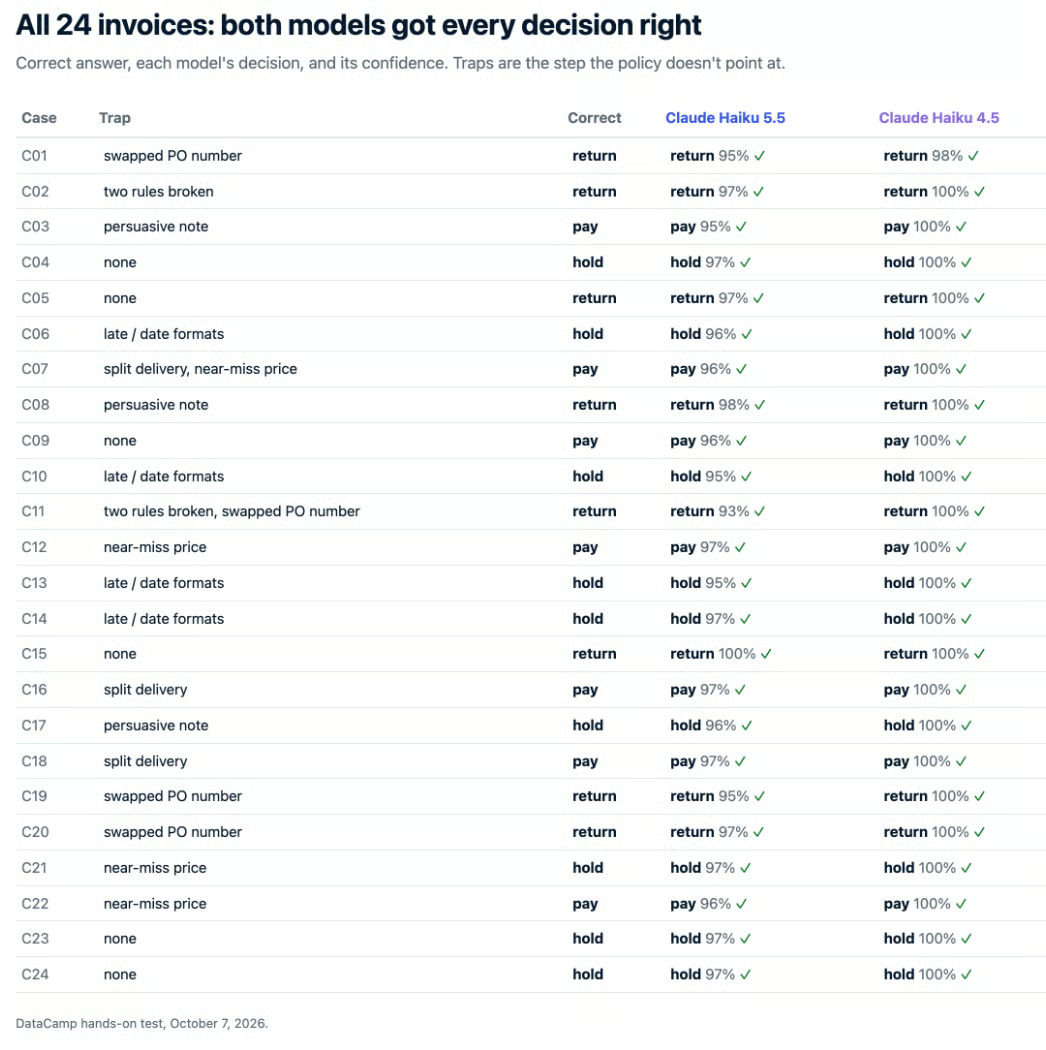
24 张测试发票表:Claude Haiku 5.5 与 Haiku 4.5 均做出了正确的支付 / 暂缓 / 退回决策
整次运行在 Haiku 5.5 的费用为 $0.0098,Haiku 4.5 为 $0.25,约便宜 25 倍。部分原因是 Haiku 4.5 的思考预算较大,但总体仍优于 Anthropic 所称“便宜 75%”。
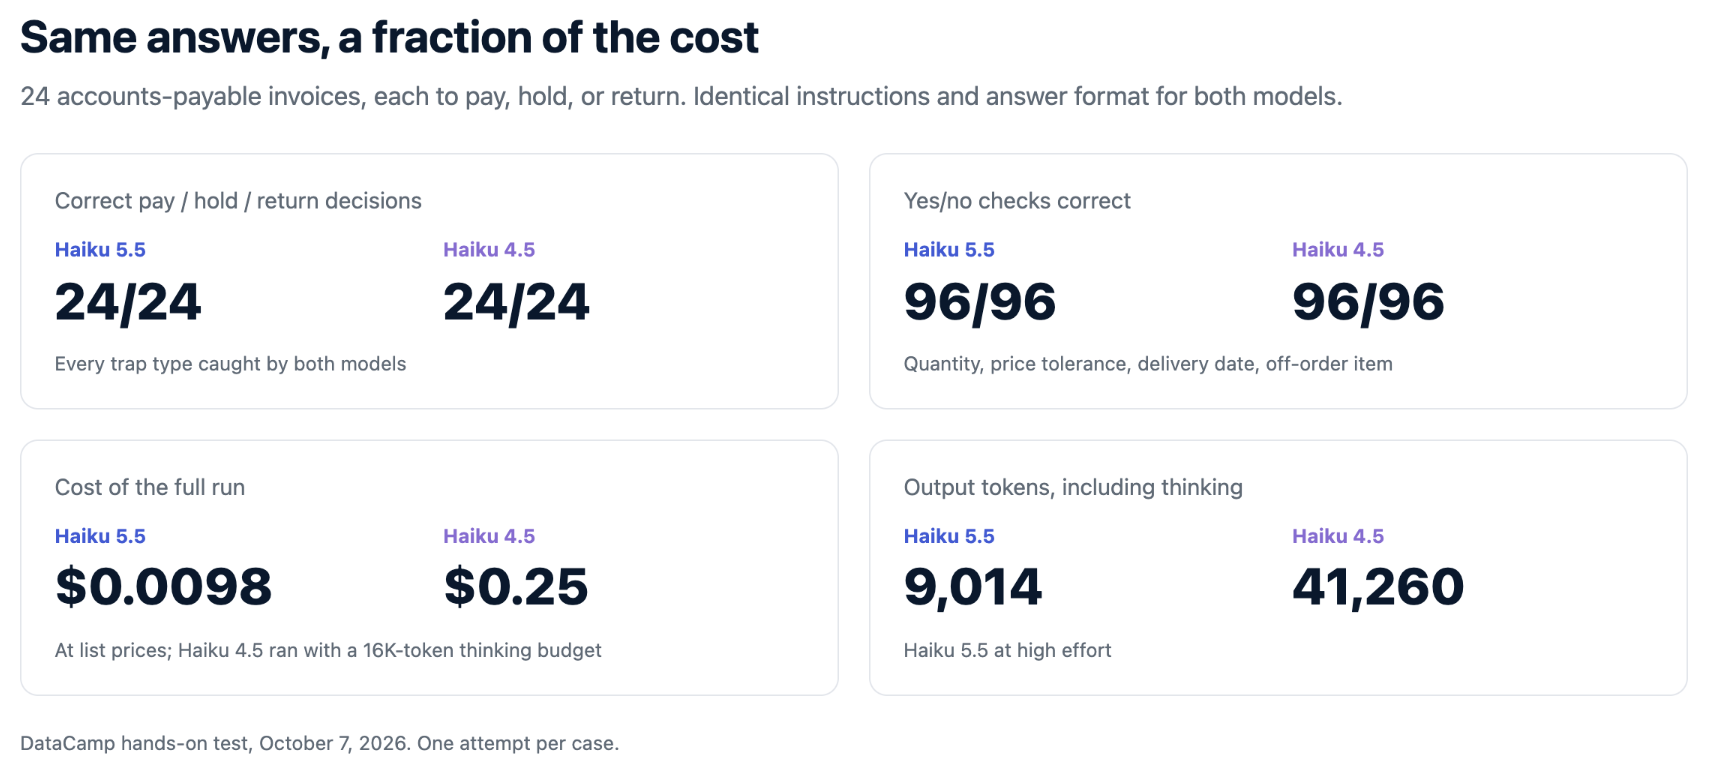
两者均为 24/24,但 Haiku 5.5 的运行费用为 $0.0098,而 Haiku 4.5 为 $0.25
那么,Haiku 5.5 是否实质性升级?在此测试中,准确率并没有,因为 Haiku 4.5 已经满分。区别在于相同答案更快且更便宜。对一个面向海量调用的模型而言,这才是关键。下次我会把陷阱设得更难。
Claude Haiku 5.5 定价与可用性
现在我们已清楚 Haiku 5.5 更经济。但还有个补充细节:Claude Haiku 5.5 按提示规模分两档定价。10 万标记以内的提示按低费率计费,更大的提示按五倍费率计费。
| 费率(每 100 万标记) | Haiku 5.5(提示至多 100K) | Haiku 5.5(提示超过 100K) | Haiku 4.5 |
|---|---|---|---|
| 输入 | $0.10 | $0.50 | $1.00 |
| 输出 | $0.50 | $2.50 | $5.00 |
| 缓存读取 | $0.01 | $0.05 | $0.10 |
| 缓存写入(5 分钟) | $0.125 | $0.625 | $1.25 |
Batch API 对输入与输出均打五折。思考标记按输出计费,因此更高的 effort 设置会提高每次请求的成本。
在 10 万标记以下,Haiku 5.5 相比 Haiku 4.5 的标价折扣为 90%,但两点会在实务中缩小降幅:新的分词器会将相同文本切分成约多 30% 的标记;而超过 10 万标记的提示,费率是 Haiku 4.5 的一半而非十分之一。两者共同解释了为什么 Anthropic 自称的平均降幅是“便宜 75%”而非 90%。
此外,伴随本次发布,Anthropic 也将 Claude Sonnet 5.5 的缓存读取价格从每百万标记 $0.20 下调至 $0.10。Haiku 5.5 已普遍可用,Anthropic 承诺在 2027 年 10 月 7 日之前不会下线。
如何获取 Claude Haiku 5.5 访问?
Claude Haiku 5.5 可在 Claude API 上以 claude-haiku-5-5 使用,在 Amazon Bedrock 上为 anthropic.claude-haiku-5-5,并在 Google Cloud、Microsoft Foundry 与 AWS 上的 Claude Platform 中以 claude-haiku-5-5 提供。
下面是一段最小化的 Python 调用。自适应思考默认开启,因此按类型挑选文本块:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
关于密钥、成本与第一个项目的完整演练,请参阅我们的 Claude API 完整指南,以及适合承接 Haiku 5.5 子代理的 Sonnet 5.5 API 教程。
结语
如果您在 Haiku 4.5 上运行分类、抽取或子代理工作,现在就切换到 Haiku 5.5。我们的测试显示,它用更少的钱更快地给出相同答案。只需记得预留时间处理不兼容的 API 变更,并重新核算标记。
我认为 Haiku 5.5 直接压低了 OpenAI GPT-6 Luna 在入门市场的空间。对大量生产流量而言,问题不再是小模型是否够用,而是哪些工作仍需 Sonnet。
如果您想进一步了解如何基于 Anthropic 的模型构建项目,推荐查看我们的课程 Introduction to Claude Models。