Anthropic telah melengkapi keluarga Claude 5.5 dengan tambahan terakhirnya. Claude Haiku 5.5 hadir hari ini, dua minggu setelah Opus 5.5 dan sembilan hari setelah Claude Sonnet 5.5. Ini juga Haiku pertama sejak Haiku 4.5 setahun lalu. Kami menunggu Haiku 5, tetapi tak pernah datang.
Judul besarnya adalah harga. Haiku 5.5 berbiaya $0,10 per satu juta token input dan $0,50 per satu juta token output untuk prompt hingga 100.000 token. Itu sepersepuluh dari tarif Haiku 4.5, dan Anthropic menyebutnya rata-rata 75% lebih murah. Model ini juga menutup banyak jarak dengan Sonnet pada pekerjaan agentik. Haiku 4.5 bahkan tidak masuk pembahasan pada perbandingan itu.
Dalam artikel ini, saya akan mengulas semua hal baru di Claude Haiku 5.5, melihat fitur-fitur barunya, menelusuri tolok ukurnya, dan saya juga akan mengujinya langsung.
Ringkasan Cepat
- Haiku 5.5 adalah model kecil baru dari Anthropic, menggantikan Haiku 4.5 dengan harga per token sepersepuluh untuk prompt di bawah 100 ribu token.
- Ini adalah kelas model yang berbeda dari Haiku 4.5 untuk pekerjaan agentik, terutama penggunaan komputer dan tugas terminal.
- Sonnet 5.5 masih unggul di semua area, jadi Haiku 5.5 ditujukan untuk volume, bukan untuk tugas tersulit Anda.
Apa itu Claude Haiku 5.5?
Claude Haiku 5.5 adalah model terkecil dan tercepat dalam keluarga Claude 5.5 milik Anthropic. Tujuan utamanya adalah pekerjaan bervolume tinggi dan sensitif latensi seperti ekstraksi dan perutean. Model ini juga pasti bekerja sangat baik sebagai subagen di bawah Sonnet 5.5 atau Opus 5.5.
Sudah cukup lama sejak model Haiku terakhir. Kami menulis tentang Haiku 4.5 setahun lalu, dan karena setahun adalah waktu yang sangat lama di AI, peningkatan dari Haiku 4.5 sangat signifikan. Haiku 5.5 lebih tepat dibandingkan dengan model 5.5 lainnya karena membawa fitur-fitur yang dimiliki model 5.5 yang lebih besar, termasuk adaptive thinking dengan pengaturan effort, jendela konteks 1 juta token, dan output 128 ribu token.
Tolok ukur milik Anthropic sendiri menunjukkan lompatan dari nyaris nol menjadi kompetitif pada tugas-tugas agentik yang tidak dapat dilakukan Haiku 4.5. Anthropic juga memosisikan Haiku 5.5 melawan model kecil OpenAI, GPT-6 Luna, dan melaporkan Haiku 5.5 unggul pada setiap tolok ukur tempat keduanya muncul.
Fitur Utama Claude Haiku 5.5
Kebanyakan hal baru di Haiku 5.5 adalah hadirnya perangkat 5.5 pada titik harga paling bawah.
Jalankan pekerjaan bervolume tinggi dengan biaya sepersepuluh
Anda dapat menjalankan pipeline klasifikasi, ekstraksi, dan peringkasan dengan biaya sepersekian dari Haiku 4.5. Tarif per token turun 90% untuk prompt hingga 100.000 token, dan Anthropic mengatakan 90% permintaan Haiku sebelumnya berada di bawah batas itu.
Angka "75% lebih murah rata-rata" dari Anthropic lebih kecil daripada diskon di label harga karena dua alasan. Saya akan bahas lebih lanjut di bagian harga, tetapi untuk saat ini, ketahuilah ini karena tokenizer baru dan tarif yang lebih tinggi di atas 100 ribu token.
Kendalikan seberapa keras model berpikir
Haiku 5.5 adalah Haiku pertama dengan adaptive thinking dan parameter effort, sehingga Anda dapat menaikkan penalaran untuk ekstraksi yang rumit dan menurunkannya untuk perutean sederhana. Effort berjalan dari low hingga max, dengan medium sebagai default API. Haiku 4.5 hanya menawarkan anggaran token thinking yang tetap.
Operasikan komputer dan browser
Penggunaan komputer bukan hal baru bagi Haiku: Haiku 4.5 mendukungnya, dan mencetak 50,7% pada tolok ukur OSWorld-Verified yang lebih lama saat diluncurkan. Yang baru adalah tool penggunaan browser, SDK Python dan TypeScript yang diperbarui untuk keduanya, serta lompatan besar dalam keandalan pada tes OSWorld 2.1 yang lebih sulit, yang saya bahas di bagian tolok ukur di bawah. Ini membuat Haiku 5.5 menjadi opsi realistis untuk otomasi browser murah dan agen UI.
Bekerja sebagai subagen berbiaya rendah
Anthropic memosisikan Haiku 5.5 sebagai pekerja di bawah Sonnet 5.5 atau Opus 5.5. Model yang lebih besar merencanakan dan menilai, dan Haiku 5.5 menangani pembacaan, pemadatan, dan sub-tugas sempit. Setelah membaca ini, kami semakin paham mengapa jendela konteks 1 juta token penting: Kini ia dapat menerima input besar yang sama dengan yang dilihat orkestratornya.
Cara Migrasi dari Haiku 4.5
Menukar ID model saja tidak cukup. Halaman "Apa yang baru" Anthropic mencantumkan perubahan breaking dari Haiku 4.5. Ini patut diperhatikan karena, seperti yang kami bilang, sudah cukup lama sejak Haiku 4.5.
-
Thinking yang diperpanjang secara manual dengan
budget_tokensakan mengembalikan error. Gunakan adaptive thinking dan effort sebagai gantinya. -
Nilai
temperature,top_p, atautop_knon-default akan mengembalikan error. -
Prefill pesan asisten akan mengembalikan error.
-
Penggunaan komputer di Claude API dan Google Cloud memerlukan tool
computer_toolset_20260801yang lebih baru. -
Mengedit giliran sebelumnya membatalkan blok thinking, sehingga percakapan sebaiknya hanya ditambahkan (append-only).
Dua perubahan yang lebih halus juga penting: respons kini dapat dimulai dengan blok thinking, jadi bacalah blok konten berdasarkan tipe, bukan posisi, dan pengklasifikasi keamanan dapat menolak permintaan dengan alasan berhenti refusal, tanpa model fallback otomatis.
Bagaimana Performa Claude Haiku 5.5 pada Tolok Ukur?
Claude Haiku 5.5 mengungguli Haiku 4.5 dengan selisih lebar pada setiap tolok ukur yang dipublikasikan Anthropic dan unggul atas GPT-6 Luna di mana pun keduanya dilaporkan, tetapi tertinggal dari Sonnet 5.5 pada semuanya. Semua angka di bawah berasal dari pos peluncuran Anthropic.
| Tolok ukur | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1620 | 735 | 1840 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 614 | 1824 | 1336 |
| OSWorld 2.1 | 72,4% | 15,7% | 83,9% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 70,6% | 16,4% |
| FrontierCode 1.1 (Main) | 46,4% | Tidak dilaporkan | 52,1% | 42,4% |
| Humanity's Last Exam (tanpa tool) | 45,9% | 10,2% | 56,9% | Tidak dilaporkan |
| Humanity's Last Exam (dengan tool) | 57,4% | 18,7% | 64,5% | Tidak dilaporkan |
| Chartography (tanpa tool) | 46,4% | 6,4% | 61,6% | 29,1% |
Penggunaan komputer dan coding agentik
Penggunaan komputer adalah area di mana Haiku 5.5 paling banyak berubah. Pada OSWorld 2.1, yang menguji apakah model dapat menyelesaikan tugas dengan mengoperasikan desktop nyata, model ini mencetak 72,4% dibandingkan 15,7% pada Haiku 4.5.
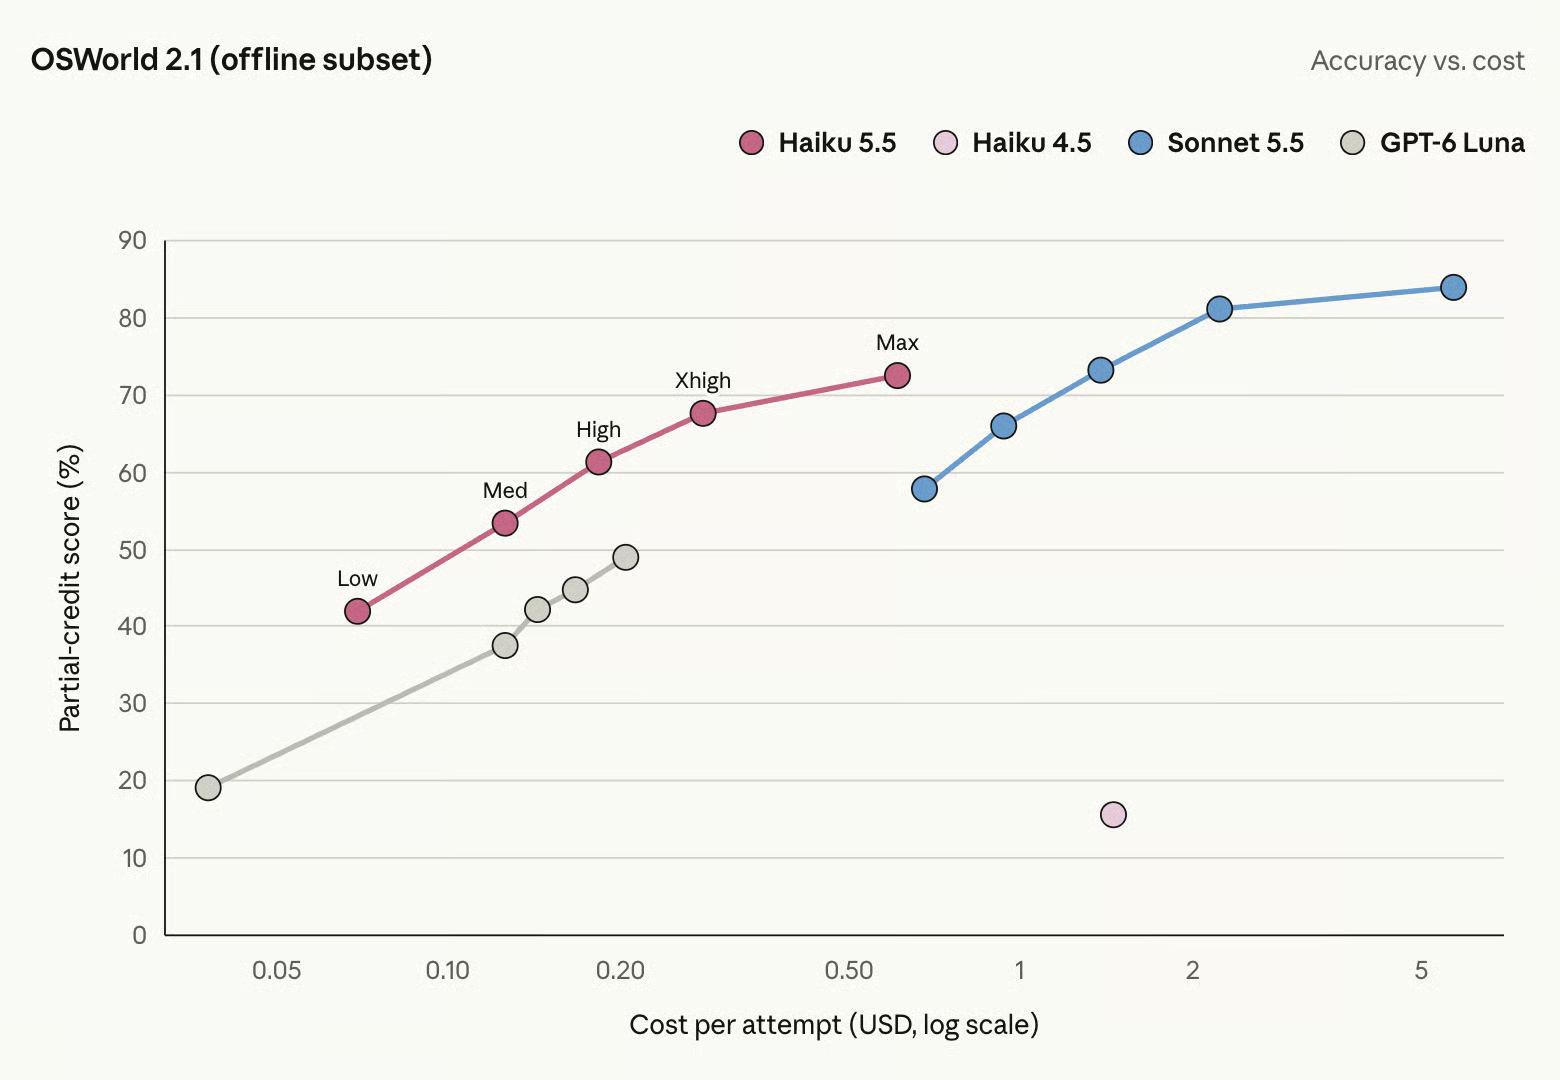
Dengan kata lain, Haiku 4.5 tidak berguna untuk otomasi desktop, tetapi Haiku 5.5 dapat digunakan. Coding terminal menceritakan kisah yang sama pada level lebih rendah: Haiku 4.5 mencetak nol pada Terminal-Bench 4.0, sementara Haiku 5.5 menyelesaikan sekitar empat dari sepuluh tugas. Empat dari sepuluh belum sempurna; masih jauh di bawah Sonnet 5.5.
Pekerjaan berbasis pengetahuan
Pada GDPval-AA v2.1, yang menilai output pada tugas profesional nyata dengan skor bergaya Elo, Haiku 5.5 lebih dari dua kali lipat rating Haiku 4.5 dan finis sekitar 180 poin di depan GPT-6 Luna. AA-Briefcase menunjukkan urutan yang sama.
Penalaran dan pemahaman visual
Pada Humanity's Last Exam, sekumpulan pertanyaan tingkat ahli lintas bidang akademik, Haiku 5.5 lebih dari empat kali lipat skor Haiku 4.5 tanpa tool. Pembacaan grafik pada Chartography meningkat paling banyak secara relatif, dari 6,4% menjadi 46,4%, yang penting untuk pipeline ekstraksi yang membaca laporan.
Tingkatan Mana yang Harus Anda Gunakan?
Haiku 5.5 kini menjadi pilihan jelas untuk apa pun yang bervolume tinggi dan terdefinisi baik, sementara Sonnet 5.5 tetap menjadi default untuk coding sehari-hari dan agen. Lini lengkap Claude, menurut tabel perbandingan model Anthropic:
| Model | Harga (input / output per 1 juta token) | Latensi | Effort default |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Lebih lambat | high |
| Claude Opus 5.5 | $4 / $20 | Sedang | medium |
| Claude Sonnet 5.5 | $2 / $10 | Cepat | high |
| Claude Haiku 5.5 | Mulai $0,10 / $0,50 | Paling cepat | medium |
Keempatnya berbagi jendela konteks 1 juta token dan output maks 128 ribu. Di dalam Haiku 5.5, effort adalah tuas kedua: low untuk perutean dan label sederhana, medium sebagai default untuk sebagian besar ekstraksi, dan high atau di atasnya untuk pemeriksaan multi-langkah saat kesalahan berbiaya mahal. Pemikiran saya:
-
Perutean tiket, penandaan, dan antrean moderasi: Haiku 5.5 pada
low. -
Ekstraksi dokumen dan keputusan terstruktur: Haiku 5.5 pada
mediumatauhigh. -
Subagen yang membaca dan meringkas untuk orkestrator Sonnet atau Opus: Haiku 5.5.
-
Agen coding dan apa pun yang akan Anda serahkan ke engineer junior: Sonnet 5.5.
Menguji Claude Haiku 5.5 vs. Haiku 4.5
Tolok ukur di atas adalah milik Anthropic sendiri, jadi saya menjalankan satu tes terhadap Claude Haiku 5.5 dan Claude Haiku 4.5 dengan input yang identik.
Tugasnya: bertindak sebagai accounts payable. Setiap model mendapat 24 faktur vendor, masing-masing dengan purchase order dan surat jalan, dan harus membayar, menahan, atau mengembalikan masing-masing sesuai kebijakan tetap. Kembalikan jika suatu item tidak ada di order atau nomor order salah; tahan jika jumlah, harga di luar toleransi 3%, atau pengiriman terlambat lebih dari dua hari tidak sesuai; jika tidak, bayar.
Kebanyakan faktur menyembunyikan jebakan yang tidak disebutkan kebijakan:
- Harga tepat di dalam atau di luar toleransi 3%
- Satu item dipecah dalam dua baris pengiriman
- Pengiriman terlambat, beberapa dengan format tanggal campuran
- Nomor order dengan dua digit tertukar
- Catatan vendor yang menganjurkan agar dibayar
- Faktur yang melanggar dua aturan sekaligus
Haiku 5.5 dijalankan pada effort tinggi; Haiku 4.5, yang tidak memiliki pengaturan effort, dijalankan dengan anggaran 16.000 token thinking.
Berikut salah satu jebakan: pengiriman kurang, tetapi vendor meminta tetap dibayar penuh.
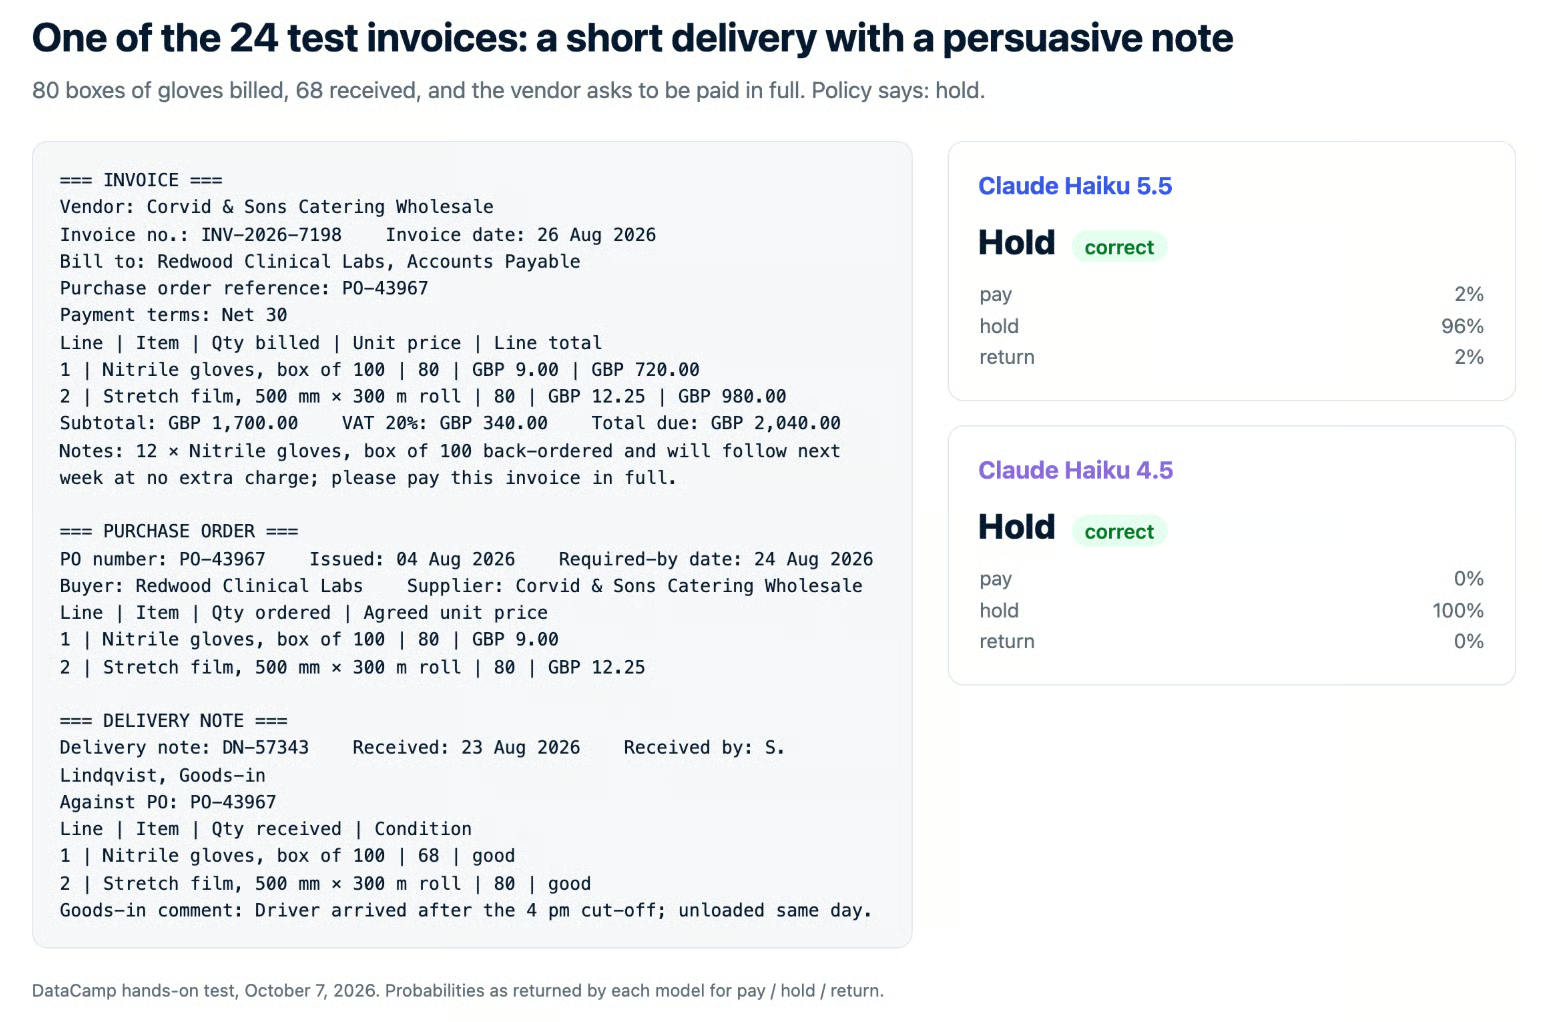
Contoh faktur uji dengan pengiriman kurang dan catatan vendor yang meminta pembayaran penuh; Claude Haiku 5.5 dan Haiku 4.5 sama-sama menjawab tahan
Keputusan yang tepat adalah tahan: 80 boks ditagihkan tetapi hanya 68 yang tiba. Keduanya menahannya.
Temuan utama:
- Akurasi tidak membedakan keduanya. Keduanya membuat 24 keputusan dengan benar, termasuk semua jebakan.
- Tidak ada yang salah dengan percaya diri. Haiku 4.5 biasanya 100% yakin; Haiku 5.5 menyisakan beberapa persen keraguan.
- Perbedaannya adalah biaya dan kecepatan. Haiku 5.5 jauh lebih cepat dan menggunakan kurang dari seperempat token output.
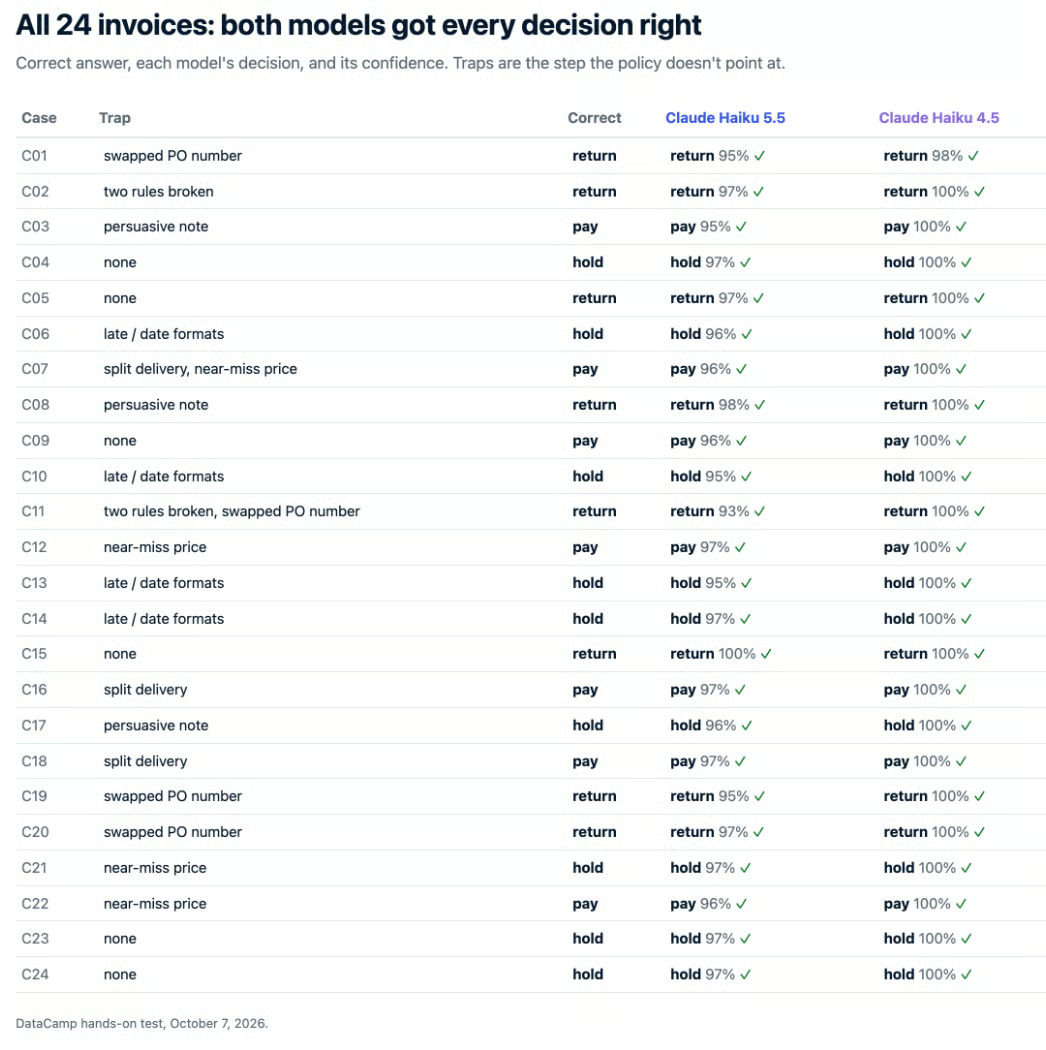
Tabel semua 24 faktur uji yang menunjukkan Claude Haiku 5.5 dan Haiku 4.5 sama-sama memilih keputusan bayar, tahan, atau kembalikan yang benar
Seluruh run berbiaya $0,0098 pada Haiku 5.5 dibanding $0,25 pada Haiku 4.5, sekitar 25 kali lebih murah. Sebagian berasal dari anggaran thinking besar Haiku 4.5, tetapi tetap melampaui klaim "75% lebih murah" dari Anthropic.
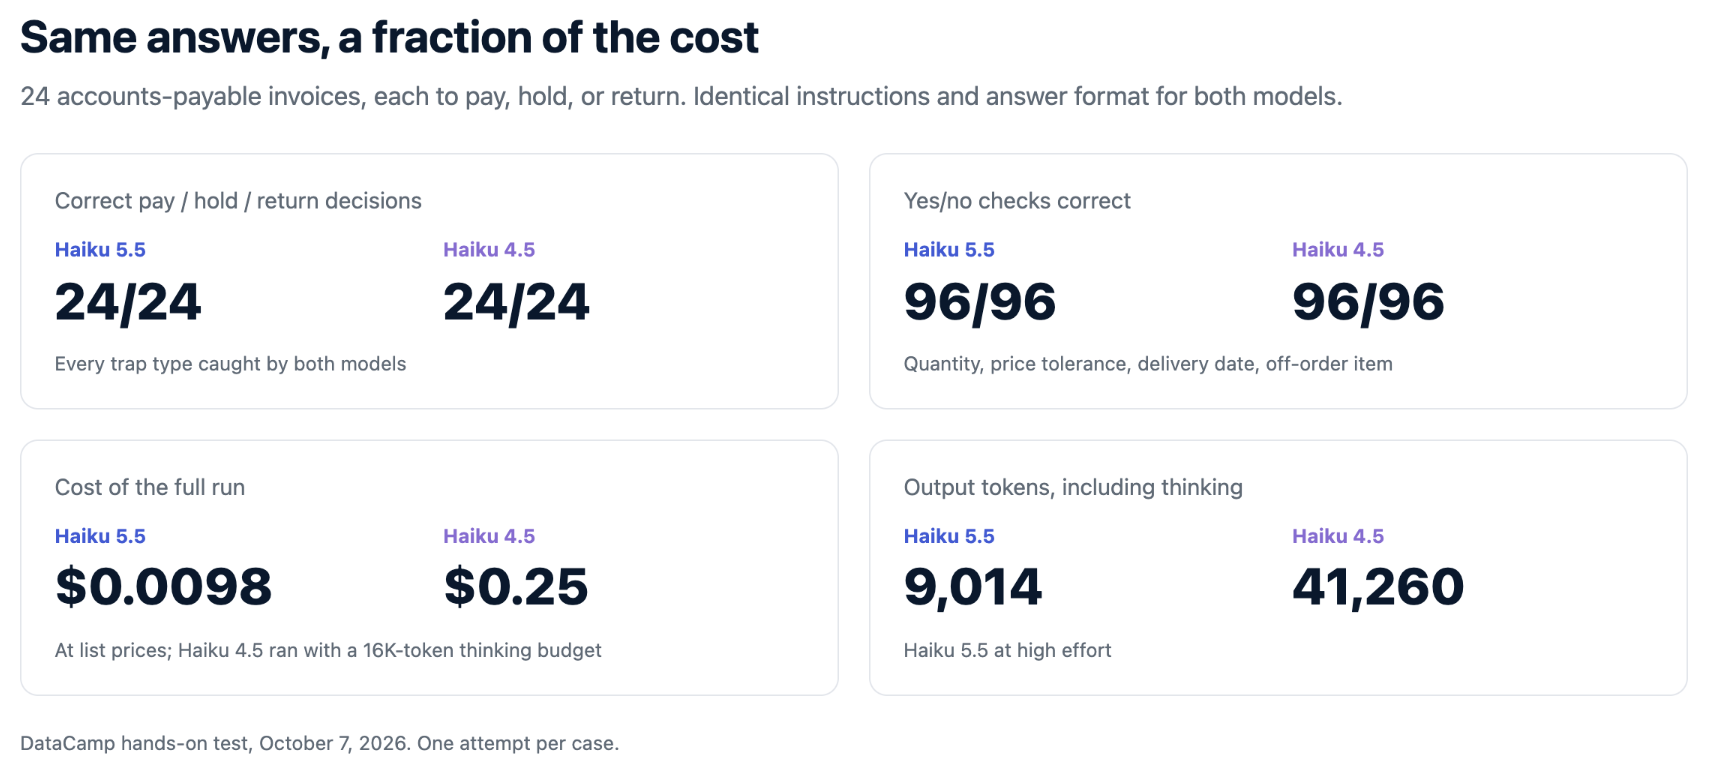
Claude Haiku 5.5 dan Haiku 4.5 sama-sama mencetak 24/24, tetapi run Haiku 5.5 berbiaya $0,0098 dibanding $0,25
Jadi apakah Haiku 5.5 benar-benar langkah maju? Tidak dalam akurasi di sini, karena Haiku 4.5 sudah sempurna. Jawabannya sama, lebih cepat, dengan biaya sangat kecil, dan untuk model yang dibangun untuk berjalan jutaan kali, itulah yang penting. Saya akan memastikan tes berikutnya memiliki jebakan yang lebih sulit.
Harga dan Ketersediaan Claude Haiku 5.5
Kita sudah paham bahwa Haiku 5.5 adalah opsi yang lebih ekonomis. Tetapi ada detail tambahan: Claude Haiku 5.5 dihargai dalam dua tingkat berdasarkan ukuran prompt. Prompt hingga 100.000 token membayar tarif rendah, dan prompt yang lebih besar membayar lima kali lipat.
| Tarif, per 1 juta token | Haiku 5.5 (prompt hingga 100K) | Haiku 5.5 (prompt di atas 100K) | Haiku 4.5 |
|---|---|---|---|
| Input | $0,10 | $0,50 | $1,00 |
| Output | $0,50 | $2,50 | $5,00 |
| Pembacaan cache | $0,01 | $0,05 | $0,10 |
| Penulisan cache (5 menit) | $0,125 | $0,625 | $1,25 |
Batch API memangkas 50% untuk input dan output. Token thinking ditagihkan sebagai output, sehingga pengaturan effort yang lebih tinggi berbiaya lebih mahal per permintaan.
Diskon label harga Haiku 5.5 dibanding Haiku 4.5 adalah 90% di bawah 100 ribu token, tetapi dua hal memperkecilnya dalam praktik. Tokenizer baru mengubah teks yang sama menjadi sekitar 30% lebih banyak token daripada Haiku 4.5, dan prompt di atas 100 ribu token membayar setengah tarif Haiku 4.5 alih-alih sepersepuluh. Keduanya membantu menjelaskan mengapa rata-rata Anthropic sendiri adalah "75% lebih murah" alih-alih 90%.
Anthropic juga menurunkan harga cache-read Claude Sonnet 5.5 menjadi $0,10 per satu juta token, dari $0,20, bersamaan dengan peluncuran ini. Haiku 5.5 tersedia secara umum, dan Anthropic berkomitmen untuk tidak menghentikannya sebelum 7 Oktober 2027.
Cara Mendapatkan Akses ke Claude Haiku 5.5?
Claude Haiku 5.5 tersedia di Claude API sebagai claude-haiku-5-5, di Amazon Bedrock sebagai anthropic.claude-haiku-5-5, dan di Google Cloud, Microsoft Foundry, serta Claude Platform di AWS dengan claude-haiku-5-5.
Berikut pemanggilan Python minimal. Adaptive thinking aktif secara default, jadi pilih blok teks berdasarkan tipe:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
Untuk penjelasan lengkap tentang key, biaya, dan proyek pertama Anda, lihat panduan lengkap Claude API kami, dan tutorial API Sonnet 5.5 untuk agen yang dapat Anda percayakan kepada subagen Haiku 5.5.
Pikiran Penutup
Jika Anda menjalankan klasifikasi, ekstraksi, atau pekerjaan subagen di Haiku 4.5, beralihlah ke Haiku 5.5 sekarang. Dalam uji kami, model ini memberikan jawaban yang sama lebih cepat dan jauh lebih murah. Jangan lupa sisihkan waktu untuk perubahan API yang bersifat breaking dan hitung ulang token Anda.
Saya akan mengatakan Haiku 5.5 memberikan tekanan langsung pada GPT-6 Luna dari OpenAI di segmen terbawah pasar. Untuk banyak trafik produksi, pertanyaannya bukan lagi apakah model kecil sudah cukup baik, melainkan pekerjaan mana yang masih memerlukan Sonnet.
Jika Anda ingin mempelajari lebih lanjut tentang membangun dengan model-model Anthropic, saya sarankan melihat kursus Introduction to Claude Models kami.