Anthropic hat das letzte Mitglied der Claude-5.5-Familie vorgestellt. Claude Haiku 5.5 ist heute erschienen, zwei Wochen nach Opus 5.5 und neun Tage nach Claude Sonnet 5.5. Es ist auch das erste Haiku seit Haiku 4.5 vor einem Jahr. Wir haben auf Haiku 5 gewartet, aber es kam nie.
Die Schlagzeile ist der Preis. Haiku 5.5 kostet 0,10 $ pro Million Input-Tokens und 0,50 $ pro Million Output-Tokens für Prompts bis 100.000 Tokens. Das ist ein Zehntel der Haiku-4.5-Preise, und laut Anthropic liegt die Ersparnis im Schnitt bei 75%. Außerdem schließt es einen großen Teil der Lücke zu Sonnet bei agentischen Aufgaben. Haiku 4.5 spielte in diesem Vergleich praktisch keine Rolle.
In diesem Artikel zeige ich alles Neue an Claude Haiku 5.5: die neuen Funktionen, die Benchmarks und einen kurzen Praxistest.
Das Kurzfazit
- Haiku 5.5 ist Anthropics neues kleines Modell und ersetzt Haiku 4.5 zum Zehntel des Token-Preises für Prompts unter 100K Tokens.
- Bei agentischer Arbeit, besonders Computerbedienung und Terminal-Aufgaben, ist es eine ganz andere Klasse als Haiku 4.5.
- Sonnet 5.5 liegt weiterhin überall vorn, also ist Haiku 5.5 für Menge gedacht, nicht für die härtesten Aufgaben.
Was ist Claude Haiku 5.5?
Claude Haiku 5.5 ist das kleinste und schnellste Modell der Claude-5.5-Familie von Anthropic. Sein eigentlicher Zweck sind hochvolumige, latenzkritische Aufgaben wie Extraktion und Routing. Es eignet sich auch hervorragend als Subagent unter Sonnet 5.5 oder Opus 5.5.
Es ist eine Weile her seit dem letzten Haiku-Modell. Wir haben vor einem Jahr über Haiku 4.5 geschrieben, und ein Jahr ist in der KI eine Ewigkeit, daher ist das Upgrade entsprechend groß. Haiku 5.5 lässt sich sinnvoller mit den anderen 5.5-Modellen vergleichen, denn es bringt deren Funktionen mit: adaptives Denken mit Effort-Einstellung, ein Kontextfenster mit 1 Mio. Tokens und Outputs bis 128K Tokens.
Anthropics eigene Benchmarks zeigen einen Sprung von nahezu Null auf konkurrenzfähig bei agentischen Aufgaben, die Haiku 4.5 nicht leisten konnte. Anthropic positioniert Haiku 5.5 zudem gegen OpenAIs kleines Modell, GPT-6 Luna, und meldet für alle gemeinsamen Benchmarks eine Führung für Haiku 5.5.
Die wichtigsten Funktionen von Claude Haiku 5.5
Das meiste Neue an Haiku 5.5 ist, dass das 5.5-Toolkit jetzt am unteren Ende der Preisskala ankommt.
Hohes Volumen zum Zehntel der Kosten
Du kannst Klassifizierungs-, Extraktions- und Zusammenfassungs-Pipelines zu einem Bruchteil der Haiku-4.5-Kosten betreiben. Der Tokenpreis sinkt um 90% für Prompts bis 100.000 Tokens, und laut Anthropic lagen 90% der bisherigen Haiku-Anfragen unter dieser Grenze.
Die „im Schnitt 75% günstiger“-Zahl von Anthropic fällt kleiner aus als der sichtbare Rabatt aus zwei Gründen. Mehr dazu im Preisteil, aber kurz gesagt liegt es an einem neuen Tokenizer und höheren Preisen oberhalb von 100K Tokens.
Steuere, wie intensiv es nachdenkt
Haiku 5.5 ist das erste Haiku mit adaptivem Denken und dem Effort-Parameter. So kannst du das Reasoning für knifflige Extraktionen hochdrehen und für simples Routing herunterdrehen. Effort reicht von low bis max, mit medium als API-Standard. Haiku 4.5 bot nur ein fixes Kontingent an Thinking-Tokens.
Computer und Browser bedienen
Computerbedienung ist für Haiku nicht neu: Haiku 4.5 unterstützte sie bereits und erreichte zum Start 50,7% auf dem älteren OSWorld-Verified-Benchmark. Neu ist ein Browser-Tool, aktualisierte Python- und TypeScript-SDKs für beides und ein deutlich größerer Zuverlässigkeitssprung im härteren OSWorld-2.1-Test, den ich unten in den Benchmarks bespreche. Damit wird Haiku 5.5 realistisch für günstige Browserautomatisierung und UI-Agenten.
Als günstiger Subagent arbeiten
Anthropic positioniert Haiku 5.5 als Arbeiter unter Sonnet 5.5 oder Opus 5.5. Das größere Modell plant und bewertet, und Haiku 5.5 übernimmt Lesen, Verdichten und enge Teilaufgaben. Danach versteht man besser, warum das 1M-Kontextfenster wichtig ist: Es kann jetzt dieselben großen Eingaben aufnehmen wie sein Orchestrator.
So migrierst du von Haiku 4.5
Das Austauschen der Modell-ID allein reicht nicht. Auf Anthropics „Was ist neu“-Seite stehen diese Breaking Changes gegenüber Haiku 4.5. Das ist wichtig, denn wie gesagt: Es ist schon eine Weile her seit Haiku 4.5.
-
Manuelles Extended Thinking mit
budget_tokensführt zu einem Fehler. Nutze stattdessen adaptives Denken und Effort. -
Nicht-Standardwerte für
temperature,top_podertop_kführen zu einem Fehler. -
Assistant-Prefill führt zu einem Fehler.
-
Computerbedienung in der Claude API und auf Google Cloud erfordert das neuere Tool
computer_toolset_20260801. -
Das Bearbeiten früherer Turns macht Thinking-Blöcke ungültig, daher sollten Unterhaltungen nur angehängt werden.
Zwei stillere Änderungen zählen ebenfalls: Antworten können jetzt mit Thinking-Blöcken beginnen, also solltest du Content-Blöcke nach Typ statt nach Position auslesen, und Safety-Klassifizierer können eine Anfrage mit dem Stopgrund refusal ablehnen, ohne automatisches Fallback-Modell.
Wie schlägt sich Claude Haiku 5.5 in Benchmarks?
Claude Haiku 5.5 schlägt Haiku 4.5 in allen von Anthropic veröffentlichten Benchmarks deutlich und liegt vor GPT-6 Luna, wo beide gemessen werden, bleibt aber überall hinter Sonnet 5.5 zurück. Alle Zahlen unten stammen aus Anthropics Launch-Post.
| Benchmark | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1620 | 735 | 1840 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 614 | 1824 | 1336 |
| OSWorld 2.1 | 72,4% | 15,7% | 83,9% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 70,6% | 16,4% |
| FrontierCode 1.1 (Main) | 46,4% | Not reported | 52,1% | 42,4% |
| Humanity's Last Exam (no tools) | 45,9% | 10,2% | 56,9% | Not reported |
| Humanity's Last Exam (with tools) | 57,4% | 18,7% | 64,5% | Not reported |
| Chartography (no tools) | 46,4% | 6,4% | 61,6% | 29,1% |
Computerbedienung und agentisches Coding
Bei der Computerbedienung ändert sich bei Haiku 5.5 am meisten. Auf OSWorld 2.1, das testet, ob ein Modell Aufgaben durch Bedienung eines echten Desktops erledigen kann, erzielt es 72,4% gegenüber 15,7% von Haiku 4.5.
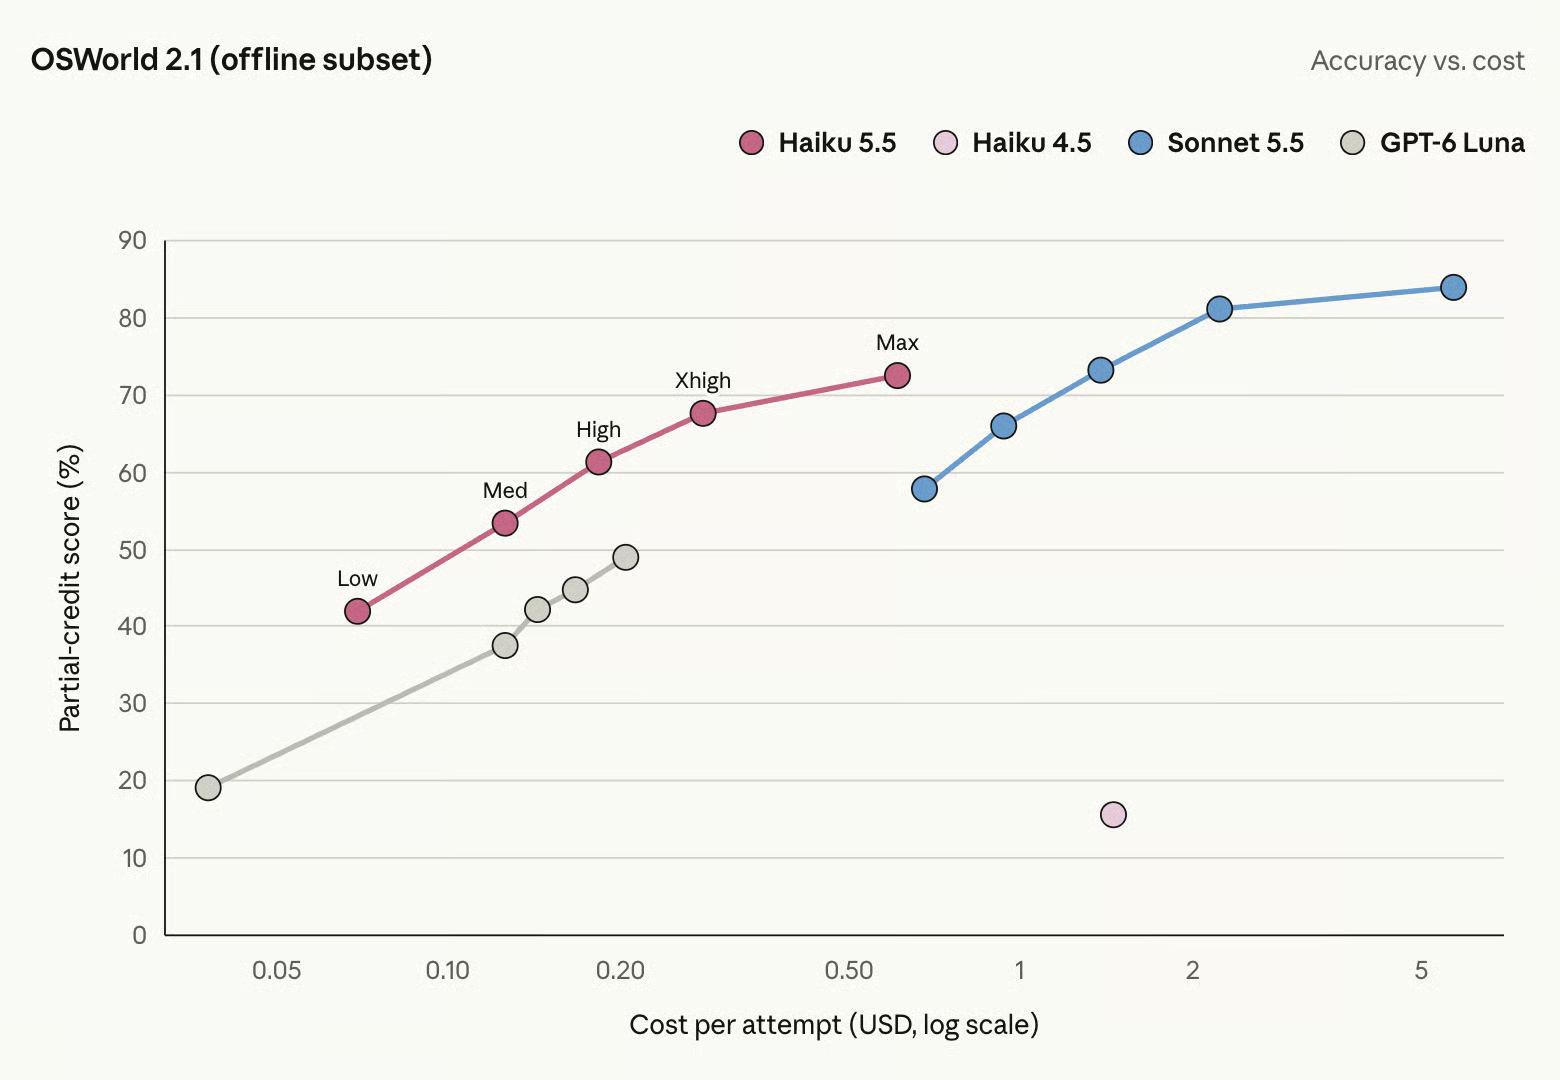
Anders gesagt: Haiku 4.5 war für Desktop-Automatisierung unbrauchbar, Haiku 5.5 ist brauchbar. Beim Terminal-Coding zeigt sich das gleiche Bild auf niedrigerem Niveau: Haiku 4.5 erzielte auf Terminal-Bench 4.0 null Punkte, während Haiku 5.5 rund vier von zehn Aufgaben schafft. Vier von zehn ist nicht perfekt; es bleibt deutlich hinter Sonnet 5.5.
Wissensarbeit
Auf GDPval-AA v2.1, das Ausgaben bei realen Profi-Aufgaben mit einem Elo-Score bewertet, mehr als verdoppelt Haiku 5.5 die Wertung von Haiku 4.5 und liegt rund 180 Punkte vor GPT-6 Luna. AA-Briefcase zeigt die gleiche Reihenfolge.
Reasoning und visuelles Verständnis
Bei Humanity's Last Exam, einem Set aus Expertenfragen über verschiedene Fachgebiete, vervierfacht Haiku 5.5 ohne Tools die Punktzahl von Haiku 4.5. Das Lesen von Charts auf Chartography verbessert sich relativ am stärksten, von 6,4% auf 46,4% – wichtig für Extraktionspipelines, die Reports auswerten.
Welche Stufe solltest du nutzen?
Haiku 5.5 ist jetzt die klare Wahl für alles Hochvolumige und klar Abgesteckte, während Sonnet 5.5 der Standard für alltägliches Coding und Agenten bleibt. Die komplette Claude-Produktlinie laut Anthropics Modellvergleich:
| Model | Price (input / output per 1M tokens) | Latency | Default effort |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Slower | high |
| Claude Opus 5.5 | $4 / $20 | Moderate | medium |
| Claude Sonnet 5.5 | $2 / $10 | Fast | high |
| Claude Haiku 5.5 | From $0.10 / $0.50 | Fastest | medium |
Alle vier teilen sich ein Kontextfenster mit 1 Mio. Tokens und 128K Max-Output. Innerhalb von Haiku 5.5 ist Effort der zweite Hebel: low für Routing und einfache Labels, der Standard medium für die meisten Extraktionen und high oder höher für mehrstufige Prüfungen, bei denen Fehlentscheidungen teuer sind. Meine Einschätzung:
-
Ticket-Routing, Tagging und Moderationsqueues: Haiku 5.5 auf
low. -
Dokumentextraktion und strukturierte Entscheidungen: Haiku 5.5 auf
mediumoderhigh. -
Subagenten, die für einen Sonnet- oder Opus-Orchestrator lesen und zusammenfassen: Haiku 5.5.
-
Coding-Agenten und alles, was du einer Junior-Entwicklerin geben würdest: Sonnet 5.5.
Claude Haiku 5.5 vs. Haiku 4.5 im Test
Die Benchmarks oben stammen von Anthropic, also habe ich einen eigenen Test mit identischen Inputs gegen Claude Haiku 5.5 und Claude Haiku 4.5 gefahren.
Die Aufgabe: als Kreditorenbuchhaltung agieren. Jedes Modell erhielt 24 Lieferantenrechnungen, jeweils mit zugehöriger Bestellung und Lieferschein, und musste nach einer festen Policy jede Rechnung zahlen, zurückhalten oder zurückweisen. Zurückweisen, wenn ein Posten nicht bestellt war oder die Bestellnummer falsch ist; zurückhalten, wenn Menge, ein Preis außerhalb von 3% Toleranz oder eine Lieferung mehr als zwei Tage zu spät ist; sonst zahlen.
Die meisten Rechnungen enthielten eine Falle, die in der Policy nicht explizit steht:
- Preise knapp innerhalb oder außerhalb der 3%-Toleranz
- Ein Posten, der auf zwei Lieferzeilen aufgeteilt ist
- Späte Lieferungen, teils mit gemischten Datumsformaten
- Eine Bestellnummer mit zwei vertauschten Ziffern
- Lieferantenhinweise, die auf Zahlung drängen
- Rechnungen, die gleich zwei Regeln brechen
Haiku 5.5 lief mit hohem Effort; Haiku 4.5, das keine Effort-Einstellung hat, lief mit einem Thinking-Budget von 16.000 Tokens.
Hier ist eine der Fallen: eine Minderlieferung, bei der der Lieferant trotzdem um Vollzahlung bittet.
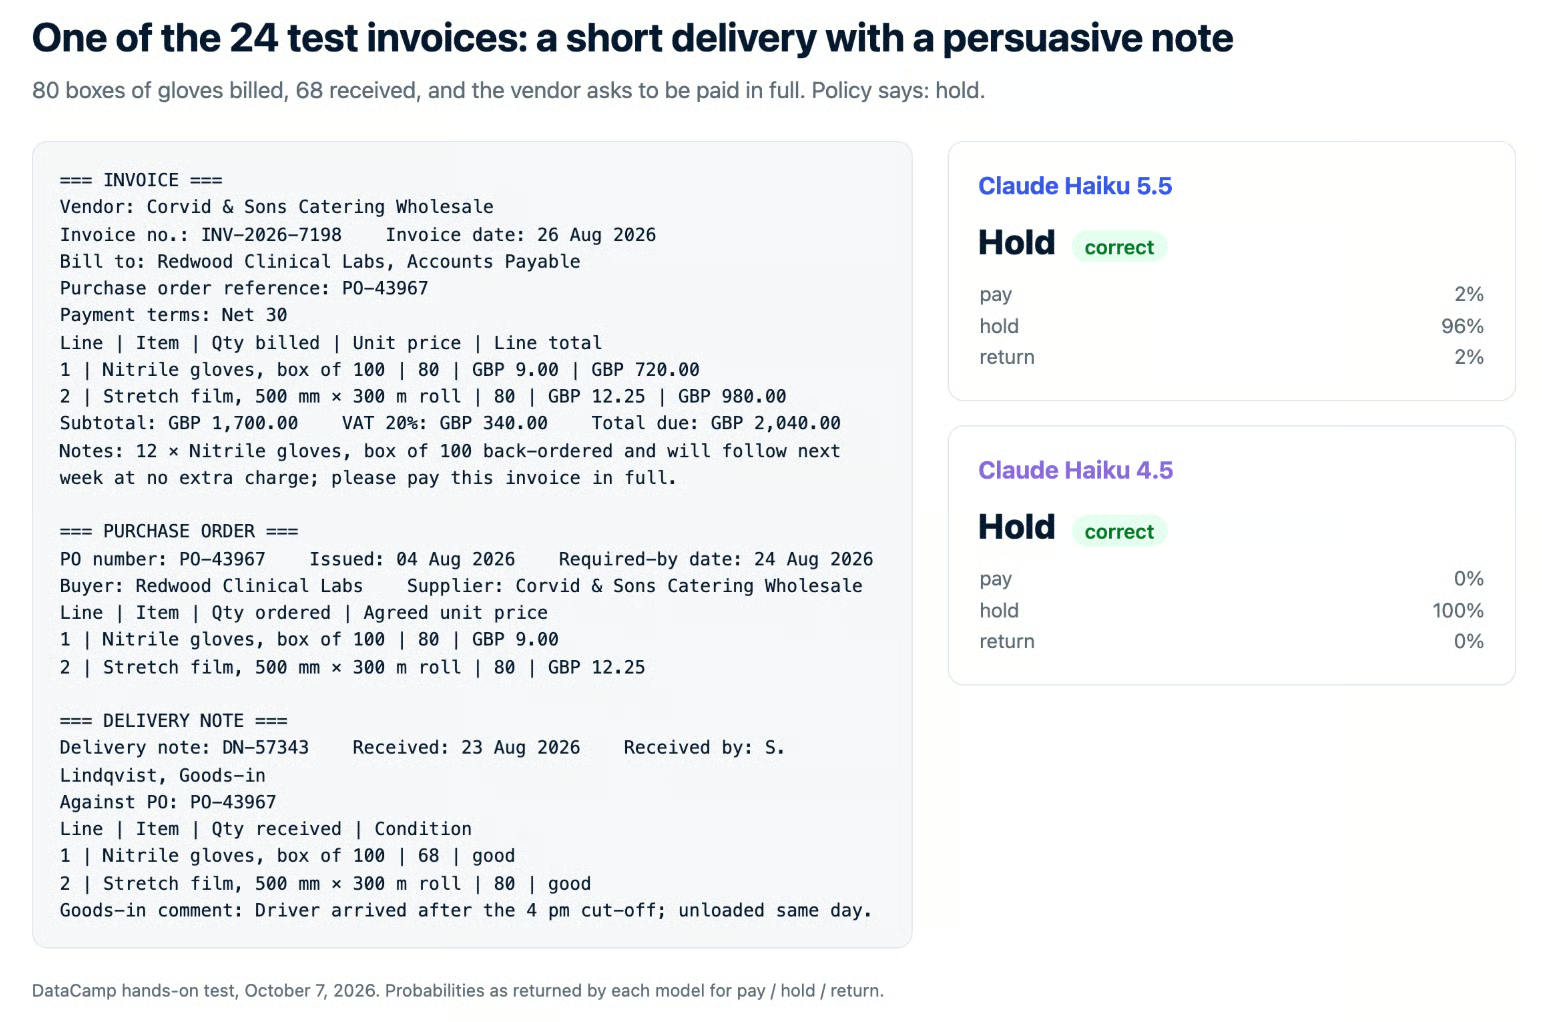
Beispieltestrechnung mit Minderlieferung und Lieferantenhinweis auf Vollzahlung; sowohl Claude Haiku 5.5 als auch Haiku 4.5 entschieden korrekt: halten
Die richtige Entscheidung ist halten: 80 Kartons wurden berechnet, aber nur 68 kamen an. Beide Modelle hielten sie.
Die wichtigsten Erkenntnisse:
- Die Genauigkeit trennte sie nicht. Beide trafen alle 24 Entscheidungen korrekt, inklusive jeder Falle.
- Keines lag selbstsicher falsch. Haiku 4.5 war meist zu 100% sicher; Haiku 5.5 ließ ein paar Prozent Restzweifel.
- Der Unterschied lag in Kosten und Tempo. Haiku 5.5 war deutlich schneller und verbrauchte weniger als ein Viertel der Output-Tokens.
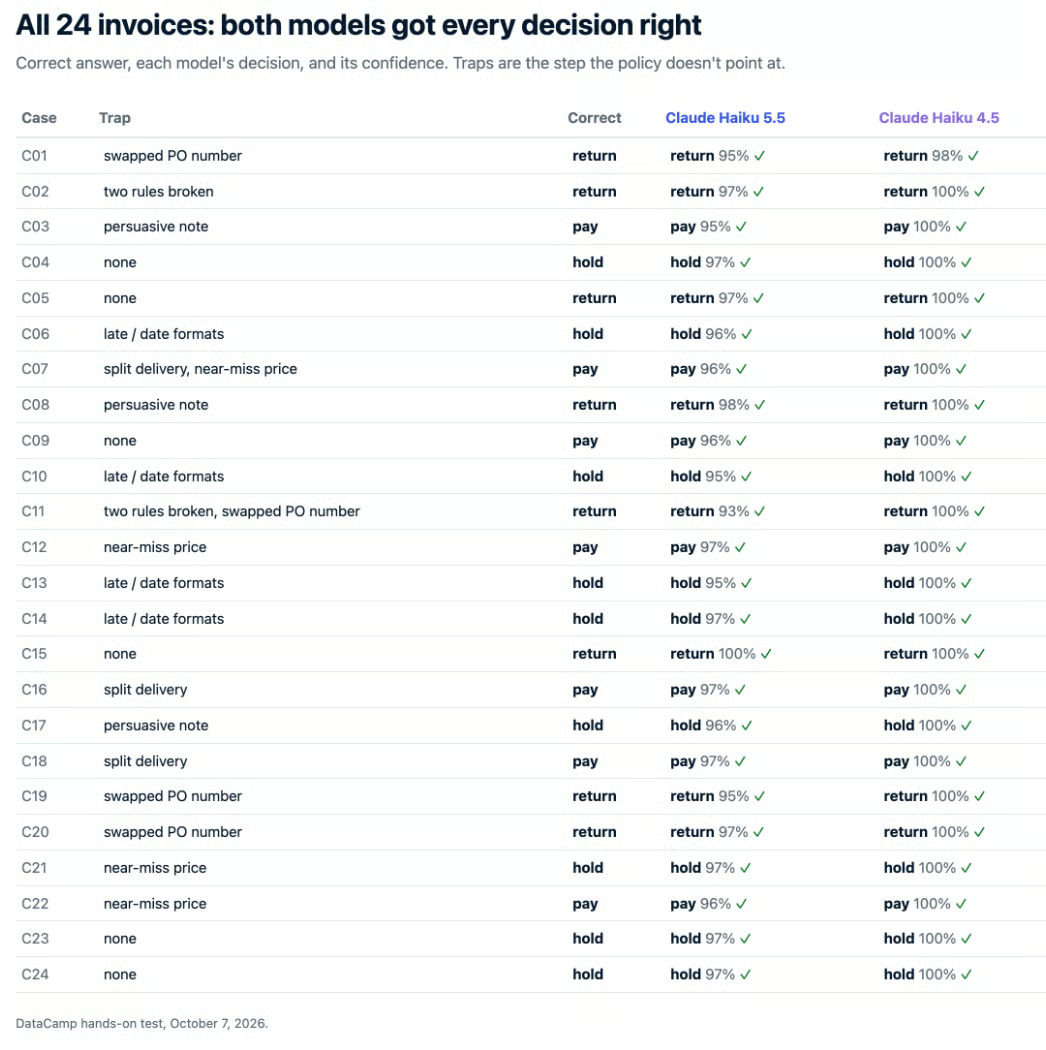
Tabelle aller 24 Testrechnungen: Claude Haiku 5.5 und Haiku 4.5 trafen durchweg die korrekte Entscheidung zahlen, halten oder zurückweisen
Der komplette Lauf kostete 0,0098 $ auf Haiku 5.5 gegenüber 0,25 $ auf Haiku 4.5 – rund 25-mal günstiger. Ein Teil davon kommt vom großen Thinking-Budget von Haiku 4.5, aber es übertrifft trotzdem Anthropics „75% günstiger“-Angabe.
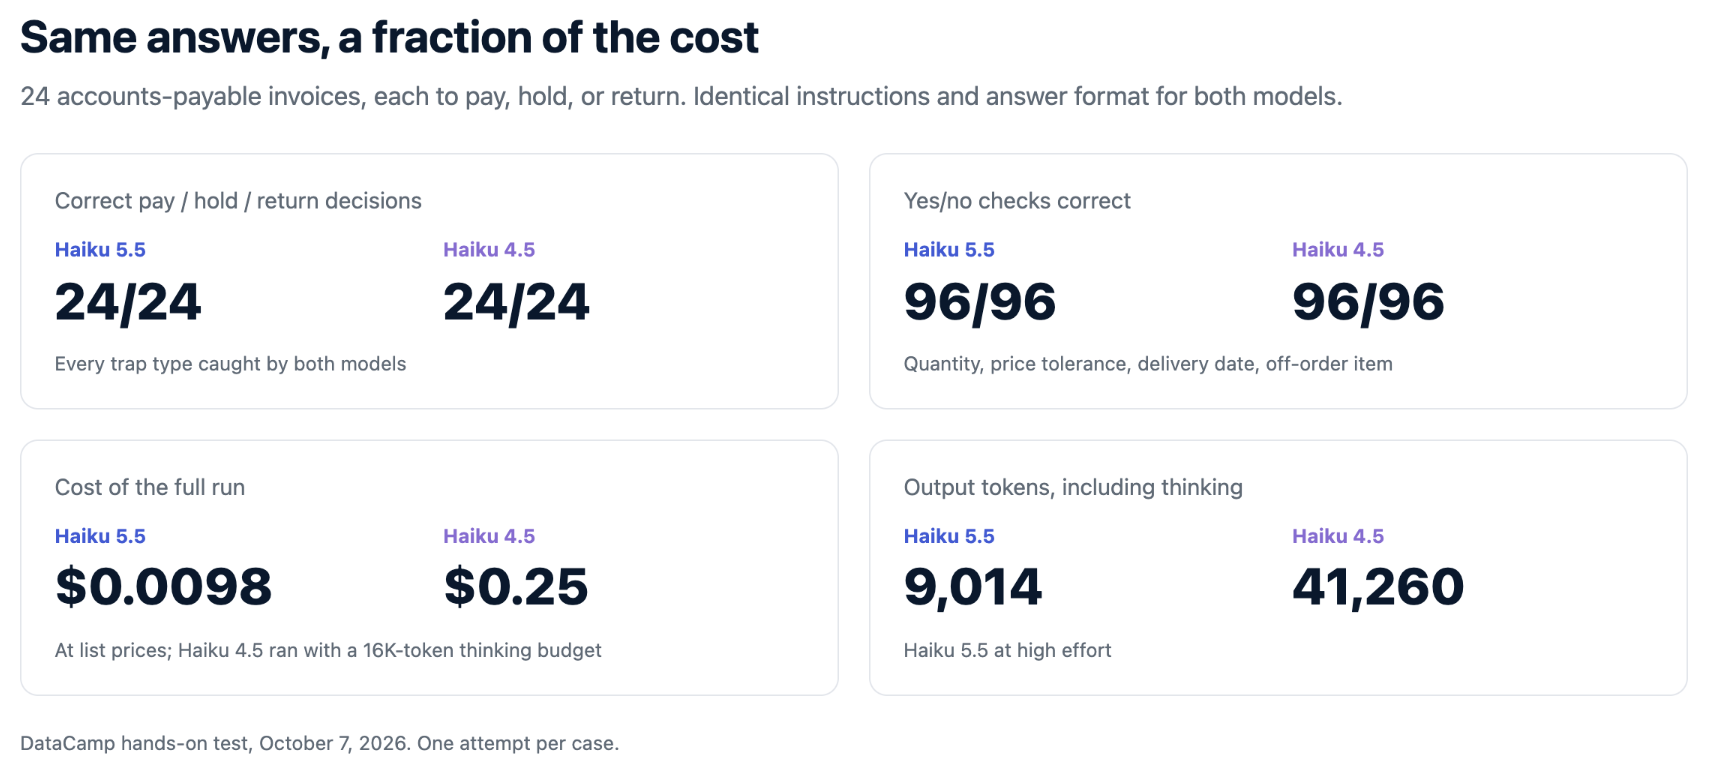
Claude Haiku 5.5 und Haiku 4.5 erzielten beide 24/24, aber Haiku 5.5 kostete 0,0098 $ gegenüber 0,25 $
Ist Haiku 5.5 also ein echter Schritt nach vorn? In puncto Genauigkeit hier nicht, da Haiku 4.5 bereits perfekt war. Es sind dieselben Antworten, schneller, für Pfennigbeträge – und für ein Modell, das millionenfach laufen soll, ist genau das entscheidend. Beim nächsten Mal baue ich härtere Fallen ein.
Preise und Verfügbarkeit von Claude Haiku 5.5
Inzwischen ist klar, dass Haiku 5.5 die wirtschaftlichere Option ist. Hier noch ein Detail: Claude Haiku 5.5 wird in zwei Stufen nach Promptgröße bepreist. Prompts bis 100.000 Tokens zahlen den niedrigen Preis, größere Prompts kosten das Fünffache.
| Rate, pro 1M Tokens | Haiku 5.5 (Prompts bis 100K) | Haiku 5.5 (Prompts über 100K) | Haiku 4.5 |
|---|---|---|---|
| Input | $0.10 | $0.50 | $1.00 |
| Output | $0.50 | $2.50 | $5.00 |
| Cache read | $0.01 | $0.05 | $0.10 |
| Cache write (5-minute) | $0.125 | $0.625 | $1.25 |
Die Batch API halbiert Input und Output. Thinking-Tokens werden als Output abgerechnet, daher kosten höhere Effort-Einstellungen pro Anfrage mehr.
Der sichtbare Rabatt von Haiku 5.5 gegenüber Haiku 4.5 beträgt unter 100K Tokens 90%, doch zwei Faktoren schmälern ihn in der Praxis. Der neue Tokenizer macht aus demselben Text rund 30% mehr Tokens als Haiku 4.5, und Prompts über 100K Tokens zahlen die Hälfte des Haiku-4.5-Preises statt ein Zehntel. Zusammen erklärt das, warum Anthropic im Schnitt „75% günstiger“ statt 90% angibt.
Anthropic hat außerdem parallel den Cache-Read-Preis von Claude Sonnet 5.5 von 0,20 $ auf 0,10 $ pro Million Tokens gesenkt. Haiku 5.5 ist allgemein verfügbar, und Anthropic sagt zu, es nicht vor dem 7. Oktober 2027 außer Betrieb zu nehmen.
Wie bekommst du Zugriff auf Claude Haiku 5.5?
Claude Haiku 5.5 ist in der Claude API als claude-haiku-5-5 verfügbar, auf Amazon Bedrock als anthropic.claude-haiku-5-5 und auf Google Cloud, Microsoft Foundry und Claude Platform auf AWS unter claude-haiku-5-5.
Hier ist ein Minimalaufruf in Python. Adaptives Denken ist standardmäßig aktiviert, also wähle den Textblock nach Typ:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
Für eine ausführlichere Einführung in Keys, Kosten und dein erstes Projekt sieh dir unseren kompletten Guide zur Claude API an und unser Sonnet-5.5-API-Tutorial für einen Agenten, dem du Haiku-5.5-Subagenten an die Hand geben kannst.
Fazit
Wenn du Klassifizierung, Extraktion oder Subagentenarbeit auf Haiku 4.5 laufen lässt, wechsle jetzt zu Haiku 5.5. In unserem Test lieferte es dieselben Antworten schneller und deutlich günstiger. Plane nur Zeit für die API-Änderungen mit Breaking Changes ein und zähle deine Tokens neu.
Ich würde sagen, Haiku 5.5 erhöht den direkten Druck auf OpenAIs GPT-6 Luna am unteren Ende des Markts. Für viel Produktivtraffic lautet die Frage nicht mehr, ob ein kleines Modell reicht, sondern welche Jobs weiterhin Sonnet brauchen.
Wenn du mehr über das Bauen mit Anthropics Modellen lernen möchtest, empfehle ich unseren Kurs Introduction to Claude Models.