Anthropic가 Claude 5.5 제품군의 마지막 퍼즐을 맞췄습니다. Claude Haiku 5.5가 오늘 출시되었으며, Opus 5.5 이후 2주, Claude Sonnet 5.5 이후 9일 만입니다. 또한 1년 전 Haiku 4.5 이후 처음 나오는 Haiku입니다. 우리는 Haiku 5를 기다렸지만 끝내 나오지 않았습니다.
핵심은 가격입니다. Haiku 5.5는 최대 100,000토큰 프롬프트에 대해 입력 토큰 100만 개당 $0.10, 출력 토큰 100만 개당 $0.50가 듭니다. Haiku 4.5 요금의 10분의 1이며, Anthropic은 평균 75% 저렴하다고 말합니다. 또한 에이전트형 작업에서 Sonnet과의 격차를 상당 부분 줄였습니다. 그 비교에서 Haiku 4.5는 논외였습니다.
이 글에서는 Claude Haiku 5.5의 새로운 점을 모두 살펴보고, 새로운 기능과 벤치마크를 정리한 뒤, 직접 테스트로 성능을 점검해 보겠습니다.
한눈에 보기
- Haiku 5.5는 Anthropic의 새 소형 모델로, 100K 토큰 이하 프롬프트에서 토큰당 가격이 Haiku 4.5의 10분의 1입니다.
- 에이전트형 작업, 특히 컴퓨터 사용과 터미널 작업에서 Haiku 4.5와는 다른 급의 모델입니다.
- 여전히 모든 영역에서 Sonnet 5.5가 앞서므로, Haiku 5.5는 고난도 과제용이 아니라 대량 처리용입니다.
Claude Haiku 5.5란?
Claude Haiku 5.5는 Anthropic의 Claude 5.5 제품군 중 가장 작고 가장 빠른 모델입니다. 핵심 목적은 추출과 라우팅처럼 대량 처리와 지연에 민감한 작업입니다. Sonnet 5.5나 Opus 5.5 아래의 서브에이전트로도 훌륭히 작동할 것입니다.
마지막 Haiku 모델 이후 시간이 꽤 흘렀습니다. 우리가 Haiku 4.5를 다룬 지 1년이 되었고, AI에서 1년은 매우 긴 시간이라 Haiku 4.5에서의 업그레이드는 대대적입니다. Haiku 5.5는 더 큰 5.5 모델들이 가진 기능을 가져오면서 비교 대상으로는 동세대 5.5가 더 적절합니다. 예컨대 노력 강도를 설정할 수 있는 적응형 사고, 100만 토큰 콘텍스트 윈도우, 128K 토큰 출력 등이 포함됩니다.
Anthropic의 자체 벤치마크에 따르면 Haiku 4.5가 못 하던 에이전트형 작업에서 거의 제로에 가깝던 성능이 경쟁 수준으로 올라섰습니다. Anthropic은 Haiku 5.5를 OpenAI의 소형 모델인 GPT-6 Luna와도 비교하며, 공통으로 보고된 모든 벤치마크에서 Haiku 5.5가 앞선다고 밝혔습니다.
Claude Haiku 5.5의 핵심 기능
Haiku 5.5의 대부분의 새로움은 5.5 제품군의 툴킷이 가격대 가장 아래로 내려왔다는 점입니다.
10분의 1 가격으로 대량 작업 실행
분류, 추출, 요약 파이프라인을 Haiku 4.5 대비 극히 낮은 비용으로 돌릴 수 있습니다. 100,000토큰까지의 프롬프트에서 토큰당 요금이 90% 하락하며, Anthropic은 이전 Haiku 요청의 90%가 그 범위 안에 든다고 말합니다.
Anthropic의 "평균 75% 저렴" 수치는 라벨 할인보다 작습니다. 자세한 내용은 가격 섹션에서 다루겠지만, 새로운 토크나이저와 100K 토큰 초과 구간의 더 높은 요금 때문이라는 점을 먼저 알아두세요.
생각의 강도를 제어
Haiku 5.5는 노력 매개변수가 있는 적응형 사고를 최초로 도입한 Haiku입니다. 까다로운 추출에는 추론을 올리고, 단순 라우팅에는 내릴 수 있습니다. 노력 강도는 low부터 max까지이며, API 기본값은 medium입니다. Haiku 4.5는 고정된 사고 토큰 예산만 제공했습니다.
컴퓨터와 브라우저 조작
컴퓨터 사용 자체가 Haiku에 처음은 아닙니다. Haiku 4.5도 이를 지원했고 출시 당시 구형 OSWorld-Verified 벤치마크에서 50.7%를 기록했습니다. 새로워진 점은 브라우저 사용 도구, 양자를 위한 Python과 TypeScript SDK 업데이트, 그리고 아래 벤치마크 섹션에서 다루는 더 어려운 OSWorld 2.1 테스트에서의 신뢰성 대폭 향상입니다. 덕분에 Haiku 5.5는 저렴한 브라우저 자동화와 UI 에이전트에 현실적인 선택지가 되었습니다.
저렴한 서브에이전트로 동작
Anthropic은 Haiku 5.5를 Sonnet 5.5나 Opus 5.5 아래에서 일하는 워커로 제안합니다. 더 큰 모델이 계획하고 평가하면, Haiku 5.5가 읽기, 압축, 좁은 하위 과제를 담당합니다. 이를 읽고 나면 100만 토큰 콘텍스트 윈도우가 왜 중요한지도 더 명확해집니다. 오케스트레이터와 같은 대용량 입력을 그대로 받을 수 있기 때문입니다.
Haiku 4.5에서 어떻게 마이그레이션하나요
모델 ID만 바꾸면 충분하지 않습니다. Anthropic의 "What's new" 페이지에는 Haiku 4.5 대비 다음과 같은 변경 사항이 호환성을 깨뜨린다고 안내합니다. 말씀드렸듯 Haiku 4.5 이후 시간이 꽤 흘렀으니 주의 깊게 보시길 권합니다.
-
budget_tokens로 수동 확장 사고를 요청하면 오류가 납니다. 대신 적응형 사고와 노력 강도를 사용하세요. -
기본값이 아닌
temperature,top_p,top_k값은 오류를 반환합니다. -
Assistant 메시지 프리필은 오류를 반환합니다.
-
Claude API와 Google Cloud에서의 컴퓨터 사용은 더 새로운
computer_toolset_20260801도구가 필요합니다. -
이전 턴을 수정하면 사고 블록이 무효화되어, 대화는 추가만 가능한 방식이어야 합니다.
덜 눈에 띄는 두 가지 변경도 중요합니다. 이제 응답이 사고 블록으로 시작할 수 있으므로, 위치가 아니라 유형별로 콘텐츠 블록을 읽어야 합니다. 또한 안전 분류기가 refusal 중지 사유로 요청을 거부할 수 있으며, 자동 폴백 모델은 없습니다.
Claude Haiku 5.5의 벤치마크 성능은?
Claude Haiku 5.5는 Anthropic이 공개한 모든 벤치마크에서 Haiku 4.5를 큰 폭으로 앞서며, 공통 보고된 지표에서는 GPT-6 Luna보다도 앞섭니다. 다만 모든 항목에서 Sonnet 5.5에는 못 미칩니다. 아래 수치는 모두 Anthropic의 출시 글에서 인용했습니다.
| 벤치마크 | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1620 | 735 | 1840 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 614 | 1824 | 1336 |
| OSWorld 2.1 | 72.4% | 15.7% | 83.9% | 48.9% |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 70.6% | 16.4% |
| FrontierCode 1.1 (Main) | 46.4% | Not reported | 52.1% | 42.4% |
| Humanity's Last Exam (no tools) | 45.9% | 10.2% | 56.9% | Not reported |
| Humanity's Last Exam (with tools) | 57.4% | 18.7% | 64.5% | Not reported |
| Chartography (no tools) | 46.4% | 6.4% | 61.6% | 29.1% |
컴퓨터 사용과 에이전트형 코딩
컴퓨터 사용은 Haiku 5.5에서 가장 큰 변화가 있었습니다. 실제 데스크톱을 조작해 작업을 완수할 수 있는지를 평가하는 OSWorld 2.1에서 Haiku 5.5는 72.4%를 기록해 Haiku 4.5의 15.7%를 크게 상회했습니다.
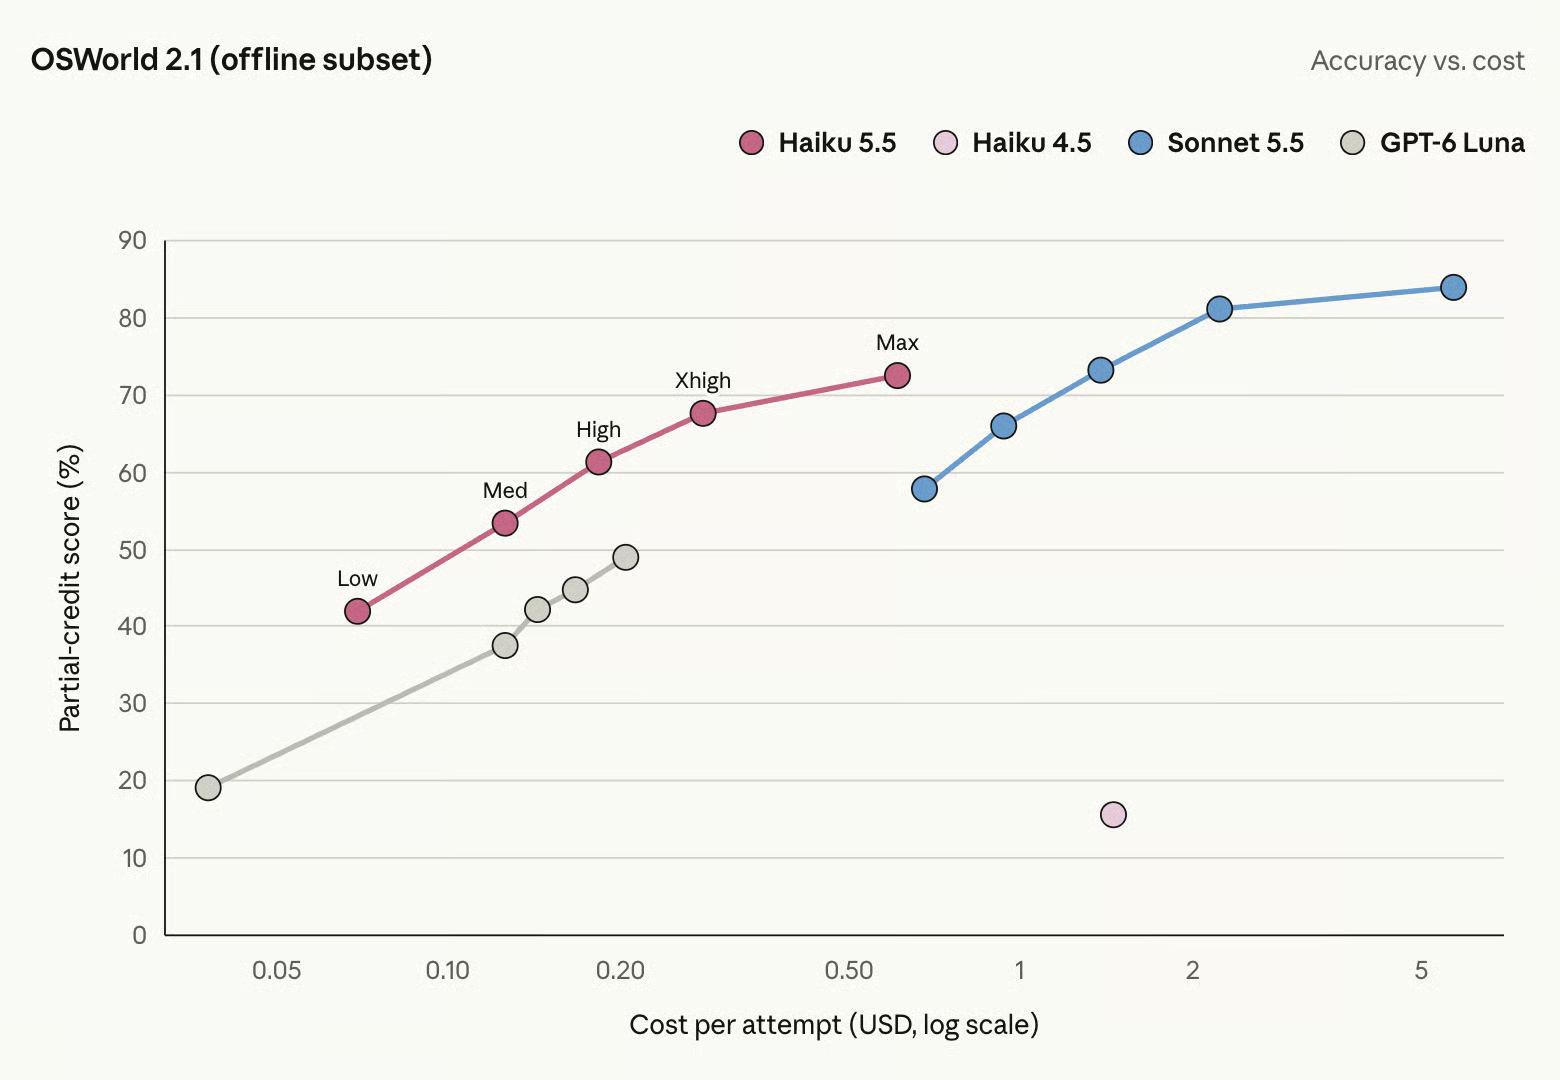
다시 말해, Haiku 4.5는 데스크톱 자동화에 쓸모가 없었지만 Haiku 5.5는 실사용 가능합니다. 터미널 코딩도 같은 이야기를 더 낮은 수준에서 보여줍니다. Haiku 4.5는 Terminal-Bench 4.0에서 0점을 기록한 반면, Haiku 5.5는 열 개 중 약 네 개의 작업을 완료합니다. 네 개 중 하나꼴은 완벽과는 거리가 있으며, 여전히 Sonnet 5.5에는 미치지 못합니다.
지식 작업
실제 전문 업무 결과물을 Elo 스타일 점수로 평가하는 GDPval-AA v2.1에서 Haiku 5.5는 Haiku 4.5의 점수를 두 배 이상 끌어올리고 GPT-6 Luna보다 약 180점 앞서 마칩니다. AA-Briefcase도 같은 순위를 보입니다.
추론과 시각 이해
Humanity's Last Exam은 학술 분야 전반의 전문가 수준 질문으로 구성되어 있는데, Haiku 5.5는 도구 없이도 Haiku 4.5의 점수를 네 배 이상 끌어올렸습니다. 보고서 읽기에 중요한 차트 해석(Chartography)은 6.4%에서 46.4%로 상대적으로 가장 큰 폭으로 개선되어, 보고서를 읽는 추출 파이프라인에 의미가 큽니다.
어떤 티어를 써야 할까요?
Haiku 5.5는 이제 대량 처리이면서 문제 범위가 명확한 작업에 가장 적합합니다. 일상적인 코딩과 에이전트는 여전히 Sonnet 5.5가 기본입니다. Anthropic의 모델 비교 표 기준 전체 Claude 라인업은 다음과 같습니다.
| 모델 | 가격 (입력 / 출력, 100만 토큰당) | 지연 | 기본 노력 강도 |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | 더 느림 | high |
| Claude Opus 5.5 | $4 / $20 | 보통 | medium |
| Claude Sonnet 5.5 | $2 / $10 | 빠름 | high |
| Claude Haiku 5.5 | From $0.10 / $0.50 | 가장 빠름 | medium |
네 모델 모두 100만 토큰 콘텍스트 윈도우와 최대 128K 출력이 동일합니다. Haiku 5.5 내부에서는 노력 강도가 두 번째 레버입니다. 라우팅과 단순 라벨에는 low, 대부분의 추출에는 기본값 medium, 오판 비용이 큰 다단계 점검에는 high 이상을 권합니다. 제 생각은 다음과 같습니다.
-
티켓 라우팅, 태깅, 모더레이션 큐: Haiku 5.5의
low. -
문서 추출과 구조적 의사결정: Haiku 5.5의
medium또는high. -
Sonnet 또는 Opus 오케스트레이터를 위한 읽기/요약 서브에이전트: Haiku 5.5.
-
코딩 에이전트 및 주니어 엔지니어에게 맡길 법한 작업: Sonnet 5.5.
Claude Haiku 5.5 vs. Haiku 4.5 테스트
위 벤치마크는 Anthropic 자체 수치이므로, 동일 입력으로 Claude Haiku 5.5와 Claude Haiku 4.5를 상대로 테스트 하나를 직접 진행했습니다.
과제: 매입 채무 계정으로 행동하기. 두 모델 모두에게 24개의 공급업체 송장을 해당 구매 주문서와 납품서와 함께 제공하고, 고정 정책에 따라 각 송장을 지불(pay), 보류(hold), 반송(return)해야 했습니다. 주문에 없는 품목이 있거나 주문 번호가 틀리면 반송, 수량 또는 3% 허용오차를 넘는 가격 또는 2일 이상 지연 납품이면 보류, 그 외에는 지불.
대부분의 송장에는 정책이 직접 언급하지 않는 함정이 숨어 있었습니다.
- 3% 허용오차의 경계 안팎에 걸친 가격
- 한 품목이 두 개의 납품 라인으로 분할
- 지연 납품(일부는 날짜 형식 혼재)
- 두 자리가 바뀐 주문 번호
- 지급을 주장하는 공급업체 메모
- 두 가지 규칙을 동시에 위반한 송장
Haiku 5.5는 높은 노력 강도로, 노력 설정이 없는 Haiku 4.5는 16,000 토큰 사고 예산으로 실행했습니다.
다음은 함정 중 하나입니다. 납품 수량이 부족하지만 공급업체가 전액 지급을 요구하는 사례입니다.
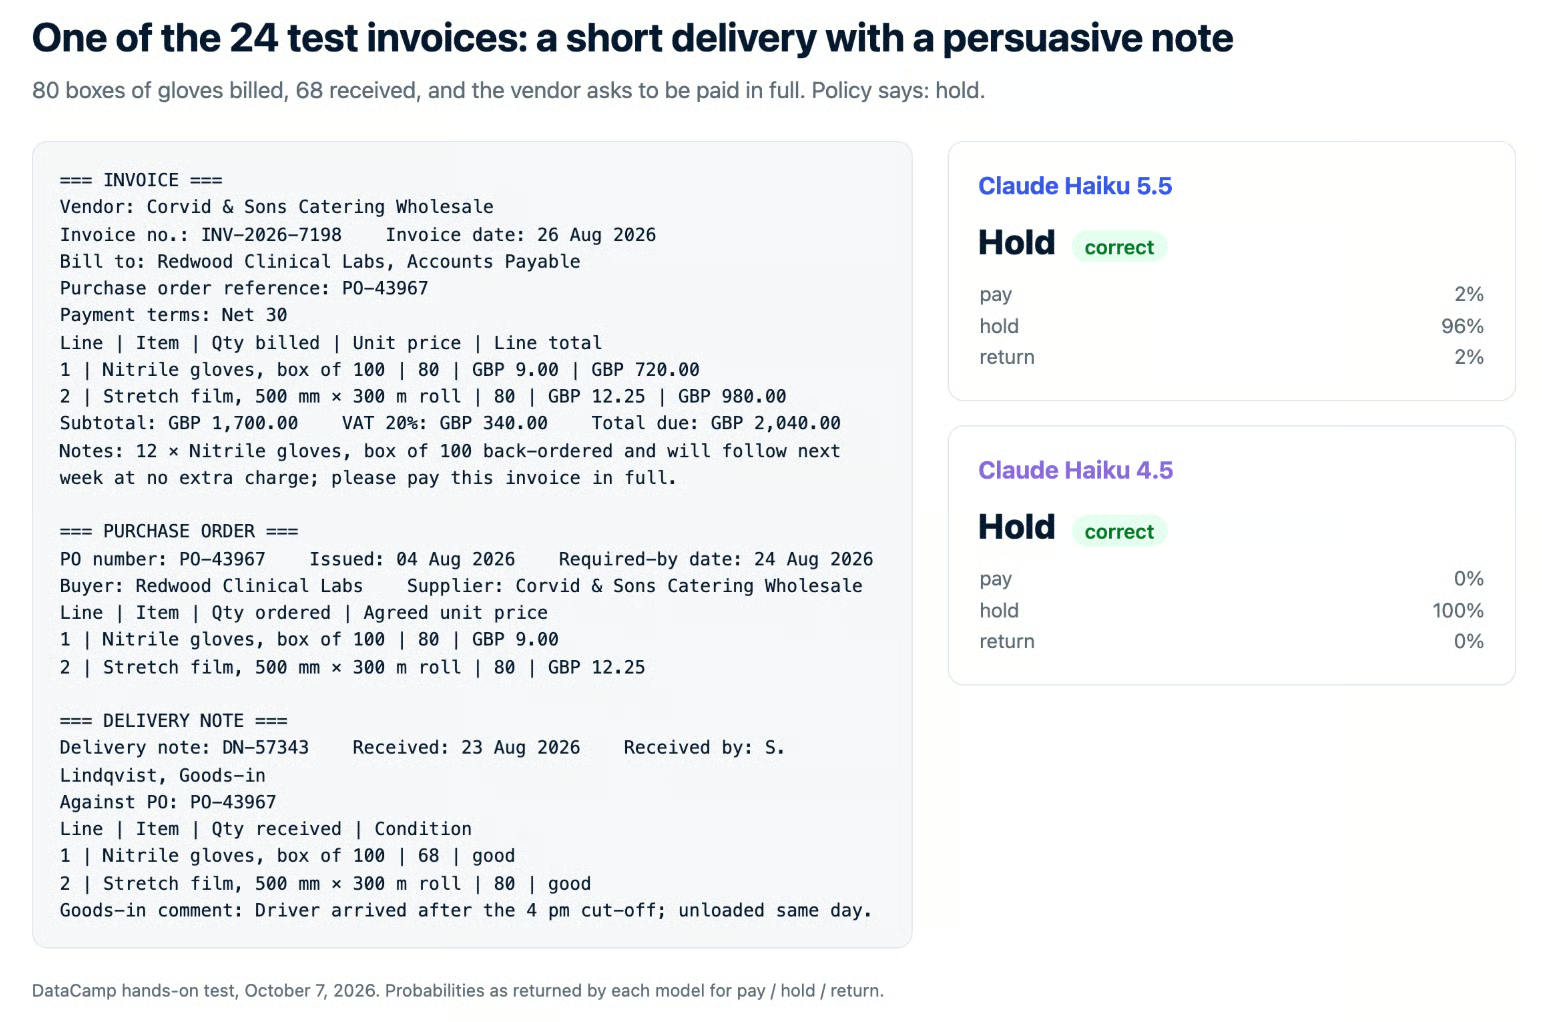
납품 수량이 부족하지만 전액 지급을 요구하는 예시 테스트 송장; Claude Haiku 5.5와 Haiku 4.5 모두 정답인 보류로 응답
정답은 보류입니다. 80박스를 청구했지만 68박스만 도착했습니다. 두 모델 모두 보류했습니다.
주요 결과:
- 정확도는 둘을 가르지 못했습니다. 두 모델 모두 24건 전부를 맞혔고, 모든 함정을 잡았습니다.
- 둘 다 자신만만하게 틀리진 않았습니다. Haiku 4.5는 대개 확신이 100%였고, Haiku 5.5는 몇 퍼센트의 여지를 남겼습니다.
- 차이는 비용과 속도였습니다. Haiku 5.5가 훨씬 빨랐고 출력 토큰을 4분의 1 이하만 사용했습니다.
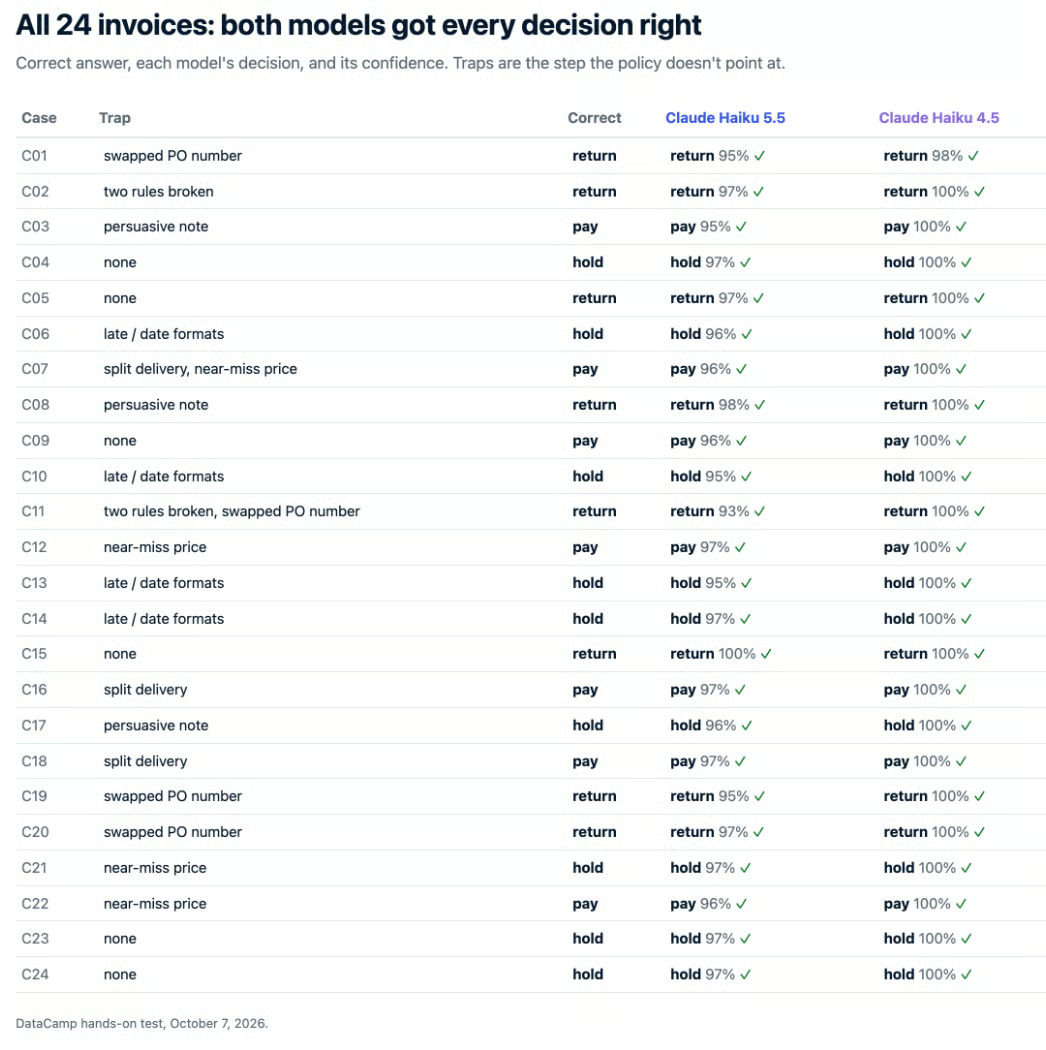
24개 테스트 송장 전체 표: Claude Haiku 5.5와 Haiku 4.5 모두 지불/보류/반송 결정을 정확히 선택
전체 실행 비용은 Haiku 5.5에서 $0.0098, Haiku 4.5에서 $0.25로 약 25배 저렴했습니다. 일부는 Haiku 4.5의 큰 사고 예산 때문이지만, 그래도 Anthropic의 "75% 저렴" 주장보다 더 큰 차이입니다.
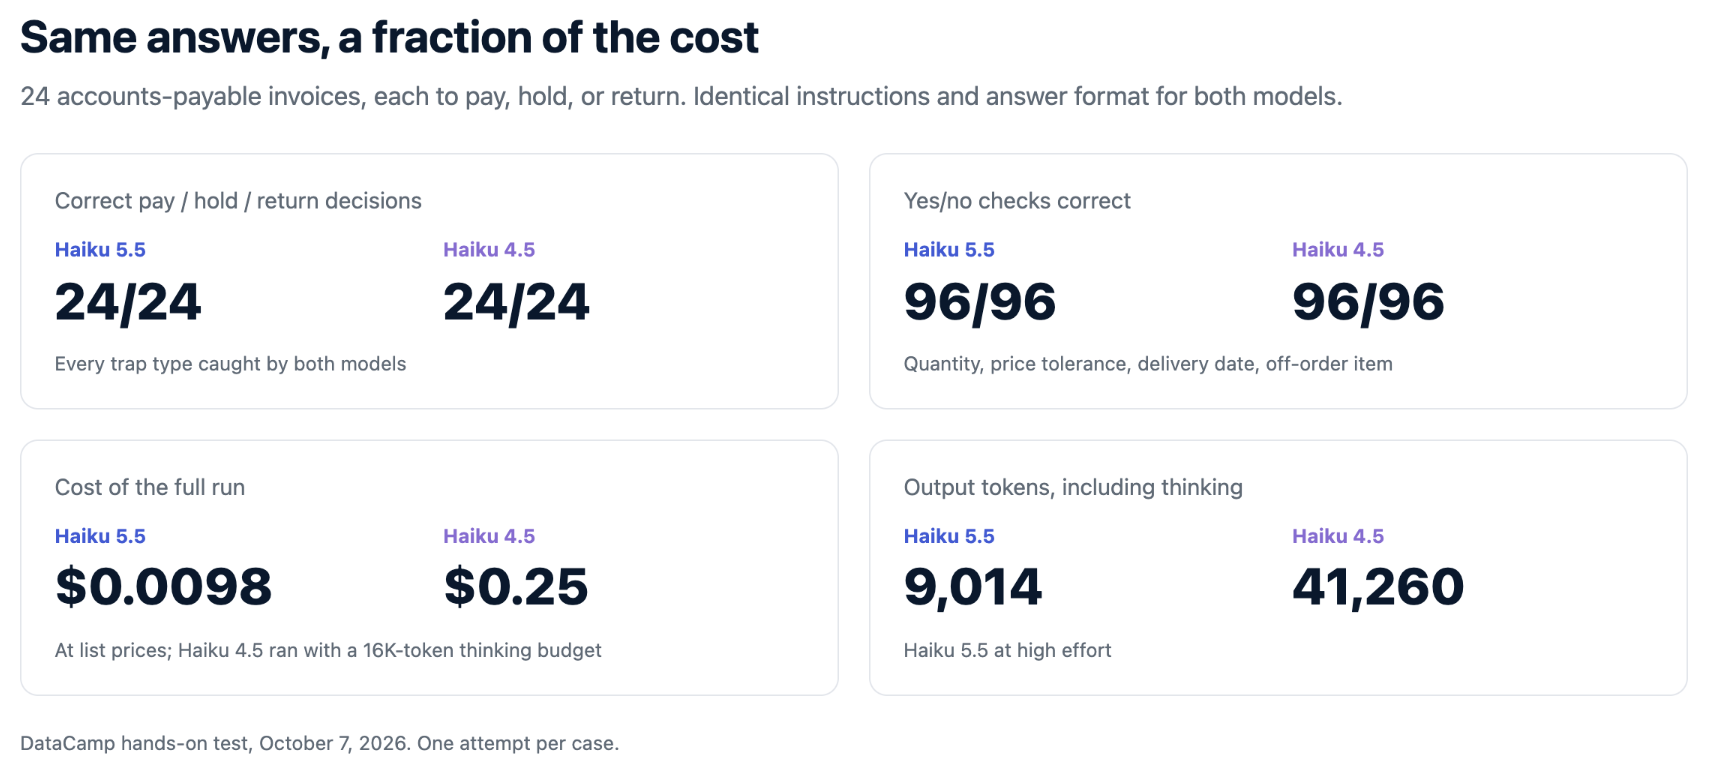
Claude Haiku 5.5와 Haiku 4.5 모두 24/24를 기록했지만, Haiku 5.5는 $0.0098, Haiku 4.5는 $0.25
그렇다면 Haiku 5.5가 진짜로 한 단계 올라선 걸까요? 여기서는 정확도 면에서 아니었습니다. Haiku 4.5가 이미 완벽했기 때문입니다. 같은 답을 더 빠르게, 몇 푼으로 내놓습니다. 수백만 번 실행하도록 설계된 모델에 중요한 건 바로 이것이죠. 다음번에는 더 어려운 함정으로 테스트하겠습니다.
Claude Haiku 5.5 가격과 제공 여부
이제 Haiku 5.5가 더 경제적인 선택이라는 점은 충분히 이해하셨을 겁니다. 추가로, Claude Haiku 5.5는 프롬프트 크기에 따라 두 단계 가격을 적용합니다. 100,000토큰 이하 프롬프트는 낮은 요금, 더 큰 프롬프트는 다섯 배 요금을 냅니다.
| 요율 (100만 토큰당) | Haiku 5.5 (100K 이하 프롬프트) | Haiku 5.5 (100K 초과 프롬프트) | Haiku 4.5 |
|---|---|---|---|
| 입력 | $0.10 | $0.50 | $1.00 |
| 출력 | $0.50 | $2.50 | $5.00 |
| 캐시 읽기 | $0.01 | $0.05 | $0.10 |
| 캐시 쓰기 (5분) | $0.125 | $0.625 | $1.25 |
Batch API는 입력과 출력 요금을 50% 할인합니다. 사고 토큰은 출력으로 청구되므로, 노력 강도를 올리면 요청당 비용이 증가합니다.
Haiku 5.5의 라벨 대비 Haiku 4.5의 할인율은 100K 토큰 이하에서 90%지만, 실제 절감폭을 줄이는 두 가지가 있습니다. 새로운 토크나이저는 동일한 텍스트를 Haiku 4.5보다 약 30% 더 많은 토큰으로 분할하고, 100K 토큰을 초과하는 프롬프트는 10분의 1이 아니라 절반 요금을 냅니다. 이 둘이 합쳐져 Anthropic이 평균을 "90%가 아닌 75% 저렴"으로 제시한 이유를 설명해 줍니다.
또한 이번 출시와 함께 Anthropic은 Claude Sonnet 5.5의 캐시 읽기 가격을 100만 토큰당 $0.20에서 $0.10으로 낮췄습니다. Haiku 5.5는 일반 제공 중이며, Anthropic은 2027년 10월 7일 이전에 이를 단종하지 않겠다고 약속했습니다.
Claude Haiku 5.5 액세스 방법
Claude Haiku 5.5는 Claude API에서 claude-haiku-5-5, Amazon Bedrock에서 anthropic.claude-haiku-5-5, Google Cloud, Microsoft Foundry, AWS의 Claude Platform에서는 claude-haiku-5-5로 제공됩니다.
다음은 최소한의 Python 호출 예시입니다. 적응형 사고는 기본 활성화되어 있으니, 유형별로 텍스트 블록을 선택하세요.
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
키, 비용, 첫 프로젝트까지 자세한 안내는 Claude API 완벽 가이드와, Haiku 5.5 서브에이전트를 붙일 수 있는 에이전트를 다룬 Sonnet 5.5 API 튜토리얼을 참고하세요.
마무리
Haiku 4.5로 분류, 추출, 서브에이전트 작업을 돌리고 계시다면 지금 Haiku 5.5로 전환하세요. 우리의 테스트에서 같은 답을 더 빠르고 훨씬 저렴하게 냈습니다. 다만 호환성 변경에 대비해 시간을 확보하고, 토큰을 다시 계산하는 것을 잊지 마세요.
Haiku 5.5는 시장 하단에서 OpenAI의 GPT-6 Luna에 직접 압박을 가한다고 보입니다. 많은 프로덕션 트래픽에서 이제 질문은 "소형 모델이 충분한가?"가 아니라, "어떤 작업이 여전히 Sonnet을 필요로 하는가?"입니다.
Anthropic 모델로 빌드하는 방법을 더 배우고 싶다면 Introduction to Claude Models 코스를 추천합니다.