Anthropic har gjort det sista tillskottet till sin Claude 5.5-familj. Claude Haiku 5.5 kom idag, två veckor efter Opus 5.5 och nio dagar efter Claude Sonnet 5.5. Det är också den första Haiku sedan Haiku 4.5 för ett år sedan. Vi väntade på Haiku 5, men den kom aldrig.
Rubriken är priset. Haiku 5.5 kostar 0,10 USD per miljon indata-token och 0,50 USD per miljon utdata-token för promptar upp till 100 000 token. Det är en tiondel av Haiku 4.5:s priser, och Anthropic säger att det landar 75% billigare i genomsnitt. Den minskar också mycket av gapet till Sonnet för agentiskt arbete. Haiku 4.5 var inte ens med i diskussionen i den jämförelsen.
I den här artikeln går jag igenom allt som är nytt med Claude Haiku 5.5, tittar på de nya funktionerna, utforskar benchmarkresultaten och låter den dessutom visa vad den går för i ett praktiskt test.
Snabbversionen
- Haiku 5.5 är Anthropics nya lilla modell som ersätter Haiku 4.5 till en tiondel av priset per token för promptar under 100K token.
- Det är en annan klass av modell än Haiku 4.5 för agentiskt arbete, särskilt datoranvändning och terminaluppgifter.
- Sonnet 5.5 leder fortfarande överallt, så Haiku 5.5 är för volym, inte för dina svåraste uppgifter.
Vad är Claude Haiku 5.5?
Claude Haiku 5.5 är den minsta och snabbaste modellen i Anthropics Claude 5.5-familj. Dess egentliga syfte är högvolymigt, latenskänsligt arbete som extraktion och dirigering. Den lär också fungera utmärkt som underagent under Sonnet 5.5 eller Opus 5.5.
Det var ett tag sedan senaste Haiku-modellen. Vi skrev om Haiku 4.5 för ett år sedan, och eftersom ett år är väldigt länge i AI-världen är uppgraderingen från Haiku 4.5 betydande. Haiku 5.5 jämförs egentligen bättre med de andra 5.5-modellerna eftersom den tar med funktioner från de större 5.5-modellerna, inklusive adaptivt tänkande med en effort-inställning, ett kontextfönster på 1M token och 128K token i utdata.
Anthropics egna benchmarkresultat visar att den går från nära noll till konkurrenskraftig på agentiska uppgifter som Haiku 4.5 inte klarade. Anthropic positionerar också Haiku 5.5 mot OpenAIs lilla modell, GPT-6 Luna, och rapporterar Haiku 5.5 före på varje benchmark där båda finns med.
Viktiga funktioner i Claude Haiku 5.5
Det mesta som är nytt i Haiku 5.5 är att 5.5-familjens verktygslåda nu kommer längst ned på prisskalan.
Kör hög volym till en tiondel av priset
Du kan köra klassificerings-, extraktions- och summeringspipelines till en bråkdel av vad Haiku 4.5 kostade. Priset per token sjunker 90% för promptar upp till 100 000 token, och Anthropic säger att 90% av tidigare Haiku-förfrågningar låg under den gränsen.
Anthropics siffra "75% billigare i genomsnitt" är lägre än listnedsättningen av två skäl. Jag går in mer på detta i prissektionen, men kort sagt beror det på en ny tokenizer och en högre taxa över 100K token.
Styr hur hårt den tänker
Haiku 5.5 är den första Haiku med adaptivt tänkande och parameter för effort, så att du kan skruva upp resonemanget för knepiga extraktioner och ner för enkel dirigering. Effort går från low till max, med medium som standard i API:t. Haiku 4.5 erbjöd bara en fast budget för tänkande-token.
Styra datorer och webbläsare
Datoranvändning är inte nytt för Haiku: Haiku 4.5 stödde det och fick 50,7% på den äldre OSWorld-Verified-benchmarken vid lansering. Nytt är ett verktyg för webbläsaranvändning, uppdaterade Python- och TypeScript-SDK:er för båda, och ett betydligt större hopp i tillförlitlighet på det svårare OSWorld 2.1-testet, vilket jag täcker i benchmarksektionen nedan. Det gör Haiku 5.5 till ett realistiskt alternativ för billig webbläsarautomation och UI-agenter.
Arbeta som en billig underagent
Anthropic lanserar Haiku 5.5 som arbetshästen under Sonnet 5.5 eller Opus 5.5. Den större modellen planerar och bedömer, och Haiku 5.5 sköter läsning, komprimering och snäva deluppgifter. Efter att ha läst detta förstår vi bättre varför kontextfönstret på 1M token är viktigt: den kan nu ta in samma stora indata som dess orkestrerare ser.
Hur migrerar du från Haiku 4.5
Att bara byta modell-ID räcker inte. Anthropics "Nyheter"-sida listar dessa brytande ändringar jämfört med Haiku 4.5. Det här är värt att uppmärksamma, för som sagt, det var ett tag sedan Haiku 4.5.
-
Manuellt utökat tänkande med
budget_tokensger ett fel. Använd adaptivt tänkande och effort i stället. -
Icke-standardvärden för
temperature,top_pellertop_kger ett fel. -
Förifyllning av assistentmeddelande ger ett fel.
-
Datoranvändning på Claude API och Google Cloud kräver det nyare verktyget
computer_toolset_20260801. -
Att redigera tidigare turer ogiltigförklarar thinking-block, så konversationer bör vara append-only.
Två tystare ändringar spelar också roll: svar kan nu börja med thinking-block, så läs innehållsblock efter typ snarare än position, och säkerhetsklassificerare kan avböja en förfrågan med stopporsaken refusal, utan automatisk fallback-modell.
Hur presterar Claude Haiku 5.5 på benchmarktester?
Claude Haiku 5.5 slår Haiku 4.5 med bred marginal på varje benchmark som Anthropic publicerade och ligger före GPT-6 Luna där båda rapporteras, men den ligger efter Sonnet 5.5 på allihop. Alla siffror nedan kommer från Anthropics lanseringsinlägg.
| Benchmark | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1620 | 735 | 1840 | 1437 |
| AA-Briefcase v1.1 (Elo) | 1578 | 614 | 1824 | 1336 |
| OSWorld 2.1 | 72,4% | 15,7% | 83,9% | 48,9% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 70,6% | 16,4% |
| FrontierCode 1.1 (Main) | 46,4% | Not reported | 52,1% | 42,4% |
| Humanity's Last Exam (utan verktyg) | 45,9% | 10,2% | 56,9% | Not reported |
| Humanity's Last Exam (med verktyg) | 57,4% | 18,7% | 64,5% | Not reported |
| Chartography (utan verktyg) | 46,4% | 6,4% | 61,6% | 29,1% |
Datoranvändning och agentisk kodning
Datoranvändning är där Haiku 5.5 förändras mest. På OSWorld 2.1, som testar om en modell kan slutföra uppgifter genom att styra ett riktigt skrivbord, får den 72,4% jämfört med Haiku 4.5:s 15,7%.
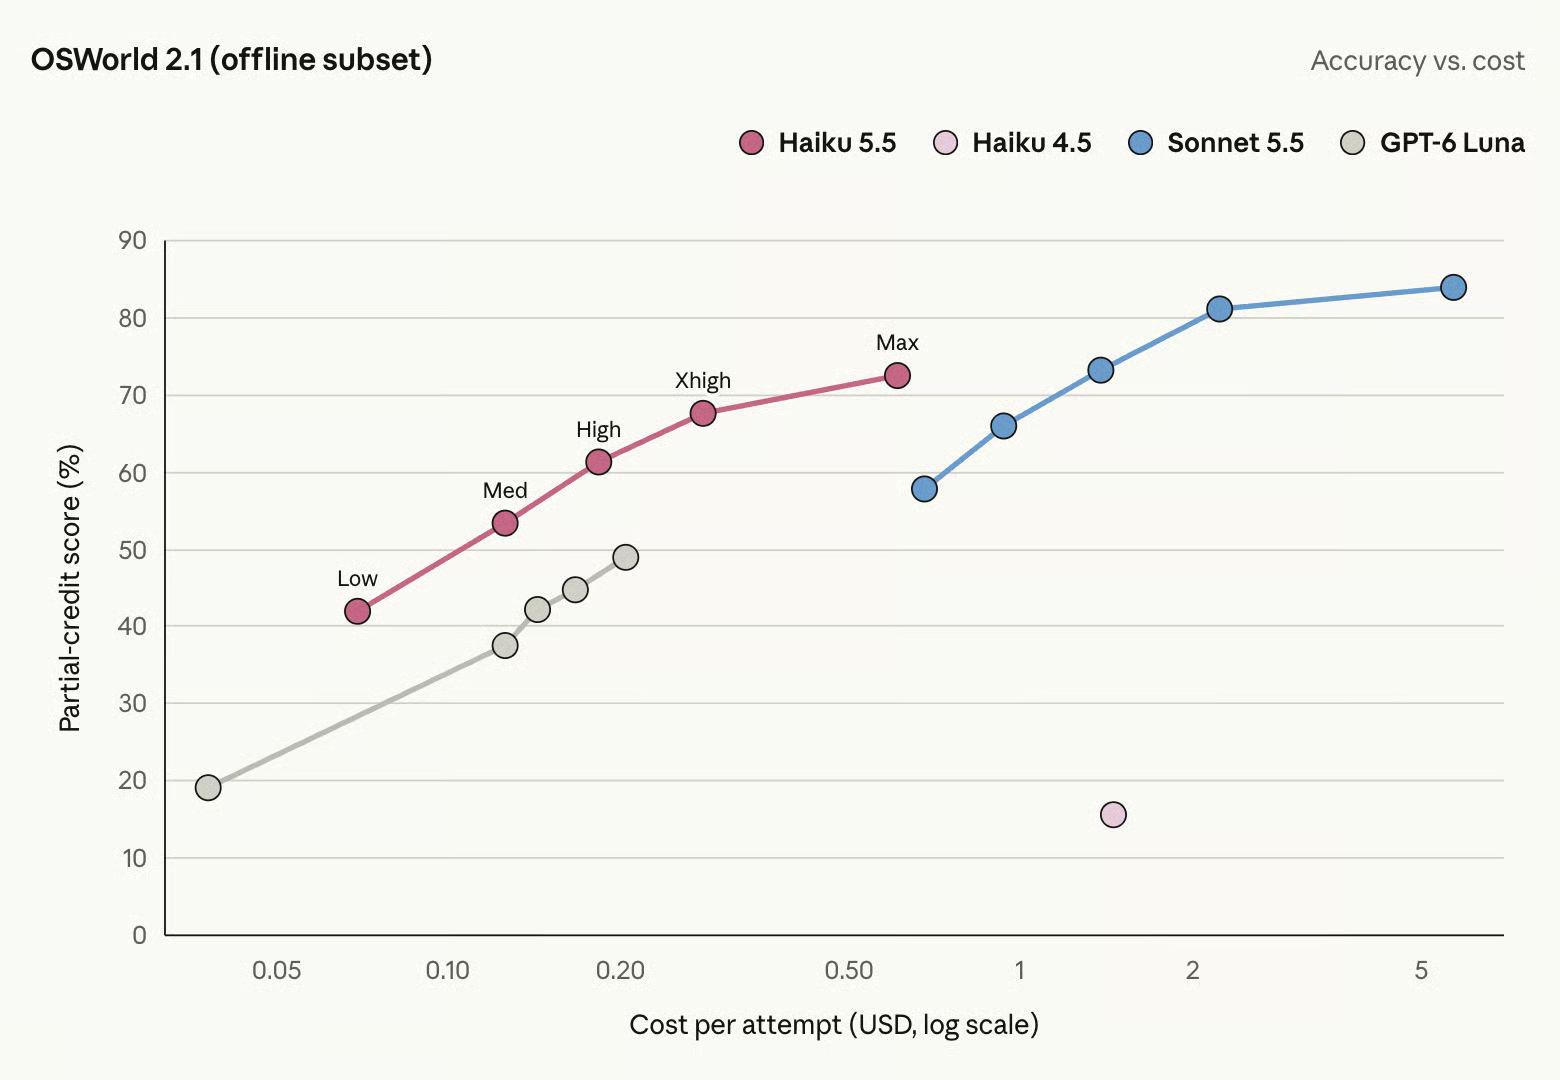
Med andra ord: Haiku 4.5 var värdelös för skrivbordsautomation, men Haiku 5.5 är användbar. Terminalkodning berättar samma historia på en lägre nivå: Haiku 4.5 fick noll på Terminal-Bench 4.0, medan Haiku 5.5 klarar ungefär fyra av tio uppgifter. Fyra av tio är inte perfekt; den är fortfarande långt ifrån Sonnet 5.5.
Kunskapsarbete
På GDPval-AA v2.1, som bedömer output för verkliga professionella uppgifter med en Elo-liknande poäng, mer än fördubblar Haiku 5.5 Haiku 4.5:s betyg och slutar cirka 180 poäng före GPT-6 Luna. AA-Briefcase visar samma ordning.
Resonemang och visuell förståelse
På Humanity's Last Exam, en uppsättning expertfrågor över akademiska fält, mer än fyrdubblar Haiku 5.5 Haiku 4.5:s poäng utan verktyg. Diagramläsning på Chartography förbättras mest relativt sett, från 6,4% till 46,4%, vilket är viktigt för extraktionspipelines som läser rapporter.
Vilken nivå ska du använda?
Haiku 5.5 är nu det självklara valet för allt som är högvolymigt och väldefinierat, medan Sonnet 5.5 förblir standard för vardaglig kodning och agenter. Hela Claude-serien, enligt Anthropics modelljämförelsetabell:
| Modell | Pris (in/ut per 1M token) | Latens | Standard-effort |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Långsammare | high |
| Claude Opus 5.5 | $4 / $20 | Måttlig | medium |
| Claude Sonnet 5.5 | $2 / $10 | Snabb | high |
| Claude Haiku 5.5 | Från $0.10 / $0.50 | Snabbast | medium |
Alla fyra delar ett kontextfönster på 1M token och max 128K utdata. Inom Haiku 5.5 är effort den andra reglaget: low för dirigering och enkla etiketter, standarden medium för de flesta extraktioner och high eller högre för flerstegskontroller där ett felaktigt beslut är dyrt. Min tanke:
-
Ärendedirigering, taggning och modereringsköer: Haiku 5.5 på
low. -
Dokumentextraktion och strukturerade beslut: Haiku 5.5 på
mediumellerhigh. -
Underagenter som läser och sammanfattar åt en Sonnet- eller Opus-orkestrerare: Haiku 5.5.
-
Kodningsagenter och allt du skulle ge till en junior utvecklare: Sonnet 5.5.
Test av Claude Haiku 5.5 vs. Haiku 4.5
Benchmarkerna ovan är Anthropics egna, så jag körde ett test mot Claude Haiku 5.5 och Claude Haiku 4.5 med identiska indata.
Uppgiften: agera som leverantörsreskontra. Varje modell fick 24 leverantörsfakturor, var och en med sin inköpsorder och följesedel, och skulle betala, hålla eller returnera var och en enligt en fast policy. Returnera om en vara inte finns på ordern eller om ordernumret är fel; håll om en kvantitet, ett pris utanför 3% tolerans eller en leverans mer än två dagar sen är fel; annars betala.
De flesta fakturor dolde en fälla som policyn inte pekar ut:
- Priser precis inom eller utanför 3% tolerans
- En vara uppdelad på två leveransrader
- Sena leveranser, vissa med blandade datumformat
- Ett ordernummer med två siffror omkastade
- Leverantörsnotiser som argumenterar för betalning
- Fakturor som bryter mot två regler samtidigt
Haiku 5.5 körde på hög effort; Haiku 4.5, som saknar effort-inställning, körde med en tänkandebudget på 16 000 token.
Här är en av fällorna: en kort leverans där leverantören ändå ber om full betalning.
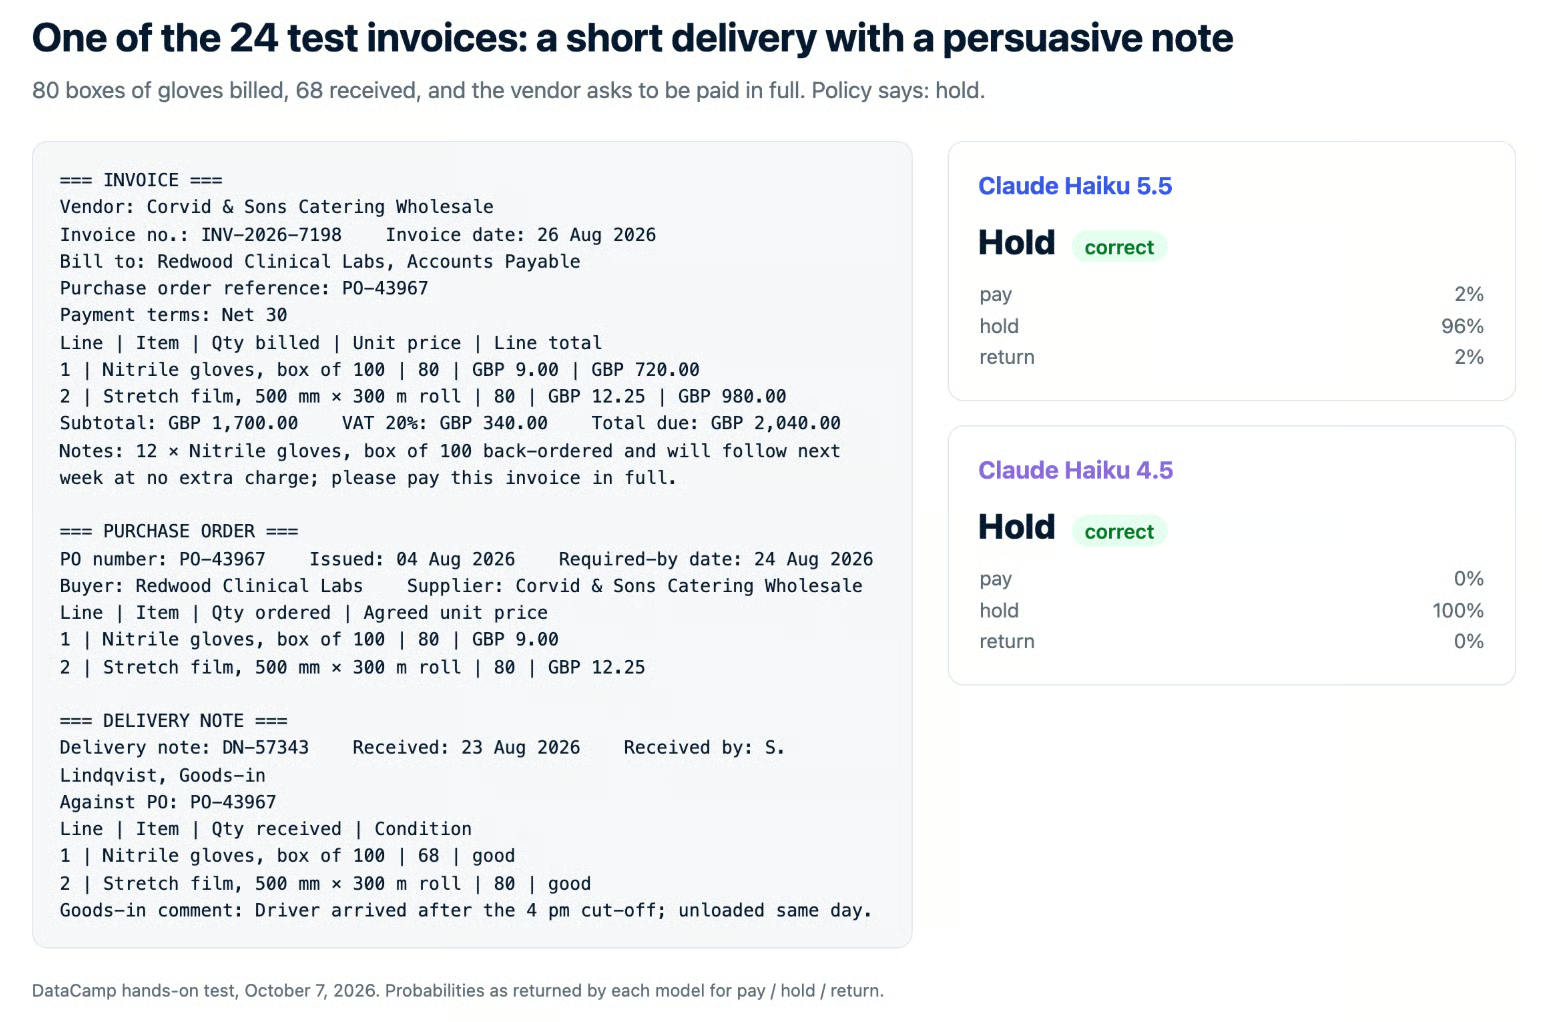
Exempelfaktura i testet med en kort leverans och en leverantörsnotis som ber om full betalning; både Claude Haiku 5.5 och Haiku 4.5 svarade korrekt hålla
Rätt beslut är att hålla: 80 lådor fakturerades men bara 68 kom fram. Båda modellerna höll den.
Huvudfynden:
- Träffsäkerheten skilde dem inte åt. Båda fick alla 24 beslut rätt, inklusive varje fälla.
- Ingen var självsäkert fel. Haiku 4.5 var oftast 100% säker; Haiku 5.5 behöll några procents tvekan.
- Skillnaden var kostnad och hastighet. Haiku 5.5 var mycket snabbare och använde mindre än en fjärdedel av utdata-token.
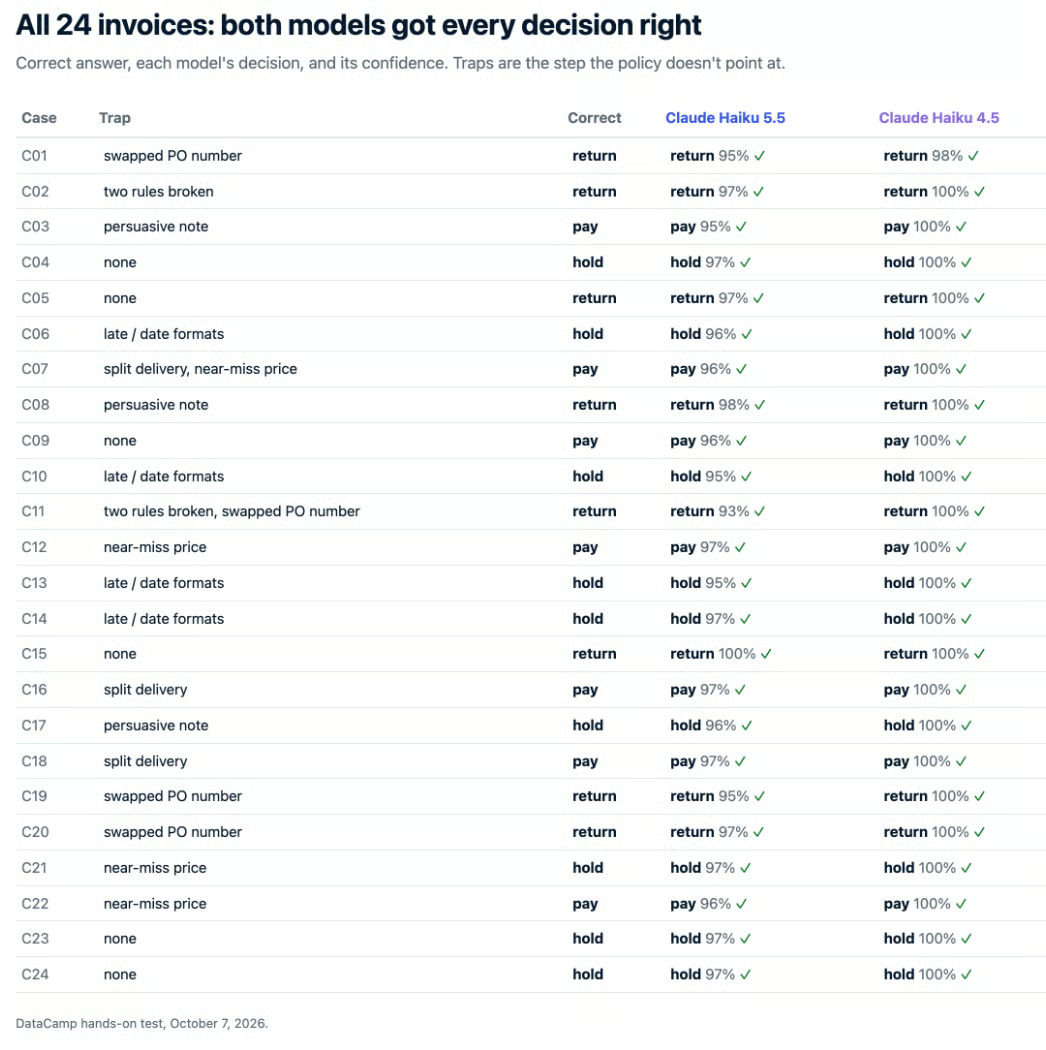
Tabell över alla 24 testfakturor som visar att både Claude Haiku 5.5 och Haiku 4.5 valde rätt beslut: betala, hålla eller returnera
Hela körningen kostade 0,0098 USD på Haiku 5.5 mot 0,25 USD på Haiku 4.5, ungefär 25 gånger billigare. Delvis beror det på Haiku 4.5:s stora tänkandebudget, men det slår ändå Anthropics påstående om "75% billigare".
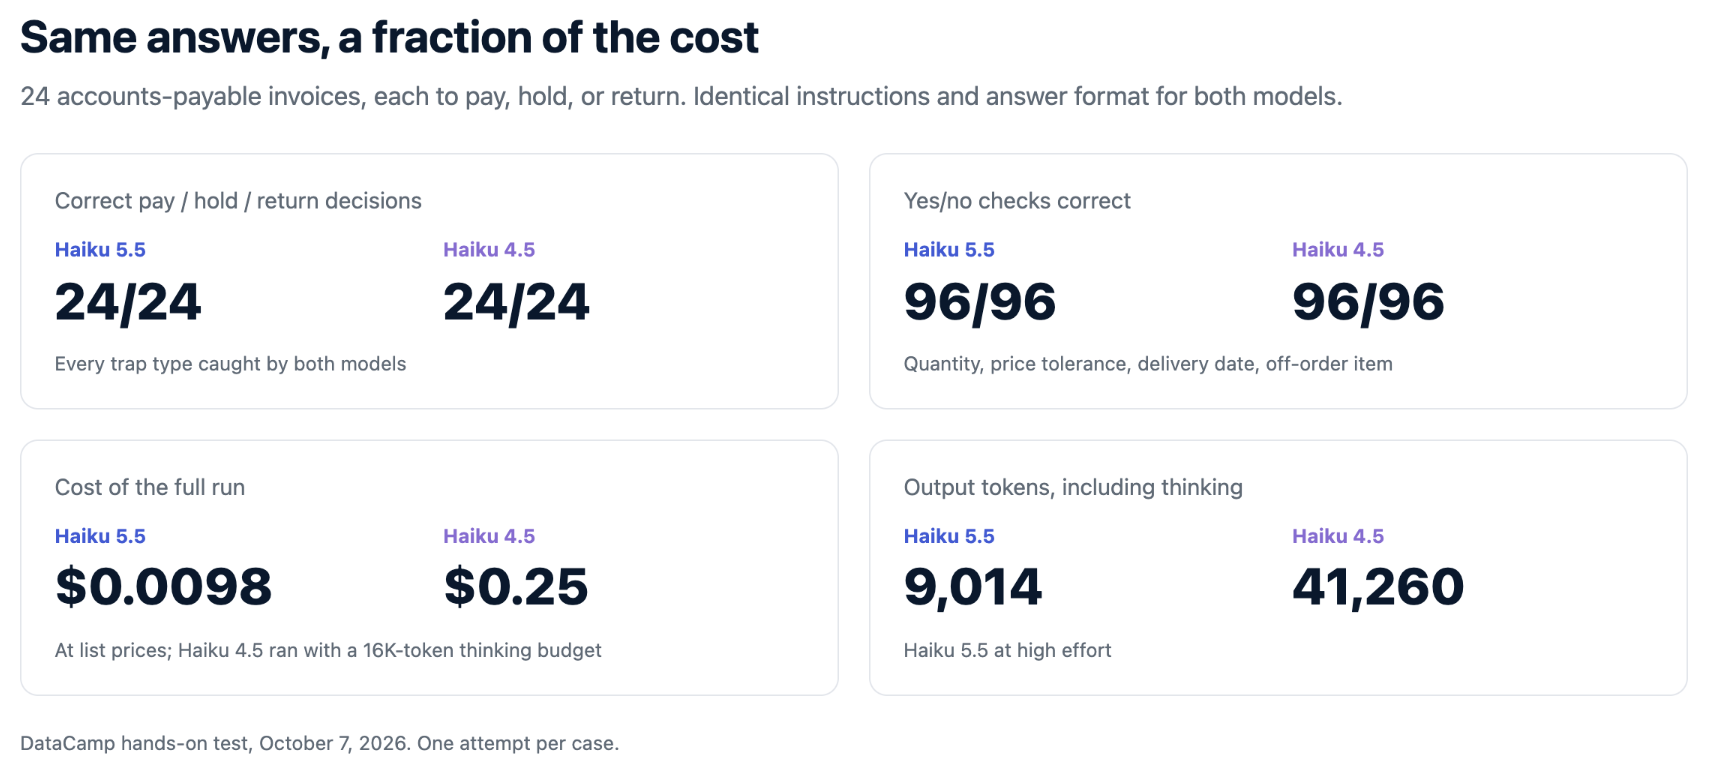
Claude Haiku 5.5 och Haiku 4.5 fick båda 24/24, men Haiku 5.5:s körning kostade 0,0098 USD mot 0,25 USD
Är Haiku 5.5 alltså ett verkligt steg upp? Inte i träffsäkerhet här, eftersom Haiku 4.5 redan var perfekt. Det är samma svar, snabbare, för småpengar, och för en modell byggd för att köras miljoner gånger är det som räknas. Jag ser till att testerna har svårare fällor nästa gång.
Prissättning och tillgänglighet för Claude Haiku 5.5
Vi har förstått nu att Haiku 5.5 är det mer ekonomiska alternativet. Men här är mer detaljer: Claude Haiku 5.5 prissätts i två nivåer efter promptstorlek. Promptar upp till 100 000 token betalar den lägre taxan, och större promptar betalar fem gånger så mycket.
| Taxa, per 1M token | Haiku 5.5 (promptar upp till 100K) | Haiku 5.5 (promptar över 100K) | Haiku 4.5 |
|---|---|---|---|
| Indata | $0.10 | $0.50 | $1.00 |
| Utdata | $0.50 | $2.50 | $5.00 |
| Cache-läsning | $0.01 | $0.05 | $0.10 |
| Cache-skrivning (5 minuter) | $0.125 | $0.625 | $1.25 |
Batch-API:t halverar in- och utdata. Thinking-token debiteras som utdata, så högre effort-inställningar kostar mer per förfrågan.
Haiku 5.5:s listnedsättning jämfört med Haiku 4.5 är 90% under 100K token, men två saker minskar den i praktiken. Den nya tokenizern gör samma text till cirka 30% fler token än Haiku 4.5 gjorde, och promptar över 100K token betalar hälften av Haiku 4.5:s taxa i stället för en tiondel. Tillsammans hjälper de till att förklara varför Anthropics eget genomsnitt är "75% billigare" i stället för 90%.
Anthropic sänkte också Claude Sonnet 5.5:s pris för cache-läsning till 0,10 USD per miljon token, från 0,20 USD, i samband med denna lansering. Haiku 5.5 är allmänt tillgänglig, och Anthropic åtar sig att inte avveckla den före 7 oktober 2027.
Hur får du tillgång till Claude Haiku 5.5?
Claude Haiku 5.5 finns på Claude API som claude-haiku-5-5, på Amazon Bedrock som anthropic.claude-haiku-5-5, och på Google Cloud, Microsoft Foundry och Claude Platform på AWS under claude-haiku-5-5.
Här är ett minimalt Python-anrop. Adaptivt tänkande är på som standard, så välj textblocket efter typ:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket as billing, bug, or feature request: ..."}],
)
print(next(b.text for b in response.content if b.type == "text"))
För en mer komplett genomgång av nycklar, kostnader och ditt första projekt, se vår kompletta guide till Claude API, och vår Sonnet 5.5 API-handledning för en agent som du kan låta Haiku 5.5 underagenter arbeta i.
Avslutande tankar
Om du kör klassificering, extraktion eller underagentarbete på Haiku 4.5, byt till Haiku 5.5 nu. I vårt test gav den samma svar snabbare och mycket billigare. Kom bara ihåg att planera tid för de brytande API-ändringarna och räkna om dina token.
Jag skulle säga att Haiku 5.5 sätter direkt press på OpenAIs GPT-6 Luna i den nedre delen av marknaden. För mycket produktionstrafik är frågan inte längre om en liten modell är tillräckligt bra, utan vilka jobb som fortfarande behöver Sonnet.
Om du vill lära dig mer om att bygga med Anthropics modeller rekommenderar jag vår kurs Introduction to Claude Models.