Sechs Tage nachdem Anthropic Claude Opus 5.5 an die Spitze seines Portfolios gesetzt hat, schließt das Mittelklassemodell zum halben Preis den Großteil der Lücke. Claude Sonnet 5.5 übertrumpft Opus 5.5 in einem Benchmark und liegt sonst nur wenige Punkte zurück – bei unverändertem Sonnet‑5‑Preis.
Dieses Muster kennen wir bereits. Claude Sonnet 5 kam nahe an Opus 4.8s agentische Benchmarks heran – zu einem Bruchteil der Kosten. Davor landete Sonnet 4.6 zu ähnlichen Konditionen in Schlagdistanz zu Opus 4.6. Jedes Mal erscheint kurz nach dem Flaggschiff ein Mid‑Tier‑Modell und schließt den Großteil der Lücke zum halben Preis.
So sieht eine logarithmische Skalierungskurve von außen aus. Die Leistung steigt grob mit dem Logarithmus des Compute – die Kosten damit grob exponentiell mit der Leistung. Ein Flaggschiff sitzt oben auf der Kurve und zahlt viel für die letzten Prozentpunkte. Ein günstigeres Modell, wenige Wochen später mit denselben Fortschritten im Unterbau, muss nur etwas weiter unten auf der Kurve landen, um fast genauso gut zu wirken. Heißt: Der größte Teil des Werts ist weiterhin günstig zu haben – nur das letzte Stück wird teuer.
Das lohnt sich zu entwirren, denn die führenden Anbieter zaubern hier gerne mit PR und Branding.
TL;DR
- Sonnet 5.5 ist Anthropics neues Mid‑Tier‑Modell und ersetzt Sonnet 5 zum selben Preis.
- Der größte Sprung liegt beim agentischen Terminal‑Coding, wo es Opus 5.5 sogar knapp überholt.
- Bei Wissensarbeit und Computerbedienung liegt es knapp hinter Opus 5.5 – bei halbem Tokenpreis.
- Mach es zu deinem Standard‑Claude und nutze Opus 5.5 für offene, urteilslastige Aufgaben.
Was ist Claude Sonnet 5.5?
In Anthropics Modelldokumentation heißt es, Claude Sonnet 5.5 sei „die beste Kombination aus Geschwindigkeit und Intelligenz“ im aktuellen Line‑up. Es ist das Mid‑Tier‑Modell in der Claude‑5.5‑Familie – zwischen dem Flaggschiff Claude Opus 5.5 und dem kommenden Claude Haiku 5.5. (Wir halten dich zu Haiku 5.5 auf dem Laufenden – Haiku 5 kam allerdings nie.)
Im Vergleich zu Sonnet 5 ist der Sprung größer als eine halbe Versionsnummer vermuten lässt. Das überrascht wenig, nachdem auch der Abstand zwischen Opus 5.5 und Opus 5 größer ausfiel als erwartet.
Zum Launch‑Post: Anthropic meldet Zugewinne in allen veröffentlichten Benchmarks, mit den größten Sprüngen beim Terminal‑Coding, beim Lesen von Charts und in Bewertungen von Wissensarbeit.
Interessant: Laut Anthropic ist dies das erste Sonnet‑Modell, das Pokémon Red allein anhand von Screenshots schlägt. Klingt ungewöhnlich, dient aber als Proxy für Langzeitaufgaben und Bildverständnis.
Opus 5.5 bleibt laut Unternehmen klar stärker bei komplexer, offener Arbeit, die nachhaltiges Urteilsvermögen braucht. Sonnet 5.5 ist hingegen das Modell für Aufgaben, bei denen klar ist, wie „fertig“ aussieht – eine hilfreiche Heuristik.
Die wichtigsten Features von Claude Sonnet 5.5
Das meiste Neue in Sonnet 5.5 zielt darauf ab, dieselbe Arbeit schneller und mit weniger Tokens zu erledigen – plus ein paar Änderungen, auf die sich API‑Nutzer einstellen sollten.
Nahezu Opus‑Ergebnisse bei Alltagsaufgaben – in Sonnet‑Tempo
Du kannst Sonnet 5.5 Arbeiten geben, die zuvor eher nach Opus verlangten – und bekommst sie schneller zurück. Anthropic spricht von über 30% schnellerer Ausgabe als bei Sonnet 5 und davon, dass das Modell pro Aufgabe weniger Tokens nutzt – „bis zu 30% weniger pro Aufgabe“ – ist die genannte Zahl.
Frühe Tester im Launch‑Post untermauern das mit eigenen Zahlen:
- Base44 meldet 3,6 Iterationen pro App‑Build mit Sonnet 5.5 gegenüber 7,7 mit Opus 5.
- Box sah Workloads 2,4‑mal schneller bei 12% weniger Gesamttokens.
- Zendesk maß 20% schnelleres Ticket‑Processing.
- Slack berichtet von rund 14% weniger Output‑Tokens.
Das sind kuratierte Kundenstimmen – dennoch zeigt sich ein Muster: weniger Iterationen, weniger Tokens. Neben dem Tokenpreis zählt das für deine Rechnung.
Coding‑Agenten im Terminal und auf dem Desktop ausführen
Sonnet 5.5 ist als Agent gedacht: Shell‑Befehle ausführen, Bugs im Repo beheben und einen Desktop über Screenshots bedienen. Es ist ab Launch in Claude Code live, und Anthropic beschreibt die Computerbedienung als nah an Opus 5.5.
Praktisch heißt das für viele: Sonnet 5.5 ist jetzt ein glaubwürdiger Standard für Claude‑Code‑Sessions und für Agent‑Loops, die du selbst mit unserem Claude‑API‑Guide baust.
Ausgereifte Dokumente, Slides und Interfaces produzieren
Anthropic hebt ein „gutes Auge für Design“ als Stärke von Sonnet 5.5 hervor. In der Praxis sollte das zu besseren User‑Interfaces führen, wenn du Frontend‑Code verfeinern lässt, und zu fertiger wirkenden Ergebnissen bei Slides, Tabellen oder langen Dokumenten.
Dieser Design‑Claim braucht am ehesten unabhängige Überprüfung. Er ist schwer zu benchen und stützt sich im Launch‑Post nur auf Kundenstimmen.
Sicherheits- und Biologie‑Safeguards einplanen
Sonnet 5.5 ist das erste Sonnet, das mit Cybersicherheits‑Safeguards ähnlich wie bei Opus 5.5 startet. Bei als risikoreicher eingestuften Security‑Anfragen fällt das Modell auf Sonnet 5 zurück. Biologie‑Safeguards entsprechen Sonnet 5; laut Anthropic bleiben die meisten Software‑ und Life‑Sciences‑Aufgaben unbeeinflusst.
Ebenso neu: Classifier blockieren Reasoning‑Extraktion, und Thinking‑Blöcke sind nun an Konto und Konversation gebunden, die sie erzeugt haben. Wenn du Security‑Tooling betreibst, teste deine Prompts vor dem Umstieg in einer Pipeline.
Mit wenigen Code‑Änderungen von Sonnet 5 migrieren
Nur die Modell‑ID zu tauschen, reicht nicht ganz. Anthropics Dokumentation listet fünf Breaking Changes für Code, der bereits auf Sonnet 5 läuft:
-
Adaptive Thinking ist standardmäßig aktiv; die niedrigste Stufe ist
between_toolsund schaltet Vorab‑Thinking ab. -
Erzwungene Tool‑Nutzung führt zu einem Fehler.
-
Thinking‑Blöcke sind an das Modell und die Konversation gebunden, die sie erzeugt haben.
-
Das ältere
computer_20251124Computer‑Use‑Tool wird auf der Claude API und bei Google Cloud abgelehnt. -
Das Advisor‑Tool akzeptiert Opus 4.8, Opus 4.7 und Sonnet 5 nicht mehr als Advisors.
Leiser, aber relevant: Text zwischen Tool‑Calls kommt jetzt in thinking‑Blöcken zurück. Eine App, die Text an Nutzer streamt, bleibt zwischen Tool‑Calls stumm, bis du ihre display‑Einstellung anpasst. Das Setzen von temperature, top_p oder top_k auf Nicht‑Standardwerte führt zudem zu einem 400‑Fehler. Das sind Dinge, über die du stolpern könntest.
Wie schlägt sich Claude Sonnet 5.5 in den Benchmarks?
Claude Sonnet 5.5 schlägt Sonnet 5 in allen von Anthropic veröffentlichten Benchmarks, liegt beim Terminal‑Coding vor Opus 5.5 und sonst wenige Punkte dahinter. Gegen OpenAIs GPT‑6 Sol führt es bei Wissensarbeit und Chart‑Lesen, liegt aber bei FrontierCode zurück. Alle Zahlen unten stammen aus Anthropics Launch‑Post.
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 10,3% | 66,4% | Nicht berichtet |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | Nicht berichtet |
| FrontierCode 1.1 (Main) | 46,2% (max effort) | 42,4% | 54,4% | 49,3% (52,1% bei xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (mit Tools) | 64,5% | 54,9% | 67,7% | Nicht berichtet |
| OSWorld 2.1 | 80,1% | 57,0% | 81,8% | Nicht berichtet |
| Chartography (ohne Tools) | 61,6% | 15,6% | 64,4% | 53,6% |
Die Tabelle erzählt eine klare Geschichte: ein großer Generationssprung gegenüber Sonnet 5 und fast Gleichstand mit Opus 5.5. Schauen wir, was das für deine Arbeit bedeutet.
Agentisches Coding
Bei Terminal‑Bench 4.0 setzt sich Sonnet 5.5 ab. Es erzielt 70,6% – nach 10,3% bei Sonnet 5 – und liegt vor Opus 5.5 mit 66,4%. Der Benchmark misst, ob ein Modell reale Aufgaben in einer Kommandozeilenumgebung erledigen kann, etwa mehrstufige Shell‑Workflows – also sehr nah an der Nutzung in Claude Code.
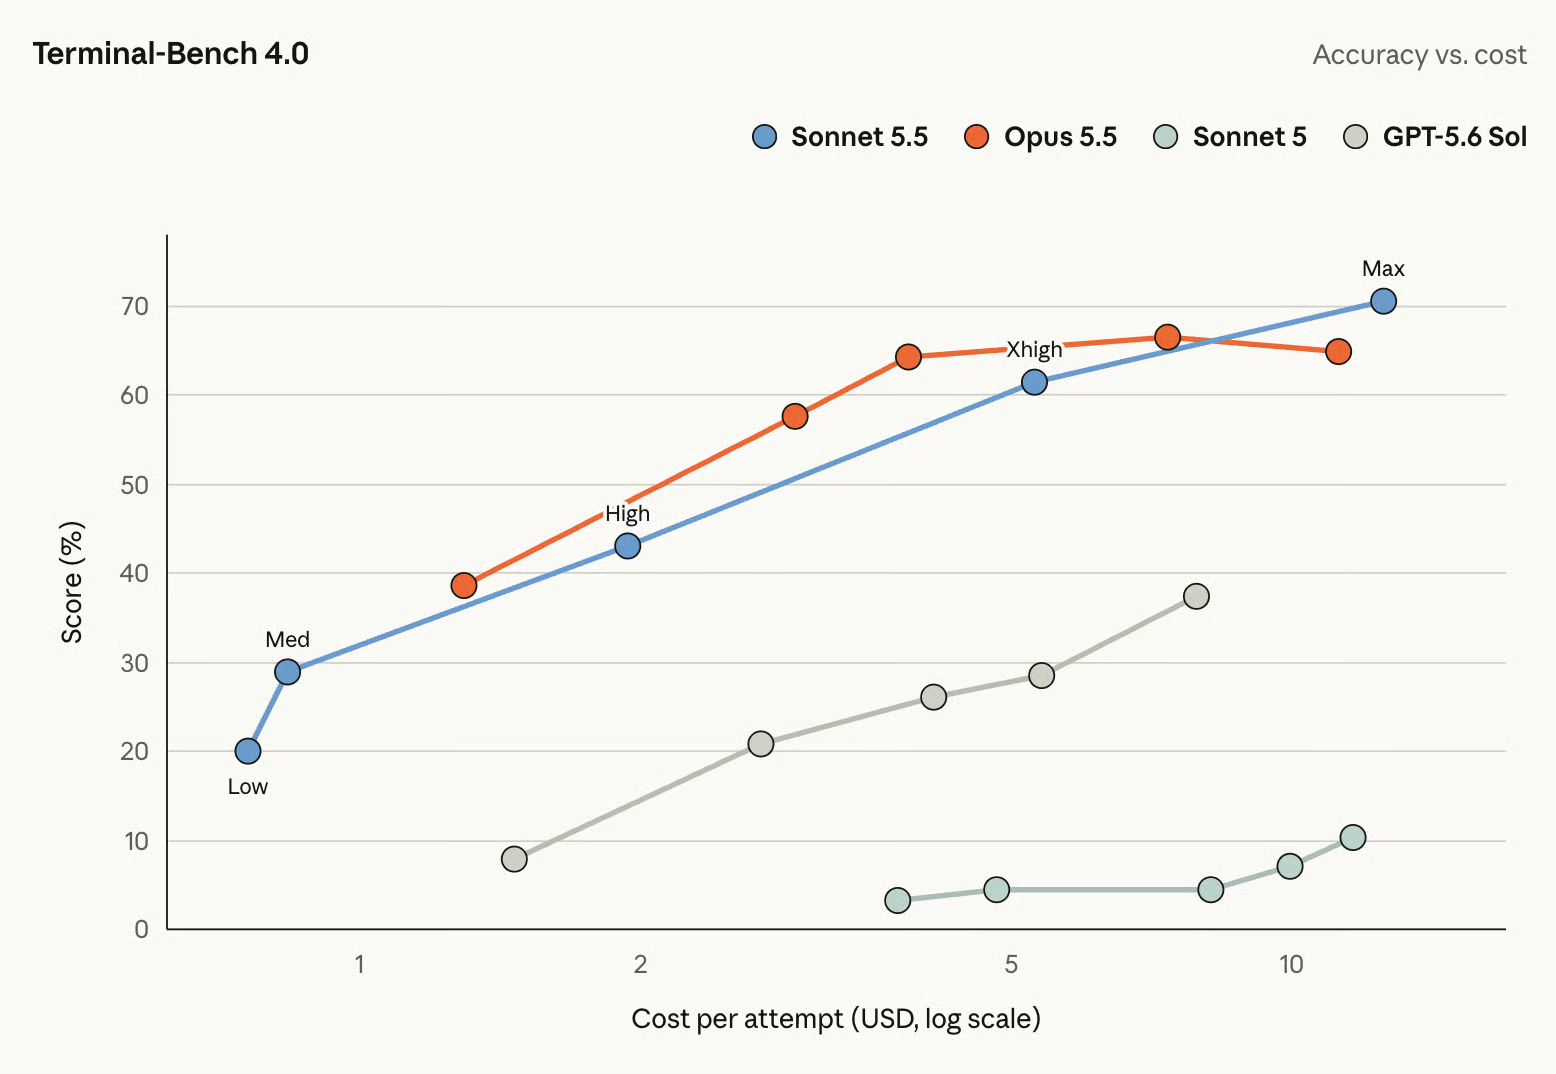
Ein Sprung um 60 Punkte in einem Release ist ungewöhnlich. Der Rest des Coding‑Bildes fällt weniger dramatisch aus.
Wissensarbeit
Bei GDPval‑AA v2.1, das Modell‑Outputs für wirtschaftlich relevante Aufgaben aus echten Berufen im Elo‑Stil bewertet, erreicht Sonnet 5.5 1844 Punkte. Das sind 2 weniger als Opus 5.5 und fast 400 mehr als Sonnet 5.
Für Teams, die Claude für Reports, Analysen und Geschäftsdokumente nutzen, ist das das aussagekräftigste Ergebnis. Für diese Arbeit kauft der Aufpreis von Opus 5.5 nur wenig hinzu.
Reasoning und visuelles Verständnis
Chartography – ein Test für Lesen und Schlussfolgern über Charts ohne Tools – zeigt den relativ größten Gewinn: Sonnet 5.5 erreicht 61,6% gegenüber 15,6% bei Sonnet 5. Das passt zu Anthropics Aussagen über verbessertes Bildverständnis.
Computerbedienung
Bei OSWorld 2.1 – einem Maß dafür, ob ein Modell Aufgaben durch Bedienung eines echten Desktop‑Betriebssystems erledigen kann – kommt Sonnet 5.5 auf 80,1%, nach 57,0% bei Sonnet 5 und innerhalb von zwei Punkten zu Opus 5.5.
Welche Stufe solltest du wählen?
Für die meisten Developer sollte Sonnet 5.5 jetzt das Standard‑Claude‑Modell sein. Opus 5.5 rechtfertigt seinen höheren Preis nur dann, wenn die Aufgabe so offen ist, dass Urteilsvermögen – nicht Geschwindigkeit – der Engpass ist.
Das aktuelle Line‑up laut Anthropics Modellvergleich sieht so aus. Alle vier Modelle außer Haiku 4.5 teilen sich ein 1M‑Token‑Kontextfenster und 128K Max‑Output.
| Modell | Preis (Input / Output pro 1M Tokens) | Latenz | Am besten für |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Langsamer | Top‑End‑Arbeit, bei der Fähigkeit wichtiger als Kosten ist |
| Claude Opus 5.5 | $4 / $20 | Moderat | Komplexe, offene Aufgaben mit anhaltendem Urteilsbedarf |
| Claude Sonnet 5.5 | $2 / $10 | Schnell | Gut abgegrenztes Coding, Agenten und Dokumentenarbeit |
| Claude Haiku 4.5 | $1 / $5 | Am schnellsten | High‑Volume‑, kostenkritische Aufgaben |
Innerhalb von Sonnet 5.5 ist die Effort‑Einstellung der zweite Hebel. Anthropic hat fünf Stufen neu kalibriert: low, medium, high, xhigh und max. Niedrigere Stufen bevorzugen Tempo und Kosten, höhere lassen das Modell länger überlegen und sein Ergebnis prüfen. Standard ist medium in den Claude‑Apps und in Claude Code, sowie high in der API.
Ein Detail aus dem Launch‑Post ändert meine Nutzung: Bei low oder medium schlägt Sonnet 5.5 Sonnet 5s Bestwerte in mehreren Benchmarks – bei rund einem Zehntel der Kosten pro Aufgabe. Kurz gefasst:
-
Bugfixes, Refactors und Claude‑Code‑Sessions: Sonnet 5.5 auf Standard‑Effort.
-
High‑Throughput‑Agent‑Loops und Pipelines: Sonnet 5.5 auf
lowodermediumund Effort nur bei Fehlschlägen erhöhen. -
Harte Coding‑Probleme mit klarer Spezifikation: Sonnet 5.5 auf
xhighodermax, bevor du für Opus zahlst. -
Mehrdeutige Projekte über mehrere Tage: Opus 5.5.
Claude Sonnet 5.5 im Test: Hands‑on
Die Benchmarks oben stammen von Anthropic, daher habe ich eine Build‑Aufgabe mit identischem Prompt und identischem Tooling gegen Claude Sonnet 5.5 und Claude Sonnet 5 laufen lassen.
Die Aufgabe: FiveThirtyEights Datensatz zu frisch graduierten Studierenden (173 US‑Majors, CC BY 4.0) in ein Single‑File‑HTML‑Dashboard verwandeln, das angehenden Studierenden hilft, Kategorien nach Einkommen und Beschäftigung zu vergleichen und die best‑ und schlechtestverdienenden Majors zu finden.
Der eigentliche Test steckt in den Daten, die einige Eigenschaften haben, die im Prompt nicht erwähnt werden:
- Der Top‑Verdiener, Petroleum Engineering, hat nur 36 Befragte; 76 der 173 Majors haben weniger als 100
- Einkommen sind schief verteilt, ein einzelner Medianbalken verdeckt viel Streuung
- Ein Major, Food Science, hat leere Headcount‑Felder
- Die Job‑Typ‑Spalten summieren sich nicht auf die Zahl der Beschäftigten
Diese Punkte zu bemerken, ist der Kern des Tests. Er prüft Anthropics Claim eines „guten Auges für Design“.
Die wichtigsten Ergebnisse:
- Nur Sonnet 5.5 lieferte ein funktionierendes Dashboard. Sonnet 5 verlinkte eine Chart.js‑Datei, die es auf cdnjs nicht gibt (URL liefert 404), sodass die Library nicht lud und alle Panels – auch die simplen Tabellen – leer blieben. Sonnet 5.5 prüft zudem, ob die Chart‑Library geladen wurde, und hält Tabellen funktionsfähig, falls nicht.
- Sonnet 5.5 erkannte die Kleinstichproben‑Falle – überwiegend. Majors mit weniger als 30 Befragten werden als „mit Vorsicht behandeln“ markiert, plus ein Minimum‑Respondents‑Filter. In der Default‑Ansicht steht Petroleum Engineering dennoch ohne Warnung auf Platz 1.
- Sonnet 5 hätte es ohnehin übersehen. Sein Code liest Sample‑Size‑ und Gehaltsstreuungs‑Spalten ein, nutzt sie aber nie und rankt nur nach Median.
- Die kleineren Fallen erwischten niemanden. Beide gingen mit der leeren Food‑Science‑Zeile explizit um, und Sonnet 5.5 berechnete den Anteil „College‑Job“, ohne zu implizieren, dass sich die Job‑Spalten zur Gesamtbeschäftigung summieren.
Hier ist Sonnet 5.5s Dashboard mit dem Filter auf Majors mit mindestens 100 Befragten.
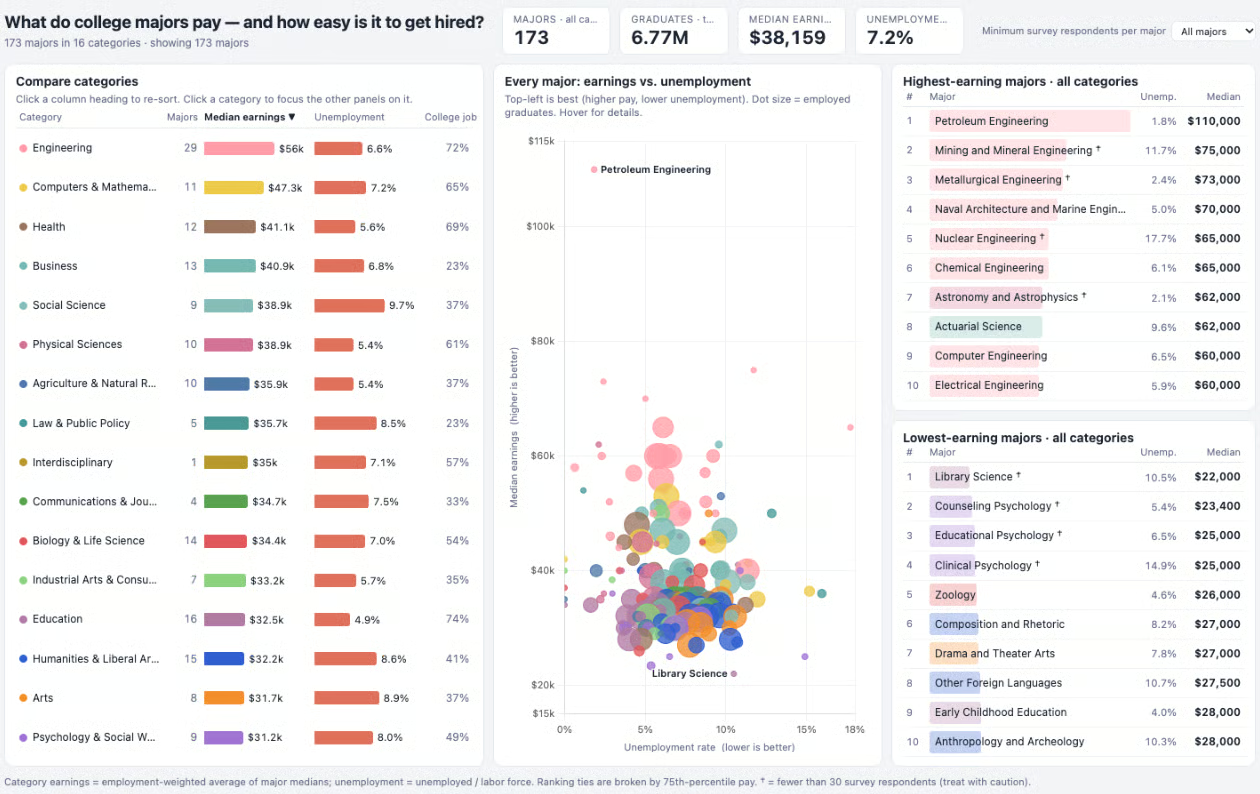
Ich habe Sonnet 5.5s Dashboard mit 4 von 5 für ehrlichen Umgang mit Daten, 5 für analytischen Nutzen und 4 für Chart‑ und Layout‑Qualität bewertet. Sonnet 5s leere Seite folgt unten.
Warum ist Sonnet 5 gescheitert? Das Dashboard brauchte eine Charting‑Library. Sonnet 5 forderte bei cdnjs eine Version an, die dort nicht gehostet wird – es kam ein „404“. Ohne Library stürzte Sonnet 5s Code ab: „Chart is not defined.“ Offenbar war die Seite so gebaut, dass alles – selbst einfache Texttabellen – erst nach diesem Schritt lief und der Fehler nicht abgefangen wurde.
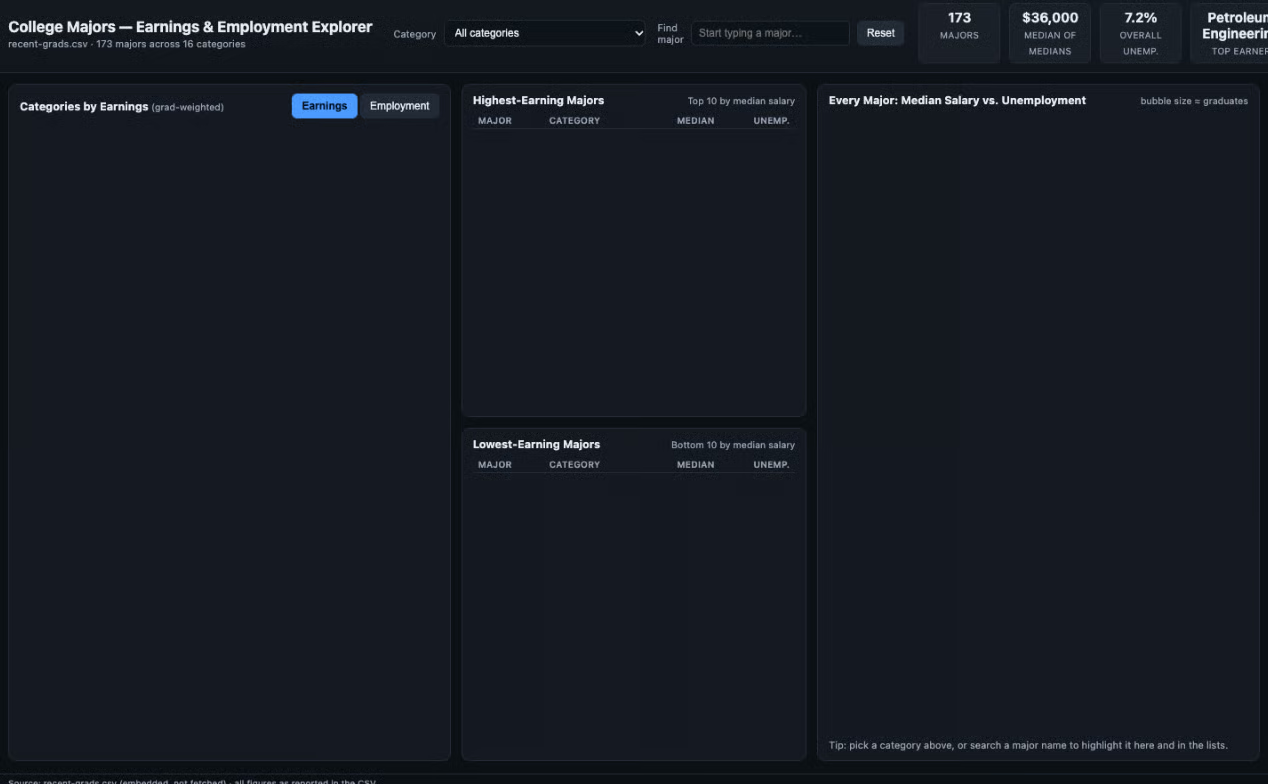
Die Kosten pro Run waren praktisch identisch: $0,56 für Sonnet 5.5 und $0,57 für Sonnet 5. Zudem war Sonnet 5.5 schneller fertig.
Ist Sonnet 5.5 also ein echter Schritt nach vorn? Für diese Aufgabe: ja. Sonnet 5.5 lieferte ein funktionierendes Dashboard mit Warnhinweisen zu dünnen Daten, Sonnet 5 eine leere Seite.
Claude Sonnet 5.5: Preise und Verfügbarkeit
Claude Sonnet 5.5 kostet in der API $2 pro Million Input‑Tokens und $10 pro Million Output‑Tokens – unverändert zu Sonnet 5 und halb so teuer wie Opus 5.5. Anthropic berichtet von weniger Tokens pro Aufgabe, was die effektiven Job‑Kosten trotz gleicher Rate senkt. In unserem Hands‑on lagen die Gesamtkosten beider Modelle für die Aufgabe jedoch ähnlich.
| Token‑Typ | Preis pro 1M Tokens |
|---|---|
| Input | $2 |
| Output | $10 |
| Cache Write (5 Minuten) | $2,50 |
| Cache Write (1 Stunde) | $4 |
| Cache Read | $0,20 |
Die Batch API halbiert Input und Output. Das minimale cache‑fähige Prompt sind 512 Tokens, und über die Batch API kann das Modell mit dem Beta‑Header output-300k-2026-03-24 bis zu 300K Output‑Tokens zurückgeben.
Sonnet 5.5 ist allgemein verfügbar, nicht als Preview, mit optionaler Null‑Datenaufbewahrung. Anthropic sagt zu, es vor dem 28. September 2027 nicht abzukündigen.
Wie erhältst du Zugang zu Claude Sonnet 5.5?
Du kannst Claude Sonnet 5.5 ab sofort in den Claude‑Apps, in Claude Code und über die API mit der Modell‑ID claude-sonnet-5-5 nutzen. Es ist außerdem auf Amazon Bedrock als anthropic.claude-sonnet-5-5 sowie auf Google Cloud, Microsoft Foundry und der Claude Platform auf AWS unter claude-sonnet-5-5 verfügbar.
Hier ein minimales Python‑Beispiel. Adaptive Thinking ist standardmäßig aktiviert, daher kann die Antwort Thinking‑Blöcke vor dem Text enthalten:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Für einen echten Walkthrough zu Keys, Kosten und deinem ersten Projekt sieh dir unseren kompletten Guide zur Claude API an. Wenn du Agenten baust, ist unser Tutorial zum Bau von Claude Managed Agents der nächste Schritt. Ein API‑Tutorial zu Claude Sonnet 5.5 folgt in Kürze.
Fazit
Anthropic wettet darauf, dass der Großteil bezahlter Arbeit – inklusive der meisten Coding‑Agent‑Workloads – auf diesem neuen Mid‑Tier‑Modell läuft. Das erhöht auch den Druck auf OpenAIs GPT‑6 Sol, das laut Anthropics Zahlen zur Wissensarbeit zurückliegt.
Ich würde jetzt wechseln, wenn du noch auf Sonnet 5 bist – aber lies dich in die API‑Änderungen ein. Behalte Opus 5.5 für Projekte, bei denen das Modell selbst entscheiden muss, was gebaut wird.
Wenn du mehr darüber lernen willst, wie du mit Anthropics Modellen baust, empfehle ich unseren Kurs Introduction to Claude Models.