Anthropic द्वारा Claude Opus 5.5 को लाइनअप के शीर्ष पर लाने के छह दिन बाद, मिड-टियर मॉडल ने आधी कीमत पर अधिकांश अंतर बंद कर दिया है। Claude Sonnet 5.5 एक बेंचमार्क पर Opus 5.5 को मात देता है और बाकी में उससे केवल कुछ अंकों से पीछे है, और यह सब Sonnet 5 की प्राइसिंग बरकरार रखते हुए।
हमने यह पैटर्न पहले भी देखा है। Claude Sonnet 5 लॉन्च हुआ, जो Opus 4.8 के एजेंटिक बेंचमार्क्स के करीब था और लागत का एक अंश मांगता था। उससे पहले, Sonnet 4.6 भी Opus 4.6 के काफी करीब आया था। हर बार, फ्लैगशिप के कुछ दिन या हफ्ते बाद एक मिड-टियर मॉडल आता है और आधी कीमत पर अधिकांश गैप बंद कर देता है।
बाहर से देखने पर यही एक लघुगणकीय स्केलिंग कर्व जैसा दिखता है। परफॉर्मेंस मोटे तौर पर कंप्यूट के लॉग के साथ बढ़ती है, इसलिए लागत परफॉर्मेंस के साथ लगभग एक्सपोनेंशियली बढ़ती है। एक फ्लैगशिप मॉडल उस कर्व के शीर्ष पर बैठता है, जहां वह अंतिम कुछ अंकों के लिए भारी खर्च कर रहा होता है। कुछ हफ्तों बाद बना सस्ता मॉडल, उन्हीं मूलभूत प्रगतियों से लाभ उठाते हुए, कर्व पर एक निचले बिंदु तक ही पहुंचना चाहता है ताकि लगभग उतना ही अच्छा दिखे। यानी, कर्व का अधिकांश “वैल्यू” अभी भी सस्ते में मिल जाता है और केवल अंतिम खिंचाव महंगा है।
मुझे लगता है इसे अलग करके देखना जरूरी है क्योंकि अग्रणी कंपनियां PR और ब्रांडिंग के साथ थोड़ा जादू दिखाती हैं।
TL;DR
- Sonnet 5.5 Anthropic का नया मिड-टियर मॉडल है, जो उसी कीमत पर Sonnet 5 की जगह लेता है।
- सबसे बड़ी बढ़त एजेंटिक टर्मिनल कोडिंग में है, जहां यह अब वास्तव में Opus 5.5 से थोड़ा आगे निकलता है।
- नॉलेज वर्क और कंप्यूटर उपयोग पर, यह आधी प्रति-टोकन कीमत पर Opus 5.5 से बस थोड़ा पीछे बैठता है।
- इसे अपना डिफॉल्ट Claude मॉडल बनाएं और खुली-अवधि, निर्णय-प्रधान काम के लिए Opus 5.5 रखें।
Claude Sonnet 5.5 क्या है?
Anthropic के मॉडल दस्तावेज़ के अनुसार, Claude Sonnet 5.5 वर्तमान लाइनअप में “स्पीड और इंटेलिजेंस का सर्वश्रेष्ठ संयोजन” है। यह Anthropic के Claude 5.5 परिवार का मिड-टियर मॉडल है, जो फ्लैगशिप Claude Opus 5.5 और आने वाले Claude Haiku 5.5 के बीच बैठता है। (हम Haiku 5.5 पर आपको अपडेट देते रहेंगे, हालांकि Haiku 5 कभी आया नहीं।)
Sonnet 5 की तुलना में, छलांग आधा-वर्ज़न नंबर से कही ज्यादा बड़ी है। यह चौंकाने वाला नहीं है, क्योंकि हमने देखा था कि Opus 5.5 और Opus 5 के बीच की छलांग भी उम्मीद से बड़ी थी।
लॉन्च पोस्ट की बात करें—Anthropic ने हर प्रकाशित बेंचमार्क पर बढ़त की रिपोर्ट की है, जिसमें सबसे बड़ी छलांग टर्मिनल कोडिंग, चार्ट रीडिंग, और नॉलेज-वर्क इवैल्यूएशंस में है।
दिलचस्प बात यह है कि Anthropic का कहना है कि यह Sonnet मॉडल स्क्रीनशॉट्स से ही काम करते हुए Pokémon Red को हराने वाला पहला है। यह असामान्य लगता है लेकिन यह एक टेस्ट है जिसे Anthropic लंबी-अवधि के काम और इमेज समझ के लिए प्रॉक्सी के रूप में इस्तेमाल करता है।
तो, कंपनी के शब्दों में, Opus 5.5 अब भी जटिल, खुले-छोर वाले काम में स्पष्ट रूप से मजबूत है, जहां निरंतर निर्णय की जरूरत होती है। लेकिन Sonnet 5.5 उन कार्यों का मॉडल है जिनमें आपको पता होता है कि “डन” कैसा दिखता है—यह एक अच्छा ह्यूरिस्टिक है।
Claude Sonnet 5.5 के मुख्य फीचर्स
Sonnet 5.5 में ज़्यादातर नई चीजें वही काम तेज़ी से और कम टोकन्स में करने पर केंद्रित हैं, साथ ही कुछ बदलाव जिनके लिए API उपयोगकर्ताओं को योजना बनानी होगी।
रोज़मर्रा के काम में Sonnet की स्पीड पर near-Opus नतीजे पाएं
आप Sonnet 5.5 को वह काम दे सकते हैं जो पहले Opus चाहता था, और वह काम आपको जल्दी वापस मिलेगा। Anthropic कहता है कि आउटपुट जेनरेशन Sonnet 5 की तुलना में 30% से अधिक तेज़ है, और मॉडल प्रति टास्क कम टोकन्स उपयोग करता है—“प्रति टास्क 30% तक कम”—यही आंकड़ा वे उपयोग करते हैं।
लॉन्च पोस्ट में उद्धृत शुरुआती टेस्टर्स अपने आंकड़ों से इसे पुष्ट करते हैं:
- Base44 के अनुसार Sonnet 5.5 के साथ प्रति ऐप बिल्ड 3.6 इटरशन हुए, जबकि Opus 5 के साथ 7.7।
- Box ने अपने वर्कलोड्स को 2.4x तेज़ चलते देखा, कुल टोकन्स 12% कम हुए।
- Zendesk ने टिकट प्रोसेसिंग 20% तेज़ मापी।
- Slack ने लगभग 14% कम आउटपुट टोकन्स रिपोर्ट किए।
ये वेंडर-चुने हुए कस्टमर कोट्स हैं। फिर भी, इसमें एक पैटर्न है—कम इटरशन और कम टोकन्स—जो आपके बिल के लिए मायने रखता है, प्रति-टोकन दर के साथ-साथ।
टर्मिनल और डेस्कटॉप पर कोडिंग एजेंट्स चलाएं
Sonnet 5.5 एजेंट की तरह काम करने के लिए बना है: शेल कमांड चलाना, पूरे रिपो में बग फिक्स करना, और स्क्रीनशॉट्स के जरिए डेस्कटॉप ऑपरेट करना। यह लॉन्च के समय से ही Claude Code में लाइव है, और Anthropic इसका कंप्यूटर उपयोग Opus 5.5 के काफी करीब बताता है।
अधिकांश लोगों के लिए व्यावहारिक नतीजा यह है कि Sonnet 5.5 अब Claude Code सेशन्स के लिए और हमारे Claude API गाइड से बनाए गए आपके अपने एजेंट लूप्स के लिए एक भरोसेमंद डिफॉल्ट है।
पॉलिश्ड डॉक्यूमेंट्स, स्लाइड्स, और इंटरफेस बनाएं
Anthropic ने “डिज़ाइन के लिए तेज़ नजर” को Sonnet 5.5 की ताकत के रूप में चिन्हित किया है। प्रैक्टिस में, इसका मतलब होना चाहिए कि जब आप फ्रंट-एंड कोड रिफाइन करने को कहें तो बेहतर दिखते UI, और जब आप स्लाइड्स, स्प्रेडशीट्स, या लंबे डॉक्यूमेंट्स मांगे तो अधिक फिनिश्ड आउटपुट।
डिज़ाइन का दावा सबसे ज्यादा स्वतंत्र जाँच मांगता है। इसे बेंचमार्क करना सबसे मुश्किल है, और लॉन्च पोस्ट इसे केवल ग्राहक उद्धरणों से सपोर्ट करता है।
सुरक्षा और बायोलॉजी कार्यों पर सेफगार्ड्स की उम्मीद रखें
Sonnet 5.5 Opus 5.5 जैसे साइबरसिक्योरिटी सेफगार्ड्स के साथ लॉन्च होने वाला पहला Sonnet मॉडल है। जब कोई रिक्वेस्ट उच्च-जोखिम सुरक्षा कार्य के रूप में वर्गीकृत होती है, तो रिक्वेस्ट Sonnet 5 पर फॉल-बैक हो जाती है। बायोलॉजी सेफगार्ड्स Sonnet 5 जैसे ही हैं, और Anthropic कहता है कि अधिकांश सॉफ्टवेयर डेवलपमेंट और लाइफ साइंसेज कार्य अप्रभावित रहेंगे।
यह ऐसा पहला Sonnet भी है जो रीज़निंग एक्स्ट्रैक्शन ब्लॉक करने वाले क्लासिफायर के साथ आता है, और थिंकिंग ब्लॉक्स अब उस अकाउंट और बातचीत से बंधे हैं जिसने उन्हें उत्पन्न किया। यदि आप सिक्योरिटी टूलिंग चलाते हैं, तो पाइपलाइन बदलने से पहले अपने प्रॉम्प्ट्स का परीक्षण करें।
कुछ कोड बदलावों के साथ Sonnet 5 से माइग्रेट करें
सिर्फ मॉडल ID बदलना पर्याप्त नहीं है। Anthropic के दस्तावेज़ में Sonnet 5 पर पहले से चल रहे कोड के लिए पांच ब्रेकिंग चेंजेस सूचीबद्ध हैं:
-
एडेप्टिव थिंकिंग डिफॉल्ट रूप से ऑन है, और सबसे निम्न सेटिंग
between_toolsहै, जो upfront थिंकिंग बंद करती है। -
फोर्स्ड टूल यूज़ एक एरर लौटाता है।
-
थिंकिंग ब्लॉक्स उस मॉडल और बातचीत से बंधे हैं जिन्होंने उन्हें उत्पन्न किया।
-
पुराना
computer_20251124कंप्यूटर यूज़ टूल Claude API और Google Cloud पर रिजेक्ट हो जाता है। -
एडवाइजर टूल अब Opus 4.8, Opus 4.7, या Sonnet 5 को एडवाइजर के रूप में स्वीकार नहीं करता।
एक शांत बदलाव भी है: अब टूल कॉल्स के बीच का टेक्स्ट thinking ब्लॉक्स में आता है। कोई ऐप जो यूज़र्स को टेक्स्ट स्ट्रीम करता है, तब तक चुप रहेगा जब तक आप उसके display सेटिंग को अपडेट नहीं करते। temperature, top_p, या top_k को नॉन-डिफॉल्ट वैल्यू पर सेट करना भी 400 एरर देता है। ये वे खास चीजें हैं जो आपको पता चल सकती हैं।
बेंचमार्क्स पर Claude Sonnet 5.5 का प्रदर्शन कैसा है?
Anthropic द्वारा प्रकाशित हर बेंचमार्क पर Claude Sonnet 5.5 ने Sonnet 5 को पीछे छोड़ा, टर्मिनल कोडिंग पर Opus 5.5 को मात दी, और बाकी जगहों पर उससे कुछ अंकों से पीछे रहा। OpenAI के GPT-6 Sol के मुकाबले, यह नॉलेज-वर्क और चार्ट-रीडिंग इवैल्यूएशंस पर आगे है लेकिन FrontierCode पर पीछे। नीचे दिए सभी आंकड़े Anthropic के लॉन्च पोस्ट से हैं।
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% | Not reported |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | Not reported |
| FrontierCode 1.1 (Main) | 46.2% (max effort) | 42.4% | 54.4% | 49.3% (52.1% at xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (with tools) | 64.5% | 54.9% | 67.7% | Not reported |
| OSWorld 2.1 | 80.1% | 57.0% | 81.8% | Not reported |
| Chartography (no tools) | 61.6% | 15.6% | 64.4% | 53.6% |
तालिका एक सरल कहानी बताती है: Sonnet 5 पर एक बड़ी जनरेशन-स्तरीय छलांग, और Opus 5.5 के साथ लगभग टाई। आइए देखें कि आपके काम के लिए हर क्षेत्र का क्या मतलब है।
एजेंटिक कोडिंग
Terminal-Bench 4.0 वह जगह है जहां Sonnet 5.5 खुद को अलग करता है। यह 70.6% स्कोर करता है, जो Sonnet 5 के 10.3% से ऊपर और Opus 5.5 के 66.4% से आगे है। यह बेंचमार्क मापता है कि क्या कोई मॉडल कमांड-लाइन वातावरण में वास्तविक कार्य पूरे कर सकता है, जैसे मल्टी-स्टेप शेल वर्कफ्लोज़—यानी यह Claude Code के उपयोग से काफ़ी मेल खाता है।
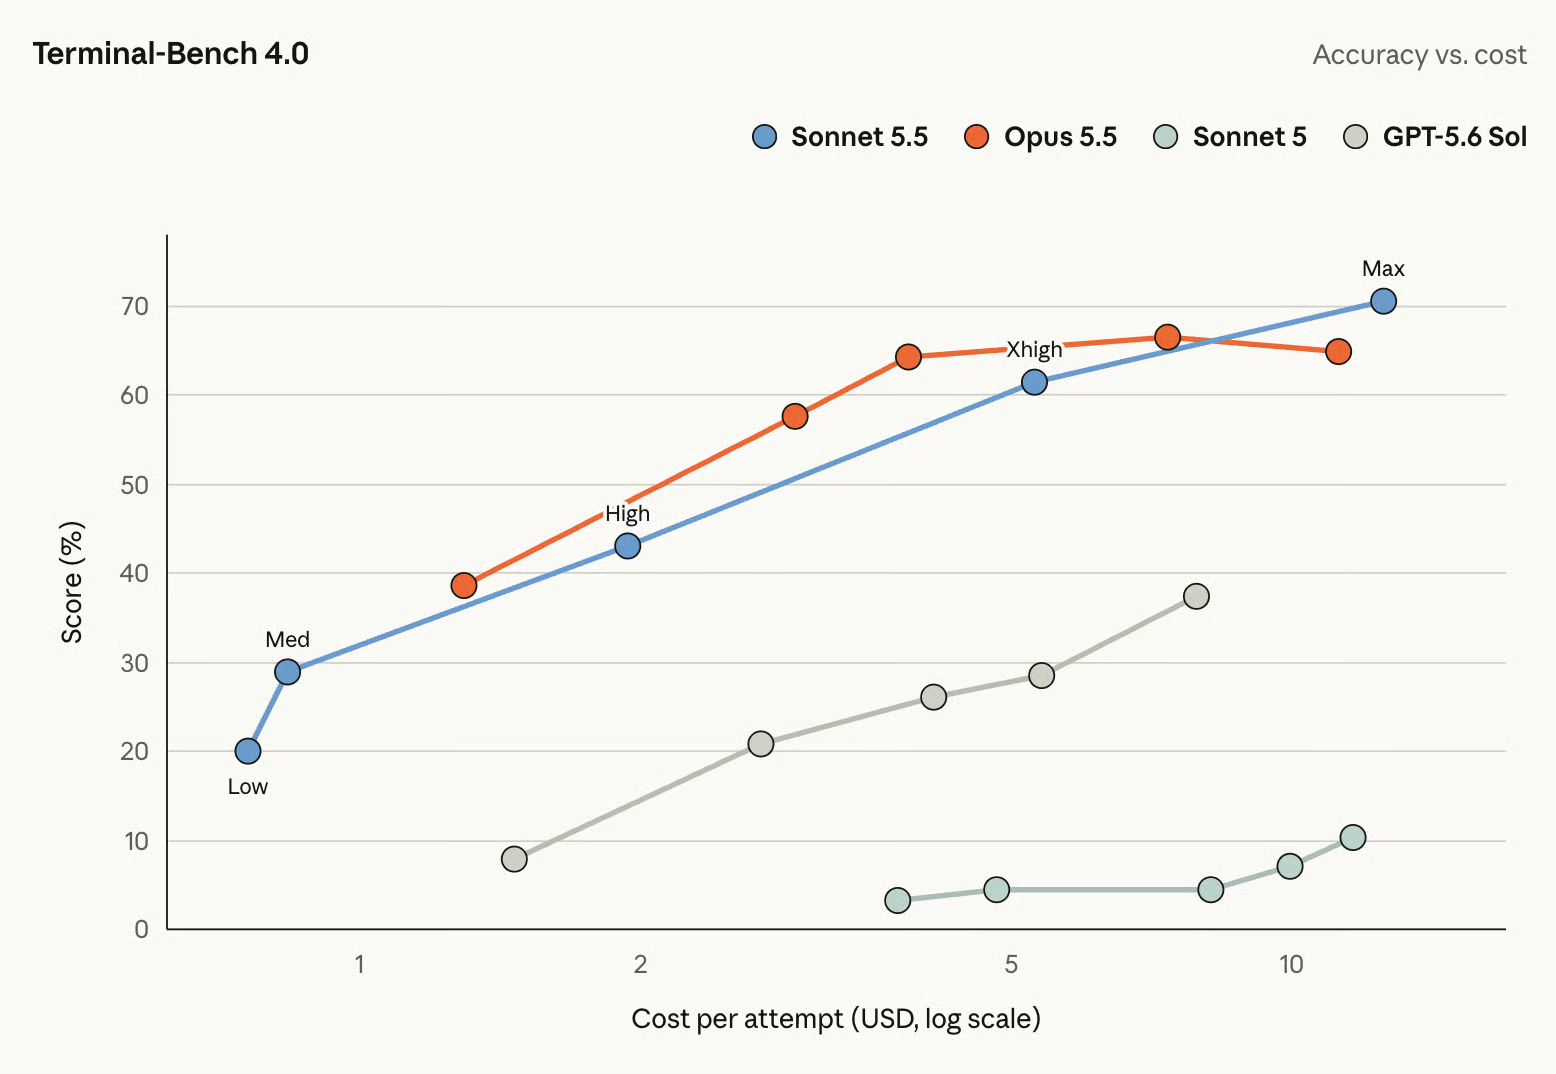
एक ही रिलीज़ में 60-पॉइंट की छलांग असामान्य ही है। बाकी कोडिंग तस्वीर कम नाटकीय है।
नॉलेज वर्क
GDPval-AA v2.1 पर, जो वास्तविक व्यवसायों से आर्थिक रूप से मूल्यवान कार्यों पर मॉडल आउटपुट को Elo-शैली के स्कोर से रेट करता है, Sonnet 5.5 1844 स्कोर करता है। यह Opus 5.5 से 2 अंक पीछे है और Sonnet 5 से लगभग 400 आगे।
रिपोर्ट्स, विश्लेषण, और व्यवसायिक दस्तावेज़ों के लिए Claude का उपयोग करने वाली टीमों के लिए, यह तालिका में सबसे उपयोगी परिणाम है। इस तरह के काम पर, Opus 5.5 की अतिरिक्त लागत बहुत थोड़ा ही खरीदती है।
रीज़निंग और विज़ुअल अंडरस्टैंडिंग
Chartography, जो बिना टूल्स के चार्ट्स को पढ़ने और उन पर तर्क करने का परीक्षण है, सबसे बड़ा सापेक्ष लाभ दिखाता है: Sonnet 5.5 61.6% स्कोर करता है जबकि Sonnet 5 15.6% पर था। यह Anthropic के बेहतर इमेज अंडरस्टैंडिंग के दावों से मेल खाता है।
कंप्यूटर उपयोग
OSWorld 2.1 पर, जो मापता है कि क्या कोई मॉडल वास्तविक डेस्कटॉप ऑपरेटिंग सिस्टम चलाकर कार्य पूरे कर सकता है, Sonnet 5.5 80.1% तक पहुंचता है—Sonnet 5 के 57.0% से ऊपर और Opus 5.5 से सिर्फ 2 अंकों के भीतर।
आपको कौन-सा टियर इस्तेमाल करना चाहिए?
अधिकांश डेवलपर्स के लिए, Sonnet 5.5 अब डिफॉल्ट Claude मॉडल होना चाहिए। Opus 5.5 अपनी ऊंची कीमत तभी कमाता है जब काम इतना खुला-छोर वाला हो कि बाधा स्पीड नहीं बल्कि निर्णय हो।
Anthropic की मॉडल तुलना तालिका के अनुसार मौजूदा लाइनअप इस प्रकार है। Haiku 4.5 को छोड़कर बाकी चारों मॉडल 1M-टोकन कॉन्टेक्स्ट विंडो और 128K अधिकतम आउटपुट साझा करते हैं।
| Model | Price (input / output per 1M tokens) | Latency | Best for |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Slower | टॉप-एंड काम जहाँ क्षमता लागत से अधिक मायने रखती है |
| Claude Opus 5.5 | $4 / $20 | Moderate | जटिल, खुले-छोर वाले काम जिन्हें निरंतर निर्णय चाहिए |
| Claude Sonnet 5.5 | $2 / $10 | Fast | अच्छी तरह-परिभाषित कोडिंग, एजेंट्स, और डॉक्यूमेंट कार्य |
| Claude Haiku 4.5 | $1 / $5 | Fastest | बड़े पैमाने, लागत-संवेदनशील कार्य |
Sonnet 5.5 के भीतर, “effort” सेटिंग दूसरा लीवर है। Anthropic ने पांच स्तरों को फिर से कैलिब्रेट किया है: low, medium, high, xhigh, और max। निचली सेटिंग्स स्पीड और लागत को तरजीह देती हैं, जबकि ऊंची सेटिंग्स मॉडल को ज्यादा देर तर्क करने और अपना काम जांचने देती हैं। डिफॉल्ट Claude ऐप्स और Claude Code में medium है, और API पर high।
लॉन्च पोस्ट का एक विवरण मेरे उपयोग को बदलता है: लो या मीडियम effort पर, Sonnet 5.5 कई बेंचमार्क्स पर Sonnet 5 के सर्वश्रेष्ठ स्कोर को प्रति टास्क लगभग दसवें हिस्से की लागत में पछाड़ देता है। संक्षेप में:
-
बग फिक्स, रिफैक्टर्स, और Claude Code सेशन्स: डिफॉल्ट effort पर Sonnet 5.5।
-
हाई-थ्रूपुट एजेंट लूप्स और पाइपलाइन्स:
lowयाmediumपर Sonnet 5.5, फिर केवल असफलताओं पर effort बढ़ाएं। -
साफ स्पेक वाले कठिन कोडिंग प्रॉब्लम्स: Opus का खर्चा करने से पहले
xhighयाmaxपर Sonnet 5.5। -
अस्पष्ट, कई-दिनों के प्रोजेक्ट्स: Opus 5.5।
Claude Sonnet 5.5 का परीक्षण: हैंड्स-ऑन उदाहरण
उपरोक्त बेंचमार्क Anthropic के अपने हैं, इसलिए मैंने एक बिल्ड टास्क Claude Sonnet 5.5 और Claude Sonnet 5 पर एक समान प्रॉम्प्ट और एक समान टूलिंग के साथ चलाया।
टास्क: FiveThirtyEight के recent college grads डेटासेट (173 U.S. मेजर्स, CC BY 4.0) को एक सिंगल-फाइल HTML डैशबोर्ड में बदलना, जो किसी भविष्य के छात्र को अर्निंग्स और एम्प्लॉयमेंट पर केटेगरीज़ की तुलना करने और सबसे अधिक तथा सबसे कम कमाने वाले मेजर्स खोजने में मदद करे।
वास्तविक टेस्ट डेटा में है, जिसमें कुछ विशेषताएं हैं जिनका प्रॉम्प्ट कभी ज़िक्र नहीं करता:
- टॉप अर्नर, Petroleum Engineering, में केवल 36 सर्वे उत्तरदाता हैं, और 173 में से 76 मेजर्स में 100 से कम हैं
- अर्निंग्स स्क्योड हैं, इसलिए एक अकेला मीडियन बार बहुत कुछ छुपा देता है
- एक मेजर, Food Science, में हेडकाउंट फील्ड्स खाली हैं
- जॉब-टाइप कॉलम्स नियोजित लोगों की संख्या के बराबर नहीं जोड़ते
इन मुद्दों को नोटिस करना ही टेस्ट का मकसद है। टेस्ट Anthropic के “डिज़ाइन के लिए तेज़ नजर” वाले दावे की पड़ताल करता है।
मुख्य निष्कर्ष:
- सिर्फ Sonnet 5.5 ने काम करता हुआ डैशबोर्ड डिलीवर किया। Sonnet 5 ने एक Chart.js फाइल से लिंक किया जो cdnjs पर मौजूद ही नहीं है (URL 404 लौटाता है), इसलिए लाइब्रेरी कभी लोड ही नहीं हुई और हर पैनल, उसके सादे टेबल्स सहित, खाली रेंडर हुए। Sonnet 5.5 यह भी चेक करता है कि उसकी चार्ट लाइब्रेरी लोड हुई या नहीं और यदि नहीं हुई तो भी अपने टेबल्स को काम करता रखता है।
- Sonnet 5.5 ने छोटे-सैंपल का जाल पकड़ा, ज्यादातर हद तक। यह 30 से कम उत्तरदाताओं वाले मेजर्स को “सावधानी से लें” के रूप में मार्क करता है और एक न्यूनतम-उत्तरदाता फ़िल्टर जोड़ता है। उसका डिफॉल्ट व्यू Petroleum Engineering को #1 पर रखता है, बिना चेतावनी के।
- Sonnet 5 इसे वैसे भी मिस कर देता। उसका कोड सैंपल-साइज़ और सैलरी-रेंज कॉलम्स को पढ़ता है, फिर उनका कभी उपयोग नहीं करता, और केवल मीडियन के आधार पर मेजर्स को रैंक करता है।
- छोटे जाल किसी को नहीं फंसाए। दोनों ने खाली Food Science पंक्ति को स्पष्ट रूप से संभाला, और Sonnet 5.5 ने अपने कॉलेज-जॉब शेयर की गणना इस तरह की कि जॉब कॉलम्स के कुल रोजगार के बराबर होने का संकेत न मिले।
यह रहा Sonnet 5.5 का डैशबोर्ड, जिसमें फ़िल्टर कम-से-कम 100 उत्तरदाताओं वाले मेजर्स पर सेट है।
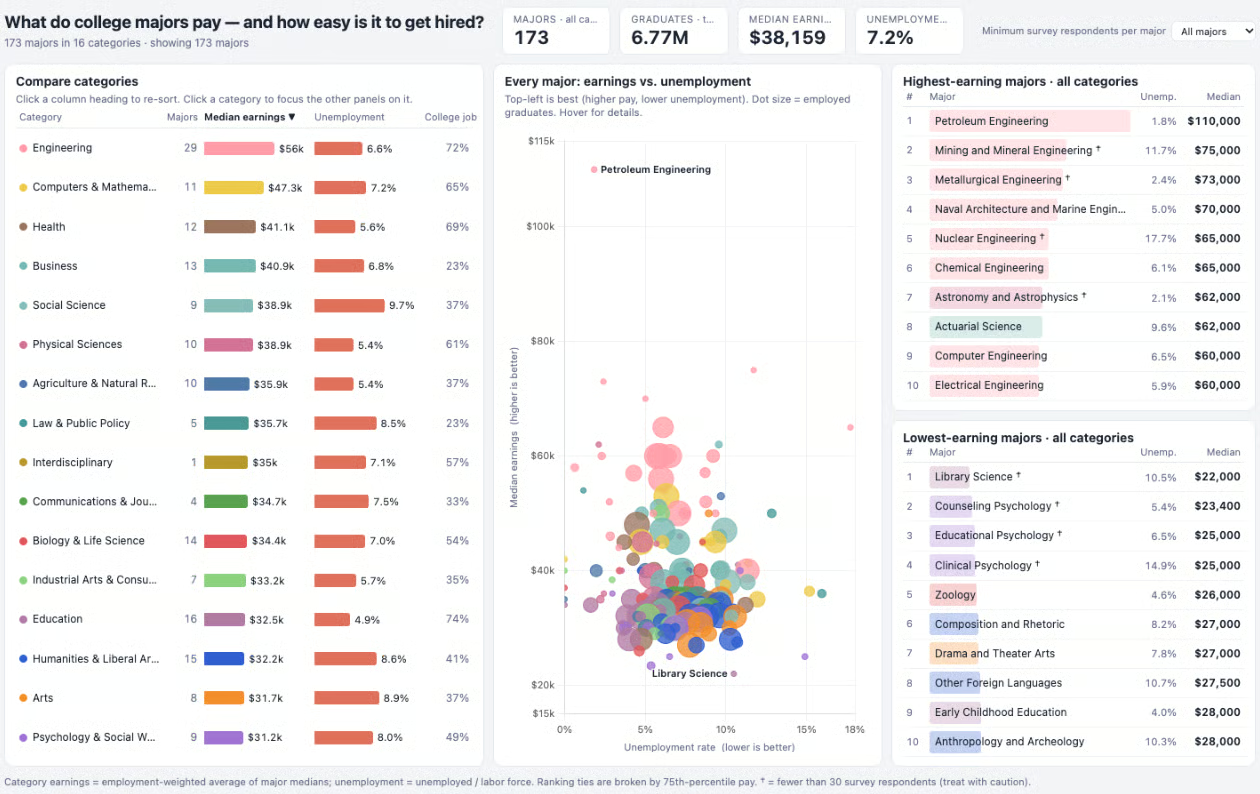
मैंने Sonnet 5.5 के डैशबोर्ड को ईमानदार डेटा हैंडलिंग के लिए 5 में से 4, विश्लेषणात्मक उपयोगिता के लिए 5, और चार्ट व लेआउट क्वालिटी के लिए 4 अंक दिए। Sonnet 5 का खाली पेज नीचे शामिल कर रहा हूँ।
तो Sonnet 5 असफल क्यों हुआ? समस्या यह थी कि डैशबोर्ड को एक चार्टिंग लाइब्रेरी चाहिए थी। Sonnet 5 ने cdnjs से एक ऐसा वर्ज़न मांगा जो वह होस्ट नहीं करता। फिर उसे “404” एरर मिला। लाइब्रेरी के बिना, Sonnet 5 का कोड क्रैश हो गया: “Chart is not defined.” जाहिर है, Sonnet 5 ने पेज इस तरह लिखा था कि सब कुछ, उसके सादे टेक्स्ट टेबल्स भी, उसी स्टेप के बाद रन होते थे, और वह गलती पकड़ नहीं सका।
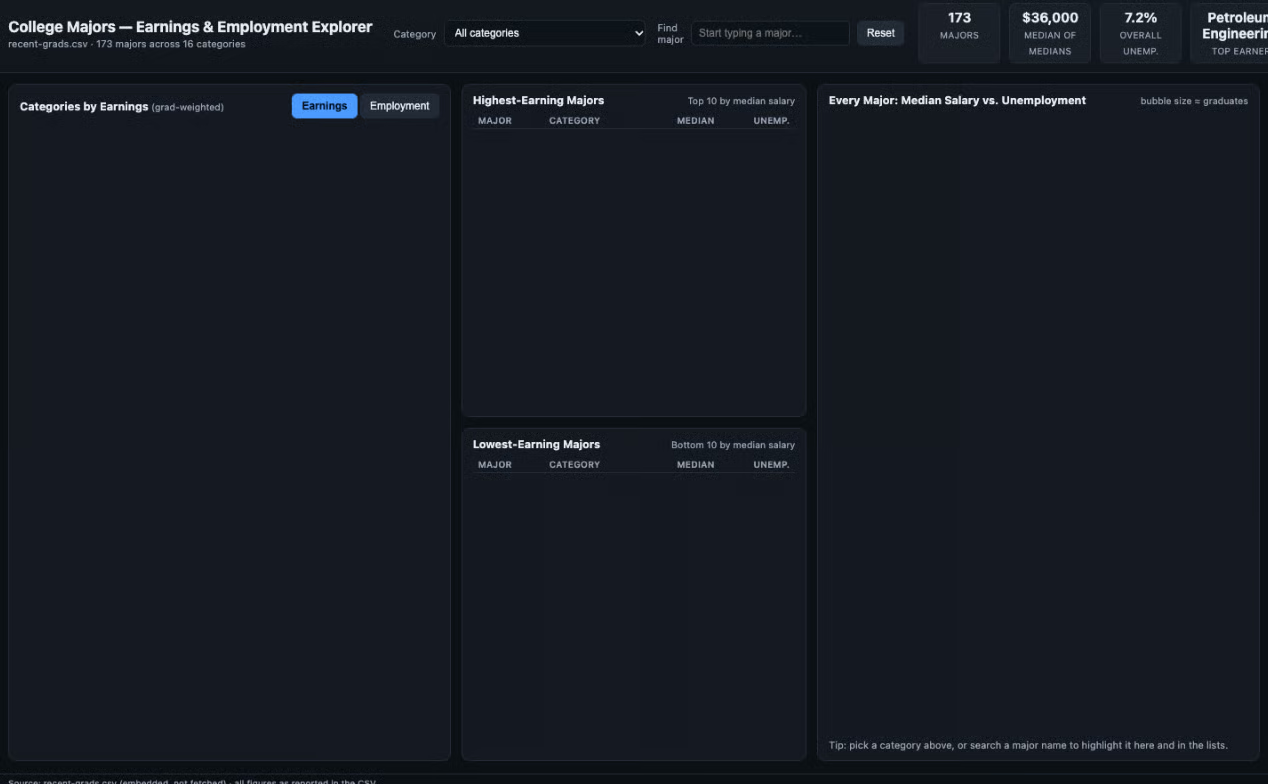
प्रति रन लागत मूलतः समान थी: Sonnet 5.5 के लिए $0.56 और Sonnet 5 के लिए $0.57। साथ ही, Sonnet 5.5 ने काम तेज़ी से पूरा किया।
तो क्या Sonnet 5.5 सच में एक कदम आगे है? इस टास्क पर, हाँ। Sonnet 5.5 ने काम करता हुआ डैशबोर्ड भेजा जो पतले डेटा के बारे में चेतावनी भी देता है, जबकि Sonnet 5 ने खाली पेज भेजा।
Claude Sonnet 5.5 की प्राइसिंग और उपलब्धता
Claude Sonnet 5.5 की कीमत API पर प्रति मिलियन इनपुट टोकन्स $2 और प्रति मिलियन आउटपुट टोकन्स $10 है, जो Sonnet 5 जैसी ही है और Opus 5.5 की आधी। Anthropic प्रति टास्क कम टोकन्स की रिपोर्ट करता है, जो दर फ्लैट होने के बावजूद किसी जॉब की प्रभावी लागत को कम करेगा। हालांकि, हमारे हैंड्स-ऑन टेस्ट में, दोनों मॉडलों की टास्क पूरी करने की लागत लगभग समान थी।
| Token type | Price per 1M tokens |
|---|---|
| Input | $2 |
| Output | $10 |
| Cache write (5-minute) | $2.50 |
| Cache write (1-hour) | $4 |
| Cache read | $0.20 |
Batch API इनपुट और आउटपुट—दोनों पर 50% की छूट देता है। न्यूनतम कैश योग्य प्रॉम्प्ट 512 टोकन्स है, और Batch API पर मॉडल output-300k-2026-03-24 बीटा हेडर के साथ 300K तक आउटपुट टोकन्स लौटा सकता है।
Sonnet 5.5 जनरल उपलब्ध है, प्रीव्यू नहीं, और ज़ीरो डेटा रिटेंशन का विकल्प देता है। Anthropic इसे 28 सितंबर, 2027 से पहले रिटायर न करने की प्रतिबद्धता देता है।
Claude Sonnet 5.5 तक एक्सेस कैसे पाएं?
आप Claude Sonnet 5.5 का उपयोग आज ही Claude ऐप्स, Claude Code, और API के जरिए मॉडल ID claude-sonnet-5-5 के साथ कर सकते हैं। यह Amazon Bedrock पर anthropic.claude-sonnet-5-5 के रूप में, और Google Cloud, Microsoft Foundry, तथा AWS पर Claude Platform पर claude-sonnet-5-5 के तहत भी उपलब्ध है।
यह रहा एक न्यूनतम Python कॉल। एडेप्टिव थिंकिंग डिफॉल्ट रूप से ऑन है, इसलिए रिस्पॉन्स में टेक्स्ट से पहले थिंकिंग ब्लॉक्स शामिल हो सकते हैं:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
कुंजियों, लागत, और आपके पहले प्रोजेक्ट का एक वास्तविक walkthrough के लिए हमारा Claude API का संपूर्ण गाइड देखें। यदि आप एजेंट्स बना रहे हैं, तो Claude Managed Agents बनाने पर हमारा ट्यूटोरियल अगला अच्छा कदम है। हम जल्द ही Claude Sonnet 5.5 API पर ट्यूटोरियल प्रकाशित करेंगे।
अंतिम विचार
Anthropic यह दांव लगा रहा है कि अधिकांश पेड वर्क, जिसमें अधिकांश कोडिंग-एजेंट वर्क भी शामिल है, इस नए मिड-टियर मॉडल पर चलेगा। यह OpenAI के GPT-6 Sol पर भी सीधा दबाव डालता है, जो Anthropic के नॉलेज-वर्क नंबरों पर इससे पीछे है।
यदि आप Sonnet 5 पर हैं तो मैं अभी स्विच करूँगा, लेकिन API बदलावों पर खुद को अपडेट ज़रूर करें। वे प्रोजेक्ट्स जिनमें मॉडल को तय करना होता है कि क्या बनाना है, उनके लिए Opus 5.5 रखें।
यदि आप Anthropic के मॉडलों के साथ बिल्डिंग के बारे में और सीखना चाहते हैं, तो मैं हमारे Introduction to Claude Models कोर्स को देखने की सलाह देता हूँ।