หกวันหลังจาก Anthropic วาง Claude Opus 5.5 ไว้บนสุดของไลน์อัป โมเดลระดับกลางก็ไล่ช่องว่างส่วนใหญ่ทันที่ครึ่งราคา Claude Sonnet 5.5 ชนะ Opus 5.5 ในหนึ่งเกณฑ์ทดสอบ และตามหลังเพียงไม่กี่คะแนนในด้านอื่น ๆ ทั้งหมด โดยยังคงราคาเท่า Sonnet 5
รูปแบบนี้เคยเห็นมาแล้ว Claude Sonnet 5 เปิดตัวโดยเข้าใกล้คะแนน agentic ของ Opus 4.8 ที่ต้นทุนเพียงเศษเสี้ยว ก่อนหน้านั้น Sonnet 4.6 ก็ทำคะแนนไล่ชิด Opus 4.6 ในเงื่อนไขเดียวกัน ทุกครั้ง โมเดลระดับกลางจะตามหลังเรือธงเพียงไม่กี่วันหรือสัปดาห์ แล้วปิดช่องว่างส่วนใหญ่ได้ที่ครึ่งราคา
นี่คือหน้าตาของเส้นโค้งสเกลแบบลอการิทึมจากมุมมองภายนอก ประสิทธิภาพเพิ่มขึ้นโดยประมาณตามลอการิทึมของคอมพิวต์ ดังนั้นต้นทุนจึงเพิ่มขึ้นแบบเอ็กซ์โปเนนเชียลตามประสิทธิภาพ โมเดลเรือธงอยู่บนยอดเส้นโค้งนั้น ซึ่งต้องจ่ายหนักเพื่อแลกกับคะแนนท้าย ๆ โมเดลที่ถูกกว่าสร้างหลังจากนั้นไม่กี่สัปดาห์ ได้อานิสงส์จากความก้าวหน้าเดียวกัน จึงต้องไต่ขึ้นไปถึงจุดที่ต่ำกว่าเพื่อให้ดูใกล้เคียงกัน กล่าวอีกนัยหนึ่ง มูลค่าส่วนใหญ่บนเส้นโค้งยังคงได้มาด้วยต้นทุนต่ำ มีเพียงช่วงสุดท้ายเท่านั้นที่แพง
น่าจะแยกแยะประเด็นนี้ไว้ เพราะบริษัทผู้นำตลาดมักใช้เล่ห์เหลี่ยมด้าน PR และการสร้างแบรนด์อยู่บ้าง
สรุปสั้น ๆ
- Sonnet 5.5 คือโมเดลระดับกลางตัวใหม่ของ Anthropic มาแทน Sonnet 5 ที่ราคาเดิม
- ไฮไลต์คือการโค้ดแบบ agentic ในเทอร์มินัล ซึ่งตอนนี้แซงหน้า Opus 5.5 ได้จริง
- ด้านงานความรู้และการใช้งานคอมพิวเตอร์ อยู่ถัดจาก Opus 5.5 เพียงเล็กน้อยที่ครึ่งราคาต่อโทเค็น
- ตั้งให้เป็นโมเดล Claude ค่าเริ่มต้น แล้วเก็บ Opus 5.5 ไว้สำหรับงานปลายเปิดที่ต้องใช้ดุลยพินิจสูง
Claude Sonnet 5.5 คืออะไร?
เอกสารโมเดลของ Anthropic อธิบายว่า Claude Sonnet 5.5 คือ “ส่วนผสมที่ดีที่สุดของความเร็วและความฉลาด” ในไลน์อัปปัจจุบัน เป็นโมเดลระดับกลางในตระกูล Claude 5.5 ของ Anthropic อยู่ระหว่างเรือธง Claude Opus 5.5 และ Claude Haiku 5.5 ที่กำลังจะมา (จะอัปเดตความคืบหน้า Haiku 5.5 ให้ทราบ แม้ Haiku 5 จะไม่เคยมา)
เมื่อเทียบกับ Sonnet 5 การก้าวกระโดดครั้งนี้ใหญ่กว่าหมายเลขเวอร์ชัน .5 จะชี้นำ ไม่แปลกใจหลังจากเห็นว่าช่องว่างระหว่าง Opus 5.5 กับ Opus 5 ก็ใหญ่กว่าที่คาด
สำหรับโพสต์เปิดตัว—Anthropic รายงานว่าดีขึ้นในทุกเกณฑ์ทดสอบที่เผยแพร่ โดยกระโดดมากที่สุดในงานโค้ดเทอร์มินัล การอ่านกราฟ และการประเมินงานความรู้
ที่น่าสนใจ Anthropic ระบุว่า Sonnet รุ่นนี้เป็นรุ่นแรกที่เล่น Pokémon Red ได้โดยใช้แค่ภาพหน้าจอ ฟังดูแปลก แต่เป็นแบบทดสอบที่ Anthropic ใช้แทนงานระยะยาวและความเข้าใจภาพ
ดังนั้น Opus 5.5 จึงยังคงแข็งแกร่งกว่าอย่างชัดเจนในงานซับซ้อน ปลายเปิด ที่ต้องอาศัยดุลยพินิจต่อเนื่อง แต่ Sonnet 5.5 เหมาะกับงานที่รู้ชัดว่าหน้าตา “เสร็จ” เป็นอย่างไร ซึ่งเป็นฮิวริสติกที่ช่วยได้มาก
ฟีเจอร์เด่นของ Claude Sonnet 5.5
สิ่งใหม่ส่วนใหญ่ใน Sonnet 5.5 มุ่งทำงานเดิมให้เร็วขึ้นและใช้โทเค็นน้อยลง พร้อมการเปลี่ยนแปลงบางอย่างที่ผู้ใช้ API ต้องวางแผนรับมือ
ได้ผลลัพธ์ใกล้ Opus ในงานประจำที่ความเร็วแบบ Sonnet
งานที่ก่อนหน้านี้เหมาะกับ Opus ตอนนี้ส่งให้ Sonnet 5.5 ทำและได้กลับมาไวกว่า Anthropic ระบุว่าการสร้างเอาต์พุตเร็วกว่า Sonnet 5 มากกว่า 30% และโมเดลใช้โทเค็นต่อภารกิจน้อยลง—“สูงสุด 30% ต่อภารกิจ” คือค่าที่ระบุไว้
ผู้ทดสอบช่วงต้นที่ถูกอ้างในโพสต์เปิดตัวสนับสนุนด้วยตัวเลขของตนเอง:
- Base44 รายงาน 3.6 รอบต่อการบิลด์แอปด้วย Sonnet 5.5 เทียบกับ 7.7 ด้วย Opus 5
- Box เห็นเวิร์กโหลดเร็วขึ้น 2.4 เท่า โดยใช้โทเค็นรวมน้อยลง 12%
- Zendesk วัดว่าประมวลผลทิกเก็ตเร็วขึ้น 20%
- Slack รายงานโทเค็นเอาต์พุตน้อยลงราว 14%
แม้จะเป็นคำกล่าวอ้างที่คัดจากลูกค้า แต่เห็นแพทเทิร์นชัด คือรอบทำงานน้อยลงและโทเค็นน้อยลง ซึ่งมีผลต่อบิล นอกเหนือจากอัตราต่อโทเค็น
รันเอเจนต์สำหรับโค้ดในเทอร์มินัลและบนเดสก์ท็อป
Sonnet 5.5 ถูกสร้างมาให้ทำงานแบบเอเจนต์: รันคำสั่งเชลล์ แก้บั๊กทั้งรีโพ และควบคุมเดสก์ท็อปผ่านภาพหน้าจอ ใช้งานได้ใน Claude Code ตั้งแต่เปิดตัว และ Anthropic ระบุว่าความสามารถใช้งานคอมพิวเตอร์ใกล้กับ Opus 5.5
ผลลัพธ์เชิงปฏิบัติสำหรับหลายคนคือ Sonnet 5.5 เป็นค่าเริ่มต้นที่น่าเชื่อถือสำหรับเซสชัน Claude Code และลูปเอเจนต์ที่สร้างเองด้วย คู่มือ Claude API ของเรา
ผลิตเอกสาร สไลด์ และอินเทอร์เฟซที่ดูเรียบร้อย
Anthropic ชูจุดแข็ง “สายตาแหลมคมด้านดีไซน์” ของ Sonnet 5.5 ในทางปฏิบัติ น่าจะหมายถึง UI ที่ดูดีขึ้นเมื่อให้ปรับแต่งโค้ดฝั่งหน้าบ้าน และเอาต์พุตที่ดูเสร็จสมบูรณ์ยิ่งขึ้นเมื่อขอให้ทำสไลด์ สเปรดชีต หรือเอกสารยาว
ข้ออ้างเรื่องดีไซน์นี่เองที่ควรตรวจสอบอิสระมากที่สุด วัดเป็นเกณฑ์ยาก และโพสต์เปิดตัวสนับสนุนเพียงด้วยคำกล่าวจากลูกค้า
คาดหวังมาตรการคุ้มกันด้านความปลอดภัยและชีววิทยา
Sonnet 5.5 เป็น Sonnet รุ่นแรกที่เปิดตัวพร้อมมาตรการคุ้มกันไซเบอร์คล้ายกับของ Opus 5.5 เมื่อคำขอถูกจัดเป็นงานความปลอดภัยที่เสี่ยงสูง ระบบจะถอยกลับไปใช้ Sonnet 5 มาตรการด้านชีววิทยาเหมือน Sonnet 5 และ Anthropic ระบุว่างานพัฒนาซอฟต์แวร์และวิทยาศาสตร์ชีวภาพส่วนใหญ่จะไม่กระทบ
ยังเป็น Sonnet รุ่นแรกที่มาพร้อมตัวจัดประเภทซึ่งบล็อกการดึงเหตุผล และบล็อกการคิดจะผูกกับบัญชีและบทสนทนาที่สร้างมันขึ้นมา หากรันเครื่องมือความปลอดภัย ควรทดสอบพรอมป์ตก่อนสลับไปป์ไลน์
ย้ายจาก Sonnet 5 ด้วยการแก้โค้ดเล็กน้อย
แค่สลับรหัสโมเดลยังไม่พอ เอกสารของ Anthropic ระบุการเปลี่ยนแปลงที่ทำให้โค้ดเดิมพัง 5 รายการสำหรับโค้ดที่รันบน Sonnet 5 อยู่แล้ว:
-
Adaptive thinking เปิดเป็นค่าเริ่มต้น และค่าต่ำสุดคือ
between_toolsซึ่งปิดการคิดล่วงหน้า -
การบังคับใช้เครื่องมือจะส่งคืนข้อผิดพลาด
-
บล็อกการคิดจะผูกกับโมเดลและบทสนทนาที่สร้างมันขึ้นมา
-
เครื่องมือใช้งานคอมพิวเตอร์รุ่นเก่า
computer_20251124จะถูกปฏิเสธบน Claude API และ Google Cloud -
เครื่องมือ advisor ไม่ยอมรับ Opus 4.8, Opus 4.7 หรือ Sonnet 5 เป็นที่ปรึกษาอีกต่อไป
ยังมีการเปลี่ยนแปลงเงียบ ๆ อีกอย่าง: ข้อความระหว่างการเรียกเครื่องมือจะถูกส่งกลับในบล็อก thinking แอปที่สตรีมข้อความให้ผู้ใช้จะเงียบระหว่างการเรียกเครื่องมือ จนกว่าจะอัปเดตการตั้งค่า display การตั้งค่า temperature, top_p หรือ top_k เป็นค่าที่ไม่ใช่ค่าเริ่มต้นจะส่งคืนข้อผิดพลาด 400 นี่เป็นรายละเอียดเฉพาะที่อาจพบเจอ
Claude Sonnet 5.5 ทำผลงานอย่างไรบนเกณฑ์ทดสอบ?
Claude Sonnet 5.5 ชนะ Sonnet 5 ในทุกเกณฑ์ที่ Anthropic เผยแพร่ ชนะ Opus 5.5 ในงานโค้ดเทอร์มินัล และตาม Opus 5.5 เพียงไม่กี่คะแนนในด้านอื่น เทียบกับ GPT-6 Sol ของ OpenAI นำหน้าในงานความรู้และการอ่านกราฟ แต่ตามหลังใน FrontierCode ตัวเลขทั้งหมดด้านล่างมาจากโพสต์เปิดตัวของ Anthropic
| เกณฑ์ทดสอบ | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% | ไม่ระบุ |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | ไม่ระบุ |
| FrontierCode 1.1 (หลัก) | 46.2% (max effort) | 42.4% | 54.4% | 49.3% (52.1% ที่ xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (with tools) | 64.5% | 54.9% | 67.7% | ไม่ระบุ |
| OSWorld 2.1 | 80.1% | 57.0% | 81.8% | ไม่ระบุ |
| Chartography (ไม่มีเครื่องมือ) | 61.6% | 15.6% | 64.4% | 53.6% |
ตารางบอกเรื่องง่าย ๆ: ก้าวกระโดดใหญ่เหนือ Sonnet 5 และเกือบเสมอกับ Opus 5.5 มาดูว่าแต่ละด้านหมายถึงอะไรต่อการทำงาน
การโค้ดแบบเอเจนต์
Terminal-Bench 4.0 คือจุดที่ Sonnet 5.5 แยกตัวออกมา คะแนน 70.6% จาก 10.3% ของ Sonnet 5 และเหนือ 66.4% ของ Opus 5.5 เกณฑ์นี้วัดว่าโมเดลทำงานจริงในสภาพแวดล้อมบรรทัดคำสั่งได้หรือไม่ เช่น เวิร์กโฟลว์เชลล์หลายขั้นตอน จึงสอดคล้องกับวิธีใช้ Claude Code อย่างใกล้ชิด
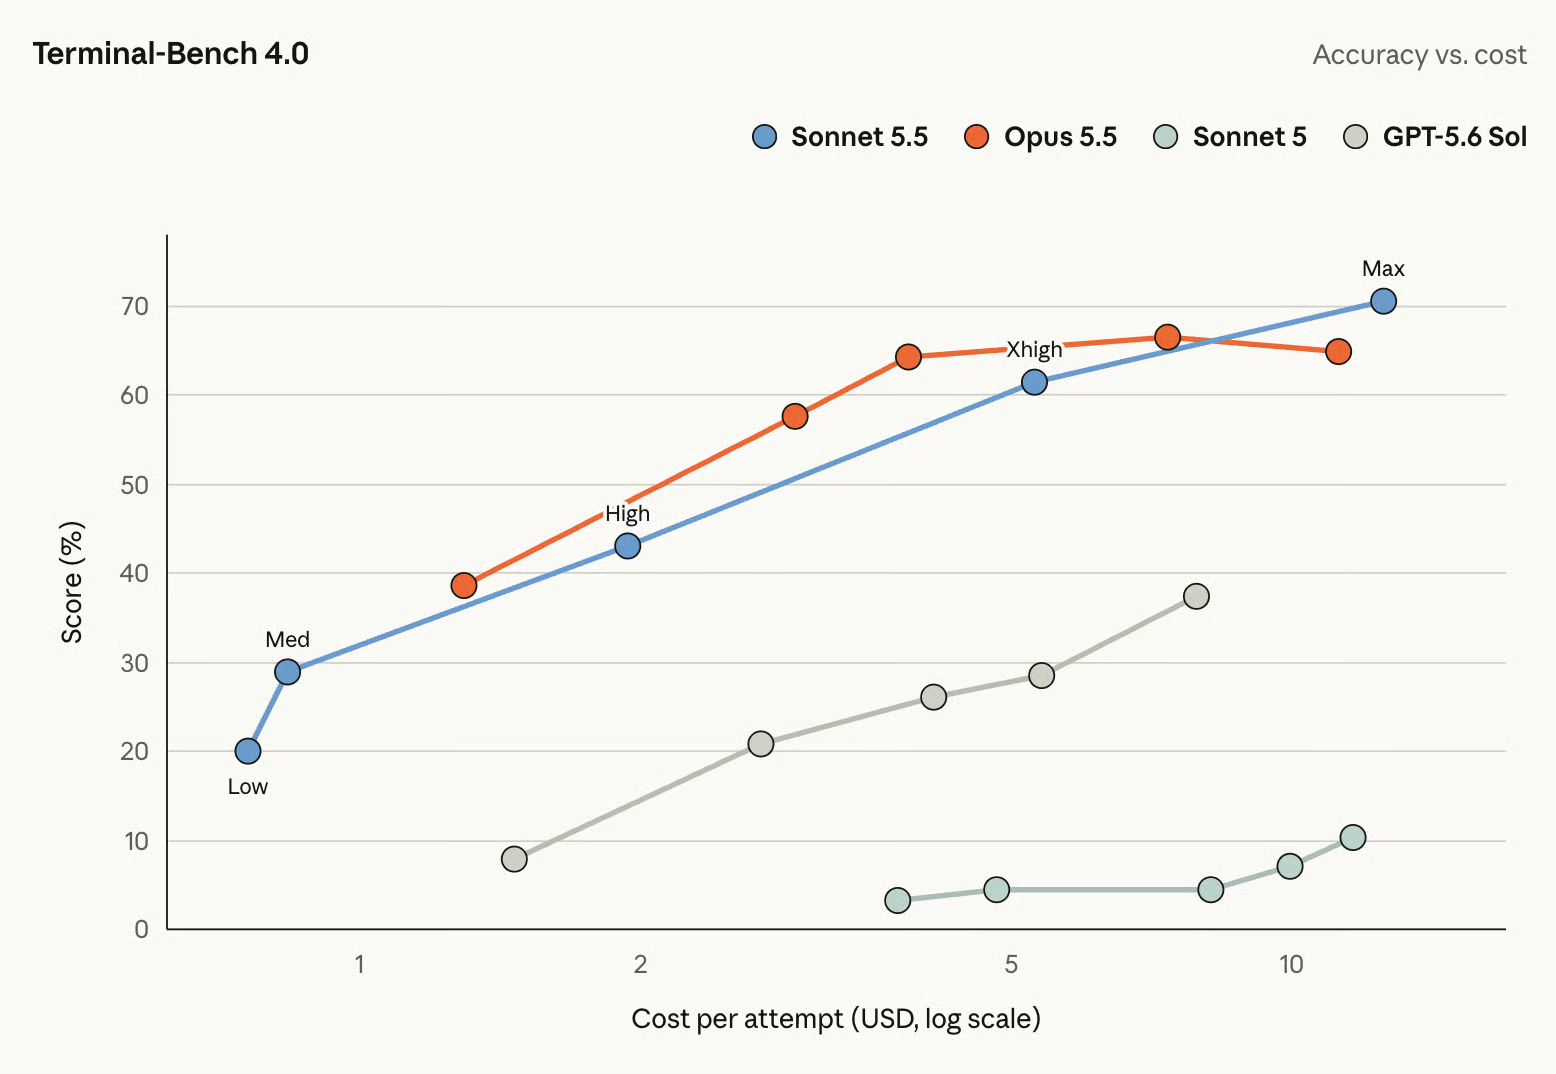
การกระโดด 60 คะแนนในรุ่นเดียวถือว่าแปลกตา ส่วนภาพรวมงานโค้ดด้านอื่นไม่หวือหวาเท่า
งานความรู้
บน GDPval-AA v2.1 ซึ่งให้คะแนนเอาต์พุตของโมเดลในงานที่มีมูลค่าทางเศรษฐกิจจากอาชีพจริงแบบ Elo Sonnet 5.5 ทำได้ 1844 ห่าง Opus 5.5 อยู่ 2 แต้ม และนำหน้า Sonnet 5 เกือบ 400 แต้ม
สำหรับทีมที่ใช้ Claude ทำรายงาน วิเคราะห์ และเอกสารธุรกิจ นี่คือผลที่เป็นประโยชน์ที่สุด ในงานลักษณะนี้ ต้นทุนส่วนเพิ่มของ Opus 5.5 ซื้อได้คะแนนเพิ่มเพียงเล็กน้อย
การให้เหตุผลและความเข้าใจเชิงภาพ
Chartography แบบทดสอบการอ่านและให้เหตุผลจากกราฟโดยไม่ใช้เครื่องมือ แสดงการเพิ่มขึ้นสัมพัทธ์ที่ใหญ่ที่สุด: Sonnet 5.5 ได้ 61.6% เทียบกับ 15.6% ของ Sonnet 5 สอดคล้องกับคำกล่าวของ Anthropic เรื่องความเข้าใจภาพที่ดีขึ้น
การใช้งานคอมพิวเตอร์
บน OSWorld 2.1 ซึ่งวัดว่าโมเดลทำงานสำเร็จได้โดยการควบคุมระบบปฏิบัติการเดสก์ท็อปจริงหรือไม่ Sonnet 5.5 ไปถึง 80.1% จาก 57.0% ของ Sonnet 5 และตามหลัง Opus 5.5 เพียง 2 แต้ม
ควรใช้รุ่นไหน?
สำหรับนักพัฒนาส่วนใหญ่ ตอนนี้ Sonnet 5.5 ควรเป็นโมเดล Claude ค่าเริ่มต้น Opus 5.5 คุ้มราคาที่สูงกว่าก็ต่อเมื่อภารกิจปลายเปิดมากพอที่ดุลยพินิจ ไม่ใช่ความเร็ว เป็นคอขวด
ไลน์อัปปัจจุบันตามตารางเปรียบเทียบโมเดลของ Anthropic เป็นดังนี้ โมเดลทั้งสี่ยกเว้น Haiku 4.5 มีหน้าต่างบริบท 1M โทเค็นและเอาต์พุตสูงสุด 128K
| โมเดล | ราคา (อินพุต / เอาต์พุต ต่อ 1M โทเค็น) | Latency | เหมาะสำหรับ |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | ช้ากว่า | งานระดับบนที่ความสามารถสำคัญกว่าต้นทุน |
| Claude Opus 5.5 | $4 / $20 | ปานกลาง | งานซับซ้อน ปลายเปิด ที่ต้องใช้ดุลยพินิจต่อเนื่อง |
| Claude Sonnet 5.5 | $2 / $10 | เร็ว | งานโค้ดที่กำหนดขอบเขตชัด เอเจนต์ และงานเอกสาร |
| Claude Haiku 4.5 | $1 / $5 | เร็วที่สุด | งานปริมาณมาก อ่อนไหวต่อต้นทุน |
ภายใน Sonnet 5.5 การตั้งค่า effort คือคันโยกอีกตัว Anthropic ปรับคาลิเบรต 5 ระดับ: low, medium, high, xhigh และ max ระดับต่ำเน้นความเร็วและต้นทุน ระดับสูงเปิดให้โมเดลใช้เหตุผลนานขึ้นและตรวจงานตัวเอง ค่าเริ่มต้นคือ medium ในแอป Claude และ Claude Code และ high บน API
รายละเอียดหนึ่งจากโพสต์เปิดตัวทำให้วิธีใช้งานเปลี่ยน: ที่ effort ระดับ low หรือ medium Sonnet 5.5 ชนะคะแนนดีที่สุดของ Sonnet 5 บนเกณฑ์หลายตัวด้วยต้นทุนต่อภารกิจราวหนึ่งในสิบ โดยสรุป:
-
แก้บั๊ก รีแฟกเตอร์ และเซสชัน Claude Code: Sonnet 5.5 ที่ effort ค่าเริ่มต้น
-
ลูปเอเจนต์และไปป์ไลน์ที่ต้องการงานผ่านจำนวนมาก: Sonnet 5.5 ที่
lowหรือmediumแล้วค่อยเพิ่ม effort เฉพาะเคสที่ล้มเหลว -
ปัญหาโค้ดยากที่สเปกระบุชัด: Sonnet 5.5 ที่
xhighหรือmaxก่อนจะยอมจ่ายให้ Opus -
โปรเจ็กต์กำกวม หลายวัน: Opus 5.5
ทดสอบ Claude Sonnet 5.5: ตัวอย่างใช้งานจริง
เกณฑ์ด้านบนเป็นของ Anthropic เอง จึงรันงานบิลด์หนึ่งงานกับ Claude Sonnet 5.5 และ Claude Sonnet 5 ด้วยพรอมป์ตและเครื่องมือชุดเดียวกัน
โจทย์: แปลงชุดข้อมูล recent college grads ของ FiveThirtyEight (สาขาวิชาในสหรัฐ 173 สาขา, CC BY 4.0) ให้เป็นแดชบอร์ด HTML ไฟล์เดียวที่ช่วยนักเรียนอนาคตเทียบหมวดหมู่ตามรายได้และการจ้างงาน และค้นหาสาขาที่รายได้สูงสุดและต่ำสุด
บททดสอบจริงอยู่ในข้อมูล ซึ่งมีลักษณะบางอย่างที่พรอมป์ตไม่ได้เอ่ยถึง:
- ผู้มีรายได้สูงสุด Petroleum Engineering มีผู้ตอบแบบสำรวจเพียง 36 คน และ 76 จาก 173 สาขามีไม่ถึง 100 คน
- การกระจายรายได้เอนเอียงมาก แท่งมัธยฐานแท่งเดียวซ่อนความแปรปรวนไว้มาก
- หนึ่งสาขา Food Science มีช่องจำนวนคนว่างเปล่า
- คอลัมน์ประเภทงานรวมกันแล้วไม่เท่าจำนวนผู้มีงานทำ
การสังเกตประเด็นเหล่านี้คือหัวใจของบททดสอบ ทดสอบคำกล่าวของ Anthropic เรื่อง “สายตาแหลมคมด้านดีไซน์”
ข้อค้นพบหลัก:
- มีเพียง Sonnet 5.5 ที่ส่งแดชบอร์ดใช้งานได้จริง Sonnet 5 ลิงก์ไปยังไฟล์ Chart.js ที่ไม่มีบน cdnjs (URL คืนค่า 404) ทำให้ไลบรารีไม่โหลด และทุกพาเนลรวมถึงตารางธรรมดาแสดงผลว่างเปล่า Sonnet 5.5 ยังตรวจว่าไลบรารีกราฟโหลดหรือไม่ และทำให้ตารางยังทำงานได้หากโหลดไม่สำเร็จ
- Sonnet 5.5 จับกับดักตัวอย่างเล็กได้ ส่วนใหญ่ มาร์กสาขาที่มีผู้ตอบต่ำกว่า 30 ว่า “ระวังในการตีความ” และเพิ่มตัวกรองจำนวนผู้ตอบขั้นต่ำ มุมมองเริ่มต้นยังจัด Petroleum Engineering เป็นอันดับ 1 โดยไม่มีคำเตือน
- Sonnet 5 น่าจะพลาดอยู่ดี โค้ดอ่านคอลัมน์ขนาดตัวอย่างและช่วงเงินเดือนแล้วไม่ใช้ จัดอันดับสาขาด้วยมัธยฐานล้วน ๆ
- กับดักเล็ก ๆ ไม่ทำให้ใครสะดุด ทั้งคู่จัดการแถว Food Science ที่ว่างได้อย่างชัดเจน และ Sonnet 5.5 คำนวณสัดส่วนงานสายวิทยาลัยโดยไม่สื่อว่าคอลัมน์ประเภทงานรวมกันเท่ากับการจ้างงานทั้งหมด
นี่คือแดชบอร์ดของ Sonnet 5.5 โดยตั้งตัวกรองเป็นสาขาที่มีผู้ตอบอย่างน้อย 100 คน
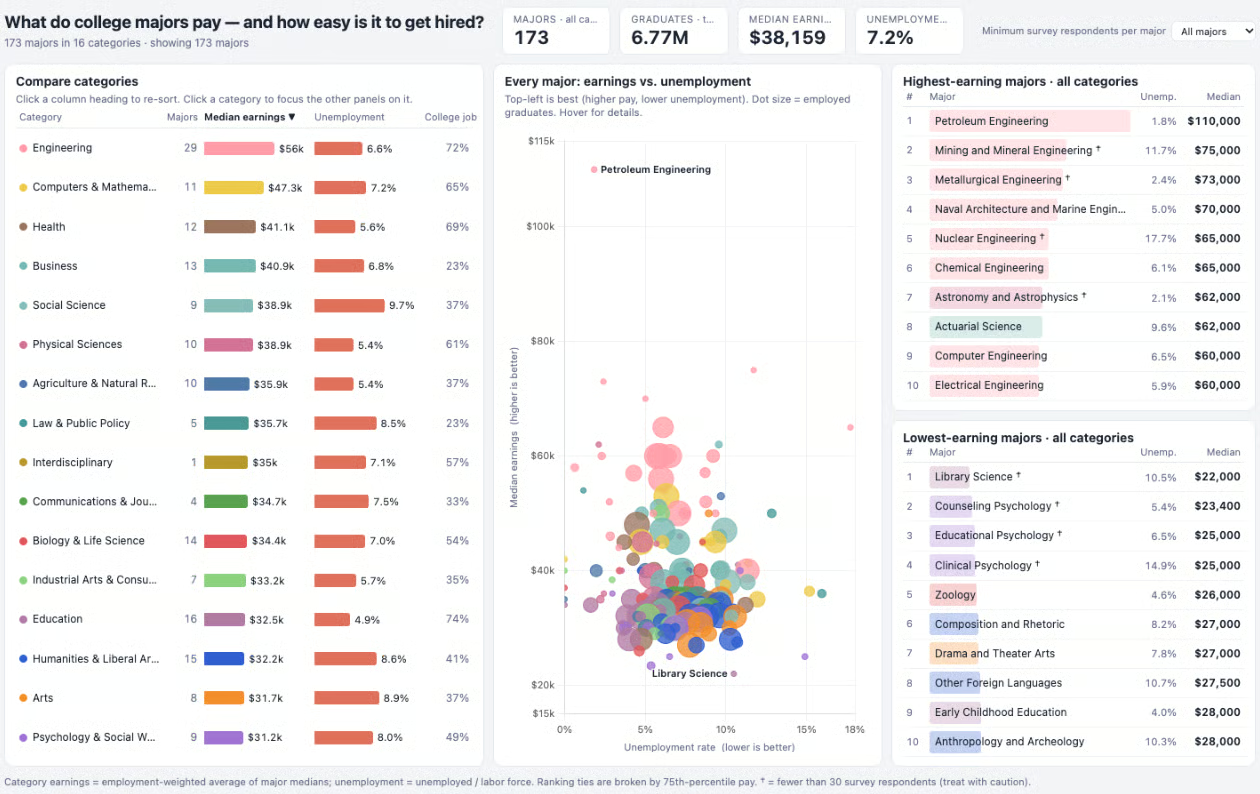
ให้คะแนนแดชบอร์ดของ Sonnet 5.5 ที่ 4 จาก 5 สำหรับความซื่อสัตย์ในการจัดการข้อมูล 5 สำหรับประโยชน์เชิงวิเคราะห์ และ 4 สำหรับคุณภาพกราฟและเลย์เอาต์ ส่วนหน้าเปล่าของ Sonnet 5 แนบไว้ด้านล่าง
แล้วทำไม Sonnet 5 ถึงล้มเหลว? ปัญหาคือแดชบอร์ดต้องใช้ไลบรารีกราฟ Sonnet 5 ขอเวอร์ชันจาก cdnjs ที่ไม่ได้โฮสต์ จากนั้นได้ข้อผิดพลาด “404” เมื่อไม่มีไลบรารี โค้ดของ Sonnet 5 ก็พัง: “Chart is not defined.” ดูเหมือนว่า Sonnet 5 เขียนเพจให้ทุกอย่าง แม้แต่ตารางข้อความธรรมดา ไปรันหลังขั้นตอนนั้น และไม่สามารถจับข้อผิดพลาดได้
ต้นทุนต่อครั้งแทบไม่ต่างกัน: $0.56 สำหรับ Sonnet 5.5 และ $0.57 สำหรับ Sonnet 5 และ Sonnet 5.5 ทำงานเสร็จเร็วกว่า
ดังนั้น Sonnet 5.5 ก้าวหน้าจริงไหม? สำหรับงานนี้ ใช่ Sonnet 5.5 ส่งแดชบอร์ดที่ทำงานได้และเตือนเรื่องข้อมูลบาง เบา ส่วน Sonnet 5 ส่งหน้าเปล่า
ราคาและการให้บริการของ Claude Sonnet 5.5
Claude Sonnet 5.5 มีราคา $2 ต่ออินพุต 1 ล้านโทเค็น และ $10 ต่อเอาต์พุต 1 ล้านโทเค็นบน API ไม่เปลี่ยนจาก Sonnet 5 และครึ่งราคาของ Opus 5.5 Anthropic ระบุว่าใช้โทเค็นต่อภารกิจน้อยลง ซึ่งลดต้นทุนที่แท้จริงของงาน แม้อัตราจะคงที่ ในการทดสอบใช้งานจริงของเรา โมเดลทั้งสองมีต้นทุนใกล้เคียงกันในการทำงานให้เสร็จ
| ประเภทโทเค็น | ราคาต่อ 1M โทเค็น |
|---|---|
| อินพุต | $2 |
| เอาต์พุต | $10 |
| เขียนแคช (5 นาที) | $2.50 |
| เขียนแคช (1 ชั่วโมง) | $4 |
| อ่านแคช | $0.20 |
Batch API ลดทั้งอินพุตและเอาต์พุต 50% พรอมป์ตขั้นต่ำที่แคชได้คือ 512 โทเค็น และบน Batch API โมเดลสามารถคืนเอาต์พุตได้สูงสุด 300K โทเค็นด้วยเฮดเดอร์เบต้า output-300k-2026-03-24
Sonnet 5.5 พร้อมให้บริการทั่วไป ไม่ใช่พรีวิว และมีตัวเลือกไม่เก็บรักษาข้อมูล Anthropic รับปากว่าจะไม่ยุติบริการก่อนวันที่ 28 กันยายน 2027
เข้าถึง Claude Sonnet 5.5 ได้อย่างไร?
สามารถใช้ Claude Sonnet 5.5 ได้แล้ววันนี้ในแอป Claude ใน Claude Code และผ่าน API ด้วยรหัสโมเดล claude-sonnet-5-5 มีให้บริการบน Amazon Bedrock ในชื่อ anthropic.claude-sonnet-5-5 และบน Google Cloud, Microsoft Foundry และ Claude Platform on AWS ใต้ claude-sonnet-5-5
นี่คือตัวอย่างเรียกใช้ Python ขั้นต่ำ Adaptive thinking เปิดเป็นค่าเริ่มต้น ดังนั้นการตอบอาจมีบล็อกการคิดนำหน้าข้อความ:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
สำหรับบทเดินผ่านจริงเรื่องคีย์ ค่าใช้จ่าย และโปรเจ็กต์แรก ดู คู่มือฉบับสมบูรณ์ของ Claude API หากกำลังสร้างเอเจนต์ บทเรียนเกี่ยวกับ การสร้าง Claude Managed Agents เป็นขั้นถัดไปที่ดี เราจะเผยแพร่บทเรียน API ของ Claude Sonnet 5.5 ในเร็ว ๆ นี้
ข้อคิดส่งท้าย
Anthropic กำลังเดิมพันว่างานที่มีผู้จ่ายเงินจริงส่วนใหญ่ รวมถึงงานเอเจนต์โค้ดส่วนใหญ่ จะรันบนโมเดลระดับกลางใหม่นี้ ซึ่งกดดันโดยตรงต่อ GPT-6 Sol ของ OpenAI ที่ตามหลังบนตัวเลขงานความรู้ของ Anthropic
แนะนำให้สลับทันทีหากยังอยู่บน Sonnet 5 แต่ควรอัปเดตตัวเองเรื่องการเปลี่ยนแปลง API เก็บ Opus 5.5 ไว้สำหรับโปรเจ็กต์ที่โมเดลต้องเป็นฝ่ายตัดสินใจว่าจะสร้างอะไร
ถ้าต้องการเรียนรู้เพิ่มเติมเกี่ยวกับการพัฒนาด้วยโมเดลของ Anthropic แนะนำให้ดูคอร์ส Introduction to Claude Models