Seis dias depois de a Anthropic colocar o Claude Opus 5.5 no topo do portfólio, o modelo intermediário encurtou quase todo o gap pela metade do preço. O Claude Sonnet 5.5 vence o Opus 5.5 em um benchmark e fica apenas alguns pontos atrás nos demais, mantendo o preço do Sonnet 5.
Já vimos esse padrão antes. O Claude Sonnet 5 chegou bem próximo dos benchmarks agentivos do Opus 4.8 por uma fração do custo. Antes disso, o Sonnet 4.6 ficou a uma distância pequena do Opus 4.6 nas mesmas condições. Toda vez, um modelo intermediário aparece dias ou semanas após o carro-chefe e fecha a maior parte do gap custando metade.
É assim que uma curva de escalonamento logarítmica se parece vista de fora. O desempenho cresce mais ou menos com o log do compute, então o custo cresce quase exponencialmente com o desempenho. O modelo carro-chefe fica no topo dessa curva, gastando muito para comprar os últimos pontos. Um modelo mais barato, construído semanas depois e se beneficiando dos mesmos avanços, só precisa chegar a um ponto mais baixo na curva para parecer quase tão bom. Em outras palavras, a maior parte do valor da curva ainda é barata de alcançar; só o trecho final é caro.
Vale detalhar isso porque as líderes do mercado fazem um pouco de mágica de PR e branding.
Resumo
- O Sonnet 5.5 é o novo modelo intermediário da Anthropic, substituindo o Sonnet 5 pelo mesmo preço.
- O destaque é a codificação agentiva em terminal, onde ele agora ultrapassa o Opus 5.5.
- Em trabalho de conhecimento e uso de computador, ele fica logo atrás do Opus 5.5 por metade do preço por token.
- Defina-o como seu modelo padrão do Claude e mantenha o Opus 5.5 para trabalhos abertos, que exigem mais julgamento.
O que é o Claude Sonnet 5.5?
A documentação do modelo da Anthropic descreve o Claude Sonnet 5.5 como "a melhor combinação de velocidade e inteligência" do portfólio atual. Ele é o modelo intermediário da família Claude 5.5, entre o carro-chefe Claude Opus 5.5 e o futuro Claude Haiku 5.5. (Vamos manter você atualizado sobre o Haiku 5.5, embora o Haiku 5 nunca tenha chegado.)
Comparado ao Sonnet 5, o salto é maior do que um meio ponto de versão sugere. Isso não surpreende depois de vermos que o salto entre Opus 5.5 e Opus 5 foi maior que o esperado.
Quanto ao post de lançamento, a Anthropic reporta ganhos em todos os benchmarks publicados, com os maiores avanços em terminal coding, leitura de gráficos e avaliações de trabalho de conhecimento.
Curiosamente, a Anthropic diz que este Sonnet é o primeiro a zerar o Pokémon Red trabalhando apenas a partir de screenshots. Parece inusitado, mas é um teste que a Anthropic usa como proxy para trabalhos de longo horizonte e entendimento de imagem.
Então, o Opus 5.5 continua, nas palavras da empresa, claramente mais forte em trabalhos complexos e abertos, que exigem julgamento sustentado. Já o Sonnet 5.5 é o modelo para tarefas em que você sabe como é o "pronto", o que é uma boa heurística.
Principais recursos do Claude Sonnet 5.5
A maior parte das novidades no Sonnet 5.5 é sobre fazer o mesmo trabalho mais rápido e com menos tokens, além de algumas mudanças que usuários da API precisam considerar.
Resultados quase no nível do Opus em tarefas do dia a dia, com velocidade de Sonnet
Você pode passar para o Sonnet 5.5 o tipo de trabalho que antes pedia o Opus e recebê-lo de volta mais rápido. A Anthropic diz que a geração de saída está mais de 30% mais rápida que no Sonnet 5, e que o modelo usa menos tokens por tarefa — "até 30% menos por tarefa" — é o número que eles citam.
Os primeiros testadores citados no post de lançamento reforçam isso com números próprios:
- Base44 reporta 3,6 iterações por build de app com o Sonnet 5.5, contra 7,7 com o Opus 5.
- Box viu suas cargas rodarem 2,4x mais rápido com 12% menos tokens no total.
- Zendesk mediu processamento de tickets 20% mais rápido.
- Slack reporta cerca de 14% menos tokens de saída.
São depoimentos de clientes selecionados pelo fornecedor. Ainda assim, há um padrão: menos iterações e menos tokens, o que impacta sua conta junto com a tarifa por token.
Rode agentes de código no terminal e no desktop
O Sonnet 5.5 foi feito para atuar como agente: executando comandos de shell, corrigindo bugs em um repositório e operando um desktop a partir de screenshots. Ele já está disponível no Claude Code desde o lançamento, e a Anthropic descreve seu uso de computador como próximo ao do Opus 5.5.
Na prática, isso torna o Sonnet 5.5 um padrão crível para sessões no Claude Code e para loops de agentes que você mesmo constrói com o nosso guia da API do Claude.
Produza documentos, slides e interfaces mais polidos
A Anthropic destaca um "olhar apurado para design" como força do Sonnet 5.5. Na prática, isso deve significar interfaces de usuário mais bonitas quando você pedir para refinar código de front-end e resultados mais finalizados quando pedir slides, planilhas ou documentos longos.
A alegação de design é a que mais precisa de validação independente. É a mais difícil de mensurar, e o post de lançamento a apoia apenas com depoimentos de clientes.
Conte com salvaguardas para segurança e biologia
O Sonnet 5.5 é o primeiro Sonnet a lançar com salvaguardas de cibersegurança similares às do Opus 5.5. Quando uma solicitação é classificada como trabalho de segurança de maior risco, ela faz fallback para o Sonnet 5. As salvaguardas de biologia são as mesmas do Sonnet 5, e a Anthropic diz que a maior parte do desenvolvimento de software e do trabalho em ciências da vida não será afetada.
Também é o primeiro Sonnet a vir com classificadores que bloqueiam extração de raciocínio, e os blocos de thinking agora ficam vinculados à conta e à conversa que os gerou. Se você roda ferramentas de segurança, teste seus prompts antes de migrar um pipeline.
Migre do Sonnet 5 com poucas alterações de código
Apenas trocar o ID do modelo não basta. A documentação da Anthropic lista cinco breaking changes para códigos que já rodam no Sonnet 5:
-
Adaptive thinking ativado por padrão, e o nível mais baixo é
between_tools, que desliga o thinking inicial. -
Forçar o uso de ferramenta retorna erro.
-
Thinking blocks ficam vinculados ao modelo e à conversa que os gerou.
-
A ferramenta antiga de uso de computador
computer_20251124é rejeitada na Claude API e no Google Cloud. -
A ferramenta advisor não aceita mais Opus 4.8, Opus 4.7 ou Sonnet 5 como advisors.
Há uma mudança mais sutil também: o texto entre chamadas de ferramenta agora volta em blocos de thinking. Um app que faz streaming de texto para usuários ficará em silêncio entre chamadas de ferramenta até você atualizar a configuração de display. Definir temperature, top_p ou top_k com valor diferente do padrão também retorna erro 400. São pontos específicos que você pode descobrir na prática.
Como o Claude Sonnet 5.5 se sai nos benchmarks?
O Claude Sonnet 5.5 supera o Sonnet 5 em todos os benchmarks publicados pela Anthropic, vence o Opus 5.5 em terminal coding e fica poucos pontos atrás do Opus 5.5 nos demais. Contra o GPT-6 Sol da OpenAI, ele lidera nas avaliações de trabalho de conhecimento e leitura de gráficos, mas fica atrás no FrontierCode. Todos os números abaixo vêm do post de lançamento da Anthropic.
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 10,3% | 66,4% | Não reportado |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | Não reportado |
| FrontierCode 1.1 (Main) | 46,2% (máx. esforço) | 42,4% | 54,4% | 49,3% (52,1% em xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (com ferramentas) | 64,5% | 54,9% | 67,7% | Não reportado |
| OSWorld 2.1 | 80,1% | 57,0% | 81,8% | Não reportado |
| Chartography (sem ferramentas) | 61,6% | 15,6% | 64,4% | 53,6% |
A tabela conta uma história simples: um salto geracional grande sobre o Sonnet 5 e um quase empate com o Opus 5.5. Vamos ver o que cada área significa para o seu trabalho.
Codificação agentiva
O Terminal-Bench 4.0 é onde o Sonnet 5.5 se destaca. Ele marca 70,6%, subindo dos 10,3% do Sonnet 5 e à frente dos 66,4% do Opus 5.5. O benchmark mede se um modelo consegue concluir tarefas reais em um ambiente de linha de comando, como fluxos de shell em múltiplas etapas, então mapeia bem o uso do Claude Code.
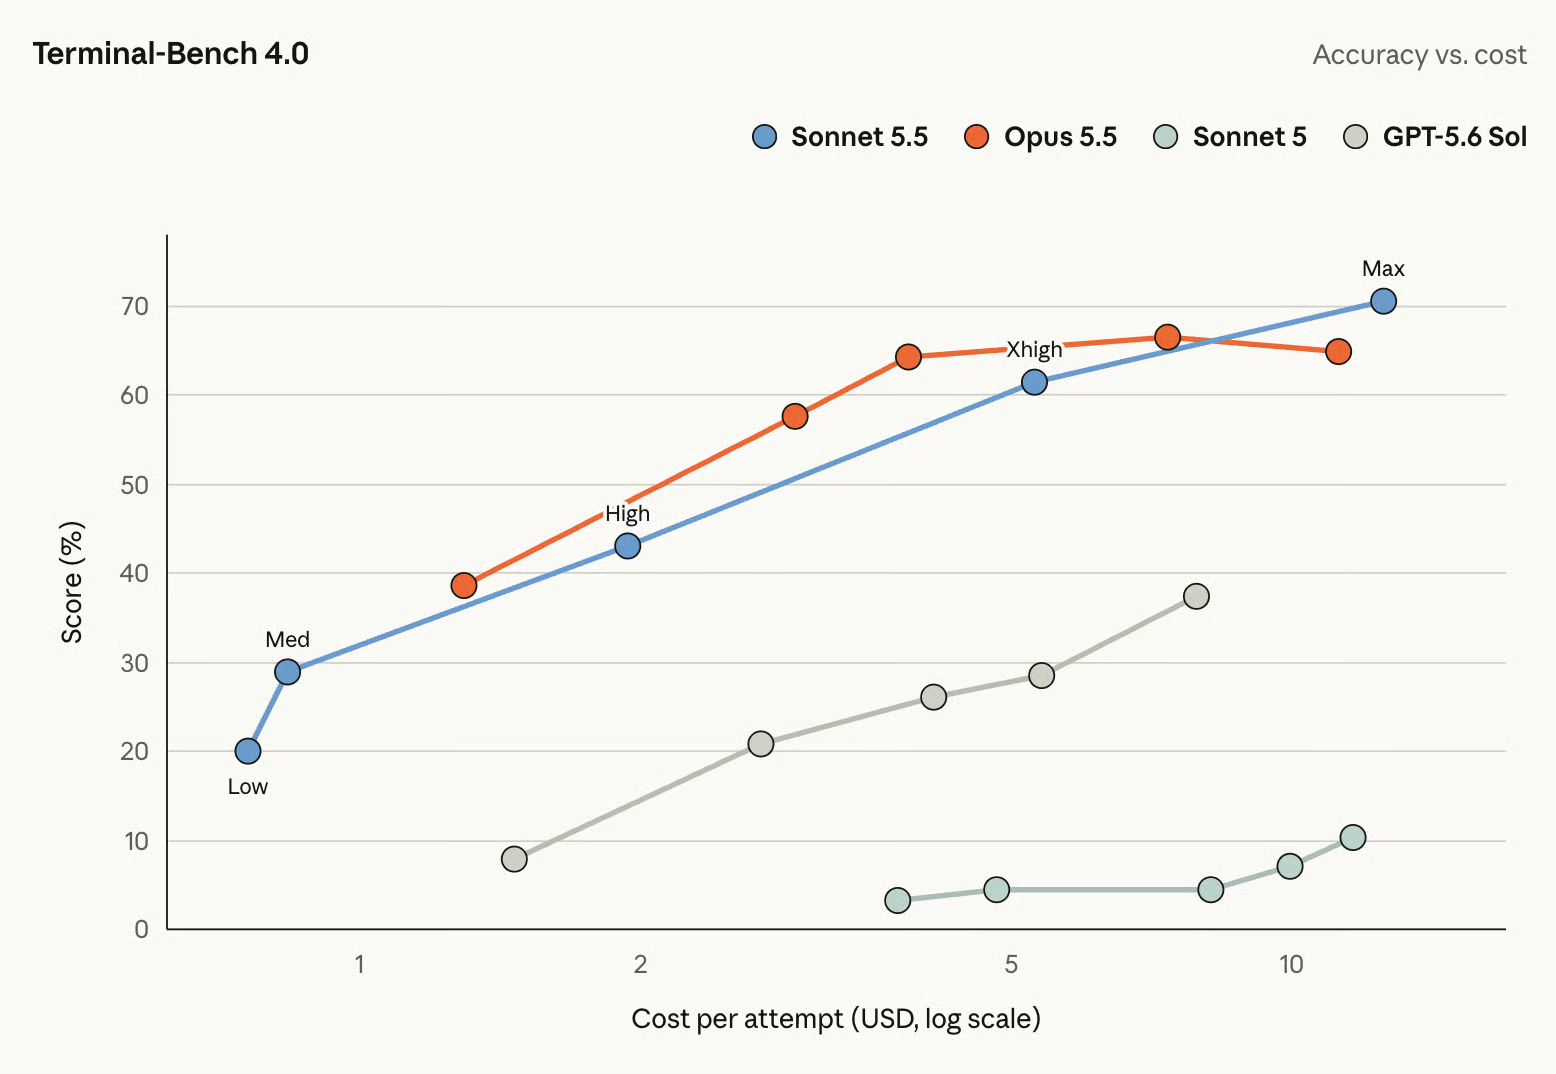
Um salto de 60 pontos em um lançamento é incomum. O restante do panorama de código é menos dramático.
Trabalho de conhecimento
No GDPval-AA v2.1, que avalia saídas do modelo em tarefas economicamente valiosas de ocupações reais usando um score no estilo Elo, o Sonnet 5.5 marca 1844. Isso é 2 pontos atrás do Opus 5.5 e quase 400 à frente do Sonnet 5.
Para times que usam o Claude para relatórios, análises e documentos de negócios, este é o resultado mais útil da tabela. Nesse tipo de trabalho, o custo extra do Opus 5.5 compra pouca vantagem.
Raciocínio e entendimento visual
O Chartography, um teste de leitura e raciocínio sobre gráficos sem ferramentas, mostra o maior ganho relativo: o Sonnet 5.5 marca 61,6% contra 15,6% do Sonnet 5. Isso está alinhado com as alegações da Anthropic sobre melhor entendimento de imagens.
Uso de computador
No OSWorld 2.1, que mede se um modelo completa tarefas operando um sistema operacional de desktop real, o Sonnet 5.5 chega a 80,1%, subindo de 57,0% do Sonnet 5 e a menos de 2 pontos do Opus 5.5.
Qual nível você deve usar?
Para a maioria dos desenvolvedores, o Sonnet 5.5 deve ser agora o modelo padrão do Claude. O Opus 5.5 justifica seu preço maior apenas quando a tarefa é tão aberta que o gargalo é o julgamento, não a velocidade.
O portfólio atual, segundo a tabela de comparação da Anthropic, está assim. Todos os quatro modelos, exceto o Haiku 4.5, compartilham janela de contexto de 1M tokens e saída máxima de 128K.
| Modelo | Preço (input / output por 1M tokens) | Latência | Melhor para |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Mais lenta | Trabalhos de ponta, em que capacidade importa mais que custo |
| Claude Opus 5.5 | $4 / $20 | Moderada | Trabalho complexo e aberto que exige julgamento sustentado |
| Claude Sonnet 5.5 | $2 / $10 | Rápida | Código bem delimitado, agentes e documentos |
| Claude Haiku 4.5 | $1 / $5 | Mais rápida | Tarefas de alto volume e custo sensível |
Dentro do Sonnet 5.5, o ajuste de effort é a outra alavanca. A Anthropic recalibrou cinco níveis: low, medium, high, xhigh e max. Níveis mais baixos favorecem velocidade e custo, enquanto os mais altos permitem que o modelo raciocine por mais tempo e cheque o próprio trabalho. O padrão é medium nos apps do Claude e no Claude Code, e high na API.
Um detalhe do post de lançamento muda como eu usaria: com effort baixo ou médio, o Sonnet 5.5 supera o melhor score do Sonnet 5 em vários benchmarks por cerca de um décimo do custo por tarefa. Em resumo:
-
Correção de bugs, refactors e sessões no Claude Code: Sonnet 5.5 no effort padrão.
-
Loops de agentes e pipelines de alto throughput: Sonnet 5.5 em
lowoumedium, elevando o effort só em casos de falha. -
Problemas de código difíceis com especificação clara: Sonnet 5.5 em
xhighoumaxantes de pagar pelo Opus. -
Projetos ambíguos, de vários dias: Opus 5.5.
Testando o Claude Sonnet 5.5: exemplos práticos
Os benchmarks acima são da própria Anthropic, então rodei uma tarefa de build no Claude Sonnet 5.5 e no Claude Sonnet 5 com prompt idêntico e as mesmas ferramentas.
A tarefa: transformar o dataset de recém-formados do FiveThirtyEight (173 cursos nos EUA, CC BY 4.0) em um dashboard HTML de arquivo único que ajude um futuro estudante a comparar categorias por renda e emprego e a encontrar os cursos com maior e menor remuneração.
O verdadeiro teste está nos dados, que têm algumas características que o prompt não menciona:
- O topo, Petroleum Engineering, tem apenas 36 respondentes, e 76 dos 173 cursos têm menos de 100
- As rendas são assimétricas, então uma barra de mediana esconde muita variação
- Um curso, Food Science, tem campos de headcount em branco
- As colunas de tipo de emprego não somam o número de pessoas empregadas
Perceber esses pontos é o objetivo do teste. Ele investiga a alegação da Anthropic sobre ter um "olhar apurado para design".
Principais achados:
- Só o Sonnet 5.5 entregou um dashboard funcional. O Sonnet 5 referenciou um arquivo do Chart.js que não existe no cdnjs (a URL retorna 404), então a biblioteca não carregou e todos os painéis, inclusive as tabelas simples, ficaram vazios. O Sonnet 5.5 também verifica se a biblioteca de gráficos carregou e mantém as tabelas funcionando se não tiver carregado.
- O Sonnet 5.5 detectou o problema de amostra pequena, em parte. Ele marca cursos com menos de 30 respondentes como "interprete com cautela" e adiciona um filtro de respondentes mínimos. Na visão padrão, coloca Petroleum Engineering em #1 sem aviso.
- O Sonnet 5 perderia isso de qualquer forma. Seu código lê as colunas de tamanho de amostra e faixa salarial, mas não as usa, e ordena os cursos apenas pela mediana.
- As armadilhas menores não pegaram ninguém. Ambos trataram explicitamente a linha em branco de Food Science, e o Sonnet 5.5 calculou a parcela de empregos de nível superior sem sugerir que as colunas de emprego somam o total.
Aqui está o dashboard do Sonnet 5.5 com o filtro ajustado para cursos com pelo menos 100 respondentes.
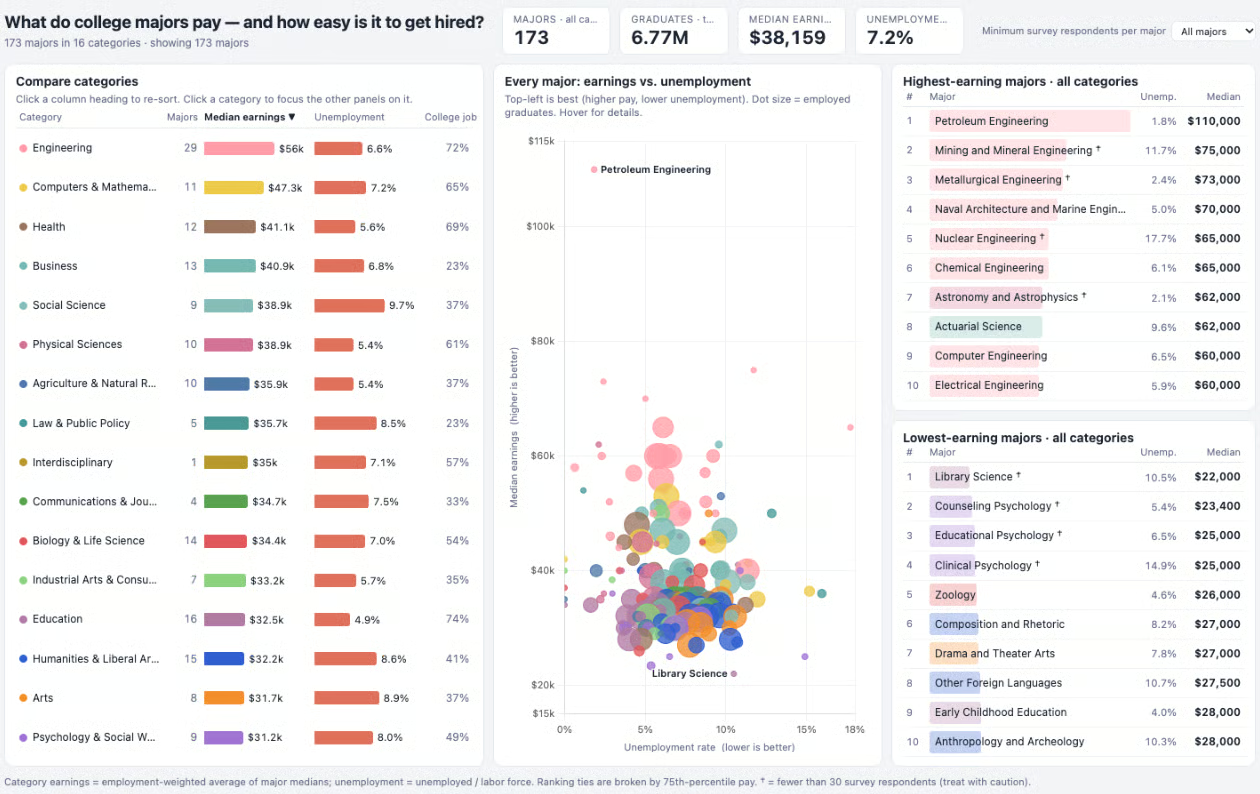
Avaliei o dashboard do Sonnet 5.5 com nota 4 de 5 em honestidade no tratamento dos dados, 5 em utilidade analítica e 4 em qualidade de gráficos e layout. A página em branco do Sonnet 5 está abaixo.
Então por que o Sonnet 5 falhou? O problema foi que o dashboard precisava de uma biblioteca de gráficos. O Sonnet 5 pediu ao cdnjs uma versão que não hospeda. Recebeu um erro "404". Sem a biblioteca, o código do Sonnet 5 quebrou: "Chart is not defined". Ao que parece, o Sonnet 5 estruturou a página de modo que tudo, até as tabelas de texto simples, rodasse depois dessa etapa, e não conseguiu capturar o erro.
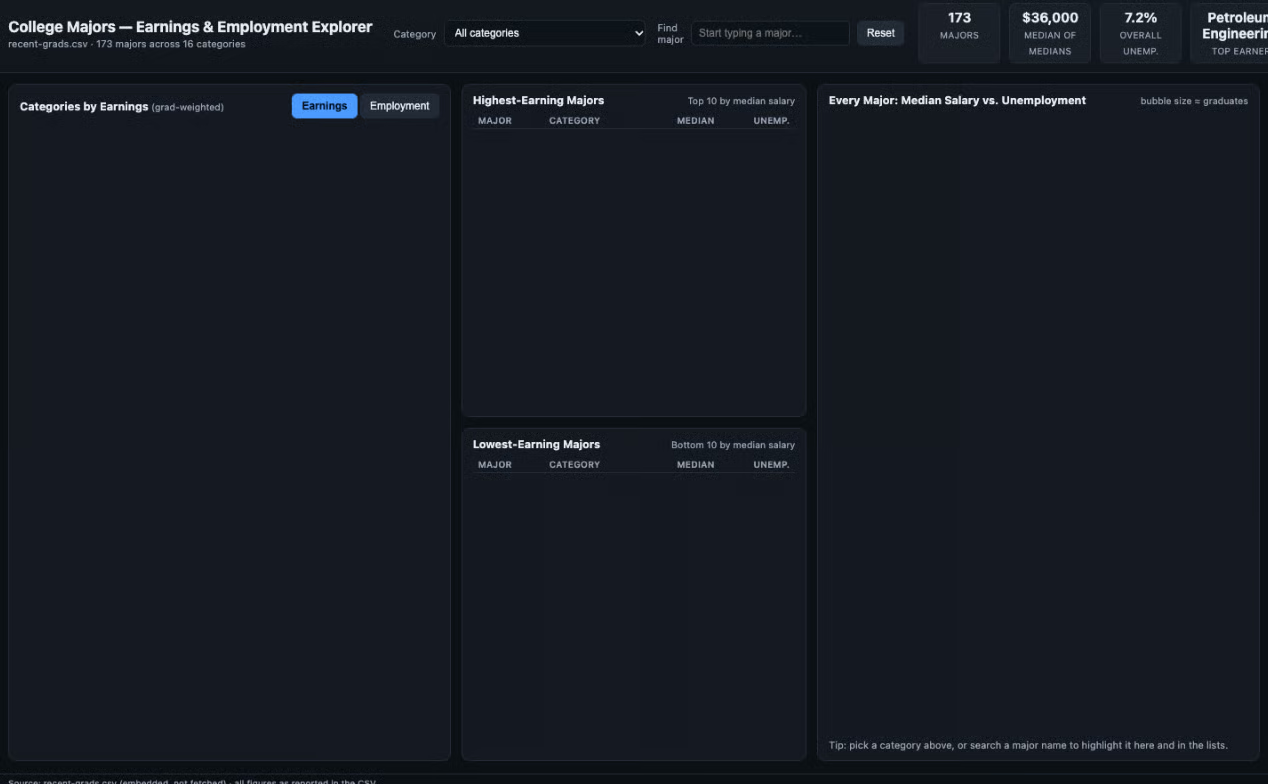
O custo por execução foi essencialmente idêntico: $0,56 para o Sonnet 5.5 e $0,57 para o Sonnet 5. Além disso, o Sonnet 5.5 terminou mais rápido.
Então o Sonnet 5.5 é um avanço real? Nesta tarefa, sim. O Sonnet 5.5 entregou um dashboard que funciona e alerta sobre dados escassos, enquanto o Sonnet 5 entregou uma página em branco.
Preço e disponibilidade do Claude Sonnet 5.5
O Claude Sonnet 5.5 custa $2 por milhão de tokens de input e $10 por milhão de tokens de output na API, sem mudanças em relação ao Sonnet 5 e pela metade do preço do Opus 5.5. A Anthropic reporta menos tokens por tarefa, o que reduziria o custo efetivo por job mesmo com a tarifa fixa. No nosso teste prático, porém, ambos custaram quase o mesmo para concluir a tarefa.
| Tipo de token | Preço por 1M tokens |
|---|---|
| Input | $2 |
| Output | $10 |
| Cache write (5 minutos) | $2,50 |
| Cache write (1 hora) | $4 |
| Cache read | $0,20 |
A Batch API dá 50% de desconto em input e output. O prompt mínimo cacheável é de 512 tokens, e na Batch API o modelo pode retornar até 300K tokens de saída com o header beta output-300k-2026-03-24.
O Sonnet 5.5 está em disponibilidade geral, não é preview, com opção de zero data retention. A Anthropic se compromete a não aposentar o modelo antes de 28 de setembro de 2027.
Como ter acesso ao Claude Sonnet 5.5?
Você pode usar o Claude Sonnet 5.5 hoje nos apps do Claude, no Claude Code e via API com o ID de modelo claude-sonnet-5-5. Ele também está disponível na Amazon Bedrock como anthropic.claude-sonnet-5-5, e no Google Cloud, Microsoft Foundry e Claude Platform na AWS como claude-sonnet-5-5.
Aqui vai uma chamada mínima em Python. O adaptive thinking vem ativado por padrão, então a resposta pode incluir blocos de thinking antes do texto:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Para um passo a passo real de chaves, custos e seu primeiro projeto, veja nosso guia completo da Claude API. Se você está criando agentes, nosso tutorial sobre como construir Claude Managed Agents é um bom próximo passo. Publicaremos em breve um tutorial da API do Claude Sonnet 5.5.
Considerações finais
A Anthropic aposta que a maior parte do trabalho pago, incluindo a maior parte do trabalho com agentes de código, rode neste novo modelo intermediário. Isso também coloca pressão direta sobre o GPT-6 Sol da OpenAI, que fica atrás nos números de trabalho de conhecimento da Anthropic.
Eu migraria agora se você ainda estiver no Sonnet 5, mas atualize-se sobre as mudanças na API. Mantenha o Opus 5.5 para projetos em que o modelo precisa decidir o que construir.
Se você quer aprender mais sobre como construir com os modelos da Anthropic, recomendo conferir nosso curso Introduction to Claude Models.