Six jours après qu'Anthropic a placé Claude Opus 5.5 en haut de sa gamme, le modèle intermédiaire a comblé l'essentiel de l'écart pour deux fois moins cher. Claude Sonnet 5.5 bat Opus 5.5 sur un benchmark et ne le suit que de quelques points ailleurs, tout en conservant les tarifs de Sonnet 5.
Ce schéma, on l'a déjà vu. Claude Sonnet 5 est arrivé tout près des benchmarks agentiques d'Opus 4.8 pour une fraction du coût. Avant cela, Sonnet 4.6 s'était rapproché d'Opus 4.6 dans les mêmes conditions. À chaque fois, un modèle de milieu de gamme débarque quelques jours ou semaines après le porte-étendard et referme l'essentiel de l'écart à moitié prix.
Vu de l'extérieur, c'est à cela que ressemble une courbe d'échelle logarithmique. Les performances augmentent grosso modo avec le log du calcul, donc le coût croît de manière quasi exponentielle avec la performance. Un modèle phare se place en haut de la courbe, où il dépense beaucoup pour gratter les derniers points. Un modèle moins cher, construit quelques semaines plus tard et profitant des mêmes avancées, n'a qu'à viser plus bas sur la courbe pour paraître presque aussi bon. Autrement dit, la majeure partie de la valeur de la courbe reste peu coûteuse à obtenir ; seule la dernière ligne droite est onéreuse.
Cela vaut la peine de le détailler, car les leaders du marché manient habilement RP et branding.
Résumé
- Sonnet 5.5 est le nouveau modèle intermédiaire d'Anthropic, qui remplace Sonnet 5 au même prix.
- Le gain phare concerne le codage agentique en terminal, où il dépasse désormais Opus 5.5.
- Sur les tâches de connaissance et l'usage de l'ordinateur, il se situe juste derrière Opus 5.5 pour deux fois moins cher par token.
- Faites-en votre modèle Claude par défaut et gardez Opus 5.5 pour les travaux ouverts, à forte part de jugement.
Qu'est-ce que Claude Sonnet 5.5 ?
La documentation du modèle d'Anthropic présente Claude Sonnet 5.5 comme « la meilleure combinaison de vitesse et d'intelligence » de la gamme actuelle. C'est le modèle intermédiaire de la famille Claude 5.5 d'Anthropic, positionné entre le porte-étendard Claude Opus 5.5 et le futur Claude Haiku 5.5. (Nous vous tiendrons informés de Haiku 5.5, même si Haiku 5 n'a jamais vu le jour.)
Par rapport à Sonnet 5, le saut est plus grand que ne le laisse penser un numéro de version « 5.5 ». Rien d'étonnant après avoir constaté que l'écart entre Opus 5.5 et Opus 5 était lui aussi supérieur aux attentes.
Côté annonce : Anthropic indique des progrès sur tous les benchmarks publiés, avec les plus fortes hausses en codage terminal, lecture de graphiques et évaluations de travail de connaissance.
Fait intéressant, Anthropic affirme que ce modèle Sonnet est le premier à battre Pokémon Red uniquement à partir de captures d'écran. Ça peut sembler insolite, mais c'est un test que la société utilise comme proxy pour le travail à long horizon et la compréhension d'images.
En somme, Opus 5.5 reste, selon l'entreprise, clairement supérieur pour les tâches complexes et ouvertes qui exigent un jugement soutenu. Mais Sonnet 5.5 est le modèle à privilégier dès lors que vous savez à quoi ressemble le résultat final : un bon repère pratique.
Fonctionnalités clé de Claude Sonnet 5.5
La plupart des nouveautés de Sonnet 5.5 visent à effectuer le même travail plus vite et avec moins de tokens, avec quelques changements à anticiper pour les utilisateurs de l'API.
Des résultats proches d'Opus sur les tâches courantes, à la vitesse de Sonnet
Vous pouvez confier à Sonnet 5.5 des travaux qui, auparavant, appelaient Opus, et les récupérer plus rapidement. Anthropic annonce une génération de sortie plus de 30% plus rapide que Sonnet 5, et une consommation de tokens réduite par tâche — « jusqu'à 30% de moins par tâche » — selon leurs chiffres.
Les premiers bêta-testeurs cités dans le billet de lancement corroborent avec leurs propres données :
- Base44 rapporte 3,6 itérations par build d'app avec Sonnet 5.5, contre 7,7 avec Opus 5.
- Box a observé des charges 2,4× plus rapides avec 12% de tokens en moins au total.
- Zendesk a mesuré un traitement des tickets 20% plus rapide.
- Slack rapporte environ 14% de tokens de sortie en moins.
Ce sont des témoignages clients sélectionnés par le fournisseur. Néanmoins, une tendance se dégage : moins d'itérations et moins de tokens, ce qui compte pour votre facture, en plus du tarif par token.
Exécuter des agents de code dans le terminal et sur le poste
Sonnet 5.5 est conçu pour fonctionner en agent : exécution de commandes shell, correction de bugs sur un dépôt, et pilotage d'un bureau via des captures d'écran. C'est disponible dans Claude Code dès le lancement, et Anthropic indique un usage de l'ordinateur proche d'Opus 5.5.
Conséquence concrète pour beaucoup : Sonnet 5.5 devient un choix crédible par défaut pour les sessions Claude Code et pour les boucles d'agents que vous construisez vous-même avec notre guide de l'API Claude.
Produire des documents, des slides et des interfaces soignés
Anthropic met en avant un « sens aigu du design » comme point fort de Sonnet 5.5. En pratique, cela devrait se traduire par des interfaces plus soignées lorsque vous lui faites affiner du code front-end, et des livrables plus aboutis lorsque vous demandez des slides, des feuilles de calcul ou de longs documents.
C'est toutefois l'allégation qui mérite le plus une vérification indépendante. Elle est difficile à benchmarker et le billet de lancement ne l'étaye que par des citations clients.
Prévoir des garde-fous sur la sécurité et la biologie
Sonnet 5.5 est le premier modèle Sonnet à être lancé avec des garde-fous cybersécurité comparables à ceux d'Opus 5.5. Lorsqu'une requête est classée comme à risque élevé en sécurité, elle bascule vers Sonnet 5. Les garde-fous biologiques sont les mêmes que sur Sonnet 5, et Anthropic indique que la plupart des travaux en développement logiciel et sciences de la vie ne seront pas affectés.
C'est aussi le premier Sonnet livré avec des classifieurs qui bloquent l'extraction du raisonnement, et les blocs de pensée sont désormais liés au compte et à la conversation qui les ont générés. Si vous exécutez des outils de sécurité, testez vos prompts avant de basculer une pipeline.
Migrer depuis Sonnet 5 avec quelques changements de code
Changer uniquement l'ID du modèle ne suffit pas. La documentation d'Anthropic liste cinq changements incompatibles pour du code déjà opérationnel sur Sonnet 5 :
-
La pensée adaptative est activée par défaut, et le niveau le plus bas est
between_tools, qui coupe la phase de pensée initiale. -
L'usage forcé d'un outil renvoie une erreur.
-
Les blocs de pensée sont liés au modèle et à la conversation qui les ont produits.
-
L'ancien outil d'usage ordinateur
computer_20251124est refusé sur l'API Claude et sur Google Cloud. -
L'outil advisor n'accepte plus Opus 4.8, Opus 4.7, ni Sonnet 5 comme conseillers.
Il y a aussi un changement plus discret : le texte entre les appels d'outils revient désormais dans des blocs thinking. Une application qui streame du texte aux utilisateurs restera muette entre deux appels d'outils tant que vous n'aurez pas mis à jour son paramètre display. Définir temperature, top_p ou top_k à une valeur non défaut renvoie également une erreur 400. Autant de points à connaître.
Quelles performances pour Claude Sonnet 5.5 aux benchmarks ?
Claude Sonnet 5.5 dépasse Sonnet 5 sur tous les benchmarks publiés par Anthropic, bat Opus 5.5 en codage terminal, et ne le suit que de quelques points ailleurs. Face à GPT-6 Sol d'OpenAI, il est devant sur les évaluations de travail de connaissance et de lecture de graphiques, mais derrière sur FrontierCode. Les chiffres ci-dessous proviennent du billet de lancement d'Anthropic.
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 10,3% | 66,4% | Non publié |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | Non publié |
| FrontierCode 1.1 (Main) | 46,2% (max effort) | 42,4% | 54,4% | 49,3% (52,1% à xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (with tools) | 64,5% | 54,9% | 67,7% | Non publié |
| OSWorld 2.1 | 80,1% | 57,0% | 81,8% | Non publié |
| Chartography (no tools) | 61,6% | 15,6% | 64,4% | 53,6% |
Le tableau raconte une histoire simple : un gros saut générationnel sur Sonnet 5, et un quasi-ex aequo avec Opus 5.5. Voyons ce que chaque domaine implique pour votre travail.
Codage agentique
Terminal-Bench 4.0 est là où Sonnet 5.5 se distingue. Il obtient 70,6%, contre 10,3% pour Sonnet 5 et 66,4% pour Opus 5.5. Le benchmark évalue la capacité du modèle à réaliser des tâches réelles en ligne de commande, comme des chaînes d'actions shell multi-étapes ; il reflète donc de près l'usage de Claude Code.
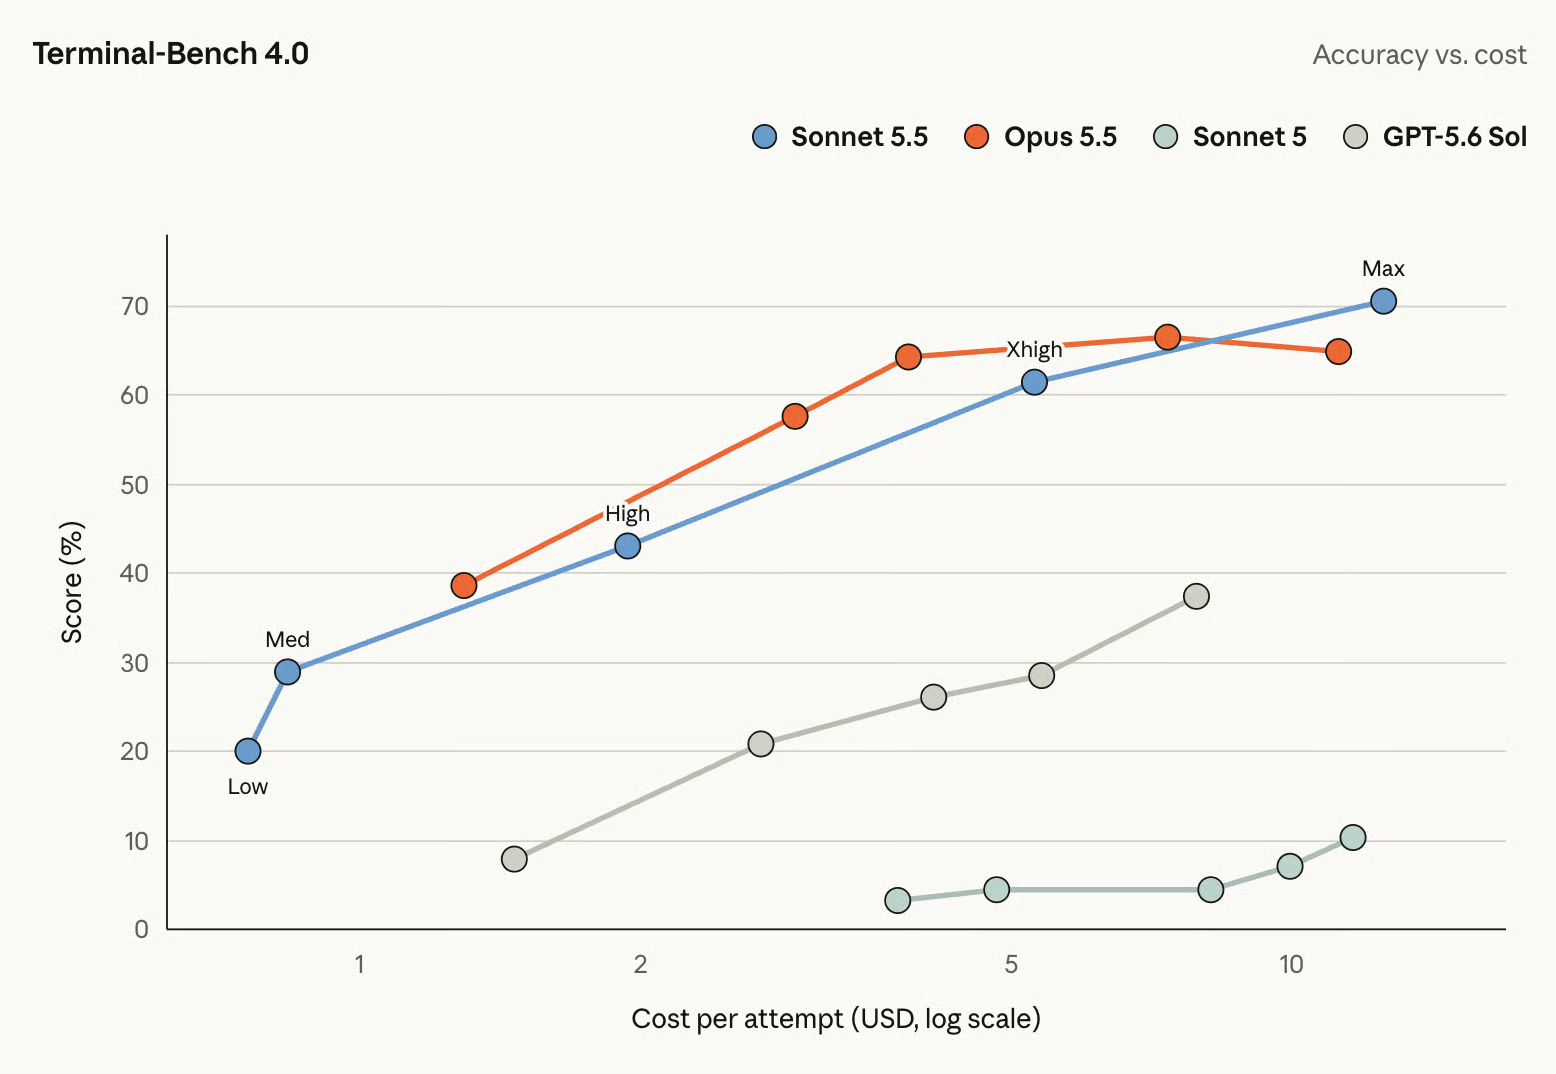
Un bond de 60 points en une version, c'est assez rare. Le reste du tableau pour le code est moins spectaculaire.
Travail de connaissance
Sur GDPval-AA v2.1, qui note en Elo la valeur économique de sorties sur des tâches réelles de métiers, Sonnet 5.5 obtient 1844. C'est 2 points derrière Opus 5.5 et près de 400 devant Sonnet 5.
Pour les équipes qui utilisent Claude pour des rapports, des analyses et des documents business, c'est le résultat le plus pertinent du tableau. Sur ce type de travail, payer plus pour Opus 5.5 n'apporte que peu.
Raisonnement et compréhension visuelle
Chartography, un test de lecture et de raisonnement sur des graphiques sans outils, montre le gain relatif le plus fort : Sonnet 5.5 atteint 61,6% contre 15,6% pour Sonnet 5. Cela corrobore les affirmations d'Anthropic sur une meilleure compréhension d'images.
Utilisation de l'ordinateur
Sur OSWorld 2.1, qui mesure la capacité à accomplir des tâches en pilotant un véritable système d'exploitation de bureau, Sonnet 5.5 atteint 80,1%, contre 57,0% pour Sonnet 5 et à moins de 2 points d'Opus 5.5.
Quel niveau choisir ?
Pour la plupart des développeurs, Sonnet 5.5 devrait désormais être le modèle Claude par défaut. Opus 5.5 ne justifie son surcoût que lorsque la tâche est suffisamment ouverte pour que le goulot d'étranglement soit le jugement, pas la vitesse.
La gamme actuelle, selon le tableau de comparaison d'Anthropic, ressemble à ceci. Tous les modèles sauf Haiku 4.5 partagent une fenêtre de contexte d'1 million de tokens et une sortie max de 128K.
| Modèle | Prix (entrée / sortie pour 1M tokens) | Latence | Idéal pour |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Plus lent | Travaux haut de gamme où la capacité prime sur le coût |
| Claude Opus 5.5 | $4 / $20 | Modéré | Tâches complexes et ouvertes, exigeant un jugement soutenu |
| Claude Sonnet 5.5 | $2 / $10 | Rapide | Code bien cadré, agents et production de documents |
| Claude Haiku 4.5 | $1 / $5 | Le plus rapide | Tâches à grand volume, sensibles au coût |
Au sein de Sonnet 5.5, le réglage d'effort est l'autre levier. Anthropic a recalibré cinq niveaux : low, medium, high, xhigh et max. Les niveaux bas privilégient la vitesse et le coût, les plus élevés laissent le modèle raisonner plus longtemps et vérifier son travail. Le défaut est medium dans les applis Claude et Claude Code, et high sur l'API.
Un détail de l'annonce change mon usage : à effort low ou medium, Sonnet 5.5 dépasse le meilleur score de Sonnet 5 sur plusieurs benchmarks pour environ un dixième du coût par tâche. En bref :
-
Corrections de bugs, refactorings et sessions Claude Code : Sonnet 5.5 avec l'effort par défaut.
-
Boucles d'agents et pipelines à haut débit : Sonnet 5.5 en
lowoumedium, puis augmenter l'effort uniquement en cas d'échec. -
Problèmes de code ardus avec spéc claire : Sonnet 5.5 en
xhighoumaxavant d'envisager Opus. -
Projets ambigus sur plusieurs jours : Opus 5.5.
Tests de Claude Sonnet 5.5 : exemples pratiques
Les benchmarks ci-dessus sont ceux d'Anthropic, donc j'ai exécuté une tâche de build avec Claude Sonnet 5.5 et Claude Sonnet 5, même prompt et mêmes outils.
La tâche : transformer le jeu de données des jeunes diplômés de FiveThirtyEight (173 filières aux États-Unis, CC BY 4.0) en un tableau de bord HTML monofichier permettant à un futur étudiant de comparer les catégories par revenus et emploi, et d'identifier les filières qui gagnent le plus et le moins.
Le véritable test est dans les données, qui ont quelques caractéristiques jamais mentionnées dans le prompt :
- La filière la mieux payée, Petroleum Engineering, n'a que 36 répondants, et 76 des 173 filières en ont moins de 100
- Les revenus sont asymétriques, donc une médiane seule masque une forte dispersion
- Une filière, Food Science, a des effectifs vides
- Les colonnes par type d'emploi ne totalisent pas le nombre de personnes en poste
Repérer ces points est l'objectif du test. Il éprouve l'affirmation d'Anthropic sur le « sens aigu du design ».
Principaux constats :
- Seul Sonnet 5.5 a livré un dashboard fonctionnel. Sonnet 5 référençait un fichier Chart.js inexistant sur cdnjs (l'URL renvoie 404), la bibliothèque ne se charge donc jamais et tous les panneaux, y compris les tableaux simples, restent vides. Sonnet 5.5 vérifie aussi le chargement de sa bibliothèque de graphiques et conserve des tableaux fonctionnels si elle ne se charge pas.
- Sonnet 5.5 a repéré le piège des petits échantillons, en partie. Il marque les filières avec moins de 30 répondants « à interpréter avec prudence » et ajoute un filtre sur le nombre minimal de répondants. Sa vue par défaut place Petroleum Engineering en #1 sans avertissement.
- Sonnet 5 serait passé à côté de toute façon. Son code lit les colonnes taille d'échantillon et plage de salaires, puis ne les utilise jamais, et classe les filières par la seule médiane.
- Les pièges plus mineurs n'ont piégé personne. Les deux gèrent explicitement la ligne Food Science vide, et Sonnet 5.5 calcule la part d'emplois de niveau université sans laisser entendre que les colonnes d'emploi totalisent l'ensemble.
Voici le dashboard de Sonnet 5.5 avec le filtre réglé sur les filières avec au moins 100 répondants.
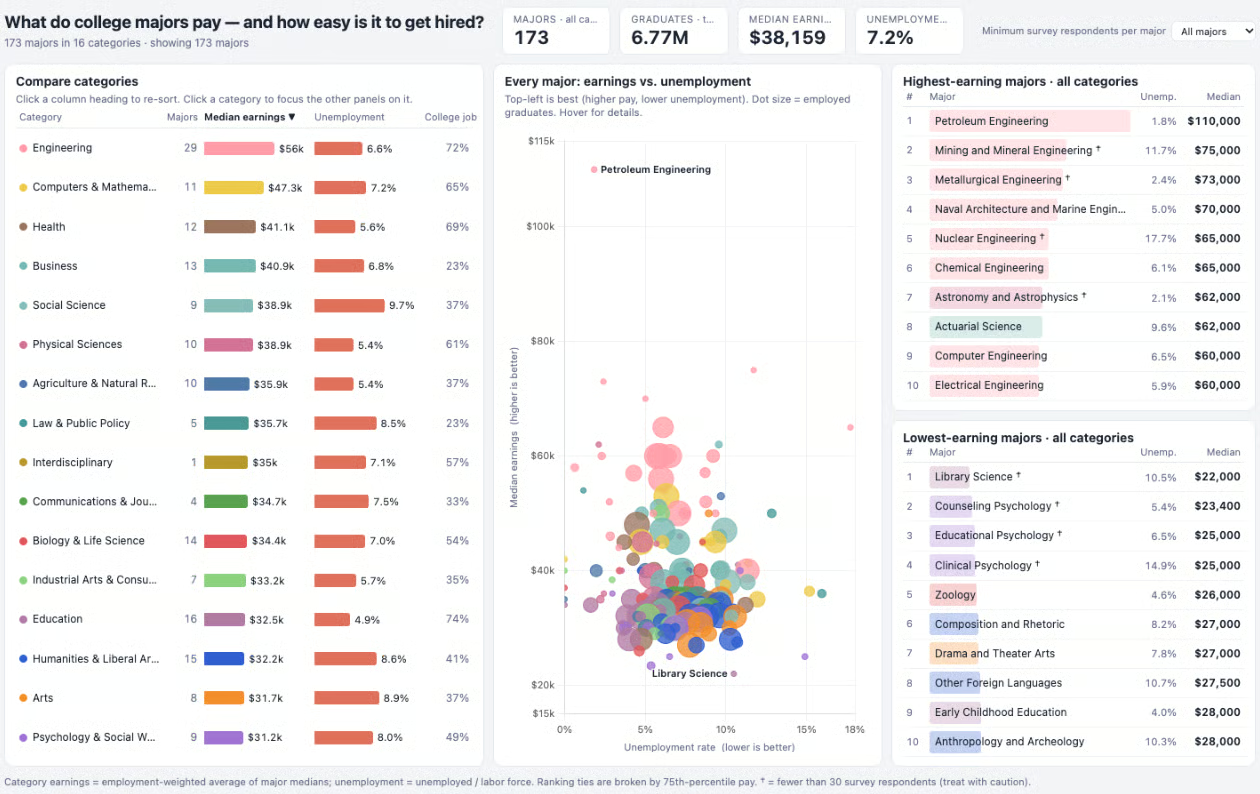
J'ai noté le dashboard de Sonnet 5.5 à 4 sur 5 pour l'honnêteté sur les données, 5 pour l'utilité analytique, et 4 pour la qualité des graphiques et de la mise en page. La page blanche de Sonnet 5 est ci-dessous.
Pourquoi Sonnet 5 a-t-il échoué ? Le problème, c'est que le dashboard avait besoin d'une bibliothèque de graphiques. Sonnet 5 a demandé à cdnjs une version qu'il n'héberge pas. Il a alors reçu une erreur « 404 ». Sans la bibliothèque, le code de Sonnet 5 a planté : « Chart is not defined. » Apparemment, Sonnet 5 avait structuré la page pour que tout, y compris les tableaux en texte brut, s'exécute après cette étape, et il n'a pas su intercepter l'erreur.
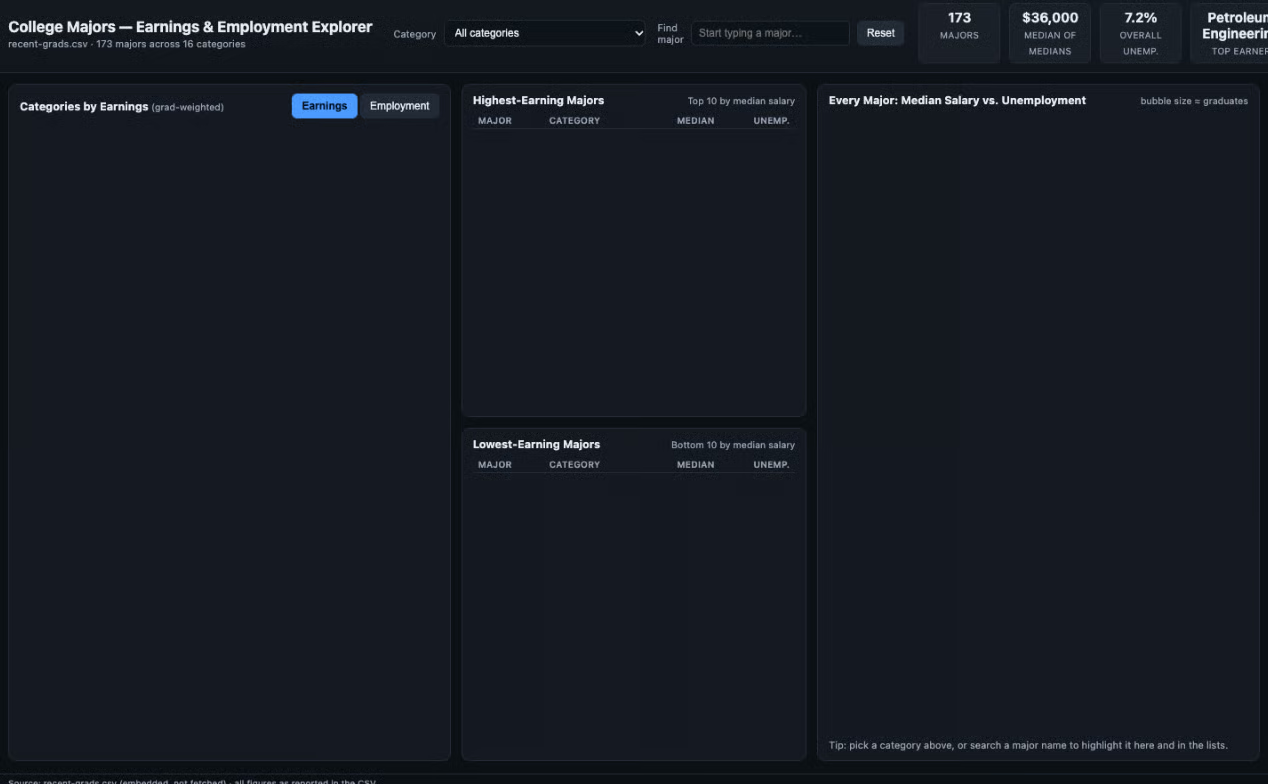
Le coût par exécution était quasiment identique : $0,56 pour Sonnet 5.5 et $0,57 pour Sonnet 5. Et Sonnet 5.5 a terminé plus vite.
Alors, Sonnet 5.5 est-il un vrai progrès ? Sur cette tâche, oui. Sonnet 5.5 a livré un dashboard fonctionnel qui alerte sur les données fragiles, là où Sonnet 5 a livré une page blanche.
Prix et disponibilité de Claude Sonnet 5.5
Claude Sonnet 5.5 coûte $2 par million de tokens d'entrée et $10 par million de tokens de sortie sur l'API, inchangé par rapport à Sonnet 5 et à moitié du prix d'Opus 5.5. Anthropic rapporte moins de tokens par tâche, ce qui réduit le coût effectif d'un job même si le tarif est fixe. Dans notre test pratique, toutefois, les deux modèles ont coûté sensiblement la même chose pour terminer la tâche.
| Type de token | Prix pour 1M tokens |
|---|---|
| Entrée | $2 |
| Sortie | $10 |
| Écriture cache (5 minutes) | $2,50 |
| Écriture cache (1 heure) | $4 |
| Lecture cache | $0,20 |
L'API Batch applique 50% de remise sur l'entrée et la sortie. Le prompt minimal à mettre en cache est de 512 tokens, et sur l'API Message Batches le modèle peut renvoyer jusqu'à 300K tokens de sortie avec l'en-tête beta output-300k-2026-03-24.
Sonnet 5.5 est généralement disponible, pas en préversion, avec option de rétention zéro de données. Anthropic s'engage à ne pas le retirer avant le 28 septembre 2027.
Comment accéder à Claude Sonnet 5.5 ?
Vous pouvez utiliser Claude Sonnet 5.5 dès aujourd'hui dans les applications Claude, dans Claude Code, et via l'API avec l'ID de modèle claude-sonnet-5-5. Il est aussi disponible sur Amazon Bedrock sous anthropic.claude-sonnet-5-5, ainsi que sur Google Cloud, Microsoft Foundry et Claude Platform sur AWS sous claude-sonnet-5-5.
Voici un appel Python minimal. La pensée adaptative est activée par défaut, la réponse peut donc inclure des blocs de pensée avant le texte :
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Pour un guide pas à pas des clés, des coûts et de votre premier projet, consultez notre guide complet de l'API Claude. Si vous construisez des agents, notre tutoriel sur la création d'agents Claude Managed est une bonne étape suivante. Nous publierons bientôt un tutoriel API pour Claude Sonnet 5.5.
Conclusion
Anthropic parie que l'essentiel du travail facturé, y compris la plupart des travaux d'agents de code, tournera sur ce nouveau modèle intermédiaire. Cela met aussi une pression directe sur GPT-6 Sol d'OpenAI, qui est derrière sur les chiffres de travail de connaissance publiés par Anthropic.
Je basculerais dès maintenant si vous êtes sur Sonnet 5, en prenant le temps de vous mettre à jour sur les changements d'API. Conservez Opus 5.5 pour les projets où le modèle doit d'abord décider quoi construire.
Si vous souhaitez aller plus loin sur la construction avec les modèles d'Anthropic, je vous recommande notre cours Introduction to Claude Models.