
Last chance! 50% off DataCamp Premium
Sale ends in
Anthropic が Claude Opus 5.5 を最上位として発表してから 6 日、ミッドレンジのモデルが半額で差の大半を詰めました。Claude Sonnet 5.5 はあるベンチマークで Opus 5.5 を上回り、他でもわずか数ポイント差に迫りつつ、価格は Sonnet 5 を据え置きです。
このパターンは以前から見ています。Claude Sonnet 5 は、コストのごく一部で Opus 4.8 のエージェント系ベンチマークに迫って登場しました。その前は Sonnet 4.6 が、同条件で Opus 4.6 に肉薄しました。毎回、フラッグシップの数日から数週間後にミッドレンジが現れ、半額で差の大半を埋めるのです。
これは外から見る対数的スケーリング曲線そのものです。性能は計算量の対数におおむね比例して伸びるので、コストは性能に対して概ね指数的に増えます。フラッグシップはその曲線の頂上付近にいて、最後の数ポイントを買うために大きなコストを払っています。同じ基盤的改良の恩恵を受けつつ数週間遅れて作られる安価なモデルは、曲線上のより低い位置に到達すれば、ほぼ同等に見えます。つまり、曲線の価値の大半はまだ安く手に入り、最後のひと伸ばしだけが高くつくということです。
主要企業が広報やブランディングで少し魔法をかけてくるので、これは切り分けて考える価値があります。
Anthropic のモデルドキュメントでは、Claude Sonnet 5.5 を現行ラインナップで「速度と知性の最良の組み合わせ」と説明しています。Claude 5.5 ファミリーのミッドレンジで、フラッグシップの Claude Opus 5.5 と、今後登場予定の Claude Haiku 5.5 の間に位置します。(Haiku 5 は結局出なかったものの、Haiku 5.5 については続報をお伝えします。)
Sonnet 5 と比べると、飛躍は「0.5」以上に大きい印象です。Opus 5.5 と Opus 5 の間の伸びが想定以上だったことを踏まえれば、驚きではありません。
発表記事によれば、Anthropic は公開したすべてのベンチマークで改善を報告しており、特にターミナルコーディング、チャート読解、ナレッジワーク評価での伸びが大きいとしています。
興味深いことに、Anthropic はこの Sonnet モデルが、スクリーンショットだけで ポケモン赤 を初めてクリアしたと述べています。少し変わっていますが、これは長期的タスクや画像理解の代理指標として Anthropic が使っているテストです。
同社の言葉を借りれば、Opus 5.5 は継続的な判断が必要な複雑でオープンエンドな作業で明確に優位です。一方、Sonnet 5.5 は「完了」の姿がはっきりしているタスクに向くモデル、という分け方は有用なヒューリスティクスです。
Sonnet 5.5 の新機能の多くは、同じ作業をより速く、より少ないトークンでこなすことに関するものです。加えて、API 利用者が対応すべきいくつかの変更があります。
これまで Opus が欲しかった類いの作業を Sonnet 5.5 に任せ、より速く返すことができます。Anthropic によれば、出力生成は Sonnet 5 より 30% 超高速化され、1 タスクあたりの使用トークンも減少——「最大 30% 削減」と表現しています。
発表記事で引用された初期テスターの数値もこれを裏付けます。
いずれもベンダー選定の顧客引用ではありますが、反復とトークンの削減という一定の傾向が見られます。これはトークン単価と並んで、請求額に効いてきます。
Sonnet 5.5 は、シェルコマンドの実行、リポジトリ横断のバグ修正、スクリーンショット経由のデスクトップ操作といったエージェント動作を前提に作られています。リリース時点から Claude Code で利用でき、コンピュータ操作は Opus 5.5 に近いと説明されています。
実用面では、Claude Code セッションや、こちらのClaude API ガイドで自作するエージェントループの既定モデルとして、Sonnet 5.5 を選べるようになったと言えます。
Anthropic は Sonnet 5.5 の強みとして「デザインに鋭い目」を挙げています。実際には、フロントエンドコードのブラッシュアップ依頼でより見栄えのする UI を、スライドやスプレッドシート、長文ドキュメントの作成依頼でより完成度の高い出力を期待できるはずです。
もっとも検証が必要なのはこのデザイン面の主張です。ベンチマークが難しく、発表記事でも顧客引用の裏付けにとどまっています。
Sonnet 5.5 は、Opus 5.5 と同等のサイバーセキュリティセーフガードを備えてローンチした初の Sonnet モデルです。高リスクのセキュリティ作業と分類されたリクエストは Sonnet 5 にフォールバックします。バイオ関連のセーフガードは Sonnet 5 と同じで、ソフトウェア開発やライフサイエンスの大半は影響を受けないとしています。
また、推論抽出をブロックする分類器を初めて同梱し、thinking ブロックはそれを生成したアカウントと会話に紐づくようになりました。もしセキュリティ系ツールを運用しているなら、パイプライン切替前にプロンプトをテストしてください。
モデル ID の差し替えだけでは不十分です。Anthropic のドキュメントは、Sonnet 5 で動いているコードに対する 5 つの破壊的変更を挙げています。
アダプティブ思考がデフォルトで有効になり、最小設定は between_tools(先行思考をオフにする)です。
強制的なツール使用はエラーになります。
thinking ブロックは、それを生成したモデルと会話に紐づきます。
旧来の computer_20251124 コンピュータ使用ツールは Claude API と Google Cloud で拒否されます。
advisor ツールは Opus 4.8、Opus 4.7、Sonnet 5 をアドバイザーとして受け付けなくなります。
静かな変更もあります。ツール呼び出し間のテキストは thinking ブロックで返るようになりました。ユーザーへテキストをストリーミングするアプリは、display 設定を更新するまでツール呼び出しの間が無音になります。さらに、temperature、top_p、top_k をデフォルト以外に設定すると 400 エラーが返ります。遭遇しがちなポイントです。
Claude Sonnet 5.5 は、Anthropic が公開した全ベンチマークで Sonnet 5 を上回り、ターミナルコーディングで Opus 5.5 を凌駕、他は数ポイント差で追随します。OpenAI の GPT-6 Sol に対しては、ナレッジワークとチャート読解で優位、FrontierCode では後塵を拝します。以下の数値はすべて Anthropic の発表記事からの引用です。
| ベンチマーク | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% | 非公開 |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | 非公開 |
| FrontierCode 1.1(メイン) | 46.2%(max effort) | 42.4% | 54.4% | 49.3%(xhigh で 52.1%) |
| GDPval-AA v2.1(Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1(Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam(ツールあり) | 64.5% | 54.9% | 67.7% | 非公開 |
| OSWorld 2.1 | 80.1% | 57.0% | 81.8% | 非公開 |
| Chartography(ツールなし) | 61.6% | 15.6% | 64.4% | 53.6% |
表が語るのは単純です。Sonnet 5 からの大きな世代飛躍、そして Opus 5.5 にほぼ肩を並べる水準。各分野が仕事に何を意味するかを見ていきます。
Sonnet 5.5 が頭一つ抜けたのが Terminal-Bench 4.0。Sonnet 5 の 10.3% から 70.6% に跳ね上がり、Opus 5.5 の 66.4% を上回ります。コマンドライン環境で実タスク(多段のシェル作業など)を完了できるかを測るベンチマークで、Claude Code の実態に近い指標です。
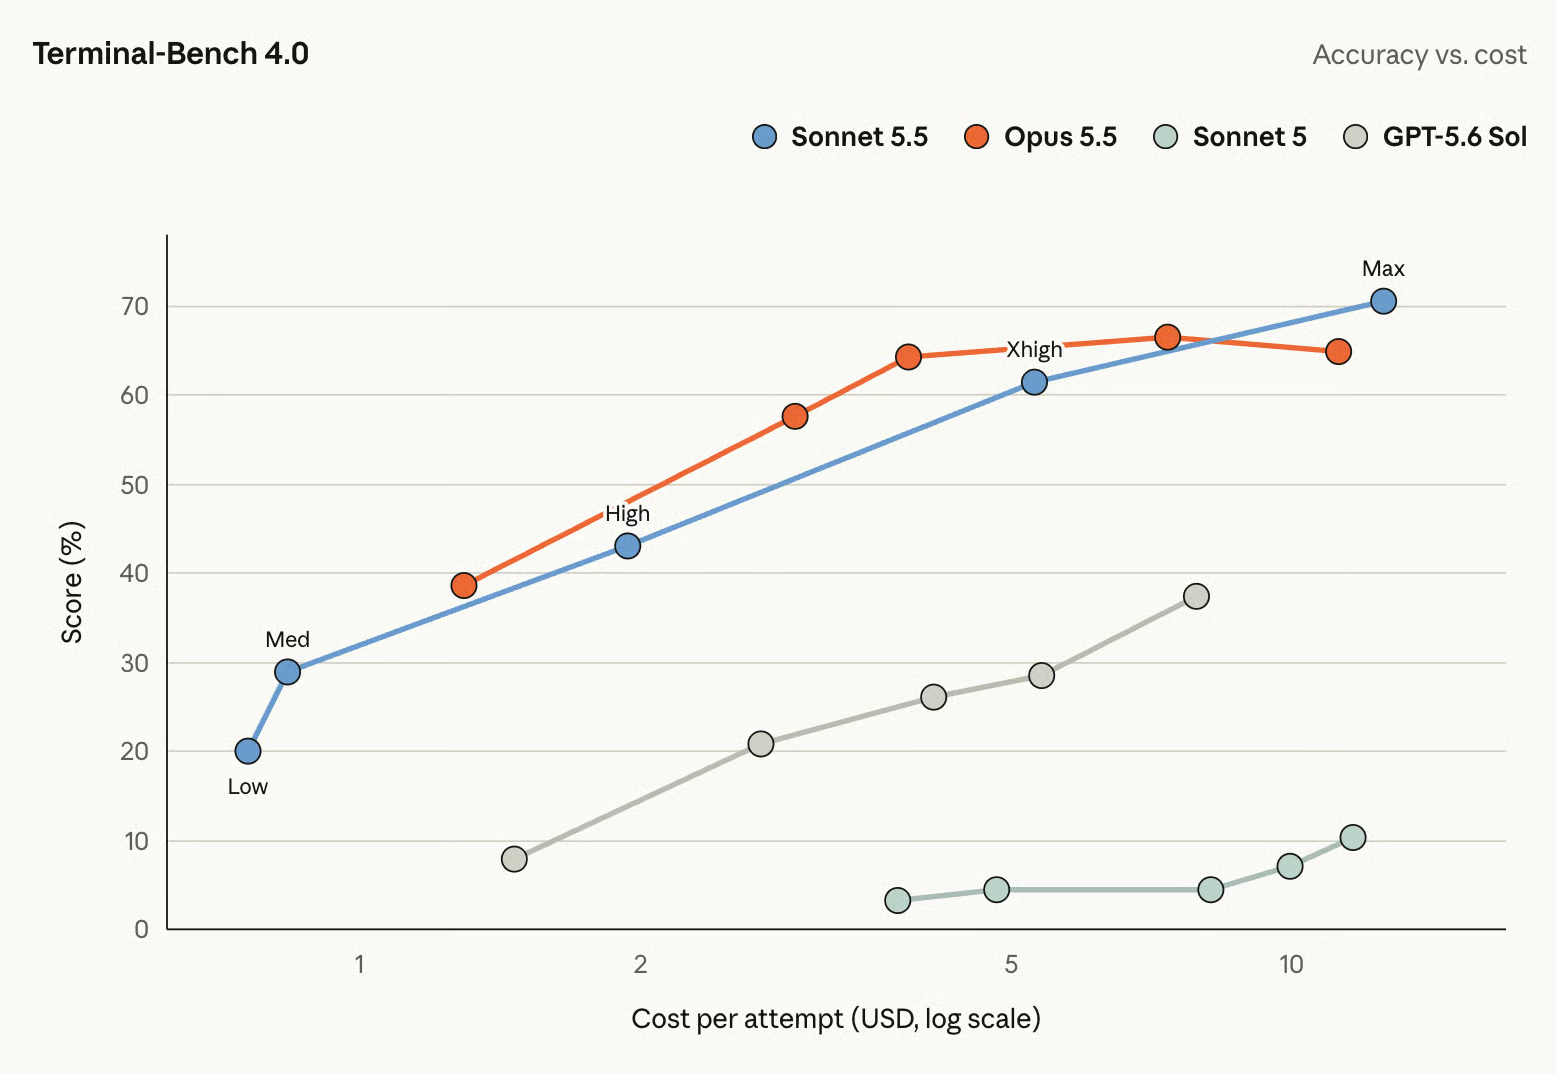
1 リリースで 60 ポイントのジャンプは異例です。その他のコーディング面はここまで劇的ではありません。
現実の職務に基づく経済価値タスクの出力を Elo 風に評価する GDPval-AA v2.1 で、Sonnet 5.5 は 1844。Opus 5.5 に 2 ポイント差で迫り、Sonnet 5 に約 400 ポイント差をつけます。
レポート、分析、ビジネス文書で Claude を使うチームには、これがもっとも実用的な結果です。この種の作業では、Opus 5.5 の追加コストが買う差は小さいと言えます。
ツールなしでチャートを読み推論する Chartography では、相対的に最大の伸びが見られます。Sonnet 5 の 15.6% に対して Sonnet 5.5 は 61.6%。Anthropic の画像理解向上の主張と合致します。
実際のデスクトップ OS を操作してタスクを完了できるかを見る OSWorld 2.1 で、Sonnet 5.5 は 80.1% に到達。Sonnet 5 の 57.0% から伸び、Opus 5.5 との差も 2 ポイントです。
多くの開発者にとって、既定の Claude モデルは Sonnet 5.5 でよいでしょう。タスクが十分にオープンエンドで、ボトルネックが速度ではなく判断である場合にのみ、Opus 5.5 の高価格が正当化されます。
Anthropic のモデル比較表による現行ラインナップは次のとおりです。Haiku 4.5 を除く 4 モデルは、いずれも 100 万トークンのコンテキストと最大 128K の出力を共有します。
| モデル | 価格(入力/出力・100 万トークンあたり) | レイテンシ | 適した用途 |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | 遅め | コストより能力が重視されるトップエンドの作業 |
| Claude Opus 5.5 | $4 / $20 | 中程度 | 継続的な判断が必要な複雑でオープンエンドの作業 |
| Claude Sonnet 5.5 | $2 / $10 | 高速 | スコープが明確なコーディング、エージェント、文書作成 |
| Claude Haiku 4.5 | $1 / $5 | 最速 | 大量・コスト重視のタスク |
Sonnet 5.5 内では、effort 設定がもう一つのレバーです。Anthropic は low、medium、high、xhigh、max の 5 段階を再調整しました。低設定は速度とコストを優先し、高設定はモデルに長く考えさせ自己検証を促します。既定は Claude アプリと Claude Code で medium、API で high です。
発表記事の一節は使い方を変えます。low か medium の effort でも、Sonnet 5.5 は複数のベンチマークで Sonnet 5 の最高スコアを、タスクあたりコスト 1/10 程度で上回ります。まとめると:
バグ修正、リファクタ、Claude Code セッション: 既定の effort の Sonnet 5.5。
高スループットのエージェントループ/パイプライン: Sonnet 5.5 を low または medium で開始し、失敗時のみ effort を上げる。
仕様が明確な難問コーディング: Opus 課金に行く前に、Sonnet 5.5 を xhigh または max で。
あいまいで複数日にわたるプロジェクト: Opus 5.5。
上のベンチマークは Anthropic 自身のものなので、同一プロンプト・同一ツールで Claude Sonnet 5.5 と Claude Sonnet 5 にビルドタスクを 1 件走らせました。
タスク: FiveThirtyEight の新卒者データセット(米国の 173 専攻、CC BY 4.0)を、将来の学生が収入・雇用でカテゴリ比較し、最高・最低年収の専攻を探せる 1 ファイルの HTML ダッシュボードにする。
肝はデータです。プロンプトでは触れていない次のような特徴があります。
これらに気づけるかがテストの狙いです。Anthropic の「デザインに鋭い目」という主張を検証します。
主な結果:
以下は、回答者 100 人以上にフィルタした Sonnet 5.5 のダッシュボードです。
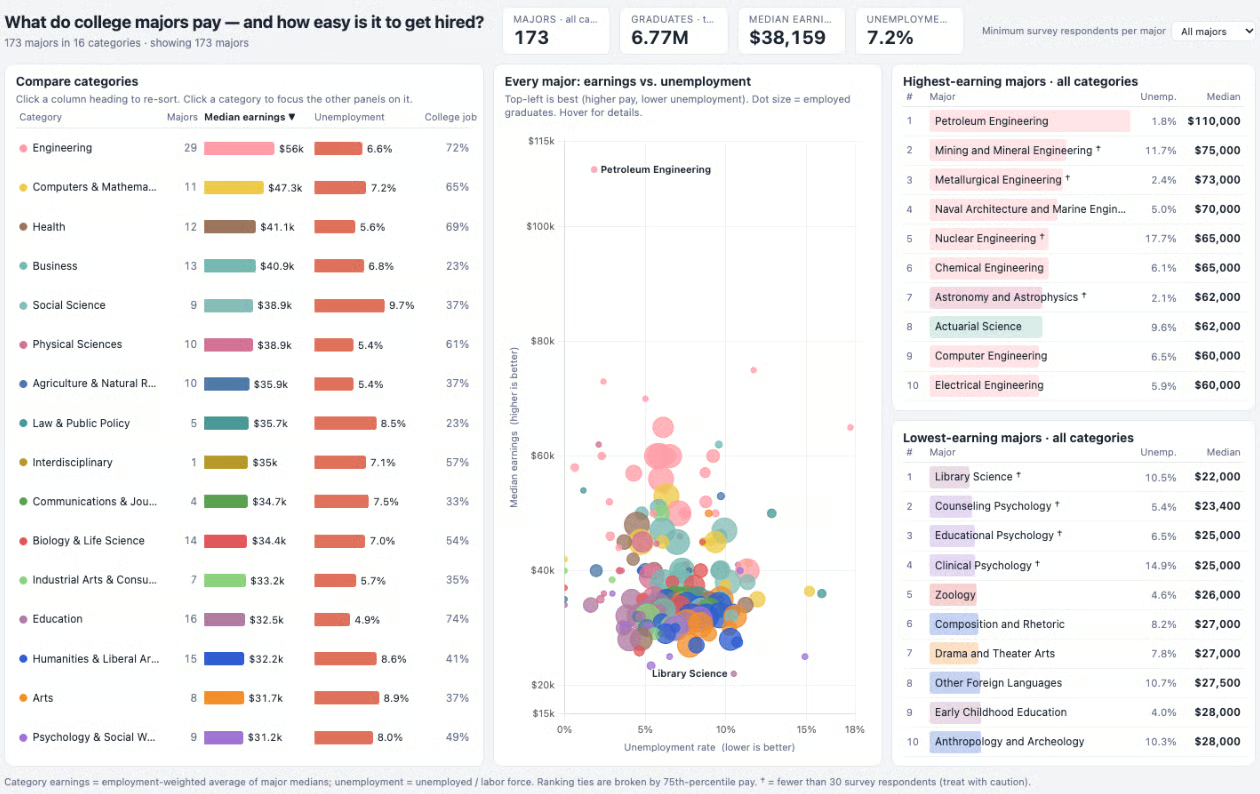
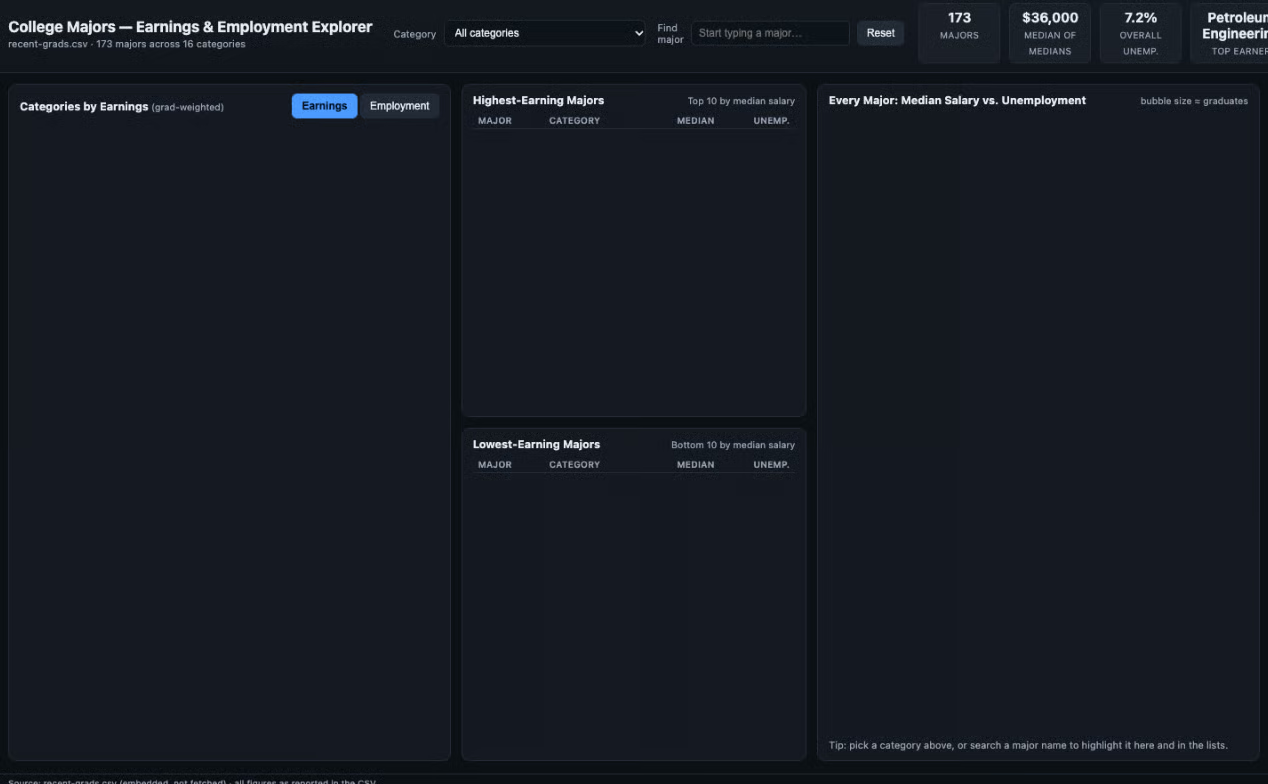
データの扱いの誠実さは 5 点満点中 4、分析の有用性は 5、チャートとレイアウトの質は 4 と採点しました。Sonnet 5 の空ページは以下に載せます。
なぜ Sonnet 5 は失敗したのか。原因はダッシュボードにチャートライブラリが必要だったことです。Sonnet 5 は cdnjs にないバージョンを要求し、「404」を受け取りました。ライブラリなしで Sonnet 5 のコードは「Chart is not defined」としてクラッシュ。ページの組み方が、プレーンな表すらもその後段に依存しており、失敗を拾えなかったようです。
実行あたりのコストはほぼ同じで、Sonnet 5.5 が $0.56、Sonnet 5 が $0.57。Sonnet 5.5 のほうが仕上がりも速かったです。
では Sonnet 5.5 は実際に前進か?このタスクではイエス。薄いデータへの警告付きで動くダッシュボードを出荷したのは Sonnet 5.5、Sonnet 5 は白紙でした。
Claude Sonnet 5.5 の API 価格は、入力 100 万トークンあたり $2、出力 100 万トークンあたり $10。Sonnet 5 から据え置きで、Opus 5.5 の半額です。Anthropic は 1 タスクあたりの使用トークン減少を報告しており、レートは同じでも実効コストは下がる可能性があります。なおハンズオンでは両モデルともほぼ同コストでした。
| トークン種別 | 100 万トークンあたりの価格 |
|---|---|
| 入力 | $2 |
| 出力 | $10 |
| キャッシュ書き込み(5 分) | $2.50 |
| キャッシュ書き込み(1 時間) | $4 |
| キャッシュ読み出し | $0.20 |
Batch API では入力・出力ともに 50% 割引。キャッシュ可能な最小プロンプトは 512 トークンで、Batch API では output-300k-2026-03-24 ベータヘッダにより最大 300K の出力が可能です。
Sonnet 5.5 はプレビューではなく一般提供で、データ保存なしのオプションがあります。Anthropic は 2027 年 9 月 28 日以前に廃止しないことを約束しています。
Claude アプリ、Claude Code、API でモデル ID claude-sonnet-5-5 を指定して、今日から Claude Sonnet 5.5 を使えます。Amazon Bedrock では anthropic.claude-sonnet-5-5、Google Cloud、Microsoft Foundry、AWS 上の Claude Platform でも claude-sonnet-5-5 として提供されています。
最小の Python 呼び出し例です。アダプティブ思考は既定で有効なため、応答にはテキスト前に thinking ブロックが含まれ得ます。
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
print(block.text)鍵やコスト、最初のプロジェクトまでの実践的な手順は、Claude API 完全ガイドを参照してください。エージェント構築中であれば、Claude Managed Agents の作り方チュートリアルが次の一歩に適しています。Claude Sonnet 5.5 の API チュートリアルも近日公開します。
Anthropic は、有償の多くの作業——コーディングエージェントの大半も含め——がこの新ミッドレンジで動くと見ています。これは、Anthropic のナレッジワーク指標で劣後する OpenAI の GPT-6 Sol にも直接的な圧力となります。
Sonnet 5 を使っているなら今すぐ切り替えてよいでしょうが、API 変更点の確認は忘れずに。何を作るかの判断をモデルに委ねるプロジェクトには Opus 5.5 を残してください。
Anthropic のモデルでの構築に関心がある場合は、Introduction to Claude Models コースをおすすめします。