La șase zile după ce Anthropic a pus Claude Opus 5.5 în fruntea gamei, modelul din segmentul mediu a recuperat cea mai mare parte a diferenței la jumătate din preț. Claude Sonnet 5.5 îl depășește pe Opus 5.5 într-un benchmark și este la doar câteva puncte în urmă în rest, păstrând în același timp prețurile lui Sonnet 5.
Am mai văzut acest tipar. Claude Sonnet 5 a fost lansat apropiindu-se de benchmark-urile agentice ale lui Opus 4.8 la o fracțiune din cost. Înainte de asta, Sonnet 4.6 a ajuns aproape de Opus 4.6 în aceiași termeni. De fiecare dată, un model de nivel mediu apare la câteva zile sau săptămâni după vârf de gamă și închide mare parte din diferență la jumătate din preț.
Asta înseamnă o curbă de scalare logaritmică văzută din exterior. Performanța crește aproximativ cu logaritmul puterii de calcul, așa că și costul crește aproximativ exponențial cu performanța. Un model de vârf stă în partea superioară a curbei, unde cheltuiește mult pentru a cumpăra ultimele câteva puncte. Un model mai ieftin construit câteva săptămâni mai târziu, beneficiind de aceleași progrese de bază, are nevoie doar să atingă un punct mai jos pe curbă pentru a părea aproape la fel de bun. Cu alte cuvinte, cea mai mare parte a valorii curbei e încă ieftină, iar doar ultima porțiune e scumpă.
Cred că merită evidențiat, pentru că firmele de top fac puțină magie cu PR-ul și brandingul.
Pe scurt
- Sonnet 5.5 este noul model mid-tier al Anthropic, înlocuindu-l pe Sonnet 5 la același preț.
- Câștigul principal este la codarea agentică în terminal, unde acum chiar îl depășește pe Opus 5.5.
- La munca de cunoaștere și folosirea calculatorului, stă imediat în spatele lui Opus 5.5, la jumătate din prețul per token.
- Fă-l modelul tău Claude implicit și păstrează Opus 5.5 pentru munca deschisă, unde judecata cântărește mai mult.
Ce este Claude Sonnet 5.5?
Documentația Anthropic descrie Claude Sonnet 5.5 drept „cea mai bună combinație de viteză și inteligență” din gama actuală. Este modelul de nivel mediu din familia Claude 5.5 a Anthropic, situat între vârful de gamă Claude Opus 5.5 și viitorul Claude Haiku 5.5. (Te vom ține la curent cu Haiku 5.5, deși Haiku 5 nu a mai apărut.)
Comparat cu Sonnet 5, saltul este mai mare decât sugerează o jumătate de versiune. Nu e surprinzător după ce am văzut că și trecerea de la Opus 5 la Opus 5.5 a fost mai mare decât ne așteptam.
Cât despre postarea de lansare - Anthropic raportează câștiguri pe fiecare benchmark publicat, cu cele mai mari salturi la codarea în terminal, citirea de diagrame și evaluările pentru munca de cunoaștere.
Interesant, Anthropic spune că acesta este primul model Sonnet care bate Pokémon Red lucrând doar din capturi de ecran. Sună neobișnuit, dar e un test pe care Anthropic îl folosește ca proxy pentru sarcini pe orizont lung și înțelegere a imaginilor.
Așadar, Opus 5.5 rămâne, în cuvintele companiei, clar mai puternic la munca complexă, deschisă, care cere judecată susținută. Dar Sonnet 5.5 este modelul pentru sarcini în care știi ce înseamnă „gata”, ceea ce e o euristică utilă.
Funcționalități-cheie Claude Sonnet 5.5
Majoritatea noutăților din Sonnet 5.5 țin de a face aceeași muncă mai rapid și cu mai puțini tokeni, plus câteva schimbări la care utilizatorii de API trebuie să fie atenți.
Obține rezultate aproape de Opus la sarcinile zilnice, la viteza Sonnet
Îi poți da lui Sonnet 5.5 tipul de muncă ce anterior cerea Opus și o primești înapoi mai repede. Anthropic spune că generarea de output e cu peste 30% mai rapidă decât la Sonnet 5 și că modelul folosește mai puțini tokeni per sarcină - „până la 30% mai puțin per sarcină” - acesta e procentul pe care îl menționează.
Primii testeri citați în postarea de lansare confirmă cu propriile cifre:
- Base44 raportează 3,6 iterații per build de aplicație cu Sonnet 5.5, față de 7,7 cu Opus 5.
- Box a văzut workload-urile rulând de 2,4 ori mai rapid cu 12% mai puțini tokeni în total.
- Zendesk a măsurat procesarea tichetelor cu 20% mai rapidă.
- Slack raportează aproximativ 14% mai puțini tokeni de output.
Acestea sunt citate de la clienți selectați de vendor. Totuși, se conturează un tipar: mai puține iterații și mai puțini tokeni, ceea ce contează la factură, pe lângă tariful per token.
Rulează agenți de cod în terminal și pe desktop
Sonnet 5.5 e construit să lucreze ca agent: rulează comenzi shell, repară buguri într-un repo și operează un desktop prin capturi de ecran. E disponibil în Claude Code de la lansare, iar Anthropic descrie folosirea calculatorului ca fiind aproape de Opus 5.5.
Concluzia practică pentru mulți este că Sonnet 5.5 e acum o opțiune credibilă implicită pentru sesiunile Claude Code și pentru buclele de agenți pe care le construiești singur, urmând ghidul nostru pentru API-ul Claude.
Produ documente, prezentări și interfețe finisate
Anthropic evidențiază o „atenție ascuțită la design” ca punct forte al lui Sonnet 5.5. În practică, asta ar trebui să însemne interfețe mai arătoase când îi ceri să rafineze codul de front-end și un output mai finisat când ceri slide-uri, foi de calcul sau documente lungi.
Afirmația despre design e cea care are cel mai mult nevoie de verificare independentă. E cel mai greu de evaluat prin benchmark-uri, iar postarea de lansare o susține doar cu citate de la clienți.
Așteaptă-te la măsuri de siguranță pentru securitate și biologie
Sonnet 5.5 este primul model Sonnet lansat cu măsuri de securitate cibernetică similare celor de pe Opus 5.5. Când o cerere este clasificată ca muncă de securitate cu risc mai ridicat, cererea revine la Sonnet 5. Măsurile pentru biologie sunt aceleași ca pe Sonnet 5, iar Anthropic spune că majoritatea lucrărilor de dezvoltare software și științe ale vieții nu vor fi afectate.
Este și primul Sonnet livrat cu clasificatori care blochează extragerea raționamentului, iar blocurile de gândire sunt acum legate de contul și conversația care le-au generat. Dacă rulezi unelte de securitate, testează-ți prompturile înainte de a schimba un pipeline.
Migrează de la Sonnet 5 cu câteva modificări de cod
Schimbarea ID-ului de model nu e chiar suficientă. Documentația Anthropic enumeră cinci schimbări care rup compatibilitatea pentru codul ce rulează deja pe Sonnet 5:
-
Gândirea adaptivă e activă implicit, iar setarea minimă este
between_tools, care dezactivează gândirea inițială. -
Forțarea folosirii unui tool returnează o eroare.
-
Blocurile de gândire sunt legate de modelul și conversația care le-au produs.
-
Tool-ul vechi de computer use
computer_20251124este respins pe Claude API și Google Cloud. -
Tool-ul advisor nu mai acceptă Opus 4.8, Opus 4.7 sau Sonnet 5 ca „advisors”.
Există și o schimbare mai discretă: textul dintre apelurile de tool revine acum în blocuri thinking. O aplicație care face streaming de text către utilizatori va rămâne tăcută între apelurile de tool până îi actualizezi setarea de display. Setarea temperature, top_p sau top_k la o valoare non-implicită returnează de asemenea o eroare 400. Sunt lucruri punctuale pe care le-ai putea descoperi.
Cum se descurcă Claude Sonnet 5.5 în benchmark-uri?
Claude Sonnet 5.5 îl depășește pe Sonnet 5 în fiecare benchmark publicat de Anthropic, îl bate pe Opus 5.5 la codarea în terminal și rămâne la câteva puncte în urmă peste tot în rest. În comparație cu GPT-6 Sol de la OpenAI, conduce la evaluările de muncă de cunoaștere și citire de diagrame, dar este în urmă la FrontierCode. Toate cifrele de mai jos provin din postarea de lansare a Anthropic.
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% | Neraportat |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | Neraportat |
| FrontierCode 1.1 (Main) | 46.2% (max effort) | 42.4% | 54.4% | 49.3% (52.1% la xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (cu tool-uri) | 64.5% | 54.9% | 67.7% | Neraportat |
| OSWorld 2.1 | 80.1% | 57.0% | 81.8% | Neraportat |
| Chartography (fără tool-uri) | 61.6% | 15.6% | 64.4% | 53.6% |
Tabelul spune o poveste simplă: un pas generațional mare peste Sonnet 5 și aproape egalitate cu Opus 5.5. Să vedem ce înseamnă fiecare zonă pentru munca ta.
Codare agentică
Terminal-Bench 4.0 este locul unde Sonnet 5.5 se desprinde. Are 70,6%, în urcare de la 10,3% la Sonnet 5 și peste 66,4% la Opus 5.5. Benchmark-ul măsoară dacă un model poate finaliza sarcini reale într-un mediu de linie de comandă, cum ar fi fluxuri shell pe mai mulți pași, așa că se potrivește îndeaproape cu modul în care e folosit Claude Code.
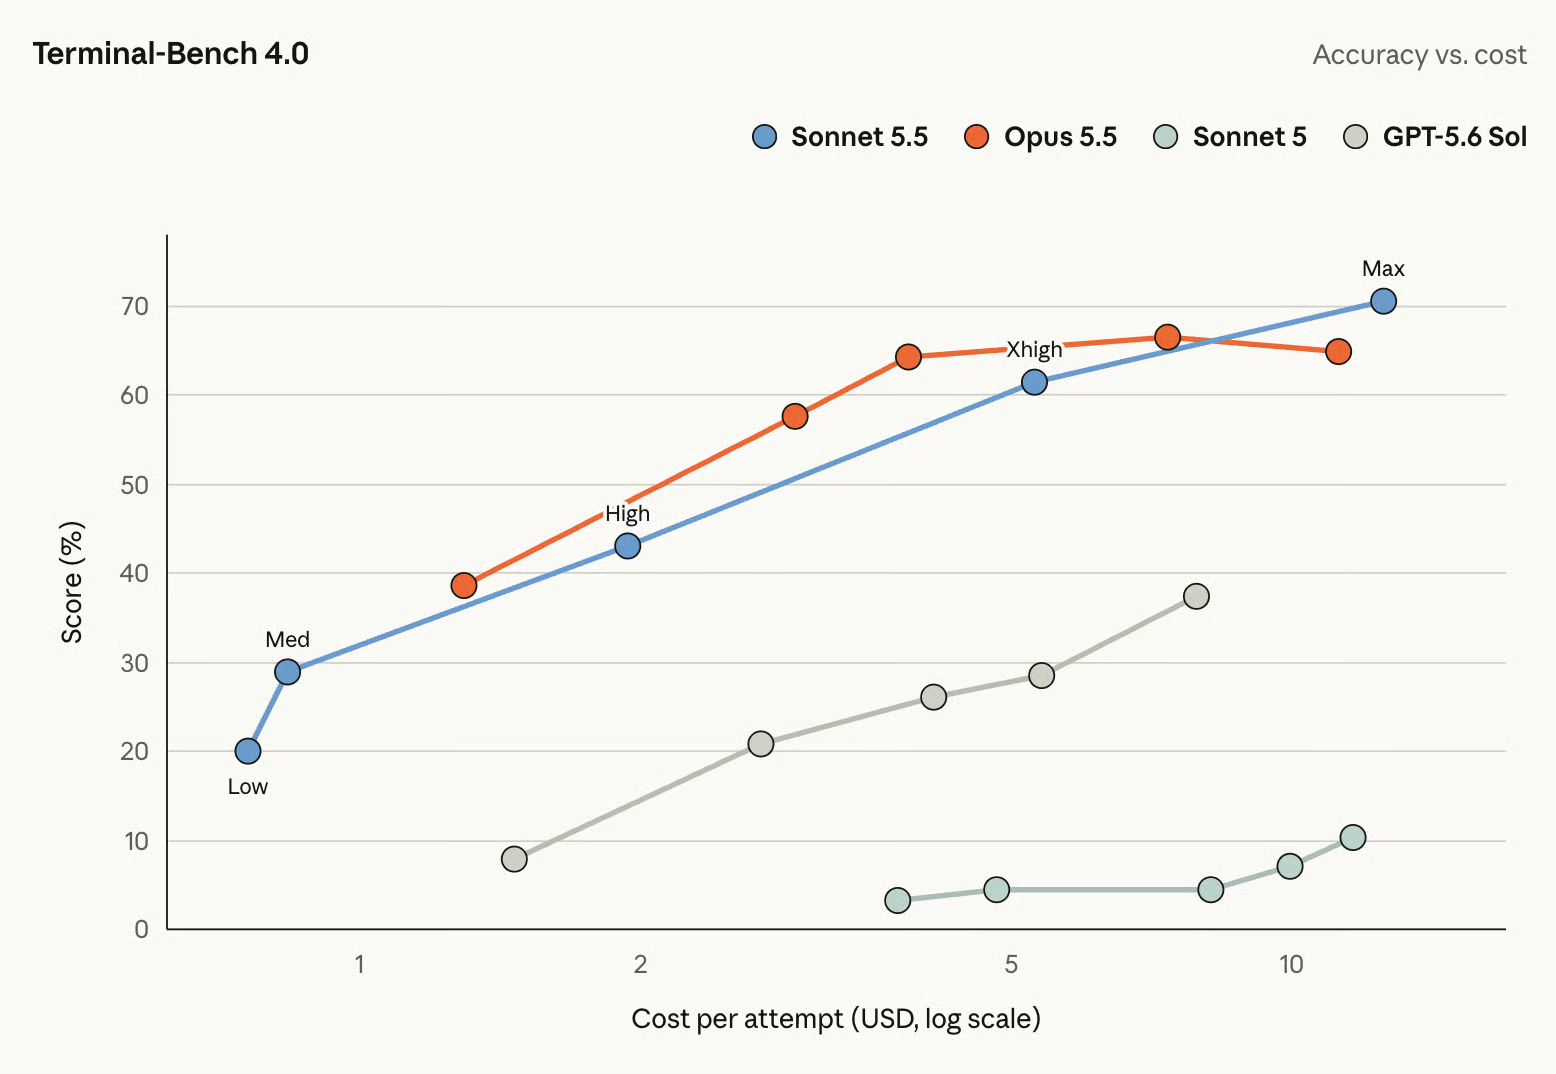
Un salt de 60 de puncte într-o singură versiune e destul de neobișnuit. Restul imaginii pe cod este mai puțin dramatic.
Muncă de cunoaștere
La GDPval-AA v2.1, care evaluează outputul modelului pe sarcini cu valoare economică din ocupații reale, folosind un scor de tip Elo, Sonnet 5.5 obține 1844. Asta înseamnă cu 2 puncte sub Opus 5.5 și cu aproape 400 peste Sonnet 5.
Pentru echipele care folosesc Claude pentru rapoarte, analize și documente de business, acesta e cel mai util rezultat din tabel. La acest tip de muncă, costul suplimentar al lui Opus 5.5 cumpără doar puțin în plus.
Raționament și înțelegere vizuală
Chartography, un test de citire și raționare pe diagrame fără tool-uri, arată cel mai mare câștig relativ: Sonnet 5.5 are 61,6% față de 15,6% la Sonnet 5. Asta se aliniază cu afirmațiile Anthropic despre îmbunătățirea înțelegerii imaginilor.
Folosirea calculatorului
La OSWorld 2.1, care măsoară dacă un model poate finaliza sarcini operând un sistem de operare desktop real, Sonnet 5.5 ajunge la 80,1%, în urcare de la 57,0% pentru Sonnet 5 și la 2 puncte de Opus 5.5.
Ce nivel ar trebui să folosești?
Pentru majoritatea dezvoltatorilor, Sonnet 5.5 ar trebui acum să fie modelul Claude implicit. Opus 5.5 își justifică prețul mai mare doar când sarcina e suficient de deschisă încât judecata, nu viteza, devine blocajul.
Gama actuală, conform tabelului de comparație a modelelor al Anthropic, arată astfel. Toate cele patru modele, cu excepția Haiku 4.5, au fereastră de context de 1M tokeni și output maxim de 128K.
| Model | Preț (input / output per 1M tokeni) | Latentă | Ideal pentru |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Mai lent | Muncă de top unde capabilitatea contează mai mult decât costul |
| Claude Opus 5.5 | $4 / $20 | Moderată | Muncă complexă, deschisă, care necesită judecată susținută |
| Claude Sonnet 5.5 | $2 / $10 | Rapid | Cod cu specificații clare, agenți și documente |
| Claude Haiku 4.5 | $1 / $5 | Cel mai rapid | Sarcini cu volum mare și sensibilitate la cost |
În cadrul lui Sonnet 5.5, setarea effort e celălalt levier. Anthropic a recalibrat cinci niveluri: low, medium, high, xhigh și max. Setările mai joase favorizează viteza și costul, în timp ce cele mai ridicate lasă modelul să raționeze mai mult și să-și verifice munca. Implicitul este medium în aplicațiile Claude și în Claude Code și high pe API.
Un detaliu din postarea de lansare îmi schimbă modul de utilizare: la effort low sau medium, Sonnet 5.5 bate cel mai bun scor al lui Sonnet 5 pe mai multe benchmark-uri la cam o zecime din costul per sarcină. Pe scurt:
-
Bugfix-uri, refactorizări și sesiuni Claude Code: Sonnet 5.5 la effort implicit.
-
Bucle și pipeline-uri de agenți cu debit mare: Sonnet 5.5 la
lowsaumedium, apoi crește effort-ul doar la eșecuri. -
Probleme grele de cod cu specificație clară: Sonnet 5.5 la
xhighsaumaxînainte de a plăti pentru Opus. -
Proiecte ambigue, pe mai multe zile: Opus 5.5.
Testarea lui Claude Sonnet 5.5: exemple practice
Benchmark-urile de mai sus sunt ale Anthropic, așa că am rulat o sarcină de build cu Claude Sonnet 5.5 și Claude Sonnet 5 cu un prompt identic și tooling identic.
Sarcina: transformă setul de date al proaspeților absolvenți colegiu de la FiveThirtyEight recent college grads (173 specializări din SUA, CC BY 4.0) într-un dashboard HTML într-un singur fișier care să ajute un viitor student să compare categoriile după câștiguri și angajare și să găsească specializările cu cele mai mari și cele mai mici câștiguri.
Testul real e în date, care au câteva caracteristici pe care promptul nu le menționează:
- Câștigătorul de top, Petroleum Engineering, are doar 36 de respondenți în sondaj, iar 76 din cele 173 de specializări au sub 100
- Distribuția câștigurilor e asimetrică, deci o singură bară a medianei ascunde multă variație
- O specializare, Food Science, are câmpuri goale la headcount
- Coloanele de tip de job nu se adună până la numărul de persoane angajate
Observarea acestor probleme e esența testului. Testul sondează afirmațiile Anthropic despre o „atenție ascuțită la design”.
Concluziile principale:
- Doar Sonnet 5.5 a livrat un dashboard funcțional. Sonnet 5 a legat un fișier Chart.js care nu există pe cdnjs (URL-ul întoarce 404), astfel că biblioteca nu s-a încărcat și fiecare panou, inclusiv tabelele simple, a fost randat gol. Sonnet 5.5 verifică și dacă biblioteca de chart s-a încărcat și își păstrează tabelele funcționale dacă nu.
- Sonnet 5.5 a prins capcana eșantionului mic, în mare. Marchează specializările cu sub 30 de respondenți drept „tratează cu prudență” și adaugă un filtru pentru numărul minim de respondenți. Vederea implicită pune Petroleum Engineering pe locul #1 fără un avertisment.
- Sonnet 5 ar fi ratat-o oricum. Codul lui citește coloanele de mărime a eșantionului și de plajă salarială, apoi nu le mai folosește, și clasează specializările doar după mediană.
- Capcanele mai mici nu au încurcat pe nimeni. Ambele au gestionat explicit rândul gol pentru Food Science, iar Sonnet 5.5 și-a calculat ponderea joburilor „de colegiu” fără a sugera că acele coloane însumează totalul angajărilor.
Iată dashboard-ul lui Sonnet 5.5 cu filtrul setat pe specializări cu cel puțin 100 de respondenți.
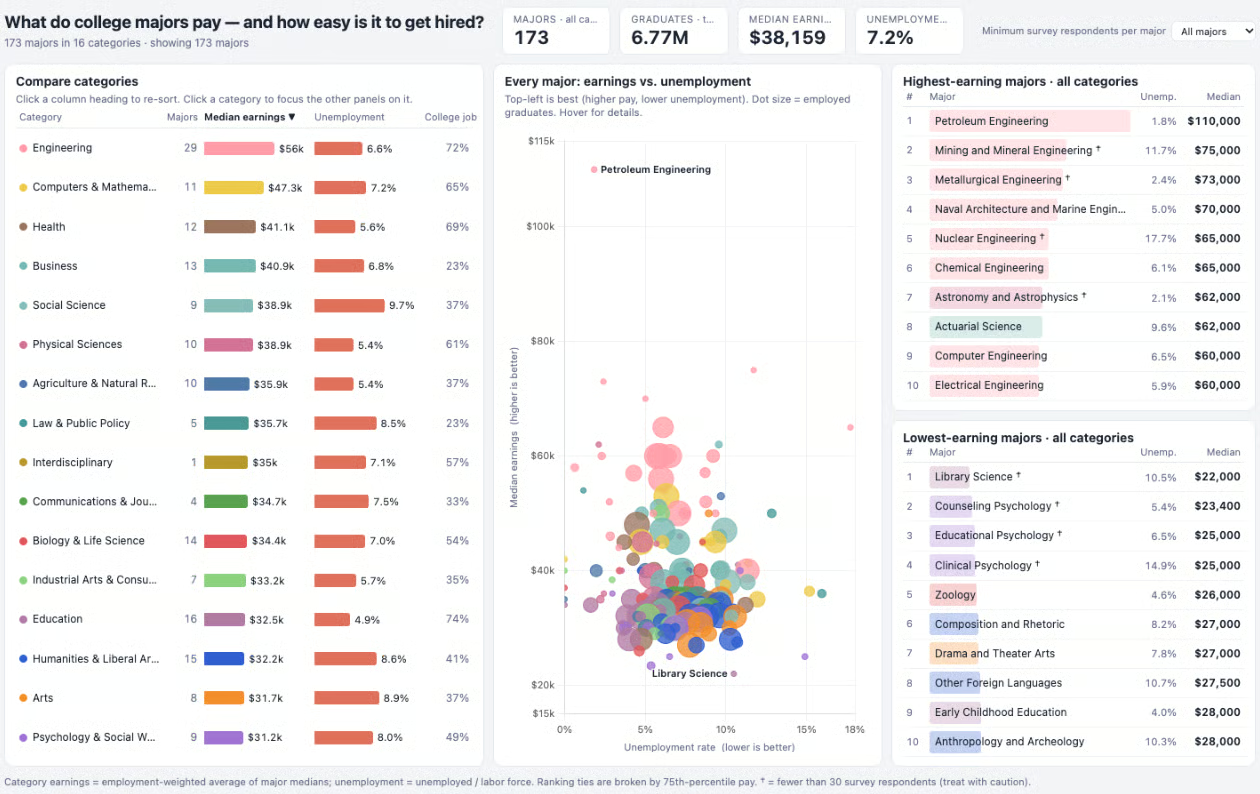
Am notat dashboard-ul lui Sonnet 5.5 cu 4 din 5 pentru onestitate în tratarea datelor, 5 pentru utilitate analitică și 4 pentru calitatea graficelor și a layout-ului. Pagina goală a lui Sonnet 5 e mai jos.
De ce a eșuat Sonnet 5? Problema a fost că dashboard-ul avea nevoie de o bibliotecă de charting. Sonnet 5 a cerut cdnjs o versiune pe care nu o găzduiește. A primit apoi o eroare „404”. Fără bibliotecă, codul lui Sonnet 5 a crăpat: „Chart is not defined.” Se pare că Sonnet 5 scrisese pagina astfel încât totul, chiar și tabelele simple de text, rula după acel pas și nu a putut prinde greșeala.
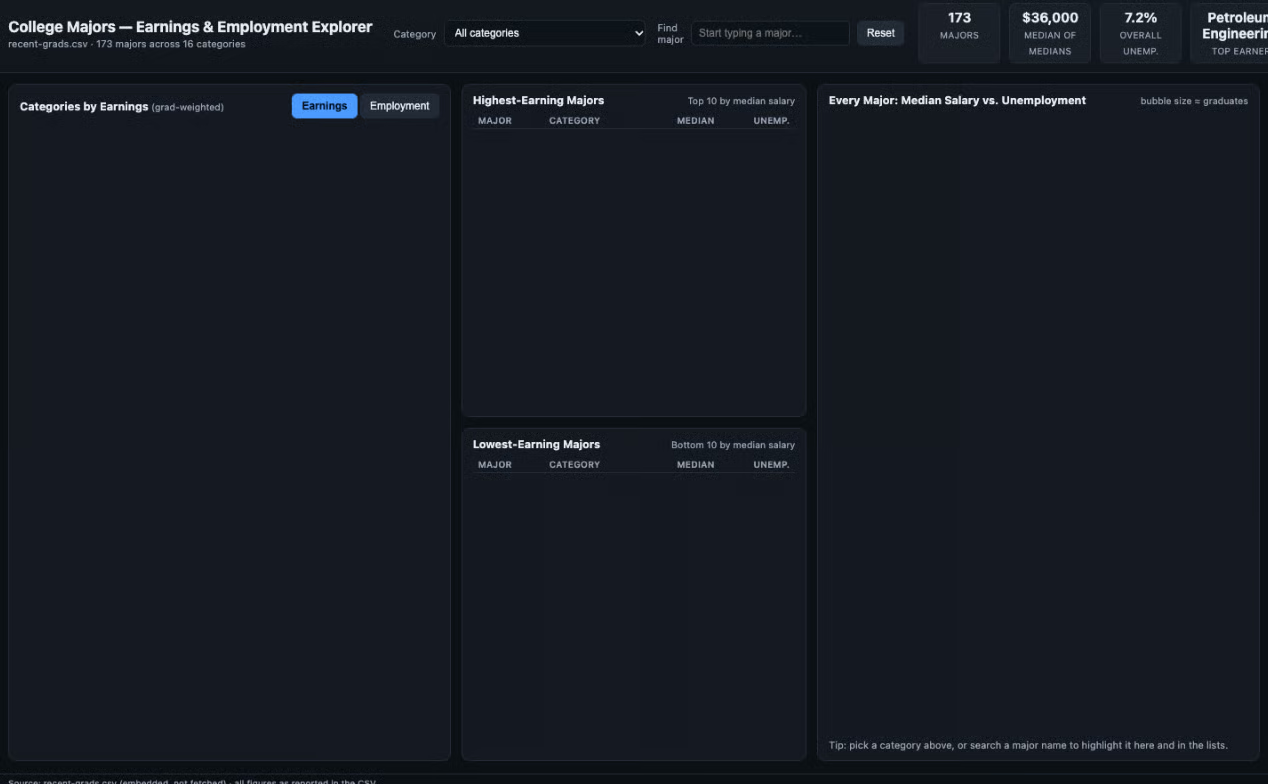
Costul per rulare a fost practic identic: 0,56 $ pentru Sonnet 5.5 și 0,57 $ pentru Sonnet 5. De asemenea, Sonnet 5.5 a terminat munca mai repede.
Este, așadar, Sonnet 5.5 un pas real înainte? La această sarcină, da. Sonnet 5.5 a livrat un dashboard care funcționează și te avertizează despre date subțiri, în timp ce Sonnet 5 a livrat o pagină goală.
Prețuri și disponibilitate pentru Claude Sonnet 5.5
Claude Sonnet 5.5 costă 2 $ per milion de tokeni de input și 10 $ per milion de tokeni de output pe API, neschimbat față de Sonnet 5 și la jumătate din prețul lui Opus 5.5. Anthropic raportează mai puțini tokeni per sarcină, ceea ce ar reduce costul efectiv al unei lucrări chiar dacă tariful e plat. În testul nostru practic, însă, ambele modele au costat cam la fel pentru a termina sarcina.
| Tip token | Preț per 1M tokeni |
|---|---|
| Input | $2 |
| Output | $10 |
| Cache write (5 minute) | $2.50 |
| Cache write (1 oră) | $4 |
| Cache read | $0.20 |
Batch API oferă o reducere de 50% atât la input, cât și la output. Promptul minim cacheabil este de 512 tokeni, iar pe Batch API modelul poate returna până la 300K tokeni de output cu header-ul beta output-300k-2026-03-24.
Sonnet 5.5 este disponibil în general, nu în previzualizare, cu opțiune de zero retenție a datelor. Anthropic se angajează să nu-l retragă înainte de 28 septembrie 2027.
Cum obții acces la Claude Sonnet 5.5?
Poți folosi Claude Sonnet 5.5 chiar azi în aplicațiile Claude, în Claude Code și prin API cu ID-ul de model claude-sonnet-5-5. Este disponibil și pe Amazon Bedrock ca anthropic.claude-sonnet-5-5 și pe Google Cloud, Microsoft Foundry și Claude Platform pe AWS sub claude-sonnet-5-5.
Iată un apel Python minimal. Gândirea adaptivă e activă implicit, astfel că răspunsul poate include blocuri de „thinking” înaintea textului:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Pentru un ghid real despre chei, costuri și primul tău proiect, vezi ghidul nostru complet pentru API-ul Claude. Dacă construiești agenți, tutorialul nostru despre construirea agenților gestionați Claude e un pas bun în continuare. Vom publica în curând un tutorial API pentru Claude Sonnet 5.5.
Gânduri finale
Anthropic pariază că cea mai mare parte a muncii plătite, inclusiv majoritatea muncii de agenți de cod, va rula pe acest nou model mid-tier. Asta pune presiune directă și pe GPT-6 Sol de la OpenAI, care e în urmă la cifrele Anthropic pentru munca de cunoaștere.
Aș face trecerea acum dacă ești pe Sonnet 5, dar actualizează-te la schimbările din API. Păstrează Opus 5.5 pentru proiecte în care modelul trebuie să decidă ce să construiască.
Dacă vrei să aprofundezi construcția cu modelele Anthropic, îți recomand cursul nostru Introduction to Claude Models.