在 Anthropic 将 Claude Opus 5.5 推到产品线顶端的六天后,中端型号以半价追平了大部分差距。Claude Sonnet 5.5 在一项基准上击败了 Opus 5.5,在其他项目上也只落后几个点,同时保持了与 Sonnet 5 相同的定价。
这种模式我们之前见过。Claude Sonnet 5 发布时,以更低成本逼近 Opus 4.8 的代理型评测。在那之前,Sonnet 4.6 也在相同条件下逼近了 Opus 4.6。每次都是旗舰机型发布后数天或数周,中端机型登场,以半价缩小大部分差距。
这就是从外部看“对数型扩展曲线”的样子。性能大致随算力的对数增长,因此成本与性能大致呈指数关系。旗舰模型位于曲线顶端,为“最后几分”付出高昂代价。几周后基于同样底层突破打造的更便宜模型,只需到达曲线较低位置,就能看起来几乎一样好。换句话说,曲线的大部分价值仍然容易获取,真正昂贵的是最后那段冲刺。
我之所以展开说,是因为领军公司在公关与品牌上确实颇有章法。
要点速览
- Sonnet 5.5 是 Anthropic 新的中端模型,以相同价格替代 Sonnet 5。
- 最大亮点是“代理型终端编码”,它现在略微超越 Opus 5.5。
- 在知识工作与电脑操作上,它以一半的每 token 价格略落后于 Opus 5.5。
- 将其设为您的默认 Claude 模型,将 Opus 5.5 留给开放式、判断密集型任务。
什么是 Claude Sonnet 5.5?
Anthropic 的模型文档称 Claude Sonnet 5.5 是当前产品线中“速度与智能的最佳组合”。它是 Claude 5.5 家族的中端模型,位于旗舰Claude Opus 5.5与后续的 Claude Haiku 5.5 之间。(我们会持续关注 Haiku 5.5,尽管 Haiku 5 并未发布。)
与 Sonnet 5 相比,这次跃升幅度大于“半个版本号”所暗示的。在看到 Opus 5.5 与 Opus 5 之间的提升超出预期后,这并不令人意外。
至于发布公告——Anthropic 报告称其公布的每项基准上都有提升,最大飞跃出现在终端编码、图表解读与知识工作评测。
有趣的是,Anthropic 表示,这是首个仅凭截图就能通关《精灵宝可梦 红》的 Sonnet 模型。听起来有些特别,但这是 Anthropic 用作“长程任务与图像理解”代理测试的项目。
因此,用该公司的话说,Opus 5.5 仍在复杂、开放式、需要持续判断的任务上更强。但 Sonnet 5.5 适用于那些“目标明确、知道成品应是什么样”的任务——这是个很实用的判断法则。
Claude Sonnet 5.5 关键特性
Sonnet 5.5 的新变化大多围绕“用更少的 tokens、更快地完成相同工作”,同时还有一些 API 用户需要提前规划的调整。
以 Sonnet 的速度拿到接近 Opus 的日常结果
您可以把过去更适合交给 Opus 的工作交给 Sonnet 5.5,并更快拿回结果。Anthropic 表示,其输出生成速度比 Sonnet 5 快 30% 以上,且每个任务消耗的 tokens 更少——“每个任务最多减少 30%”——这是他们给出的数字。
发布文中引用的早期测试用户也给出了类似数据:
- Base44 报告称每次应用构建的迭代次数,Sonnet 5.5 为 3.6 次,Opus 5 为 7.7 次。
- Box 的工作负载运行速度提升至 2.4 倍,总 tokens 降低 12%。
- Zendesk 的工单处理速度提升 20%。
- Slack 报告输出 tokens 大约减少 14%。
这些当然是厂商精选的客户引述。但仍能看出一个模式:更少迭代与更少 tokens。除了每 token 费率,这两者也直接影响账单。
在终端与桌面上运行编码代理
Sonnet 5.5 旨在作为代理工作:运行 shell 命令、跨仓库修复缺陷,并通过截图操作桌面。它从发布即在 Claude Code 中可用,Anthropic 表示其电脑使用能力接近 Opus 5.5。
对很多人而言,实用结论是:Sonnet 5.5 现在足以作为 Claude Code 会话的默认选择,以及使用我们的Claude API 指南自建代理循环的默认选择。
产出更精致的文档、幻灯片与界面
Anthropic 特别强调“敏锐的设计眼光”是 Sonnet 5.5 的强项。实际效果应体现在:当您让它润色前端代码时,界面更美观;当您需要幻灯片、电子表格或长文档时,成品感更强。
不过,这一设计方面的主张最需要独立验证。它最难量化,且发布文仅用客户引述来支撑。
对安全与生物方向的防护预期
Sonnet 5.5 是首个搭载与 Opus 5.5 类似网络安全防护的 Sonnet 模型。当请求被判为更高风险的安全类工作时,请求将回退至 Sonnet 5。生物安全防护与 Sonnet 5 保持一致,Anthropic 表示大多数软件开发与生命科学工作不会受影响。
它也是首个内置“阻止推理提取”的分类器的 Sonnet,且思考块现在绑定到产生它们的账号与会话。如果您运行安全工具,请在切换流水线前测试提示词。
以少量改动从 Sonnet 5 迁移
仅替换模型 ID 还不够。Anthropic 的文档列出了已运行在 Sonnet 5 上的代码会遇到的五项破坏性变更:
-
自适应思考默认开启,且最低设置为
between_tools,该设置会关闭前置思考。 -
强制工具使用会返回错误。
-
思考块与生成它们的模型与会话绑定。
-
较旧的
computer_20251124电脑使用工具会在 Claude API 与 Google Cloud 上被拒绝。 -
顾问工具不再接受 Opus 4.8、Opus 4.7 或 Sonnet 5 作为顾问。
还有个较隐蔽的变化:工具调用之间的文本现在会以 thinking 块返回。若应用会将文本流式输出给用户,则在工具调用之间会“沉默”,直到您更新其 display 设置。将 temperature、top_p 或 top_k 设为非默认值也会返回 400 错误。这些都是您可能会碰到的具体事项。
Claude Sonnet 5.5 的基准表现如何?
在 Anthropic 公布的每项基准上,Claude Sonnet 5.5 均优于 Sonnet 5;在终端编码上超过 Opus 5.5;在其他方面仅落后 Opus 5.5 几个点。对比 OpenAI 的 GPT-6 Sol,它在知识工作与图表解读上领先,但在 FrontierCode 上落后。下列数据均来自 Anthropic 的发布文。
| 基准 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% | 未公布 |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | 未公布 |
| FrontierCode 1.1(主) | 46.2%(max effort) | 42.4% | 54.4% | 49.3%(xhigh 为 52.1%) |
| GDPval-AA v2.1(Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1(Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam(带工具) | 64.5% | 54.9% | 67.7% | 未公布 |
| OSWorld 2.1 | 80.1% | 57.0% | 81.8% | 未公布 |
| Chartography(无工具) | 61.6% | 15.6% | 64.4% | 53.6% |
这张表的结论很直接:相较 Sonnet 5 的一大代飞跃,且与 Opus 5.5 几乎打成平手。下面看看各领域对您的工作意味着什么。
代理型编码
Sonnet 5.5 在 Terminal-Bench 4.0 上拉开差距。它拿到 70.6%,远高于 Sonnet 5 的 10.3%,也领先于 Opus 5.5 的 66.4%。该基准衡量模型在命令行环境中完成真实任务(如多步 shell 流程)的能力,与 Claude Code 的实际用法高度契合。
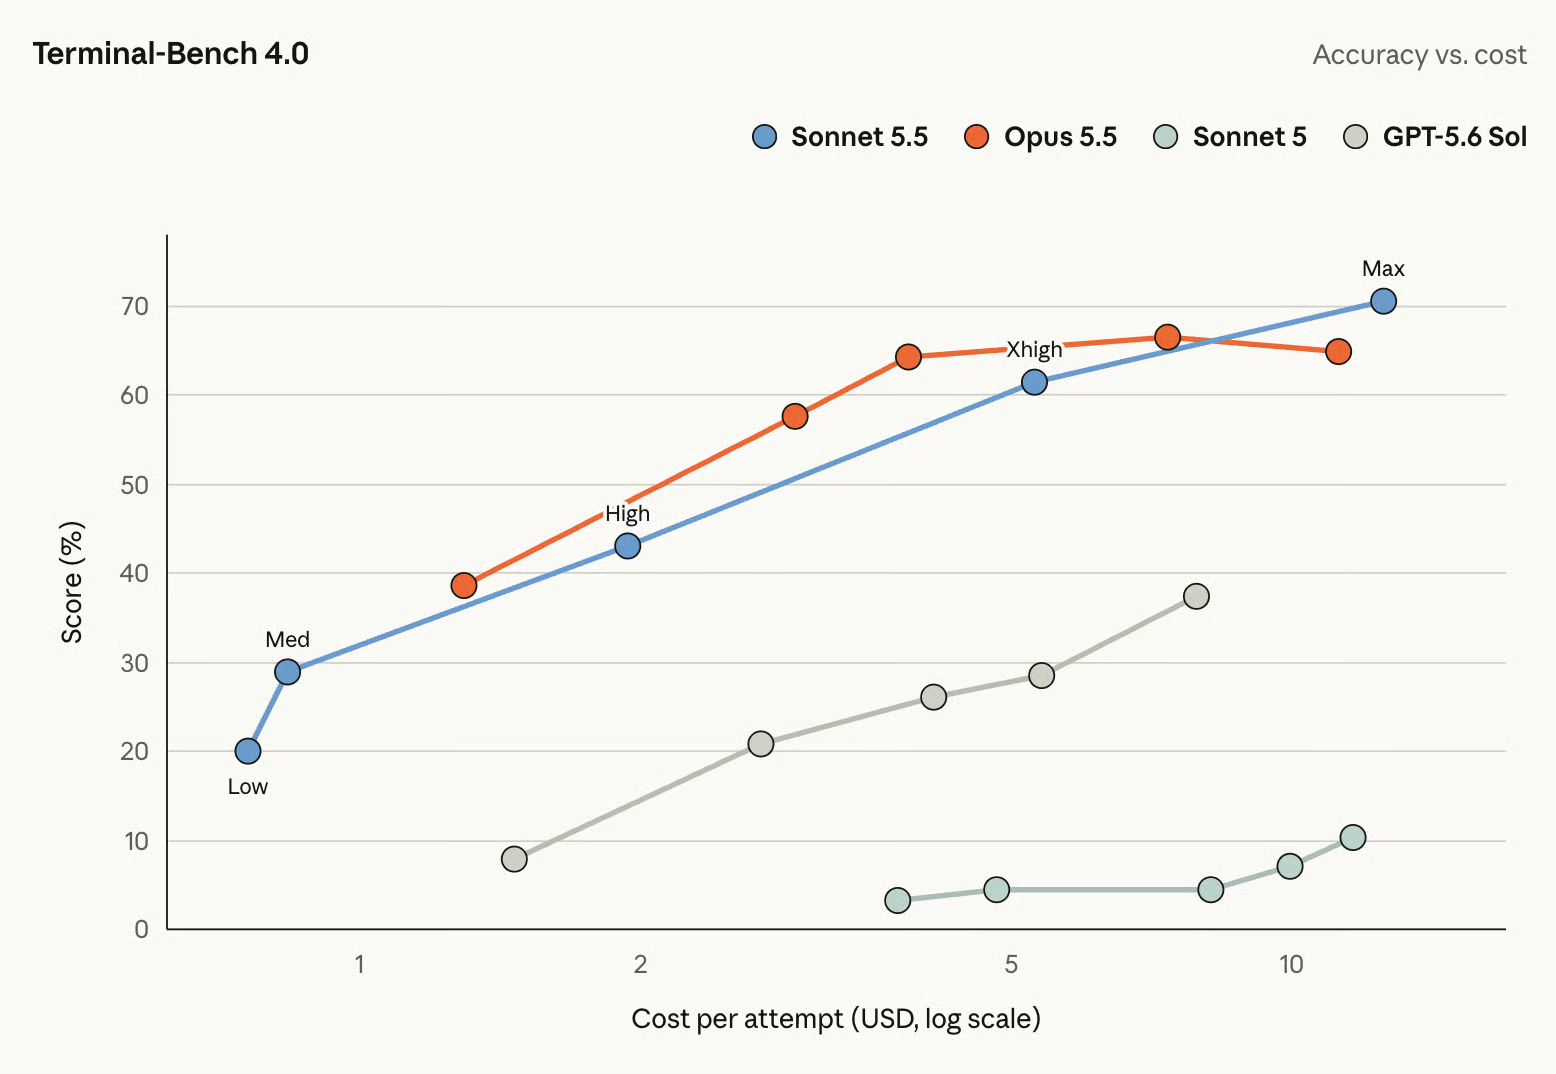
一个版本内跃升 60 分已相当罕见。其余编码方面的差距则没这么戏剧化。
知识工作
在 GDPval-AA v2.1 上,该评测以 Elo 式分数评估模型在真实职业的“经济价值”任务中的输出,Sonnet 5.5 得分 1844。比 Opus 5.5 只低 2 分,领先 Sonnet 5 近 400 分。
对用 Claude 写报告、做分析与商务文档的团队而言,这是表中最有参考价值的结果。在这类工作上,Opus 5.5 的额外成本换来的提升并不多。
推理与视觉理解
Chartography 测试“无工具情况下对图表的阅读与推理”,相对涨幅最大:Sonnet 5.5 得分 61.6%,而 Sonnet 5 为 15.6%。这与 Anthropic 所称“图像理解提升”一致。
电脑操作
在 OSWorld 2.1(评估模型是否能通过操作真实桌面操作系统完成任务)上,Sonnet 5.5 达到 80.1%,较 Sonnet 5 的 57.0% 大幅提升,并与 Opus 5.5 仅差 2 分。
该用哪个层级?
对大多数开发者而言,Sonnet 5.5 现在应成为默认的 Claude 模型。只有当任务足够开放、瓶颈在“判断而非速度”时,Opus 5.5 才物有所值。
根据 Anthropic 的模型对比表,当前阵容如下。除 Haiku 4.5 外,其余四款模型均为 100 万 token 上下文窗口、128K 最大输出。
| 模型 | 价格(每 100 万 tokens,输入 / 输出) | 时延 | 最佳场景 |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | 较慢 | 能力优先于成本的高端任务 |
| Claude Opus 5.5 | $4 / $20 | 中等 | 需要持续判断的复杂、开放式工作 |
| Claude Sonnet 5.5 | $2 / $10 | 快速 | 范围清晰的编码、代理与文档工作 |
| Claude Haiku 4.5 | $1 / $5 | 最快 | 高吞吐、成本敏感型任务 |
在 Sonnet 5.5 内部,“努力等级”是另一个可调杠杆。Anthropic 重新校准了五个级别:low、medium、high、xhigh、max。较低设置偏向速度与成本,较高设置允许模型更长时间推理并自检。Claude 应用与 Claude Code 的默认是 medium,API 上则为 high。
发布文中的一个细节会影响我的用法:在 low 或 medium 努力下,Sonnet 5.5 在多个基准上超过 Sonnet 5 的最好成绩,而每个任务的成本大约只有其十分之一。总之:
-
缺陷修复、重构与 Claude Code 会话: 使用默认努力的 Sonnet 5.5。
-
高吞吐代理循环与流水线: 用
low或medium的 Sonnet 5.5,失败时再提高努力。 -
规格清晰的硬核编码难题: 先用
xhigh或max的 Sonnet 5.5,再考虑为 Opus 付费。 -
目标不明的多日项目: Opus 5.5。
实测 Sonnet 5.5:上手示例
上述基准均来自 Anthropic,因此我用相同提示与相同工具,分别让 Claude Sonnet 5.5 与 Claude Sonnet 5 完成一次构建任务。
任务:将 FiveThirtyEight 的应届大学毕业生数据集(美国 173 个专业,CC BY 4.0)做成单文件 HTML 仪表板,帮助准学生在收入与就业上对比专业类别,并找出收入最高与最低的专业。
真正的考验在数据本身,它有一些提示词未提及的特点:
- 最高收入的石油工程只有 36 名受访者,且 173 个专业中有 76 个样本数不足 100
- 收入分布偏斜,仅靠一根“中位数”柱状难以反映差异
- 食品科学专业有人数字段为空
- 工作类型列的加总并不等于就业人数
能否注意到这些问题正是测试要点。它也检验 Anthropic 所称的“敏锐设计眼光”。
主要发现:
- 只有 Sonnet 5.5 交付了可用的仪表板。 Sonnet 5 链接了一个 cdnjs 上并不存在的 Chart.js 文件(URL 返回 404),导致库未加载,所有面板(包括纯表格)都空白。Sonnet 5.5 还会检查图表库是否加载成功,并在未加载时保证表格仍可用。
- Sonnet 5.5 基本避开了小样本陷阱。 它会将样本少于 30 的专业标注为“谨慎对待”,并加入最小样本筛选。但默认视图仍把石油工程排在第 1 且未警示。
- Sonnet 5 则无论如何都会错过。 它读取了样本量与薪资范围列,却从未使用,以“中位数”单一指标排序。
- 较小的陷阱没有难倒它们。 两者都显式处理了食品科学的空行;Sonnet 5.5 计算“对口工作占比”时也未暗示各工作列之和等于总就业。
下面是将筛选器设置为“样本至少 100 人”的 Sonnet 5.5 仪表板。
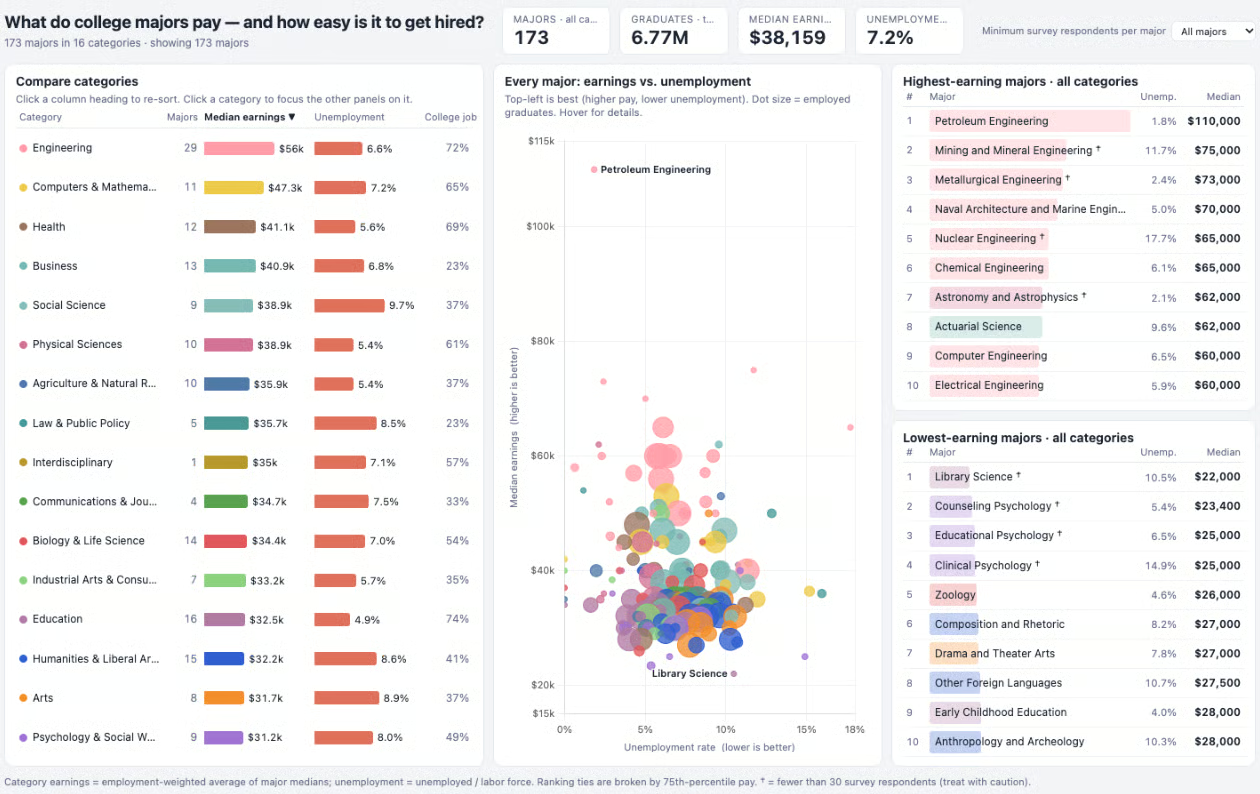
我对 Sonnet 5.5 的评分是:数据处理诚实性 4/5,分析实用性 5/5,图表与布局质量 4/5。Sonnet 5 的空白页如下。
Sonnet 5 为何失败?问题在于:该仪表板需要图表库。Sonnet 5 请求了 cdnjs 上不存在的版本,收到“404”后,因库缺失而报错:“Chart is not defined”。显然,Sonnet 5 将页面写成“所有内容(甚至纯文本表格)都在该步骤之后执行”,因此没能捕获错误。
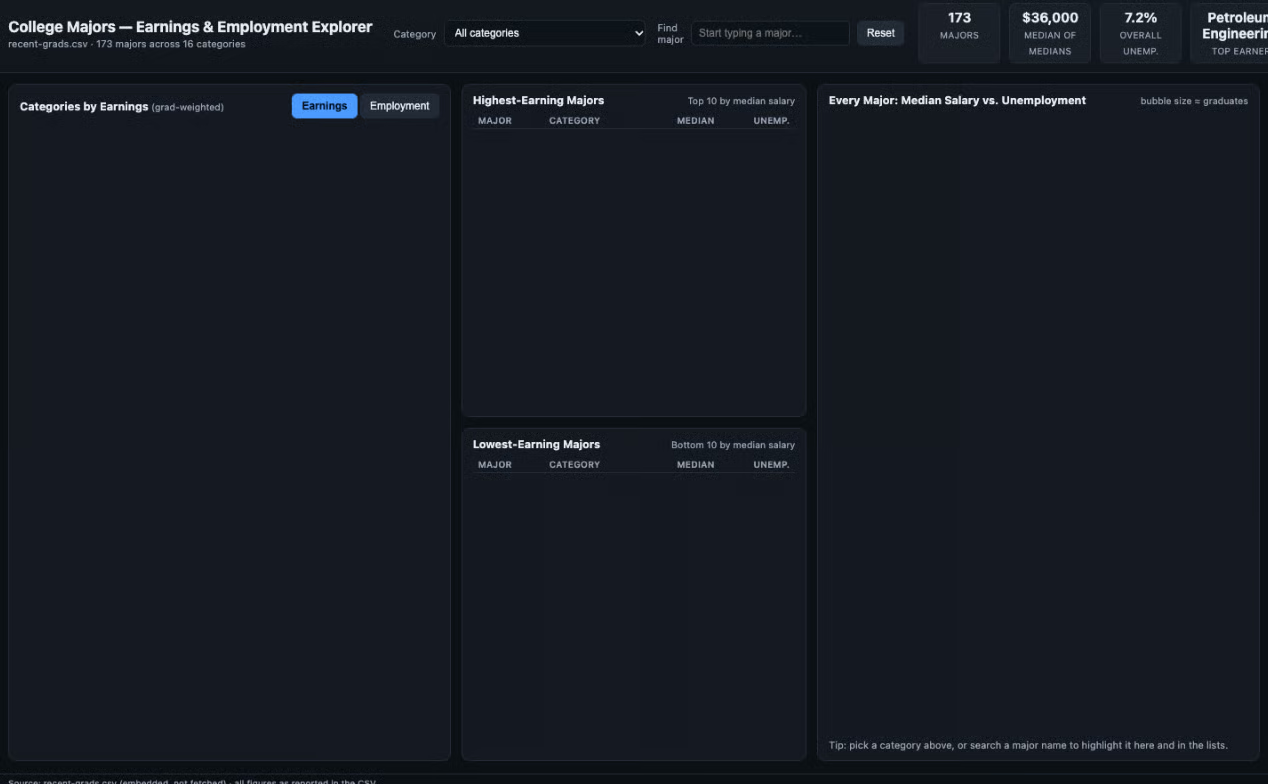
每次运行成本几乎相同:Sonnet 5.5 为 $0.56,Sonnet 5 为 $0.57。且 Sonnet 5.5 完成更快。
因此,Sonnet 5.5 是否真有明显进步?就此任务而言,是。Sonnet 5.5 交付了可用且会提示“数据偏薄”的仪表板,而 Sonnet 5 只交付了一张空白页。
Claude Sonnet 5.5 的定价与可用性
Claude Sonnet 5.5 的 API 价格为:输入每百万 tokens $2、输出每百万 tokens $10,与 Sonnet 5 持平,为 Opus 5.5 的一半。Anthropic 表示每个任务所用 tokens 更少,即便费率不变,等效成本也会下降。但在我们的实测任务中,两者完成任务的总成本接近。
| Token 类型 | 每 100 万 tokens 价格 |
|---|---|
| 输入 | $2 |
| 输出 | $10 |
| 写入缓存(5 分钟) | $2.50 |
| 写入缓存(1 小时) | $4 |
| 读取缓存 | $0.20 |
批处理 API 的输入与输出均可再打 5 折。可缓存提示的最小长度为 512 tokens,在批处理 API 上,配合 output-300k-2026-03-24 测试标头,模型最多可返回 30 万输出 tokens。
Sonnet 5.5 已全面可用(非预览),并可选择“零数据留存”。Anthropic 承诺在 2027 年 9 月 28 日之前不予下线。
如何获取 Claude Sonnet 5.5?
您今天就可以在 Claude 应用、Claude Code,以及通过使用模型 ID claude-sonnet-5-5 的 API 中使用 Claude Sonnet 5.5。它也可在 Amazon Bedrock 上以 anthropic.claude-sonnet-5-5 使用,并在 Google Cloud、Microsoft Foundry、以及 AWS 上的 Claude Platform 以 claude-sonnet-5-5 使用。
下面是最小化的 Python 调用示例。自适应思考默认开启,因此响应中会在正文前包含思考块:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
print(block.text)关于密钥、费用与第一个项目的完整演示,请参阅我们的Claude API 完整指南。如果您在构建代理,建议阅读我们的Claude 托管代理构建教程。我们将很快发布 Claude Sonnet 5.5 的 API 教程。
结语
Anthropic 的押注是:大多数付费工作(包括多数编码代理工作)将运行在这款新的中端模型上。这也直接给 OpenAI 的 GPT-6 Sol 施加压力,后者在 Anthropic 的知识工作指标上落后。
如果您还在用 Sonnet 5,我建议现在就切换,但请先了解 API 变更。对需要模型自行决策“该做什么”的项目,保留 Opus 5.5。
若您想进一步学习如何使用 Anthropic 的模型,推荐查看我们的Claude 模型入门课程。