
Last chance! 50% off DataCamp Premium
Sale ends in
Через шесть дней после того, как Anthropic поставила Claude Opus 5.5 во главе линейки, модель среднего уровня почти ликвидировала разрыв за половину цены. Claude Sonnet 5.5 обходит Opus 5.5 в одном бенчмарке и отстаёт всего на пару пунктов в остальных, при этом сохраняя цены Sonnet 5.
Мы уже видели такой сценарий. Claude Sonnet 5 вышел и приблизился к агентным бенчмаркам Opus 4.8 за долю стоимости. До этого Sonnet 4.6 подошёл вплотную к Opus 4.6 на тех же условиях. Каждый раз модель среднего уровня появляется через дни или недели после флагмана и закрывает большую часть разрыва за половину цены.
Так выглядит логарифмическая кривая масштабирования снаружи. Производительность растёт примерно как логарифм от вычислительных ресурсов, поэтому стоимость растёт примерно экспоненциально от производительности. Флагманская модель находится наверху этой кривой, где приходятся большие затраты на последние несколько пунктов. Более доступная модель, построенная несколькими неделями позже и использующая те же фундаментальные наработки, должна достичь более низкой точки на кривой, чтобы выглядеть почти так же хорошо. Иными словами, большая часть ценности на кривой всё ещё дёшево достижима, и только финальный отрезок дорог.
Стоит это проговорить, потому что лидирующие компании слегка «колдуют» с PR и брендингом.
Документация модели Anthropic описывает Claude Sonnet 5.5 как «лучшее сочетание скорости и интеллекта» в текущей линейке. Это модель среднего уровня в семействе Claude 5.5 от Anthropic, между флагманом Claude Opus 5.5 и грядущей Claude Haiku 5.5. (Мы будем держать вас в курсе по Haiku 5.5, хотя Haiku 5 так и не вышла.)
По сравнению с Sonnet 5 скачок больше, чем намекает «половинный» номер версии. Это не удивляет после того, как мы увидели, что разница между Opus 5.5 и Opus 5 оказалась больше ожидаемой.
Что касается анонса, Anthropic сообщает приросты по всем опубликованным бенчмаркам, с наибольшими скачками в терминальном кодировании, чтении графиков и оценках работы с информацией.
Интересно, что Anthropic заявляет: эта модель Sonnet — первая, которая прошла Pokémon Red, работая только со скриншотами. Звучит необычно, но это тест, который Anthropic использует как прокси для задач с длинным горизонтом и понимания изображений.
Итак, Opus 5.5, по словам компании, остаётся явно сильнее в сложной, открытой работе, требующей устойчивых суждений. Но Sonnet 5.5 — это модель для задач, где вы точно знаете, как выглядит «готово», что полезно как эвристика.
Большинство нововведений в Sonnet 5.5 — про то, чтобы делать ту же работу быстрее и с меньшим числом токенов, плюс несколько изменений, к которым пользователям API стоит подготовиться.
Можно передавать Sonnet 5.5 работу, которая раньше просила Opus, и получать результат быстрее. Anthropic говорит, что генерация вывода более чем на 30% быстрее, чем у Sonnet 5, и что модель использует меньше токенов на задачу — «до 30% меньше на задачу» — такова их формулировка.
Ранние тестировщики, процитированные в анонсе, подтверждают это своими цифрами:
Это отобранные вендором отзывы клиентов. Тем не менее есть закономерность: меньше итераций и меньше токенов, что влияет на счёт, помимо тарифа за токен.
Sonnet 5.5 создавался как агент: выполняет команды в шелле, чинит баги по репозиторию и управляет рабочим столом по скриншотам. Он доступен в Claude Code с запуска, и Anthropic описывает его компьютерное использование как близкое к Opus 5.5.
Практический вывод для многих: Sonnet 5.5 теперь — вполне надёжный вариант по умолчанию для сессий Claude Code и для агентных циклов, которые вы строите сами по нашему руководству по Claude API.
Anthropic выделяет «острый глаз на дизайн» как сильную сторону Sonnet 5.5. На практике это должно означать более аккуратные интерфейсы, когда вы просите улучшить фронтенд-код, и более «доведённый до ума» результат, когда нужны слайды, таблицы или длинные документы.
Именно это утверждение о дизайне больше всего нуждается в независимой проверке. Его труднее всего бенчмаркать, а в анонсе оно подкреплено лишь отзывами клиентов.
Sonnet 5.5 — первая модель Sonnet, вышедшая с кибербезопасными ограничителями, аналогичными Opus 5.5. Когда запрос классифицируется как работа с повышенным риском в области безопасности, он откатывается на Sonnet 5. Ограничители по биологии такие же, как в Sonnet 5; Anthropic говорит, что на большинство задач в разработке ПО и в бионауках это не повлияет.
Это также первый Sonnet с классификаторами, блокирующими извлечение рассуждений, а блоки «thinking» теперь привязаны к аккаунту и разговору, в которых они были созданы. Если вы запускаете инструменты безопасности, протестируйте подсказки перед переключением конвейера.
Просто поменять ID модели недостаточно. В документации Anthropic перечислены пять критичных изменений для кода, уже работающего на Sonnet 5:
Адаптивное мышление включено по умолчанию, и самый низкий уровень — between_tools, который отключает предварительное рассуждение.
Принудительное использование инструмента возвращает ошибку.
Блоки «thinking» привязаны к модели и разговору, где они были созданы.
Старый инструмент для компьютерного использования computer_20251124 отклоняется в Claude API и на Google Cloud.
Инструмент advisor больше не принимает Opus 4.8, Opus 4.7 или Sonnet 5 в роли советников.
Есть и более тихое изменение: текст между вызовами инструментов теперь возвращается в блоках thinking. Приложение, которое стримит текст пользователям, замолкнет между вызовами инструментов, пока вы не обновите настройку display. Установка для temperature, top_p или top_k незначений по умолчанию также приводит к ошибке 400. Эти моменты легко обнаружить на практике.
Claude Sonnet 5.5 обходит Sonnet 5 во всех бенчмарках Anthropic, опережает Opus 5.5 в терминальном кодировании и отстаёт от него лишь на несколько пунктов в остальных тестах. В сравнении с GPT-6 Sol от OpenAI он лидирует в оценках по работе с информацией и чтению графиков, но уступает на FrontierCode. Все цифры ниже — из анонса Anthropic.
| Бенчмарк | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% | Не сообщалось |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | Не сообщалось |
| FrontierCode 1.1 (Main) | 46.2% (max effort) | 42.4% | 54.4% | 49.3% (52.1% на xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (with tools) | 64.5% | 54.9% | 67.7% | Не сообщалось |
| OSWorld 2.1 | 80.1% | 57.0% | 81.8% | Не сообщалось |
| Chartography (no tools) | 61.6% | 15.6% | 64.4% | 53.6% |
Таблица рассказывает простую историю: крупный шаг вперёд относительно Sonnet 5 и почти паритет с Opus 5.5. Посмотрим, что это значит для вашей работы по направлениям.
Terminal-Bench 4.0 — место, где Sonnet 5.5 выделяется. 70.6% против 10.3% у Sonnet 5 и 66.4% у Opus 5.5. Этот тест измеряет, может ли модель выполнять реальные задачи в командной строке, например многошаговые shell-пайплайны, поэтому он близко отражает использование Claude Code.
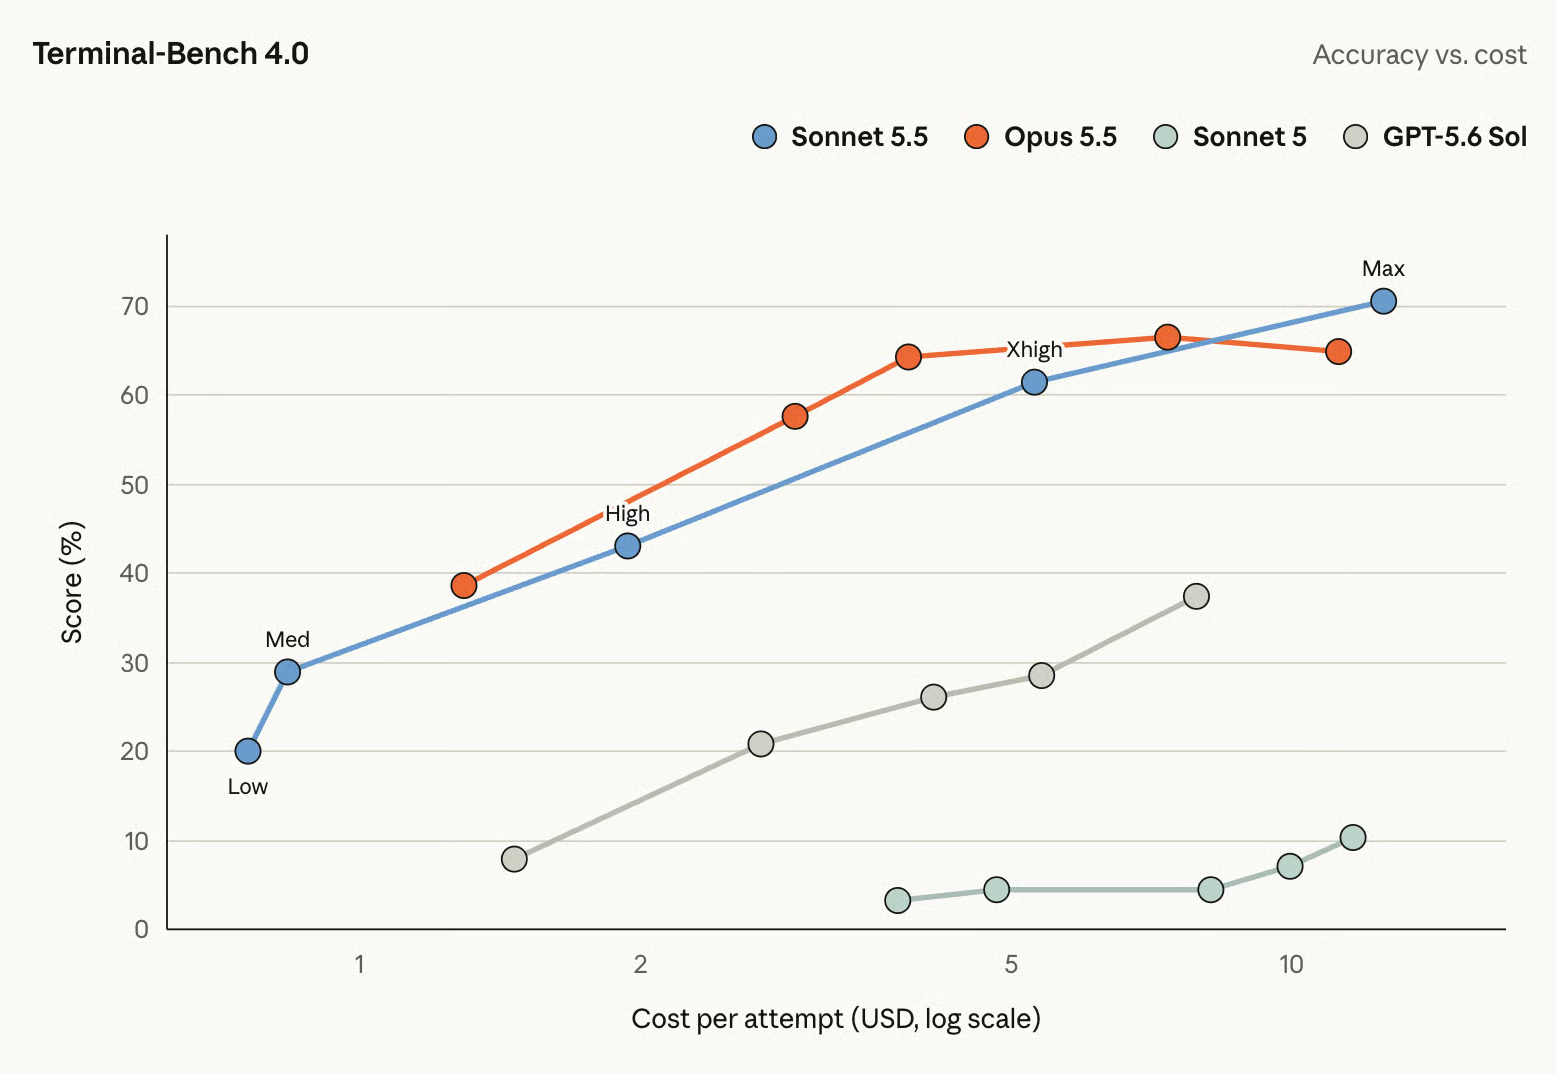
Скачок на 60 пунктов за один релиз — редкость. Остальная картина по коду менее драматична.
В GDPval-AA v2.1, который оценивает результаты модели на экономически ценных задачах из реальных профессий по шкале Elo, Sonnet 5.5 набирает 1844. Это на 2 пункта меньше Opus 5.5 и почти на 400 больше Sonnet 5.
Для команд, использующих Claude для отчётов, анализа и деловых документов, это самый полезный результат в таблице. В таких задачах доплата за Opus 5.5 даёт лишь небольшой выигрыш.
Chartography — тест чтения и рассуждения по графикам без инструментов — показывает наибольший относительный прирост: Sonnet 5.5 набирает 61.6% против 15.6% у Sonnet 5. Это согласуется с заявлениями Anthropic о лучшем понимании изображений.
В OSWorld 2.1, измеряющем способность модели выполнять задачи, управляя реальной настольной ОС, Sonnet 5.5 достигает 80.1% против 57.0% у Sonnet 5 и в пределах 2 пунктов от Opus 5.5.
Для большинства разработчиков Sonnet 5.5 теперь должна быть моделью Claude по умолчанию. Opus 5.5 оправдывает более высокую цену лишь тогда, когда задача настолько открытая, что узким местом становятся суждения, а не скорость.
Текущая линейка, по сравнительной таблице моделей Anthropic, выглядит так. У всех четырёх моделей, кроме Haiku 4.5, общее контекстное окно на 1 млн токенов и максимум вывода 128K.
| Модель | Цена (ввод / вывод за 1 млн токенов) | Задержка | Лучше всего подходит для |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Медленнее | Задачи верхнего уровня, где важнее возможности, чем стоимость |
| Claude Opus 5.5 | $4 / $20 | Умеренная | Сложная, открытая работа, требующая устойчивых суждений |
| Claude Sonnet 5.5 | $2 / $10 | Быстрая | Чётко очерченные задачи по коду, агенты и документы |
| Claude Haiku 4.5 | $1 / $5 | Самая быстрая | Большие объёмы при чувствительности к стоимости |
Внутри Sonnet 5.5 второй рычаг — установка усилия. Anthropic перекалибровала пять уровней: low, medium, high, xhigh и max. Низкие уровни отдают приоритет скорости и цене, высокие позволяют модели дольше рассуждать и проверять свою работу. По умолчанию — medium в приложениях Claude и Claude Code и high в API.
Одна деталь из анонса меняет подход к использованию: на низком или среднем усилии Sonnet 5.5 обходит лучшие результаты Sonnet 5 в нескольких бенчмарках примерно за десятую часть стоимости на задачу. В итоге:
Исправления багов, рефакторинг и сессии Claude Code: Sonnet 5.5 с усилием по умолчанию.
Высокопоточные агентные циклы и конвейеры: Sonnet 5.5 на low или medium, повышайте усилие только при сбоях.
Сложные задачи по коду с чётким ТЗ: Sonnet 5.5 на xhigh или max перед тем, как платить за Opus.
Неопределённые, многодневные проекты: Opus 5.5.
Приведённые выше бенчмарки — от самой Anthropic, поэтому мы прогнали одну сборочную задачу через Claude Sonnet 5.5 и Claude Sonnet 5 с одинаковым промптом и одинаковыми инструментами.
Задача: превратить датасет FiveThirtyEight для недавних выпускников колледжей (173 специальности в США, CC BY 4.0) в одностраничную HTML-панель, которая помогает будущему студенту сравнивать категории по доходам и занятости и находить самые высоко- и низкооплачиваемые специальности.
Главная проверка — в данных, у которых есть несколько особенностей, о которых промпт не упоминает:
Замечать эти моменты — цель теста. Он проверяет заявления Anthropic о «остром глазе на дизайн».
Основные выводы:
Вот панель Sonnet 5.5 с фильтром по специальностям с как минимум 100 респондентами.
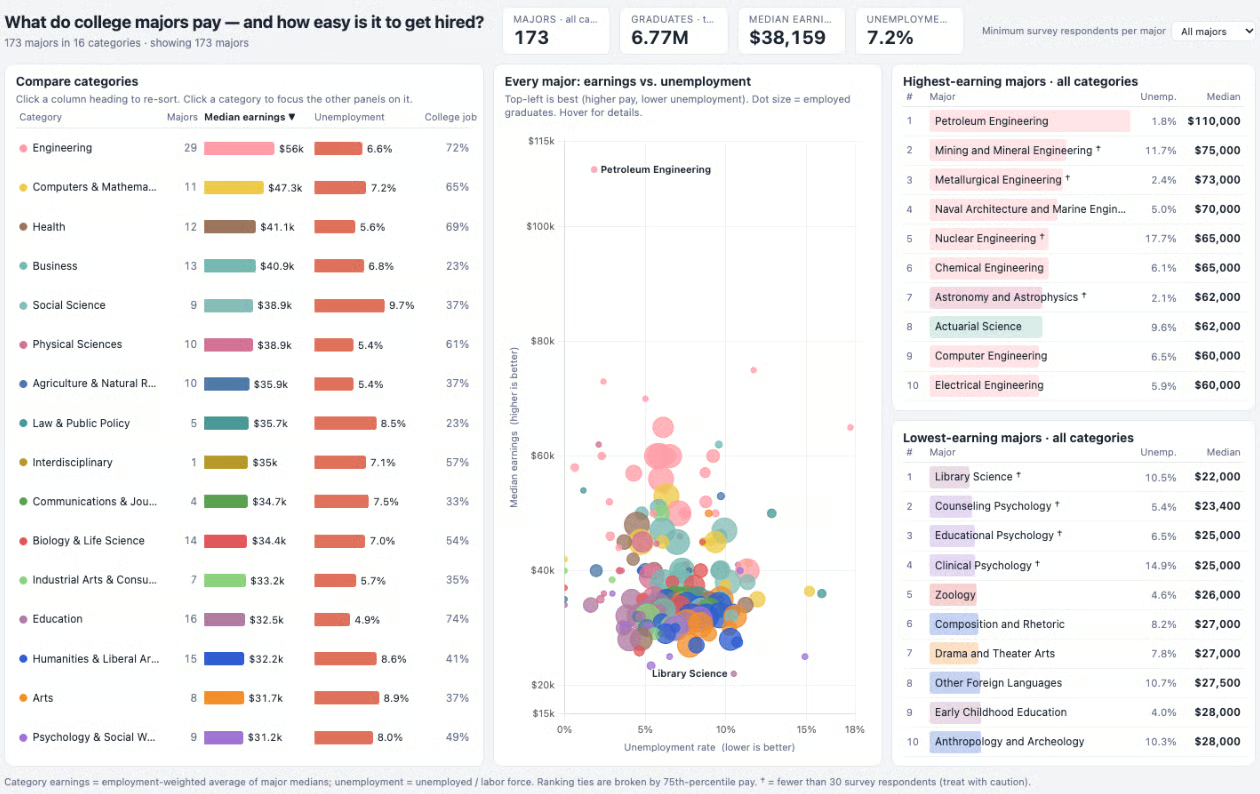
Мы оценили панель Sonnet 5.5 на 4 из 5 за честную работу с данными, 5 за аналитическую полезность и 4 за качество графиков и вёрстки. Пустую страницу Sonnet 5 приводим ниже.
Почему же Sonnet 5 провалилась? Проблема в том, что панели требовалась библиотека графиков. Sonnet 5 запросила у cdnjs версию, которой там нет. В ответ пришла «404». Без библиотеки код Sonnet 5 рухнул: «Chart is not defined». Похоже, страница была устроена так, что всё, даже простые текстовые таблицы, выполнялось после этого шага, и ошибка не была перехвачена.
Стоимость на запуск оказалась практически одинаковой: $0.56 для Sonnet 5.5 и $0.57 для Sonnet 5. Кроме того, Sonnet 5.5 справилась быстрее.
Итак, это реальный шаг вперёд? На этой задаче — да. Sonnet 5.5 выдала рабочую панель и предупредила о «тонких» данных, а Sonnet 5 — пустую страницу.
Claude Sonnet 5.5 стоит $2 за миллион входных токенов и $10 за миллион выходных токенов в API, без изменений относительно Sonnet 5 и вдвое дешевле Opus 5.5. Anthropic сообщает о меньшем числе токенов на задачу, что снижает эффективную стоимость задания, хотя тариф фиксирован. В нашем практическом тесте обе модели стоили примерно одинаково для завершения задачи.
| Тип токенов | Цена за 1 млн токенов |
|---|---|
| Ввод | $2 |
| Вывод | $10 |
| Запись кэша (5 минут) | $2.50 |
| Запись кэша (1 час) | $4 |
| Чтение кэша | $0.20 |
Batch API снижает цену на 50% и для ввода, и для вывода. Минимальный объём запроса для кэширования — 512 токенов, а в Batch API модель может вернуть до 300K выходных токенов с бета-заголовком output-300k-2026-03-24.
Sonnet 5.5 доступна в общем доступе, не превью, с опцией нулевого хранения данных. Anthropic обязуется не выводить её из эксплуатации до 28 сентября 2027 года.
Вы можете использовать Claude Sonnet 5.5 уже сегодня в приложениях Claude, в Claude Code и через API с ID модели claude-sonnet-5-5. Она также доступна в Amazon Bedrock как anthropic.claude-sonnet-5-5, а также в Google Cloud, Microsoft Foundry и Claude Platform на AWS под claude-sonnet-5-5.
Вот минимальный вызов на Python. Адаптивное мышление включено по умолчанию, поэтому ответ может содержать блоки «thinking» перед текстом:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Для подробного разбора ключей, стоимости и первого проекта см. наше полное руководство по Claude API. Если вы создаёте агентов, следующий шаг — наш туториал по созданию Claude Managed Agents. В ближайшее время мы опубликуем туториал по API Claude Sonnet 5.5.
Anthropic делает ставку на то, что большая часть оплачиваемой работы, включая работу кодирующих агентов, пойдёт на этой новой модели среднего уровня. Это также создаёт прямое давление на GPT-6 Sol от OpenAI, который уступает ей по показателям Anthropic в задачах по работе с информацией.
Если вы на Sonnet 5, стоит переключиться уже сейчас, но заранее изучите изменения в API. Оставьте Opus 5.5 для проектов, где модели нужно решать, что именно строить.
Если хотите глубже разобраться в работе с моделями Anthropic, рекомендуем наш курс Introduction to Claude Models.