Seis días después de que Anthropic colocara a Claude Opus 5.5 en lo más alto de su catálogo, el modelo intermedio ha recortado casi toda la distancia a mitad de precio. Claude Sonnet 5.5 supera a Opus 5.5 en un benchmark y se queda a solo un par de puntos en el resto, manteniendo los precios de Sonnet 5.
Ya hemos visto este patrón. Claude Sonnet 5 salió acercándose a los resultados agentivos de Opus 4.8 por una fracción del coste. Antes, Sonnet 4.6 quedó muy cerca de Opus 4.6 en las mismas condiciones. Cada vez, un modelo de gama media llega días o semanas después del buque insignia y cierra casi toda la brecha a la mitad de precio.
Así es como se ve desde fuera una curva de escalado logarítmico. El rendimiento crece aproximadamente con el logaritmo del cómputo, por lo que el coste sube de forma casi exponencial con el rendimiento. Un modelo flagship se sienta en la parte alta de esa curva, gastando mucho para comprar los últimos puntos. Un modelo más barato construido semanas después, que se beneficia de los mismos avances, solo necesita llegar a un punto más bajo de la curva para parecer casi igual de bueno. En otras palabras, la mayor parte del valor de la curva sigue siendo barata de conseguir, y solo el tramo final es caro.
Creo que conviene subrayarlo porque las empresas líderes hacen algo de magia con el PR y el branding.
Resumen
- Sonnet 5.5 es el nuevo modelo intermedio de Anthropic, que sustituye a Sonnet 5 al mismo precio.
- La mejora estrella es la codificación agentiva en terminal, donde ahora incluso adelanta a Opus 5.5.
- En trabajo del conocimiento y uso del ordenador, queda justo por detrás de Opus 5.5 por la mitad del precio por token.
- Hazlo tu modelo Claude por defecto y reserva Opus 5.5 para trabajo abierto y con alta carga de juicio.
¿Qué es Claude Sonnet 5.5?
La documentación del modelo de Anthropic describe Claude Sonnet 5.5 como "la mejor combinación de velocidad e inteligencia" en la oferta actual. Es el modelo de gama media de la familia Claude 5.5, situado entre el buque insignia Claude Opus 5.5 y el próximo Claude Haiku 5.5. (Te mantendremos al día sobre Haiku 5.5, aunque Haiku 5 nunca llegó.)
En comparación con Sonnet 5, el salto es mayor de lo que sugiere medio número de versión. No sorprende tras ver que el salto entre Opus 5.5 y Opus 5 también fue mayor de lo esperado.
En cuanto a la nota de lanzamiento, Anthropic informa mejoras en todos los benchmarks que publica, con los mayores avances en terminal coding, lectura de gráficos y evaluaciones de trabajo del conocimiento.
Curiosamente, Anthropic afirma que este Sonnet es el primero en superar Pokémon Red trabajando solo desde capturas de pantalla. Suena raro, pero es una prueba que Anthropic usa como proxy de tareas de largo recorrido y comprensión de imágenes.
Así que, Opus 5.5 sigue siendo, en palabras de la compañía, claramente más fuerte en trabajo complejo y abierto que requiere juicio sostenido. Pero Sonnet 5.5 es el modelo para tareas donde sabes cómo es el "listo", lo cual es una buena regla práctica.
Funciones clave de Claude Sonnet 5.5
La mayoría de las novedades de Sonnet 5.5 tienen que ver con hacer lo mismo más rápido y con menos tokens, además de algunos cambios que los usuarios de API deben tener en cuenta.
Resultados casi de Opus en tareas diarias a velocidad Sonnet
Puedes encargar a Sonnet 5.5 el tipo de trabajo que antes pedía Opus y recibirlo antes. Anthropic afirma que la generación de salida es más de un 30% más rápida que en Sonnet 5 y que el modelo usa menos tokens por tarea —"hasta un 30% menos por tarea"— es la cifra que dan.
Los primeros testers citados en la nota de lanzamiento lo respaldan con sus números:
- Base44 reporta 3,6 iteraciones por build con Sonnet 5.5, frente a 7,7 con Opus 5.
- Box vio sus cargas ejecutarse 2,4 veces más rápido con un 12% menos de tokens totales.
- Zendesk midió un 20% menos de tiempo en la tramitación de tickets.
- Slack informa de aproximadamente un 14% menos de tokens de salida.
Son testimonios de clientes seleccionados por el proveedor. Aun así, hay un patrón: menos iteraciones y menos tokens, lo que impacta en tu factura además del precio por token.
Ejecuta agentes de código en terminal y en el escritorio
Sonnet 5.5 está pensado para trabajar como agente: ejecutar comandos de shell, corregir bugs en un repositorio y manejar un escritorio a partir de capturas. Está disponible en Claude Code desde el lanzamiento, y Anthropic describe su uso del ordenador como cercano a Opus 5.5.
Para mucha gente, la consecuencia práctica es que Sonnet 5.5 ya es una opción sólida por defecto para sesiones de Claude Code y para los bucles de agentes que construyas con nuestra guía de la API de Claude.
Crea documentos, presentaciones e interfaces pulidas
Anthropic destaca un "buen ojo para el diseño" como fortaleza de Sonnet 5.5. En la práctica, eso debería traducirse en interfaces de usuario con mejor acabado cuando le pidas refinar código front-end, y resultados más terminados cuando solicites slides, hojas de cálculo o documentos largos.
Esta es la afirmación que más necesita validación independiente. Es la más difícil de evaluar y la nota de lanzamiento la respalda solo con testimonios.
Prevé salvaguardas en seguridad y biología
Sonnet 5.5 es el primer Sonnet que se lanza con salvaguardas de ciberseguridad similares a las de Opus 5.5. Cuando una solicitud se clasifica como trabajo de seguridad de mayor riesgo, la petición hace fallback a Sonnet 5. Las salvaguardas de biología son las mismas que en Sonnet 5, y Anthropic afirma que la mayoría del desarrollo de software y el trabajo en ciencias de la vida no se verán afectados.
También es el primer Sonnet que incluye clasificadores que bloquean la extracción de razonamiento, y los bloques de pensamiento ahora quedan vinculados a la cuenta y a la conversación que los generó. Si ejecutas tooling de seguridad, prueba tus prompts antes de cambiar un pipeline.
Migra desde Sonnet 5 con unos pocos cambios de código
No basta con cambiar el ID del modelo. La documentación de Anthropic enumera cinco cambios incompatibles para código que ya corre en Sonnet 5:
-
El pensamiento adaptativo está activado por defecto, y el nivel más bajo es
between_tools, que desactiva el pensamiento previo. -
El uso forzado de herramientas devuelve un error.
-
Los bloques de pensamiento quedan vinculados al modelo y a la conversación que los generó.
-
La herramienta antigua de computer use
computer_20251124se rechaza en la API de Claude y en Google Cloud. -
La herramienta advisor ya no acepta Opus 4.8, Opus 4.7 ni Sonnet 5 como advisors.
Hay otro cambio más sutil: el texto entre llamadas a herramientas ahora vuelve en bloques de thinking. Una app que hace streaming de texto al usuario se quedará en silencio entre llamadas a herramientas hasta que actualices su ajuste de display. Además, fijar temperature, top_p o top_k a un valor no predeterminado también devuelve un error 400. Son detalles que podrías descubrir en el uso.
¿Cómo rinde Claude Sonnet 5.5 en los benchmarks?
Claude Sonnet 5.5 supera a Sonnet 5 en todos los benchmarks publicados por Anthropic, gana a Opus 5.5 en terminal coding y se queda a unos pocos puntos de Opus 5.5 en el resto. Frente a GPT-6 Sol de OpenAI, aventaja en las evaluaciones de trabajo del conocimiento y lectura de gráficos, pero va por detrás en FrontierCode. Todas las cifras siguientes proceden de la nota de lanzamiento de Anthropic.
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 10,3% | 66,4% | No informado |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | No informado |
| FrontierCode 1.1 (Main) | 46,2% (max effort) | 42,4% | 54,4% | 49,3% (52,1% en xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (con herramientas) | 64,5% | 54,9% | 67,7% | No informado |
| OSWorld 2.1 | 80,1% | 57,0% | 81,8% | No informado |
| Chartography (sin herramientas) | 61,6% | 15,6% | 64,4% | 53,6% |
La tabla cuenta una historia sencilla: un salto generacional grande sobre Sonnet 5 y un casi empate con Opus 5.5. Veamos qué significa cada área para tu trabajo.
Programación agentiva
Terminal-Bench 4.0 es donde Sonnet 5.5 se desmarca. Logra un 70,6%, frente al 10,3% de Sonnet 5 y por delante del 66,4% de Opus 5.5. El benchmark mide si un modelo puede completar tareas reales en un entorno de línea de comandos, como flujos de trabajo de shell en varios pasos, por lo que se ajusta bien a cómo se usa Claude Code.
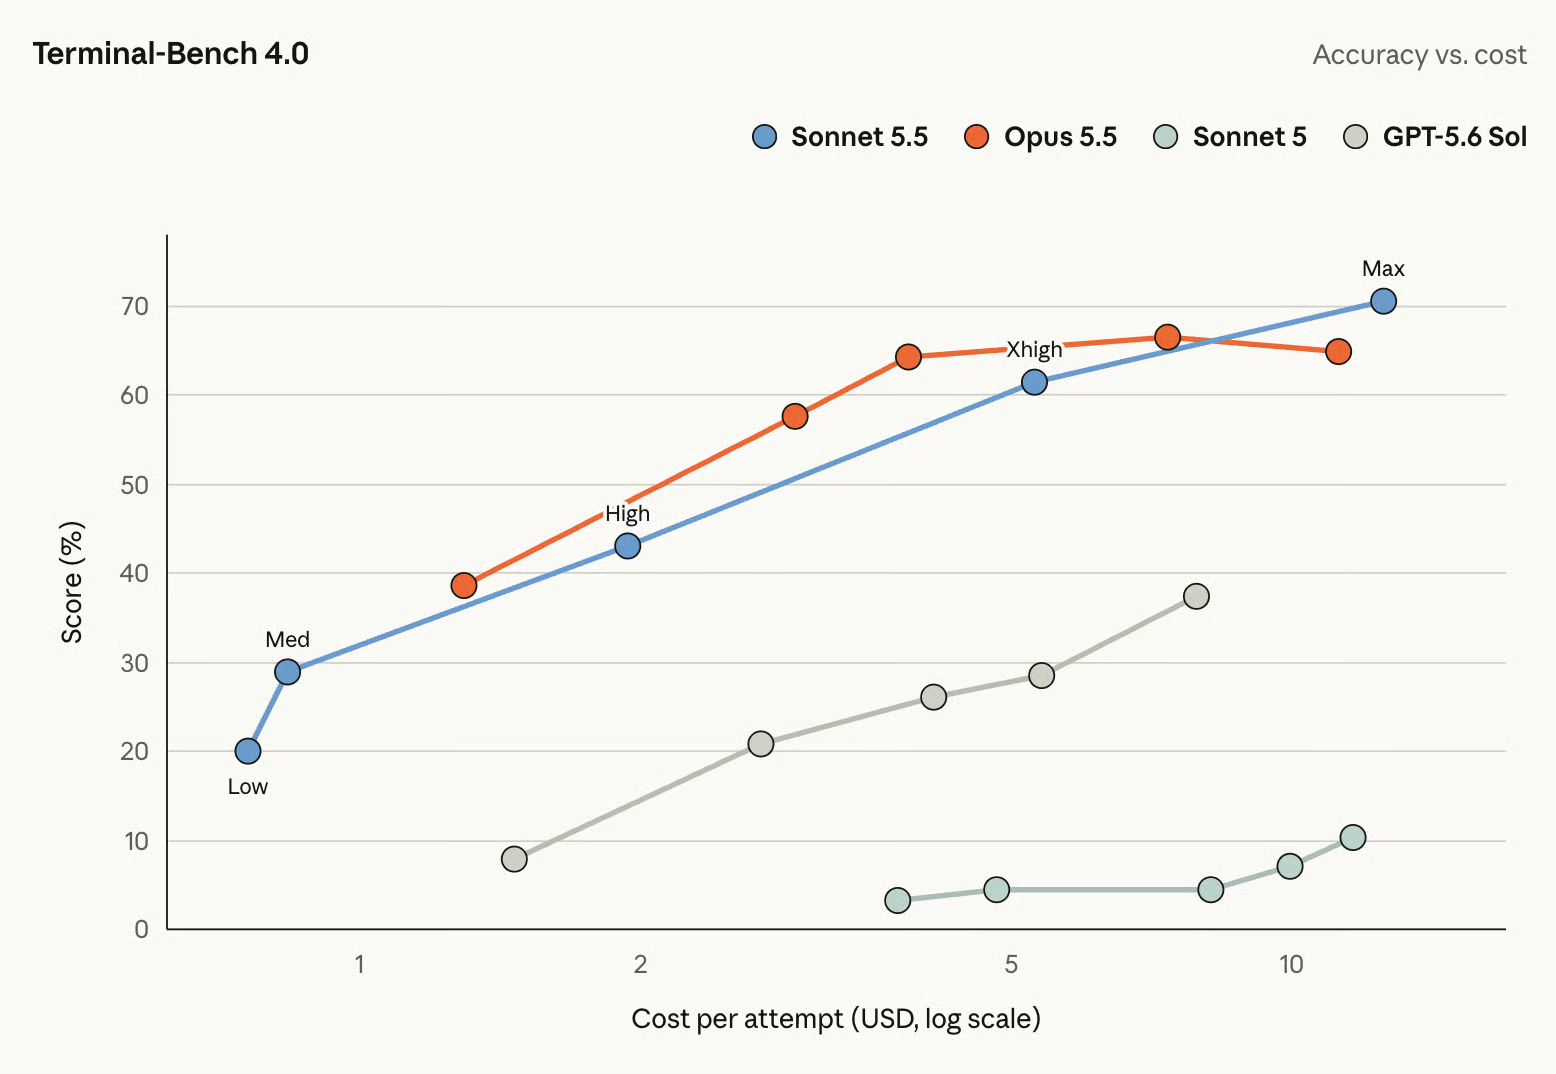
Un salto de 60 puntos en una sola versión es inusual. El resto del panorama de código es menos dramático.
Trabajo del conocimiento
En GDPval-AA v2.1, que puntúa la salida del modelo en tareas económicamente valiosas de ocupaciones reales con un sistema tipo Elo, Sonnet 5.5 consigue 1844. Son 2 puntos menos que Opus 5.5 y casi 400 más que Sonnet 5.
Para equipos que usan Claude para informes, análisis y documentos de negocio, este es el resultado más útil de la tabla. En este tipo de trabajo, pagar más por Opus 5.5 compra muy poco extra.
Razonamiento y comprensión visual
Chartography, una prueba de lectura y razonamiento sobre gráficos sin herramientas, muestra la mayor mejora relativa: Sonnet 5.5 consigue un 61,6% frente al 15,6% de Sonnet 5. Esto encaja con las afirmaciones de Anthropic sobre una mejor comprensión de imágenes.
Uso del ordenador
En OSWorld 2.1, que mide si un modelo puede completar tareas operando un sistema operativo de escritorio real, Sonnet 5.5 llega al 80,1%, frente al 57,0% de Sonnet 5 y a solo 2 puntos de Opus 5.5.
¿Qué nivel deberías usar?
Para la mayoría de desarrolladores, Sonnet 5.5 debería ser ahora el modelo Claude por defecto. Opus 5.5 justifica su mayor precio solo cuando la tarea es tan abierta que el cuello de botella es el juicio, no la velocidad.
La oferta actual, según la tabla comparativa de modelos de Anthropic, queda así. Los cuatro modelos salvo Haiku 4.5 comparten una ventana de contexto de 1M de tokens y un máximo de salida de 128K.
| Modelo | Precio (entrada / salida por 1M tokens) | Latencia | Ideal para |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Más lenta | Trabajo de gama alta donde importa más la capacidad que el coste |
| Claude Opus 5.5 | $4 / $20 | Media | Trabajo complejo y abierto que requiere juicio sostenido |
| Claude Sonnet 5.5 | $2 / $10 | Rápida | Código bien delimitado, agentes y documentos |
| Claude Haiku 4.5 | $1 / $5 | La más rápida | Tareas de gran volumen y alta sensibilidad al coste |
Dentro de Sonnet 5.5, el ajuste de effort es la otra palanca. Anthropic ha recalibrado cinco niveles: low, medium, high, xhigh y max. Los niveles bajos favorecen velocidad y coste, mientras que los altos dejan al modelo razonar más y comprobar su propio trabajo. El valor por defecto es medium en las apps de Claude y en Claude Code, y high en la API.
Un detalle de la nota de lanzamiento cambia cómo lo usaría: con effort bajo o medio, Sonnet 5.5 supera la mejor puntuación de Sonnet 5 en varios benchmarks por aproximadamente una décima parte del coste por tarea. En resumen:
-
Corrección de bugs, refactors y sesiones de Claude Code: Sonnet 5.5 con el effort por defecto.
-
Bucles de agentes y pipelines de alto rendimiento: Sonnet 5.5 en
lowomedium, y sube el effort solo en los fallos. -
Problemas de código difíciles con un requisito claro: Sonnet 5.5 en
xhighomaxantes de pagar por Opus. -
Proyectos ambiguos de varios días: Opus 5.5.
Probando Claude Sonnet 5.5: ejemplos prácticos
Los benchmarks anteriores son de Anthropic, así que ejecuté una tarea de build con Claude Sonnet 5.5 y Claude Sonnet 5 con el mismo prompt y las mismas herramientas.
La tarea: convertir el dataset de recién graduados universitarios de FiveThirtyEight (173 carreras en EE. UU., CC BY 4.0) en un dashboard HTML de un solo archivo que ayude a un futuro estudiante a comparar categorías por ingresos y empleo y a encontrar las carreras con mayores y menores salarios.
La prueba real está en los datos, que tienen algunas características que el prompt nunca menciona:
- La carrera con mayor salario, Petroleum Engineering, tiene solo 36 encuestados, y 76 de las 173 carreras tienen menos de 100
- Los ingresos están sesgados, así que una sola barra de la mediana oculta mucha dispersión
- Una carrera, Food Science, tiene campos de recuento en blanco
- Las columnas de tipo de empleo no suman el número de personas empleadas
Detectar estos puntos es el objetivo de la prueba. La prueba indaga en la afirmación de Anthropic sobre tener un "buen ojo para el diseño".
Principales conclusiones:
- Solo Sonnet 5.5 entregó un dashboard funcional. Sonnet 5 enlazó a un archivo de Chart.js que no existe en cdnjs (la URL devuelve 404), así que la librería no cargó y todos los paneles, incluidas sus tablas simples, quedaron vacíos. Sonnet 5.5 además comprueba si su librería de gráficos cargó y mantiene sus tablas operativas si no lo hizo.
- Sonnet 5.5 detectó el problema de las muestras pequeñas, en gran parte. Marca las carreras con menos de 30 encuestados como "tratar con cautela" y añade un filtro mínimo de encuestados. Su vista por defecto coloca Petroleum Engineering como nº1 sin aviso.
- Sonnet 5 lo habría pasado por alto igualmente. Su código lee las columnas de tamaño de muestra y rango salarial, luego no las usa, y ordena las carreras solo por la mediana.
- Las trampas menores no pillaron a nadie. Ambos manejaron explícitamente la fila en blanco de Food Science, y Sonnet 5.5 calculó su proporción de trabajos de nivel universitario sin sugerir que las columnas de empleo sumen el total.
Este es el dashboard de Sonnet 5.5 con el filtro en carreras con al menos 100 encuestados.
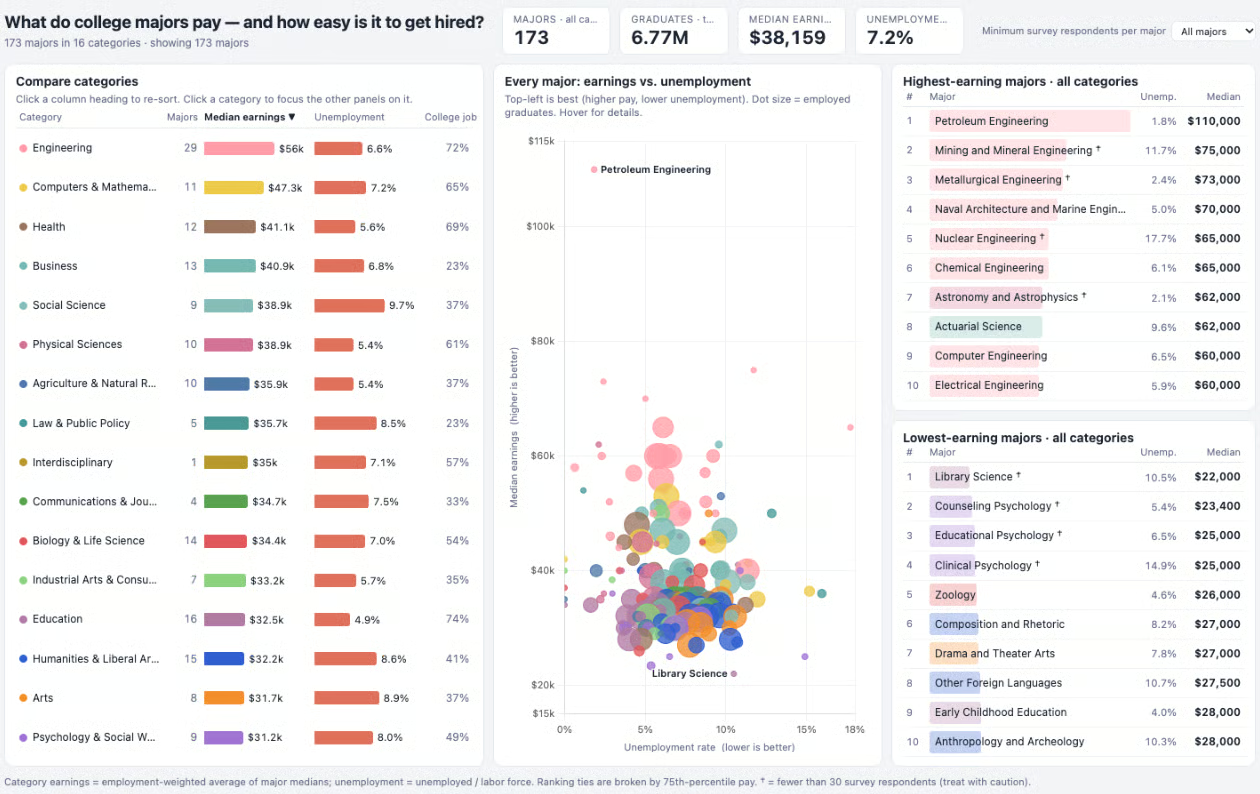
Puntué el dashboard de Sonnet 5.5 con 4 sobre 5 en tratamiento honesto de los datos, 5 en utilidad analítica y 4 en calidad de gráficos y maquetación. Incluyo abajo la página en blanco de Sonnet 5.
¿Por qué falló Sonnet 5? El problema fue que el dashboard necesitaba una librería de gráficos. Sonnet 5 pidió a cdnjs una versión que no aloja. Luego recibió un error "404". Sin la librería, el código de Sonnet 5 se estrelló: "Chart is not defined". Aparentemente, Sonnet 5 había escrito la página de modo que todo, incluso sus tablas de texto, se ejecutara después de ese paso y no pudo capturar el fallo.
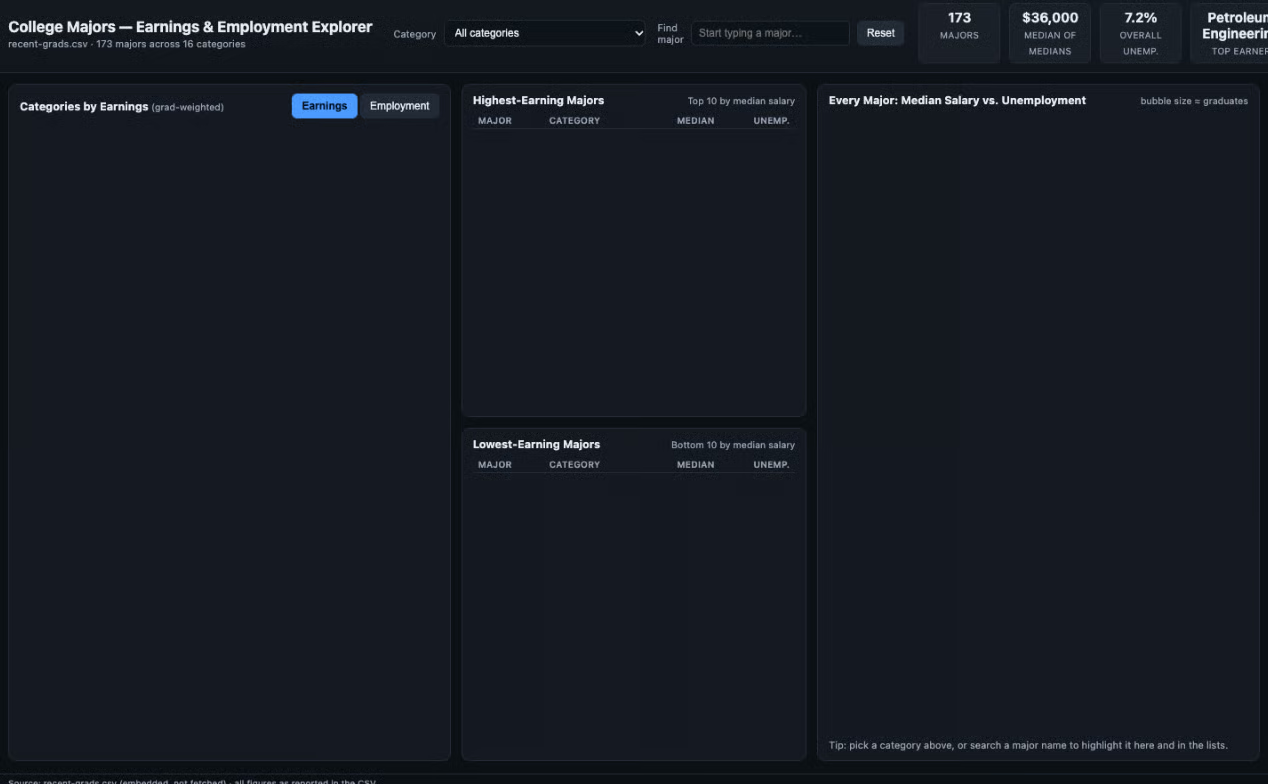
El coste por ejecución fue prácticamente idéntico: $0,56 para Sonnet 5.5 y $0,57 para Sonnet 5. Además, Sonnet 5.5 terminó antes.
Entonces, ¿Sonnet 5.5 es una mejora real? En esta tarea, sí. Sonnet 5.5 entregó un dashboard que funciona y advierte sobre datos escasos, mientras que Sonnet 5 entregó una página en blanco.
Precio y disponibilidad de Claude Sonnet 5.5
Claude Sonnet 5.5 cuesta $2 por millón de tokens de entrada y $10 por millón de tokens de salida en la API, sin cambios respecto a Sonnet 5 y a la mitad del precio de Opus 5.5. Anthropic informa de menos tokens por tarea, lo que bajaría el coste efectivo aunque la tarifa sea plana. En nuestra prueba práctica, ambos modelos costaron casi lo mismo para completar la tarea.
| Tipo de token | Precio por 1M tokens |
|---|---|
| Entrada | $2 |
| Salida | $10 |
| Cache write (5 minutos) | $2,50 |
| Cache write (1 hora) | $4 |
| Cache read | $0,20 |
La Batch API aplica un 50% de descuento tanto en entrada como en salida. El prompt mínimo cacheable es de 512 tokens, y en la Batch API el modelo puede devolver hasta 300K tokens de salida con la cabecera beta output-300k-2026-03-24.
Sonnet 5.5 está generalmente disponible, no es una vista previa, con opción de retención de datos cero. Anthropic se compromete a no retirarlo antes del 28 de septiembre de 2027.
¿Cómo obtener acceso a Claude Sonnet 5.5?
Puedes usar Claude Sonnet 5.5 hoy en las apps de Claude, en Claude Code y mediante la API con el ID de modelo claude-sonnet-5-5. También está disponible en Amazon Bedrock como anthropic.claude-sonnet-5-5, y en Google Cloud, Microsoft Foundry y Claude Platform on AWS bajo claude-sonnet-5-5.
Aquí tienes una llamada mínima en Python. El pensamiento adaptativo está activado por defecto, así que la respuesta puede incluir bloques de thinking antes del texto:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Para un recorrido real por claves, costes y tu primer proyecto, consulta nuestra guía completa de la API de Claude. Si estás creando agentes, nuestro tutorial sobre cómo crear Claude Managed Agents es un buen siguiente paso. Publicaremos en breve un tutorial de la API de Claude Sonnet 5.5.
Conclusión
Anthropic apuesta a que la mayor parte del trabajo de pago, incluido gran parte del trabajo con agentes de código, se ejecute en este nuevo modelo intermedio. Eso también mete presión directa sobre el GPT-6 Sol de OpenAI, que queda por detrás en los números de trabajo del conocimiento de Anthropic.
Yo haría el cambio ya si estás en Sonnet 5, pero actualízate antes sobre los cambios de la API. Conserva Opus 5.5 para proyectos donde el modelo tenga que decidir qué construir.
Si te interesa aprender más sobre cómo construir con los modelos de Anthropic, te recomiendo nuestro curso Introduction to Claude Models.