Enam hari setelah Anthropic menempatkan Claude Opus 5.5 di puncak lini produknya, model kelas menengah ini menutup sebagian besar kesenjangan dengan setengah harga. Claude Sonnet 5.5 mengungguli Opus 5.5 pada satu tolok ukur dan hanya tertinggal beberapa poin di tempat lain, sambil tetap mempertahankan harga Sonnet 5.
Pola ini bukan hal baru. Claude Sonnet 5 diluncurkan dengan kinerja mendekati tolok ukur keagenan Opus 4.8 dengan biaya jauh lebih rendah. Sebelumnya, Sonnet 4.6 berada dalam jarak yang dapat dijangkau dari Opus 4.6 dengan ketentuan yang sama. Setiap kali, model kelas menengah hadir beberapa hari atau minggu setelah flagship dan menutup sebagian besar kesenjangan dengan setengah harga.
Inilah rupa kurva penskalaan logaritmik jika dilihat dari luar. Performa naik kira-kira sesuai log komputasi, sehingga biaya naik kira-kira secara eksponensial terhadap performa. Model flagship berada di puncak kurva itu, mengeluarkan biaya besar untuk membeli beberapa poin terakhir. Model yang lebih murah, dibangun beberapa minggu kemudian dan memanfaatkan kemajuan yang sama, hanya perlu mencapai titik yang lebih rendah pada kurva untuk terlihat hampir setara. Dengan kata lain, sebagian besar nilai pada kurva masih murah untuk diraih, dan hanya bagian akhir yang mahal.
Menurut saya ini layak diurai karena perusahaan terdepan melakukan sedikit sulap lewat PR dan branding.
Ringkasnya
- Sonnet 5.5 adalah model kelas menengah baru Anthropic, menggantikan Sonnet 5 dengan harga yang sama.
- Peningkatan utama adalah coding terminal berbasis agen, di mana kini ia sedikit mengungguli Opus 5.5.
- Pada pekerjaan berbasis pengetahuan dan penggunaan komputer, posisinya tepat di belakang Opus 5.5 dengan setengah harga per token.
- Jadikan ini model Claude bawaan Anda dan simpan Opus 5.5 untuk pekerjaan terbuka yang menuntut banyak penilaian.
Apa Itu Claude Sonnet 5.5?
Dokumentasi model Anthropic menyebut Claude Sonnet 5.5 sebagai "kombinasi terbaik antara kecepatan dan kecerdasan" dalam lini saat ini. Ini adalah model kelas menengah dalam keluarga Claude 5.5 Anthropic, berada di antara Claude Opus 5.5 sebagai flagship dan Claude Haiku 5.5 yang akan datang. (Kami akan terus memberi kabar tentang Haiku 5.5, meski Haiku 5 tak pernah hadir.)
Dibandingkan dengan Sonnet 5, lompatan yang terjadi lebih besar daripada kesan setengah versi. Ini tidak mengejutkan setelah kita melihat bahwa lompatan antara Opus 5.5 dan Opus 5 juga lebih besar dari perkiraan.
Terkait pengumuman peluncuran - Anthropic melaporkan peningkatan pada semua tolok ukur yang mereka publikasikan, dengan lonjakan terbesar pada coding terminal, pembacaan grafik, dan evaluasi pekerjaan berbasis pengetahuan.
Menariknya, Anthropic menyatakan model Sonnet ini adalah yang pertama mengalahkan Pokémon Red hanya dari tangkapan layar. Kedengarannya tidak biasa namun ini adalah uji yang digunakan Anthropic sebagai proksi untuk pekerjaan berjangka panjang dan pemahaman gambar.
Jadi, Opus 5.5 tetap, menurut perusahaan, jelas lebih kuat untuk pekerjaan yang kompleks dan terbuka yang membutuhkan penilaian berkelanjutan. Namun Sonnet 5.5 adalah model untuk tugas-tugas yang hasilnya jelas, yang merupakan heuristik berguna.
Fitur Utama Claude Sonnet 5.5
Kebanyakan hal baru di Sonnet 5.5 berfokus pada menyelesaikan pekerjaan yang sama lebih cepat dan dengan lebih sedikit token, plus beberapa perubahan yang perlu diperhatikan pengguna API.
Dapatkan hasil nyaris setara Opus pada tugas harian dengan kecepatan Sonnet
Anda bisa menyerahkan pekerjaan yang sebelumnya membutuhkan Opus kepada Sonnet 5.5 dan mendapatkannya kembali lebih cepat. Anthropic menyatakan pembuatan output lebih dari 30% lebih cepat dibanding Sonnet 5, dan model menggunakan lebih sedikit token per tugas - "hingga 30% lebih sedikit per tugas" - adalah angka yang mereka pakai.
Penguji awal yang dikutip di pengumuman peluncuran mendukung ini dengan angka mereka sendiri:
- Base44 melaporkan 3,6 iterasi per build aplikasi dengan Sonnet 5.5, dibanding 7,7 dengan Opus 5.
- Box melihat beban kerjanya berjalan 2,4x lebih cepat dengan total token 12% lebih sedikit.
- Zendesk mengukur pemrosesan tiket 20% lebih cepat.
- Slack melaporkan sekitar 14% lebih sedikit token output.
Ini adalah kutipan pelanggan pilihan vendor. Namun, ada pola: lebih sedikit iterasi dan lebih sedikit token, yang berdampak pada tagihan Anda, selain tarif per token.
Jalankan agen coding di terminal dan desktop
Sonnet 5.5 dibangun untuk bekerja sebagai agen: menjalankan perintah shell, memperbaiki bug di seluruh repo, dan mengoperasikan desktop melalui tangkapan layar. Fitur ini langsung tersedia di Claude Code sejak peluncuran, dan Anthropic menggambarkan kemampuan penggunaan komputernya mendekati Opus 5.5.
Dampak praktis bagi banyak orang adalah Sonnet 5.5 kini menjadi pilihan default yang kredibel untuk sesi Claude Code dan untuk loop agen yang Anda bangun sendiri dengan panduan API Claude kami.
Hasilkan dokumen, slide, dan antarmuka yang rapi
Anthropic menyoroti "kepekaan desain yang tajam" sebagai kekuatan Sonnet 5.5. Dalam praktiknya, ini berarti antarmuka pengguna yang lebih baik saat Anda memintanya memoles kode front-end, dan keluaran yang lebih matang saat Anda meminta slide, spreadsheet, atau dokumen panjang.
Klaim desain ini paling perlu diuji independen. Ini yang paling sulit dibakukan, dan pengumuman peluncuran hanya mendukungnya dengan kutipan pelanggan.
Harapkan pengaman untuk pekerjaan keamanan dan biologi
Sonnet 5.5 adalah model Sonnet pertama yang diluncurkan dengan pengaman keamanan siber serupa Opus 5.5. Saat permintaan diklasifikasikan sebagai pekerjaan keamanan berisiko lebih tinggi, permintaan akan dialihkan ke Sonnet 5. Pengaman biologi sama seperti pada Sonnet 5, dan Anthropic menyatakan sebagian besar pengembangan perangkat lunak dan pekerjaan ilmu hayati tidak akan terdampak.
Ini juga Sonnet pertama yang dikirim dengan pengklasifikasi yang memblokir ekstraksi penalaran, dan blok pemikiran kini terikat pada akun serta percakapan yang menghasilkannya. Jika Anda menjalankan tooling keamanan, uji prompt Anda sebelum mengganti pipeline.
Migrasi dari Sonnet 5 dengan beberapa perubahan kode
Menukar ID model saja belum cukup. Dokumentasi Anthropic mencantumkan lima perubahan yang berpotensi merusak untuk kode yang sudah berjalan di Sonnet 5:
-
Adaptive thinking aktif secara default, dan pengaturan terendah adalah
between_tools, yang mematikan pemikiran di awal. -
Pemaksaan penggunaan tool mengembalikan error.
-
Blok pemikiran terikat pada model dan percakapan yang menghasilkannya.
-
Tool penggunaan komputer
computer_20251124yang lebih lama ditolak pada Claude API dan Google Cloud. -
Tool advisor tidak lagi menerima Opus 4.8, Opus 4.7, atau Sonnet 5 sebagai advisor.
Ada perubahan yang lebih senyap juga: teks di antara pemanggilan tool kini dikembalikan dalam blok thinking. Aplikasi yang melakukan streaming teks ke pengguna akan diam di antara pemanggilan tool sampai Anda memperbarui pengaturan display-nya. Mengatur temperature, top_p, atau top_k ke nilai non-default juga mengembalikan error 400. Ini hal-hal spesifik yang mungkin Anda temui.
Bagaimana Performa Claude Sonnet 5.5 pada Tolok Ukur?
Claude Sonnet 5.5 mengungguli Sonnet 5 pada semua tolok ukur yang dipublikasikan Anthropic, mengalahkan Opus 5.5 pada coding terminal, dan tertinggal beberapa poin dari Opus 5.5 di tempat lain. Dibanding GPT-6 Sol dari OpenAI, ia unggul pada evaluasi pekerjaan berbasis pengetahuan dan pembacaan grafik tetapi tertinggal pada FrontierCode. Semua angka di bawah ini berasal dari pengumuman peluncuran Anthropic.
| Tolok ukur | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% | Tidak dilaporkan |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | Tidak dilaporkan |
| FrontierCode 1.1 (Utama) | 46.2% (upaya maks) | 42.4% | 54.4% | 49.3% (52.1% pada xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (dengan tool) | 64.5% | 54.9% | 67.7% | Tidak dilaporkan |
| OSWorld 2.1 | 80.1% | 57.0% | 81.8% | Tidak dilaporkan |
| Chartography (tanpa tool) | 61.6% | 15.6% | 64.4% | 53.6% |
Tabelnya menyampaikan cerita sederhana: lompatan generasional besar atas Sonnet 5, dan hampir seri dengan Opus 5.5. Mari lihat arti tiap area bagi pekerjaan Anda.
Coding berbasis agen
Terminal-Bench 4.0 adalah tempat Sonnet 5.5 membedakan diri. Skornya 70,6%, naik dari 10,3% milik Sonnet 5 dan di depan 66,4% milik Opus 5.5. Tolok ukur ini mengukur apakah model dapat menyelesaikan tugas nyata di lingkungan command-line, seperti alur kerja shell multi-langkah, sehingga sangat selaras dengan penggunaan Claude Code.
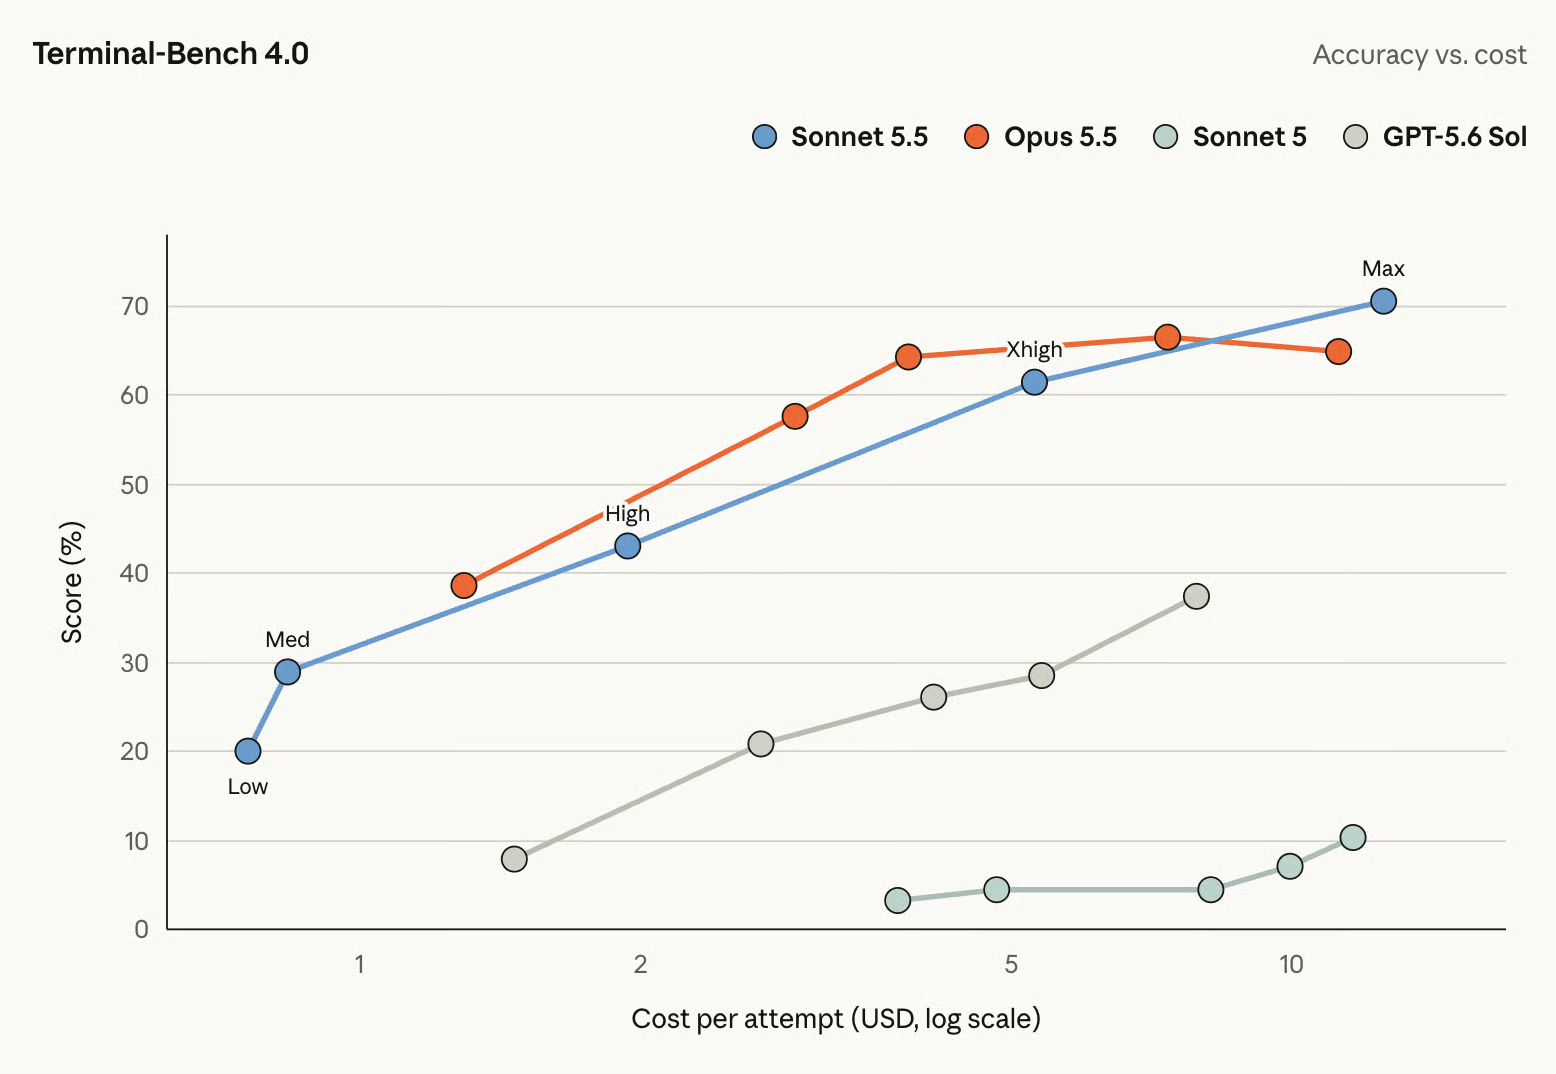
Lompatan 60 poin dalam satu rilis sudah terbilang tidak biasa. Sisa gambaran coding kurang dramatis.
Pekerjaan berbasis pengetahuan
Pada GDPval-AA v2.1, yang menilai output model pada tugas bernilai ekonomi dari profesi nyata dengan skor gaya Elo, Sonnet 5.5 meraih 1844. Itu 2 poin di belakang Opus 5.5 dan hampir 400 di depan Sonnet 5.
Bagi tim yang menggunakan Claude untuk laporan, analisis, dan dokumen bisnis, ini adalah hasil paling berguna di tabel. Untuk jenis pekerjaan ini, biaya tambahan Opus 5.5 hanya membeli sedikit keunggulan.
Penalaran dan pemahaman visual
Chartography, uji membaca dan menalar atas grafik tanpa tool, menunjukkan kenaikan relatif terbesar: Sonnet 5.5 mencetak 61,6% dibanding 15,6% milik Sonnet 5. Ini selaras dengan klaim Anthropic tentang peningkatan pemahaman gambar.
Penggunaan komputer
Pada OSWorld 2.1, yang mengukur apakah model dapat menyelesaikan tugas dengan mengoperasikan sistem operasi desktop nyata, Sonnet 5.5 mencapai 80,1%, naik dari 57,0% untuk Sonnet 5 dan terpaut dalam 2 poin dari Opus 5.5.
Tier Mana yang Sebaiknya Anda Gunakan?
Bagi sebagian besar pengembang, Sonnet 5.5 kini seharusnya menjadi model Claude default. Opus 5.5 layak dengan harga lebih tinggi hanya ketika tugas cukup terbuka sehingga penilaian, bukan kecepatan, menjadi hambatan.
Lini saat ini, menurut tabel perbandingan model Anthropic, tampak seperti ini. Keempat model kecuali Haiku 4.5 berbagi jendela konteks 1M token dan output maksimum 128K.
| Model | Harga (input / output per 1M token) | Latensi | Terbaik untuk |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Lebih lambat | Pekerjaan level atas di mana kapabilitas lebih penting daripada biaya |
| Claude Opus 5.5 | $4 / $20 | Sedang | Pekerjaan kompleks dan terbuka yang membutuhkan penilaian berkelanjutan |
| Claude Sonnet 5.5 | $2 / $10 | Cepat | Coding terdefinisi jelas, agen, dan pekerjaan dokumen |
| Claude Haiku 4.5 | $1 / $5 | Paling cepat | Tugas berkuantitas tinggi dan sensitif biaya |
Di dalam Sonnet 5.5, pengaturan effort adalah tuas lainnya. Anthropic mengalibrasi ulang lima level: low, medium, high, xhigh, dan max. Level lebih rendah memprioritaskan kecepatan dan biaya, sementara level lebih tinggi memungkinkan model menalar lebih lama dan memeriksa pekerjaannya sendiri. Default-nya adalah medium di aplikasi Claude dan Claude Code, serta high pada API.
Satu detail dari pengumuman peluncuran mengubah cara saya menggunakannya: pada effort low atau medium, Sonnet 5.5 mengungguli skor terbaik Sonnet 5 pada beberapa tolok ukur dengan sekitar sepersepuluh biaya per tugas. Singkatnya:
-
Perbaikan bug, refactor, dan sesi Claude Code: Sonnet 5.5 pada effort default.
-
Loop agen dan pipeline ber-throughput tinggi: Sonnet 5.5 pada
lowataumedium, lalu naikkan effort hanya saat gagal. -
Masalah coding sulit dengan spesifikasi jelas: Sonnet 5.5 pada
xhighataumaxsebelum membayar Opus. -
Proyek ambigu dan multi-hari: Opus 5.5.
Menguji Claude Sonnet 5.5: Contoh Praktis
Tolok ukur di atas adalah milik Anthropic, jadi saya menjalankan satu tugas build menggunakan Claude Sonnet 5.5 dan Claude Sonnet 5 dengan prompt identik dan tooling identik.
Tugasnya: ubah dataset lulusan perguruan tinggi terbaru FiveThirtyEight (173 jurusan di AS, CC BY 4.0) menjadi dashboard HTML satu berkas yang membantu calon mahasiswa membandingkan kategori berdasarkan pendapatan dan pekerjaan serta menemukan jurusan berpendapatan tertinggi dan terendah.
Ujian sesungguhnya ada pada data, yang memiliki beberapa karakteristik yang tidak disebut dalam prompt:
- Peringkat pendapatan tertinggi, Petroleum Engineering, hanya memiliki 36 responden survei, dan 76 dari 173 jurusan memiliki kurang dari 100 responden
- Pendapatan miring, sehingga satu batang median menyembunyikan banyak sebaran
- Satu jurusan, Food Science, memiliki kolom jumlah responden yang kosong
- Kolom jenis pekerjaan tidak dijumlahkan hingga sama dengan jumlah orang yang bekerja
Menyadari isu-isu ini adalah inti uji. Uji ini menelisik klaim Anthropic tentang memiliki "kepekaan desain yang tajam."
Temuan utama:
- Hanya Sonnet 5.5 yang menghasilkan dashboard berfungsi. Sonnet 5 menautkan ke berkas Chart.js yang tidak ada di cdnjs (URL mengembalikan 404), sehingga pustaka tidak pernah dimuat dan setiap panel, termasuk tabel polosnya, tidak menampilkan apa pun. Sonnet 5.5 juga memeriksa apakah pustaka chart-nya termuat dan menjaga tabelnya tetap berfungsi jika tidak.
- Sonnet 5.5 menangkap jebakan sampel kecil, sebagian besar. Ia menandai jurusan dengan kurang dari 30 responden sebagai "perlu kehati-hatian" dan menambahkan filter minimum responden. Tampilan default-nya menempatkan Petroleum Engineering di #1 tanpa peringatan.
- Sonnet 5 akan melewatkannya juga. Kodenya membaca kolom ukuran sampel dan rentang gaji, lalu tidak pernah menggunakannya, dan memberi peringkat jurusan berdasarkan median saja.
- Jebakan yang lebih kecil tidak menjatuhkan siapa pun. Keduanya menangani baris Food Science yang kosong secara eksplisit, dan Sonnet 5.5 menghitung porsi pekerjaan terkait kuliah tanpa menyiratkan kolom pekerjaan dijumlahkan ke total pekerjaan.
Berikut dashboard Sonnet 5.5 dengan filter disetel ke jurusan dengan minimal 100 responden.
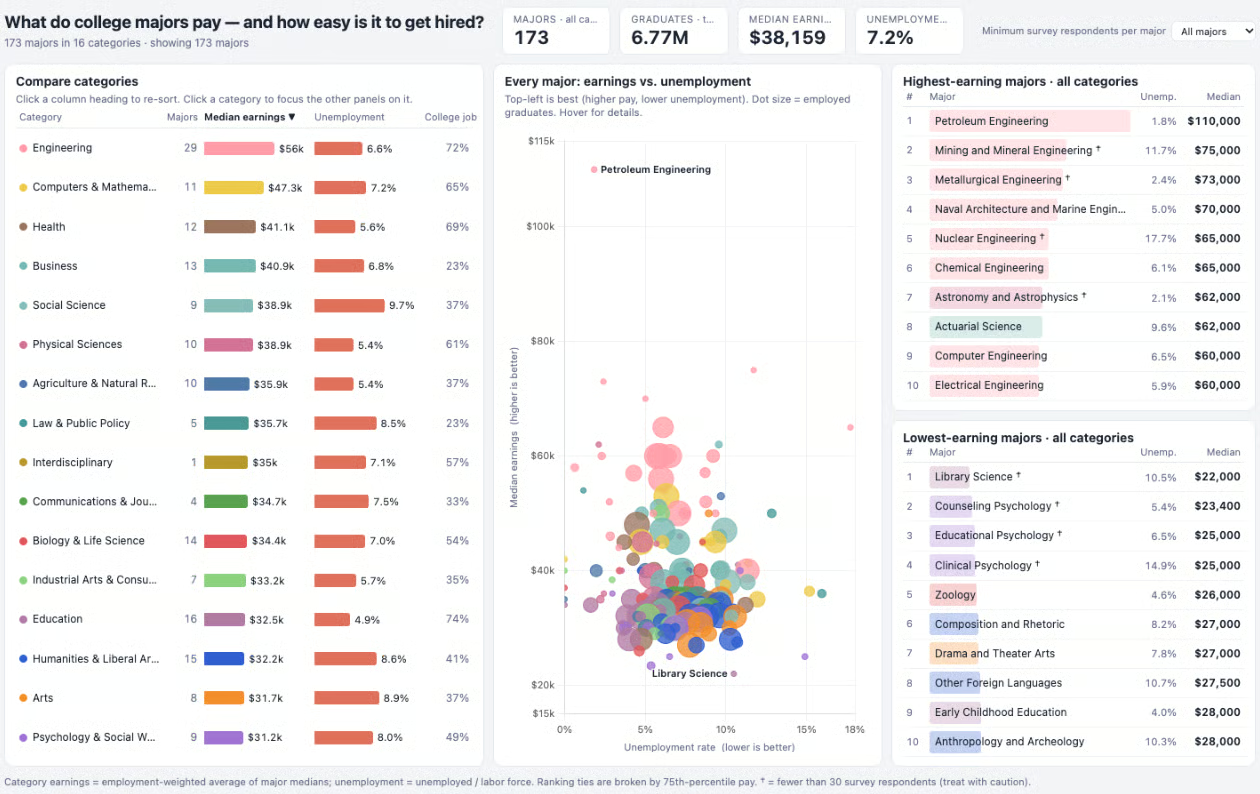
Saya menilai dashboard Sonnet 5.5 skor 4 dari 5 untuk kejujuran penanganan data, 5 untuk kegunaan analitis, dan 4 untuk kualitas grafik dan tata letak. Halaman kosong Sonnet 5 saya sertakan di bawah.
Lalu mengapa Sonnet 5 gagal? Masalahnya, dashboard memerlukan pustaka charting. Sonnet 5 meminta versi pada cdnjs yang tidak dihosting. Kemudian mendapat error "404". Tanpa pustaka, kode Sonnet 5 mogok: "Chart is not defined." Rupanya, Sonnet 5 menulis halaman sehingga semuanya, bahkan tabel teks polosnya, berjalan setelah langkah itu, dan ia tidak bisa menangkap kesalahan itu.
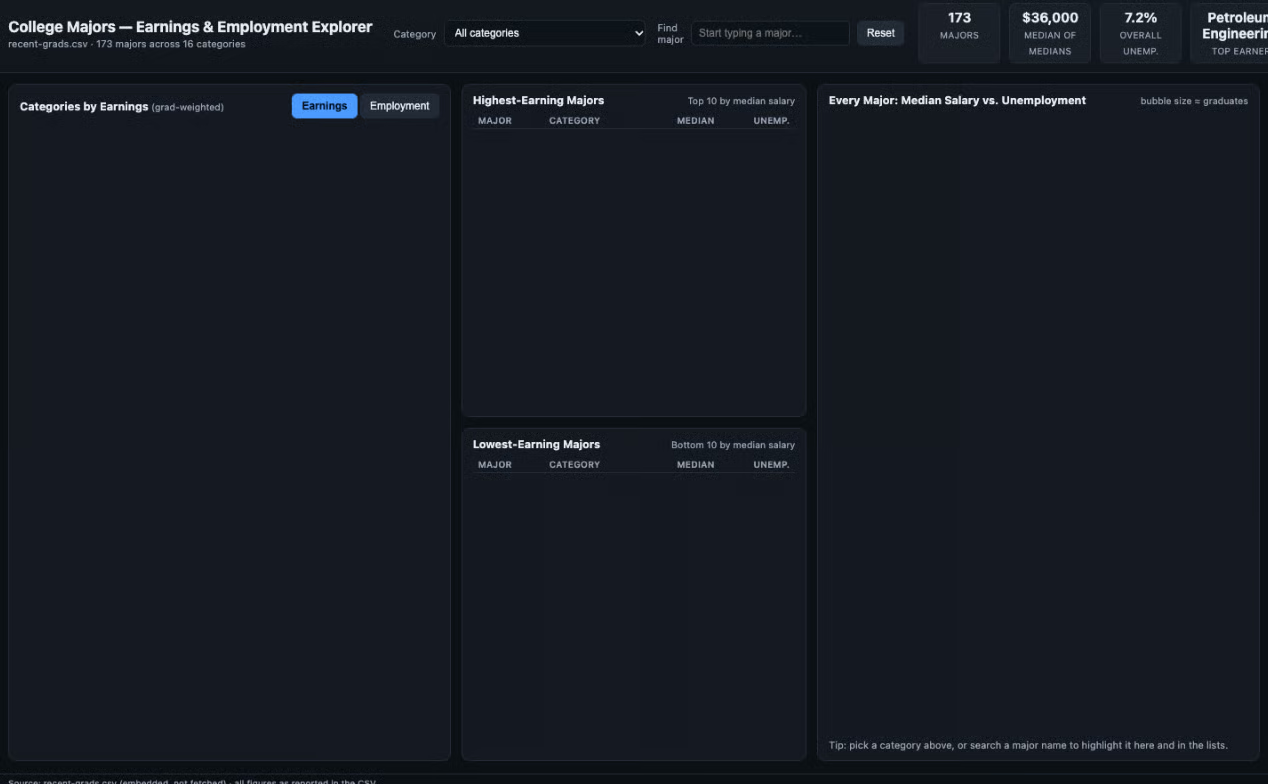
Biaya per run pada dasarnya identik: $0,56 untuk Sonnet 5.5 dan $0,57 untuk Sonnet 5. Selain itu, Sonnet 5.5 menyelesaikan pekerjaan lebih cepat.
Jadi, apakah Sonnet 5.5 benar-benar peningkatan? Untuk tugas ini, ya. Sonnet 5.5 menghasilkan dashboard yang berfungsi dan memperingatkan Anda tentang data yang tipis, sementara Sonnet 5 menghasilkan halaman kosong.
Harga dan Ketersediaan Claude Sonnet 5.5
Claude Sonnet 5.5 berharga $2 per satu juta token input dan $10 per satu juta token output di API, tidak berubah dari Sonnet 5 dan setengah harga Opus 5.5. Anthropic melaporkan lebih sedikit token per tugas, yang akan menurunkan biaya efektif per pekerjaan meski tarif tetap. Namun dalam uji langsung kami, kedua model biayanya hampir sama untuk menyelesaikan tugas.
| Jenis token | Harga per 1M token |
|---|---|
| Input | $2 |
| Output | $10 |
| Tulis cache (5 menit) | $2,50 |
| Tulis cache (1 jam) | $4 |
| Baca cache | $0,20 |
Batch API memberikan potongan 50% untuk input dan output. Prompt minimum yang dapat di-cache adalah 512 token, dan pada Batch API model dapat mengembalikan hingga 300K token output dengan header beta output-300k-2026-03-24.
Sonnet 5.5 tersedia umum, bukan pratinjau, dengan opsi zero data retention. Anthropic berkomitmen untuk tidak menghentikannya sebelum 28 September 2027.
Bagaimana Cara Mendapatkan Akses ke Claude Sonnet 5.5?
Anda dapat menggunakan Claude Sonnet 5.5 hari ini di aplikasi Claude, di Claude Code, dan melalui API dengan ID model claude-sonnet-5-5. Model ini juga tersedia di Amazon Bedrock sebagai anthropic.claude-sonnet-5-5, serta di Google Cloud, Microsoft Foundry, dan Claude Platform di AWS dengan claude-sonnet-5-5.
Berikut pemanggilan Python minimal. Adaptive thinking aktif secara default, jadi respons dapat menyertakan blok thinking sebelum teks:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Untuk panduan nyata tentang kunci, biaya, dan proyek pertama Anda, lihat panduan lengkap API Claude kami. Jika Anda membangun agen, tutorial kami tentang membangun Claude Managed Agents adalah langkah berikut yang bagus. Kami akan menerbitkan tutorial API Claude Sonnet 5.5 segera.
Pikiran Penutup
Anthropic bertaruh bahwa sebagian besar pekerjaan berbayar, termasuk sebagian besar pekerjaan agen coding, berjalan pada model kelas menengah baru ini. Ini juga memberi tekanan langsung pada GPT-6 Sol milik OpenAI, yang tertinggal pada angka pekerjaan berbasis pengetahuan versi Anthropic.
Saya akan beralih sekarang jika Anda masih di Sonnet 5, namun pastikan memperbarui diri pada perubahan API. Simpan Opus 5.5 untuk proyek di mana model harus memutuskan apa yang akan dibangun.
Jika Anda ingin mempelajari lebih lanjut tentang membangun dengan model-model Anthropic, saya sarankan melihat kursus Pengantar Model Claude kami.