Sáu ngày sau khi Anthropic đưa Claude Opus 5.5 lên vị trí đầu bảng, mẫu tầm trung đã thu hẹp phần lớn khoảng cách với mức giá chỉ bằng một nửa. Claude Sonnet 5.5 vượt Opus 5.5 ở một bài đánh giá và chỉ kém vài điểm ở các bài khác, đồng thời vẫn giữ mức giá của Sonnet 5.
Chúng ta đã thấy mô thức này trước đây. Claude Sonnet 5 ra mắt, tiến sát các điểm chuẩn về năng lực tác vụ của Opus 4.8 với chi phí chỉ bằng một phần nhỏ. Trước đó, Sonnet 4.6 cũng kịp bám sát Opus 4.6 theo cùng điều kiện. Mỗi lần, một mẫu tầm trung xuất hiện sau mẫu đầu bảng vài ngày hoặc vài tuần và thu hẹp phần lớn khoảng cách với mức giá bằng một nửa.
Nhìn từ bên ngoài, đó chính là hình dáng của một đường cong tăng trưởng theo logarit. Hiệu năng tăng xấp xỉ theo log của năng lực tính toán, nên chi phí tăng gần như theo hàm mũ theo hiệu năng. Mẫu đầu bảng ngồi ở đỉnh đường cong đó, nơi phải chi rất nhiều để mua những điểm cuối cùng. Một mẫu rẻ hơn được xây dựng vài tuần sau, hưởng lợi từ cùng các tiến bộ nền tảng, chỉ cần vươn tới một điểm thấp hơn trên đường cong là trông đã gần tương đương. Nói cách khác, phần lớn giá trị trên đường cong vẫn rẻ để đạt được, và chỉ đoạn cuối mới đắt đỏ.
Tôi nghĩ đáng để bóc tách điều này vì các công ty dẫn đầu có chút "phép thuật" trong PR và thương hiệu.
TL;DR
- Sonnet 5.5 là mẫu tầm trung mới của Anthropic, thay thế Sonnet 5 với cùng mức giá.
- Điểm nổi bật là khả năng lập trình theo tác vụ trong terminal, nơi nó hiện nhỉnh hơn Opus 5.5.
- Với công việc tri thức và sử dụng máy tính, nó chỉ kém Opus 5.5 một chút trong khi giá mỗi token bằng một nửa.
- Hãy đặt làm mẫu Claude mặc định của bạn và giữ Opus 5.5 cho các tác vụ mở, đòi hỏi phán đoán nhiều.
Claude Sonnet 5.5 là gì?
Tài liệu của Anthropic mô tả Claude Sonnet 5.5 là "sự kết hợp tốt nhất giữa tốc độ và trí tuệ" trong danh mục hiện tại. Đây là mẫu tầm trung trong gia đình Claude 5.5 của Anthropic, nằm giữa mẫu đầu bảng Claude Opus 5.5 và Claude Haiku 5.5 sắp ra mắt. (Chúng tôi sẽ cập nhật cho bạn về Haiku 5.5, dù Haiku 5 chưa từng xuất hiện.)
So với Sonnet 5, bước nhảy lớn hơn con số nửa phiên bản gợi ý. Điều này không bất ngờ sau khi thấy bước nhảy giữa Opus 5.5 và Opus 5 cũng lớn hơn dự kiến.
Về bài ra mắt - Anthropic báo cáo mức tăng ở mọi điểm chuẩn đã công bố, với bước nhảy lớn nhất ở lập trình trong terminal, đọc biểu đồ và đánh giá công việc tri thức.
Điều thú vị là Anthropic cho biết mẫu Sonnet này là mẫu đầu tiên vượt qua Pokémon Red chỉ bằng ảnh chụp màn hình. Nghe có vẻ lạ nhưng đây là bài kiểm tra Anthropic dùng làm đại diện cho công việc dài hơi và hiểu hình ảnh.
Vì vậy, theo lời công ty, Opus 5.5 vẫn vượt trội rõ rệt ở các tác vụ phức tạp, mở, cần phán đoán liên tục. Nhưng Sonnet 5.5 là mẫu cho các tác vụ mà bạn biết rõ thế nào là "xong", đây là một quy ước hữu ích.
Tính năng chính của Claude Sonnet 5.5
Phần lớn điểm mới ở Sonnet 5.5 là làm cùng khối lượng công việc nhanh hơn và dùng ít token hơn, cộng thêm vài thay đổi mà người dùng API cần lưu ý.
Nhận kết quả gần như Opus cho các tác vụ hằng ngày với tốc độ Sonnet
Bạn có thể giao cho Sonnet 5.5 những công việc vốn trước đây cần Opus và nhận lại kết quả nhanh hơn. Anthropic cho biết tốc độ sinh đầu ra nhanh hơn Sonnet 5 trên 30%, và mẫu dùng ít token hơn mỗi tác vụ - con số họ đưa ra là "giảm tới 30% mỗi tác vụ".
Những người kiểm thử sớm được trích dẫn trong bài ra mắt cũng xác nhận điều này bằng số liệu của họ:
- Base44 báo cáo trung bình 3,6 vòng lặp mỗi lần dựng ứng dụng với Sonnet 5.5, so với 7,7 với Opus 5.
- Box thấy khối lượng công việc chạy nhanh hơn 2,4 lần với tổng số token giảm 12%.
- Zendesk đo được tốc độ xử lý phiếu hỗ trợ nhanh hơn 20%.
- Slack báo cáo số token đầu ra giảm khoảng 14%.
Đây là trích dẫn khách hàng do nhà cung cấp chọn lọc. Dù vậy, có một mẫu số chung: ít vòng lặp hơn và ít token hơn, điều này ảnh hưởng đến hóa đơn của bạn, bên cạnh mức phí mỗi token.
Chạy agent lập trình trong terminal và trên desktop
Sonnet 5.5 được xây dựng để hoạt động như một agent: chạy lệnh shell, sửa lỗi trong toàn bộ repo và điều khiển máy tính để bàn qua ảnh chụp màn hình. Nó hoạt động ngay trong Claude Code từ khi ra mắt, và Anthropic mô tả khả năng sử dụng máy tính của nó là tiệm cận Opus 5.5.
Điều này có nghĩa thực tế cho nhiều người là Sonnet 5.5 giờ là lựa chọn mặc định đáng tin cho các phiên Claude Code và cho các vòng lặp agent bạn tự xây dựng theo hướng dẫn Claude API của chúng tôi.
Tạo tài liệu, slide và giao diện được trau chuốt
Anthropic nhấn mạnh "con mắt tinh về thiết kế" là điểm mạnh của Sonnet 5.5. Trên thực tế, điều đó nên đồng nghĩa các giao diện người dùng trông đẹp hơn khi bạn yêu cầu tinh chỉnh mã front-end, và đầu ra hoàn thiện hơn khi bạn cần slide, bảng tính hoặc tài liệu dài.
Tuyên bố về thiết kế là phần cần kiểm chứng độc lập nhất. Đây là khía cạnh khó đo bằng điểm chuẩn nhất, và bài ra mắt chỉ hỗ trợ bằng trích dẫn khách hàng.
Mong đợi các biện pháp bảo vệ trong bảo mật và sinh học
Sonnet 5.5 là mẫu Sonnet đầu tiên ra mắt với các biện pháp bảo vệ an ninh mạng tương tự Opus 5.5. Khi một yêu cầu bị phân loại là công việc bảo mật rủi ro cao hơn, yêu cầu sẽ được chuyển về Sonnet 5. Các biện pháp bảo vệ sinh học giống Sonnet 5, và Anthropic cho biết hầu hết công việc phát triển phần mềm và khoa học đời sống sẽ không bị ảnh hưởng.
Nó cũng là mẫu Sonnet đầu tiên tích hợp bộ phân loại chặn trích xuất suy luận, và các khối tư duy giờ được gắn với tài khoản và cuộc hội thoại đã tạo ra chúng. Nếu bạn chạy công cụ bảo mật, hãy thử nghiệm prompt trước khi chuyển pipeline.
Di chuyển từ Sonnet 5 với vài thay đổi mã
Chỉ đổi ID mẫu là chưa đủ. Tài liệu của Anthropic liệt kê năm thay đổi phá vỡ tương thích cho mã đang chạy trên Sonnet 5:
-
Chế độ tư duy thích ứng bật mặc định, và mức thấp nhất là
between_tools, tắt phần tư duy ban đầu. -
Bắt buộc dùng công cụ sẽ trả về lỗi.
-
Các khối tư duy được gắn với mẫu và cuộc hội thoại đã tạo ra chúng.
-
Công cụ sử dụng máy tính cũ
computer_20251124bị từ chối trên Claude API và Google Cloud. -
Công cụ advisor không còn chấp nhận Opus 4.8, Opus 4.7 hoặc Sonnet 5 làm cố vấn.
Cũng có một thay đổi âm thầm: văn bản giữa các lần gọi công cụ giờ sẽ trả về trong các khối thinking. Ứng dụng phát trực tuyến văn bản tới người dùng sẽ im lặng giữa các lần gọi công cụ cho đến khi bạn cập nhật thiết lập display. Đặt temperature, top_p hoặc top_k khác mặc định cũng sẽ trả về lỗi 400. Đây là những thứ cụ thể bạn có thể gặp.
Claude Sonnet 5.5 hoạt động thế nào trên các điểm chuẩn?
Claude Sonnet 5.5 vượt Sonnet 5 ở mọi điểm chuẩn Anthropic công bố, vượt Opus 5.5 ở lập trình trong terminal và chỉ kém Opus 5.5 vài điểm ở nơi khác. So với GPT-6 Sol của OpenAI, nó dẫn trước ở các đánh giá công việc tri thức và đọc biểu đồ nhưng kém ở FrontierCode. Tất cả số liệu dưới đây đều từ bài ra mắt của Anthropic.
| Điểm chuẩn | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 10,3% | 66,4% | Không báo cáo |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | Không báo cáo |
| FrontierCode 1.1 (Chính) | 46,2% (nỗ lực tối đa) | 42,4% | 54,4% | 49,3% (52,1% ở xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (có công cụ) | 64,5% | 54,9% | 67,7% | Không báo cáo |
| OSWorld 2.1 | 80,1% | 57,0% | 81,8% | Không báo cáo |
| Chartography (không công cụ) | 61,6% | 15,6% | 64,4% | 53,6% |
Bảng cho thấy một câu chuyện đơn giản: bước nhảy thế hệ lớn so với Sonnet 5, và gần như hòa với Opus 5.5. Hãy xem mỗi mảng có ý nghĩa gì với công việc của bạn.
Lập trình theo tác vụ
Terminal-Bench 4.0 là nơi Sonnet 5.5 bứt lên. Nó đạt 70,6%, từ mức 10,3% của Sonnet 5 và vượt 66,4% của Opus 5.5. Bài đánh giá đo việc mẫu có hoàn thành được tác vụ thực trong môi trường dòng lệnh hay không, như quy trình shell nhiều bước, nên phản ánh sát cách Claude Code được dùng.
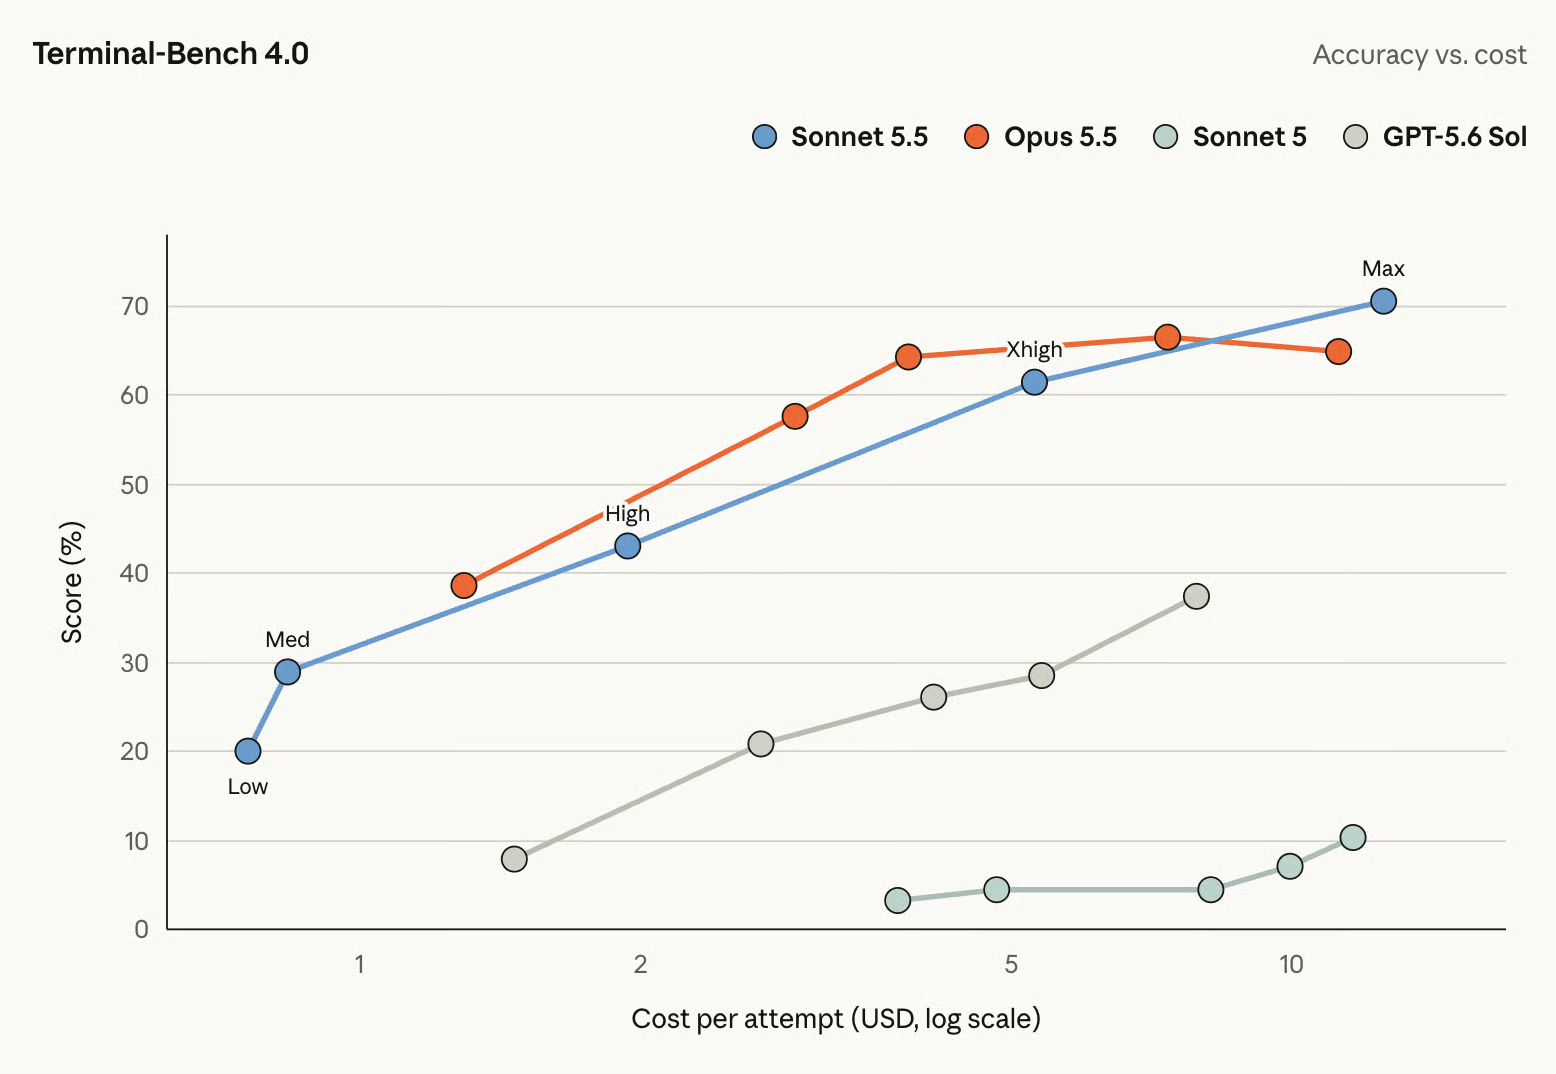
Một cú nhảy 60 điểm trong một phiên bản là điều khá hiếm. Phần còn lại của bức tranh lập trình thì bớt kịch tính hơn.
Công việc tri thức
Trên GDPval-AA v2.1, bài chấm đầu ra của mẫu cho các tác vụ có giá trị kinh tế từ nghề nghiệp thực bằng thang điểm Elo, Sonnet 5.5 đạt 1844. Đó là kém Opus 5.5 chỉ 2 điểm và hơn Sonnet 5 gần 400 điểm.
Với các đội dùng Claude cho báo cáo, phân tích và tài liệu kinh doanh, đây là kết quả hữu ích nhất. Với dạng công việc này, chi phí cao hơn của Opus 5.5 chỉ mua thêm một chút.
Lý luận và hiểu hình ảnh
Chartography, bài kiểm tra đọc và suy luận qua biểu đồ không dùng công cụ, cho thấy mức tăng tương đối lớn nhất: Sonnet 5.5 đạt 61,6% so với 15,6% của Sonnet 5. Điều này khớp với tuyên bố của Anthropic về hiểu hình ảnh được cải thiện.
Sử dụng máy tính
Trên OSWorld 2.1, bài đo việc mẫu có hoàn thành tác vụ bằng cách vận hành một hệ điều hành máy tính để bàn thực hay không, Sonnet 5.5 đạt 80,1%, tăng từ 57,0% của Sonnet 5 và chỉ kém Opus 5.5 hai điểm.
Nên dùng phân hạng nào?
Với hầu hết nhà phát triển, Sonnet 5.5 giờ nên là mẫu Claude mặc định. Opus 5.5 chỉ xứng giá cao hơn khi tác vụ đủ mở đến mức nút thắt là phán đoán chứ không phải tốc độ.
Danh mục hiện tại, theo bảng so sánh mẫu của Anthropic, như sau. Cả bốn mẫu trừ Haiku 4.5 đều có cửa sổ ngữ cảnh 1M token và đầu ra tối đa 128K.
| Mẫu | Giá (input / output mỗi 1M token) | Độ trễ | Phù hợp nhất cho |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Chậm hơn | Công việc đỉnh cao nơi năng lực quan trọng hơn chi phí |
| Claude Opus 5.5 | $4 / $20 | Trung bình | Công việc phức tạp, mở, cần phán đoán liên tục |
| Claude Sonnet 5.5 | $2 / $10 | Nhanh | Lập trình phạm vi rõ, agent và tài liệu |
| Claude Haiku 4.5 | $1 / $5 | Nhanh nhất | Tác vụ khối lượng lớn, nhạy chi phí |
Bên trong Sonnet 5.5, thiết lập effort là đòn bẩy còn lại. Anthropic hiệu chỉnh lại năm mức: low, medium, high, xhigh và max. Mức thấp ưu tiên tốc độ và chi phí, mức cao cho phép mẫu suy luận lâu hơn và tự kiểm tra. Mặc định là medium trong ứng dụng Claude và Claude Code, và high trên API.
Một chi tiết từ bài ra mắt thay đổi cách tôi dùng nó: ở effort thấp hoặc trung bình, Sonnet 5.5 vượt điểm tốt nhất của Sonnet 5 trên vài điểm chuẩn với chi phí mỗi tác vụ chỉ khoảng một phần mười. Tóm lại:
-
Sửa lỗi, refactor và phiên Claude Code: Sonnet 5.5 ở effort mặc định.
-
Vòng lặp agent và pipeline thông lượng cao: Sonnet 5.5 ở
lowhoặcmedium, rồi chỉ tăng effort khi thất bại. -
Bài toán lập trình khó với đặc tả rõ ràng: Sonnet 5.5 ở
xhighhoặcmaxtrước khi trả tiền cho Opus. -
Dự án mơ hồ, kéo dài nhiều ngày: Opus 5.5.
Kiểm thử Claude Sonnet 5.5: Ví dụ thực hành
Các điểm chuẩn trên là của Anthropic, nên tôi đã chạy một tác vụ dựng ứng dụng với Claude Sonnet 5.5 và Claude Sonnet 5 bằng prompt và công cụ giống hệt nhau.
Tác vụ: biến bộ dữ liệu cử nhân mới tốt nghiệp của FiveThirtyEight (173 ngành tại Hoa Kỳ, CC BY 4.0) thành một dashboard HTML tệp đơn giúp sinh viên tương lai so sánh các nhóm ngành về thu nhập và việc làm, đồng thời tìm ngành có thu nhập cao nhất và thấp nhất.
Bài kiểm thử thực sự nằm ở dữ liệu, vốn có vài đặc điểm mà prompt không hề nhắc đến:
- Ngành thu nhập cao nhất, Kỹ thuật Dầu khí, chỉ có 36 người trả lời khảo sát, và 76/173 ngành có dưới 100 người
- Thu nhập bị lệch, nên một cột median đơn che giấu nhiều độ phân tán
- Một ngành, Khoa học Thực phẩm, có các trường số lượng trống
- Các cột loại hình công việc không cộng lại bằng số người có việc làm
Nhận ra các vấn đề này là mục tiêu của bài kiểm thử. Bài kiểm thử thăm dò tuyên bố của Anthropic về "con mắt tinh về thiết kế".
Kết quả chính:
- Chỉ Sonnet 5.5 xuất xưởng một dashboard hoạt động. Sonnet 5 liên kết tới tệp Chart.js không tồn tại trên cdnjs (URL trả về 404), nên thư viện không tải và mọi panel, kể cả các bảng thuần văn bản, đều trống trơn. Sonnet 5.5 cũng kiểm tra xem thư viện biểu đồ có tải không và giữ cho các bảng vẫn hoạt động nếu không tải được.
- Sonnet 5.5 phát hiện bẫy mẫu nhỏ, ở mức độ nhất định. Nó đánh dấu các ngành có dưới 30 người trả lời là "cần thận trọng" và thêm bộ lọc số người trả lời tối thiểu. Chế độ xem mặc định đặt Kỹ thuật Dầu khí ở #1 mà không có cảnh báo.
- Sonnet 5 vốn cũng sẽ bỏ lỡ điều đó. Mã của nó đọc cột kích thước mẫu và phạm vi lương, rồi không dùng nữa, và xếp hạng ngành chỉ theo median.
- Các bẫy nhỏ hơn không làm khó ai. Cả hai đều xử lý rõ ràng dòng Khoa học Thực phẩm bị trống, và Sonnet 5.5 tính tỷ lệ công việc đúng chuyên ngành mà không ngụ ý các cột nghề nghiệp cộng lại bằng tổng việc làm.
Đây là dashboard của Sonnet 5.5 với bộ lọc đặt ở các ngành có ít nhất 100 người trả lời.
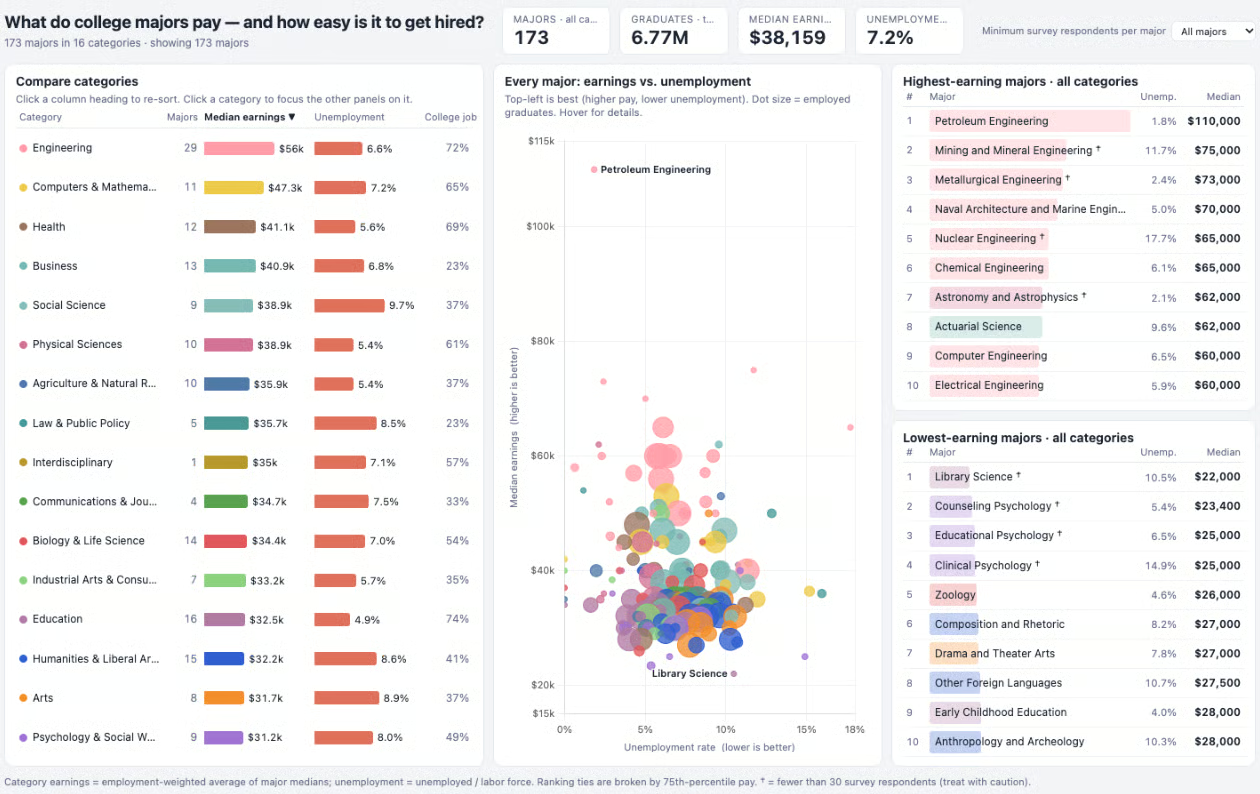
Tôi chấm dashboard của Sonnet 5.5 điểm 4/5 cho xử lý dữ liệu trung thực, 5 cho giá trị phân tích và 4 cho chất lượng biểu đồ và bố cục. Trang trắng của Sonnet 5 tôi đưa bên dưới.
Vậy tại sao Sonnet 5 thất bại? Vấn đề là dashboard cần một thư viện vẽ biểu đồ. Sonnet 5 yêu cầu cdnjs một phiên bản không được host. Nó nhận lỗi "404". Không có thư viện, mã của Sonnet 5 bị sập: "Chart is not defined." Rõ ràng, Sonnet 5 viết trang sao cho mọi thứ, kể cả các bảng văn bản thuần, đều chạy sau bước đó, và nó không thể bắt lỗi này.
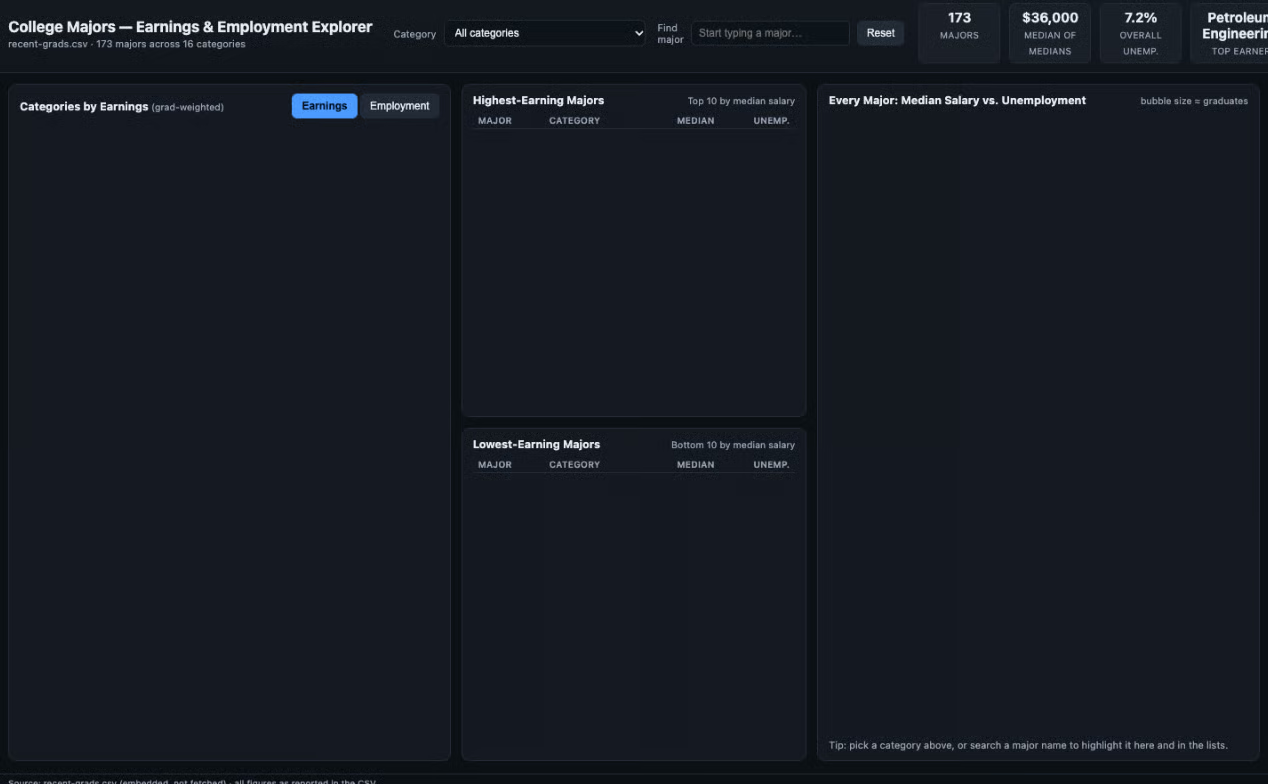
Chi phí mỗi lần chạy về cơ bản là như nhau: $0,56 cho Sonnet 5.5 và $0,57 cho Sonnet 5. Ngoài ra, Sonnet 5.5 hoàn thành công việc nhanh hơn.
Vậy Sonnet 5.5 có thực sự là bước tiến? Với tác vụ này, có. Sonnet 5.5 xuất xưởng một dashboard hoạt động và cảnh báo bạn về dữ liệu mỏng, trong khi Sonnet 5 xuất xưởng một trang trắng.
Giá và khả dụng của Claude Sonnet 5.5
Claude Sonnet 5.5 có giá $2 cho mỗi triệu token đầu vào và $10 cho mỗi triệu token đầu ra trên API, không đổi so với Sonnet 5 và bằng một nửa giá của Opus 5.5. Anthropic báo cáo dùng ít token hơn mỗi tác vụ, điều này sẽ giảm chi phí thực tế của một công việc dù mức giá danh nghĩa không đổi. Tuy nhiên, trong thử nghiệm thực hành của chúng tôi, cả hai mẫu tốn gần như nhau để hoàn thành tác vụ.
| Loại token | Giá mỗi 1M token |
|---|---|
| Input | $2 |
| Output | $10 |
| Ghi cache (5 phút) | $2,50 |
| Ghi cache (1 giờ) | $4 |
| Đọc cache | $0,20 |
Batch API giảm 50% cho cả input và output. Prompt tối thiểu có thể cache là 512 token, và trên Batch API, mẫu có thể trả tối đa 300K token đầu ra với header beta output-300k-2026-03-24.
Sonnet 5.5 khả dụng rộng rãi, không phải bản xem trước, với tùy chọn không lưu giữ dữ liệu. Anthropic cam kết không ngừng hỗ trợ trước ngày 28 tháng 9 năm 2027.
Làm sao để truy cập Claude Sonnet 5.5?
Bạn có thể dùng Claude Sonnet 5.5 ngay hôm nay trong các ứng dụng Claude, trong Claude Code và qua API với ID mẫu claude-sonnet-5-5. Nó cũng có trên Amazon Bedrock dưới dạng anthropic.claude-sonnet-5-5, và trên Google Cloud, Microsoft Foundry, cũng như Claude Platform trên AWS với claude-sonnet-5-5.
Dưới đây là lời gọi Python tối thiểu. Chế độ tư duy thích ứng bật mặc định, nên phản hồi có thể bao gồm các khối tư duy trước phần văn bản:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Để xem hướng dẫn thực tế về khóa API, chi phí và dự án đầu tay của bạn, hãy xem hướng dẫn đầy đủ về Claude API của chúng tôi. Nếu bạn đang xây dựng agent, hướng dẫn về xây dựng Claude Managed Agents là bước tiếp theo phù hợp. Chúng tôi sẽ sớm xuất bản một hướng dẫn API cho Claude Sonnet 5.5.
Kết luận
Anthropic đặt cược rằng phần lớn công việc trả phí, bao gồm phần lớn công việc agent lập trình, sẽ chạy trên mẫu tầm trung mới này. Điều đó cũng tạo áp lực trực tiếp lên GPT-6 Sol của OpenAI, vốn kém nó ở các con số về công việc tri thức do Anthropic công bố.
Nếu bạn đang dùng Sonnet 5, tôi khuyên chuyển ngay, nhưng hãy tự cập nhật về các thay đổi API. Giữ Opus 5.5 cho các dự án nơi mẫu phải tự quyết định xây gì.
Nếu bạn muốn tìm hiểu thêm về xây dựng với các mẫu của Anthropic, tôi khuyến nghị xem khóa học Introduction to Claude Models của chúng tôi.
