Sex dagar efter att Anthropic satte Claude Opus 5.5 högst upp i sin uppställning har mellanmodellen stängt större delen av gapet till halva priset. Claude Sonnet 5.5 slår Opus 5.5 på ett benchmark och ligger bara ett par poäng efter på övriga, samtidigt som den behåller Sonnet 5:s prissättning.
Vi har sett det här mönstret förut. Claude Sonnet 5 lanserades och närmade sig Opus 4.8:s agentiska benchmarkresultat till en bråkdel av kostnaden. Dessförinnan landade Sonnet 4.6 inom räckhåll för Opus 4.6 på samma villkor. Varje gång kommer en mellanmodell dagar eller veckor efter flaggskeppet och stänger större delen av gapet till halva priset.
Det här är hur en logaritmisk skalningskurva ser ut från utsidan. Prestandan stiger ungefär med logaritmen av beräkningen, så kostnaden stiger ungefär exponentiellt med prestandan. Ett flaggskepp ligger högst upp på den kurvan, där man spenderar mycket för att köpa de sista poängen. En billigare modell som byggs veckor senare, och drar nytta av samma underliggande framsteg, behöver bara nå en lägre punkt på kurvan för att verka nästan lika bra. Med andra ord: större delen av kurvans värde är fortfarande billig att nå, och bara den sista sträckan är dyr.
Jag tycker det är värt att reda ut, eftersom de ledande företagen ägnar sig åt lite trolleri med PR och varumärken.
TL;DR
- Sonnet 5.5 är Anthropics nya mellanmodell och ersätter Sonnet 5 till samma pris.
- Den största vinsten är agentisk terminalkodning, där den nu faktiskt går om Opus 5.5.
- För kunskapsarbete och datoranvändning ligger den strax bakom Opus 5.5 till halva per-token-priset.
- Gör den till din standardmodell för Claude och behåll Opus 5.5 för öppna, bedömningsintensiva uppgifter.
Vad är Claude Sonnet 5.5?
Anthropics modelldokumentation beskriver Claude Sonnet 5.5 som ”den bästa kombinationen av hastighet och intelligens” i den aktuella uppställningen. Det är mellanmodellen i Anthropics Claude 5.5-familj, mellan flaggskeppet Claude Opus 5.5 och kommande Claude Haiku 5.5. (Vi håller dig uppdaterad om Haiku 5.5, även om Haiku 5 aldrig dök upp.)
Jämfört med Sonnet 5 är hoppet större än vad ett halvt versionsnummer antyder. Det är inte förvånande efter att vi såg att språnget mellan Opus 5.5 och Opus 5 var större än väntat.
När det gäller lanseringsinlägget – Anthropic rapporterar förbättringar på varje benchmark de publicerade, med de största lyften i terminalkodning, diagramtolkning och utvärderingar av kunskapsarbete.
Intressant nog säger Anthropic att den här Sonnet-modellen är den första som klarar Pokémon Red enbart från skärmdumpar. Det låter ovanligt, men det är ett test som Anthropic använder som proxy för uppgifter med lång horisont och bildförståelse.
Så, Opus 5.5 är enligt företaget tydligt starkare på komplext, öppet arbete som kräver uthållig omdömesförmåga. Men Sonnet 5.5 är modellen för uppgifter där du vet hur ”klart” ser ut, vilket är en hjälpsam tumregel.
Viktiga funktioner i Claude Sonnet 5.5
Det mesta som är nytt i Sonnet 5.5 handlar om att göra samma jobb snabbare och med färre tokens, plus några ändringar som API-användare behöver planera för.
Nära Opus-resultat i vardagsuppgifter i Sonnet-fart
Du kan lämna över till Sonnet 5.5 sådant arbete som tidigare krävde Opus och få tillbaka det snabbare. Anthropic säger att utdatagenerering är mer än 30% snabbare än Sonnet 5 och att modellen använder färre tokens per uppgift – ”upp till 30% mindre per uppgift” – är siffran de använder.
Tidiga testare som citeras i lanseringsinlägget backar upp detta med egna siffror:
- Base44 rapporterar 3,6 iterationer per appbygge med Sonnet 5.5, mot 7,7 med Opus 5.
- Box såg sina arbetslaster köra 2,4x snabbare med 12% färre totalt antal tokens.
- Zendesk mätte 20% snabbare ärendehantering.
- Slack rapporterar ungefär 14% färre utdatatokens.
Detta är kundcitat utvalda av leverantören. Ändå finns ett mönster: färre iterationer och färre tokens, vilket påverkar din faktura utöver per-token-priset.
Kör kodagenter i terminalen och på skrivbordet
Sonnet 5.5 är byggd för att fungera som en agent: köra shellkommandon, fixa buggar i ett repo och styra ett skrivbord via skärmdumpar. Den finns live i Claude Code från start, och Anthropic beskriver dess datoranvändning som nära Opus 5.5.
Den praktiska konsekvensen för många är att Sonnet 5.5 nu är ett trovärdigt standardval för Claude Code-sessioner och för agentloopar du bygger själv med vår Claude API-guide.
Ta fram polerade dokument, presentationer och gränssnitt
Anthropic lyfter fram ett ”skarpt öga för design” som en styrka i Sonnet 5.5. I praktiken bör det betyda snyggare användargränssnitt när du ber den förfina front-end-kod, och mer färdigt material när du ber om presentationer, kalkylblad eller längre dokument.
Designpåståendet är det som mest behöver oberoende granskning. Det är svårast att benchmarka och lanseringsinlägget stöder det bara med kundcitat.
Räkna med skyddsåtgärder för säkerhet och biologi
Sonnet 5.5 är den första Sonnet-modellen som lanseras med cybersäkerhetsskydd liknande dem i Opus 5.5. När en förfrågan klassas som mer riskfyllt säkerhetsarbete, faller förfrågan tillbaka till Sonnet 5. Bioskydden är desamma som i Sonnet 5, och Anthropic säger att de flesta mjukvaru- och life science-arbeten inte påverkas.
Det är också den första Sonnet som levereras med klassificerare som blockerar extraktion av resonemang, och thinking-block är nu knutna till kontot och konversationen som skapade dem. Om du kör säkerhetsverktyg, testa dina prompts innan du byter pipeline.
Migrera från Sonnet 5 med några få kodändringar
Att bara byta modell-ID räcker inte riktigt. Anthropics dokumentation listar fem brytande ändringar för kod som redan körs på Sonnet 5:
-
Adaptivt tänkande är på som standard, och den lägsta inställningen är
between_tools, som stänger av initialt tänkande. -
Tvingad verktygsanvändning returnerar ett fel.
-
Thinking-block är knutna till modellen och konversationen som skapade dem.
-
Det äldre datoranvändningsverktyget
computer_20251124avvisas på Claude API och Google Cloud. -
Rådgivarverktyget accepterar inte längre Opus 4.8, Opus 4.7 eller Sonnet 5 som rådgivare.
Det finns också en tystare ändring: text mellan verktygsanrop kommer nu tillbaka i thinking-block. En app som strömmar text till användare blir tyst mellan verktygsanrop tills du uppdaterar dess display-inställning. Att sätta temperature, top_p eller top_k till ett icke-standardvärde ger också ett 400-fel. Detta är sådant du kan upptäcka i praktiken.
Hur presterar Claude Sonnet 5.5 på benchmark?
Claude Sonnet 5.5 slår Sonnet 5 på varje benchmark som Anthropic publicerade, slår Opus 5.5 på terminalkodning och ligger några poäng efter Opus 5.5 på övriga. Jämfört med OpenAI:s GPT-6 Sol leder den på utvärderingar av kunskapsarbete och diagramläsning men ligger efter på FrontierCode. Alla siffror nedan kommer från Anthropics lanseringsinlägg.
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 10,3% | 66,4% | Inte rapporterat |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | Inte rapporterat |
| FrontierCode 1.1 (Main) | 46,2% (max effort) | 42,4% | 54,4% | 49,3% (52,1% vid xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (with tools) | 64,5% | 54,9% | 67,7% | Inte rapporterat |
| OSWorld 2.1 | 80,1% | 57,0% | 81,8% | Inte rapporterat |
| Chartography (no tools) | 61,6% | 15,6% | 64,4% | 53,6% |
Tabellen berättar en enkel historia: ett stort generationskliv över Sonnet 5 och nästan dött lopp med Opus 5.5. Låt oss se vad varje område betyder för ditt arbete.
Agentisk kodning
Terminal-Bench 4.0 är där Sonnet 5.5 särskiljer sig. Den får 70,6%, upp från Sonnet 5:s 10,3% och före Opus 5.5:s 66,4%. Benchmarken mäter om en modell kan slutföra verkliga uppgifter i en kommandoradsmiljö, som flerstegs shellflöden, så den kartlägger väl hur Claude Code används.
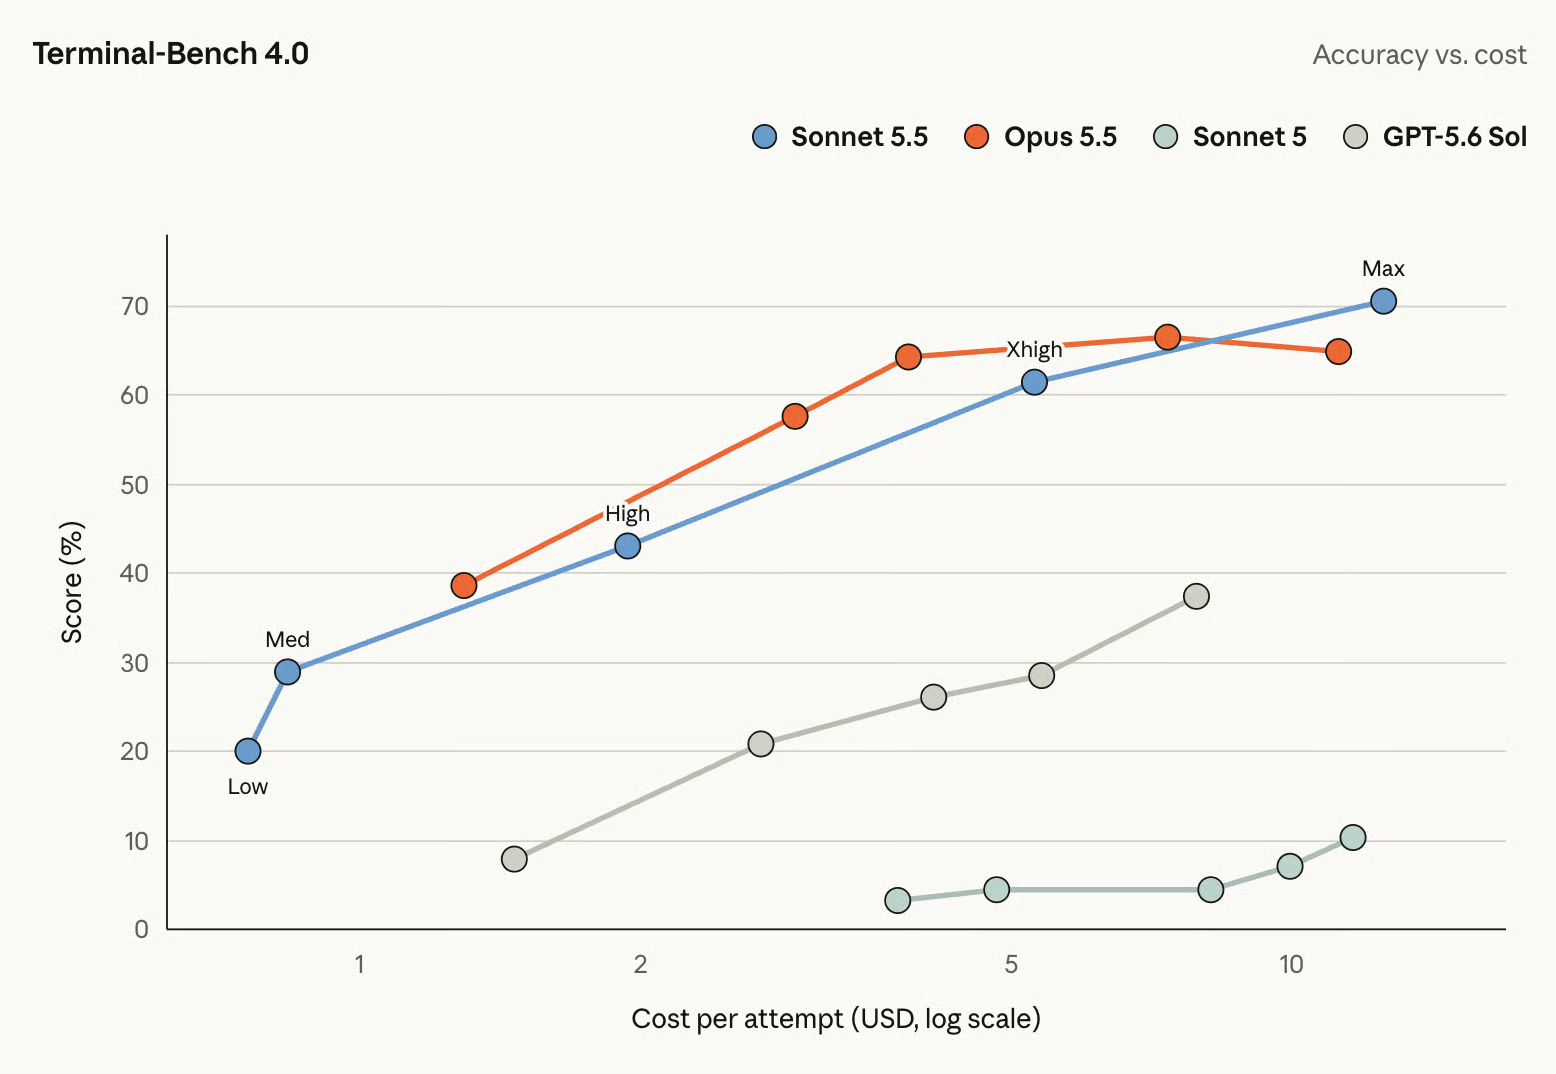
Ett hopp på 60 poäng i en release är ovanligt nog. Resten av kodningsbilden är mindre dramatisk.
Kunskapsarbete
På GDPval-AA v2.1, som betygsätter modellutdata på ekonomiskt värdefulla uppgifter från verkliga yrken med ett Elo-liknande mått, får Sonnet 5.5 1844. Det är 2 poäng bakom Opus 5.5 och nästan 400 före Sonnet 5.
För team som använder Claude för rapporter, analyser och affärsdokument är detta det mest användbara resultatet i tabellen. För den här typen av arbete köper Opus 5.5:s extrakostnad bara lite.
Resonemang och visuell förståelse
Chartography, ett test av att läsa och resonera över diagram utan verktyg, visar den största relativa vinsten: Sonnet 5.5 får 61,6% mot Sonnet 5:s 15,6%. Det ligger i linje med Anthropics påståenden om förbättrad bildförståelse.
Datoranvändning
På OSWorld 2.1, som mäter om en modell kan slutföra uppgifter genom att styra ett riktigt skrivbordsoperativsystem, når Sonnet 5.5 80,1%, upp från 57,0% för Sonnet 5 och inom 2 poäng från Opus 5.5.
Vilken nivå ska du använda?
För de flesta utvecklare bör Sonnet 5.5 nu vara standardmodellen för Claude. Opus 5.5 förtjänar sitt högre pris bara när uppgiften är så öppen att omdöme, inte hastighet, är flaskhalsen.
Den nuvarande uppställningen, enligt Anthropics modelljämförelsetabell, ser ut så här. Alla fyra modeller utom Haiku 4.5 delar ett kontextfönster på 1M tokens och maxutdata på 128K.
| Modell | Pris (in/ut per 1M tokens) | Latens | Bäst för |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Långsammare | Arbete i toppskiktet där kapabilitet är viktigare än kostnad |
| Claude Opus 5.5 | $4 / $20 | Måttlig | Komplext, öppet arbete som kräver uthålligt omdöme |
| Claude Sonnet 5.5 | $2 / $10 | Snabb | Tydligt avgränsad kodning, agenter och dokumentarbete |
| Claude Haiku 4.5 | $1 / $5 | Snabbast | Stora volymer där kostnadskänslighet är viktig |
Inom Sonnet 5.5 är insatsnivån den andra reglaget. Anthropic har kalibrerat fem nivåer: low, medium, high, xhigh och max. Lägre nivåer gynnar hastighet och kostnad, medan högre låter modellen resonera längre och kontrollera sitt arbete. Standard är medium i Claude-apparna och Claude Code, och high på API:et.
En detalj från lanseringsinlägget ändrar hur jag skulle använda den: på low eller medium effort slår Sonnet 5.5 Sonnet 5:s bästa poäng på flera benchmark till omkring en tiondel av kostnaden per uppgift. Sammanfattningsvis:
-
Buggrättningar, refaktoreringar och Claude Code-sessioner: Sonnet 5.5 på standardinsats.
-
Agentloopar och pipelines med hög genomströmning: Sonnet 5.5 på
lowellermedium, höj insatsen först vid fel. -
Svåra kodproblem med tydlig spec: Sonnet 5.5 på
xhighellermaxinnan du betalar för Opus. -
Tvetydiga projekt över flera dagar: Opus 5.5.
Test av Claude Sonnet 5.5: praktiska exempel
Benchmarken ovan är Anthropics egna, så jag körde en bygguppgift mot Claude Sonnet 5.5 och Claude Sonnet 5 med identisk prompt och identiska verktyg.
Uppgiften: förvandla FiveThirtyEights dataset över nyutexaminerade (173 amerikanska utbildningar, CC BY 4.0) till en HTML-dashboard i en fil som hjälper en blivande student att jämföra kategorier utifrån inkomst och sysselsättning, samt hitta de högst och lägst betalande utbildningarna.
Det verkliga testet finns i datan, som har några egenskaper som prompten aldrig nämner:
- Topptjänaren, Petroleum Engineering, har bara 36 svarande, och 76 av de 173 utbildningarna har färre än 100
- Inkomsterna är skeva, så en ensam medianstapel döljer stor spridning
- En utbildning, Food Science, har tomma fält för antal
- Kolumnerna för jobbkategori summerar inte till antalet sysselsatta
Att upptäcka dessa frågor är poängen med testet. Testet sonderar Anthropics påståenden om att ha ett ”skarpt öga för design”.
Huvudfynden:
- Endast Sonnet 5.5 levererade en fungerande dashboard. Sonnet 5 länkade till en Chart.js-fil som inte finns på cdnjs (URL:en ger 404), så biblioteket laddades aldrig och varje panel, inklusive dess enkla tabeller, renderades tomma. Sonnet 5.5 kontrollerar också om dess diagrambibliotek laddades och håller sina tabeller fungerande om det inte gjorde det.
- Sonnet 5.5 fångade fällan med små urval, mestadels. Den markerar utbildningar med färre än 30 svarande som ”ta med en nypa salt” och lägger till ett filter för minsta antal svarande. Dess standardvy placerar Petroleum Engineering som #1 utan varning.
- Sonnet 5 hade missat det ändå. Dess kod läser kolumnerna för urvalsstorlek och lönespann, men använder dem aldrig, och rankar utbildningar enbart efter median.
- De mindre fällorna snubblade ingen på. Båda hanterade raden med tomma värden för Food Science uttryckligen, och Sonnet 5.5 beräknade sin andel ”college-jobb” utan att antyda att jobbkolumnerna summerar till total sysselsättning.
Här är Sonnet 5.5:s dashboard med filtret satt till utbildningar med minst 100 svarande.
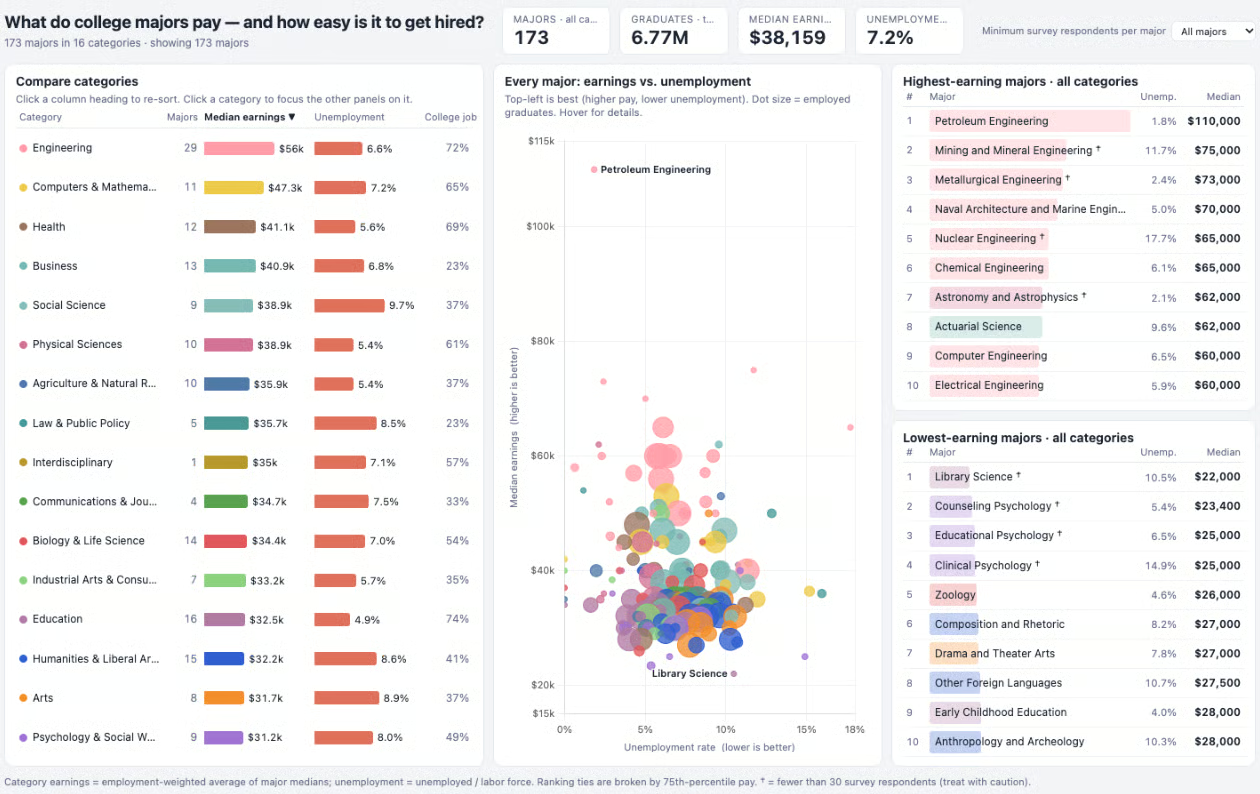
Jag satte betyget 4 av 5 för ärlig datahantering, 5 för analytisk användbarhet och 4 för diagram- och layoutkvalitet på Sonnet 5.5:s dashboard. Sonnet 5:s tomma sida finns nedan.
Så varför misslyckades Sonnet 5? Problemet var att dashboarden behövde ett diagrambibliotek. Sonnet 5 bad cdnjs om en version som inte finns. Den fick sedan ett ”404”-fel. Utan biblioteket kraschade Sonnet 5:s kod: ”Chart is not defined.” Tydligen hade Sonnet 5 skrivit sidan så att allt, även dess enkla texttabeller, kördes efter det steget, och den kunde inte fånga misstaget.
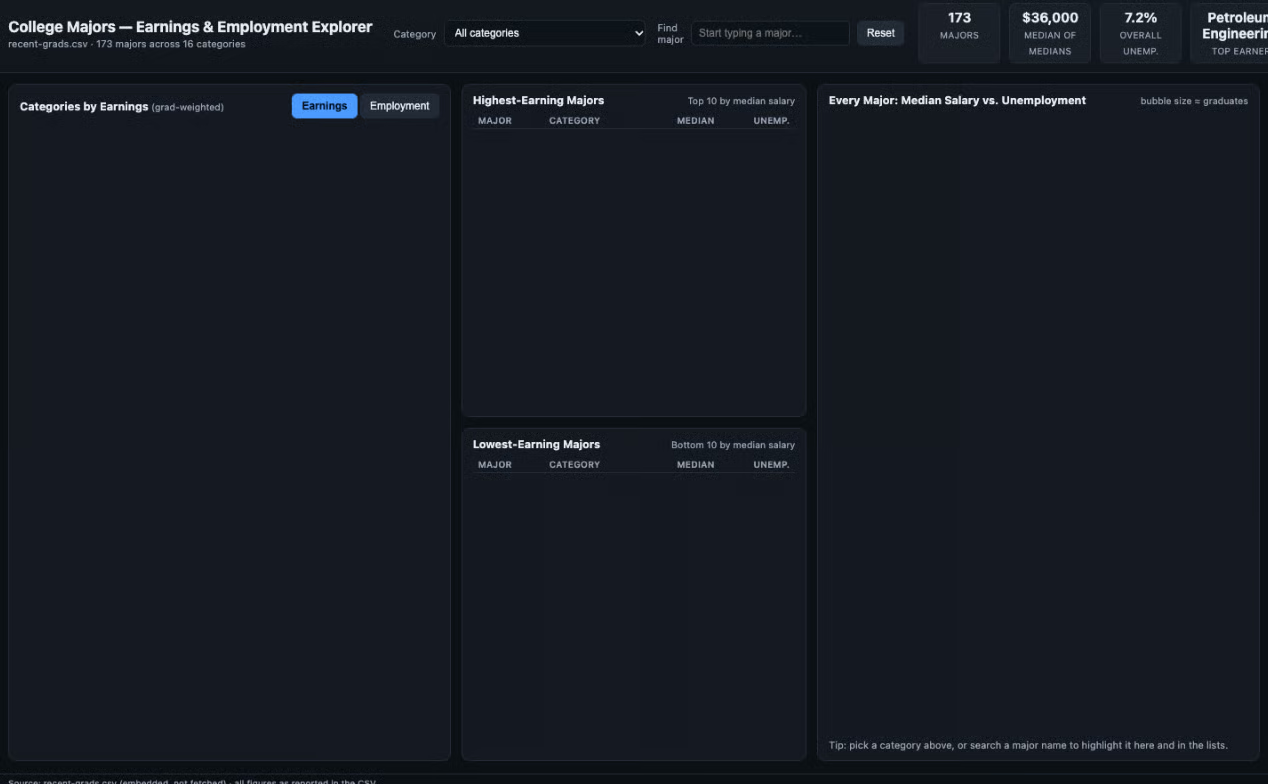
Kostnaden per körning var i praktiken identisk: $0,56 för Sonnet 5.5 och $0,57 för Sonnet 5. Dessutom blev Sonnet 5.5 klar snabbare.
Så är Sonnet 5.5 ett verkligt lyft? För den här uppgiften, ja. Sonnet 5.5 levererade en dashboard som fungerar och varnar för tunn data, medan Sonnet 5 levererade en tom sida.
Pris och tillgänglighet för Claude Sonnet 5.5
Claude Sonnet 5.5 kostar $2 per miljon indatatokens och $10 per miljon utdatatokens på API:et, oförändrat från Sonnet 5 och hälften av priset för Opus 5.5. Anthropic rapporterar färre tokens per uppgift, vilket skulle sänka den faktiska kostnaden för ett jobb även om taxan är oförändrad. I vårt praktiska test kostade dock båda modellerna ungefär lika mycket för att slutföra uppgiften.
| Tokentyp | Pris per 1M tokens |
|---|---|
| Indata | $2 |
| Utdata | $10 |
| Cache write (5 minuter) | $2,50 |
| Cache write (1 timme) | $4 |
| Cache read | $0,20 |
Batch-API:t halverar både in- och utdata. Minsta cachebara prompt är 512 tokens, och på Batch-API:t kan modellen returnera upp till 300K utdatatokens med betahuvudet output-300k-2026-03-24.
Sonnet 5.5 är allmänt tillgänglig, inte en förhandsvisning, med erbjudande om noll datalagring. Anthropic förbinder sig att inte pensionera den före 28 september 2027.
Hur får du tillgång till Claude Sonnet 5.5?
Du kan använda Claude Sonnet 5.5 idag i Claude-apparna, i Claude Code och via API:et med modell-ID claude-sonnet-5-5. Den finns också på Amazon Bedrock som anthropic.claude-sonnet-5-5, samt på Google Cloud, Microsoft Foundry och Claude Platform på AWS under claude-sonnet-5-5.
Här är ett minimalt Python-anrop. Adaptivt tänkande är på som standard, så svaret kan innehålla thinking-block före texten:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
För en riktig genomgång av nycklar, kostnader och ditt första projekt, se vår kompletta guide till Claude API. Om du bygger agenter är vår handledning om att bygga Claude Managed Agents ett bra nästa steg. Vi publicerar snart en API-handledning för Claude Sonnet 5.5.
Avslutande tankar
Anthropic satsar på att det mesta betalande arbetet, inklusive det mesta kodagent-arbetet, körs på den här nya mellanmodellen. Det sätter också direkt press på OpenAI:s GPT-6 Sol, som ligger efter på Anthropics siffror för kunskapsarbete.
Jag skulle byta nu om du är på Sonnet 5, men uppdatera dig om API-ändringarna. Behåll Opus 5.5 för projekt där modellen måste bestämma vad som ska byggas.
Om du vill lära dig mer om att bygga med Anthropics modeller rekommenderar jag vår kurs Introduction to Claude Models.