Curso
Introdução ao Snowflake SQL
2 h
55.8K
Assim como desenvolvedores de software usam o Git para controle de versão, engenheiros de dados têm o Time Travel nos bancos de dados Snowflake. O recurso Time Travel permite que administradores consultem dados históricos, clonem tabelas antigas e restaurem objetos excluídos no passado.
No entanto, como os bancos de dados podem atingir tamanhos enormes, o Time Travel não é um substituto direto do controle de versão de código. Toda vez que uma tabela é modificada (linhas deletadas ou atualizadas), o Snowflake cria um snapshot do estado dos dados antes da atualização. Esse snapshot só fica disponível por um número específico de dias, chamado de período de retenção de dados.
Para contas Snowflake Standard, o período máximo de retenção é de apenas um dia. Para contas Enterprise, ele pode variar de 0 a 90 dias. Um período de retenção 0 desativa o Time Travel (que é habilitado por padrão para todas as tabelas).
Ao ler a documentação do Snowflake, você também pode se deparar com o termo “Fail-safe”. Pelo nome, pode parecer que Time Travel e Fail-safe fazem a mesma coisa, mas não fazem.
Quando um objeto conclui seu período de retenção, ele é movido para o Fail-safe do Snowflake. No Fail-safe, você não pode:
O Fail-safe mantém os dados por apenas 7 dias e esse prazo não é configurável. Durante esse período, a recuperação só pode ser feita pelo próprio Snowflake. Esse recurso existe como um serviço de recuperação de dados e deve ser usado apenas como último recurso, quando todos os outros métodos falham. É indicado para situações em que dados foram danificados ou excluídos por falhas operacionais.
Portanto, você não pode pedir ao Snowflake que recupere versões antigas dos seus objetos depois que eles saem naturalmente do período de retenção configurado. Tenha essa regra em mente ao seguir este tutorial.
O Snowflake tem duas interfaces para interagir com a plataforma: o SnowSight (UI web) e o Snowflake CLI (cliente de terminal). Vamos usar o SnowSight, pois é mais simples de começar. Se você é novo no Snowflake, leia este tutorial completo. Ele também cobre como usar o Snowflake CLI.
Primeiro, crie uma conta gratuita na página inicial do Snowflake. Você terá acesso aos recursos Enterprise por um teste gratuito de 30 dias.
Quando sua conta estiver pronta, você será levado à página Worksheets do seu painel. Pense em cada worksheet como um ambiente separado para executar SQL ou até Python.
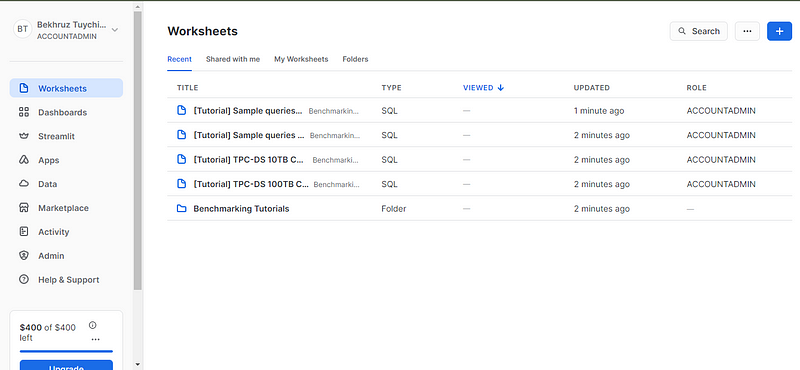
Agora, crie uma nova worksheet usando o botão “+” no canto superior direito:
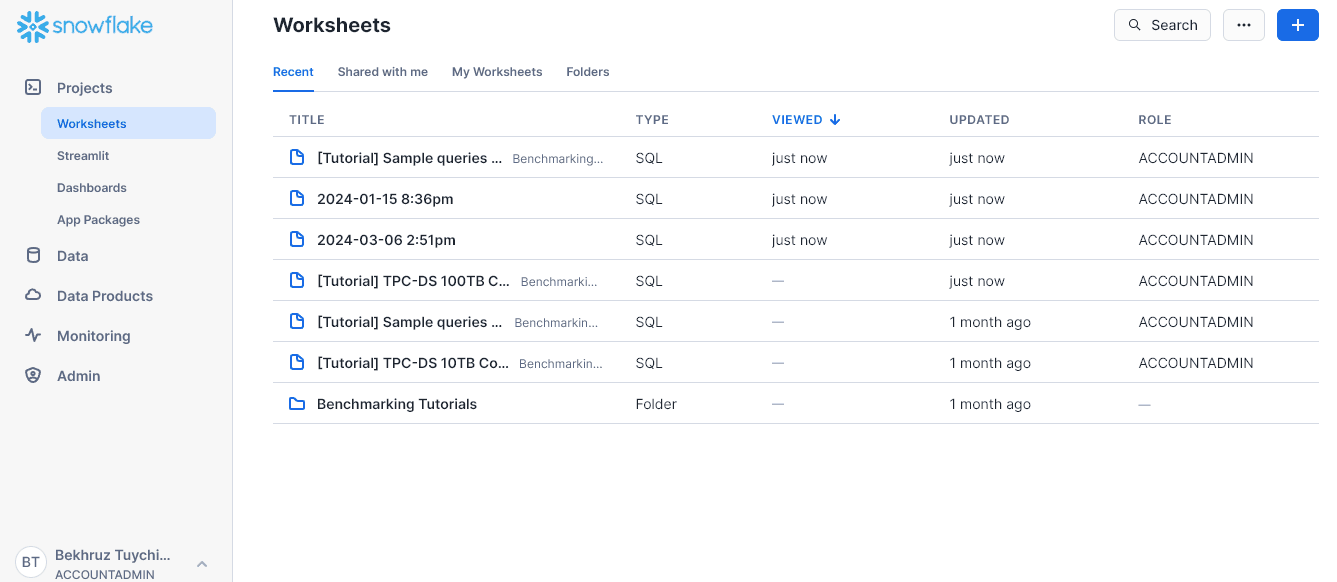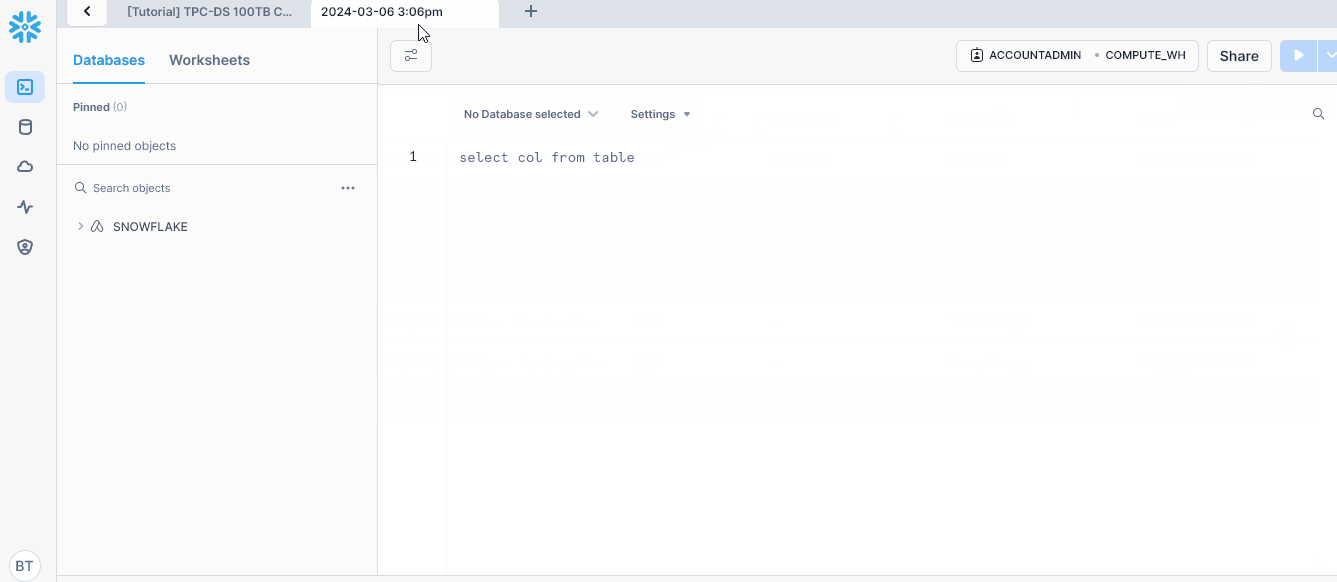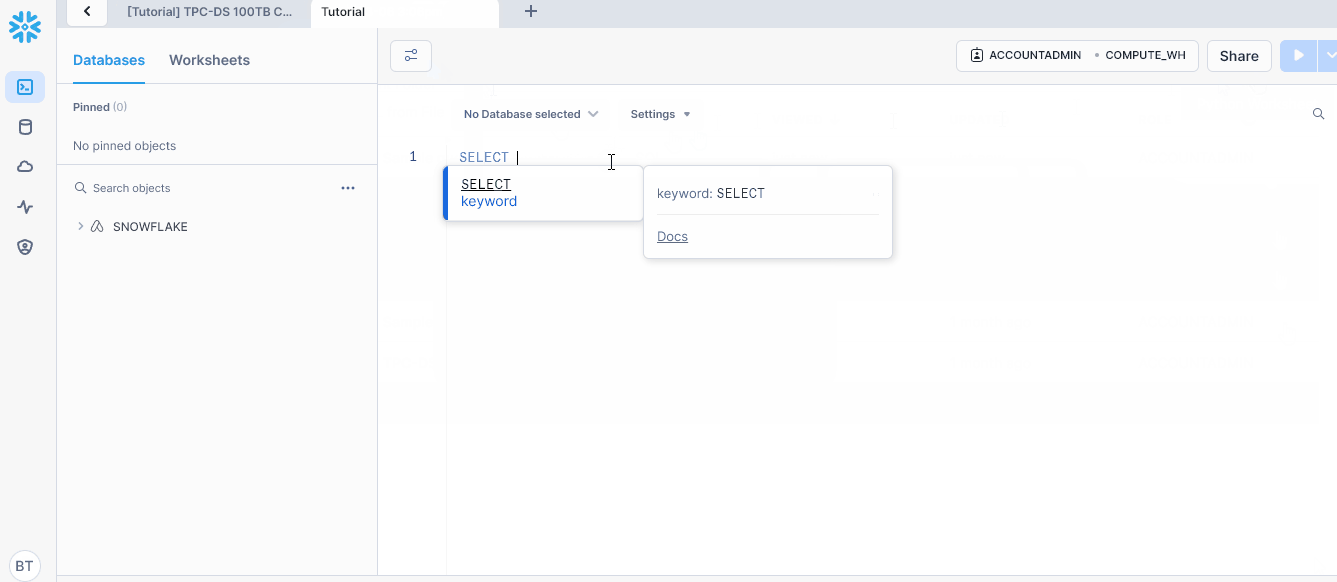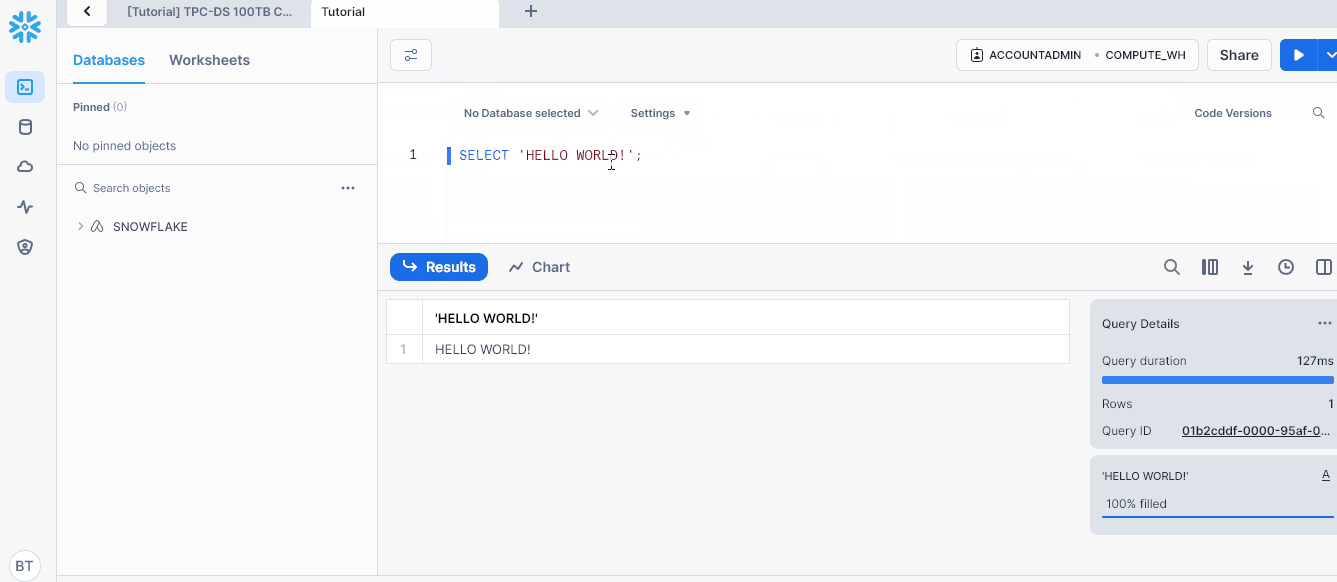
Em seguida, vamos criar alguns bancos de dados e tabelas e preenchê-los com dados.
Primeiro, vamos criar um banco de dados chamado ecommerce_db. Cole o código abaixo e pressione "Ctrl + Enter" (Cmd + Enter) para executar ("Ctrl + Shift + Enter" executa todas as instruções da worksheet).
CREATE DATABASE IF NOT EXISTS ecommerce_db;
Usaremos esse banco hipotético para vender produtos relacionados a IA. Execute o comando abaixo para defini-lo como padrão:
USE DATABASE ecommerce_db;
Agora, vamos criar uma tabela chamada inventory com três colunas:
CREATE OR REPLACE TABLE inventory (
 product_id INT PRIMARY KEY,
 name VARCHAR(255),
 stock_level INT,
 last_updated TIMESTAMP_TZ DEFAULT CURRENT_TIMESTAMP
);
Depois, vamos inserir alguns produtos iniciais:
INSERT INTO inventory (product_id, name, stock_level)
VALUES (1, Llama hoodie', 10), (2, Falcon cap', 20);
Também vamos criar uma tabela para pedidos:
CREATE OR REPLACE TABLE orders (
 order_id INT PRIMARY KEY,
 product_id INT REFERENCES inventory(product_id),
 quantity INT,
 order_date TIMESTAMP_TZ DEFAULT CURRENT_TIMESTAMP
);
-- Assume some time passes after this table was created
Depois de publicar um site para vender nossos produtos, recebemos alguns pedidos. Pela manhã, chegam dois pedidos para ambos os produtos:
INSERT INTO orders (order_id, product_id, quantity)
VALUES (1, 1, 5), (1, 2, 3);
À tarde, recebemos outro:
-- Simulate a system glitch causing an extra order for product 1
INSERT INTO orders (order_id, (product_id, quantity)
VALUES  (3, 1, 100);  -- This might cause negative stock
Mas, por causa de uma falha no sistema, o pedido foi registrado com uma quantidade maior do que temos em estoque. Vamos fingir que só percebemos isso duas semanas depois.
Obs.: fiz algumas outras atualizações nas tabelas nos bastidores.
Nossa primeira tarefa é definir um período de retenção. Meu teste gratuito terminou, então só posso configurá-lo para um dia:
ALTER TABLE inventory SET DATA_RETENTION_TIME_IN_DAYS=1;
ALTER TABLE orders SET DATA_RETENTION_TIME_IN_DAYS=1;
Se o seu ainda estiver ativo, tente definir para quatro semanas, já que o teste expira depois desse período.
AT e BEFOREO Snowflake implementa o Time Travel com estas extensões de SQL:
AT e BEFORE para usar em instruções SELECT e apontar o instante (ou período) exato no tempo que você quer consultar. Elas aceitam estes parâmetros:TIMESTAMPOFFSET - diferença de tempo em segundos em relação ao agoraSTATEMENT - ID único da consultaUNDROP para restaurar tabelas, schemas e bancos de dadosVamos ver como usar essas extensões no nosso banco de exemplo.
Primeiro, vamos ver o que temos em inventory:
-- Check current stock level (might show negative value)
SELECT * FROM inventory;
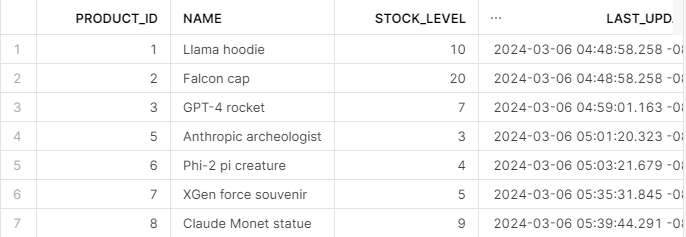
Agora, vamos combinar os pedidos com o inventário:
SELECT i.name, i.stock_level, o.quantity as "order_amount"
 FROM inventory as i
 JOIN orders as o
   ON i.product_id = o.product_id;
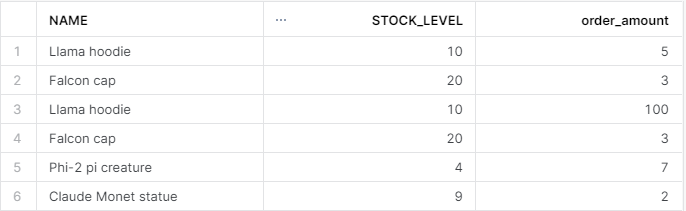
Ih! Parece que há um erro — a quantidade de pedidos do Llama hoodie é maior do que temos. Vamos voltar 17,5 horas para identificar o momento exato em que a instrução incorreta foi executada:
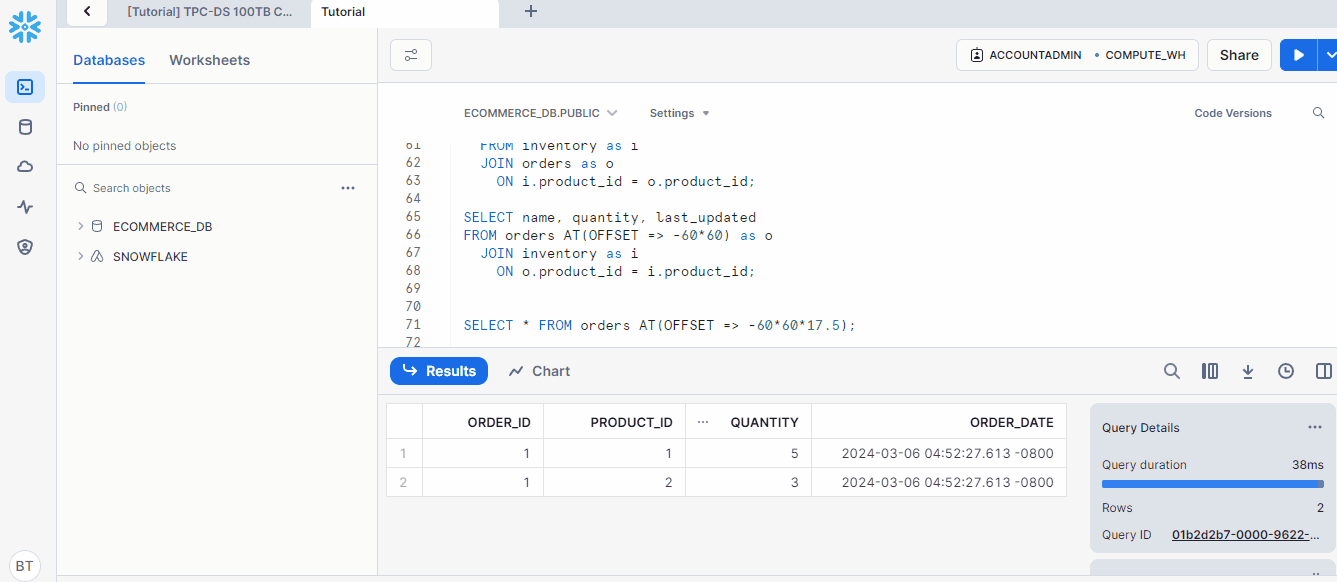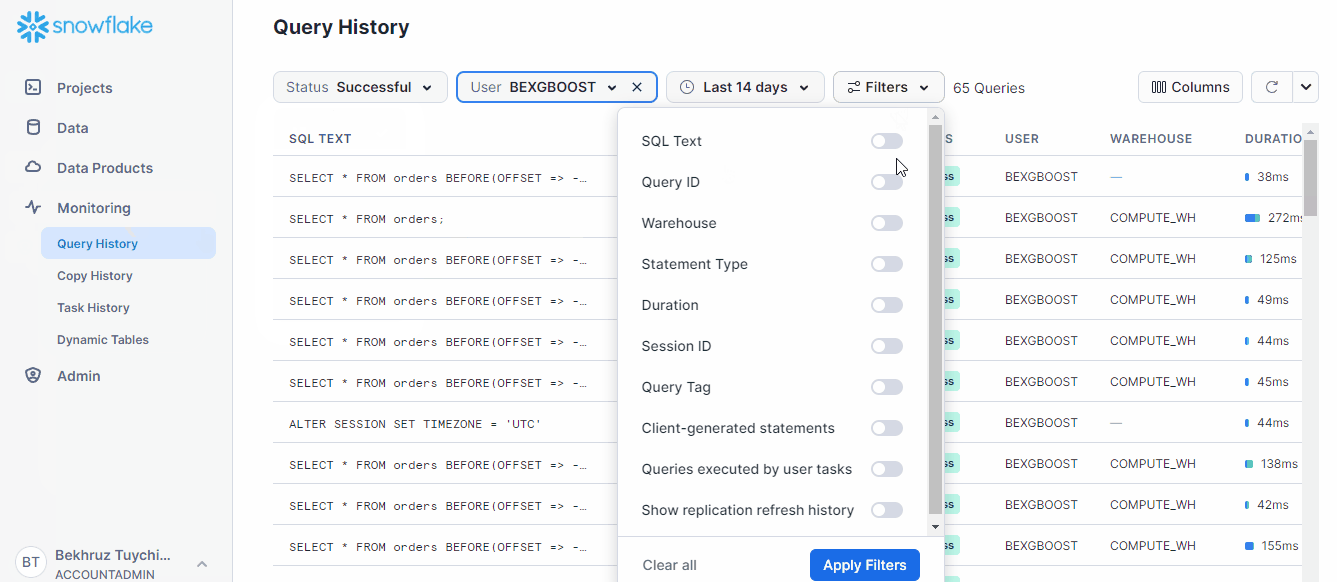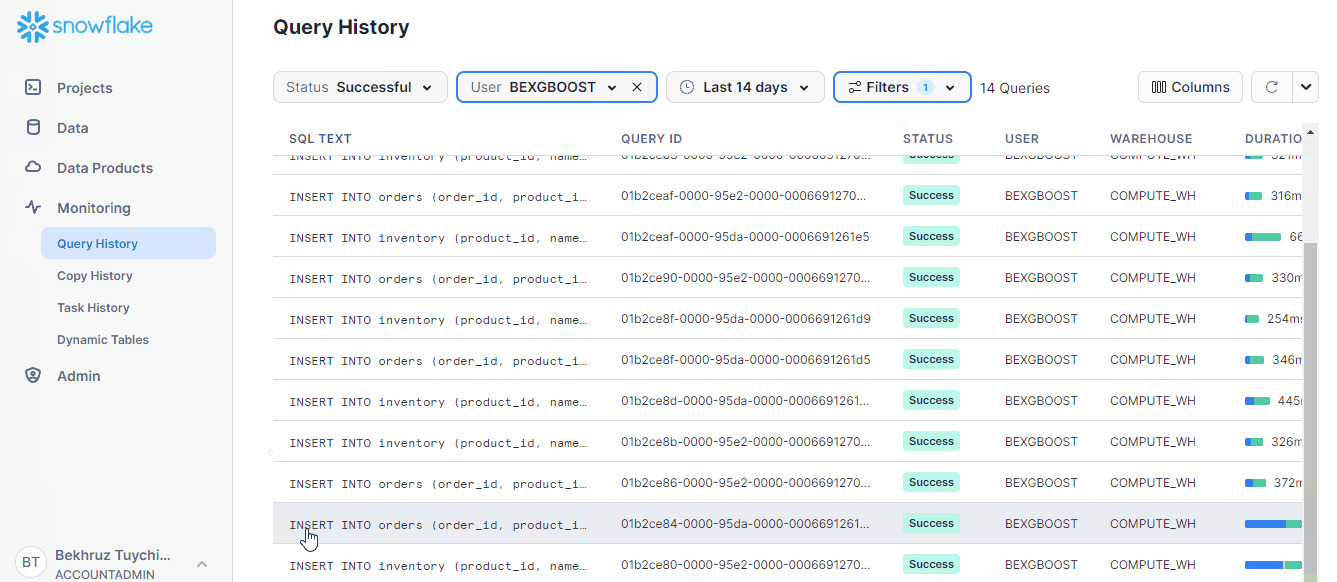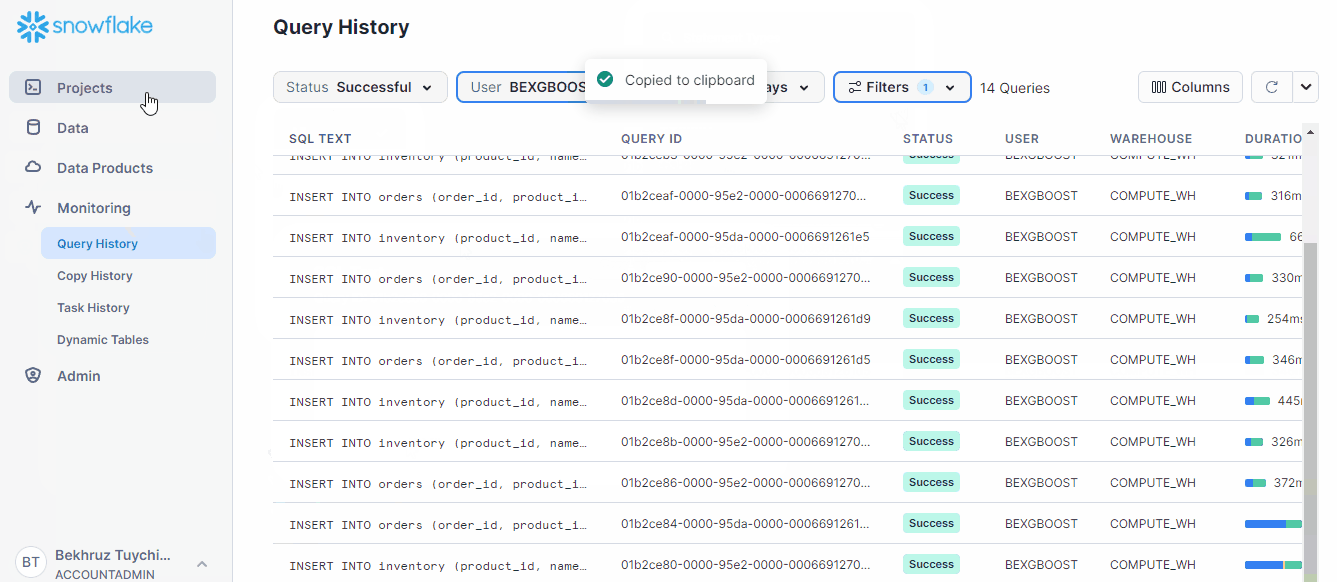
SELECT * FROM orders AT(OFFSET => -60*60*17.5); -- Go back 17.5
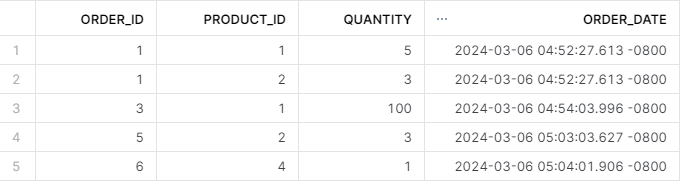
Então, o pedido incorreto foi feito às 16h54 do dia 6 de março. Isso significa que precisamos do estado da tabela antes desse horário. É fácil consultar isso com a cláusula BEFORE:
-- Change the timezone
ALTER SESSION  SET TIMEZONE = 'UTC';

-- Select the table state before the error
SELECT * FROM orders BEFORE(TIMESTAMP => '2024-03-06 04:54:00 -0800'::timestamp_tz);
Não esqueça de usar timestamp_tz como tipo de dado do carimbo de tempo. tz significa fuso horário.
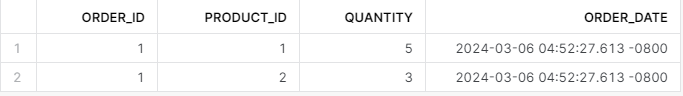
Esses exemplos mostram como usar as cláusulas AT e BEFORE com timestamps e offsets. Se você não quiser ter que descobrir o horário das consultas, pode usar os IDs das instruções.
Por exemplo, a consulta abaixo executa a mesma tarefa da última — consultar o estado da tabela antes do pedido incorreto:
SELECT * FROM orders BEFORE(STATEMENT => '01b2ce86-0000-95e2-0000-000669127035');Veja como encontrar o ID de qualquer consulta:
Filtrando pelo tipo de consulta, você encontra o que procura muito mais rápido no SnowSight.
Temos um pedido incorreto na tabela — como nos livramos dele?
Uma alternativa é clonar a tabela sem a linha incorreta:
CREATE OR REPLACE TABLE orders_clone AS
SELECT * FROM orders WHERE quantity != 100;

SELECT * FROM orders_clone;
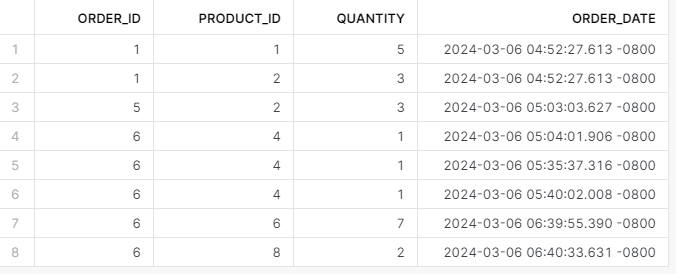
Funcionou — e nem precisamos do Time Travel para corrigir o problema. Mas, quando for necessário clonar estados passados de uma tabela, use esta sintaxe:
-- Clone an object as it existed 2 days ago
CREATE TABLE old_table_clone CLONE olt_table
   AT(OFFSET => -2 * 24 * 60 * 60);  -- Offset for 2 days
Clonar bancos de dados é similar:
CREATE DATABASE cloned_db CLONE my_db
 BEFORE(STATEMENT => '8e5d0ca9-005e-44e6-b858-a8f5b37c5726');
Suponha que acabamos de contratar um estagiário e passamos a ele o problema do pedido incorreto.
Ao tentar remover o registro, o estagiário, sem querer, exclui a tabela de pedidos em produção:
-- Simulate accidentally dropping the orders table
DROP TABLE orders

SELECT * FROM orders;;
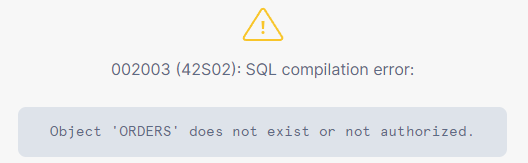
O estagiário vem falar com a gente, desesperado, e conta o que fez. Aí, nós calmamente executamos o comando UNDROP:
-- Recover the dropped table using UNDROP
UNDROP TABLE orders

SELECT * FROM orders;;
E recuperamos a tabela. Também perdoamos o estagiário e (claro) decidimos não demiti-lo por esse erro.
Neste tutorial, vimos um recurso essencial do Snowflake — o Time Travel. Com ele, você pode consultar e restaurar informações do passado, algo muito valorizado em ferramentas de gerenciamento de bancos de dados.
Tudo pode acontecer em produção, e ter um backup do seu banco antes de cada atualização traz tranquilidade.
Eu considero o Snowflake a melhor ferramenta de gerenciamento de bancos de dados disponível. É uma plataforma robusta, e dominá-la é uma habilidade muito desejada em carreiras de dados. Se quiser se aprofundar, confira o curso Introduction to Snowflake na DataCamp.
Se você já está à vontade com a ferramenta e quer testar suas habilidades, veja as melhores certificações Snowflake disponíveis em 2024.
Comece sua jornada no Snowflake hoje!
Curso
Curso
Programa
blog
Matt Crabtree
11 min
blog
Nisha Arya Ahmed
15 min
Tutorial
Javier Canales Luna
15 min
Tutorial
DataCamp Team
3 min
Tutorial
Kevin Babitz
13 min
Tutorial
Kafaru Simileoluwa
12 min