
Kurs
Einführung in Snowflake SQL
2 Std.
55.8K
So wie Softwareentwickler Git zur Versionsverwaltung nutzen, haben Data Engineers in Snowflake-Datenbanken Time Travel. Mit Time Travel können Datenbank-Admins historische Daten abfragen, alte Tabellen klonen und gelöschte Objekte wiederherstellen.
Angesichts der teils enormen Datenbankgrößen ist Time Travel jedoch kein 1:1-Ersatz für Code-Versionskontrolle. Jedes Mal, wenn eine Tabelle geändert wird (Löschen oder Aktualisieren), erstellt Snowflake einen Snapshot des vorherigen Zustands der Daten. Dieser Snapshot bleibt nur für eine bestimmte Anzahl von Tagen erhalten – die sogenannte Datenaufbewahrungsfrist.
Bei Snowflake Standard-Konten beträgt die maximale Aufbewahrungsfrist nur einen Tag. Bei Enterprise-Konten kann sie zwischen 0 und 90 Tagen liegen. Eine Aufbewahrungsfrist von 0 deaktiviert Time Travel faktisch; standardmäßig ist Time Travel für alle Tabellen aktiviert.
In den Snowflake-Dokumenten stößt du auch auf den Begriff „Fail-safe“. Vom Namen her klingen Time Travel und Fail-safe ähnlich – sie erfüllen aber unterschiedliche Aufgaben.
Wenn die Aufbewahrungsfrist eines Objekts endet, wird es in den Snowflake Fail-safe verschoben. Im Fail-safe kannst du Folgendes nicht:
Fail-safe bewahrt Daten für einen nicht konfigurierbaren Zeitraum von 7 Tagen auf. In diesem Zeitraum kann nur Snowflake selbst die Daten wiederherstellen. Diese Funktion dient als Notfall-Wiederherstellungsservice und ist nur als letzter Ausweg gedacht, wenn alle anderen Methoden scheitern – etwa bei Beschädigung oder Löschung durch Betriebsfehler.
Du kannst Snowflake also nicht bitten, vergangene Versionen deiner Objekte wiederherzustellen, wenn die Aufbewahrungsfrist regulär abgelaufen ist. Behalte diese Regel im Hinterkopf, während du diesem Tutorial folgst.
Snowflake bietet zwei Oberflächen zur Interaktion mit der Plattform: SnowSight (die Web-UI) und die Snowflake CLI (Terminal-Client). Wir arbeiten hier mit SnowSight, da es schneller startklar ist. Wenn du neu bei Snowflake bist, lies dieses ausführliche Tutorial. Es behandelt auch die Nutzung der Snowflake CLI.
Erstelle zuerst ein kostenloses Konto über die Snowflake-Homepage. Dort erhältst du 30 Tage lang Zugriff auf Enterprise-Funktionen.
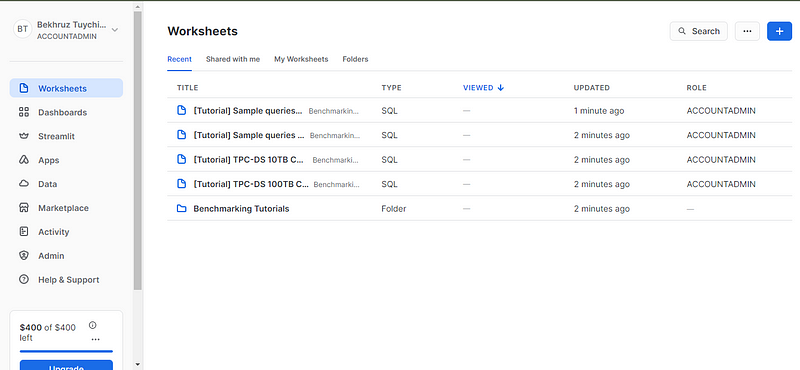
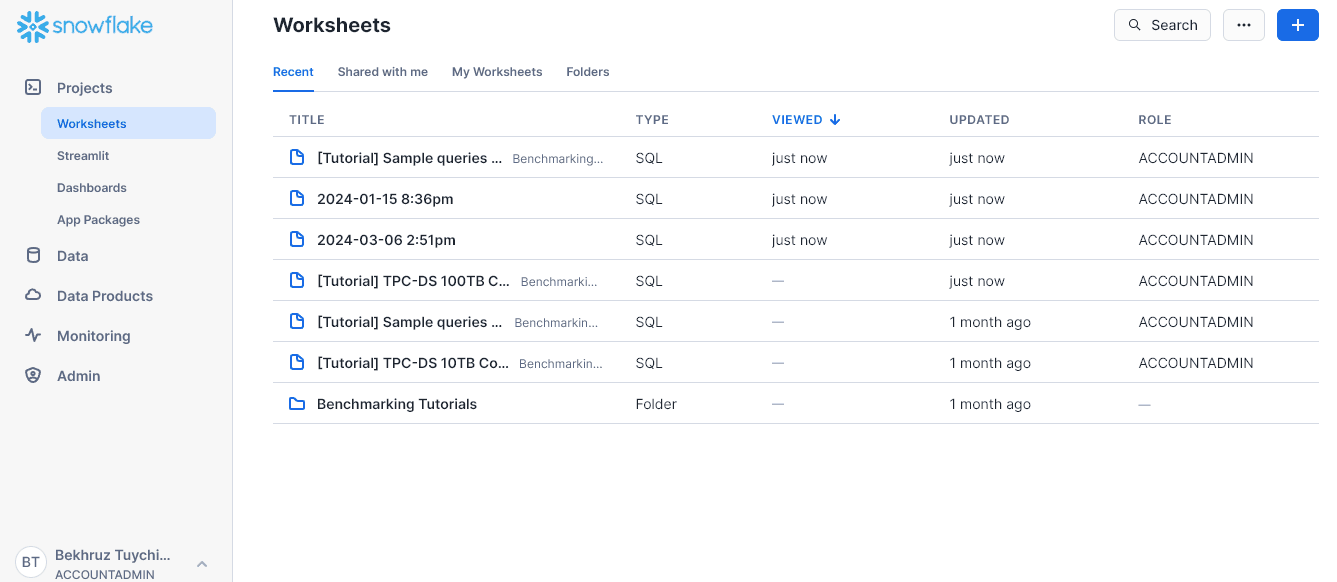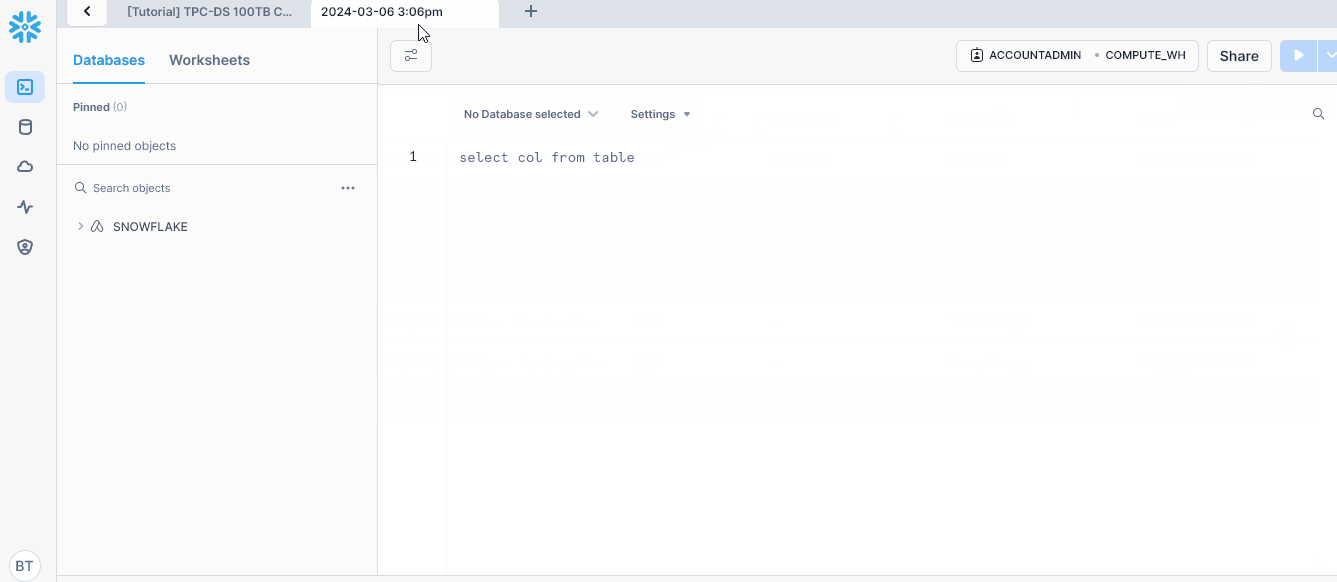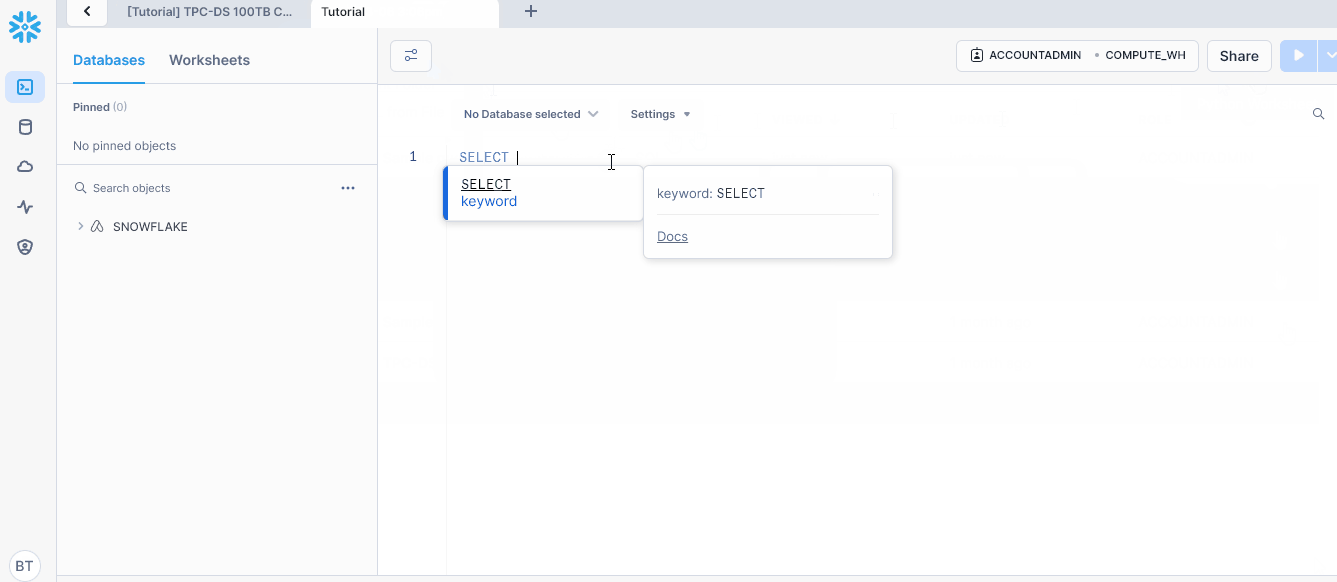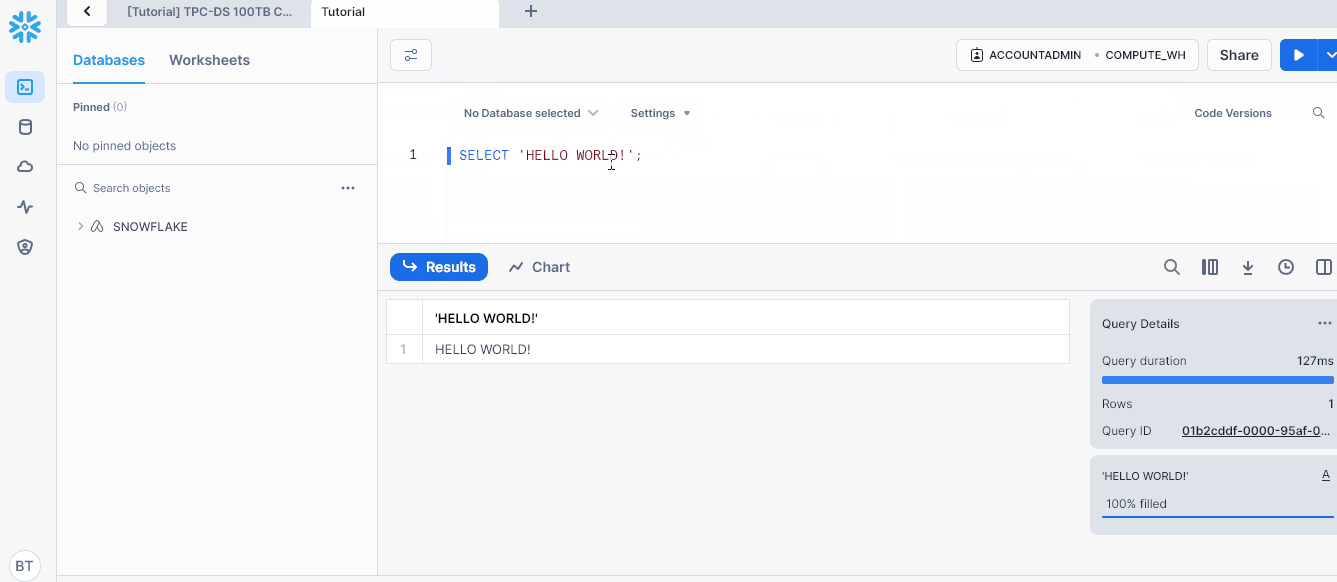
Sobald dein Konto bereit ist, landest du auf der Worksheets-Seite deines Dashboards. Du kannst dir jedes Worksheet als eigene Umgebung vorstellen, in der du SQL oder sogar Python ausführst.
Erstelle jetzt über die „+“-Schaltfläche oben rechts ein neues Worksheet:
Als Nächstes legen wir Datenbanken und Tabellen an und füllen sie mit Daten.
Zuerst erstellen wir eine Datenbank namens ecommerce_db. Füge den folgenden Code ein und drücke "Ctrl + Enter" (Cmd + Enter), um ihn auszuführen ("Ctrl + Shift + Enter" führt alle Anweisungen im Worksheet aus).
CREATE DATABASE IF NOT EXISTS ecommerce_db;
Diese hypothetische Datenbank nutzen wir, um KI-bezogene Merch-Artikel zu verkaufen. Setze sie mit dem folgenden Befehl als Standard:
USE DATABASE ecommerce_db;
Als Erstes erstellen wir eine Tabelle namens inventory mit drei Spalten:
CREATE OR REPLACE TABLE inventory (
 product_id INT PRIMARY KEY,
 name VARCHAR(255),
 stock_level INT,
 last_updated TIMESTAMP_TZ DEFAULT CURRENT_TIMESTAMP
);
Dann fügen wir ein paar Startprodukte hinzu:
INSERT INTO inventory (product_id, name, stock_level)
VALUES (1, Llama hoodie', 10), (2, Falcon cap', 20);
Außerdem erstellen wir eine Tabelle für Bestellungen:
CREATE OR REPLACE TABLE orders (
 order_id INT PRIMARY KEY,
 product_id INT REFERENCES inventory(product_id),
 quantity INT,
 order_date TIMESTAMP_TZ DEFAULT CURRENT_TIMESTAMP
);
-- Assume some time passes after this table was created
Nachdem wir eine Website für unseren Merch gestartet haben, gehen Bestellungen ein. Am Morgen kommen zwei Bestellungen für beide Produkte rein:
INSERT INTO orders (order_id, product_id, quantity)
VALUES (1, 1, 5), (1, 2, 3);
Am Nachmittag folgt eine weitere:
-- Simulate a system glitch causing an extra order for product 1
INSERT INTO orders (order_id, (product_id, quantity)
VALUES  (3, 1, 100);  -- This might cause negative stock
Durch einen Systemfehler wird jedoch eine Menge bestellt, die unseren Bestand übersteigt. Nehmen wir an, wir merken das erst nach zwei Wochen.
Hinweis: Ich habe im Hintergrund noch einige weitere Änderungen an Tabellen vorgenommen.
Unsere erste Aufgabe ist das Setzen einer Aufbewahrungsfrist. Meine Testphase ist abgelaufen, daher kann ich nur einen Tag festlegen:
ALTER TABLE inventory SET DATA_RETENTION_TIME_IN_DAYS=1;
ALTER TABLE orders SET DATA_RETENTION_TIME_IN_DAYS=1;
Wenn deine Testphase noch läuft, setze sie gerne auf vier Wochen – so lange läuft dein Trial ohnehin.
AT- und BEFORE-KlauselnSnowflake implementiert Time Travel über diese SQL-Erweiterungen:
AT- und BEFORE-Klauseln in SELECT-Abfragen, um den exakten Zeitpunkt (oder Zeitraum) der Abfrage festzulegen. Sie unterstützen folgende Parameter:TIMESTAMPOFFSET – Zeitdifferenz in Sekunden zur GegenwartSTATEMENT – eindeutige Query-IDUNDROP-Befehl zum Wiederherstellen von Tabellen, Schemas und DatenbankenSchauen wir uns an, wie wir diese Erweiterungen auf unserer Beispieldatenbank nutzen.
Prüfen wir zunächst den Inhalt von inventory:
-- Check current stock level (might show negative value)
SELECT * FROM inventory;
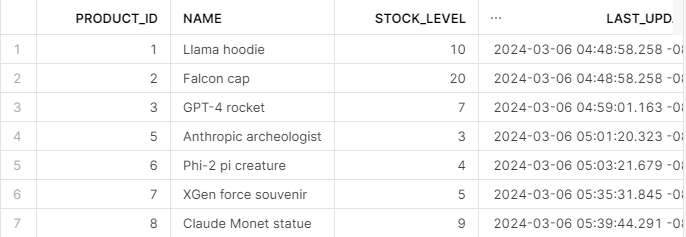
Jetzt kombinieren wir Bestellungen und Bestand:
SELECT i.name, i.stock_level, o.quantity as "order_amount"
 FROM inventory as i
 JOIN orders as o
   ON i.product_id = o.product_id;
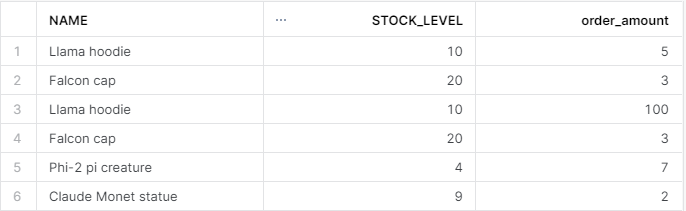
Uff! Offenbar stimmt etwas nicht – die Bestellmenge des Llama-Hoodies übersteigt unseren Bestand. Gehen wir 17,5 Stunden zurück, um den genauen Zeitpunkt der fehlerhaften Anweisung zu finden:
SELECT * FROM orders AT(OFFSET => -60*60*17.5); -- Go back 17.5
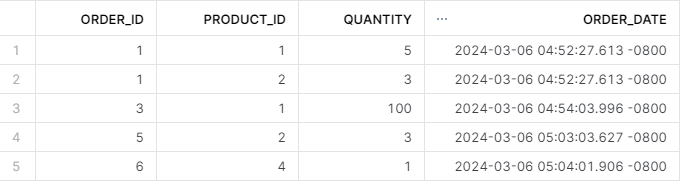
Die fehlerhafte Bestellung wurde also am 6. März um 16:54 Uhr aufgegeben. Wir brauchen daher den Tabellenzustand vor diesem Zeitpunkt. Das lässt sich mit der BEFORE-Klausel leicht abfragen:
-- Change the timezone
ALTER SESSION  SET TIMEZONE = 'UTC';

-- Select the table state before the error
SELECT * FROM orders BEFORE(TIMESTAMP => '2024-03-06 04:54:00 -0800'::timestamp_tz);
Vergiss nicht, timestamp_tz als Datentyp für den Zeitstempel anzugeben. tz steht für Zeitzone.
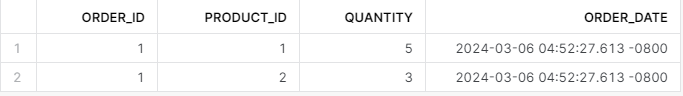
Diese Beispiele zeigen, wie du AT- und BEFORE-Klauseln mit Timestamps und Offsets verwendest. Wenn du die exakte Zeit nicht herleiten möchtest, kannst du auch Statement-IDs nutzen.
Das folgende Beispiel erzielt denselben Effekt wie die letzte Abfrage – es fragt den Tabellenzustand vor der fehlerhaften Bestellung ab:
SELECT * FROM orders BEFORE(STATEMENT => '01b2ce86-0000-95e2-0000-000669127035');So findest du die Query-ID einer beliebigen Anweisung:
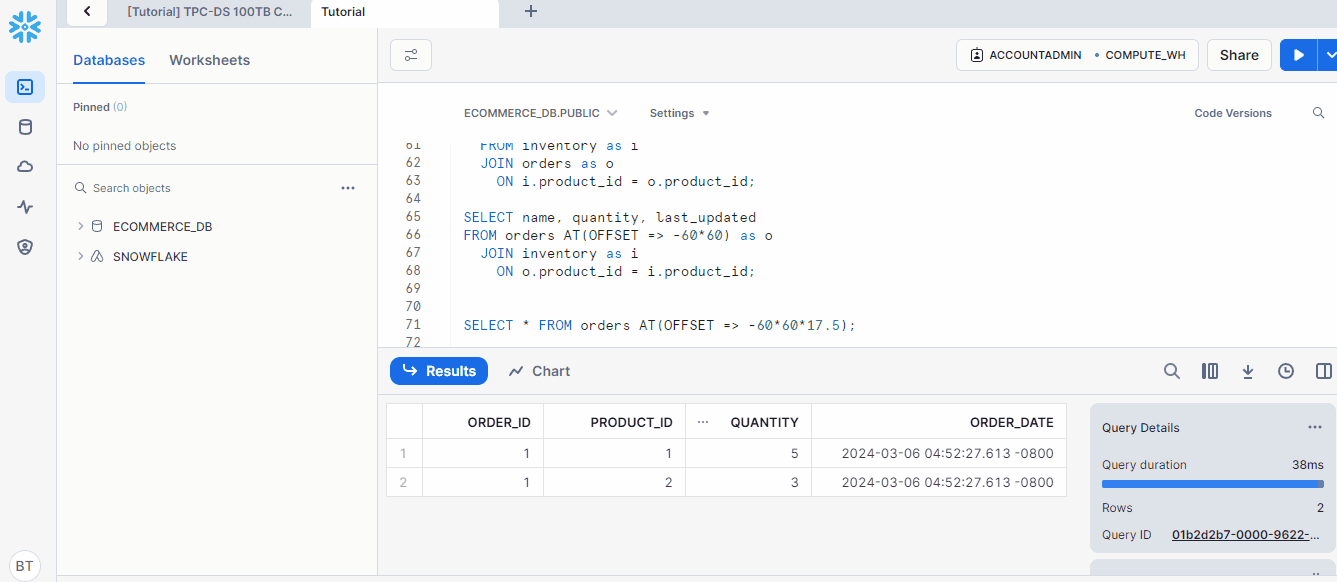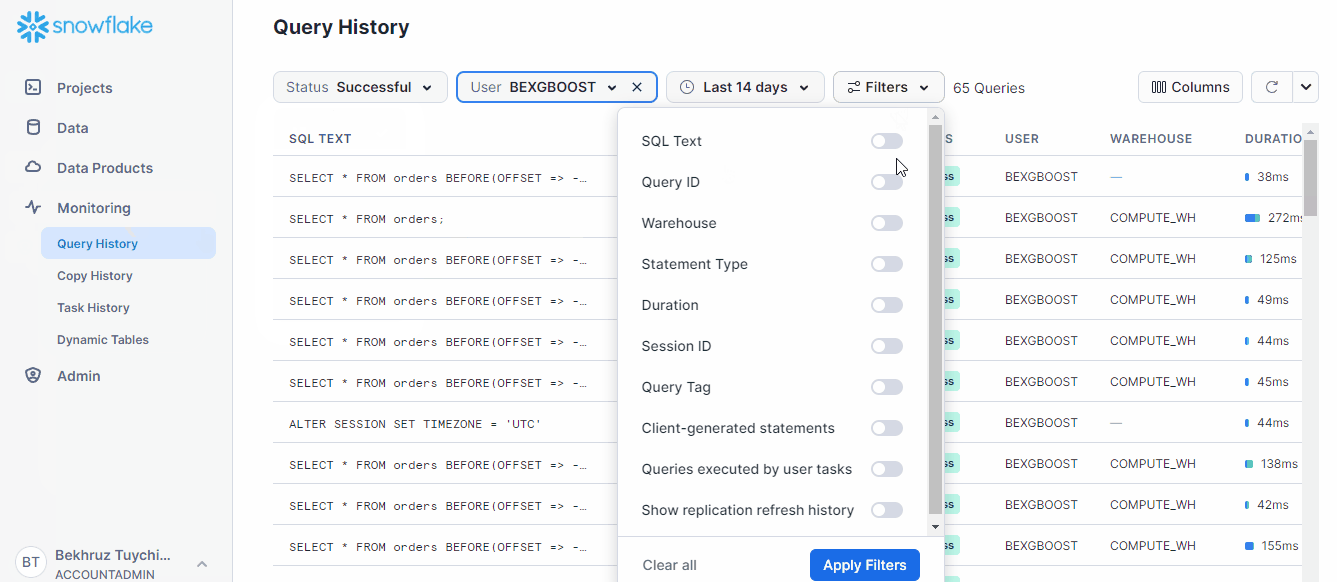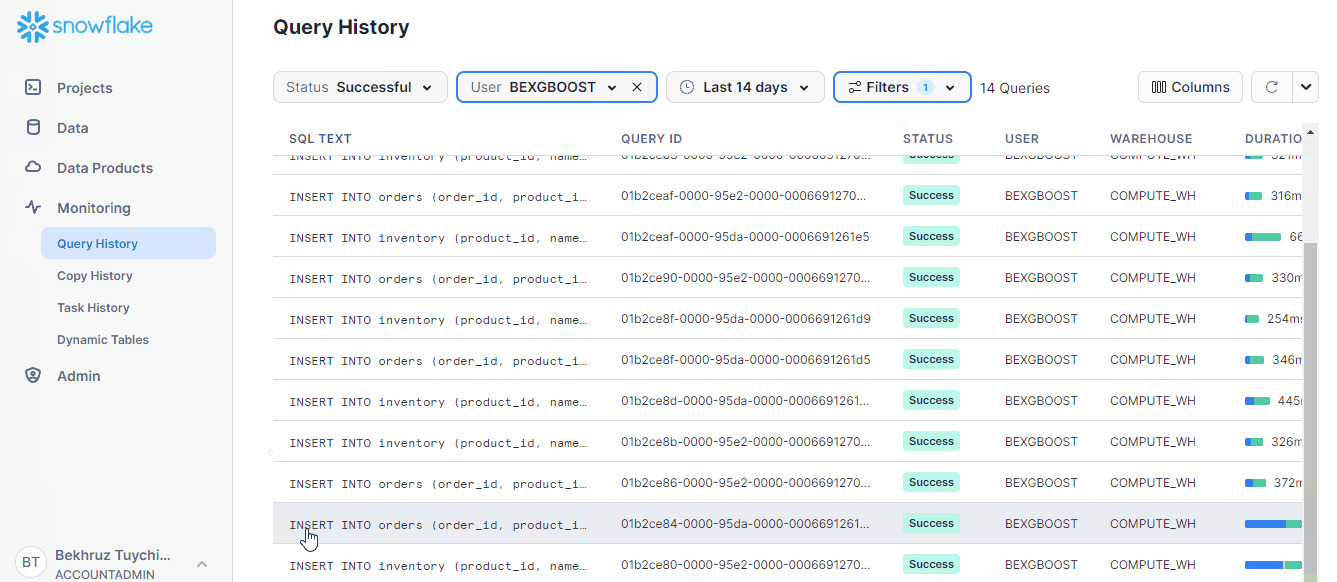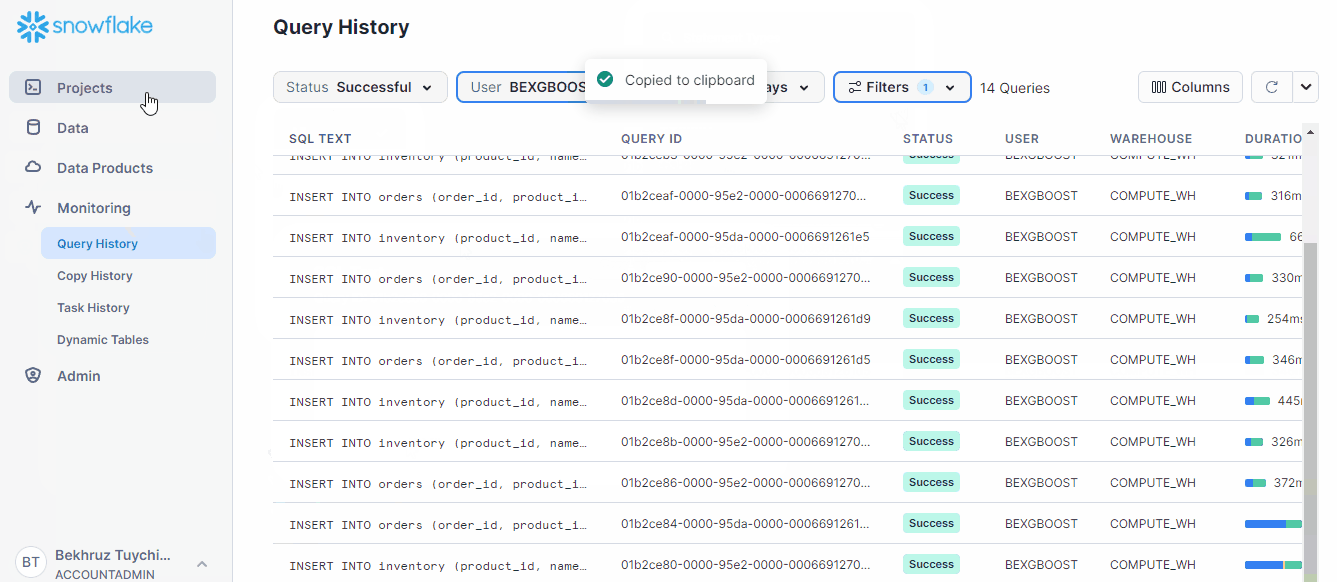
Indem du in SnowSight nach Abfragetypen filterst, findest du die gesuchte Query deutlich schneller.
Wir haben also eine fehlerhafte Bestellung in unserer Tabelle – wie werden wir sie los?
Eine Möglichkeit ist, die Tabelle ohne die fehlerhafte Zeile zu klonen:
CREATE OR REPLACE TABLE orders_clone AS
SELECT * FROM orders WHERE quantity != 100;

SELECT * FROM orders_clone;
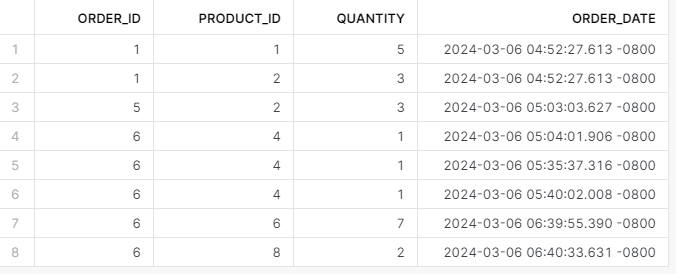
Das hat funktioniert, ganz ohne Time Travel. Wenn du jedoch vergangene Zustände einer Tabelle klonen musst, kannst du folgende Syntax verwenden:
-- Clone an object as it existed 2 days ago
CREATE TABLE old_table_clone CLONE olt_table
   AT(OFFSET => -2 * 24 * 60 * 60);  -- Offset for 2 days
Das Klonen von Datenbanken funktioniert analog:
CREATE DATABASE cloned_db CLONE my_db
 BEFORE(STATEMENT => '8e5d0ca9-005e-44e6-b858-a8f5b37c5726');
Angenommen, wir haben gerade eine:n Praktikant:in eingestellt und ihr:ihm die fehlerhafte Bestellung zur Bereinigung übergeben.
Beim Versuch, den fehlerhaften Datensatz zu entfernen, löscht die Person versehentlich die Orders-Tabelle in der Produktion:
-- Simulate accidentally dropping the orders table
DROP TABLE orders

SELECT * FROM orders;;
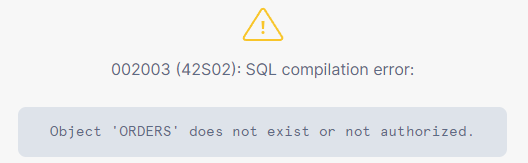
Die Praktikantin bzw. der Praktikant kommt völlig aufgelöst zu uns und schildert den Fehler. Wir führen ruhig den UNDROP-Befehl aus:
-- Recover the dropped table using UNDROP
UNDROP TABLE orders

SELECT * FROM orders;;
Und holen die Tabelle zurück. Wir verzeihen den Fehler und selbstverständlich wird niemand deswegen entlassen.
In diesem Tutorial haben wir eine zentrale Snowflake-Funktion kennengelernt: Time Travel. Damit kannst du vergangene Informationen abfragen und wiederherstellen – eine sehr gefragte Fähigkeit in Datenbank-Tools.
In Produktionsumgebungen kann alles passieren. Ein Backup deines Datenbestands vor jedem Update sorgt für deutlich mehr Ruhe.
Ich halte Snowflake für eines der stärksten Datenbank-Tools überhaupt. Es ist umfangreich, und es zu meistern, ist eine wertvolle Kompetenz in Datenjobs. Wenn du tiefer einsteigen willst, schau dir den Introduction to Snowflake-Kurs auf DataCamp an.
Wenn du bereits sicher damit umgehst und deine Kompetenzen testen möchtest, wirf einen Blick auf die besten Snowflake-Zertifizierungen 2024.
Starte jetzt deine Snowflake-Reise!
Kurs
Kurs
Lernpfad