
Cours
Introduction à Snowflake SQL
2 h
56.1K
Tout comme les ingénieurs logiciels utilisent Git pour le contrôle de version, les data engineers disposent de Time Travel dans les bases de données Snowflake. La fonctionnalité Time Travel permet aux administrateurs de bases de données d’interroger des données historiques, de cloner d’anciennes tables et de restaurer des objets supprimés par le passé.
Cependant, compte tenu de la taille potentiellement massive des bases de données, Time Travel n’est pas l’équivalent direct d’un contrôle de version de code. À chaque modification d’une table (suppression ou mise à jour), Snowflake capture un instantané de l’état des données avant l’opération. Cet instantané n’est conservé que pendant un nombre de jours défini, appelé la période de rétention des données.
Pour les comptes Snowflake Standard, la période maximale de rétention est limitée à un jour. Pour les comptes Enterprise, elle peut aller de 0 à 90 jours. Une période de rétention de 0 désactive effectivement Time Travel, qui est activé par défaut pour toutes les tables.
En consultant la documentation Snowflake, vous croiserez sans doute le terme « Fail-safe ». À l’intitulé, on pourrait croire que Time Travel et Fail-safe remplissent le même rôle, mais ce n’est pas le cas.
Lorsqu’un objet a dépassé sa période de rétention, il est déplacé dans Snowflake Fail-safe. Dans Fail-safe, vous ne pouvez pas :
Fail-safe conserve les données pendant 7 jours, sans possibilité de configuration. Durant cette période, seules les équipes Snowflake peuvent effectuer la restauration. Cette fonctionnalité est conçue comme un service de récupération des données en dernier recours, lorsque toutes les autres méthodes ont échoué — par exemple en cas de suppression ou de corruption dues à des incidents opérationnels.
En clair, vous ne pouvez pas demander à Snowflake de récupérer d’anciennes versions de vos objets une fois la période de rétention écoulée. Gardez bien cette règle à l’esprit en suivant ce tutoriel.
Snowflake propose deux interfaces pour interagir avec la plateforme : SnowSight (l’interface web) et Snowflake CLI (le client en ligne de commande). Nous utiliserons SnowSight, plus simple à prendre en main. Si vous débutez avec Snowflake, consultez ce tutoriel complet, qui couvre aussi l’utilisation de Snowflake CLI.
Commencez par créer un compte gratuit depuis la page d’accueil Snowflake. Vous pourrez accéder aux fonctionnalités Enterprise pendant un essai gratuit de 30 jours.
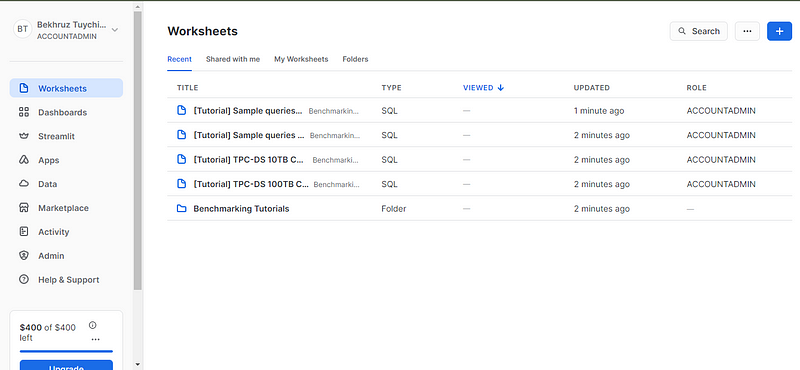
Une fois votre compte prêt, vous serez redirigé vers l’onglet Worksheets de votre tableau de bord. Considérez chaque worksheet comme un environnement distinct pour exécuter du SQL, voire du Python.
Créez maintenant un nouveau worksheet via le bouton « + » en haut à droite :
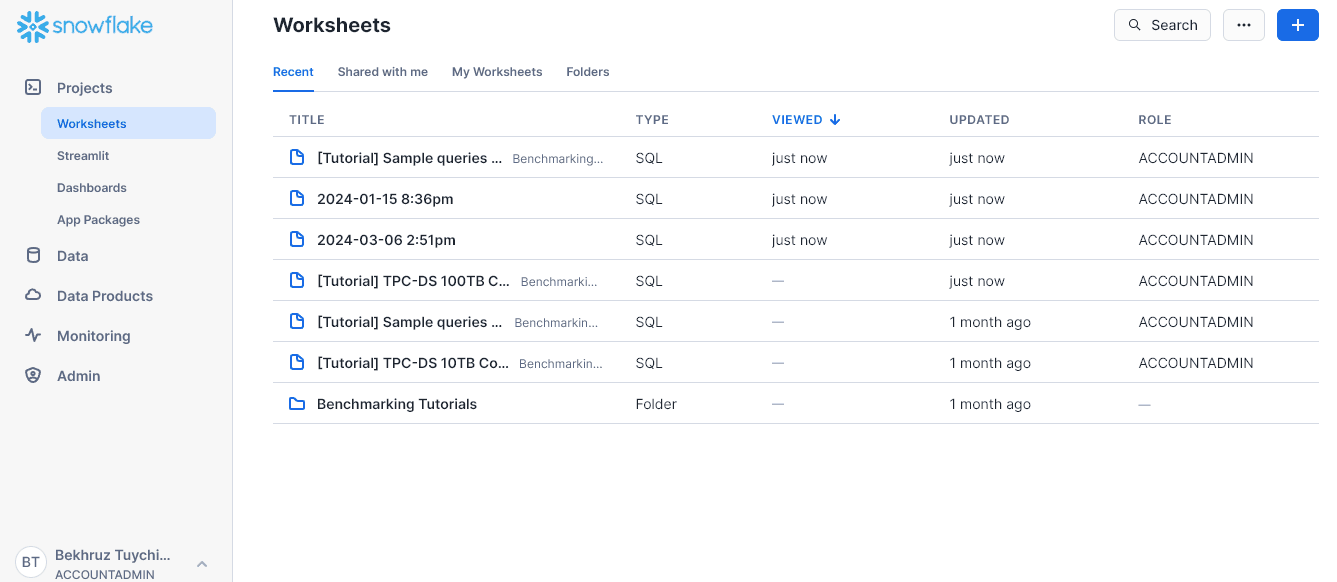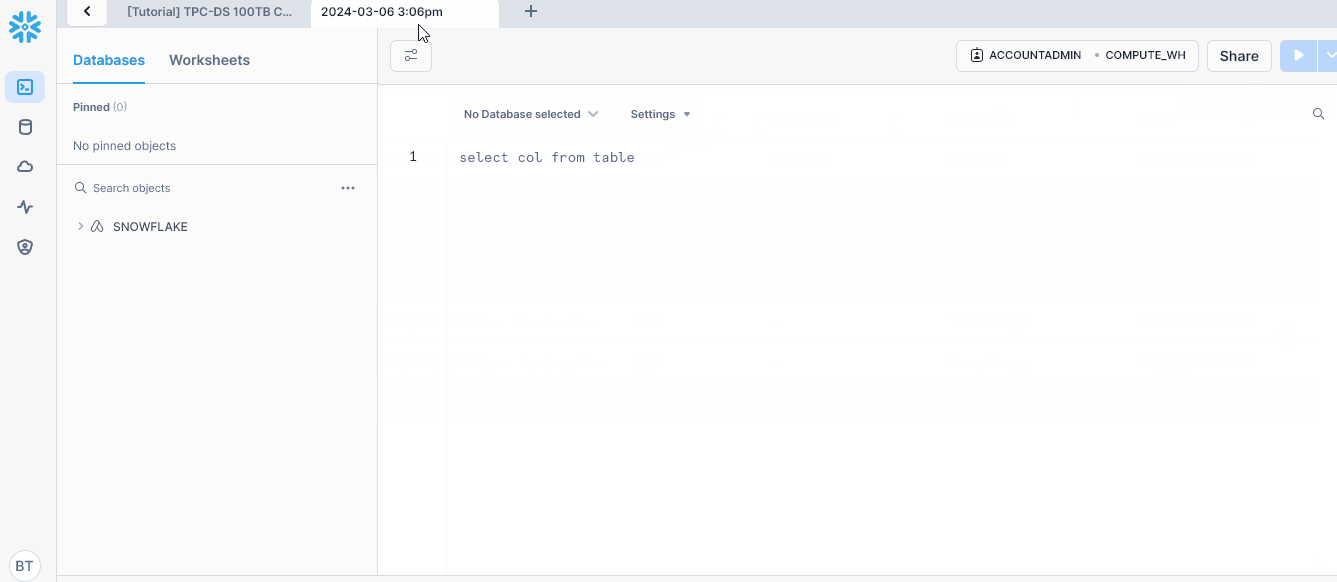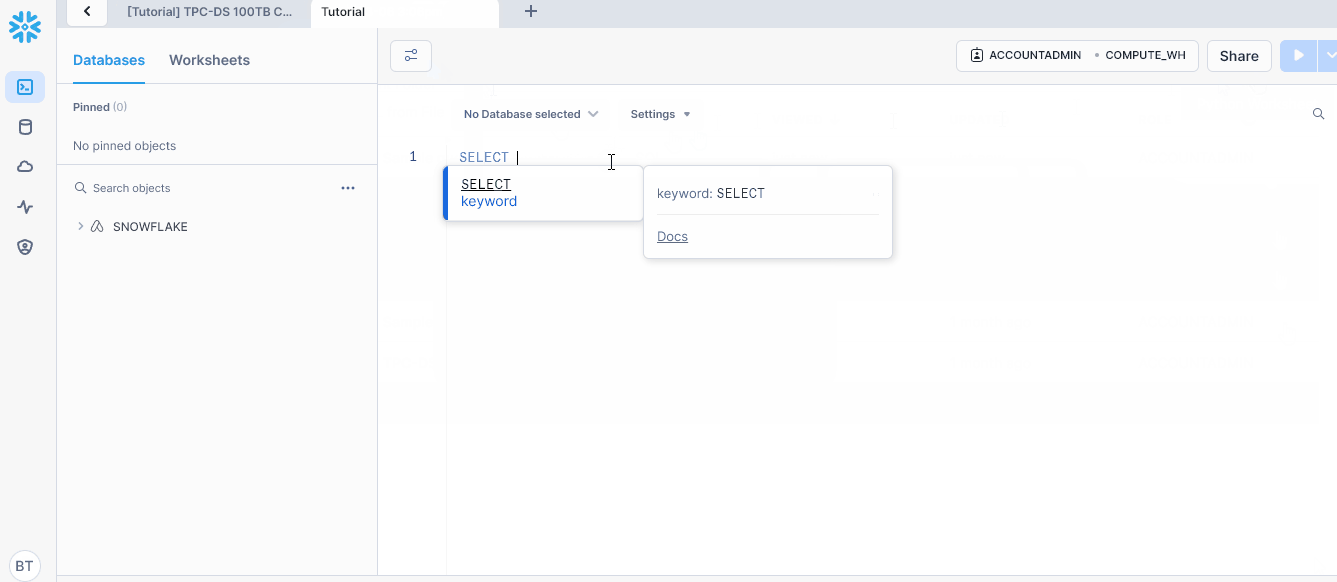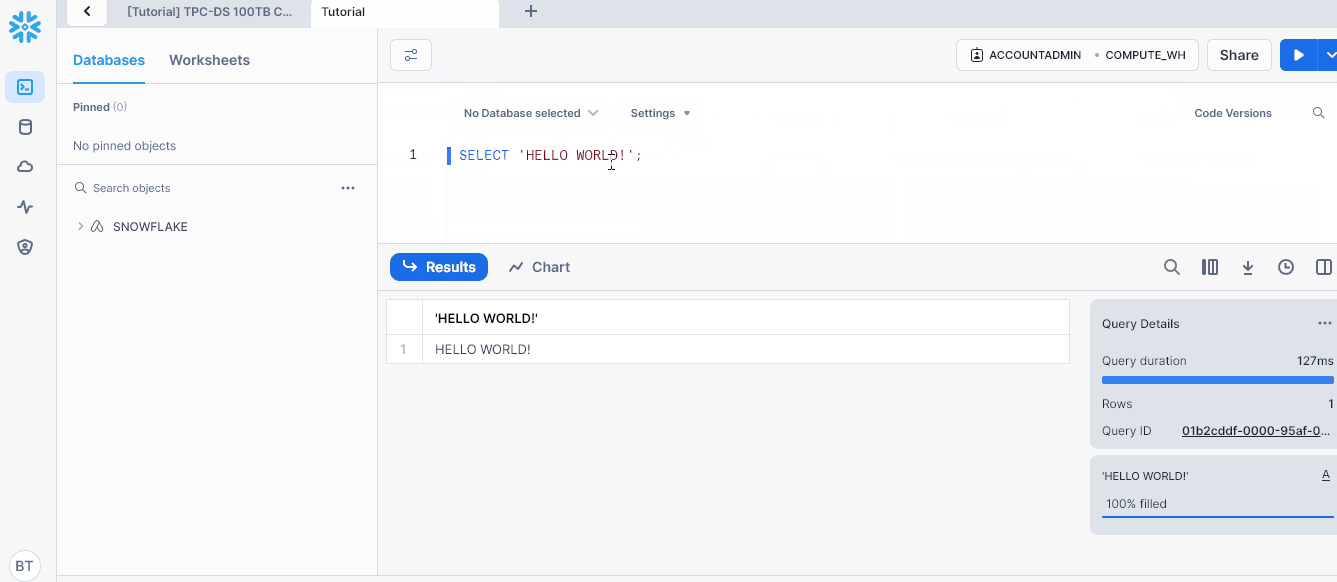
Ensuite, créons quelques bases et tables, puis alimentons-les avec des données.
Nous allons d’abord créer une base de données nommée ecommerce_db. Collez le code suivant et appuyez sur "Ctrl + Enter" (Cmd + Enter) pour l’exécuter ("Ctrl + Shift + Enter" exécute l’ensemble des instructions du worksheet).
CREATE DATABASE IF NOT EXISTS ecommerce_db;
Nous utiliserons cette base hypothétique pour vendre des articles liés à l’IA. Exécutez la commande ci-dessous pour la définir par défaut :
USE DATABASE ecommerce_db;
Commençons par créer une table nommée inventory avec trois colonnes :
CREATE OR REPLACE TABLE inventory (
 product_id INT PRIMARY KEY,
 name VARCHAR(255),
 stock_level INT,
 last_updated TIMESTAMP_TZ DEFAULT CURRENT_TIMESTAMP
);
Puis, ajoutons quelques produits de départ :
INSERT INTO inventory (product_id, name, stock_level)
VALUES (1, Llama hoodie', 10), (2, Falcon cap', 20);
Créons également une table pour les commandes :
CREATE OR REPLACE TABLE orders (
 order_id INT PRIMARY KEY,
 product_id INT REFERENCES inventory(product_id),
 quantity INT,
 order_date TIMESTAMP_TZ DEFAULT CURRENT_TIMESTAMP
);
-- Assume some time passes after this table was created
Après la mise en ligne de notre site e-commerce, nous recevons des commandes. Le matin, nous en enregistrons deux pour nos deux produits :
INSERT INTO orders (order_id, product_id, quantity)
VALUES (1, 1, 5), (1, 2, 3);
Dans l’après-midi, une autre arrive :
-- Simulate a system glitch causing an extra order for product 1
INSERT INTO orders (order_id, (product_id, quantity)
VALUES  (3, 1, 100);  -- This might cause negative stock
Mais à cause d’un bug, la commande enregistre une quantité supérieure à notre stock. Imaginons que nous ne nous en rendions compte qu’au bout de deux semaines.
Notez que j’ai réalisé quelques autres mises à jour de tables en coulisses.
Première étape : définir une période de rétention. Mon essai gratuit ayant expiré, je ne peux la fixer qu’à un jour :
ALTER TABLE inventory SET DATA_RETENTION_TIME_IN_DAYS=1;
ALTER TABLE orders SET DATA_RETENTION_TIME_IN_DAYS=1;
Si le vôtre est encore actif, essayez de la régler à quatre semaines, votre essai arrivant à échéance d’ici là.
AT et BEFORESnowflake implémente Time Travel via ces extensions SQL :
AT et BEFORE à utiliser dans les instructions SELECT pour cibler précisément le moment (ou la période) à interroger. Elles acceptent les paramètres suivants :TIMESTAMPOFFSET — décalage temporel en secondes par rapport à l’instant présentSTATEMENT — identifiant unique de requêteUNDROP pour restaurer des tables, schémas et basesVoyons comment utiliser ces extensions sur notre base d’exemple.
Commençons par observer le contenu de inventory :
-- Check current stock level (might show negative value)
SELECT * FROM inventory;
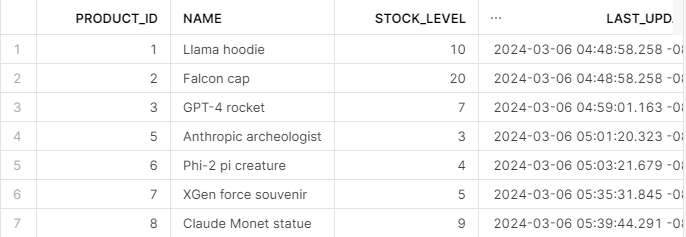
Maintenant, combinons les commandes et l’inventaire :
SELECT i.name, i.stock_level, o.quantity as "order_amount"
 FROM inventory as i
 JOIN orders as o
   ON i.product_id = o.product_id;
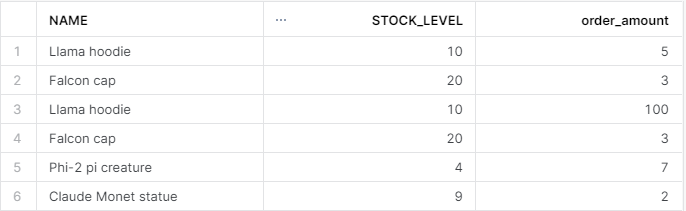
Aïe ! On voit une anomalie : le nombre de Llama hoodie commandés dépasse notre stock. Essayons de remonter 17,5 heures en arrière pour identifier le moment exact où l’instruction erronée a été exécutée :
SELECT * FROM orders AT(OFFSET => -60*60*17.5); -- Go back 17.5
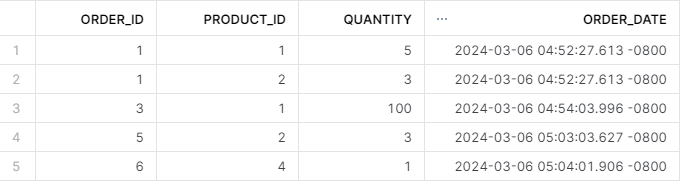
La commande incorrecte a donc été passée le 6 mars à 16h54. Nous avons besoin de l’état de la table avant cet instant. Cela se requête facilement avec la clause BEFORE :
-- Change the timezone
ALTER SESSION  SET TIMEZONE = 'UTC';

-- Select the table state before the error
SELECT * FROM orders BEFORE(TIMESTAMP => '2024-03-06 04:54:00 -0800'::timestamp_tz);
N’oubliez pas d’indiquer timestamp_tz comme type de données pour l’horodatage. tz signifie « fuseau horaire ».
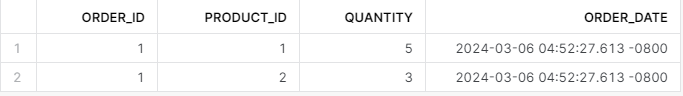
Ces exemples montrent comment utiliser les clauses AT et BEFORE avec des timestamps et des offsets. Si vous ne souhaitez pas déterminer le moment exact des requêtes, vous pouvez utiliser des IDs d’instruction.
Par exemple, la requête ci-dessous effectue la même opération que la précédente : interroger l’état de la table avant l’enregistrement de la commande incorrecte :
SELECT * FROM orders BEFORE(STATEMENT => '01b2ce86-0000-95e2-0000-000669127035');Voici comment retrouver l’ID de requête de n’importe quelle instruction :
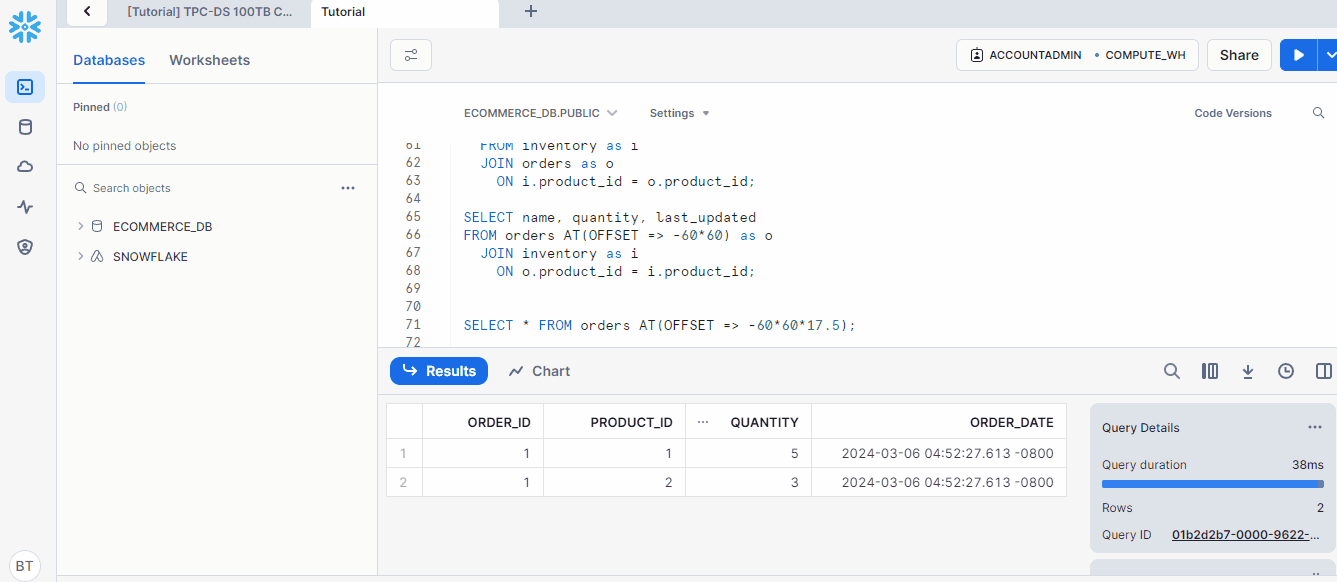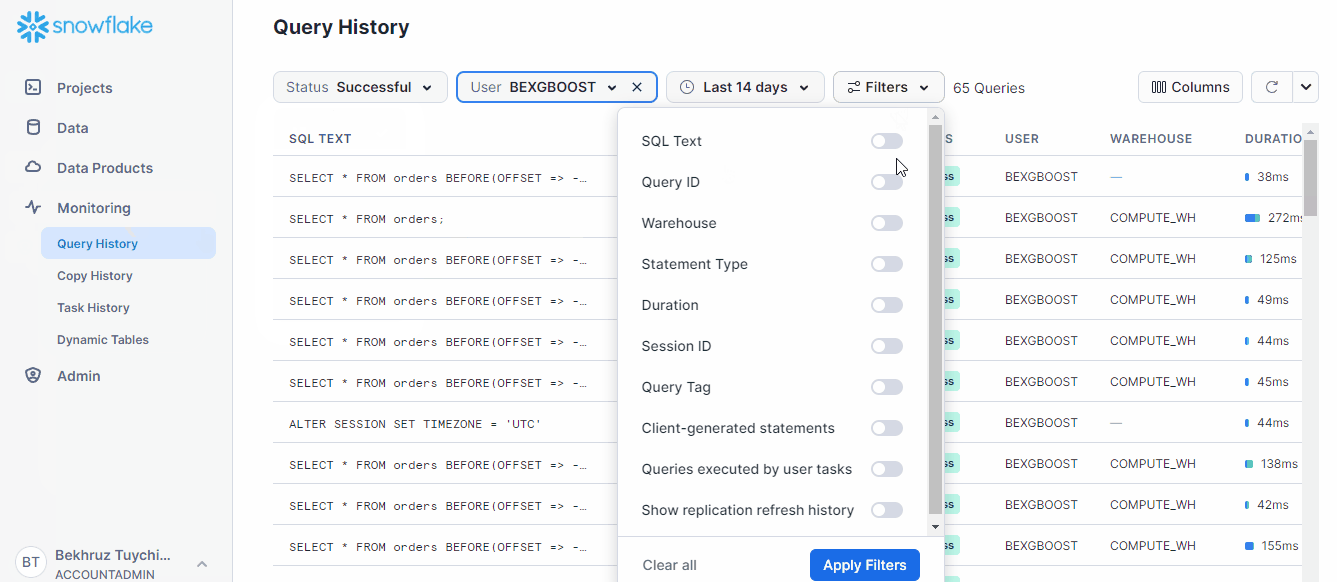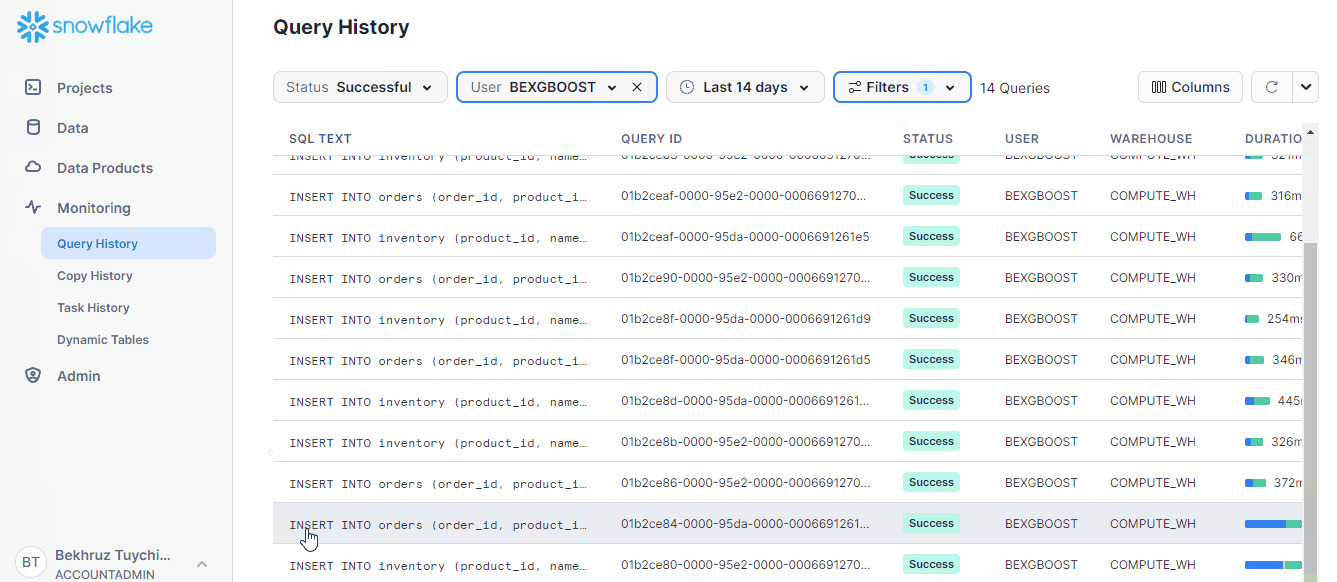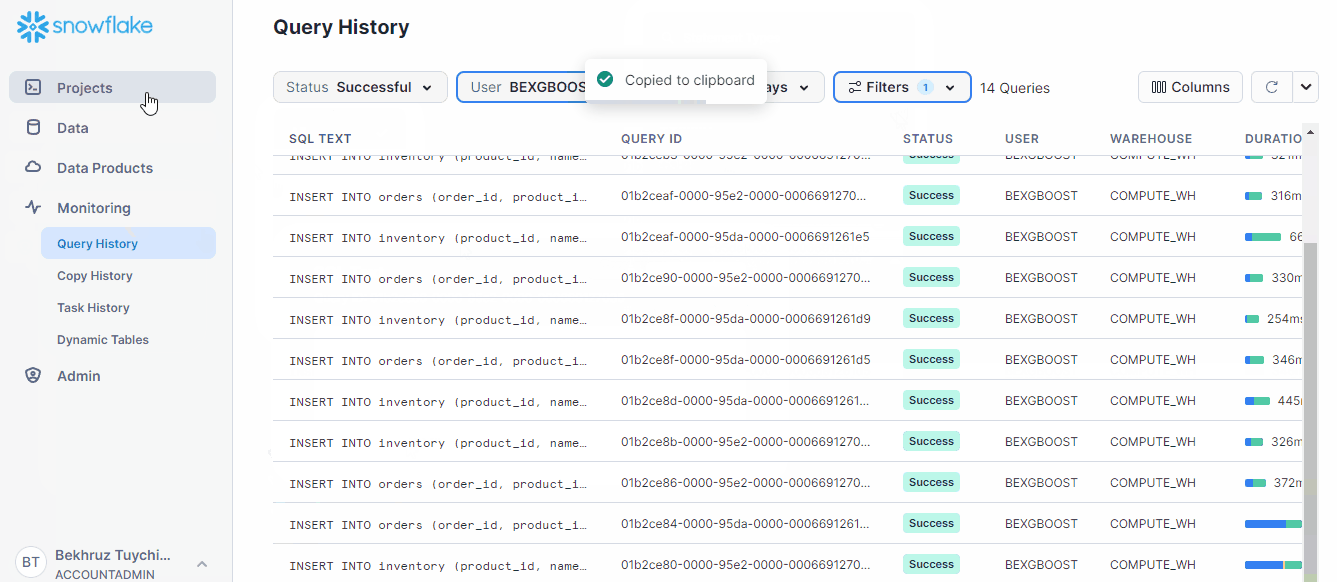
En filtrant par type de requête, vous trouverez bien plus rapidement celle que vous recherchez dans SnowSight.
Nous avons donc une commande erronée dans notre table — comment la supprimer ?
Une option consiste à cloner la table sans la ligne incorrecte :
CREATE OR REPLACE TABLE orders_clone AS
SELECT * FROM orders WHERE quantity != 100;

SELECT * FROM orders_clone;
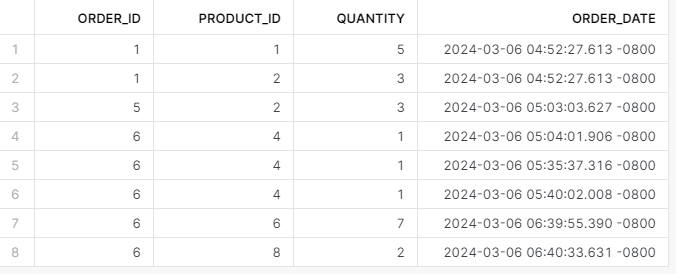
Ça fonctionne, sans même recourir à Time Travel pour corriger le problème. Mais si vous devez cloner un état passé d’une table, utilisez la syntaxe suivante :
-- Clone an object as it existed 2 days ago
CREATE TABLE old_table_clone CLONE olt_table
   AT(OFFSET => -2 * 24 * 60 * 60);  -- Offset for 2 days
Le clonage de bases de données est similaire :
CREATE DATABASE cloned_db CLONE my_db
 BEFORE(STATEMENT => '8e5d0ca9-005e-44e6-b858-a8f5b37c5726');
Imaginons que nous venions d’embaucher un stagiaire et que nous lui confiions la résolution de l’erreur de commande.
En voulant supprimer l’enregistrement, le stagiaire efface par inadvertance la table des commandes en production :
-- Simulate accidentally dropping the orders table
DROP TABLE orders

SELECT * FROM orders;;
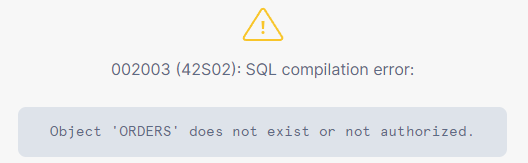
Le stagiaire nous prévient, paniqué, et nous explique ce qui s’est passé. Nous exécutons alors calmement la commande UNDROP :
-- Recover the dropped table using UNDROP
UNDROP TABLE orders

SELECT * FROM orders;;
Et nous récupérons la table. Nous pardonnons aussi au stagiaire et décidons bien sûr de ne pas le sanctionner pour cette erreur.
Dans ce tutoriel, nous avons découvert une fonctionnalité clé de Snowflake — Time Travel. Grâce à Time Travel, vous pouvez interroger et restaurer des informations passées, une capacité très recherchée dans les outils de gestion de bases de données.
En production, tout peut arriver ; disposer d’une sauvegarde de votre base avant chaque mise à jour apporte une vraie sérénité.
À mon sens, Snowflake est aujourd’hui l’un des meilleurs outils de gestion de bases de données. C’est une plateforme puissante, et la maîtriser est une compétence précieuse pour les métiers de la donnée. Pour aller plus loin, consultez le cours Introduction to Snowflake sur DataCamp.
Si vous êtes déjà à l’aise et souhaitez vous évaluer, jetez un œil aux meilleures certifications Snowflake disponibles en 2024.
Commencez votre aventure Snowflake dès aujourd’hui !
Cours
Cours
Cursus