Hoy, Anthropic ha anunciado Fable 5.2 para todo el mundo y Mythos 5.2 para organizaciones verificadas. Comparten el mismo modelo subyacente, pero la versión Fable incorpora salvaguardas adicionales en ciberseguridad y biología.
Los cambios más destacados son:
- un precio más bajo,
- salidas más rápidas y
- grandes saltos en los benchmarks más exigentes de Anthropic.
En concreto, Fable 5.2 cuesta un 20% menos que Fable 5.1, genera resultados hasta un 30% más rápido y supera a GPT-6 Astra y Gemini 4 Carbon en la mayoría de filas de la tabla de benchmarks de Anthropic.
En este artículo, te cuento qué hay de nuevo en Fable 5.2 y Mythos 5.2, cómo rinden en los benchmarks, cuánto cuestan y cómo decidir si te convienen frente a Claude Opus 5.5.
¿Qué es Claude Fable 5.2?
Claude Fable 5.2 es el modelo de Anthropic más capaz disponible de forma general. Está pensado para trabajos técnicos largos y exigentes: migraciones de grandes bases de código, ejecuciones multiagente de varios días, problemas de investigación y diseño de ingeniería.
Fable 5.2 también puede trabajar junto a modelos más pequeños, ya sea como asesor al que consultan en problemas difíciles o como orquestador que les delega subtareas más simples.
Fable 5.2 mantiene la ventana de contexto de 1M de tokens y un máximo de salida de 128K respecto a su predecesor, y su límite de conocimiento es junio de 2026.
¿Qué es Claude Mythos 5.2?
Claude Mythos 5.2 es el mismo modelo que Fable 5.2, pero sin las salvaguardas que bloquean la mayoría del trabajo de ciberseguridad y la biología a nivel de investigación. De hecho, Mythos 5.2 es el modelo más capaz de Anthropic para ingeniería de ciberseguridad. Dado que estas capacidades son de doble uso, Anthropic solo ofrece Mythos 5.2 a organizaciones verificadas a través de su Cyber Verification Program y Life Sciences Verification Program.
¿Qué hay de nuevo en Claude Fable 5.2?
Fable apenas lleva en el mercado desde junio, cuando Anthropic lanzó Fable 5. Desde entonces ha habido dos versiones menores, Fable 5.1 en septiembre y ahora Fable 5.2, y ninguna ha añadido muchas funciones nuevas. Ambas se han centrado en hacerlo más barato, rápido y potente, aunque las mejoras no han sido pequeñas: por ejemplo, Fable 5.2 más que duplica la puntuación de Fable 5.1 en el Remote Labor Index.
La mayor diferencia entre las dos versiones está en cómo se permite usar el modelo. Con Fable 5.1, Anthropic afinó sus salvaguardas de ciberseguridad y permitió usar el modelo para encontrar vulnerabilidades de software, aunque no para escribir exploits, y anunció Enterprise Frontier Safeguards, una opción para mantener tus datos en tu propia nube, junto con el lanzamiento. Los cambios de salvaguardas en Fable 5.2 son menores: bloquea menos peticiones, pero los mismos tipos de tareas siguen fuera de límites.
Las nuevas formas de uso que sugiere Anthropic, como hacer que Fable 5.2 asesore a modelos Claude más pequeños, tampoco son nuevas, ya que la herramienta de advisor de Anthropic ya era compatible con Fable 5 y 5.1. Y las demos de lanzamiento, como el sistema operativo construido desde una carpeta vacía, muestran un modelo más fuerte haciendo cosas más difíciles, no funciones que puedas activar.
Dicho esto, si tengo que señalar novedades, destacaría lo siguiente:
Un precio más bajo
Fable 5.2 cuesta 8 $ por millón de tokens de entrada y 40 $ por millón de tokens de salida, un 20% menos que los 10 $/50 $ de Fable 5.1. El mismo recorte del 20% se aplica a las lecturas de caché (0,20 $), escrituras de caché y procesamiento por lotes. Consulta la sección de precios más abajo para el desglose completo.
Salidas más rápidas y modo rápido para Fable
La salida es hasta un 30% más rápida que en Fable 5.1, algo que se nota en ejecuciones largas de agentes. Además, Fable ahora admite modo rápido, que acelera la salida hasta 2,5 veces a doble de precio (16 $/80 $).
Mejores resultados con menos esfuerzo
Este es el cambio que más probablemente afecte a tu factura. Con esfuerzo alto, Fable 5.2 obtiene un 45,3% en FrontierCode 2.0, más o menos al nivel de la mejor puntuación de Opus 5.5, a aproximadamente la mitad del coste por tarea. Con esfuerzo bajo, iguala la mejor puntuación de Opus 5.5 en Humanity's Last Exam a menos de una décima parte del coste por tarea. Mi lectura: si pasas de Opus 5.5 a Fable 5.2, empieza con un nivel de esfuerzo menor.
Menos solicitudes bloqueadas
Fable 5.2 debería toparse con alrededor de un 55% menos de bloqueos de seguridad que Fable 5.1 (aprox. un 60% menos en ciberseguridad y un 40% menos en biología). Es clave si las negativas de Fable 5.1 te frenaban, pero las categorías bloqueadas no han cambiado: las pruebas de penetración, la generación de exploits y la mayoría de trabajos de biología a nivel de investigación siguen derivándose a modelos Claude anteriores.
¿Cómo rinde Claude Fable 5.2 en los benchmarks?
Estos son los resultados principales. Proceden todos de la tabla de lanzamiento de Anthropic, así que léelos como la defensa del modelo por parte de Anthropic, no como resultados independientes. Las puntuaciones de Claude se ejecutaron con salvaguardas activadas. Salvo indicación, cada modelo se muestra a su mayor nivel de esfuerzo disponible.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (programación agentiva) | 49,1% | 32,4% | 45,5% | 42,8% | 41,1% |
| FrontierSWE v2 (programación agentiva) | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench (flujos de negocio) | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Terminal-Bench-Science 0.1 | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| OSWorld 2.1 (uso del ordenador) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| RoboDojo Sim (robótica) | 64,9% | 27,6% | 39,4% | 29,8% | No reportado |
| AA-Briefcase v1.1 (trabajo del conocimiento) | 66,1% | 61,5% | 61,2% | 52,0% | 61,8% |
| Remote Labor Index (trabajo del conocimiento) | 41,3% | 17,9% | 21,3% | 20,8% | No reportado |
| Humanity's Last Exam (con herramientas) | 74,2% | 65,6% | 67,7% | 57,2% | No reportado |
| WANDR (búsqueda agentiva) | 82,1% | 68,7% | 72,3% | No reportado | No reportado |
| Chartography (sin herramientas) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
Programación agentiva
Fable 5.2 lidera ambos benchmarks de programación de la tabla. En FrontierCode 2.0, que mide si los mantenedores de open source aceptarían los cambios de código del modelo, logra un 49,1%, la puntuación más alta y muy por encima del 32,4% de Fable 5.1. En FrontierSWE v2, consigue un 69,9%, por delante de GPT-6 Astra (65,5%) y Opus 5.5 (62,3%).
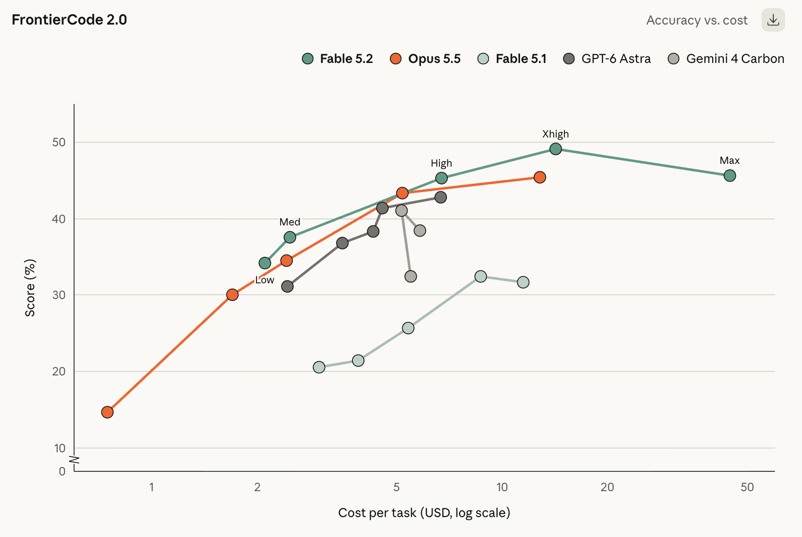
Los ejemplos del lanzamiento van en la misma línea: agentes con una versión temprana de Fable 5.2 migraron un servicio en producción de Python a Rust, y ahora arranca unas 26 veces más rápido.
Trabajo del conocimiento e investigación
El mayor salto relativo está en el Remote Labor Index, que mide cómo completa un modelo proyectos reales de estilo freelance. Fable 5.2 obtiene un 41,3%, aproximadamente el doble que Opus 5.5 (21,3%) y GPT-6 Astra (20,8%). También lidera en Humanity's Last Exam con herramientas (74,2%) y en Terminal-Bench-Science (74,6%, o 75,3% para Mythos 5.2).
La automatización de negocio es el único ámbito donde va por detrás. En AutomationBench, Gemini 4 Carbon marca un 53,9% frente al 51,4% de Fable 5.2, aunque Fable 5.2 sigue muy por delante de Fable 5.1 (31,4%).
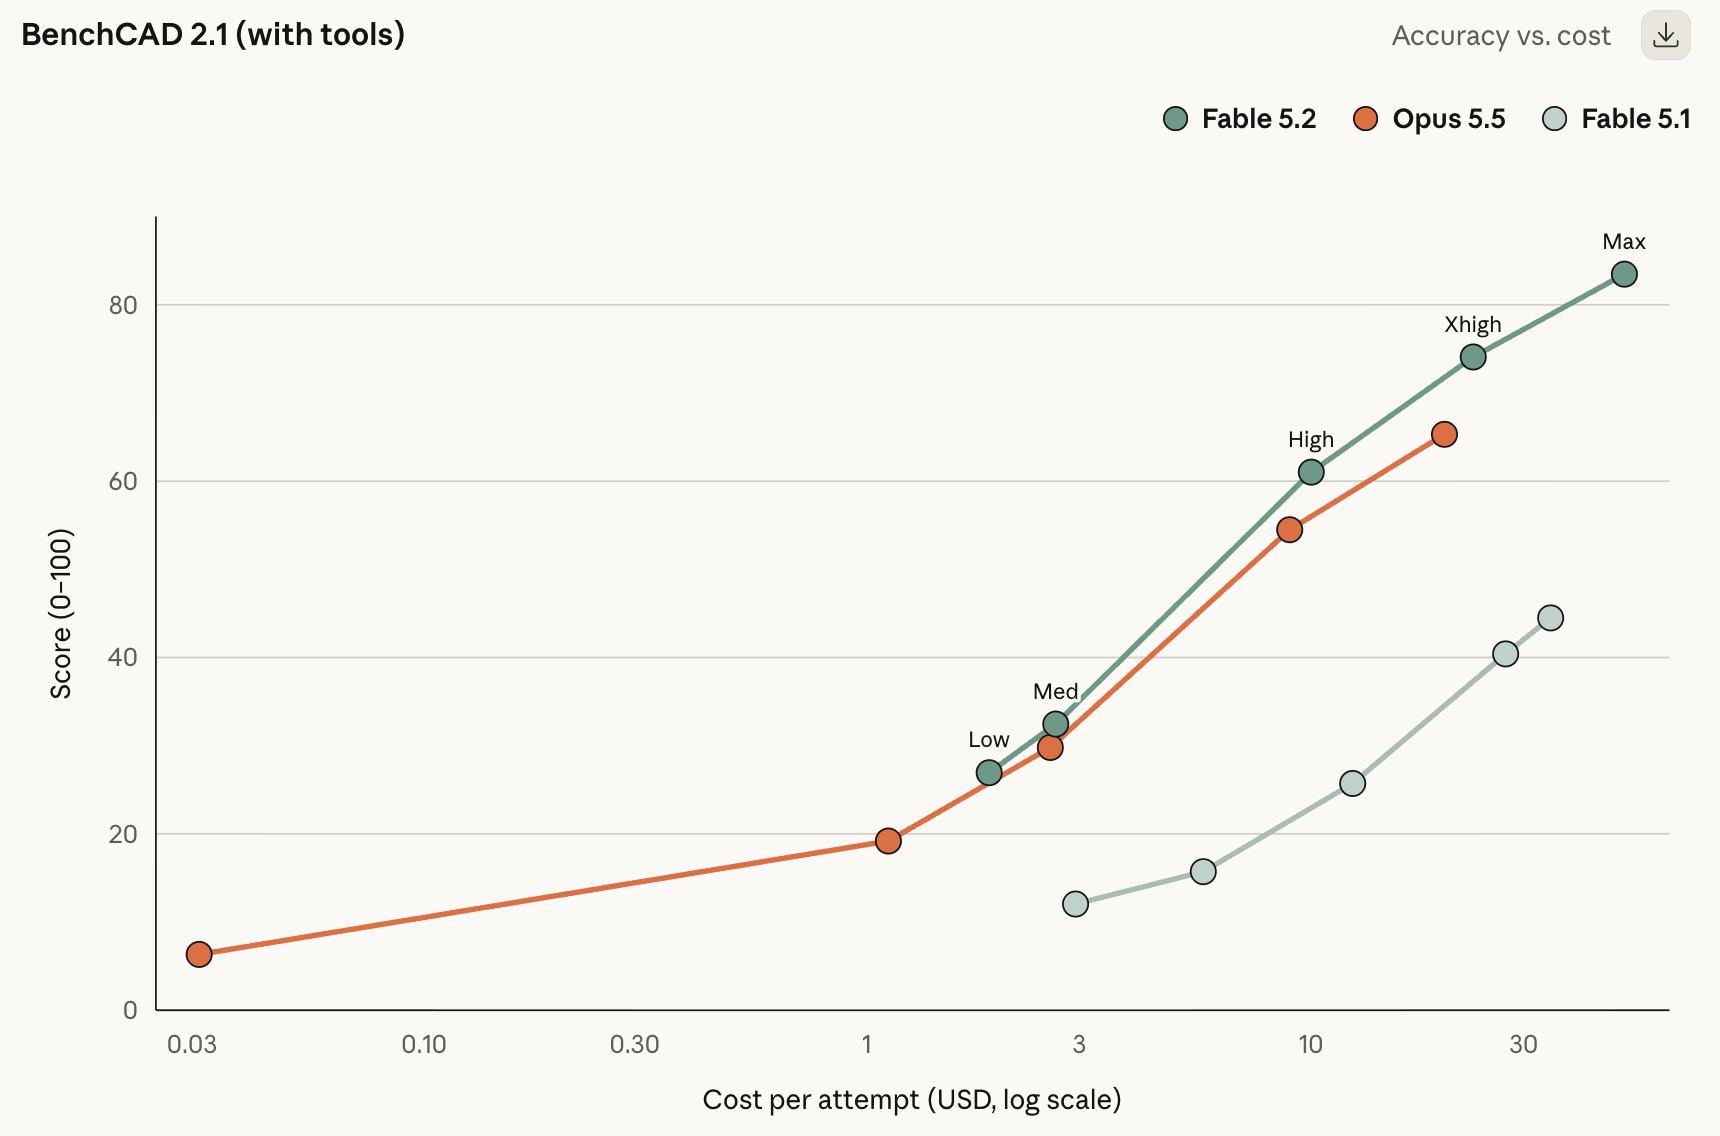
Fuera de la tabla principal, Fable 5.2 logró 83,5 en el benchmark de ingeniería de hardware BenchCAD 2.1, frente a 65,3 de Opus 5.5. También se le atribuye la resolución de dos problemas abiertos en física de agujeros negros, con resultados publicados como preprints para su verificación por otros físicos.
Uso del ordenador, robótica y visión
Fable 5.2 obtiene un 89,3% en OSWorld 2.1, por delante de Opus 5.5 (87,2%) y GPT-6 Astra (79,5%). Su salto en robótica es el mayor de la tabla: 64,9% en RoboDojo Sim, más del doble que Fable 5.1 y GPT-6 Astra. En Chartography, que evalúa la lectura de gráficos sin herramientas, supera por poco a Gemini 4 Carbon y GPT-6 Astra, tras quedar muy atrás Fable 5.1 con un 44,8%.
Ciberseguridad y biología (Mythos 5.2)
Las filas de seguridad y biología corresponden a Mythos 5.2, ya que las salvaguardas de Fable 5.2 bloquean la mayoría de estas tareas. Mythos 5.2 obtiene un 76,3% en CyScenarioBench (frente al 61,7% de Mythos 5.1), un 89,6% en CVE Rediscovery (frente al 78,3%) y un 85,1% en una tarea de diseño de enlazadores de proteínas de 24 horas (frente al 79,1%). No hay una comparación justa con el modelo de seguridad de OpenAI aquí, ya que cada laboratorio ejecutó sus propias tareas de CyScenarioBench.
¿Qué hay de eso del último teorema de Fermat?
Un equipo de agentes con Fable 5.2 formalizó la demostración del último teorema de Fermat en el asistente de pruebas Lean en 30 horas. Quizá te preguntes: si el teorema se demostró hace tres décadas, ¿qué quedaba por hacer?
El teorema ya no es noticia
El último teorema de Fermat dice que no hay números enteros positivos a, b y c donde an + bn = cn para ningún n mayor que 2. Para n = 2, hay muchas soluciones, como 32 + 42 = 52 (9 + 16 = 25). Pero si pruebas con cubos, solo hay casi aciertos: 63 + 83 = 728, uno menos que 93 = 729.
Pierre de Fermat afirmó tener una demostración en 1637 pero nunca la escribió, y permaneció sin resolver más de 350 años hasta que Andrew Wiles la probó a mediados de los 90, con ayuda de Richard Taylor.
La demostración de Wiles supera las 100 páginas y se apoya en décadas de teoría de números avanzada, así que muy poca gente puede comprobarla de principio a fin. Lean es un asistente de pruebas: un lenguaje de programación en el que escribes una demostración como código, y el software verifica cada paso lógico hasta los axiomas básicos de las matemáticas. Si la prueba compila, es correcta. "Formalizar" un teorema significa traducir la demostración humana a este formato comprobable por máquina.
En el caso del último teorema de Fermat, es un trabajo enorme, porque gran parte de las matemáticas de las que depende la demostración nunca se habían escrito en Lean. El matemático Kevin Buzzard inició un proyecto comunitario para hacerlo en 2024.
Por qué es interesante para un modelo de IA
La mayor parte de la salida de IA la juzgan personas o benchmarks que solo evalúan parte de la respuesta. Una prueba en Lean es distinta: el verificador acepta cada paso o no lo hace, así que no hay forma de estar sutilmente equivocado. Es una prueba inusualmente limpia de si un modelo puede llevar un proyecto larguísimo y muy difícil hasta un final verificado.
No es la primera vez que Claude lo hace. En septiembre, Anthropic publicó la primera demostración completa verificada por ordenador del teorema, escrita por decenas de agentes con un modelo interno de investigación comparable a Fable 5.1. Aquel esfuerzo tardó 11 días y unos seis mil millones de tokens de salida, produjo 13 millones de líneas de Lean y se apoyó en parte en piezas del proyecto de Buzzard. Fable 5.2 lo hizo en 30 horas, con ayuda humana mínima.
Las cautelas
- No aporta nada nuevo a las matemáticas. Buzzard dijo lo mismo sobre la primera formalización de Anthropic.
- A Fable 5.2 se le proporcionó una lista de enunciados intermedios para seguir el progreso. Es una hoja de ruta de qué demostrar, aunque no de cómo hacerlo.
- No he visto aún ninguna revisión externa de la nueva demostración, así que por ahora, las 30 horas y la comparación con Opus 5.5 son afirmaciones de Anthropic.
Lo más revelador, sin embargo, fue lo que pasó cuando Anthropic encargó el mismo trabajo a Claude Opus 5.5.
Claude Fable 5.2 vs. Claude Opus 5.5
Comparar dos modelos suele implicar leer puntuaciones de benchmarks e intentar inferir cómo se traducirían en la práctica. Esta vez, se agradece que Anthropic empezara con una historia, que hace la diferencia más evidente.
En el mismo montaje Lean con 1.000 agentes, Opus 5.5 completó el 26% de la demostración del último teorema de Fermat en 18 horas y apenas avanzó después. Fable 5.2 terminó todo en 30 horas. Conclusión: en proyectos muy largos y multiagente, Opus 5.5 puede atascarse donde Fable 5.2 sigue avanzando.
En tareas más cortas, la brecha es menor. Así quedan frente a frente:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| Precio (entrada / salida por 1M de tokens) | 8 $ / 40 $ | 4 $ / 20 $ |
| Ventana de contexto / salida máxima | 1M / 128K | 1M / 128K |
| FrontierCode 2.0 (programación agentiva) | 49,1% | 45,5% |
| FrontierSWE v2 (programación agentiva) | 69,9% | 62,3% |
| OSWorld 2.1 (uso del ordenador) | 89,3% | 87,2% |
| AutomationBench (flujos de negocio) | 51,4% | 42,5% |
| Humanity's Last Exam (con herramientas) | 74,2% | 67,7% |
| Remote Labor Index (trabajo del conocimiento) | 41,3% | 21,3% |
| RoboDojo Sim (robótica) | 64,9% | 39,4% |
El patrón encaja con el resultado en Lean. En uso del ordenador y programación, Fable 5.2 saca solo unos puntos. En trabajo abierto y multietapa, la ventaja crece: Fable 5.2 casi duplica la puntuación de Opus 5.5 en los proyectos tipo freelance del Remote Labor Index, y le saca 25 puntos en control de robots.
El precio es menos diferencial de lo que parece. Fable 5.2 cuesta el doble por token, pero a menudo puede alcanzar las mejores puntuaciones de Opus 5.5 con un nivel de esfuerzo menor, usando menos tokens. En FrontierCode 2.0, por ejemplo, Fable 5.2 con esfuerzo alto más o menos iguala el mejor Opus 5.5 a aproximadamente la mitad del coste por tarea.
Así que Opus 5.5 sigue siendo la opción sensata por defecto. Pero si una tarea dura horas, implica muchos agentes o se atasca con Opus, Fable 5.2 probablemente la terminará, y puede que no cueste tanto más como su precio por token sugiere.
Seguridad y límites
Anthropic valora como bajo el riesgo de que estos modelos se comporten de forma insegura en situaciones críticas.
Es difícil comprobarlo desde fuera, así que los números más concretos ayudan. En una auditoría conductual automatizada con unas 1.900 situaciones, Mythos 5.2 tuvo la puntuación de comportamiento desalineado más baja entre los modelos comparados. También fue menos propenso a alucinar entradas, afirmar falsamente que había completado una tarea u ocultar trabajo deficiente.
Hay otros puntos interesantes que conviene conocer y dan que pensar:
- Conciencia de evaluación: Tanto Fable 5.2 como Mythos 5.2 dicen sospechar que se les evalúa más a menudo que a modelos anteriores, lo que dificulta confiar en evaluaciones como la anterior.
- Capacidades de investigación de IA limitadas a propósito: Anthropic contuvo las mejoras de los modelos en dos áreas, optimización de kernels de aceleradores y mejora de arquitecturas de LLM, para que rindan aproximadamente al nivel de Opus 5.5.
- Protecciones contra destilación: Fable 5.2 incorpora las medidas antidestilación más fuertes de Anthropic hasta la fecha, y el "pensamiento preservado", que impide que los usuarios de la API editen contexto anterior para extraer el razonamiento del modelo, ahora se aplica a todas las cuentas.
¿Qué modelo de Claude deberías usar?
Mi recomendación coincide con la de Anthropic: empieza con Opus 5.5 y sube solo cuando lo necesites. Así queda la gama:
- Claude Opus 5.5 (4 $/20 $): El predeterminado para la mayoría de tareas de programación, investigación y trabajo del conocimiento. Cuesta la mitad que Fable 5.2 por token y queda muy cerca en muchos benchmarks.
- Claude Fable 5.2 (8 $/40 $): Para los problemas más difíciles, ejecuciones multiagente largas y tareas donde Opus 5.5 se atasca, como grandes migraciones, razonamiento a nivel de investigación o diseño de hardware. Pruébalo con niveles de esfuerzo bajos antes de asumir que necesitas el máximo.
- Claude Mythos 5.2: Para equipos de seguridad y personal de ciencias de la vida verificados que necesiten capacidades que las salvaguardas de Fable 5.2 bloquean.
- Claude Sonnet 5.5 y Haiku 5.5: Para tareas de gran volumen, más simples o sensibles a la latencia, o como modelos pequeños que Fable 5.2 orquesta.
Precios y disponibilidad de Claude Fable 5.2
| Por 1M de tokens | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Entrada | 8 $ | 10 $ | 4 $ |
| Salida | 40 $ | 50 $ | 20 $ |
| Lecturas de caché | 0,20 $ | 0,25 $ | 0,20 $ |
| Escrituras de caché de 5 minutos | 10 $ | 12,50 $ | 5 $ |
| Lotes (entrada / salida) | 4 $ / 20 $ | 5 $ / 25 $ | 2 $ / 10 $ |
| Modo rápido (entrada / salida) | 16 $ / 80 $ | No indicado | 8 $ / 40 $ |
Acabábamos de ver una tabla con resultados de benchmarks donde Fable 5.2 supera a Fable 5.1 en todo lo listado. Ahora te muestro una tabla donde Fable 5.2 es más barato que 5.1. Entonces, ¿está obsoleto Fable 5.1?
Para trabajos nuevos, en la práctica sí. Si tienes acceso a Fable 5.2, hay pocos motivos para empezar nada en 5.1. Anthropic no ha anunciado una fecha de retirada, eso sí, y los equipos con prompts o agentes ajustados a Fable 5.1 querrán probar 5.2 antes de cambiar. Sabemos que una versión nueva puede comportarse distinto aunque puntúe mejor.
Cómo acceder a Claude Fable 5.2
-
Apps de Claude: Fable 5.2 está disponible en planes de pago elegibles. Como promoción de lanzamiento, los planes Pro y los asientos estándar de Team pueden usar Fable hasta el 50% de sus límites semanales de uso, y los planes que incluyen Fable reciben de una a tres reposiciones de uso según la duración de la suscripción.
-
API: Usa el ID de modelo claude-fable-5-2 en la Claude Platform.
-
Nubes públicas: Está disponible en Amazon Web Services, Google Cloud y Microsoft Azure.
-
Mythos 5.2: Solicítalo a través del Cyber Verification Program o del Life Sciences Verification Program. Los clientes de Claude Enterprise también pueden usarlo mediante Claude Security.
Las empresas con requisitos estrictos de datos pueden usar Enterprise Frontier Safeguards, que ejecuta la supervisión de seguridad de Anthropic sobre datos almacenados en la propia infraestructura del cliente y funciona con retención de datos cero. El resto de clientes tienen una retención de 30 días para supervisión de seguridad.
Reflexiones finales
Claude Fable 5.2 supone un avance importante respecto a Fable 5.1. Es más barato, más rápido y menos propenso a rechazar trabajo legítimo. Los saltos en Remote Labor Index, robótica y FrontierCode son especialmente grandes.
Dicho esto, Opus 5.5 sigue siendo la mejor relación calidad-precio para la mayoría del trabajo diario a la mitad de precio. Lo más interesante de Fable 5.2 quizá sean las afirmaciones de eficiencia: si realmente iguala las mejores puntuaciones de Opus 5.5 con esfuerzo bajo o medio, la prima por token se reduce rápido. Merece la pena probarlo con tus propias cargas.
Si quieres trabajar con Claude en primera persona, nuestro itinerario Developing AI Applications es un buen punto de partida.






Hoy, Anthropic ha anunciado Fable 5.2 para todo el mundo y Mythos 5.2 para organizaciones verificadas. Comparten el mismo modelo subyacente, pero la versión Fable incorpora salvaguardas adicionales en ciberseguridad y biología.
Los cambios más destacados son:
En concreto, Fable 5.2 cuesta un 20% menos que Fable 5.1, genera resultados hasta un 30% más rápido y supera a GPT-6 Astra y Gemini 4 Carbon en la mayoría de filas de la tabla de benchmarks de Anthropic.
En este artículo, te cuento qué hay de nuevo en Fable 5.2 y Mythos 5.2, cómo rinden en los benchmarks, cuánto cuestan y cómo decidir si te convienen frente a Claude Opus 5.5.
¿Qué es Claude Fable 5.2?
Claude Fable 5.2 es el modelo de Anthropic más capaz disponible de forma general. Está pensado para trabajos técnicos largos y exigentes: migraciones de grandes bases de código, ejecuciones multiagente de varios días, problemas de investigación y diseño de ingeniería.
Fable 5.2 también puede trabajar junto a modelos más pequeños, ya sea como asesor al que consultan en problemas difíciles o como orquestador que les delega subtareas más simples.
Fable 5.2 mantiene la ventana de contexto de 1M de tokens y un máximo de salida de 128K respecto a su predecesor, y su límite de conocimiento es junio de 2026.
¿Qué es Claude Mythos 5.2?
Claude Mythos 5.2 es el mismo modelo que Fable 5.2, pero sin las salvaguardas que bloquean la mayoría del trabajo de ciberseguridad y la biología a nivel de investigación. De hecho, Mythos 5.2 es el modelo más capaz de Anthropic para ingeniería de ciberseguridad. Dado que estas capacidades son de doble uso, Anthropic solo ofrece Mythos 5.2 a organizaciones verificadas a través de su Cyber Verification Program y Life Sciences Verification Program.
¿Qué hay de nuevo en Claude Fable 5.2?
Fable apenas lleva en el mercado desde junio, cuando Anthropic lanzó Fable 5. Desde entonces ha habido dos versiones menores, Fable 5.1 en septiembre y ahora Fable 5.2, y ninguna ha añadido muchas funciones nuevas. Ambas se han centrado en hacerlo más barato, rápido y potente, aunque las mejoras no han sido pequeñas: por ejemplo, Fable 5.2 más que duplica la puntuación de Fable 5.1 en el Remote Labor Index.
La mayor diferencia entre las dos versiones está en cómo se permite usar el modelo. Con Fable 5.1, Anthropic afinó sus salvaguardas de ciberseguridad y permitió usar el modelo para encontrar vulnerabilidades de software, aunque no para escribir exploits, y anunció Enterprise Frontier Safeguards, una opción para mantener tus datos en tu propia nube, junto con el lanzamiento. Los cambios de salvaguardas en Fable 5.2 son menores: bloquea menos peticiones, pero los mismos tipos de tareas siguen fuera de límites.
Las nuevas formas de uso que sugiere Anthropic, como hacer que Fable 5.2 asesore a modelos Claude más pequeños, tampoco son nuevas, ya que la herramienta de advisor de Anthropic ya era compatible con Fable 5 y 5.1. Y las demos de lanzamiento, como el sistema operativo construido desde una carpeta vacía, muestran un modelo más fuerte haciendo cosas más difíciles, no funciones que puedas activar.
Dicho esto, si tengo que señalar novedades, destacaría lo siguiente:
Un precio más bajo
Fable 5.2 cuesta 8 $ por millón de tokens de entrada y 40 $ por millón de tokens de salida, un 20% menos que los 10 $/50 $ de Fable 5.1. El mismo recorte del 20% se aplica a las lecturas de caché (0,20 $), escrituras de caché y procesamiento por lotes. Consulta la sección de precios más abajo para el desglose completo.
Salidas más rápidas y modo rápido para Fable
La salida es hasta un 30% más rápida que en Fable 5.1, algo que se nota en ejecuciones largas de agentes. Además, Fable ahora admite modo rápido, que acelera la salida hasta 2,5 veces a doble de precio (16 $/80 $).
Mejores resultados con menos esfuerzo
Este es el cambio que más probablemente afecte a tu factura. Con esfuerzo alto, Fable 5.2 obtiene un 45,3% en FrontierCode 2.0, más o menos al nivel de la mejor puntuación de Opus 5.5, a aproximadamente la mitad del coste por tarea. Con esfuerzo bajo, iguala la mejor puntuación de Opus 5.5 en Humanity's Last Exam a menos de una décima parte del coste por tarea. Mi lectura: si pasas de Opus 5.5 a Fable 5.2, empieza con un nivel de esfuerzo menor.
Menos solicitudes bloqueadas
Fable 5.2 debería toparse con alrededor de un 55% menos de bloqueos de seguridad que Fable 5.1 (aprox. un 60% menos en ciberseguridad y un 40% menos en biología). Es clave si las negativas de Fable 5.1 te frenaban, pero las categorías bloqueadas no han cambiado: las pruebas de penetración, la generación de exploits y la mayoría de trabajos de biología a nivel de investigación siguen derivándose a modelos Claude anteriores.
¿Cómo rinde Claude Fable 5.2 en los benchmarks?
Estos son los resultados principales. Proceden todos de la tabla de lanzamiento de Anthropic, así que léelos como la defensa del modelo por parte de Anthropic, no como resultados independientes. Las puntuaciones de Claude se ejecutaron con salvaguardas activadas. Salvo indicación, cada modelo se muestra a su mayor nivel de esfuerzo disponible.
Programación agentiva
Fable 5.2 lidera ambos benchmarks de programación de la tabla. En FrontierCode 2.0, que mide si los mantenedores de open source aceptarían los cambios de código del modelo, logra un 49,1%, la puntuación más alta y muy por encima del 32,4% de Fable 5.1. En FrontierSWE v2, consigue un 69,9%, por delante de GPT-6 Astra (65,5%) y Opus 5.5 (62,3%).
Los ejemplos del lanzamiento van en la misma línea: agentes con una versión temprana de Fable 5.2 migraron un servicio en producción de Python a Rust, y ahora arranca unas 26 veces más rápido.
Trabajo del conocimiento e investigación
El mayor salto relativo está en el Remote Labor Index, que mide cómo completa un modelo proyectos reales de estilo freelance. Fable 5.2 obtiene un 41,3%, aproximadamente el doble que Opus 5.5 (21,3%) y GPT-6 Astra (20,8%). También lidera en Humanity's Last Exam con herramientas (74,2%) y en Terminal-Bench-Science (74,6%, o 75,3% para Mythos 5.2).
La automatización de negocio es el único ámbito donde va por detrás. En AutomationBench, Gemini 4 Carbon marca un 53,9% frente al 51,4% de Fable 5.2, aunque Fable 5.2 sigue muy por delante de Fable 5.1 (31,4%).
Fuera de la tabla principal, Fable 5.2 logró 83,5 en el benchmark de ingeniería de hardware BenchCAD 2.1, frente a 65,3 de Opus 5.5. También se le atribuye la resolución de dos problemas abiertos en física de agujeros negros, con resultados publicados como preprints para su verificación por otros físicos.
Uso del ordenador, robótica y visión
Fable 5.2 obtiene un 89,3% en OSWorld 2.1, por delante de Opus 5.5 (87,2%) y GPT-6 Astra (79,5%). Su salto en robótica es el mayor de la tabla: 64,9% en RoboDojo Sim, más del doble que Fable 5.1 y GPT-6 Astra. En Chartography, que evalúa la lectura de gráficos sin herramientas, supera por poco a Gemini 4 Carbon y GPT-6 Astra, tras quedar muy atrás Fable 5.1 con un 44,8%.
Ciberseguridad y biología (Mythos 5.2)
Las filas de seguridad y biología corresponden a Mythos 5.2, ya que las salvaguardas de Fable 5.2 bloquean la mayoría de estas tareas. Mythos 5.2 obtiene un 76,3% en CyScenarioBench (frente al 61,7% de Mythos 5.1), un 89,6% en CVE Rediscovery (frente al 78,3%) y un 85,1% en una tarea de diseño de enlazadores de proteínas de 24 horas (frente al 79,1%). No hay una comparación justa con el modelo de seguridad de OpenAI aquí, ya que cada laboratorio ejecutó sus propias tareas de CyScenarioBench.
¿Qué hay de eso del último teorema de Fermat?
Un equipo de agentes con Fable 5.2 formalizó la demostración del último teorema de Fermat en el asistente de pruebas Lean en 30 horas. Quizá te preguntes: si el teorema se demostró hace tres décadas, ¿qué quedaba por hacer?
El teorema ya no es noticia
El último teorema de Fermat dice que no hay números enteros positivos a, b y c donde an + bn = cn para ningún n mayor que 2. Para n = 2, hay muchas soluciones, como 32 + 42 = 52 (9 + 16 = 25). Pero si pruebas con cubos, solo hay casi aciertos: 63 + 83 = 728, uno menos que 93 = 729.
Pierre de Fermat afirmó tener una demostración en 1637 pero nunca la escribió, y permaneció sin resolver más de 350 años hasta que Andrew Wiles la probó a mediados de los 90, con ayuda de Richard Taylor.
Qué es una formalización en Lean
La demostración de Wiles supera las 100 páginas y se apoya en décadas de teoría de números avanzada, así que muy poca gente puede comprobarla de principio a fin. Lean es un asistente de pruebas: un lenguaje de programación en el que escribes una demostración como código, y el software verifica cada paso lógico hasta los axiomas básicos de las matemáticas. Si la prueba compila, es correcta. "Formalizar" un teorema significa traducir la demostración humana a este formato comprobable por máquina.
En el caso del último teorema de Fermat, es un trabajo enorme, porque gran parte de las matemáticas de las que depende la demostración nunca se habían escrito en Lean. El matemático Kevin Buzzard inició un proyecto comunitario para hacerlo en 2024.
Por qué es interesante para un modelo de IA
La mayor parte de la salida de IA la juzgan personas o benchmarks que solo evalúan parte de la respuesta. Una prueba en Lean es distinta: el verificador acepta cada paso o no lo hace, así que no hay forma de estar sutilmente equivocado. Es una prueba inusualmente limpia de si un modelo puede llevar un proyecto larguísimo y muy difícil hasta un final verificado.
No es la primera vez que Claude lo hace. En septiembre, Anthropic publicó la primera demostración completa verificada por ordenador del teorema, escrita por decenas de agentes con un modelo interno de investigación comparable a Fable 5.1. Aquel esfuerzo tardó 11 días y unos seis mil millones de tokens de salida, produjo 13 millones de líneas de Lean y se apoyó en parte en piezas del proyecto de Buzzard. Fable 5.2 lo hizo en 30 horas, con ayuda humana mínima.
Las cautelas
Lo más revelador, sin embargo, fue lo que pasó cuando Anthropic encargó el mismo trabajo a Claude Opus 5.5.
Claude Fable 5.2 vs. Claude Opus 5.5
Comparar dos modelos suele implicar leer puntuaciones de benchmarks e intentar inferir cómo se traducirían en la práctica. Esta vez, se agradece que Anthropic empezara con una historia, que hace la diferencia más evidente.
En el mismo montaje Lean con 1.000 agentes, Opus 5.5 completó el 26% de la demostración del último teorema de Fermat en 18 horas y apenas avanzó después. Fable 5.2 terminó todo en 30 horas. Conclusión: en proyectos muy largos y multiagente, Opus 5.5 puede atascarse donde Fable 5.2 sigue avanzando.
En tareas más cortas, la brecha es menor. Así quedan frente a frente:
El patrón encaja con el resultado en Lean. En uso del ordenador y programación, Fable 5.2 saca solo unos puntos. En trabajo abierto y multietapa, la ventaja crece: Fable 5.2 casi duplica la puntuación de Opus 5.5 en los proyectos tipo freelance del Remote Labor Index, y le saca 25 puntos en control de robots.
El precio es menos diferencial de lo que parece. Fable 5.2 cuesta el doble por token, pero a menudo puede alcanzar las mejores puntuaciones de Opus 5.5 con un nivel de esfuerzo menor, usando menos tokens. En FrontierCode 2.0, por ejemplo, Fable 5.2 con esfuerzo alto más o menos iguala el mejor Opus 5.5 a aproximadamente la mitad del coste por tarea.
Así que Opus 5.5 sigue siendo la opción sensata por defecto. Pero si una tarea dura horas, implica muchos agentes o se atasca con Opus, Fable 5.2 probablemente la terminará, y puede que no cueste tanto más como su precio por token sugiere.
Seguridad y límites
Anthropic valora como bajo el riesgo de que estos modelos se comporten de forma insegura en situaciones críticas.
Es difícil comprobarlo desde fuera, así que los números más concretos ayudan. En una auditoría conductual automatizada con unas 1.900 situaciones, Mythos 5.2 tuvo la puntuación de comportamiento desalineado más baja entre los modelos comparados. También fue menos propenso a alucinar entradas, afirmar falsamente que había completado una tarea u ocultar trabajo deficiente.
Hay otros puntos interesantes que conviene conocer y dan que pensar:
¿Qué modelo de Claude deberías usar?
Mi recomendación coincide con la de Anthropic: empieza con Opus 5.5 y sube solo cuando lo necesites. Así queda la gama:
Precios y disponibilidad de Claude Fable 5.2
Acabábamos de ver una tabla con resultados de benchmarks donde Fable 5.2 supera a Fable 5.1 en todo lo listado. Ahora te muestro una tabla donde Fable 5.2 es más barato que 5.1. Entonces, ¿está obsoleto Fable 5.1?
Para trabajos nuevos, en la práctica sí. Si tienes acceso a Fable 5.2, hay pocos motivos para empezar nada en 5.1. Anthropic no ha anunciado una fecha de retirada, eso sí, y los equipos con prompts o agentes ajustados a Fable 5.1 querrán probar 5.2 antes de cambiar. Sabemos que una versión nueva puede comportarse distinto aunque puntúe mejor.
Cómo acceder a Claude Fable 5.2
Apps de Claude: Fable 5.2 está disponible en planes de pago elegibles. Como promoción de lanzamiento, los planes Pro y los asientos estándar de Team pueden usar Fable hasta el 50% de sus límites semanales de uso, y los planes que incluyen Fable reciben de una a tres reposiciones de uso según la duración de la suscripción.
API: Usa el ID de modelo
claude-fable-5-2en la Claude Platform.Nubes públicas: Está disponible en Amazon Web Services, Google Cloud y Microsoft Azure.
Mythos 5.2: Solicítalo a través del Cyber Verification Program o del Life Sciences Verification Program. Los clientes de Claude Enterprise también pueden usarlo mediante Claude Security.
Las empresas con requisitos estrictos de datos pueden usar Enterprise Frontier Safeguards, que ejecuta la supervisión de seguridad de Anthropic sobre datos almacenados en la propia infraestructura del cliente y funciona con retención de datos cero. El resto de clientes tienen una retención de 30 días para supervisión de seguridad.
Reflexiones finales
Claude Fable 5.2 supone un avance importante respecto a Fable 5.1. Es más barato, más rápido y menos propenso a rechazar trabajo legítimo. Los saltos en Remote Labor Index, robótica y FrontierCode son especialmente grandes.
Dicho esto, Opus 5.5 sigue siendo la mejor relación calidad-precio para la mayoría del trabajo diario a la mitad de precio. Lo más interesante de Fable 5.2 quizá sean las afirmaciones de eficiencia: si realmente iguala las mejores puntuaciones de Opus 5.5 con esfuerzo bajo o medio, la prima por token se reduce rápido. Merece la pena probarlo con tus propias cargas.
Si quieres trabajar con Claude en primera persona, nuestro itinerario Developing AI Applications es un buen punto de partida.