Сегодня Anthropic объявила о выходе Fable 5.2 для всех и Mythos 5.2 для проверенных организаций. Это одна и та же базовая модель, но версия Fable имеет дополнительные меры безопасности в области кибербезопасности и биологии.
Ключевые изменения:
- ниже цена,
- быстрее вывод, и
- значительный прирост на самых сложных бенчмарках Anthropic.
Конкретнее: Fable 5.2 на 20% дешевле Fable 5.1, генерирует ответы до 30% быстрее и опережает GPT-6 Astra и Gemini 4 Carbon по большинству строк в таблице бенчмарков Anthropic.
В этой статье мы разберём, что нового в Fable 5.2 и Mythos 5.2, как они показывают себя в бенчмарках, сколько стоят и как решить, нужны ли они вам вместо Claude Opus 5.5.
Что такое Claude Fable 5.2?
Claude Fable 5.2 — самая мощная модель Anthropic с широкой доступностью. Она рассчитана на длительную, сложную техническую работу: миграции крупных кодовых баз, многодневные запуски агентов, исследовательские задачи и инженерное проектирование.
Fable 5.2 также может работать в паре с меньшими моделями — либо как советник для сложных задач, либо как оркестратор, который делегирует им более простые подзадачи.
Fable 5.2 сохраняет контекстное окно в 1 млн токенов и максимальный вывод 128K, как у предшественника; порог знаний — июнь 2026 года.
Что такое Claude Mythos 5.2?
Claude Mythos 5.2 — это та же модель, что и Fable 5.2, но без ограничителей, блокирующих большую часть задач по кибербезопасности и исследовательской биологии. Фактически, Mythos 5.2 — самая сильная модель Anthropic для задач в области кибербезопасности. Поскольку эти возможности имеют двойное назначение, Anthropic предлагает Mythos 5.2 только проверенным организациям через программы Cyber Verification и Life Sciences Verification.
Что нового в Claude Fable 5.2?
Fable существует всего с июня, когда Anthropic выпустила Fable 5. С тех пор было два минорных релиза — Fable 5.1 в сентябре и теперь Fable 5.2, — и ни один из них не добавил много новых функций. В основном модель стала дешевле, быстрее и мощнее, и при этом прирост производительности нельзя назвать небольшим: например, Fable 5.2 более чем вдвое превзошла результат Fable 5.1 на Remote Labor Index.
Большое отличие между релизами — в разрешённых сценариях использования. В Fable 5.1 Anthropic сузила ограничения по кибербезопасности и разрешила использовать модель для поиска уязвимостей ПО (но не для написания эксплойтов), а также представила Enterprise Frontier Safeguards — вариант хранения данных в вашей собственной облачной среде. Изменения ограничителей в Fable 5.2 скромнее: блокируется меньше запросов, но перечень запрещённых задач остался прежним.
Новые способы применения, которые рекомендует Anthropic — например, использование Fable 5.2 в роли советника для меньших моделей Claude, — тоже не новы, поскольку инструмент advisor уже поддерживал Fable 5 и 5.1. И демонстрации запуска, такие как операционная система, построенная из пустой папки, показывают более сильную модель, выполняющую более сложные задачи, а не новые функции, которые можно включить.
Тем не менее, если выделять действительно новое, то вот что стоит упомянуть:
Ниже цена
Fable 5.2 стоит $8 за миллион входных токенов и $40 за миллион выходных — на 20% дешевле, чем у Fable 5.1 ($10/$50). Та же 20%-ная скидка применяется к чтению кэша ($0.20), записи в кэш и пакетной обработке. Полный разбор — в разделе с ценами ниже.
Более быстрый вывод и быстрый режим для Fable
Вывод до 30% быстрее, чем у Fable 5.1, что особенно заметно на длительных запусках агентов. Fable теперь также поддерживает быстрый режим (fast mode), который ускоряет вывод до 2,5 раз при двойной цене ($16/$80).
Лучшие результаты при меньших усилиях
Именно это изменение, скорее всего, повлияет на ваш счёт. На высоком уровне усилий Fable 5.2 набирает 45,3% на FrontierCode 2.0 — примерно на уровне лучшего результата Opus 5.5 — при примерно вдвое меньшей стоимости задачи. На низком уровне усилий она повторяет топовый результат Opus 5.5 на Humanity's Last Exam при менее чем одной десятой стоимости задачи. Вывод: если переходите с Opus 5.5, начните с более низкого уровня усилий в Fable 5.2.
Меньше заблокированных запросов
Fable 5.2 должна сталкиваться примерно на 55% реже с блокировками безопасности, чем Fable 5.1 (около 60% реже в кибербезопасности и 40% реже в биологии). Это важно, если отказы Fable 5.1 мешали работе, но категории, которые блокируются, не изменились: тестирование на проникновение, генерация эксплойтов и большая часть исследовательских задач по биологии всё так же передаются старшим моделям Claude.
Как Claude Fable 5.2 показывает себя в бенчмарках?
Ниже — основные результаты. Все они взяты из стартовой таблицы Anthropic, так что воспринимайте их как аргументы Anthropic в пользу модели, а не независимые замеры. Оценки Claude выполнялись с включёнными ограничителями. Если не оговорено иначе, каждая модель показана на максимально доступном уровне усилий.
| Бенчмарк | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (агентное кодирование) | 49,1% | 32,4% | 45,5% | 42,8% | 41,1% |
| FrontierSWE v2 (агентное кодирование) | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench (бизнес-процессы) | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Terminal-Bench-Science 0.1 | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| OSWorld 2.1 (использование ПК) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| RoboDojo Sim (робототехника) | 64,9% | 27,6% | 39,4% | 29,8% | Не указано |
| AA-Briefcase v1.1 (интеллектуальный труд) | 66,1% | 61,5% | 61,2% | 52,0% | 61,8% |
| Remote Labor Index (интеллектуальный труд) | 41,3% | 17,9% | 21,3% | 20,8% | Не указано |
| Humanity's Last Exam (с инструментами) | 74,2% | 65,6% | 67,7% | 57,2% | Не указано |
| WANDR (агентный поиск) | 82,1% | 68,7% | 72,3% | Не указано | Не указано |
| Chartography (без инструментов) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
Агентное кодирование
Fable 5.2 лидирует в обоих кодовых бенчмарках из таблицы. На FrontierCode 2.0, который измеряет, примут ли мейнтейнеры open-source изменения кода от модели, она набирает 49,1% — лучший результат в таблице и значительно выше 32,4% у Fable 5.1. На FrontierSWE v2 результат — 69,9%, впереди GPT-6 Astra (65,5%) и Opus 5.5 (62,3%).
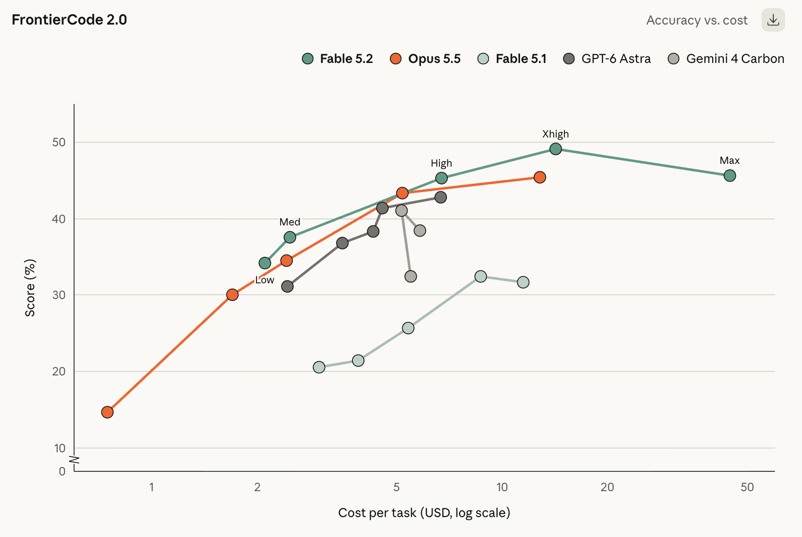
Примеры с запуска говорят о том же: агенты на ранней версии Fable 5.2 мигрировали продуктивный сервис с Python на Rust, и теперь он стартует примерно в 26 раз быстрее.
Интеллектуальный труд и исследования
Самый большой относительный скачок — на Remote Labor Index, который измеряет, насколько хорошо модель справляется с реальными задачами формата фриланса. Fable 5.2 набирает 41,3% — примерно вдвое больше Opus 5.5 (21,3%) и GPT-6 Astra (20,8%). Она также лидирует на Humanity's Last Exam с инструментами (74,2%) и на Terminal-Bench-Science (74,6%, или 75,3% для Mythos 5.2).
Автоматизация бизнеса — единственная область, где она позади. На AutomationBench Gemini 4 Carbon набирает 53,9% против 51,4% у Fable 5.2, хотя Fable 5.2 всё равно значительно впереди Fable 5.1 (31,4%).
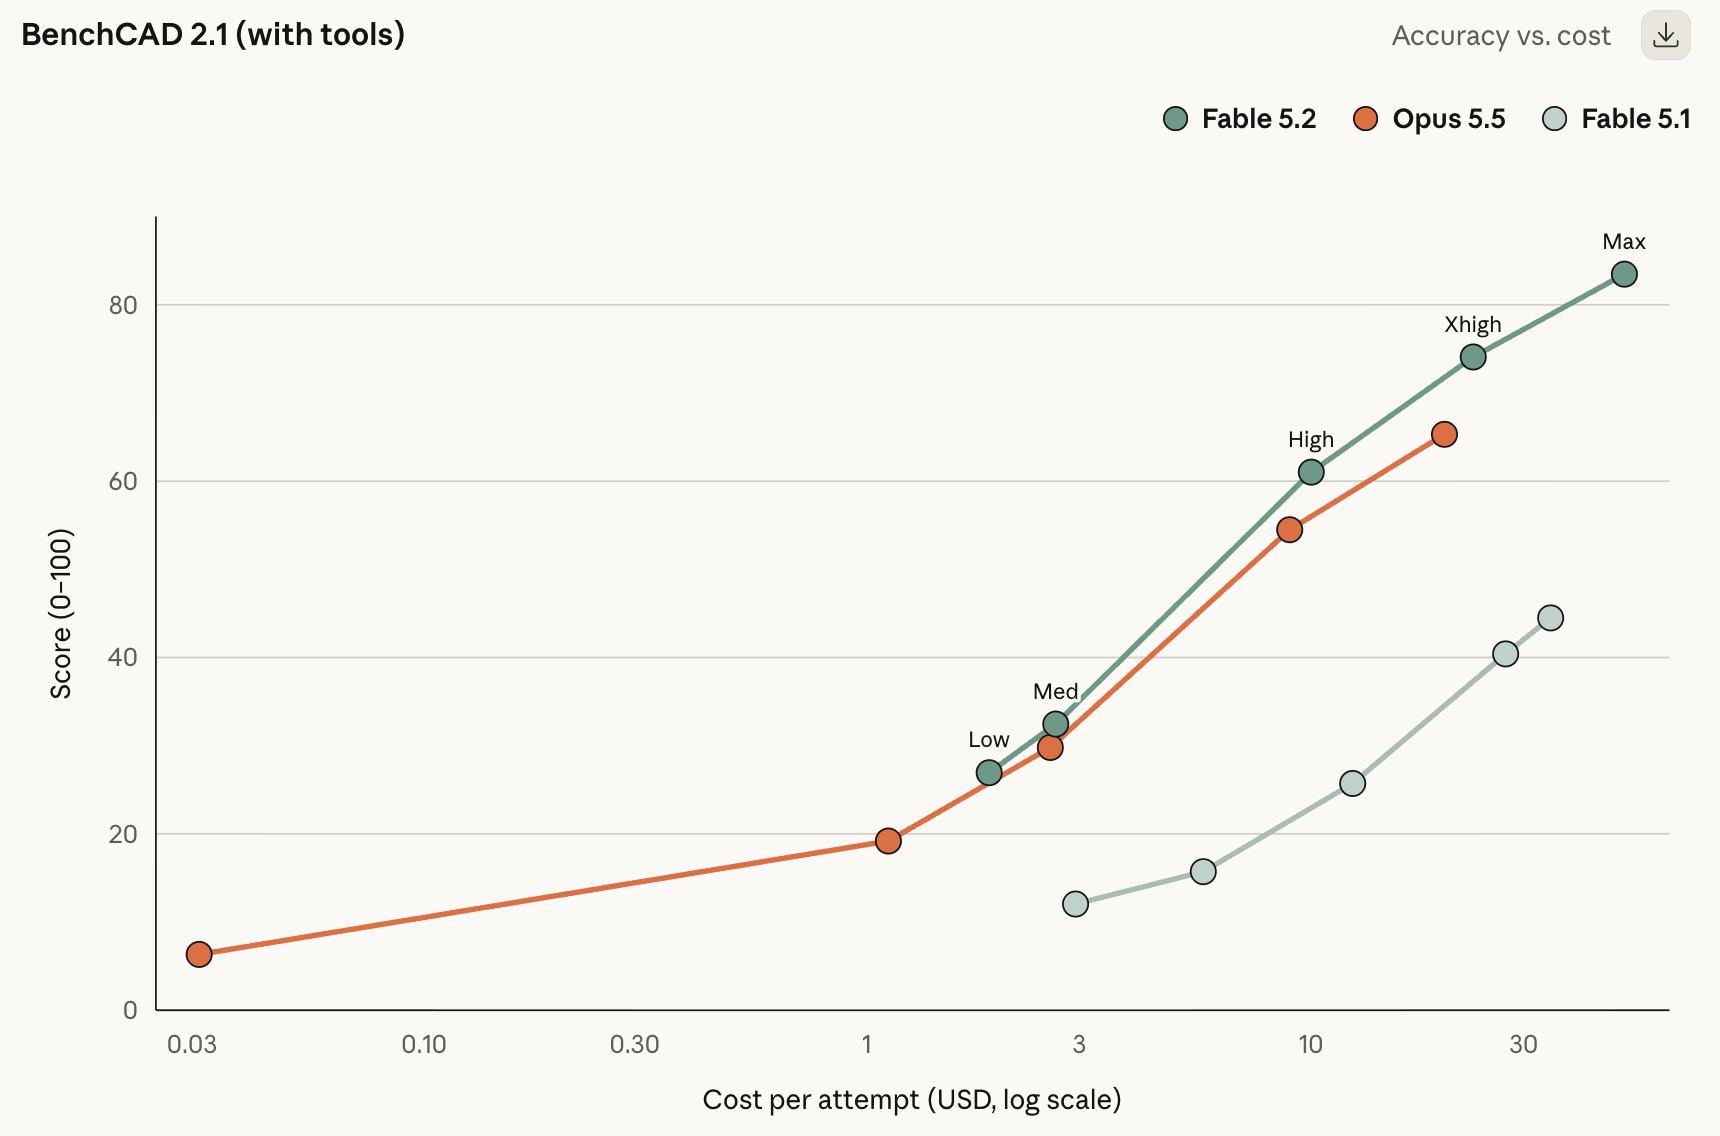
Вне основной таблицы Fable 5.2 набрала 83,5 на бенчмарке аппаратной инженерии BenchCAD 2.1 против 65,3 у Opus 5.5. Ей также приписывают решение двух открытых задач в физике чёрных дыр; результаты выложены как препринты для проверки другими физиками.
Использование компьютера, робототехника и зрение
Fable 5.2 набирает 89,3% на OSWorld 2.1, опережая Opus 5.5 (87,2%) и GPT-6 Astra (79,5%). Прорыв в робототехнике — самый крупный в таблице: 64,9% на RoboDojo Sim — более чем вдвое выше Fable 5.1 и GPT-6 Astra. На Chartography, который проверяет чтение графиков без инструментов, она совсем немного опережает Gemini 4 Carbon и GPT-6 Astra после того, как Fable 5.1 серьёзно отставала с 44,8%.
Кибербезопасность и биология (Mythos 5.2)
Строки по безопасности и биологии относятся к Mythos 5.2, потому что ограничители Fable 5.2 блокируют большинство таких задач. Mythos 5.2 набирает 76,3% на CyScenarioBench (против 61,7% у Mythos 5.1), 89,6% на CVE Rediscovery (против 78,3%) и 85,1% в 24-часовой задаче по проектированию белковых биндеров (против 79,1%). Сравнить это с моделью безопасности OpenAI корректно нельзя, так как каждая лаборатория запускала свои версии задач CyScenarioBench.
А при чём здесь последняя теорема Ферма?
Команда агентов Fable 5.2 заформализовала доказательство последней теоремы Ферма в помощнике доказательств Lean за 30 часов. Вы можете спросить: разве теорема не была доказана три десятилетия назад — что же осталось делать?
Теорема — не новость
Последняя теорема Ферма утверждает, что не существует положительных целых чисел a, b и c, для которых an + bn = cn при любом n больше 2. Для n = 2 решений много, например 32 + 42 = 52 (9 + 16 = 25). Но для кубов получаются лишь «почти попадания»: 63 + 83 = 728 — на единицу меньше, чем 93 = 729.
Пьер Ферма заявил, что имеет доказательство, в 1637 году, но не записал его, и задача оставалась нерешённой более 350 лет, пока Эндрю Уайлс не доказал её в середине 1990-х при участии Ричарда Тейлора.
Что такое формализация в Lean
Доказательство Уайлса занимает более 100 страниц и опирается на десятилетия развитой теории чисел, поэтому очень немногие могут проверить его целиком. Lean — это помощник доказательств: язык программирования, на котором вы записываете доказательство как код, а программа проверяет каждый логический шаг вплоть до базовых аксиом математики. Если «собирается» — значит, верно. «Формализовать» теорему — значит перевести человеческий текст доказательства в машинно-проверяемую форму.
Для последней теоремы Ферма это огромная работа, потому что значительная часть математики, на которой держится доказательство, ранее не была записана в Lean. Математик Кевин Баззард в 2024 году начал сообщественный проект по её формализации.
Почему это интересно для модели ИИ
Большинство результатов ИИ оценивают люди или бенчмарки, проверяющие лишь часть ответа. Доказательство в Lean отличается: проверяющая система либо принимает каждый шаг, либо нет — «слегка ошибиться» нельзя. Это делает задачу редким тестом на способность модели довести очень длинный и сложный проект до верифицированного завершения.
И это не первый раз для Claude. В сентябре Anthropic опубликовала первое полное проверенное компьютером доказательство теоремы, написанное десятками агентов на внутренней исследовательской модели, примерно сопоставимой с Fable 5.1. На это ушло 11 дней и около шести миллиардов выходных токенов, было создано 13 миллионов строк Lean, а часть работы опиралась на наработки проекта Баззарда. Fable 5.2 справилась за 30 часов, с минимальной помощью людей.
Оговорки
- Это не добавляет новой математики. Сам Баззард говорил то же о первой формализации Anthropic.
- Fable 5.2 получила список промежуточных формулировок теорем для отслеживания прогресса. Это дорожная карта того, что нужно доказать, но не того, как это сделать.
- Мне не удалось найти внешнюю рецензию нового доказательства, так что пока цифра «30 часов» и сравнение с Opus 5.5 — это заявления Anthropic.
Самое показательное — что произошло, когда Anthropic дала ту же задачу Claude Opus 5.5.
Claude Fable 5.2 против Claude Opus 5.5
Обычно сравнение моделей — это чтение бенчмарков и попытка понять, во что это выльется на практике. В этот раз ценно, что Anthropic начала с истории — так разница виднее.
В той же конфигурации из 1 000 агентов Lean Opus 5.5 за 18 часов завершила 26% доказательства последней теоремы Ферма и затем почти не продвинулась. Fable 5.2 закончила всё за 30 часов. Вывод: на очень длинных мультиагентных проектах Opus 5.5 может «застрять», где Fable 5.2 продолжает идти.
На коротких задачах разрыв меньше. Вот сравнение бок о бок:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| Цена (вход / выход за 1 млн токенов) | $8 / $40 | $4 / $20 |
| Окно контекста / макс. вывод | 1M / 128K | 1M / 128K |
| FrontierCode 2.0 (агентное кодирование) | 49,1% | 45,5% |
| FrontierSWE v2 (агентное кодирование) | 69,9% | 62,3% |
| OSWorld 2.1 (использование ПК) | 89,3% | 87,2% |
| AutomationBench (бизнес-процессы) | 51,4% | 42,5% |
| Humanity's Last Exam (с инструментами) | 74,2% | 67,7% |
| Remote Labor Index (интеллектуальный труд) | 41,3% | 21,3% |
| RoboDojo Sim (робототехника) | 64,9% | 39,4% |
Картина соответствует результату с Lean. В использовании ПК и кодировании Fable 5.2 опережает на несколько пунктов. В открытых многошаговых задачах отрыв растёт: Fable 5.2 почти вдвое опережает Opus 5.5 на фриланс-проектах из Remote Labor Index и на 25 пунктов впереди в управлении роботами.
Разница в цене меньше, чем кажется. Fable 5.2 стоит вдвое дороже за токен, но часто достигает лучших результатов Opus 5.5 при меньшем уровне усилий, используя меньше токенов. Например, на FrontierCode 2.0 Fable 5.2 на высоком уровне усилий примерно соответствует лучшему результату Opus 5.5 при примерно вдвое меньшей стоимости задачи.
Поэтому Opus 5.5 по-прежнему разумный выбор по умолчанию. Но если задача длится часами, вовлекает много агентов или «застревает» на Opus, Fable 5.2, вероятно, доведёт её до конца — и обойдётся не так уж дороже, как подсказывает цена за токен.
Безопасность и ограничения
Anthropic оценивает риск небезопасного поведения этих моделей в критически важных ситуациях как низкий.
Снаружи это сложно проверить, поэтому полезны более конкретные цифры. В автоматизированном поведенческом аудите примерно 1 900 сценариев у Mythos 5.2 был самый низкий показатель несогласованного поведения среди сравниваемых моделей. Она также реже «галлюцинировала» входные данные, ложно заявляла о выполнении задачи или скрывала некачественную работу.
Есть и другие любопытные моменты, которые стоит знать и над которыми стоит задуматься:
- Осведомлённость об оценке: И Fable 5.2, и Mythos 5.2 чаще, чем предыдущие модели, заявляют, что подозревают факт тестирования, что усложняет доверие к таким оценкам.
- Преднамеренное ограничение исследовательских навыков ИИ: Anthropic ограничила прирост возможностей моделей в двух областях — оптимизация ядер акселераторов и улучшение архитектур LLM — чтобы они были на уровне Opus 5.5.
- Защита от дистилляции: У Fable 5.2 самые сильные на сегодня меры против дистилляции, а «сохранение рассуждений» (preserved thinking), которое мешает пользователям API редактировать предыдущий контекст для извлечения хода мысли модели, теперь применяется ко всем аккаунтам.
Какую модель Claude выбрать?
Рекомендация совпадает с позицией Anthropic: начните с Opus 5.5 и переходите выше только при необходимости. Линейка выглядит так:
- Claude Opus 5.5 ($4/$20): Выбор по умолчанию для большинства задач кодирования, исследований и интеллектуального труда. Вдвое дешевле Fable 5.2 за токен и ненамного отстаёт на многих бенчмарках.
- Claude Fable 5.2 ($8/$40): Для самых сложных задач, длительных мультиагентных запусков и случаев, когда Opus 5.5 «застревает», таких как крупные миграции, исследовательские рассуждения или проектирование аппаратуры. Сначала попробуйте более низкий уровень усилий, прежде чем включать максимум.
- Claude Mythos 5.2: Для проверенных команд безопасности и исследователей в области наук о жизни, которым нужны возможности, заблокированные ограничителями Fable 5.2.
- Claude Sonnet 5.5 и Haiku 5.5: Для задач с большим объёмом, попроще или с жёсткими требованиями по задержке — или как меньшие модели, которыми оркестрирует Fable 5.2.
Цены и доступность Claude Fable 5.2
| За 1 млн токенов | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Вход | $8 | $10 | $4 |
| Выход | $40 | $50 | $20 |
| Чтение кэша | $0.20 | $0.25 | $0.20 |
| Запись в кэш на 5 минут | $10 | $12.50 | $5 |
| Пакет (вход / выход) | $4 / $20 | $5 / $25 | $2 / $10 |
| Быстрый режим (вход / выход) | $16 / $80 | Не указано | $8 / $40 |
Мы только что смотрели таблицу с результатами бенчмарков, где Fable 5.2 обходит Fable 5.1 по всем пунктам. А теперь — таблицу, где показано, что Fable 5.2 дешевле 5.1. Значит ли это, что Fable 5.1 устарела?
Для новых проектов — по сути да. Если у вас есть доступ к Fable 5.2, мало причин начинать что-то новое на 5.1. Однако Anthropic не объявляла дату вывода её из эксплуатации, и командам с промптами или агентами, настроенными под Fable 5.1, стоит протестировать 5.2 перед переходом. Мы знаем, что новая версия может вести себя иначе, даже если она набирает больше баллов.
Как получить доступ к Claude Fable 5.2
-
Приложения Claude: Fable 5.2 доступна в соответствующих платных планах. В рамках промо к запуску планы Pro и стандартные места в Team могут использовать Fable до 50% своих недельных лимитов, а планы с включённым Fable получают от одной до трёх дополнительных «сбросов» лимита в зависимости от срока подписки.
-
API: Используйте идентификатор модели claude-fable-5-2 на платформе Claude.
-
Облачные платформы: Доступна в Amazon Web Services, Google Cloud и Microsoft Azure.
-
Mythos 5.2: Подайте заявку через программу Cyber Verification или Life Sciences Verification. Клиенты Claude Enterprise также могут использовать её через Claude Security.
Предприятия с жёсткими требованиями к данным могут использовать Enterprise Frontier Safeguards: система безопасности Anthropic запускается на данных, хранящихся в инфраструктуре клиента, и работает без сохранения данных. У остальных клиентов данные сохраняются 30 дней для мониторинга безопасности.
Итоги
Claude Fable 5.2 — значительный шаг вперёд по сравнению с Fable 5.1. Она дешевле, быстрее и реже отказывается от легитимной работы. Особенно велики скачки на Remote Labor Index, в робототехнике и на FrontierCode.
При этом Opus 5.5 остаётся более выгодным вариантом для повседневных задач — за половину цены. Возможно, самое интересное в Fable 5.2 — это заявления об эффективности: если она действительно повторяет лучшие результаты Opus 5.5 на низком или среднем уровне усилий, «премия» за токен быстро сокращается. Это стоит проверить на ваших задачах.
Если хотите попробовать Claude на практике, наш трек Developing AI Applications — хороший старт.
Сегодня Anthropic объявила о выходе Fable 5.2 для всех и Mythos 5.2 для проверенных организаций. Это одна и та же базовая модель, но версия Fable имеет дополнительные меры безопасности в области кибербезопасности и биологии.
Ключевые изменения:
Конкретнее: Fable 5.2 на 20% дешевле Fable 5.1, генерирует ответы до 30% быстрее и опережает GPT-6 Astra и Gemini 4 Carbon по большинству строк в таблице бенчмарков Anthropic.
В этой статье мы разберём, что нового в Fable 5.2 и Mythos 5.2, как они показывают себя в бенчмарках, сколько стоят и как решить, нужны ли они вам вместо Claude Opus 5.5.
Что такое Claude Fable 5.2?
Claude Fable 5.2 — самая мощная модель Anthropic с широкой доступностью. Она рассчитана на длительную, сложную техническую работу: миграции крупных кодовых баз, многодневные запуски агентов, исследовательские задачи и инженерное проектирование.
Fable 5.2 также может работать в паре с меньшими моделями — либо как советник для сложных задач, либо как оркестратор, который делегирует им более простые подзадачи.
Fable 5.2 сохраняет контекстное окно в 1 млн токенов и максимальный вывод 128K, как у предшественника; порог знаний — июнь 2026 года.
Что такое Claude Mythos 5.2?
Claude Mythos 5.2 — это та же модель, что и Fable 5.2, но без ограничителей, блокирующих большую часть задач по кибербезопасности и исследовательской биологии. Фактически, Mythos 5.2 — самая сильная модель Anthropic для задач в области кибербезопасности. Поскольку эти возможности имеют двойное назначение, Anthropic предлагает Mythos 5.2 только проверенным организациям через программы Cyber Verification и Life Sciences Verification.
Что нового в Claude Fable 5.2?
Fable существует всего с июня, когда Anthropic выпустила Fable 5. С тех пор было два минорных релиза — Fable 5.1 в сентябре и теперь Fable 5.2, — и ни один из них не добавил много новых функций. В основном модель стала дешевле, быстрее и мощнее, и при этом прирост производительности нельзя назвать небольшим: например, Fable 5.2 более чем вдвое превзошла результат Fable 5.1 на Remote Labor Index.
Большое отличие между релизами — в разрешённых сценариях использования. В Fable 5.1 Anthropic сузила ограничения по кибербезопасности и разрешила использовать модель для поиска уязвимостей ПО (но не для написания эксплойтов), а также представила Enterprise Frontier Safeguards — вариант хранения данных в вашей собственной облачной среде. Изменения ограничителей в Fable 5.2 скромнее: блокируется меньше запросов, но перечень запрещённых задач остался прежним.
Новые способы применения, которые рекомендует Anthropic — например, использование Fable 5.2 в роли советника для меньших моделей Claude, — тоже не новы, поскольку инструмент advisor уже поддерживал Fable 5 и 5.1. И демонстрации запуска, такие как операционная система, построенная из пустой папки, показывают более сильную модель, выполняющую более сложные задачи, а не новые функции, которые можно включить.
Тем не менее, если выделять действительно новое, то вот что стоит упомянуть:
Ниже цена
Fable 5.2 стоит $8 за миллион входных токенов и $40 за миллион выходных — на 20% дешевле, чем у Fable 5.1 ($10/$50). Та же 20%-ная скидка применяется к чтению кэша ($0.20), записи в кэш и пакетной обработке. Полный разбор — в разделе с ценами ниже.
Более быстрый вывод и быстрый режим для Fable
Вывод до 30% быстрее, чем у Fable 5.1, что особенно заметно на длительных запусках агентов. Fable теперь также поддерживает быстрый режим (fast mode), который ускоряет вывод до 2,5 раз при двойной цене ($16/$80).
Лучшие результаты при меньших усилиях
Именно это изменение, скорее всего, повлияет на ваш счёт. На высоком уровне усилий Fable 5.2 набирает 45,3% на FrontierCode 2.0 — примерно на уровне лучшего результата Opus 5.5 — при примерно вдвое меньшей стоимости задачи. На низком уровне усилий она повторяет топовый результат Opus 5.5 на Humanity's Last Exam при менее чем одной десятой стоимости задачи. Вывод: если переходите с Opus 5.5, начните с более низкого уровня усилий в Fable 5.2.
Меньше заблокированных запросов
Fable 5.2 должна сталкиваться примерно на 55% реже с блокировками безопасности, чем Fable 5.1 (около 60% реже в кибербезопасности и 40% реже в биологии). Это важно, если отказы Fable 5.1 мешали работе, но категории, которые блокируются, не изменились: тестирование на проникновение, генерация эксплойтов и большая часть исследовательских задач по биологии всё так же передаются старшим моделям Claude.
Как Claude Fable 5.2 показывает себя в бенчмарках?
Ниже — основные результаты. Все они взяты из стартовой таблицы Anthropic, так что воспринимайте их как аргументы Anthropic в пользу модели, а не независимые замеры. Оценки Claude выполнялись с включёнными ограничителями. Если не оговорено иначе, каждая модель показана на максимально доступном уровне усилий.
Агентное кодирование
Fable 5.2 лидирует в обоих кодовых бенчмарках из таблицы. На FrontierCode 2.0, который измеряет, примут ли мейнтейнеры open-source изменения кода от модели, она набирает 49,1% — лучший результат в таблице и значительно выше 32,4% у Fable 5.1. На FrontierSWE v2 результат — 69,9%, впереди GPT-6 Astra (65,5%) и Opus 5.5 (62,3%).
Примеры с запуска говорят о том же: агенты на ранней версии Fable 5.2 мигрировали продуктивный сервис с Python на Rust, и теперь он стартует примерно в 26 раз быстрее.
Интеллектуальный труд и исследования
Самый большой относительный скачок — на Remote Labor Index, который измеряет, насколько хорошо модель справляется с реальными задачами формата фриланса. Fable 5.2 набирает 41,3% — примерно вдвое больше Opus 5.5 (21,3%) и GPT-6 Astra (20,8%). Она также лидирует на Humanity's Last Exam с инструментами (74,2%) и на Terminal-Bench-Science (74,6%, или 75,3% для Mythos 5.2).
Автоматизация бизнеса — единственная область, где она позади. На AutomationBench Gemini 4 Carbon набирает 53,9% против 51,4% у Fable 5.2, хотя Fable 5.2 всё равно значительно впереди Fable 5.1 (31,4%).
Вне основной таблицы Fable 5.2 набрала 83,5 на бенчмарке аппаратной инженерии BenchCAD 2.1 против 65,3 у Opus 5.5. Ей также приписывают решение двух открытых задач в физике чёрных дыр; результаты выложены как препринты для проверки другими физиками.
Использование компьютера, робототехника и зрение
Fable 5.2 набирает 89,3% на OSWorld 2.1, опережая Opus 5.5 (87,2%) и GPT-6 Astra (79,5%). Прорыв в робототехнике — самый крупный в таблице: 64,9% на RoboDojo Sim — более чем вдвое выше Fable 5.1 и GPT-6 Astra. На Chartography, который проверяет чтение графиков без инструментов, она совсем немного опережает Gemini 4 Carbon и GPT-6 Astra после того, как Fable 5.1 серьёзно отставала с 44,8%.
Кибербезопасность и биология (Mythos 5.2)
Строки по безопасности и биологии относятся к Mythos 5.2, потому что ограничители Fable 5.2 блокируют большинство таких задач. Mythos 5.2 набирает 76,3% на CyScenarioBench (против 61,7% у Mythos 5.1), 89,6% на CVE Rediscovery (против 78,3%) и 85,1% в 24-часовой задаче по проектированию белковых биндеров (против 79,1%). Сравнить это с моделью безопасности OpenAI корректно нельзя, так как каждая лаборатория запускала свои версии задач CyScenarioBench.
А при чём здесь последняя теорема Ферма?
Команда агентов Fable 5.2 заформализовала доказательство последней теоремы Ферма в помощнике доказательств Lean за 30 часов. Вы можете спросить: разве теорема не была доказана три десятилетия назад — что же осталось делать?
Теорема — не новость
Последняя теорема Ферма утверждает, что не существует положительных целых чисел a, b и c, для которых an + bn = cn при любом n больше 2. Для n = 2 решений много, например 32 + 42 = 52 (9 + 16 = 25). Но для кубов получаются лишь «почти попадания»: 63 + 83 = 728 — на единицу меньше, чем 93 = 729.
Пьер Ферма заявил, что имеет доказательство, в 1637 году, но не записал его, и задача оставалась нерешённой более 350 лет, пока Эндрю Уайлс не доказал её в середине 1990-х при участии Ричарда Тейлора.
Что такое формализация в Lean
Доказательство Уайлса занимает более 100 страниц и опирается на десятилетия развитой теории чисел, поэтому очень немногие могут проверить его целиком. Lean — это помощник доказательств: язык программирования, на котором вы записываете доказательство как код, а программа проверяет каждый логический шаг вплоть до базовых аксиом математики. Если «собирается» — значит, верно. «Формализовать» теорему — значит перевести человеческий текст доказательства в машинно-проверяемую форму.
Для последней теоремы Ферма это огромная работа, потому что значительная часть математики, на которой держится доказательство, ранее не была записана в Lean. Математик Кевин Баззард в 2024 году начал сообщественный проект по её формализации.
Почему это интересно для модели ИИ
Большинство результатов ИИ оценивают люди или бенчмарки, проверяющие лишь часть ответа. Доказательство в Lean отличается: проверяющая система либо принимает каждый шаг, либо нет — «слегка ошибиться» нельзя. Это делает задачу редким тестом на способность модели довести очень длинный и сложный проект до верифицированного завершения.
И это не первый раз для Claude. В сентябре Anthropic опубликовала первое полное проверенное компьютером доказательство теоремы, написанное десятками агентов на внутренней исследовательской модели, примерно сопоставимой с Fable 5.1. На это ушло 11 дней и около шести миллиардов выходных токенов, было создано 13 миллионов строк Lean, а часть работы опиралась на наработки проекта Баззарда. Fable 5.2 справилась за 30 часов, с минимальной помощью людей.
Оговорки
Самое показательное — что произошло, когда Anthropic дала ту же задачу Claude Opus 5.5.
Claude Fable 5.2 против Claude Opus 5.5
Обычно сравнение моделей — это чтение бенчмарков и попытка понять, во что это выльется на практике. В этот раз ценно, что Anthropic начала с истории — так разница виднее.
В той же конфигурации из 1 000 агентов Lean Opus 5.5 за 18 часов завершила 26% доказательства последней теоремы Ферма и затем почти не продвинулась. Fable 5.2 закончила всё за 30 часов. Вывод: на очень длинных мультиагентных проектах Opus 5.5 может «застрять», где Fable 5.2 продолжает идти.
На коротких задачах разрыв меньше. Вот сравнение бок о бок:
Картина соответствует результату с Lean. В использовании ПК и кодировании Fable 5.2 опережает на несколько пунктов. В открытых многошаговых задачах отрыв растёт: Fable 5.2 почти вдвое опережает Opus 5.5 на фриланс-проектах из Remote Labor Index и на 25 пунктов впереди в управлении роботами.
Разница в цене меньше, чем кажется. Fable 5.2 стоит вдвое дороже за токен, но часто достигает лучших результатов Opus 5.5 при меньшем уровне усилий, используя меньше токенов. Например, на FrontierCode 2.0 Fable 5.2 на высоком уровне усилий примерно соответствует лучшему результату Opus 5.5 при примерно вдвое меньшей стоимости задачи.
Поэтому Opus 5.5 по-прежнему разумный выбор по умолчанию. Но если задача длится часами, вовлекает много агентов или «застревает» на Opus, Fable 5.2, вероятно, доведёт её до конца — и обойдётся не так уж дороже, как подсказывает цена за токен.
Безопасность и ограничения
Anthropic оценивает риск небезопасного поведения этих моделей в критически важных ситуациях как низкий.
Снаружи это сложно проверить, поэтому полезны более конкретные цифры. В автоматизированном поведенческом аудите примерно 1 900 сценариев у Mythos 5.2 был самый низкий показатель несогласованного поведения среди сравниваемых моделей. Она также реже «галлюцинировала» входные данные, ложно заявляла о выполнении задачи или скрывала некачественную работу.
Есть и другие любопытные моменты, которые стоит знать и над которыми стоит задуматься:
Какую модель Claude выбрать?
Рекомендация совпадает с позицией Anthropic: начните с Opus 5.5 и переходите выше только при необходимости. Линейка выглядит так:
Цены и доступность Claude Fable 5.2
Мы только что смотрели таблицу с результатами бенчмарков, где Fable 5.2 обходит Fable 5.1 по всем пунктам. А теперь — таблицу, где показано, что Fable 5.2 дешевле 5.1. Значит ли это, что Fable 5.1 устарела?
Для новых проектов — по сути да. Если у вас есть доступ к Fable 5.2, мало причин начинать что-то новое на 5.1. Однако Anthropic не объявляла дату вывода её из эксплуатации, и командам с промптами или агентами, настроенными под Fable 5.1, стоит протестировать 5.2 перед переходом. Мы знаем, что новая версия может вести себя иначе, даже если она набирает больше баллов.
Как получить доступ к Claude Fable 5.2
Приложения Claude: Fable 5.2 доступна в соответствующих платных планах. В рамках промо к запуску планы Pro и стандартные места в Team могут использовать Fable до 50% своих недельных лимитов, а планы с включённым Fable получают от одной до трёх дополнительных «сбросов» лимита в зависимости от срока подписки.
API: Используйте идентификатор модели
claude-fable-5-2на платформе Claude.Облачные платформы: Доступна в Amazon Web Services, Google Cloud и Microsoft Azure.
Mythos 5.2: Подайте заявку через программу Cyber Verification или Life Sciences Verification. Клиенты Claude Enterprise также могут использовать её через Claude Security.
Предприятия с жёсткими требованиями к данным могут использовать Enterprise Frontier Safeguards: система безопасности Anthropic запускается на данных, хранящихся в инфраструктуре клиента, и работает без сохранения данных. У остальных клиентов данные сохраняются 30 дней для мониторинга безопасности.
Итоги
Claude Fable 5.2 — значительный шаг вперёд по сравнению с Fable 5.1. Она дешевле, быстрее и реже отказывается от легитимной работы. Особенно велики скачки на Remote Labor Index, в робототехнике и на FrontierCode.
При этом Opus 5.5 остаётся более выгодным вариантом для повседневных задач — за половину цены. Возможно, самое интересное в Fable 5.2 — это заявления об эффективности: если она действительно повторяет лучшие результаты Opus 5.5 на низком или среднем уровне усилий, «премия» за токен быстро сокращается. Это стоит проверить на ваших задачах.
Если хотите попробовать Claude на практике, наш трек Developing AI Applications — хороший старт.