Aujourd’hui, Anthropic a annoncé Fable 5.2 pour tout le monde et Mythos 5.2 pour les organisations vérifiées. Il s’agit du même modèle sous-jacent, mais la version Fable inclut des garde-fous supplémentaires en cybersécurité et en biologie.
Les changements majeurs :
- un prix plus bas,
- une génération plus rapide, et
- de gros progrès sur les benchmarks les plus difficiles d’Anthropic.
Plus précisément, Fable 5.2 coûte 20 % de moins que Fable 5.1, génère des réponses jusqu’à 30 % plus vite et dépasse GPT-6 Astra et Gemini 4 Carbon sur la plupart des lignes du tableau de benchmarks d’Anthropic.
Dans cet article, je passe en revue les nouveautés de Fable 5.2 et Mythos 5.2, leurs performances sur les benchmarks, leurs tarifs, et comment décider si vous devez les préférer à Claude Opus 5.5.
Qu’est-ce que Claude Fable 5.2 ?
Claude Fable 5.2 est le modèle le plus performant d’Anthropic disponible généralement. Il est conçu pour des travaux techniques longs et exigeants : migrations de larges bases de code, exécutions d’agents sur plusieurs jours, sujets de recherche et conception ingénierie.
Fable 5.2 peut également travailler de concert avec des modèles plus petits, soit comme conseiller qu’ils consultent sur les problèmes ardus, soit comme orchestrateur qui leur délègue des sous-tâches plus simples.
Fable 5.2 conserve la fenêtre de contexte d’un million de tokens et la sortie maximale de 128 K de son prédécesseur, et sa date de connaissance s’arrête en juin 2026.
Qu’est-ce que Claude Mythos 5.2 ?
Claude Mythos 5.2 est le même modèle que Fable 5.2, mais sans les garde-fous qui bloquent la plupart des travaux de cybersécurité et les tâches de biologie de niveau recherche. En pratique, Mythos 5.2 est le modèle le plus performant d’Anthropic pour l’ingénierie en cybersécurité. Ces capacités étant à double usage, Anthropic ne propose Mythos 5.2 qu’à des organisations vérifiées via son Cyber Verification Program et son Life Sciences Verification Program.
Quoi de neuf dans Claude Fable 5.2 ?
Fable n’existe que depuis juin, lorsque Anthropic a publié Fable 5. Depuis, il y a eu deux versions intermédiaires, Fable 5.1 en septembre et désormais Fable 5.2, sans ajout notable de nouvelles fonctionnalités. Elles ont surtout rendu le modèle moins cher, plus rapide et plus solide, avec des gains de performance loin d’être mineurs : Fable 5.2 fait plus que doubler le score de Fable 5.1 sur le Remote Labor Index, par exemple.
La plus grande différence entre les deux vient des usages autorisés. Avec Fable 5.1, Anthropic a assoupli ses garde-fous de cybersécurité et a commencé à autoriser la détection de vulnérabilités logicielles, mais pas l’écriture d’exploits, et a annoncé les Enterprise Frontier Safeguards, une option pour garder vos données dans votre propre cloud, en même temps que la sortie. Les changements de garde-fous de Fable 5.2 sont plus modestes : il bloque moins de requêtes, mais les mêmes types de tâches restent interdits.
Les nouveaux schémas d’usage suggérés par Anthropic, comme faire de Fable 5.2 le conseiller de modèles Claude plus petits, ne sont pas nouveaux non plus, puisque l’outil advisor d’Anthropic prenait déjà en charge Fable 5 et 5.1. Et les démos de lancement, comme le système d’exploitation construit à partir d’un dossier vide, illustrent surtout un modèle plus fort réussissant des tâches plus difficiles, pas des options à activer.
Cela dit, si je devais pointer de vraies nouveautés, je citerais :
Un prix en baisse
Fable 5.2 coûte 8 $ par million de tokens en entrée et 40 $ par million de tokens en sortie, soit 20 % de moins que les 10 $/50 $ de Fable 5.1. La même baisse de 20 % s’applique aux lectures du cache (0,20 $), aux écritures dans le cache et au traitement par lots. Voir la section tarifs ci-dessous pour le détail.
Une génération plus rapide, et un mode rapide pour Fable
La sortie est jusqu’à 30 % plus rapide que Fable 5.1, ce qui compte sur une longue exécution d’agents. Fable prend aussi désormais en charge le mode rapide, qui accélère la génération jusqu’à 2,5 fois pour un prix doublé (16 $/80 $).
De meilleurs résultats avec moins d’effort
C’est sans doute ce qui influera le plus sur votre facture. À effort élevé, Fable 5.2 obtient 45,3 % sur FrontierCode 2.0, au niveau du meilleur score d’Opus 5.5, pour environ la moitié du coût par tâche. À effort faible, il égale le meilleur score d’Opus 5.5 sur Humanity’s Last Exam pour moins d’un dixième du coût par tâche. Mon conseil : si vous montez depuis Opus 5.5, commencez Fable 5.2 avec un effort plus faible.
Moins de requêtes bloquées
Fable 5.2 devrait rencontrer environ 55 % de blocages de sécurité en moins que Fable 5.1 (environ 60 % de moins en cybersécurité et 40 % de moins en biologie). C’est déterminant si les refus de Fable 5.1 vous freinaient, mais les catégories bloquées n’ont pas changé : tests d’intrusion, génération d’exploits et la plupart des travaux de biologie de niveau recherche restent transférés vers d’anciens modèles Claude.
Voici les principaux résultats. Ils proviennent tous du tableau de lancement d’Anthropic, à lire donc comme la défense du modèle par Anthropic plutôt que comme des résultats indépendants. Les scores de Claude ont été obtenus avec les garde-fous activés. Sauf mention, chaque modèle est présenté à son niveau d’effort maximal disponible.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (programmation agentique) | 49,1 % | 32,4 % | 45,5 % | 42,8 % | 41,1 % |
| FrontierSWE v2 (programmation agentique) | 69,9 % | 56,3 % | 62,3 % | 65,5 % | 61,2 % |
| AutomationBench (workflows métiers) | 51,4 % | 31,4 % | 42,5 % | 41,4 % | 53,9 % |
| Terminal-Bench-Science 0.1 | 74,6 % | 52,6 % | 58,7 % | 68,1 % | 64,8 % |
| OSWorld 2.1 (usage de l’ordinateur) | 89,3 % | 83,5 % | 87,2 % | 79,5 % | 81,5 % |
| RoboDojo Sim (robotique) | 64,9 % | 27,6 % | 39,4 % | 29,8 % | Non indiqué |
| AA-Briefcase v1.1 (travail de connaissance) | 66,1 % | 61,5 % | 61,2 % | 52,0 % | 61,8 % |
| Remote Labor Index (travail de connaissance) | 41,3 % | 17,9 % | 21,3 % | 20,8 % | Non indiqué |
| Humanity’s Last Exam (avec outils) | 74,2 % | 65,6 % | 67,7 % | 57,2 % | Non indiqué |
| WANDR (recherche agentique) | 82,1 % | 68,7 % | 72,3 % | Non indiqué | Non indiqué |
| Chartography (sans outils) | 73,4 % | 44,8 % | 64,4 % | 71,0 % | 72,5 % |
Programmation agentique
Fable 5.2 prend la tête sur les deux benchmarks de code du tableau. Sur FrontierCode 2.0, qui mesure si des mainteneurs open source accepteraient les modifications proposées par le modèle, il obtient 49,1 %, le meilleur score du tableau et bien au-dessus des 32,4 % de Fable 5.1. Sur FrontierSWE v2, il atteint 69,9 %, devant GPT-6 Astra (65,5 %) et Opus 5.5 (62,3 %).
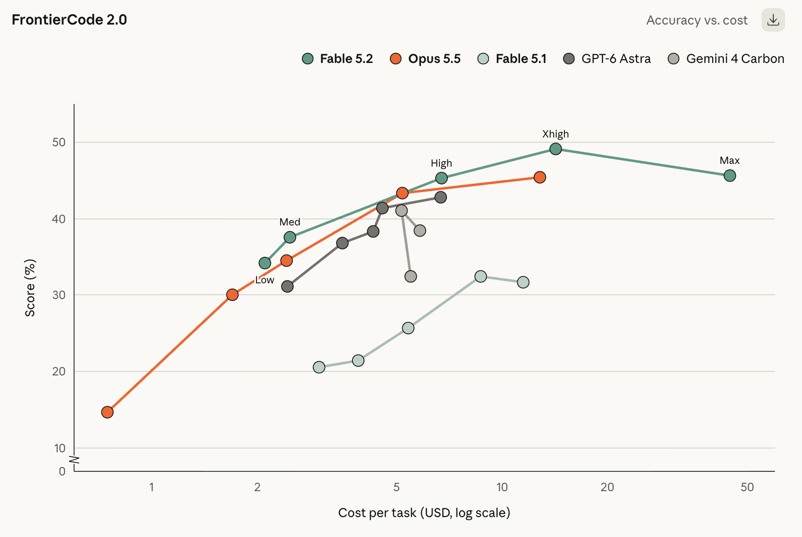
Les exemples de lancement vont dans le même sens : des agents exécutant une version précoce de Fable 5.2 ont migré un service de production de Python vers Rust, qui démarre désormais environ 26 fois plus vite.
Travail de connaissance et recherche
La plus forte progression relative concerne le Remote Labor Index, qui évalue la réussite de projets réalistes de type freelance. Fable 5.2 atteint 41,3 %, environ le double d’Opus 5.5 (21,3 %) et de GPT-6 Astra (20,8 %). Il prend également la tête sur Humanity’s Last Exam avec outils (74,2 %) et sur Terminal-Bench-Science (74,6 %, ou 75,3 % pour Mythos 5.2).
L’automatisation métier est le seul domaine où il est derrière. Sur AutomationBench, Gemini 4 Carbon obtient 53,9 % contre 51,4 % pour Fable 5.2, même si Fable 5.2 reste bien devant Fable 5.1 (31,4 %).
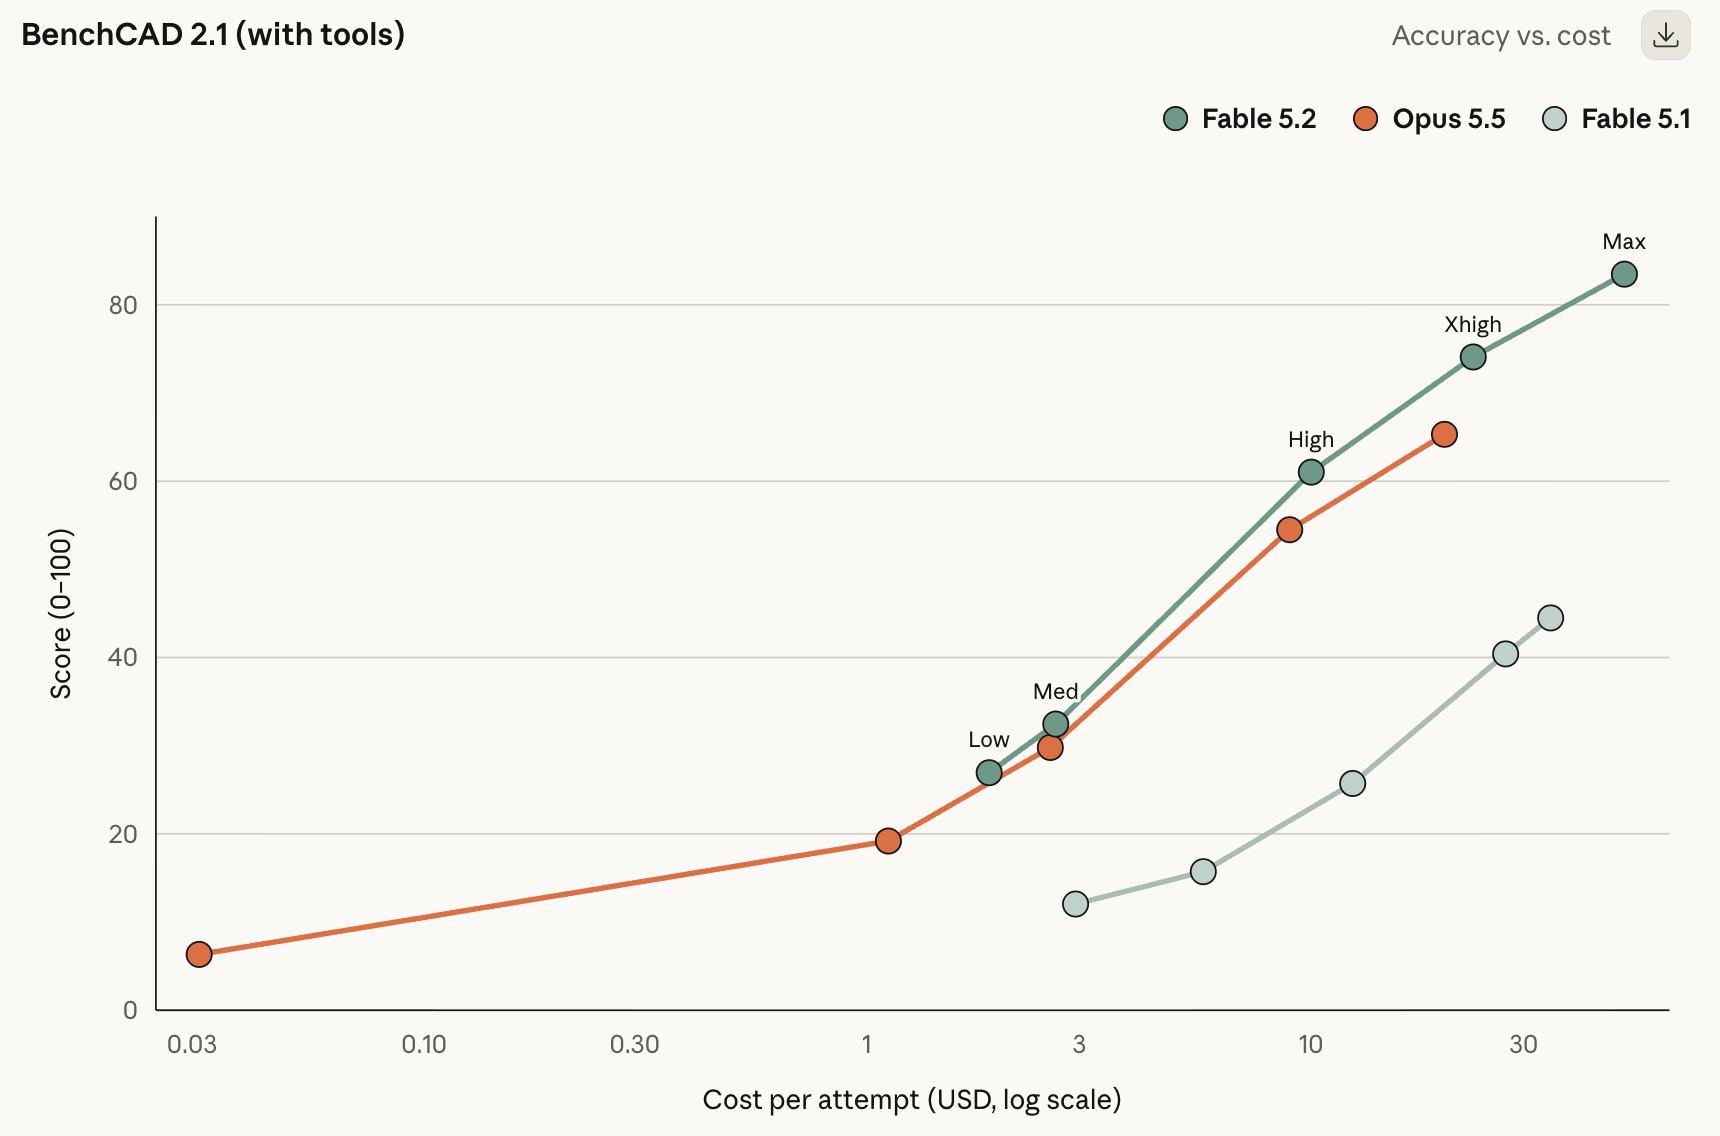
Hors tableau principal, Fable 5.2 a obtenu 83,5 sur le benchmark matériel BenchCAD 2.1, contre 65,3 pour Opus 5.5. Il est aussi crédité d’avoir résolu deux problèmes ouverts en physique des trous noirs, avec des prépublications permettant la vérification par d’autres physiciens.
Usage de l’ordinateur, robotique et vision
Fable 5.2 obtient 89,3 % sur OSWorld 2.1, devant Opus 5.5 (87,2 %) et GPT-6 Astra (79,5 %). Son bond en robotique est le plus marqué du tableau : 64,9 % sur RoboDojo Sim, plus du double de Fable 5.1 et de GPT-6 Astra. Sur Chartography, qui évalue la lecture de graphiques sans outils, il devance légèrement Gemini 4 Carbon et GPT-6 Astra, après un net retard de Fable 5.1 à 44,8 %.
Cybersécurité et biologie (Mythos 5.2)
Les lignes sécurité et biologie concernent Mythos 5.2, car les garde-fous de Fable 5.2 bloquent la plupart de ces tâches. Mythos 5.2 obtient 76,3 % sur CyScenarioBench (contre 61,7 % pour Mythos 5.1), 89,6 % sur CVE Rediscovery (contre 78,3 %) et 85,1 % sur une tâche de conception de liant protéique en 24 heures (contre 79,1 %). Pas de comparaison équitable ici avec le modèle sécurité d’OpenAI, chaque labo ayant exécuté ses propres tâches CyScenarioBench.
Et cette histoire de dernier théorème de Fermat ?
Une équipe d’agents Fable 5.2 a formalisé la démonstration du dernier théorème de Fermat dans l’assistant de preuves Lean en 30 heures. Vous vous demandez peut-être : le théorème n’a-t-il pas déjà été démontré il y a trois décennies ? Que restait-il à faire ?
Le théorème n’est plus un scoop
Le dernier théorème de Fermat affirme qu’il n’existe pas de nombres entiers positifs a, b et c tels que an + bn = cn pour un n supérieur à 2. Pour n = 2, il y a beaucoup de solutions, comme 32 + 42 = 52 (9 + 16 = 25). Mais avec des cubes, on n’obtient que des quasi-égalités : 63 + 83 = 728, à une unité de 93 = 729.
Pierre de Fermat affirmait en 1637 avoir une démonstration mais ne l’a jamais écrite, et le problème est resté ouvert plus de 350 ans jusqu’à la preuve d’Andrew Wiles au milieu des années 1990, avec l’aide de Richard Taylor.
La preuve de Wiles fait plus de 100 pages et repose sur des décennies de théorie des nombres avancée, si bien que très peu de personnes peuvent la vérifier de bout en bout. Lean est un assistant de preuves : un langage dans lequel on écrit une démonstration comme du code, et le logiciel vérifie chaque étape logique jusqu’aux axiomes de base des maths. Si la preuve compile, elle est correcte. « Formaliser » un théorème consiste à traduire la démonstration humaine dans cette forme vérifiable par machine.
Pour le théorème de Fermat, c’est un chantier immense, car une grande partie des mathématiques sous-jacentes n’avait jamais été écrite en Lean. Le mathématicien Kevin Buzzard a lancé en 2024 un projet communautaire pour le faire.
Pourquoi c’est intéressant pour un modèle d’IA
La plupart des sorties IA sont jugées par des humains ou par des benchmarks qui ne testent qu’une partie de la réponse. Une preuve Lean est différente : le vérificateur accepte chaque étape ou non, il n’y a pas de faux-positif subtil. C’est donc un test particulièrement net de la capacité d’un modèle à mener un projet très long et très difficile jusqu’à son terme vérifié.
Ce n’est pas une première pour Claude. En septembre, Anthropic a publié la première preuve complète vérifiée par ordinateur du théorème, écrite par des dizaines d’agents sur un modèle de recherche interne grosso modo comparable à Fable 5.1. Cet effort a pris 11 jours et environ six milliards de tokens de sortie, produit 13 millions de lignes de Lean, et s’est en partie appuyé sur des morceaux du projet de Buzzard. Fable 5.2 l’a fait en 30 heures, avec une aide humaine minimale.
Les bémolos
- Il n’apporte rien de nouveau aux mathématiques. Buzzard l’avait déjà dit de la première formalisation d’Anthropic.
- Fable 5.2 a reçu une liste d’énoncés intermédiaires pour suivre sa progression. C’est une feuille de route de quoi prouver, pas comment.
- Je n’ai pas vu d’évaluation externe de la nouvelle preuve pour l’instant ; les 30 heures et la comparaison à Opus 5.5 sont donc, pour l’heure, les affirmations d’Anthropic.
Le plus éloquent, toutefois, c’est ce qui s’est passé quand Anthropic a confié le même travail à Claude Opus 5.5.
Claude Fable 5.2 vs Claude Opus 5.5
Comparer deux modèles revient souvent à lire des scores de benchmarks et à deviner ce que ça donnerait en pratique. Cette fois, j’apprécie qu’Anthropic ait commencé par une histoire, qui rend l’écart plus concret.
Dans le même setup Lean à 1 000 agents, Opus 5.5 a bouclé 26 % de la preuve du théorème de Fermat en 18 heures et a très peu progressé ensuite. Fable 5.2 a terminé l’ensemble en 30 heures. La morale : sur des projets très longs et multi-agents, Opus 5.5 peut caler là où Fable 5.2 continue.
Sur des tâches plus courtes, l’écart est moindre. Voici la comparaison côte à côte :
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| Prix (entrée / sortie par 1 M de tokens) | 8 $ / 40 $ | 4 $ / 20 $ |
| Fenêtre de contexte / sortie max | 1 M / 128 K | 1 M / 128 K |
| FrontierCode 2.0 (programmation agentique) | 49,1 % | 45,5 % |
| FrontierSWE v2 (programmation agentique) | 69,9 % | 62,3 % |
| OSWorld 2.1 (usage de l’ordinateur) | 89,3 % | 87,2 % |
| AutomationBench (workflows métiers) | 51,4 % | 42,5 % |
| Humanity’s Last Exam (avec outils) | 74,2 % | 67,7 % |
| Remote Labor Index (travail de connaissance) | 41,3 % | 21,3 % |
| RoboDojo Sim (robotique) | 64,9 % | 39,4 % |
Le schéma confirme le résultat sur Lean. Pour l’usage de l’ordinateur et la programmation, Fable 5.2 n’a que quelques points d’avance. Sur les travaux ouverts et multi-étapes, l’écart se creuse : Fable 5.2 double presque le score d’Opus 5.5 sur les projets de type freelance du Remote Labor Index, et il a 25 points d’avance en contrôle de robot.
Le prix fait moins d’écart qu’il n’y paraît. Fable 5.2 coûte deux fois plus par token, mais atteint souvent le meilleur score d’Opus 5.5 avec un niveau d’effort plus bas, donc moins de tokens. Sur FrontierCode 2.0, par exemple, Fable 5.2 à effort élevé égale grosso modo le meilleur d’Opus 5.5 pour environ la moitié du coût par tâche.
Opus 5.5 reste donc le choix par défaut le plus pertinent. Mais si une tâche tourne pendant des heures, implique de nombreux agents, ou bute régulièrement avec Opus, Fable 5.2 a de fortes chances d’aller au bout, sans coûter autant de plus que le prix par token ne le laisse penser.
Sécurité et limites
Anthropic évalue comme faible le risque que ces modèles se comportent de manière dangereuse dans des situations critiques.
C’est difficile à vérifier de l’extérieur, donc les chiffres concrets sont utiles. Sur un audit comportemental automatisé d’environ 1©000 scénarios, Mythos 5.2 a obtenu le score de comportement dévoyé le plus bas des modèles comparés. Il était également moins susceptible d’halluciner les entrées, de déclarer à tort une tâche achevée ou de cacher un travail de moindre qualité.
Autres points intéressants à connaître qui font réfléchir :
- Conscience d’évaluation : Fable 5.2 et Mythos 5.2 disent soupçonner plus souvent être évalués que les modèles précédents, ce qui complique la fiabilité des évaluations comme celle ci-dessus.
- Compétences IA de recherche volontairement plafonnées : Anthropic a limité les gains des modèles sur deux sujets, l’optimisation de kernels d’accélérateur et l’amélioration d’architectures LLM, pour qu’ils performent au niveau d’Opus 5.5.
- Protections contre la distillation : Fable 5.2 bénéficie des mesures anti-distillation les plus fortes d’Anthropic, et le « preserved thinking », qui empêche de modifier le contexte précédent via l’API pour extraire le raisonnement, s’applique désormais à tous les comptes.
Quel modèle Claude utiliser ?
Mon conseil rejoint celui d’Anthropic : commencez avec Opus 5.5 et montez en gamme seulement si besoin. Voici la logique de gamme :
- Claude Opus 5.5 (4 $/20 $) : Le par défaut pour la plupart des tâches de code, de recherche et de travail de connaissance. Il coûte deux fois moins que Fable 5.2 par token et le talonne sur de nombreux benchmarks.
- Claude Fable 5.2 (8 $/40 $) : Pour les problèmes les plus difficiles, les longues exécutions multi-agents et les tâches où Opus 5.5 cale, comme les grandes migrations, le raisonnement de niveau recherche ou la conception matérielle. Testez-le à des niveaux d’effort plus bas avant de supposer qu’il faut le maximum.
- Claude Mythos 5.2 : Pour les équipes sécurité et les chercheurs en sciences de la vie vérifiés, qui ont besoin de capacités bloquées par les garde-fous de Fable 5.2.
- Claude Sonnet 5.5 et Haiku 5.5 : Pour des volumes élevés, des tâches plus simples ou sensibles à la latence, ou comme modèles « satellites » qu’orchestrent Fable 5.2.
Tarifs et disponibilité de Claude Fable 5.2
| Par 1 M de tokens | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Entrée | 8 $ | 10 $ | 4 $ |
| Sortie | 40 $ | 50 $ | 20 $ |
| Lectures du cache | 0,20 $ | 0,25 $ | 0,20 $ |
| Écritures de cache 5 min | 10 $ | 12,50 $ | 5 $ |
| Batch (entrée / sortie) | 4 $ / 20 $ | 5 $ / 25 $ | 2 $ / 10 $ |
| Mode rapide (entrée / sortie) | 16 $ / 80 $ | Non indiqué | 8 $ / 40 $ |
Nous venons de voir un tableau de résultats où Fable 5.2 dépasse Fable 5.1 partout. Maintenant, je vous montre un tableau où Fable 5.2 est moins cher que 5.1. Alors, Fable 5.1 est-il obsolète ?
Pour les nouveaux projets, pratiquement oui. Si vous avez accès à Fable 5.2, il y a peu de raisons de démarrer quoi que ce soit de nouveau sur 5.1. Anthropic n’a toutefois pas annoncé sa date de retrait, et les équipes dont les prompts ou agents sont accordés sur Fable 5.1 voudront tester 5.2 avant de basculer. On sait qu’une nouvelle version peut se comporter différemment même avec de meilleurs scores.
-
Applications Claude : Fable 5.2 est disponible sur les offres payantes éligibles. En promotion de lancement, les offres Pro et les sièges Team standards peuvent utiliser Fable jusqu’à 50 % de leurs limites d’utilisation hebdomadaire, et les formules incluant Fable bénéficient de une à trois réinitialisations d’usage selon la durée d’abonnement.
-
API : Utilisez l’ID de modèle claude-fable-5-2 sur la plateforme Claude.
-
Plateformes cloud : Disponible sur Amazon Web Services, Google Cloud et Microsoft Azure.
-
Mythos 5.2 : Demandez l’accès via le Cyber Verification Program ou le Life Sciences Verification Program. Les clients Claude Enterprise peuvent aussi l’utiliser via Claude Security.
Les entreprises avec des exigences strictes en matière de données peuvent utiliser Enterprise Frontier Safeguards, qui exécute la surveillance de sécurité d’Anthropic sur des données stockées dans l’infrastructure du client, avec rétention zéro. Les autres clients bénéficient d’une rétention de données de 30 jours pour la surveillance de sécurité.
En conclusion
Claude Fable 5.2 marque un vrai progrès par rapport à Fable 5.1. Il est moins cher, plus rapide, et moins enclin à refuser un travail légitime. Les bonds sur le Remote Labor Index, la robotique et FrontierCode sont particulièrement marquants.
Cela dit, Opus 5.5 reste l’option la plus rentable pour le quotidien à moitié prix. Le plus intéressant avec Fable 5.2 est peut-être l’argument d’efficacité : s’il égale vraiment les meilleurs scores d’Opus 5.5 avec un effort faible ou moyen, la prime par token fond rapidement. À tester sur vos propres charges.
Si vous voulez prendre Claude en main, notre parcours Developing AI Applications est un excellent point de départ.







Aujourd’hui, Anthropic a annoncé Fable 5.2 pour tout le monde et Mythos 5.2 pour les organisations vérifiées. Il s’agit du même modèle sous-jacent, mais la version Fable inclut des garde-fous supplémentaires en cybersécurité et en biologie.
Les changements majeurs :
Plus précisément, Fable 5.2 coûte 20 % de moins que Fable 5.1, génère des réponses jusqu’à 30 % plus vite et dépasse GPT-6 Astra et Gemini 4 Carbon sur la plupart des lignes du tableau de benchmarks d’Anthropic.
Dans cet article, je passe en revue les nouveautés de Fable 5.2 et Mythos 5.2, leurs performances sur les benchmarks, leurs tarifs, et comment décider si vous devez les préférer à Claude Opus 5.5.
Qu’est-ce que Claude Fable 5.2 ?
Claude Fable 5.2 est le modèle le plus performant d’Anthropic disponible généralement. Il est conçu pour des travaux techniques longs et exigeants : migrations de larges bases de code, exécutions d’agents sur plusieurs jours, sujets de recherche et conception ingénierie.
Fable 5.2 peut également travailler de concert avec des modèles plus petits, soit comme conseiller qu’ils consultent sur les problèmes ardus, soit comme orchestrateur qui leur délègue des sous-tâches plus simples.
Fable 5.2 conserve la fenêtre de contexte d’un million de tokens et la sortie maximale de 128 K de son prédécesseur, et sa date de connaissance s’arrête en juin 2026.
Qu’est-ce que Claude Mythos 5.2 ?
Claude Mythos 5.2 est le même modèle que Fable 5.2, mais sans les garde-fous qui bloquent la plupart des travaux de cybersécurité et les tâches de biologie de niveau recherche. En pratique, Mythos 5.2 est le modèle le plus performant d’Anthropic pour l’ingénierie en cybersécurité. Ces capacités étant à double usage, Anthropic ne propose Mythos 5.2 qu’à des organisations vérifiées via son Cyber Verification Program et son Life Sciences Verification Program.
Quoi de neuf dans Claude Fable 5.2 ?
Fable n’existe que depuis juin, lorsque Anthropic a publié Fable 5. Depuis, il y a eu deux versions intermédiaires, Fable 5.1 en septembre et désormais Fable 5.2, sans ajout notable de nouvelles fonctionnalités. Elles ont surtout rendu le modèle moins cher, plus rapide et plus solide, avec des gains de performance loin d’être mineurs : Fable 5.2 fait plus que doubler le score de Fable 5.1 sur le Remote Labor Index, par exemple.
La plus grande différence entre les deux vient des usages autorisés. Avec Fable 5.1, Anthropic a assoupli ses garde-fous de cybersécurité et a commencé à autoriser la détection de vulnérabilités logicielles, mais pas l’écriture d’exploits, et a annoncé les Enterprise Frontier Safeguards, une option pour garder vos données dans votre propre cloud, en même temps que la sortie. Les changements de garde-fous de Fable 5.2 sont plus modestes : il bloque moins de requêtes, mais les mêmes types de tâches restent interdits.
Les nouveaux schémas d’usage suggérés par Anthropic, comme faire de Fable 5.2 le conseiller de modèles Claude plus petits, ne sont pas nouveaux non plus, puisque l’outil advisor d’Anthropic prenait déjà en charge Fable 5 et 5.1. Et les démos de lancement, comme le système d’exploitation construit à partir d’un dossier vide, illustrent surtout un modèle plus fort réussissant des tâches plus difficiles, pas des options à activer.
Cela dit, si je devais pointer de vraies nouveautés, je citerais :
Un prix en baisse
Fable 5.2 coûte 8 $ par million de tokens en entrée et 40 $ par million de tokens en sortie, soit 20 % de moins que les 10 $/50 $ de Fable 5.1. La même baisse de 20 % s’applique aux lectures du cache (0,20 $), aux écritures dans le cache et au traitement par lots. Voir la section tarifs ci-dessous pour le détail.
Une génération plus rapide, et un mode rapide pour Fable
La sortie est jusqu’à 30 % plus rapide que Fable 5.1, ce qui compte sur une longue exécution d’agents. Fable prend aussi désormais en charge le mode rapide, qui accélère la génération jusqu’à 2,5 fois pour un prix doublé (16 $/80 $).
De meilleurs résultats avec moins d’effort
C’est sans doute ce qui influera le plus sur votre facture. À effort élevé, Fable 5.2 obtient 45,3 % sur FrontierCode 2.0, au niveau du meilleur score d’Opus 5.5, pour environ la moitié du coût par tâche. À effort faible, il égale le meilleur score d’Opus 5.5 sur Humanity’s Last Exam pour moins d’un dixième du coût par tâche. Mon conseil : si vous montez depuis Opus 5.5, commencez Fable 5.2 avec un effort plus faible.
Moins de requêtes bloquées
Fable 5.2 devrait rencontrer environ 55 % de blocages de sécurité en moins que Fable 5.1 (environ 60 % de moins en cybersécurité et 40 % de moins en biologie). C’est déterminant si les refus de Fable 5.1 vous freinaient, mais les catégories bloquées n’ont pas changé : tests d’intrusion, génération d’exploits et la plupart des travaux de biologie de niveau recherche restent transférés vers d’anciens modèles Claude.
Comment Claude Fable 5.2 s’en sort-il sur les benchmarks ?
Voici les principaux résultats. Ils proviennent tous du tableau de lancement d’Anthropic, à lire donc comme la défense du modèle par Anthropic plutôt que comme des résultats indépendants. Les scores de Claude ont été obtenus avec les garde-fous activés. Sauf mention, chaque modèle est présenté à son niveau d’effort maximal disponible.
Programmation agentique
Fable 5.2 prend la tête sur les deux benchmarks de code du tableau. Sur FrontierCode 2.0, qui mesure si des mainteneurs open source accepteraient les modifications proposées par le modèle, il obtient 49,1 %, le meilleur score du tableau et bien au-dessus des 32,4 % de Fable 5.1. Sur FrontierSWE v2, il atteint 69,9 %, devant GPT-6 Astra (65,5 %) et Opus 5.5 (62,3 %).
Les exemples de lancement vont dans le même sens : des agents exécutant une version précoce de Fable 5.2 ont migré un service de production de Python vers Rust, qui démarre désormais environ 26 fois plus vite.
Travail de connaissance et recherche
La plus forte progression relative concerne le Remote Labor Index, qui évalue la réussite de projets réalistes de type freelance. Fable 5.2 atteint 41,3 %, environ le double d’Opus 5.5 (21,3 %) et de GPT-6 Astra (20,8 %). Il prend également la tête sur Humanity’s Last Exam avec outils (74,2 %) et sur Terminal-Bench-Science (74,6 %, ou 75,3 % pour Mythos 5.2).
L’automatisation métier est le seul domaine où il est derrière. Sur AutomationBench, Gemini 4 Carbon obtient 53,9 % contre 51,4 % pour Fable 5.2, même si Fable 5.2 reste bien devant Fable 5.1 (31,4 %).
Hors tableau principal, Fable 5.2 a obtenu 83,5 sur le benchmark matériel BenchCAD 2.1, contre 65,3 pour Opus 5.5. Il est aussi crédité d’avoir résolu deux problèmes ouverts en physique des trous noirs, avec des prépublications permettant la vérification par d’autres physiciens.
Usage de l’ordinateur, robotique et vision
Fable 5.2 obtient 89,3 % sur OSWorld 2.1, devant Opus 5.5 (87,2 %) et GPT-6 Astra (79,5 %). Son bond en robotique est le plus marqué du tableau : 64,9 % sur RoboDojo Sim, plus du double de Fable 5.1 et de GPT-6 Astra. Sur Chartography, qui évalue la lecture de graphiques sans outils, il devance légèrement Gemini 4 Carbon et GPT-6 Astra, après un net retard de Fable 5.1 à 44,8 %.
Cybersécurité et biologie (Mythos 5.2)
Les lignes sécurité et biologie concernent Mythos 5.2, car les garde-fous de Fable 5.2 bloquent la plupart de ces tâches. Mythos 5.2 obtient 76,3 % sur CyScenarioBench (contre 61,7 % pour Mythos 5.1), 89,6 % sur CVE Rediscovery (contre 78,3 %) et 85,1 % sur une tâche de conception de liant protéique en 24 heures (contre 79,1 %). Pas de comparaison équitable ici avec le modèle sécurité d’OpenAI, chaque labo ayant exécuté ses propres tâches CyScenarioBench.
Et cette histoire de dernier théorème de Fermat ?
Une équipe d’agents Fable 5.2 a formalisé la démonstration du dernier théorème de Fermat dans l’assistant de preuves Lean en 30 heures. Vous vous demandez peut-être : le théorème n’a-t-il pas déjà été démontré il y a trois décennies ? Que restait-il à faire ?
Le théorème n’est plus un scoop
Le dernier théorème de Fermat affirme qu’il n’existe pas de nombres entiers positifs a, b et c tels que an + bn = cn pour un n supérieur à 2. Pour n = 2, il y a beaucoup de solutions, comme 32 + 42 = 52 (9 + 16 = 25). Mais avec des cubes, on n’obtient que des quasi-égalités : 63 + 83 = 728, à une unité de 93 = 729.
Pierre de Fermat affirmait en 1637 avoir une démonstration mais ne l’a jamais écrite, et le problème est resté ouvert plus de 350 ans jusqu’à la preuve d’Andrew Wiles au milieu des années 1990, avec l’aide de Richard Taylor.
Ce qu’est une formalisation Lean
La preuve de Wiles fait plus de 100 pages et repose sur des décennies de théorie des nombres avancée, si bien que très peu de personnes peuvent la vérifier de bout en bout. Lean est un assistant de preuves : un langage dans lequel on écrit une démonstration comme du code, et le logiciel vérifie chaque étape logique jusqu’aux axiomes de base des maths. Si la preuve compile, elle est correcte. « Formaliser » un théorème consiste à traduire la démonstration humaine dans cette forme vérifiable par machine.
Pour le théorème de Fermat, c’est un chantier immense, car une grande partie des mathématiques sous-jacentes n’avait jamais été écrite en Lean. Le mathématicien Kevin Buzzard a lancé en 2024 un projet communautaire pour le faire.
Pourquoi c’est intéressant pour un modèle d’IA
La plupart des sorties IA sont jugées par des humains ou par des benchmarks qui ne testent qu’une partie de la réponse. Une preuve Lean est différente : le vérificateur accepte chaque étape ou non, il n’y a pas de faux-positif subtil. C’est donc un test particulièrement net de la capacité d’un modèle à mener un projet très long et très difficile jusqu’à son terme vérifié.
Ce n’est pas une première pour Claude. En septembre, Anthropic a publié la première preuve complète vérifiée par ordinateur du théorème, écrite par des dizaines d’agents sur un modèle de recherche interne grosso modo comparable à Fable 5.1. Cet effort a pris 11 jours et environ six milliards de tokens de sortie, produit 13 millions de lignes de Lean, et s’est en partie appuyé sur des morceaux du projet de Buzzard. Fable 5.2 l’a fait en 30 heures, avec une aide humaine minimale.
Les bémolos
Le plus éloquent, toutefois, c’est ce qui s’est passé quand Anthropic a confié le même travail à Claude Opus 5.5.
Claude Fable 5.2 vs Claude Opus 5.5
Comparer deux modèles revient souvent à lire des scores de benchmarks et à deviner ce que ça donnerait en pratique. Cette fois, j’apprécie qu’Anthropic ait commencé par une histoire, qui rend l’écart plus concret.
Dans le même setup Lean à 1 000 agents, Opus 5.5 a bouclé 26 % de la preuve du théorème de Fermat en 18 heures et a très peu progressé ensuite. Fable 5.2 a terminé l’ensemble en 30 heures. La morale : sur des projets très longs et multi-agents, Opus 5.5 peut caler là où Fable 5.2 continue.
Sur des tâches plus courtes, l’écart est moindre. Voici la comparaison côte à côte :
Le schéma confirme le résultat sur Lean. Pour l’usage de l’ordinateur et la programmation, Fable 5.2 n’a que quelques points d’avance. Sur les travaux ouverts et multi-étapes, l’écart se creuse : Fable 5.2 double presque le score d’Opus 5.5 sur les projets de type freelance du Remote Labor Index, et il a 25 points d’avance en contrôle de robot.
Le prix fait moins d’écart qu’il n’y paraît. Fable 5.2 coûte deux fois plus par token, mais atteint souvent le meilleur score d’Opus 5.5 avec un niveau d’effort plus bas, donc moins de tokens. Sur FrontierCode 2.0, par exemple, Fable 5.2 à effort élevé égale grosso modo le meilleur d’Opus 5.5 pour environ la moitié du coût par tâche.
Opus 5.5 reste donc le choix par défaut le plus pertinent. Mais si une tâche tourne pendant des heures, implique de nombreux agents, ou bute régulièrement avec Opus, Fable 5.2 a de fortes chances d’aller au bout, sans coûter autant de plus que le prix par token ne le laisse penser.
Sécurité et limites
Anthropic évalue comme faible le risque que ces modèles se comportent de manière dangereuse dans des situations critiques.
C’est difficile à vérifier de l’extérieur, donc les chiffres concrets sont utiles. Sur un audit comportemental automatisé d’environ 1©000 scénarios, Mythos 5.2 a obtenu le score de comportement dévoyé le plus bas des modèles comparés. Il était également moins susceptible d’halluciner les entrées, de déclarer à tort une tâche achevée ou de cacher un travail de moindre qualité.
Autres points intéressants à connaître qui font réfléchir :
Quel modèle Claude utiliser ?
Mon conseil rejoint celui d’Anthropic : commencez avec Opus 5.5 et montez en gamme seulement si besoin. Voici la logique de gamme :
Tarifs et disponibilité de Claude Fable 5.2
Nous venons de voir un tableau de résultats où Fable 5.2 dépasse Fable 5.1 partout. Maintenant, je vous montre un tableau où Fable 5.2 est moins cher que 5.1. Alors, Fable 5.1 est-il obsolète ?
Pour les nouveaux projets, pratiquement oui. Si vous avez accès à Fable 5.2, il y a peu de raisons de démarrer quoi que ce soit de nouveau sur 5.1. Anthropic n’a toutefois pas annoncé sa date de retrait, et les équipes dont les prompts ou agents sont accordés sur Fable 5.1 voudront tester 5.2 avant de basculer. On sait qu’une nouvelle version peut se comporter différemment même avec de meilleurs scores.
Comment accéder à Claude Fable 5.2
Applications Claude : Fable 5.2 est disponible sur les offres payantes éligibles. En promotion de lancement, les offres Pro et les sièges Team standards peuvent utiliser Fable jusqu’à 50 % de leurs limites d’utilisation hebdomadaire, et les formules incluant Fable bénéficient de une à trois réinitialisations d’usage selon la durée d’abonnement.
API : Utilisez l’ID de modèle
claude-fable-5-2sur la plateforme Claude.Plateformes cloud : Disponible sur Amazon Web Services, Google Cloud et Microsoft Azure.
Mythos 5.2 : Demandez l’accès via le Cyber Verification Program ou le Life Sciences Verification Program. Les clients Claude Enterprise peuvent aussi l’utiliser via Claude Security.
Les entreprises avec des exigences strictes en matière de données peuvent utiliser Enterprise Frontier Safeguards, qui exécute la surveillance de sécurité d’Anthropic sur des données stockées dans l’infrastructure du client, avec rétention zéro. Les autres clients bénéficient d’une rétention de données de 30 jours pour la surveillance de sécurité.
En conclusion
Claude Fable 5.2 marque un vrai progrès par rapport à Fable 5.1. Il est moins cher, plus rapide, et moins enclin à refuser un travail légitime. Les bonds sur le Remote Labor Index, la robotique et FrontierCode sont particulièrement marquants.
Cela dit, Opus 5.5 reste l’option la plus rentable pour le quotidien à moitié prix. Le plus intéressant avec Fable 5.2 est peut-être l’argument d’efficacité : s’il égale vraiment les meilleurs scores d’Opus 5.5 avec un effort faible ou moyen, la prime par token fond rapidement. À tester sur vos propres charges.
Si vous voulez prendre Claude en main, notre parcours Developing AI Applications est un excellent point de départ.