I dag tillkännagav Anthropic Fable 5.2 för alla och Mythos 5.2 för granskade organisationer. Det är samma underliggande modell, men Fable-versionen har extra skydd för cybersäkerhet och biologi.
Huvudnyheterna är:
- ett lägre pris,
- snabbare utdata, och
- stora lyft på Anthropics svåraste benchmarktester.
Mer specifikt kostar Fable 5.2 20% mindre än Fable 5.1, genererar utdata upp till 30% snabbare och slår GPT-6 Astra och Gemini 4 Carbon på de flesta rader i Anthropics benchmarktabell.
I den här artikeln går jag igenom vad som är nytt i Fable 5.2 och Mythos 5.2, hur de presterar på benchmarktester, vad de kostar och hur du avgör om du behöver dem i stället för Claude Opus 5.5.
Vad är Claude Fable 5.2?
Claude Fable 5.2 är Anthropics mest kapabla allmänt tillgängliga modell. Den är byggd för långvarigt, krävande tekniskt arbete: migrering av stora kodbaser, flerdagars agentkörningar, forskningsproblem och ingenjörsdesign.
Fable 5.2 kan också arbeta tillsammans med de mindre modellerna, antingen som en rådgivare de konsulterar i svåra problem eller som en orkestrerare som lämnar enklare deluppgifter vidare till dem.
Fable 5.2 behåller föregångarens kontextfönster på 1M token och maxutdata på 128K, och dess kunskapsstopp är juni 2026.
Vad är Claude Mythos 5.2?
Claude Mythos 5.2 är samma modell som Fable 5.2 men utan de skydd som blockerar det mesta cybersäkerhetsarbetet och biologi på forskningsnivå. Faktum är att Mythos 5.2 är Anthropics mest kapabla modell för cybersäkerhetsengineering. Eftersom dessa typer av förmågor är dubbelanvändbara erbjuder Anthropic endast Mythos 5.2 till granskade organisationer via sitt Cyber Verification Program och Life Sciences Verification Program.
Vad är nytt i Claude Fable 5.2?
Fable har bara funnits sedan juni, då Anthropic släppte Fable 5. Sedan dess har det kommit två punktversioner, Fable 5.1 i september och nu Fable 5.2, och ingen av dem har lagt till särskilt många nya funktioner. Båda har mest gjort modellen billigare, snabbare och starkare, även om prestandalyften inte har varit små: Fable 5.2 mer än fördubblar till exempel Fable 5.1:s poäng på Remote Labor Index.
Den större skillnaden mellan de två versionerna ligger i hur du får använda modellen. Med Fable 5.1 snävade Anthropic in sina cybersäkerhetsskydd och började tillåta att modellen användes för att hitta programvarusårbarheter, men inte för att skriva exploiter för dem, och man lanserade Enterprise Frontier Safeguards, ett alternativ för att behålla dina data i ditt eget moln, samtidigt med releasen. Fable 5.2:s skyddsförändringar är mindre: den blockerar färre förfrågningar, men samma typer av uppgifter är fortfarande otillåtna.
De nya sätten Anthropic föreslår att använda den på, som att låta Fable 5.2 ge råd till mindre Claude-modeller, är inte heller nya, eftersom Anthropics advisor-verktyg redan stödde Fable 5 och 5.1. Och lanseringsdemon, som operativsystemet byggt från en tom mapp, visar en starkare modell som gör svårare saker, inte nya funktioner du kan slå på.
Med det sagt, om jag ska peka på nya saker, är det här vad jag skulle nämna:
Ett lägre pris
Fable 5.2 kostar 8 USD per miljon inmatade token och 40 USD per miljon utmatade token, 20% mindre än Fable 5.1:s 10/50 USD. Samma 20%-iga sänkning gäller för cacheläsningar (0,20 USD), cache-skrivningar och batchbearbetning. Se avsnittet om priser nedan för fullständig uppdelning.
Snabbare utdata, och snabbt läge för Fable
Utdata är upp till 30% snabbare än Fable 5.1, vilket märks under en lång agentkörning. Fable stöder nu också snabbt läge, som kan snabba upp utdata med upp till 2,5x till dubbla priset (16/80 USD).
Bättre resultat med mindre ansträngning
Det här är förändringen som troligast påverkar din nota. Vid hög ansträngning får Fable 5.2 45,3% på FrontierCode 2.0, ungefär i nivå med Opus 5.5:s bästa poäng, till ungefär halva kostnaden per uppgift. Vid låg ansträngning matchar den Opus 5.5:s toppresultat på Humanity's Last Exam till mindre än en tiondel av kostnaden per uppgift. Min tolkning: Om du går upp från Opus 5.5, börja med Fable 5.2 på en lägre ansträngningsnivå.
Färre blockerade förfrågningar
Fable 5.2 bör hamna på cirka 55% färre säkerhetsblockeringar än Fable 5.1 (cirka 60% färre inom cybersäkerhet och 40% färre inom biologi). Det är viktigt om Fable 5.1:s vägran stod i vägen för dig, men kategorierna som blockeras har inte ändrats: penetrationstester, exploitering och det mesta arbete på forskningsnivå inom biologi lämnas fortfarande över till äldre Claude-modeller.
Hur presterar Claude Fable 5.2 på benchmarktester?
Här är huvudresultaten. De kommer alla från Anthropics lanseringstabell, så läs dem som Anthropics argument för modellen snarare än oberoende resultat. Claude-poängen kördes med skydd aktiverade. Om inte annat anges visas varje modell på sin högsta tillgängliga ansträngning.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (agentiskt kodande) | 49,1% | 32,4% | 45,5% | 42,8% | 41,1% |
| FrontierSWE v2 (agentiskt kodande) | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench (affärsarbetsflöden) | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Terminal-Bench-Science 0.1 | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| OSWorld 2.1 (datoranvändning) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| RoboDojo Sim (robotik) | 64,9% | 27,6% | 39,4% | 29,8% | Inte rapporterat |
| AA-Briefcase v1.1 (kunskapsarbete) | 66,1% | 61,5% | 61,2% | 52,0% | 61,8% |
| Remote Labor Index (kunskapsarbete) | 41,3% | 17,9% | 21,3% | 20,8% | Inte rapporterat |
| Humanity's Last Exam (med verktyg) | 74,2% | 65,6% | 67,7% | 57,2% | Inte rapporterat |
| WANDR (agentisk sökning) | 82,1% | 68,7% | 72,3% | Inte rapporterat | Inte rapporterat |
| Chartography (inga verktyg) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
Agentiskt kodande
Fable 5.2 leder båda kodningsbenchmarks i tabellen. På FrontierCode 2.0, som mäter om underhållare av öppen källkod skulle slå samman en modells kodändringar, får den 49,1%, högst i tabellen och klart över Fable 5.1:s 32,4%. På FrontierSWE v2 får den 69,9%, före GPT-6 Astra (65,5%) och Opus 5.5 (62,3%).
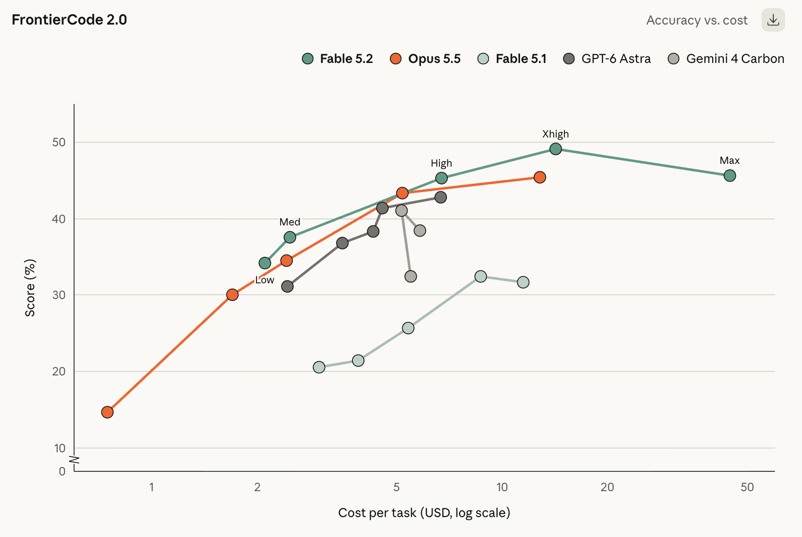
Lanseringsexemplen pekar åt samma håll: agenter som körde en tidig version av Fable 5.2 migrerade en produktionstjänst från Python till Rust, och den startar nu cirka 26 gånger snabbare.
Kunskapsarbete och forskning
Det största relativa lyftet är på Remote Labor Index, som mäter hur väl en modell slutför verkliga frilansliknande projekt. Fable 5.2 får 41,3%, ungefär dubbelt upp mot Opus 5.5 (21,3%) och GPT-6 Astra (20,8%). Den leder också på Humanity's Last Exam med verktyg (74,2%) och på Terminal-Bench-Science (74,6%, eller 75,3% för Mythos 5.2).
Affärsautomation är det enda område där den ligger efter. På AutomationBench får Gemini 4 Carbon 53,9% mot Fable 5.2:s 51,4%, även om Fable 5.2 fortfarande ligger långt före Fable 5.1 (31,4%).
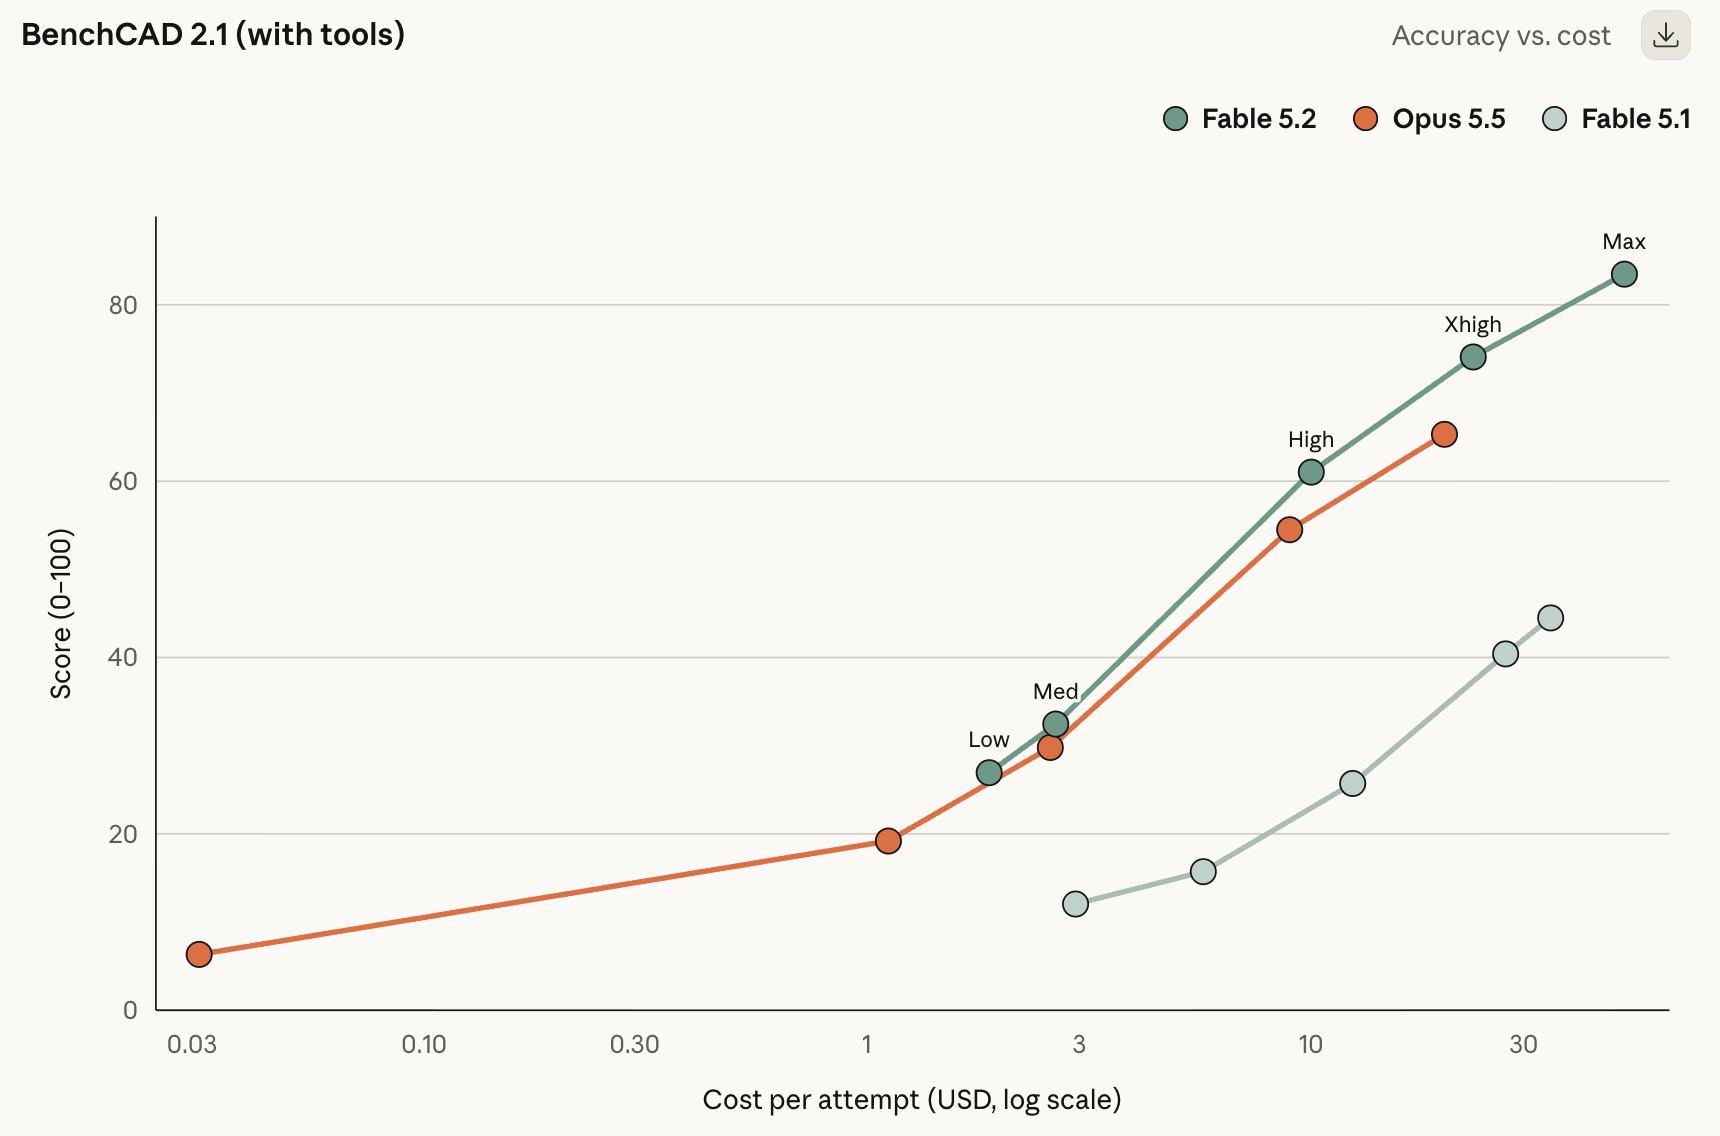
Utanför huvudtabellen fick Fable 5.2 83,5 på BenchCAD 2.1, ett benchmarktest för hårdvaruengineering, jämfört med 65,3 för Opus 5.5. Den tillskrivs också att ha löst två öppna problem inom svart hål-fysik, och resultaten är publicerade som preprints som andra fysiker kan granska.
Datoranvändning, robotik och bildförståelse
Fable 5.2 får 89,3% på OSWorld 2.1, före Opus 5.5 (87,2%) och GPT-6 Astra (79,5%). Hoppet inom robotik är det största i tabellen: 64,9% på RoboDojo Sim, mer än dubbelt upp mot Fable 5.1 och GPT-6 Astra. På Chartography, som testar avläsning av diagram utan verktyg, kniper den före Gemini 4 Carbon och GPT-6 Astra, efter att Fable 5.1 låg rejält efter med 44,8%.
Cybersäkerhet och biologi (Mythos 5.2)
Raderna om säkerhet och biologi gäller Mythos 5.2, eftersom Fable 5.2:s skydd blockerar det mesta av dessa uppgifter. Mythos 5.2 får 76,3% på CyScenarioBench (mot 61,7% för Mythos 5.1), 89,6% på CVE Rediscovery (mot 78,3%) och 85,1% på en 24-timmars uppgift för design av proteinbindare (mot 79,1%). Det finns ingen rättvis jämförelse med OpenAI:s säkerhetsmodell här, eftersom varje labb körde sina egna CyScenarioBench-uppgifter.
Vad handlar det här om Fermats sista sats?
Ett team av Fable 5.2-agenter formaliserade beviset för Fermats sista sats i bevisassistenten Lean på 30 timmar. Du kanske undrar: bevisades inte satsen för tre decennier sedan, så vad återstår att göra?
Satsen är gammal nyhet
Fermats sista sats säger att det inte finns några positiva heltal a, b och c där an + bn = cn för något n större än 2. För n = 2 finns många lösningar, som 32 + 42 = 52 (9 + 16 = 25). Men prova kuber och du får bara nästanträffar: 63 + 83 = 728, en ifrån 93 = 729.
Pierre de Fermat hävdade ett bevis 1637 men skrev aldrig ned det, och det förblev olöst i mer än 350 år tills Andrew Wiles bevisade det i mitten av 1990-talet, med hjälp av Richard Taylor.
Wiles bevis är över 100 sidor långt och vilar på decennier av avancerad talteori, så väldigt få kan kontrollera det från början till slut. Lean är en bevisassistent: ett programmeringsspråk där du skriver ett bevis som kod, och programvaran kontrollerar varje logiskt steg hela vägen ned till matematikens grundaxiom. Om beviset kompilerar är det korrekt. Att "formalisera" en sats betyder att översätta det mänskligt skrivna beviset till denna maskinverifierbara form.
För Fermats sista sats är det ett enormt arbete, eftersom mycket av den matematik som beviset bygger på aldrig hade skrivits i Lean. Matematikern Kevin Buzzard startade ett communityprojekt för att göra det 2024.
Varför det är intressant för en AI-modell
Det mesta AI-utdata bedöms av människor eller av benchmarktester som bara testar delar av svaret. Ett Lean-bevis är annorlunda: kontrollprogrammet accepterar antingen varje steg eller inte, så det går inte att vara subtilt fel. Det gör det till ett ovanligt rent test av om en modell kan bära ett mycket långt, mycket svårt projekt hela vägen till ett verifierat slut.
Det här är inte första gången Claude gör detta. I september publicerade Anthropic det första fullständiga datorgranskade beviset av satsen, skrivet av dussintals agenter som körde en intern forskningsmodell ungefär jämförbar med Fable 5.1. Den insatsen tog 11 dagar och cirka sex miljarder utmatade token, producerade 13 miljoner rader Lean och byggde delvis på delar av Buzzards projekt. Fable 5.2 gjorde det på 30 timmar, med minimal mänsklig hjälp.
Varningarna
- Det tillför inget till matematiken. Buzzard sade detsamma om Anthropics första formalisering.
- Fable 5.2 fick en lista med mellanliggande satsformuleringar för att följa sin framsteg. Det är en färdplan för vad som ska bevisas, men inte hur.
- Jag kunde inte hitta någon extern granskning av det nya beviset ännu, så för tillfället är siffran 30 timmar och jämförelsen med Opus 5.5 Anthropics påståenden.
Det mest talande är ändå vad som hände när Anthropic gav Claude Opus 5.5 samma uppgift.
Claude Fable 5.2 vs. Claude Opus 5.5
Att jämföra två modeller innebär oftast att läsa benchmarkpoäng och försöka sluta sig till hur skillnaden skulle se ut i praktiken. Den här gången uppskattar jag att Anthropic började med en berättelse, vilket gör gapet tydligare.
I samma Lean-setup med 1 000 agenter slutförde Opus 5.5 26% av beviset för Fermats sista sats på 18 timmar och kom knappt vidare efter det. Fable 5.2 slutförde allt på 30 timmar. Slutsatsen: på mycket långa, multiagent-projekt kan Opus 5.5 köra fast där Fable 5.2 fortsätter.
På kortare uppgifter är gapet mindre. Så här står de mot varandra sida vid sida:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| Pris (inmatning / utmatning per 1M token) | 8 USD / 40 USD | 4 USD / 20 USD |
| Kontextfönster / maxutdata | 1M / 128K | 1M / 128K |
| FrontierCode 2.0 (agentiskt kodande) | 49,1% | 45,5% |
| FrontierSWE v2 (agentiskt kodande) | 69,9% | 62,3% |
| OSWorld 2.1 (datoranvändning) | 89,3% | 87,2% |
| AutomationBench (affärsarbetsflöden) | 51,4% | 42,5% |
| Humanity's Last Exam (med verktyg) | 74,2% | 67,7% |
| Remote Labor Index (kunskapsarbete) | 41,3% | 21,3% |
| RoboDojo Sim (robotik) | 64,9% | 39,4% |
Mönstret matchar Lean-resultatet. Inom datoranvändning och kodning ligger Fable 5.2 bara några poäng före. På öppna, flerstegade uppgifter växer ledningen: Fable 5.2 nästan fördubblar Opus 5.5:s poäng på de frilansliknande projekten i Remote Labor Index, och den ligger 25 poäng före i robotstyrning.
Priset är mindre av ett gap än det ser ut. Fable 5.2 kostar dubbelt så mycket per token, men kan ofta nå Opus 5.5:s bästa poäng på en lägre ansträngningsnivå och använda färre token. På FrontierCode 2.0 matchar till exempel Fable 5.2 vid hög ansträngning ungefär Opus 5.5:s bästa till ungefär halva kostnaden per uppgift.
Så Opus 5.5 är fortfarande det vettiga standardvalet. Men om en uppgift kör i timmar, involverar många agenter eller ständigt kör fast på Opus, är Fable 5.2 troligen den som slutför den, och det behöver inte kosta så mycket mer som priset per token antyder.
Säkerhet och begränsningar
Anthropic bedömer risken att dessa modeller beter sig osäkert i situationer med höga insatser som låg.
Det är svårt att kontrollera utifrån, så de mer konkreta siffrorna är användbara. På en automatiserad beteendegranskning av cirka 1 900 scenarier hade Mythos 5.2 den lägsta poängen för felriktat beteende bland de jämförda modellerna. Den var också mindre benägen att hallucinerade indata, felaktigt påstå att en uppgift var klar eller dölja dåligt arbete.
Det finns några andra intressanta delar som är värda att känna till och som får dig att tänka:
- Medvetenhet om utvärdering: Både Fable 5.2 och Mythos 5.2 säger att de misstänker att de testas oftare än tidigare modeller, vilket gör utvärderingar som den ovan svårare att lita på.
- Avsiktligt begränsade AI-forskningsfärdigheter: Anthropic begränsade modellernas förbättringar inom två områden, optimering av accelerator-kärnor och förbättring av LLM-arkitekturer, så att de presterar ungefär på Opus 5.5:s nivå där.
- Skydd mot destillering: Fable 5.2 har Anthropics starkaste antidestilleringsåtgärder hittills, och "preserved thinking", som hindrar API-användare från att redigera tidigare kontext för att extrahera modellens resonemang, gäller nu för alla konton.
Vilken Claude-modell ska du använda?
Mitt råd matchar Anthropics: börja med Opus 5.5 och gå upp först när du behöver. Så här ser uppställningen ut:
- Claude Opus 5.5 (4/20 USD): Standardvalet för det mesta kodning, forskning och kunskapsarbete. Den kostar hälften så mycket som Fable 5.2 per token och ligger strax bakom på många benchmarktester.
- Claude Fable 5.2 (8/40 USD): För de svåraste problemen, långa multiagent-körningar och uppgifter där Opus 5.5 kör fast, såsom stora migreringar, resonemang på forskningsnivå eller hårdvarudesign. Prova på lägre ansträngningsnivåer innan du antar att du behöver max.
- Claude Mythos 5.2: För granskade säkerhetsteam och forskare inom livsvetenskaper som behöver förmågor som Fable 5.2:s skydd blockerar.
- Claude Sonnet 5.5 och Haiku 5.5: För högvolym, enklare eller latenskänsliga uppgifter, eller som de mindre modeller som Fable 5.2 orkestrerar.
Priser och tillgänglighet för Claude Fable 5.2
| Per 1M token | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Inmatning | 8 USD | 10 USD | 4 USD |
| Utmatning | 40 USD | 50 USD | 20 USD |
| Cacheläsningar | 0,20 USD | 0,25 USD | 0,20 USD |
| 5-minuters cache-skrivningar | 10 USD | 12,50 USD | 5 USD |
| Batch (inmatning / utmatning) | 4 USD / 20 USD | 5 USD / 25 USD | 2 USD / 10 USD |
| Snabbt läge (inmatning / utmatning) | 16 USD / 80 USD | Inte listat | 8 USD / 40 USD |
Vi hade just tittat på en tabell med benchmarkresultat som visade att Fable 5.2 slår Fable 5.1 på allt som listas. Nu visar jag dig en tabell som visar att Fable 5.2 är billigare än 5.1. Så är Fable 5.1 föråldrad?
För nytt arbete, i praktiken ja. Om du har tillgång till Fable 5.2 finns det liten anledning att starta något nytt på 5.1. Anthropic har dock inte meddelat något pensionsdatum för den, och team med promptar eller agenter fintrimmade för Fable 5.1 kommer att vilja testa 5.2 innan de byter. Vi vet att en ny version kan bete sig annorlunda även när den får bättre poäng.
Så får du tillgång till Claude Fable 5.2
-
Claude-appar: Fable 5.2 finns på berättigade betalda planer. Som lanseringskampanj kan Pro-planer och vanliga Team-licenser använda Fable för upp till 50% av sina veckovisa användningsgränser, och planer som inkluderar Fable får en till tre användningsåterställningar beroende på abonnemangets längd.
-
API: Använd modell-ID:t claude-fable-5-2 på Claude Platform.
-
Molnplattformar: Den finns på Amazon Web Services, Google Cloud och Microsoft Azure.
-
Mythos 5.2: Ansök via Cyber Verification Program eller Life Sciences Verification Program. Claude Enterprise-kunder kan också använda den via Claude Security.
Företag med strikta datakrav kan använda Enterprise Frontier Safeguards, som kör Anthropics säkerhetsövervakning på data som lagras i kundens egen infrastruktur och fungerar med noll datalagring. Andra kunder har 30 dagars datalagring för säkerhetsövervakning.
Avslutande tankar
Claude Fable 5.2 är ett meningsfullt steg upp från Fable 5.1. Den är billigare, snabbare och mindre benägen att vägra legitimt arbete. Lyften på Remote Labor Index, robotik och FrontierCode är särskilt stora.
Det sagt, Opus 5.5 är fortfarande det bättre värdet för de flesta vardagliga uppgifter till halva priset. Det mest intressanta med Fable 5.2 kan vara effektivitetsanspråken: om den verkligen matchar Opus 5.5:s bästa poäng vid låg eller medelhög ansträngning krymper premiepriset per token snabbt. Det är värt att testa på dina egna arbetsbelastningar.
Om du vill testa Claude praktiskt är vår Developing AI Applications-track en bra startpunkt.
I dag tillkännagav Anthropic Fable 5.2 för alla och Mythos 5.2 för granskade organisationer. Det är samma underliggande modell, men Fable-versionen har extra skydd för cybersäkerhet och biologi.
Huvudnyheterna är:
Mer specifikt kostar Fable 5.2 20% mindre än Fable 5.1, genererar utdata upp till 30% snabbare och slår GPT-6 Astra och Gemini 4 Carbon på de flesta rader i Anthropics benchmarktabell.
I den här artikeln går jag igenom vad som är nytt i Fable 5.2 och Mythos 5.2, hur de presterar på benchmarktester, vad de kostar och hur du avgör om du behöver dem i stället för Claude Opus 5.5.
Vad är Claude Fable 5.2?
Claude Fable 5.2 är Anthropics mest kapabla allmänt tillgängliga modell. Den är byggd för långvarigt, krävande tekniskt arbete: migrering av stora kodbaser, flerdagars agentkörningar, forskningsproblem och ingenjörsdesign.
Fable 5.2 kan också arbeta tillsammans med de mindre modellerna, antingen som en rådgivare de konsulterar i svåra problem eller som en orkestrerare som lämnar enklare deluppgifter vidare till dem.
Fable 5.2 behåller föregångarens kontextfönster på 1M token och maxutdata på 128K, och dess kunskapsstopp är juni 2026.
Vad är Claude Mythos 5.2?
Claude Mythos 5.2 är samma modell som Fable 5.2 men utan de skydd som blockerar det mesta cybersäkerhetsarbetet och biologi på forskningsnivå. Faktum är att Mythos 5.2 är Anthropics mest kapabla modell för cybersäkerhetsengineering. Eftersom dessa typer av förmågor är dubbelanvändbara erbjuder Anthropic endast Mythos 5.2 till granskade organisationer via sitt Cyber Verification Program och Life Sciences Verification Program.
Vad är nytt i Claude Fable 5.2?
Fable har bara funnits sedan juni, då Anthropic släppte Fable 5. Sedan dess har det kommit två punktversioner, Fable 5.1 i september och nu Fable 5.2, och ingen av dem har lagt till särskilt många nya funktioner. Båda har mest gjort modellen billigare, snabbare och starkare, även om prestandalyften inte har varit små: Fable 5.2 mer än fördubblar till exempel Fable 5.1:s poäng på Remote Labor Index.
Den större skillnaden mellan de två versionerna ligger i hur du får använda modellen. Med Fable 5.1 snävade Anthropic in sina cybersäkerhetsskydd och började tillåta att modellen användes för att hitta programvarusårbarheter, men inte för att skriva exploiter för dem, och man lanserade Enterprise Frontier Safeguards, ett alternativ för att behålla dina data i ditt eget moln, samtidigt med releasen. Fable 5.2:s skyddsförändringar är mindre: den blockerar färre förfrågningar, men samma typer av uppgifter är fortfarande otillåtna.
De nya sätten Anthropic föreslår att använda den på, som att låta Fable 5.2 ge råd till mindre Claude-modeller, är inte heller nya, eftersom Anthropics advisor-verktyg redan stödde Fable 5 och 5.1. Och lanseringsdemon, som operativsystemet byggt från en tom mapp, visar en starkare modell som gör svårare saker, inte nya funktioner du kan slå på.
Med det sagt, om jag ska peka på nya saker, är det här vad jag skulle nämna:
Ett lägre pris
Fable 5.2 kostar 8 USD per miljon inmatade token och 40 USD per miljon utmatade token, 20% mindre än Fable 5.1:s 10/50 USD. Samma 20%-iga sänkning gäller för cacheläsningar (0,20 USD), cache-skrivningar och batchbearbetning. Se avsnittet om priser nedan för fullständig uppdelning.
Snabbare utdata, och snabbt läge för Fable
Utdata är upp till 30% snabbare än Fable 5.1, vilket märks under en lång agentkörning. Fable stöder nu också snabbt läge, som kan snabba upp utdata med upp till 2,5x till dubbla priset (16/80 USD).
Bättre resultat med mindre ansträngning
Det här är förändringen som troligast påverkar din nota. Vid hög ansträngning får Fable 5.2 45,3% på FrontierCode 2.0, ungefär i nivå med Opus 5.5:s bästa poäng, till ungefär halva kostnaden per uppgift. Vid låg ansträngning matchar den Opus 5.5:s toppresultat på Humanity's Last Exam till mindre än en tiondel av kostnaden per uppgift. Min tolkning: Om du går upp från Opus 5.5, börja med Fable 5.2 på en lägre ansträngningsnivå.
Färre blockerade förfrågningar
Fable 5.2 bör hamna på cirka 55% färre säkerhetsblockeringar än Fable 5.1 (cirka 60% färre inom cybersäkerhet och 40% färre inom biologi). Det är viktigt om Fable 5.1:s vägran stod i vägen för dig, men kategorierna som blockeras har inte ändrats: penetrationstester, exploitering och det mesta arbete på forskningsnivå inom biologi lämnas fortfarande över till äldre Claude-modeller.
Hur presterar Claude Fable 5.2 på benchmarktester?
Här är huvudresultaten. De kommer alla från Anthropics lanseringstabell, så läs dem som Anthropics argument för modellen snarare än oberoende resultat. Claude-poängen kördes med skydd aktiverade. Om inte annat anges visas varje modell på sin högsta tillgängliga ansträngning.
Agentiskt kodande
Fable 5.2 leder båda kodningsbenchmarks i tabellen. På FrontierCode 2.0, som mäter om underhållare av öppen källkod skulle slå samman en modells kodändringar, får den 49,1%, högst i tabellen och klart över Fable 5.1:s 32,4%. På FrontierSWE v2 får den 69,9%, före GPT-6 Astra (65,5%) och Opus 5.5 (62,3%).
Lanseringsexemplen pekar åt samma håll: agenter som körde en tidig version av Fable 5.2 migrerade en produktionstjänst från Python till Rust, och den startar nu cirka 26 gånger snabbare.
Kunskapsarbete och forskning
Det största relativa lyftet är på Remote Labor Index, som mäter hur väl en modell slutför verkliga frilansliknande projekt. Fable 5.2 får 41,3%, ungefär dubbelt upp mot Opus 5.5 (21,3%) och GPT-6 Astra (20,8%). Den leder också på Humanity's Last Exam med verktyg (74,2%) och på Terminal-Bench-Science (74,6%, eller 75,3% för Mythos 5.2).
Affärsautomation är det enda område där den ligger efter. På AutomationBench får Gemini 4 Carbon 53,9% mot Fable 5.2:s 51,4%, även om Fable 5.2 fortfarande ligger långt före Fable 5.1 (31,4%).
Utanför huvudtabellen fick Fable 5.2 83,5 på BenchCAD 2.1, ett benchmarktest för hårdvaruengineering, jämfört med 65,3 för Opus 5.5. Den tillskrivs också att ha löst två öppna problem inom svart hål-fysik, och resultaten är publicerade som preprints som andra fysiker kan granska.
Datoranvändning, robotik och bildförståelse
Fable 5.2 får 89,3% på OSWorld 2.1, före Opus 5.5 (87,2%) och GPT-6 Astra (79,5%). Hoppet inom robotik är det största i tabellen: 64,9% på RoboDojo Sim, mer än dubbelt upp mot Fable 5.1 och GPT-6 Astra. På Chartography, som testar avläsning av diagram utan verktyg, kniper den före Gemini 4 Carbon och GPT-6 Astra, efter att Fable 5.1 låg rejält efter med 44,8%.
Cybersäkerhet och biologi (Mythos 5.2)
Raderna om säkerhet och biologi gäller Mythos 5.2, eftersom Fable 5.2:s skydd blockerar det mesta av dessa uppgifter. Mythos 5.2 får 76,3% på CyScenarioBench (mot 61,7% för Mythos 5.1), 89,6% på CVE Rediscovery (mot 78,3%) och 85,1% på en 24-timmars uppgift för design av proteinbindare (mot 79,1%). Det finns ingen rättvis jämförelse med OpenAI:s säkerhetsmodell här, eftersom varje labb körde sina egna CyScenarioBench-uppgifter.
Vad handlar det här om Fermats sista sats?
Ett team av Fable 5.2-agenter formaliserade beviset för Fermats sista sats i bevisassistenten Lean på 30 timmar. Du kanske undrar: bevisades inte satsen för tre decennier sedan, så vad återstår att göra?
Satsen är gammal nyhet
Fermats sista sats säger att det inte finns några positiva heltal a, b och c där an + bn = cn för något n större än 2. För n = 2 finns många lösningar, som 32 + 42 = 52 (9 + 16 = 25). Men prova kuber och du får bara nästanträffar: 63 + 83 = 728, en ifrån 93 = 729.
Pierre de Fermat hävdade ett bevis 1637 men skrev aldrig ned det, och det förblev olöst i mer än 350 år tills Andrew Wiles bevisade det i mitten av 1990-talet, med hjälp av Richard Taylor.
Vad en Lean-formalisering är
Wiles bevis är över 100 sidor långt och vilar på decennier av avancerad talteori, så väldigt få kan kontrollera det från början till slut. Lean är en bevisassistent: ett programmeringsspråk där du skriver ett bevis som kod, och programvaran kontrollerar varje logiskt steg hela vägen ned till matematikens grundaxiom. Om beviset kompilerar är det korrekt. Att "formalisera" en sats betyder att översätta det mänskligt skrivna beviset till denna maskinverifierbara form.
För Fermats sista sats är det ett enormt arbete, eftersom mycket av den matematik som beviset bygger på aldrig hade skrivits i Lean. Matematikern Kevin Buzzard startade ett communityprojekt för att göra det 2024.
Varför det är intressant för en AI-modell
Det mesta AI-utdata bedöms av människor eller av benchmarktester som bara testar delar av svaret. Ett Lean-bevis är annorlunda: kontrollprogrammet accepterar antingen varje steg eller inte, så det går inte att vara subtilt fel. Det gör det till ett ovanligt rent test av om en modell kan bära ett mycket långt, mycket svårt projekt hela vägen till ett verifierat slut.
Det här är inte första gången Claude gör detta. I september publicerade Anthropic det första fullständiga datorgranskade beviset av satsen, skrivet av dussintals agenter som körde en intern forskningsmodell ungefär jämförbar med Fable 5.1. Den insatsen tog 11 dagar och cirka sex miljarder utmatade token, producerade 13 miljoner rader Lean och byggde delvis på delar av Buzzards projekt. Fable 5.2 gjorde det på 30 timmar, med minimal mänsklig hjälp.
Varningarna
Det mest talande är ändå vad som hände när Anthropic gav Claude Opus 5.5 samma uppgift.
Claude Fable 5.2 vs. Claude Opus 5.5
Att jämföra två modeller innebär oftast att läsa benchmarkpoäng och försöka sluta sig till hur skillnaden skulle se ut i praktiken. Den här gången uppskattar jag att Anthropic började med en berättelse, vilket gör gapet tydligare.
I samma Lean-setup med 1 000 agenter slutförde Opus 5.5 26% av beviset för Fermats sista sats på 18 timmar och kom knappt vidare efter det. Fable 5.2 slutförde allt på 30 timmar. Slutsatsen: på mycket långa, multiagent-projekt kan Opus 5.5 köra fast där Fable 5.2 fortsätter.
På kortare uppgifter är gapet mindre. Så här står de mot varandra sida vid sida:
Mönstret matchar Lean-resultatet. Inom datoranvändning och kodning ligger Fable 5.2 bara några poäng före. På öppna, flerstegade uppgifter växer ledningen: Fable 5.2 nästan fördubblar Opus 5.5:s poäng på de frilansliknande projekten i Remote Labor Index, och den ligger 25 poäng före i robotstyrning.
Priset är mindre av ett gap än det ser ut. Fable 5.2 kostar dubbelt så mycket per token, men kan ofta nå Opus 5.5:s bästa poäng på en lägre ansträngningsnivå och använda färre token. På FrontierCode 2.0 matchar till exempel Fable 5.2 vid hög ansträngning ungefär Opus 5.5:s bästa till ungefär halva kostnaden per uppgift.
Så Opus 5.5 är fortfarande det vettiga standardvalet. Men om en uppgift kör i timmar, involverar många agenter eller ständigt kör fast på Opus, är Fable 5.2 troligen den som slutför den, och det behöver inte kosta så mycket mer som priset per token antyder.
Säkerhet och begränsningar
Anthropic bedömer risken att dessa modeller beter sig osäkert i situationer med höga insatser som låg.
Det är svårt att kontrollera utifrån, så de mer konkreta siffrorna är användbara. På en automatiserad beteendegranskning av cirka 1 900 scenarier hade Mythos 5.2 den lägsta poängen för felriktat beteende bland de jämförda modellerna. Den var också mindre benägen att hallucinerade indata, felaktigt påstå att en uppgift var klar eller dölja dåligt arbete.
Det finns några andra intressanta delar som är värda att känna till och som får dig att tänka:
Vilken Claude-modell ska du använda?
Mitt råd matchar Anthropics: börja med Opus 5.5 och gå upp först när du behöver. Så här ser uppställningen ut:
Priser och tillgänglighet för Claude Fable 5.2
Vi hade just tittat på en tabell med benchmarkresultat som visade att Fable 5.2 slår Fable 5.1 på allt som listas. Nu visar jag dig en tabell som visar att Fable 5.2 är billigare än 5.1. Så är Fable 5.1 föråldrad?
För nytt arbete, i praktiken ja. Om du har tillgång till Fable 5.2 finns det liten anledning att starta något nytt på 5.1. Anthropic har dock inte meddelat något pensionsdatum för den, och team med promptar eller agenter fintrimmade för Fable 5.1 kommer att vilja testa 5.2 innan de byter. Vi vet att en ny version kan bete sig annorlunda även när den får bättre poäng.
Så får du tillgång till Claude Fable 5.2
Claude-appar: Fable 5.2 finns på berättigade betalda planer. Som lanseringskampanj kan Pro-planer och vanliga Team-licenser använda Fable för upp till 50% av sina veckovisa användningsgränser, och planer som inkluderar Fable får en till tre användningsåterställningar beroende på abonnemangets längd.
API: Använd modell-ID:t
claude-fable-5-2på Claude Platform.Molnplattformar: Den finns på Amazon Web Services, Google Cloud och Microsoft Azure.
Mythos 5.2: Ansök via Cyber Verification Program eller Life Sciences Verification Program. Claude Enterprise-kunder kan också använda den via Claude Security.
Företag med strikta datakrav kan använda Enterprise Frontier Safeguards, som kör Anthropics säkerhetsövervakning på data som lagras i kundens egen infrastruktur och fungerar med noll datalagring. Andra kunder har 30 dagars datalagring för säkerhetsövervakning.
Avslutande tankar
Claude Fable 5.2 är ett meningsfullt steg upp från Fable 5.1. Den är billigare, snabbare och mindre benägen att vägra legitimt arbete. Lyften på Remote Labor Index, robotik och FrontierCode är särskilt stora.
Det sagt, Opus 5.5 är fortfarande det bättre värdet för de flesta vardagliga uppgifter till halva priset. Det mest intressanta med Fable 5.2 kan vara effektivitetsanspråken: om den verkligen matchar Opus 5.5:s bästa poäng vid låg eller medelhög ansträngning krymper premiepriset per token snabbt. Det är värt att testa på dina egna arbetsbelastningar.
Om du vill testa Claude praktiskt är vår Developing AI Applications-track en bra startpunkt.