Oggi, Anthropic ha annunciato Fable 5.2 per tutti e Mythos 5.2 per le organizzazioni verificate. Sono lo stesso modello sottostante, ma la versione Fable include ulteriori salvaguardie per cybersecurity e biologia.
Le novità principali sono:
- un prezzo più basso,
- output più veloce e
- grandi balzi nei benchmark più difficili di Anthropic.
Più nello specifico, Fable 5.2 costa il 20% in meno di Fable 5.1, genera output fino al 30% più velocemente e supera GPT-6 Astra e Gemini 4 Carbon nella maggior parte delle righe della tabella dei benchmark di Anthropic.
In questo articolo, vedremo cosa c’è di nuovo in Fable 5.2 e Mythos 5.2, come si comportano nei benchmark, quanto costano e come decidere se preferirli a Claude Opus 5.5.
Che cos’è Claude Fable 5.2?
Claude Fable 5.2 è il modello più capace di Anthropic disponibile al grande pubblico. È pensato per lavori tecnici lunghi e impegnativi: migrazioni di grandi codebase, esecuzioni di agenti su più giorni, problemi di ricerca e progettazione ingegneristica.
Fable 5.2 può anche lavorare insieme ai modelli più piccoli, sia come advisor a cui chiedono consiglio sui problemi difficili, sia come orchestratore che delega loro i sotto-task più semplici.
Fable 5.2 mantiene la finestra di contesto da 1 milione di token e un output massimo di 128K come il suo predecessore, e il suo cutoff di conoscenza è giugno 2026.
Che cos’è Claude Mythos 5.2?
Claude Mythos 5.2 è lo stesso modello di Fable 5.2 ma senza le salvaguardie che bloccano la maggior parte del lavoro di cybersecurity e la biologia a livello di ricerca. Di fatto, Mythos 5.2 è il modello Anthropic più capace per l’ingegneria della sicurezza informatica. Poiché queste capacità sono a duplice uso, Anthropic offre Mythos 5.2 solo a organizzazioni verificate tramite il suo Cyber Verification Program e il Life Sciences Verification Program.
Cosa c’è di nuovo in Claude Fable 5.2?
Fable è arrivato solo a giugno, quando Anthropic ha rilasciato Fable 5. Da allora ci sono stati due aggiornamenti minori, Fable 5.1 a settembre e ora Fable 5.2, e nessuno dei due ha aggiunto molte nuove funzionalità. Entrambi hanno soprattutto reso il modello più economico, veloce e potente, anche se i guadagni di performance non sono stati piccoli: per esempio, Fable 5.2 più che raddoppia il punteggio di Fable 5.1 sul Remote Labor Index.
La differenza più grande tra i due rilasci riguarda i modi in cui sei autorizzato a usare il modello. Con Fable 5.1, Anthropic ha ristretto le salvaguardie per la cybersecurity e ha iniziato a consentire l’uso del modello per trovare vulnerabilità software, ma non per scrivere exploit, e ha annunciato le Enterprise Frontier Safeguards, un’opzione per mantenere i tuoi dati nel tuo cloud, insieme al rilascio. Le modifiche alle salvaguardie di Fable 5.2 sono più piccole: blocca meno richieste, ma gli stessi tipi di attività restano fuori portata.
I nuovi modi suggeriti da Anthropic per usarlo, come far consigliare a Fable 5.2 i modelli Claude più piccoli, non sono nemmeno nuovi, dato che lo strumento advisor di Anthropic supportava già Fable 5 e 5.1. E le demo di lancio, come il sistema operativo costruito da una cartella vuota, mostrano un modello più forte che fa cose più difficili, non nuove funzionalità da attivare.
Detto questo, se devo indicare le novità, ecco cosa menzionerei:
Un prezzo più basso
Fable 5.2 costa 8 $ per milione di token in input e 40 $ per milione di token in output, il 20% in meno rispetto ai 10 $/50 $ di Fable 5.1. Lo stesso taglio del 20% si applica a letture di cache (0,20 $), scritture di cache e batch processing. Vedi la sezione prezzi qui sotto per il dettaglio completo.
Output più veloce e fast mode per Fable
L’output è fino al 30% più rapido rispetto a Fable 5.1, cosa che incide parecchio su esecuzioni lunghe degli agenti. Fable ora supporta anche la fast mode, che accelera l’output fino a 2,5 volte al doppio del prezzo (16 $/80 $).
Risultati migliori con minore sforzo
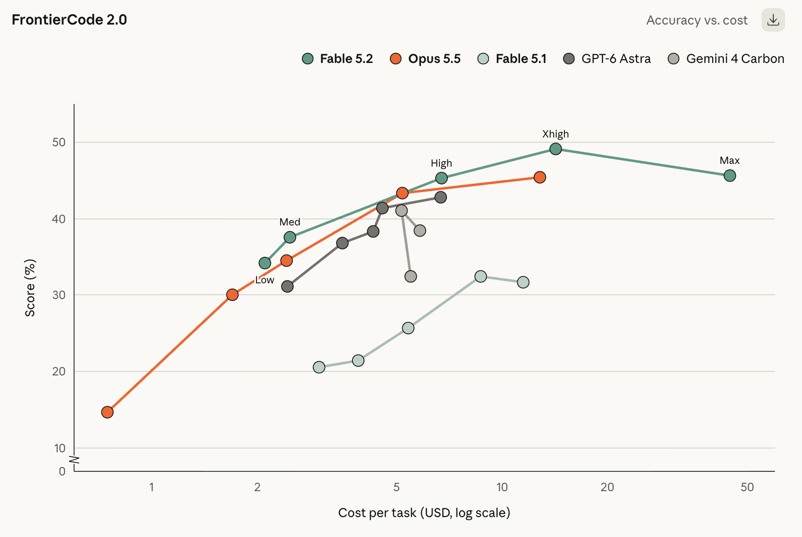
Questa è la novità più probabile a impattare la tua spesa. Con sforzo alto, Fable 5.2 segna il 45,3% su FrontierCode 2.0, circa al livello del miglior punteggio di Opus 5.5, a un costo per task all’incirca dimezzato. Con sforzo basso, eguaglia il miglior punteggio di Opus 5.5 su Humanity’s Last Exam a meno di un decimo del costo per task. La mia lettura: se passi da Opus 5.5, inizia Fable 5.2 con uno sforzo più basso.
Meno richieste bloccate
Fable 5.2 dovrebbe incorrere in circa il 55% di blocchi di sicurezza in meno rispetto a Fable 5.1 (circa 60% in meno nella cybersecurity e 40% in meno in biologia). È un bel vantaggio se i rifiuti di Fable 5.1 ti intralciavano, ma le categorie bloccate non sono cambiate: penetration testing, generazione di exploit e la maggior parte della biologia a livello di ricerca vengono ancora indirizzati ai modelli Claude precedenti.
Come si comporta Claude Fable 5.2 nei benchmark?
Ecco i risultati principali. Provengono tutti dalla tabella di lancio di Anthropic, quindi leggili come l’argomentazione di Anthropic a favore del modello, non come risultati indipendenti. I punteggi di Claude sono stati eseguiti con le salvaguardie attive. Se non indicato, ogni modello è mostrato al suo massimo livello di sforzo disponibile.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (agentic coding) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2 (agentic coding) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench (business workflows) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| OSWorld 2.1 (computer use) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| RoboDojo Sim (robotics) | 64.9% | 27.6% | 39.4% | 29.8% | Not reported |
| AA-Briefcase v1.1 (knowledge work) | 66.1% | 61.5% | 61.2% | 52.0% | 61.8% |
| Remote Labor Index (knowledge work) | 41.3% | 17.9% | 21.3% | 20.8% | Not reported |
| Humanity's Last Exam (with tools) | 74.2% | 65.6% | 67.7% | 57.2% | Not reported |
| WANDR (agentic search) | 82.1% | 68.7% | 72.3% | Not reported | Not reported |
| Chartography (no tools) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
Agentic coding
Fable 5.2 guida entrambi i benchmark di coding in tabella. Su FrontierCode 2.0, che misura se i maintainer open-source farebbero il merge delle modifiche al codice del modello, ottiene il 49,1%, il più alto in tabella e ben sopra il 32,4% di Fable 5.1. Su FrontierSWE v2, segna il 69,9%, davanti a GPT-6 Astra (65,5%) e Opus 5.5 (62,3%).
Gli esempi del lancio vanno nella stessa direzione: agenti che eseguivano una versione preliminare di Fable 5.2 hanno migrato un servizio in produzione da Python a Rust, e ora avvia circa 26 volte più velocemente.
Lavoro di conoscenza e ricerca
Il salto relativo più grande è sul Remote Labor Index, che misura quanto bene un modello completa progetti reali in stile freelance. Fable 5.2 segna il 41,3%, circa il doppio di Opus 5.5 (21,3%) e GPT-6 Astra (20,8%). Guida anche su Humanity’s Last Exam con strumenti (74,2%) e su Terminal-Bench-Science (74,6%, o 75,3% per Mythos 5.2).
L’automazione business è l’unica area in cui resta dietro. Su AutomationBench, Gemini 4 Carbon ottiene il 53,9% contro il 51,4% di Fable 5.2, anche se Fable 5.2 è comunque molto avanti rispetto a Fable 5.1 (31,4%).
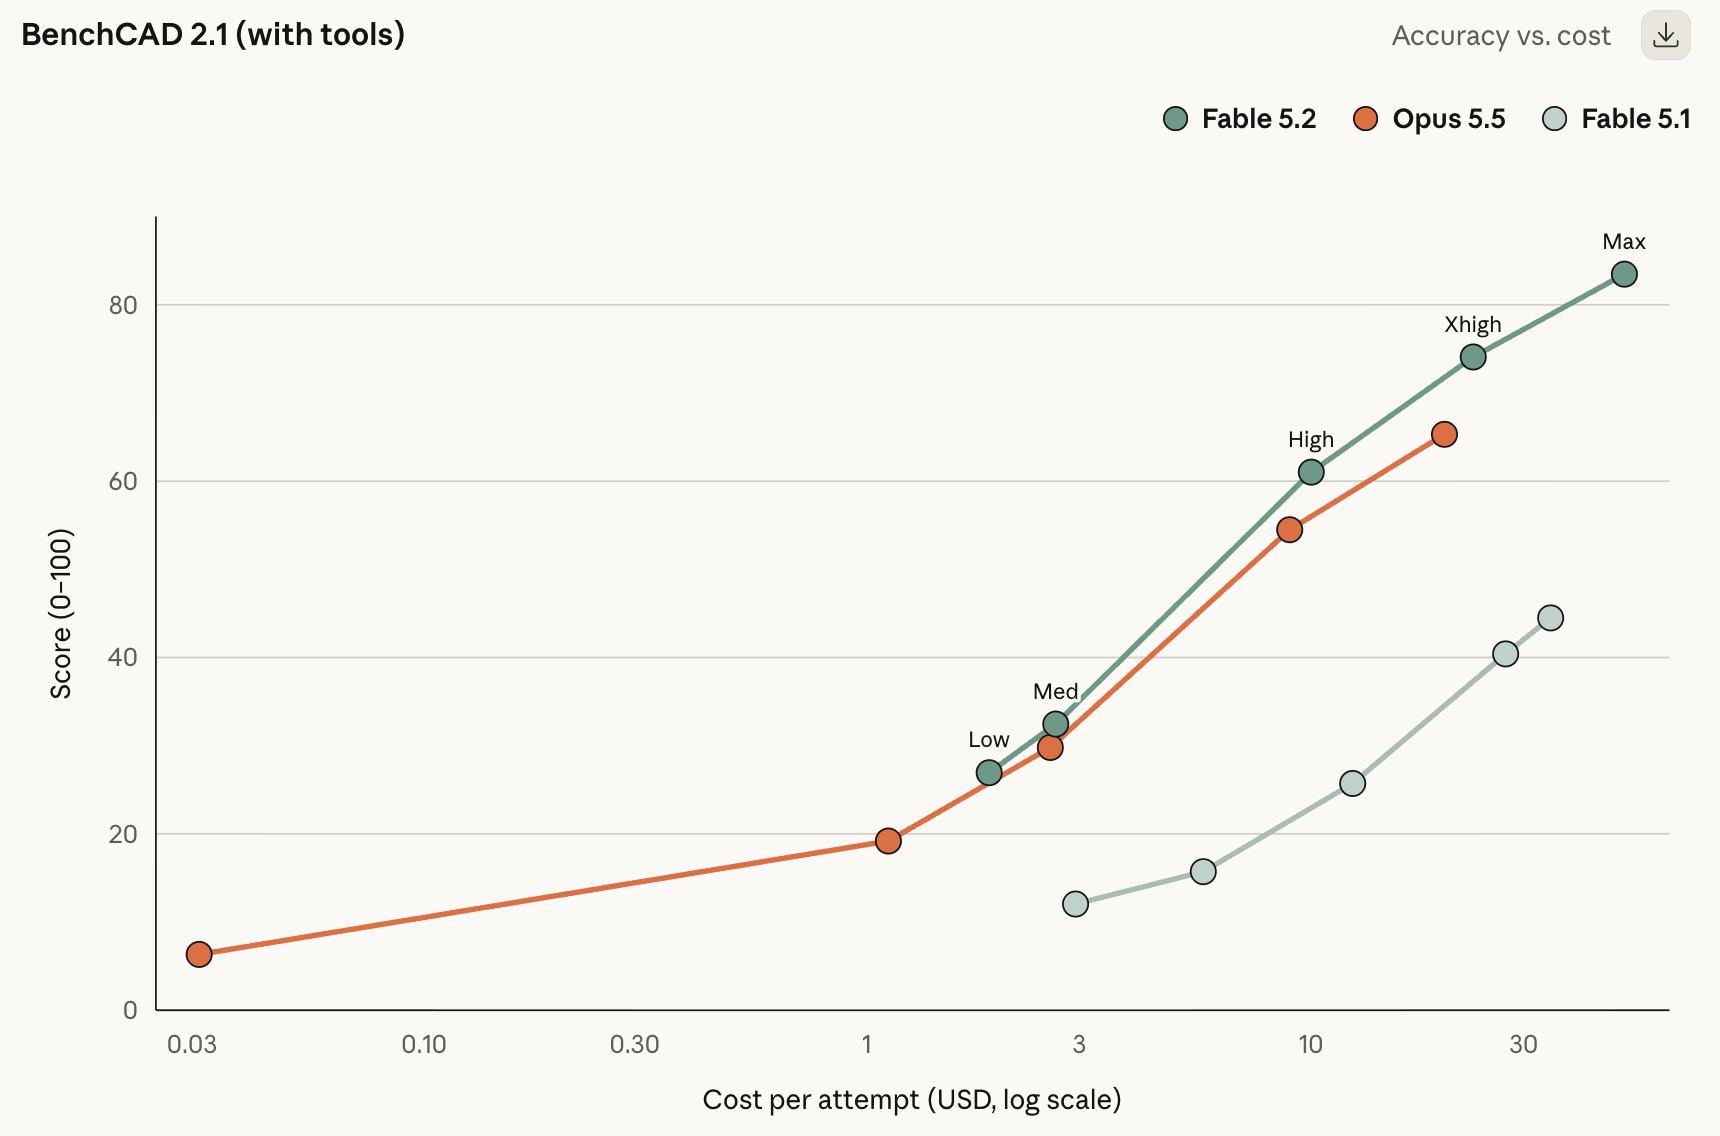
Fuori dalla tabella principale, Fable 5.2 ha segnato 83,5 nel benchmark di ingegneria hardware BenchCAD 2.1, contro 65,3 per Opus 5.5. Gli viene anche attribuita la risoluzione di due problemi aperti nella fisica dei buchi neri, e i risultati sono pubblicati come preprint che altri fisici possono verificare.
Uso del computer, robotica e visione
Fable 5.2 ottiene l’89,3% su OSWorld 2.1, davanti a Opus 5.5 (87,2%) e GPT-6 Astra (79,5%). Il salto nella robotica è il più grande in tabella: 64,9% su RoboDojo Sim, più del doppio rispetto a Fable 5.1 e GPT-6 Astra. Su Chartography, che testa la lettura di grafici senza strumenti, supera di poco Gemini 4 Carbon e GPT-6 Astra, dopo che Fable 5.1 era rimasto indietro a 44,8%.
Cybersecurity e biologia (Mythos 5.2)
Le righe su sicurezza e biologia si riferiscono a Mythos 5.2, dato che le salvaguardie di Fable 5.2 bloccano la maggior parte di questi compiti. Mythos 5.2 segna 76,3% su CyScenarioBench (vs 61,7% per Mythos 5.1), 89,6% su CVE Rediscovery (vs 78,3%) e 85,1% su un task di progettazione di leganti proteici in 24 ore (vs 79,1%). Qui non c’è un confronto equo con il modello di sicurezza di OpenAI, perché ogni laboratorio ha eseguito i propri task di CyScenarioBench.
Che c’entra l’Ultimo Teorema di Fermat?
Un team di agenti Fable 5.2 ha formalizzato la dimostrazione dell’Ultimo Teorema di Fermat nell’assistente alla dimostrazione Lean in 30 ore. Potresti chiederti: non è stato già dimostrato tre decenni fa, quindi cosa restava da fare?
Il teorema non è una novità
L’Ultimo Teorema di Fermat afferma che non esistono numeri interi positivi a, b e c tali che an + bn = cn per nessun n maggiore di 2. Per n = 2, ci sono molte soluzioni, come 32 + 42 = 52 (9 + 16 = 25). Ma provando con i cubi ottieni solo quasi-soluzioni: 63 + 83 = 728, uno in meno di 93 = 729.
Pierre de Fermat sostenne di avere una dimostrazione nel 1637 ma non la scrisse mai, e rimase irrisolto per oltre 350 anni finché Andrew Wiles lo dimostrò a metà anni ’90, con l’aiuto di Richard Taylor.
La dimostrazione di Wiles supera le 100 pagine e poggia su decenni di teoria dei numeri avanzata, quindi pochissime persone possono verificarla dall’inizio alla fine. Lean è un assistente alla dimostrazione: un linguaggio di programmazione in cui scrivi una prova come codice, e il software verifica ogni passo logico fino agli assiomi di base della matematica. Se la prova compila, è corretta. “Formalizzare” un teorema significa tradurre la dimostrazione scritta dall’uomo in questa forma verificabile dalla macchina.
Per l’Ultimo Teorema di Fermat, è un lavoro enorme, perché gran parte della matematica su cui si basa la dimostrazione non era mai stata scritta in Lean. Il matematico Kevin Buzzard ha avviato un progetto comunitario per farlo nel 2024.
Perché è interessante per un modello di IA
La maggior parte dell’output dell’IA è giudicata dalle persone o da benchmark che testano solo una parte della risposta. Una dimostrazione in Lean è diversa: il verificatore accetta ogni passo oppure no, quindi non c’è modo di essere sottilmente in errore. Questo la rende un test insolitamente pulito della capacità di un modello di portare a termine un progetto lunghissimo e difficilissimo fino a una verifica conclusiva.
Non è la prima volta che Claude ci riesce. A settembre, Anthropic ha pubblicato la prima dimostrazione completa verificata al computer del teorema, scritta da dozzine di agenti che eseguivano un modello di ricerca interno all’incirca paragonabile a Fable 5.1. Quello sforzo ha richiesto 11 giorni e circa sei miliardi di token in output, ha prodotto 13 milioni di linee di Lean ed è stato costruito in parte su componenti del progetto di Buzzard. Fable 5.2 l’ha fatto in 30 ore, con minimo aiuto umano.
Le avvertenze
- Non aggiunge nulla alla matematica. Buzzard lo ha detto chiaramente a proposito della prima formalizzazione di Anthropic.
- A Fable 5.2 è stato dato un elenco di enunciati di teoremi intermedi per monitorare i progressi. È una roadmap di cosa dimostrare, ma non di come dimostrarlo.
- Non ho ancora trovato revisioni esterne della nuova dimostrazione, quindi per ora, le 30 ore e il confronto con Opus 5.5 restano affermazioni di Anthropic.
La parte più rivelatrice, però, è cosa è successo quando Anthropic ha dato lo stesso compito a Claude Opus 5.5.
Claude Fable 5.2 vs. Claude Opus 5.5
Confrontare due modelli di solito significa leggere i punteggi dei benchmark e cercare di inferire come si tradurrebbero nella pratica. Questa volta, apprezzo che Anthropic abbia iniziato con una storia, che rende il divario più evidente.
Nella stessa configurazione Lean con 1.000 agenti, Opus 5.5 ha completato il 26% della dimostrazione dell’Ultimo Teorema di Fermat in 18 ore e ha fatto pochissimi progressi dopo. Fable 5.2 ha completato tutto in 30 ore. La morale: su progetti molto lunghi e multi-agente, Opus 5.5 può bloccarsi dove Fable 5.2 continua ad avanzare.
Sui task più brevi, il divario è più ridotto. Ecco il confronto affiancato:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| Prezzo (input / output per 1M token) | 8 $ / 40 $ | 4 $ / 20 $ |
| Finestra di contesto / output massimo | 1M / 128K | 1M / 128K |
| FrontierCode 2.0 (agentic coding) | 49.1% | 45.5% |
| FrontierSWE v2 (agentic coding) | 69.9% | 62.3% |
| OSWorld 2.1 (computer use) | 89.3% | 87.2% |
| AutomationBench (business workflows) | 51.4% | 42.5% |
| Humanity's Last Exam (with tools) | 74.2% | 67.7% |
| Remote Labor Index (knowledge work) | 41.3% | 21.3% |
| RoboDojo Sim (robotics) | 64.9% | 39.4% |
Lo schema coincide con il risultato su Lean. Su uso del computer e coding, Fable 5.2 è avanti di pochi punti. Sul lavoro aperto e multi-step, il vantaggio cresce: Fable 5.2 quasi raddoppia il punteggio di Opus 5.5 sui progetti in stile freelance del Remote Labor Index, ed è avanti di 25 punti nel controllo dei robot.
Il prezzo è meno distante di quanto sembri. Fable 5.2 costa il doppio per token, ma spesso può raggiungere il miglior punteggio di Opus 5.5 con uno sforzo inferiore, usando meno token. Su FrontierCode 2.0, per esempio, Fable 5.2 ad alto sforzo eguaglia all’incirca il meglio di Opus 5.5 a circa metà del costo per task.
Quindi Opus 5.5 resta la scelta sensata di default. Ma se un task dura ore, coinvolge molti agenti o continua a bloccarsi su Opus, Fable 5.2 probabilmente lo porterà a termine, e potrebbe non costare così tanto in più come suggerisce il prezzo per token.
Sicurezza e limiti
Anthropic valuta basso il rischio che questi modelli si comportino in modo non sicuro in situazioni ad alto impatto.
È difficile da verificare dall’esterno, quindi i numeri più concreti sono utili. In un audit comportamentale automatizzato di circa 1.900 scenari, Mythos 5.2 ha avuto il punteggio di comportamento non allineato più basso tra i modelli confrontati. Era anche meno propenso a inventare input, dichiarare falsamente completato un compito o nascondere lavoro di scarsa qualità.
Ci sono altri aspetti interessanti da conoscere che fanno riflettere:
- Consapevolezza della valutazione: Sia Fable 5.2 che Mythos 5.2 dicono di sospettare di essere testati più spesso rispetto ai modelli precedenti, il che rende valutazioni come quella sopra più difficili da considerare affidabili.
- Competenze di ricerca IA limitate intenzionalmente: Anthropic ha limitato i guadagni dei modelli in due aree, ottimizzazione dei kernel per accelerator e miglioramento delle architetture LLM, così da farli performare all’incirca al livello di Opus 5.5.
- Protezioni contro la distillazione: Fable 5.2 ha le misure anti-distillazione più forti di Anthropic finora, e il “preserved thinking”, che impedisce agli utenti API di modificare il contesto precedente per estrarre il ragionamento del modello, ora si applica a tutti gli account.
Quale modello Claude dovresti usare?
Il mio consiglio coincide con quello di Anthropic: inizia con Opus 5.5 e passa a un livello superiore solo quando serve. Ecco come si distribuisce la gamma:
- Claude Opus 5.5 (4 $/20 $): Il default per la maggior parte del coding, della ricerca e del lavoro di conoscenza. Costa la metà di Fable 5.2 per token ed è poco dietro in molti benchmark.
- Claude Fable 5.2 (8 $/40 $): Per i problemi più difficili, esecuzioni multi-agente lunghe e compiti in cui Opus 5.5 si blocca, come grandi migrazioni, ragionamenti a livello di ricerca o progettazione hardware. Provalo con livelli di sforzo più bassi prima di dare per scontato che serva il massimo.
- Claude Mythos 5.2: Per team di sicurezza e ricercatori nelle scienze della vita verificati che necessitano di capacità bloccate dalle salvaguardie di Fable 5.2.
- Claude Sonnet 5.5 e Haiku 5.5: Per attività ad alto volume, più semplici o sensibili alla latenza, o come modelli più piccoli che Fable 5.2 orchestra.
Prezzi e disponibilità di Claude Fable 5.2
| Per 1M token | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Input | 8 $ | 10 $ | 4 $ |
| Output | 40 $ | 50 $ | 20 $ |
| Letture cache | 0,20 $ | 0,25 $ | 0,20 $ |
| Scritture cache 5 minuti | 10 $ | 12,50 $ | 5 $ |
| Batch (input / output) | 4 $ / 20 $ | 5 $ / 25 $ | 2 $ / 10 $ |
| Fast mode (input / output) | 16 $ / 80 $ | Not listed | 8 $ / 40 $ |
Abbiamo appena visto una tabella con risultati di benchmark che mostrano Fable 5.2 battere Fable 5.1 su tutto ciò che è elencato. Ora ti mostro una tabella che indica che Fable 5.2 è più economico del 5.1. Quindi Fable 5.1 è obsoleto?
Per i nuovi lavori, di fatto sì. Se hai accesso a Fable 5.2, ci sono poche ragioni per iniziare qualcosa di nuovo su 5.1. Anthropic non ha annunciato una data di ritiro, però, e i team con prompt o agenti tarati su Fable 5.1 vorranno testare il 5.2 prima di passare. Sappiamo che una nuova versione può comportarsi in modo diverso anche quando ha punteggi migliori.
Come ottenere l’accesso a Claude Fable 5.2
-
App Claude: Fable 5.2 è disponibile sui piani a pagamento idonei. Come promozione di lancio, i piani Pro e le postazioni Team standard possono usare Fable fino al 50% dei loro limiti di utilizzo settimanali, e i piani che includono Fable ottengono da uno a tre reset di utilizzo a seconda della durata dell’abbonamento.
-
API: Usa l’ID modello claude-fable-5-2 sulla Claude Platform.
-
Piattaforme cloud: È disponibile su Amazon Web Services, Google Cloud e Microsoft Azure.
-
Mythos 5.2: Fai domanda tramite il Cyber Verification Program o il Life Sciences Verification Program. I clienti Claude Enterprise possono usarlo anche tramite Claude Security.
Le aziende con requisiti stringenti sui dati possono usare le Enterprise Frontier Safeguards, che eseguono il monitoraggio di sicurezza di Anthropic su dati archiviati nell’infrastruttura del cliente e funzionano con zero data retention. Gli altri clienti hanno una retention di 30 giorni per il monitoraggio di sicurezza.
Considerazioni finali
Claude Fable 5.2 è un passo avanti sostanziale rispetto a Fable 5.1. È più economico, più veloce, meno incline a rifiutare lavori legittimi. I salti su Remote Labor Index, robotica e FrontierCode sono particolarmente grandi.
Detto questo, Opus 5.5 resta il miglior valore per la maggior parte dei lavori quotidiani a metà prezzo. La cosa più interessante di Fable 5.2 potrebbe essere le affermazioni di efficienza: se davvero eguaglia i migliori punteggi di Opus 5.5 con sforzo basso o medio, il sovrapprezzo per token si riduce rapidamente. Vale la pena testarlo sui tuoi carichi.
Se vuoi mettere le mani su Claude, il nostro percorso Developing AI Applications è un buon punto di partenza.







Oggi, Anthropic ha annunciato Fable 5.2 per tutti e Mythos 5.2 per le organizzazioni verificate. Sono lo stesso modello sottostante, ma la versione Fable include ulteriori salvaguardie per cybersecurity e biologia.
Le novità principali sono:
Più nello specifico, Fable 5.2 costa il 20% in meno di Fable 5.1, genera output fino al 30% più velocemente e supera GPT-6 Astra e Gemini 4 Carbon nella maggior parte delle righe della tabella dei benchmark di Anthropic.
In questo articolo, vedremo cosa c’è di nuovo in Fable 5.2 e Mythos 5.2, come si comportano nei benchmark, quanto costano e come decidere se preferirli a Claude Opus 5.5.
Che cos’è Claude Fable 5.2?
Claude Fable 5.2 è il modello più capace di Anthropic disponibile al grande pubblico. È pensato per lavori tecnici lunghi e impegnativi: migrazioni di grandi codebase, esecuzioni di agenti su più giorni, problemi di ricerca e progettazione ingegneristica.
Fable 5.2 può anche lavorare insieme ai modelli più piccoli, sia come advisor a cui chiedono consiglio sui problemi difficili, sia come orchestratore che delega loro i sotto-task più semplici.
Fable 5.2 mantiene la finestra di contesto da 1 milione di token e un output massimo di 128K come il suo predecessore, e il suo cutoff di conoscenza è giugno 2026.
Che cos’è Claude Mythos 5.2?
Claude Mythos 5.2 è lo stesso modello di Fable 5.2 ma senza le salvaguardie che bloccano la maggior parte del lavoro di cybersecurity e la biologia a livello di ricerca. Di fatto, Mythos 5.2 è il modello Anthropic più capace per l’ingegneria della sicurezza informatica. Poiché queste capacità sono a duplice uso, Anthropic offre Mythos 5.2 solo a organizzazioni verificate tramite il suo Cyber Verification Program e il Life Sciences Verification Program.
Cosa c’è di nuovo in Claude Fable 5.2?
Fable è arrivato solo a giugno, quando Anthropic ha rilasciato Fable 5. Da allora ci sono stati due aggiornamenti minori, Fable 5.1 a settembre e ora Fable 5.2, e nessuno dei due ha aggiunto molte nuove funzionalità. Entrambi hanno soprattutto reso il modello più economico, veloce e potente, anche se i guadagni di performance non sono stati piccoli: per esempio, Fable 5.2 più che raddoppia il punteggio di Fable 5.1 sul Remote Labor Index.
La differenza più grande tra i due rilasci riguarda i modi in cui sei autorizzato a usare il modello. Con Fable 5.1, Anthropic ha ristretto le salvaguardie per la cybersecurity e ha iniziato a consentire l’uso del modello per trovare vulnerabilità software, ma non per scrivere exploit, e ha annunciato le Enterprise Frontier Safeguards, un’opzione per mantenere i tuoi dati nel tuo cloud, insieme al rilascio. Le modifiche alle salvaguardie di Fable 5.2 sono più piccole: blocca meno richieste, ma gli stessi tipi di attività restano fuori portata.
I nuovi modi suggeriti da Anthropic per usarlo, come far consigliare a Fable 5.2 i modelli Claude più piccoli, non sono nemmeno nuovi, dato che lo strumento advisor di Anthropic supportava già Fable 5 e 5.1. E le demo di lancio, come il sistema operativo costruito da una cartella vuota, mostrano un modello più forte che fa cose più difficili, non nuove funzionalità da attivare.
Detto questo, se devo indicare le novità, ecco cosa menzionerei:
Un prezzo più basso
Fable 5.2 costa 8 $ per milione di token in input e 40 $ per milione di token in output, il 20% in meno rispetto ai 10 $/50 $ di Fable 5.1. Lo stesso taglio del 20% si applica a letture di cache (0,20 $), scritture di cache e batch processing. Vedi la sezione prezzi qui sotto per il dettaglio completo.
Output più veloce e fast mode per Fable
L’output è fino al 30% più rapido rispetto a Fable 5.1, cosa che incide parecchio su esecuzioni lunghe degli agenti. Fable ora supporta anche la fast mode, che accelera l’output fino a 2,5 volte al doppio del prezzo (16 $/80 $).
Risultati migliori con minore sforzo
Questa è la novità più probabile a impattare la tua spesa. Con sforzo alto, Fable 5.2 segna il 45,3% su FrontierCode 2.0, circa al livello del miglior punteggio di Opus 5.5, a un costo per task all’incirca dimezzato. Con sforzo basso, eguaglia il miglior punteggio di Opus 5.5 su Humanity’s Last Exam a meno di un decimo del costo per task. La mia lettura: se passi da Opus 5.5, inizia Fable 5.2 con uno sforzo più basso.
Meno richieste bloccate
Fable 5.2 dovrebbe incorrere in circa il 55% di blocchi di sicurezza in meno rispetto a Fable 5.1 (circa 60% in meno nella cybersecurity e 40% in meno in biologia). È un bel vantaggio se i rifiuti di Fable 5.1 ti intralciavano, ma le categorie bloccate non sono cambiate: penetration testing, generazione di exploit e la maggior parte della biologia a livello di ricerca vengono ancora indirizzati ai modelli Claude precedenti.
Come si comporta Claude Fable 5.2 nei benchmark?
Ecco i risultati principali. Provengono tutti dalla tabella di lancio di Anthropic, quindi leggili come l’argomentazione di Anthropic a favore del modello, non come risultati indipendenti. I punteggi di Claude sono stati eseguiti con le salvaguardie attive. Se non indicato, ogni modello è mostrato al suo massimo livello di sforzo disponibile.
Agentic coding
Fable 5.2 guida entrambi i benchmark di coding in tabella. Su FrontierCode 2.0, che misura se i maintainer open-source farebbero il merge delle modifiche al codice del modello, ottiene il 49,1%, il più alto in tabella e ben sopra il 32,4% di Fable 5.1. Su FrontierSWE v2, segna il 69,9%, davanti a GPT-6 Astra (65,5%) e Opus 5.5 (62,3%).
Gli esempi del lancio vanno nella stessa direzione: agenti che eseguivano una versione preliminare di Fable 5.2 hanno migrato un servizio in produzione da Python a Rust, e ora avvia circa 26 volte più velocemente.
Lavoro di conoscenza e ricerca
Il salto relativo più grande è sul Remote Labor Index, che misura quanto bene un modello completa progetti reali in stile freelance. Fable 5.2 segna il 41,3%, circa il doppio di Opus 5.5 (21,3%) e GPT-6 Astra (20,8%). Guida anche su Humanity’s Last Exam con strumenti (74,2%) e su Terminal-Bench-Science (74,6%, o 75,3% per Mythos 5.2).
L’automazione business è l’unica area in cui resta dietro. Su AutomationBench, Gemini 4 Carbon ottiene il 53,9% contro il 51,4% di Fable 5.2, anche se Fable 5.2 è comunque molto avanti rispetto a Fable 5.1 (31,4%).
Fuori dalla tabella principale, Fable 5.2 ha segnato 83,5 nel benchmark di ingegneria hardware BenchCAD 2.1, contro 65,3 per Opus 5.5. Gli viene anche attribuita la risoluzione di due problemi aperti nella fisica dei buchi neri, e i risultati sono pubblicati come preprint che altri fisici possono verificare.
Uso del computer, robotica e visione
Fable 5.2 ottiene l’89,3% su OSWorld 2.1, davanti a Opus 5.5 (87,2%) e GPT-6 Astra (79,5%). Il salto nella robotica è il più grande in tabella: 64,9% su RoboDojo Sim, più del doppio rispetto a Fable 5.1 e GPT-6 Astra. Su Chartography, che testa la lettura di grafici senza strumenti, supera di poco Gemini 4 Carbon e GPT-6 Astra, dopo che Fable 5.1 era rimasto indietro a 44,8%.
Cybersecurity e biologia (Mythos 5.2)
Le righe su sicurezza e biologia si riferiscono a Mythos 5.2, dato che le salvaguardie di Fable 5.2 bloccano la maggior parte di questi compiti. Mythos 5.2 segna 76,3% su CyScenarioBench (vs 61,7% per Mythos 5.1), 89,6% su CVE Rediscovery (vs 78,3%) e 85,1% su un task di progettazione di leganti proteici in 24 ore (vs 79,1%). Qui non c’è un confronto equo con il modello di sicurezza di OpenAI, perché ogni laboratorio ha eseguito i propri task di CyScenarioBench.
Che c’entra l’Ultimo Teorema di Fermat?
Un team di agenti Fable 5.2 ha formalizzato la dimostrazione dell’Ultimo Teorema di Fermat nell’assistente alla dimostrazione Lean in 30 ore. Potresti chiederti: non è stato già dimostrato tre decenni fa, quindi cosa restava da fare?
Il teorema non è una novità
L’Ultimo Teorema di Fermat afferma che non esistono numeri interi positivi a, b e c tali che an + bn = cn per nessun n maggiore di 2. Per n = 2, ci sono molte soluzioni, come 32 + 42 = 52 (9 + 16 = 25). Ma provando con i cubi ottieni solo quasi-soluzioni: 63 + 83 = 728, uno in meno di 93 = 729.
Pierre de Fermat sostenne di avere una dimostrazione nel 1637 ma non la scrisse mai, e rimase irrisolto per oltre 350 anni finché Andrew Wiles lo dimostrò a metà anni ’90, con l’aiuto di Richard Taylor.
Cos’è una formalizzazione in Lean
La dimostrazione di Wiles supera le 100 pagine e poggia su decenni di teoria dei numeri avanzata, quindi pochissime persone possono verificarla dall’inizio alla fine. Lean è un assistente alla dimostrazione: un linguaggio di programmazione in cui scrivi una prova come codice, e il software verifica ogni passo logico fino agli assiomi di base della matematica. Se la prova compila, è corretta. “Formalizzare” un teorema significa tradurre la dimostrazione scritta dall’uomo in questa forma verificabile dalla macchina.
Per l’Ultimo Teorema di Fermat, è un lavoro enorme, perché gran parte della matematica su cui si basa la dimostrazione non era mai stata scritta in Lean. Il matematico Kevin Buzzard ha avviato un progetto comunitario per farlo nel 2024.
Perché è interessante per un modello di IA
La maggior parte dell’output dell’IA è giudicata dalle persone o da benchmark che testano solo una parte della risposta. Una dimostrazione in Lean è diversa: il verificatore accetta ogni passo oppure no, quindi non c’è modo di essere sottilmente in errore. Questo la rende un test insolitamente pulito della capacità di un modello di portare a termine un progetto lunghissimo e difficilissimo fino a una verifica conclusiva.
Non è la prima volta che Claude ci riesce. A settembre, Anthropic ha pubblicato la prima dimostrazione completa verificata al computer del teorema, scritta da dozzine di agenti che eseguivano un modello di ricerca interno all’incirca paragonabile a Fable 5.1. Quello sforzo ha richiesto 11 giorni e circa sei miliardi di token in output, ha prodotto 13 milioni di linee di Lean ed è stato costruito in parte su componenti del progetto di Buzzard. Fable 5.2 l’ha fatto in 30 ore, con minimo aiuto umano.
Le avvertenze
La parte più rivelatrice, però, è cosa è successo quando Anthropic ha dato lo stesso compito a Claude Opus 5.5.
Claude Fable 5.2 vs. Claude Opus 5.5
Confrontare due modelli di solito significa leggere i punteggi dei benchmark e cercare di inferire come si tradurrebbero nella pratica. Questa volta, apprezzo che Anthropic abbia iniziato con una storia, che rende il divario più evidente.
Nella stessa configurazione Lean con 1.000 agenti, Opus 5.5 ha completato il 26% della dimostrazione dell’Ultimo Teorema di Fermat in 18 ore e ha fatto pochissimi progressi dopo. Fable 5.2 ha completato tutto in 30 ore. La morale: su progetti molto lunghi e multi-agente, Opus 5.5 può bloccarsi dove Fable 5.2 continua ad avanzare.
Sui task più brevi, il divario è più ridotto. Ecco il confronto affiancato:
Lo schema coincide con il risultato su Lean. Su uso del computer e coding, Fable 5.2 è avanti di pochi punti. Sul lavoro aperto e multi-step, il vantaggio cresce: Fable 5.2 quasi raddoppia il punteggio di Opus 5.5 sui progetti in stile freelance del Remote Labor Index, ed è avanti di 25 punti nel controllo dei robot.
Il prezzo è meno distante di quanto sembri. Fable 5.2 costa il doppio per token, ma spesso può raggiungere il miglior punteggio di Opus 5.5 con uno sforzo inferiore, usando meno token. Su FrontierCode 2.0, per esempio, Fable 5.2 ad alto sforzo eguaglia all’incirca il meglio di Opus 5.5 a circa metà del costo per task.
Quindi Opus 5.5 resta la scelta sensata di default. Ma se un task dura ore, coinvolge molti agenti o continua a bloccarsi su Opus, Fable 5.2 probabilmente lo porterà a termine, e potrebbe non costare così tanto in più come suggerisce il prezzo per token.
Sicurezza e limiti
Anthropic valuta basso il rischio che questi modelli si comportino in modo non sicuro in situazioni ad alto impatto.
È difficile da verificare dall’esterno, quindi i numeri più concreti sono utili. In un audit comportamentale automatizzato di circa 1.900 scenari, Mythos 5.2 ha avuto il punteggio di comportamento non allineato più basso tra i modelli confrontati. Era anche meno propenso a inventare input, dichiarare falsamente completato un compito o nascondere lavoro di scarsa qualità.
Ci sono altri aspetti interessanti da conoscere che fanno riflettere:
Quale modello Claude dovresti usare?
Il mio consiglio coincide con quello di Anthropic: inizia con Opus 5.5 e passa a un livello superiore solo quando serve. Ecco come si distribuisce la gamma:
Prezzi e disponibilità di Claude Fable 5.2
Abbiamo appena visto una tabella con risultati di benchmark che mostrano Fable 5.2 battere Fable 5.1 su tutto ciò che è elencato. Ora ti mostro una tabella che indica che Fable 5.2 è più economico del 5.1. Quindi Fable 5.1 è obsoleto?
Per i nuovi lavori, di fatto sì. Se hai accesso a Fable 5.2, ci sono poche ragioni per iniziare qualcosa di nuovo su 5.1. Anthropic non ha annunciato una data di ritiro, però, e i team con prompt o agenti tarati su Fable 5.1 vorranno testare il 5.2 prima di passare. Sappiamo che una nuova versione può comportarsi in modo diverso anche quando ha punteggi migliori.
Come ottenere l’accesso a Claude Fable 5.2
App Claude: Fable 5.2 è disponibile sui piani a pagamento idonei. Come promozione di lancio, i piani Pro e le postazioni Team standard possono usare Fable fino al 50% dei loro limiti di utilizzo settimanali, e i piani che includono Fable ottengono da uno a tre reset di utilizzo a seconda della durata dell’abbonamento.
API: Usa l’ID modello
claude-fable-5-2sulla Claude Platform.Piattaforme cloud: È disponibile su Amazon Web Services, Google Cloud e Microsoft Azure.
Mythos 5.2: Fai domanda tramite il Cyber Verification Program o il Life Sciences Verification Program. I clienti Claude Enterprise possono usarlo anche tramite Claude Security.
Le aziende con requisiti stringenti sui dati possono usare le Enterprise Frontier Safeguards, che eseguono il monitoraggio di sicurezza di Anthropic su dati archiviati nell’infrastruttura del cliente e funzionano con zero data retention. Gli altri clienti hanno una retention di 30 giorni per il monitoraggio di sicurezza.
Considerazioni finali
Claude Fable 5.2 è un passo avanti sostanziale rispetto a Fable 5.1. È più economico, più veloce, meno incline a rifiutare lavori legittimi. I salti su Remote Labor Index, robotica e FrontierCode sono particolarmente grandi.
Detto questo, Opus 5.5 resta il miglior valore per la maggior parte dei lavori quotidiani a metà prezzo. La cosa più interessante di Fable 5.2 potrebbe essere le affermazioni di efficienza: se davvero eguaglia i migliori punteggi di Opus 5.5 con sforzo basso o medio, il sovrapprezzo per token si riduce rapidamente. Vale la pena testarlo sui tuoi carichi.
Se vuoi mettere le mani su Claude, il nostro percorso Developing AI Applications è un buon punto di partenza.