Vandaag kondigde Anthropic Fable 5.2 aan voor iedereen en Mythos 5.2 voor geverifieerde organisaties. Het gaat om hetzelfde onderliggende model, maar de Fable-versie heeft extra waarborgen voor cybersecurity en biologie.
De belangrijkste veranderingen zijn:
- een lagere prijs,
- snellere output, en
- grote sprongen op Anthropics zwaarste benchmarks.
Concreter: Fable 5.2 kost 20% minder dan Fable 5.1, genereert tot 30% sneller output en verslaat GPT-6 Astra en Gemini 4 Carbon op de meeste rijen van Anthropics benchmarktabel.
In dit artikel behandel ik wat er nieuw is in Fable 5.2 en Mythos 5.2, hoe ze presteren op de benchmarks, wat ze kosten en hoe je beslist of je ze nodig hebt boven Claude Opus 5.5.
Wat is Claude Fable 5.2?
Claude Fable 5.2 is Anthropics meest capabele algemeen beschikbare model. Het is gebouwd voor lang, veeleisend technisch werk: migraties van grote codebases, agent-runs van meerdere dagen, onderzoeksproblemen en engineeringdesign.
Fable 5.2 kan ook samenwerken met de kleinere modellen, bijvoorbeeld als adviseur die ze raadplegen bij moeilijke problemen of als orkestrator die eenvoudigere subtaken aan hen doorgeeft.
Fable 5.2 behoudt het contextvenster van 1M tokens en de maximale output van 128K van zijn voorganger, en de knowledge cutoff is juni 2026.
Wat is Claude Mythos 5.2?
Claude Mythos 5.2 is hetzelfde model als Fable 5.2 maar zonder de waarborgen die het meeste cybersecuritywerk en biologie op onderzoeksniveau blokkeren. Mythos 5.2 is zelfs Anthropics meest capabele model voor cybersecurity-engineering. Omdat dit soort capaciteiten dual-use zijn, biedt Anthropic Mythos 5.2 alleen aan geverifieerde organisaties via het Cyber Verification Program en het Life Sciences Verification Program.
Wat is er nieuw in Claude Fable 5.2?
Fable bestaat pas sinds juni, toen Anthropic Fable 5 uitbracht. Sindsdien zijn er twee puntreleases geweest, Fable 5.1 in september en nu Fable 5.2, en geen van beide heeft veel nieuwe features toegevoegd. Beide hebben het model vooral goedkoper, sneller en sterker gemaakt, al zijn de prestatiewinsten niet klein geweest: Fable 5.2 meer dan verdubbelt bijvoorbeeld Fable 5.1's score op de Remote Labor Index.
Het grootste verschil tussen de twee releases zit in hoe je het model mag gebruiken. Met Fable 5.1 versmalde Anthropic zijn cybersecurity-waarborgen en stond het toe dat het model werd gebruikt om softwarekwetsbaarheden te vinden, maar niet om daar exploits voor te schrijven, en het kondigde Enterprise Frontier Safeguards aan, een optie om je data in je eigen cloud te houden, tegelijk met de release. De aanpassingen in de waarborgen van Fable 5.2 zijn kleiner: het blokkeert minder verzoeken, maar dezelfde soorten taken blijven verboden terrein.
De nieuwe manieren waarop Anthropic voorstelt het te gebruiken, zoals Fable 5.2 kleinere Claude-modellen laten adviseren, zijn ook niet echt nieuw, aangezien Anthropics advisor-tool Fable 5 en 5.1 al ondersteunde. En de lanceringdemo's, zoals het besturingssysteem dat uit een lege map is opgebouwd, laten een sterker model zien dat moeilijkere dingen doet, geen nieuwe features die je kunt inschakelen.
Dat gezegd hebbende, als ik nieuwe dingen moet aanwijzen, zou ik dit noemen:
Een lagere prijs
Fable 5.2 kost $8 per miljoen inputtokens en $40 per miljoen outputtokens, 20% minder dan Fable 5.1's $10/$50. Dezelfde korting van 20% geldt voor cache-reads ($0,20), cache-writes en batchverwerking. Zie de prijzensectie hieronder voor het volledige overzicht.
Snellere output, en fast mode voor Fable
Output is tot 30% sneller dan Fable 5.1, wat optelt tijdens een lange agent-run. Fable ondersteunt nu ook fast mode, die de output tot wel 2,5x versnelt tegen dubbel de prijs ($16/$80).
Betere resultaten met minder inspanning
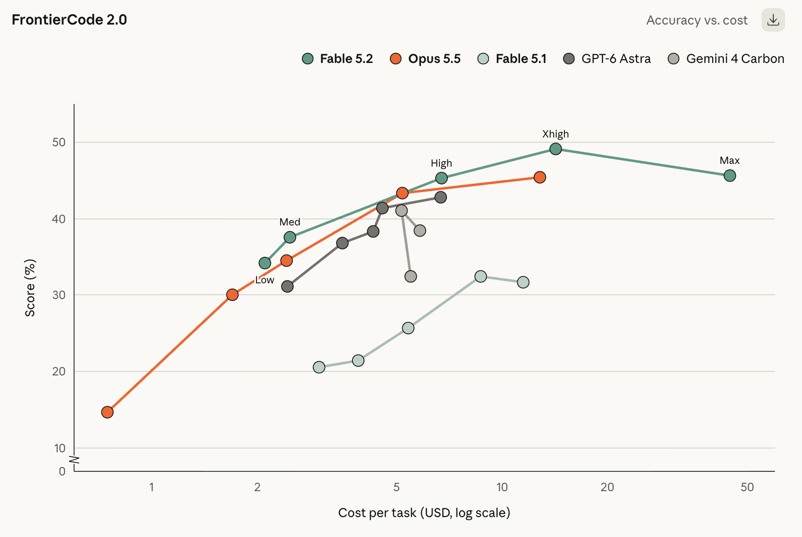
Dit is de verandering die waarschijnlijk het meeste effect heeft op je rekening. Bij hoge inspanning scoort Fable 5.2 45,3% op FrontierCode 2.0, ongeveer op het niveau van Opus 5.5's beste score, tegen grofweg de helft van de kosten per taak. Bij lage inspanning evenaart het Opus 5.5's topscore op Humanity's Last Exam tegen minder dan een tiende van de kosten per taak. Mijn advies: Als je overstapt van Opus 5.5, begin dan met Fable 5.2 op een lager inspanningsniveau.
Minder geblokkeerde verzoeken
Fable 5.2 zou ongeveer 55% minder safety blocks moeten treffen dan Fable 5.1 (ongeveer 60% minder in cybersecurity en 40% minder in biologie). Dat is een groot verschil als de weigeringen van Fable 5.1 je in de weg zaten, maar de categorieën die worden geblokkeerd zijn niet veranderd: penetratietesten, exploitgeneratie en het meeste werk op biologisch onderzoeksniveau worden nog steeds doorverwezen naar oudere Claude-modellen.
Hoe presteert Claude Fable 5.2 op de benchmarks?
Hier zijn de belangrijkste resultaten. Ze komen allemaal uit Anthropics lanceringstabel, dus lees ze als Anthropics onderbouwing voor het model en niet als onafhankelijke resultaten. De Claude-scores zijn gedraaid met waarborgen aan. Tenzij anders vermeld, wordt elk model getoond op zijn hoogst beschikbare inspanningsniveau.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (agentic coding) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2 (agentic coding) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench (business workflows) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| OSWorld 2.1 (computer use) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| RoboDojo Sim (robotics) | 64.9% | 27.6% | 39.4% | 29.8% | Not reported |
| AA-Briefcase v1.1 (knowledge work) | 66.1% | 61.5% | 61.2% | 52.0% | 61.8% |
| Remote Labor Index (knowledge work) | 41.3% | 17.9% | 21.3% | 20.8% | Not reported |
| Humanity's Last Exam (with tools) | 74.2% | 65.6% | 67.7% | 57.2% | Not reported |
| WANDR (agentic search) | 82.1% | 68.7% | 72.3% | Not reported | Not reported |
| Chartography (no tools) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
Agentic coding
Fable 5.2 leidt beide codingbenchmarks in de tabel. Op FrontierCode 2.0, dat meet of beheerders van open-sourceprojecten de codewijzigingen van een model zouden mergen, scoort het 49,1%, de hoogste in de tabel en ruim boven Fable 5.1's 32,4%. Op FrontierSWE v2 scoort het 69,9%, voor GPT-6 Astra (65,5%) en Opus 5.5 (62,3%).
De lanceervoorbeelden wijzen dezelfde kant op: agents die een vroege versie van Fable 5.2 draaiden, migreerden een productieservice van Python naar Rust, en die start nu ongeveer 26 keer sneller op.
Kenniswerk en onderzoek
De grootste relatieve sprong is op de Remote Labor Index, die meet hoe goed een model echte freelance-achtige projecten afrondt. Fable 5.2 scoort 41,3%, grofweg het dubbele van Opus 5.5 (21,3%) en GPT-6 Astra (20,8%). Het leidt ook op Humanity's Last Exam met tools (74,2%) en op Terminal-Bench-Science (74,6%, of 75,3% voor Mythos 5.2).
Bedrijfsautomatisering is het enige gebied waar het achterblijft. Op AutomationBench scoort Gemini 4 Carbon 53,9% tegenover Fable 5.2's 51,4%, al ligt Fable 5.2 nog steeds ver voor op Fable 5.1 (31,4%).
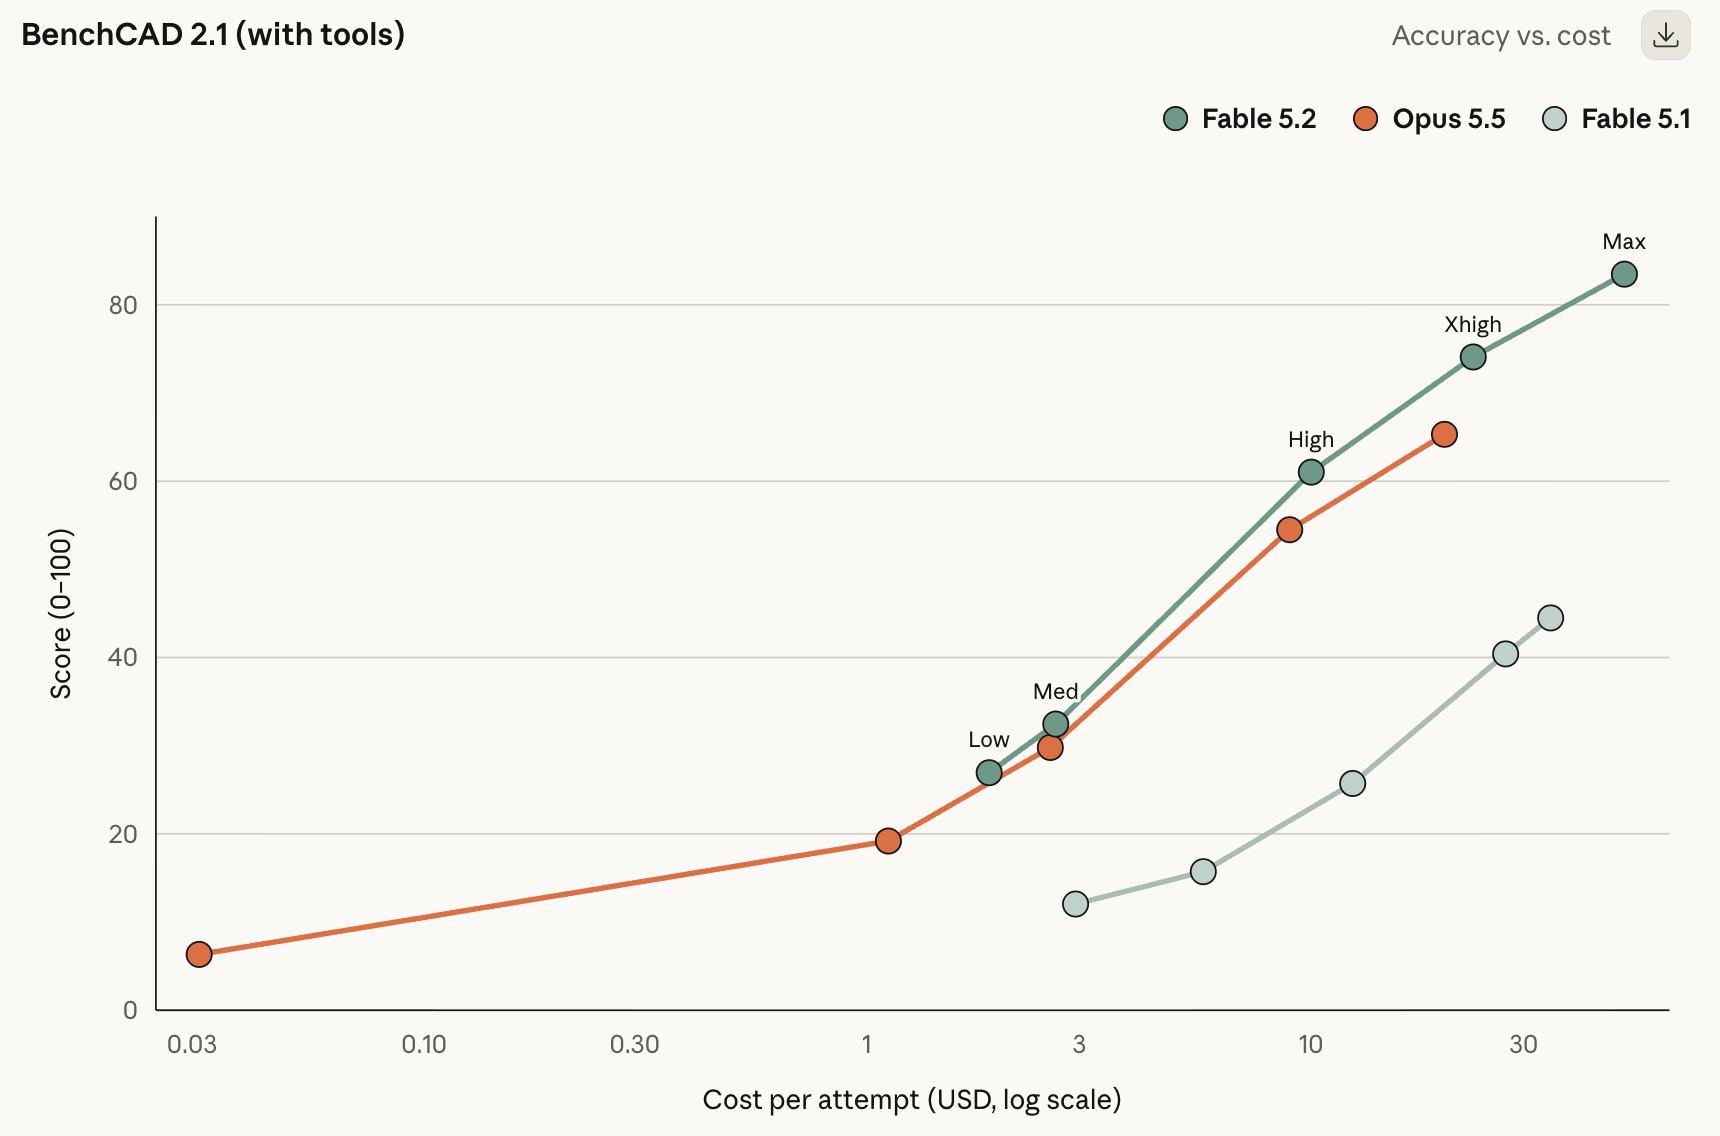
Buiten de hoofdtafel scoorde Fable 5.2 83,5 op de BenchCAD 2.1-hardware-engineeringbenchmark, vergeleken met 65,3 voor Opus 5.5. Het wordt ook gecrediteerd met het oplossen van twee open problemen in de zwartgatfysica, en die resultaten zijn gepost als preprints die andere fysici kunnen controleren.
Computergebruik, robotica en visie
Fable 5.2 scoort 89,3% op OSWorld 2.1, voor Opus 5.5 (87,2%) en GPT-6 Astra (79,5%). De sprong in robotica is de grootste in de tabel: 64,9% op RoboDojo Sim, meer dan het dubbele van Fable 5.1 en GPT-6 Astra. Op Chartography, dat het lezen van grafieken zonder tools test, blijft het net voor op Gemini 4 Carbon en GPT-6 Astra, nadat Fable 5.1 fors achterbleef op 44,8%.
Cybersecurity en biologie (Mythos 5.2)
De rijen over security en biologie gelden voor Mythos 5.2, aangezien de waarborgen van Fable 5.2 het merendeel van deze taken blokkeren. Mythos 5.2 scoort 76,3% op CyScenarioBench (vs 61,7% voor Mythos 5.1), 89,6% op CVE Rediscovery (vs 78,3%) en 85,1% op een 24-uurs taak voor het ontwerpen van eiwitbinders (vs 79,1%). Er is hier geen eerlijke vergelijking met OpenAI's securitymodel, omdat elk lab zijn eigen CyScenarioBench-taken draaide.
Wat is dit met Fermats laatste stelling?
Een team van Fable 5.2-agents formaliseerde het bewijs van Fermats laatste stelling in de Lean proof assistant in 30 uur. Je vraagt je misschien af: was de stelling niet al drie decennia geleden bewezen, wat valt er dan nog te doen?
De stelling is oud nieuws
Fermats laatste stelling zegt dat er geen positieve gehele getallen a, b en c zijn waarvoor an + bn = cn geldt voor enig n groter dan 2. Voor n = 2 zijn er genoeg oplossingen, zoals 32 + 42 = 52 (9 + 16 = 25). Maar probeer derde machten en je krijgt alleen bijna-treffers: 63 + 83 = 728, eentje minder dan 93 = 729.
Pierre de Fermat claimde in 1637 een bewijs maar schreef het nooit op, en het bleef meer dan 350 jaar onopgelost tot Andrew Wiles het in het midden van de jaren 90 bewees, met hulp van Richard Taylor.
Het bewijs van Wiles beslaat meer dan 100 pagina's en steunt op decennia aan geavanceerde getaltheorie, dus heel weinig mensen kunnen het van begin tot eind controleren. Lean is een proof assistant: een programmeertaal waarin je een bewijs als code schrijft, en de software controleert elke logische stap helemaal terug tot aan de basisaxioma's van de wiskunde. Als het bewijs compileert, is het correct. Een stelling "formaliseren" betekent het mensgeschreven bewijs vertalen naar deze door machines verifieerbare vorm.
Voor Fermats laatste stelling is dat een enorme klus, omdat veel van de wiskunde waar het bewijs op steunt nog nooit in Lean was opgeschreven. Wiskundige Kevin Buzzard startte in 2024 een communityproject om dit te doen.
Waarom het interessant is voor een AI-model
De meeste AI-output wordt beoordeeld door mensen of door benchmarks die slechts een deel van het antwoord testen. Een Lean-bewijs is anders: de checker accepteert elke stap of niet, dus er is geen manier om subtiel fout te zijn. Dat maakt het een ongewoon zuivere test of een model een heel lang, heel moeilijk project tot een geverifieerd einde kan brengen.
Dit is niet de eerste keer dat Claude dit doet. In september publiceerde Anthropic het eerste volledig computer-gecontroleerde bewijs van de stelling, geschreven door tientallen agents die een intern researchmodel draaiden dat ruwweg vergelijkbaar is met Fable 5.1. Die inspanning duurde 11 dagen en ongeveer zes miljard outputtokens, leverde 13 miljoen regels Lean op en bouwde deels voort op stukken van Buzzards project. Fable 5.2 deed het in 30 uur, met minimale menselijke hulp.
De kanttekeningen
- Het voegt niets toe aan de wiskunde. Buzzard zei hetzelfde over Anthropics eerste formalisatie.
- Fable 5.2 kreeg een lijst met tussentijdse stellingformuleringen om de voortgang bij te houden. Dat is een roadmap van wat te bewijzen, maar niet hoe het te bewijzen.
- Ik kon nog geen externe review van het nieuwe bewijs vinden, dus voorlopig zijn de 30 uur en de vergelijking met Opus 5.5 Anthropics claims.
Het meest veelzeggende is echter wat er gebeurde toen Anthropic Claude Opus 5.5 dezelfde taak gaf.
Claude Fable 5.2 vs. Claude Opus 5.5
Twee modellen vergelijken betekent meestal benchmarkscores lezen en proberen af te leiden hoe het verschil er in de praktijk uitziet. Deze keer waardeer ik dat Anthropic met een verhaal begon, waardoor het verschil duidelijker wordt.
In dezelfde Lean-setup met 1.000 agents voltooide Opus 5.5 26% van het bewijs van Fermats laatste stelling in 18 uur en boekte daarna nauwelijks nog vooruitgang. Fable 5.2 rondde het geheel af in 30 uur. De conclusie: bij zeer lange projecten met meerdere agents kan Opus 5.5 vastlopen waar Fable 5.2 door blijft gaan.
Bij kortere taken is het verschil kleiner. Zo staan de twee naast elkaar:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| Prijs (input / output per 1M tokens) | $8 / $40 | $4 / $20 |
| Contextvenster / max output | 1M / 128K | 1M / 128K |
| FrontierCode 2.0 (agentic coding) | 49.1% | 45.5% |
| FrontierSWE v2 (agentic coding) | 69.9% | 62.3% |
| OSWorld 2.1 (computer use) | 89.3% | 87.2% |
| AutomationBench (business workflows) | 51.4% | 42.5% |
| Humanity's Last Exam (with tools) | 74.2% | 67.7% |
| Remote Labor Index (knowledge work) | 41.3% | 21.3% |
| RoboDojo Sim (robotics) | 64.9% | 39.4% |
Het patroon komt overeen met het Lean-resultaat. Bij computergebruik en coderen ligt Fable 5.2 maar een paar punten voor. Bij open-einde, meerstapswerk wordt de voorsprong groter: Fable 5.2 verdubbelt bijna de score van Opus 5.5 op de freelance-achtige projecten in de Remote Labor Index, en het ligt 25 punten voor bij robotbesturing.
De prijs is minder een kloof dan het lijkt. Fable 5.2 kost twee keer zoveel per token, maar het kan vaak de beste score van Opus 5.5 halen op een lager inspanningsniveau, met minder tokens. Op FrontierCode 2.0, bijvoorbeeld, evenaart Fable 5.2 bij hoge inspanning grofweg de beste score van Opus 5.5 tegen ongeveer de helft van de kosten per taak.
Dus Opus 5.5 blijft de logische standaard. Maar als een taak urenlang draait, veel agents omvat of steeds vastloopt op Opus, zal Fable 5.2 het waarschijnlijk afronden, en het hoeft niet zoveel duurder uit te vallen als de prijs per token doet vermoeden.
Veiligheid en beperkingen
Anthropic schat het risico dat deze modellen zich onveilig gedragen in situaties met hoge inzet als laag in.
Dat is van buitenaf lastig te controleren, dus de concretere cijfers zijn nuttig. Op een geautomatiseerde gedragsaudit van ongeveer 1.900 scenario's had Mythos 5.2 de laagste score voor misaligned gedrag van de vergeleken modellen. Het had ook minder kans om input te hallucineren, onterecht te beweren dat een taak klaar was of slecht werk te verbergen.
Er zijn nog een paar interessante punten het vermelden waard die je aan het denken zetten:
- Bewustzijn van evaluatie: Zowel Fable 5.2 als Mythos 5.2 geven vaker aan te vermoeden dat ze getest worden dan eerdere modellen, wat evaluaties zoals hierboven lastiger maakt om op te vertrouwen.
- Bewust begrensde AI-onderzoeksvaardigheden: Anthropic beperkte de winst van de modellen op twee gebieden, accelerator-kerneloptimalisatie en het verbeteren van LLM-architecturen, zodat ze daar ongeveer op het niveau van Opus 5.5 presteren.
- Distillatiebescherming: Fable 5.2 heeft Anthropics sterkste anti-distillatiemaatregelen tot nu toe, en "preserved thinking", waarmee API-gebruikers eerdere context niet kunnen bewerken om de redenering van het model te extraheren, geldt nu voor alle accounts.
Welke Claude-modellen moet je gebruiken?
Mijn advies komt overeen met dat van Anthropic: begin met Opus 5.5 en stap alleen over als het nodig is. Zo ziet de line-up eruit:
- Claude Opus 5.5 ($4/$20): De standaard voor het meeste codeer-, onderzoeks- en kenniswerk. Het is de helft van de prijs van Fable 5.2 per token en ligt op veel benchmarks niet ver achter.
- Claude Fable 5.2 ($8/$40): Voor de moeilijkste problemen, lange multi-agent-runs en taken waar Opus 5.5 vastloopt, zoals grote migraties, redeneren op onderzoeksniveau of hardwaredesign. Probeer het op lagere inspanningsniveaus voordat je aanneemt dat je maximale inspanning nodig hebt.
- Claude Mythos 5.2: Voor geverifieerde securityteams en life sciences-onderzoekers die capaciteiten nodig hebben die door de waarborgen van Fable 5.2 worden geblokkeerd.
- Claude Sonnet 5.5 en Haiku 5.5: Voor taken met hoog volume, eenvoudiger werk of lage latency, of als de kleinere modellen die Fable 5.2 orkestreert.
Claude Fable 5.2: prijs en beschikbaarheid
| Per 1M tokens | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Input | $8 | $10 | $4 |
| Output | $40 | $50 | $20 |
| Cache-reads | $0.20 | $0.25 | $0.20 |
| Cache-writes van 5 minuten | $10 | $12.50 | $5 |
| Batch (input / output) | $4 / $20 | $5 / $25 | $2 / $10 |
| Fast mode (input / output) | $16 / $80 | Not listed | $8 / $40 |
We hadden net een tabel bekeken met benchmarkresultaten waarop Fable 5.2 Fable 5.1 op alles verslaat. Nu laat ik je een tabel zien waaruit blijkt dat Fable 5.2 goedkoper is dan 5.1. Dus is Fable 5.1 verouderd?
Voor nieuw werk: in feite wel. Als je toegang hebt tot Fable 5.2, is er weinig reden om iets nieuws op 5.1 te starten. Anthropic heeft echter geen einddatum voor 5.1 aangekondigd, en teams met prompts of agents die op Fable 5.1 zijn getuned, willen 5.2 testen voordat ze overschakelen. We weten dat een nieuwe versie zich anders kan gedragen, zelfs als hij beter scoort.
Hoe krijg je toegang tot Claude Fable 5.2
-
Claude-apps: Fable 5.2 is beschikbaar op in aanmerking komende betaalde abonnementen. Als lanceringspromo kunnen Pro-abonnementen en standaard Team-plekken Fable gebruiken voor tot 50% van hun wekelijkse gebruikslimieten, en abonnementen die Fable bevatten krijgen één tot drie gebruiksresets afhankelijk van de abonnementsduur.
-
API: Gebruik de model-ID claude-fable-5-2 op het Claude Platform.
-
Cloudplatforms: Het is beschikbaar op Amazon Web Services, Google Cloud en Microsoft Azure.
-
Mythos 5.2: Dien een aanvraag in via het Cyber Verification Program of het Life Sciences Verification Program. Klanten van Claude Enterprise kunnen het ook gebruiken via Claude Security.
Enterprises met strikte data-eisen kunnen Enterprise Frontier Safeguards gebruiken, waarmee Anthropics veiligheidsmonitoring draait op data die is opgeslagen in de eigen infrastructuur van de klant en dat werkt met zero data retention. Andere klanten hebben 30 dagen dataretentie voor veiligheidsmonitoring.
Slotgedachten
Claude Fable 5.2 is een betekenisvolle stap vooruit ten opzichte van Fable 5.1. Het is goedkoper, sneller en minder geneigd legitiem werk te weigeren. De sprongen op Remote Labor Index, robotica en FrontierCode zijn bijzonder groot.
Dat gezegd, Opus 5.5 blijft voor de meeste alledaagse taken de betere waarde tegen de halve prijs. Het interessantste aan Fable 5.2 zijn misschien de efficiëntieclaims: als het echt de beste scores van Opus 5.5 evenaart op lage of middelhoge inspanning, krimpt de premie per token snel. Dat is het waard om te testen op je eigen workloads.
Wil je praktisch aan de slag met Claude? Onze Developing AI Applications-track is een goed startpunt.



Vandaag kondigde Anthropic Fable 5.2 aan voor iedereen en Mythos 5.2 voor geverifieerde organisaties. Het gaat om hetzelfde onderliggende model, maar de Fable-versie heeft extra waarborgen voor cybersecurity en biologie.
De belangrijkste veranderingen zijn:
Concreter: Fable 5.2 kost 20% minder dan Fable 5.1, genereert tot 30% sneller output en verslaat GPT-6 Astra en Gemini 4 Carbon op de meeste rijen van Anthropics benchmarktabel.
In dit artikel behandel ik wat er nieuw is in Fable 5.2 en Mythos 5.2, hoe ze presteren op de benchmarks, wat ze kosten en hoe je beslist of je ze nodig hebt boven Claude Opus 5.5.
Wat is Claude Fable 5.2?
Claude Fable 5.2 is Anthropics meest capabele algemeen beschikbare model. Het is gebouwd voor lang, veeleisend technisch werk: migraties van grote codebases, agent-runs van meerdere dagen, onderzoeksproblemen en engineeringdesign.
Fable 5.2 kan ook samenwerken met de kleinere modellen, bijvoorbeeld als adviseur die ze raadplegen bij moeilijke problemen of als orkestrator die eenvoudigere subtaken aan hen doorgeeft.
Fable 5.2 behoudt het contextvenster van 1M tokens en de maximale output van 128K van zijn voorganger, en de knowledge cutoff is juni 2026.
Wat is Claude Mythos 5.2?
Claude Mythos 5.2 is hetzelfde model als Fable 5.2 maar zonder de waarborgen die het meeste cybersecuritywerk en biologie op onderzoeksniveau blokkeren. Mythos 5.2 is zelfs Anthropics meest capabele model voor cybersecurity-engineering. Omdat dit soort capaciteiten dual-use zijn, biedt Anthropic Mythos 5.2 alleen aan geverifieerde organisaties via het Cyber Verification Program en het Life Sciences Verification Program.
Wat is er nieuw in Claude Fable 5.2?
Fable bestaat pas sinds juni, toen Anthropic Fable 5 uitbracht. Sindsdien zijn er twee puntreleases geweest, Fable 5.1 in september en nu Fable 5.2, en geen van beide heeft veel nieuwe features toegevoegd. Beide hebben het model vooral goedkoper, sneller en sterker gemaakt, al zijn de prestatiewinsten niet klein geweest: Fable 5.2 meer dan verdubbelt bijvoorbeeld Fable 5.1's score op de Remote Labor Index.
Het grootste verschil tussen de twee releases zit in hoe je het model mag gebruiken. Met Fable 5.1 versmalde Anthropic zijn cybersecurity-waarborgen en stond het toe dat het model werd gebruikt om softwarekwetsbaarheden te vinden, maar niet om daar exploits voor te schrijven, en het kondigde Enterprise Frontier Safeguards aan, een optie om je data in je eigen cloud te houden, tegelijk met de release. De aanpassingen in de waarborgen van Fable 5.2 zijn kleiner: het blokkeert minder verzoeken, maar dezelfde soorten taken blijven verboden terrein.
De nieuwe manieren waarop Anthropic voorstelt het te gebruiken, zoals Fable 5.2 kleinere Claude-modellen laten adviseren, zijn ook niet echt nieuw, aangezien Anthropics advisor-tool Fable 5 en 5.1 al ondersteunde. En de lanceringdemo's, zoals het besturingssysteem dat uit een lege map is opgebouwd, laten een sterker model zien dat moeilijkere dingen doet, geen nieuwe features die je kunt inschakelen.
Dat gezegd hebbende, als ik nieuwe dingen moet aanwijzen, zou ik dit noemen:
Een lagere prijs
Fable 5.2 kost $8 per miljoen inputtokens en $40 per miljoen outputtokens, 20% minder dan Fable 5.1's $10/$50. Dezelfde korting van 20% geldt voor cache-reads ($0,20), cache-writes en batchverwerking. Zie de prijzensectie hieronder voor het volledige overzicht.
Snellere output, en fast mode voor Fable
Output is tot 30% sneller dan Fable 5.1, wat optelt tijdens een lange agent-run. Fable ondersteunt nu ook fast mode, die de output tot wel 2,5x versnelt tegen dubbel de prijs ($16/$80).
Betere resultaten met minder inspanning
Dit is de verandering die waarschijnlijk het meeste effect heeft op je rekening. Bij hoge inspanning scoort Fable 5.2 45,3% op FrontierCode 2.0, ongeveer op het niveau van Opus 5.5's beste score, tegen grofweg de helft van de kosten per taak. Bij lage inspanning evenaart het Opus 5.5's topscore op Humanity's Last Exam tegen minder dan een tiende van de kosten per taak. Mijn advies: Als je overstapt van Opus 5.5, begin dan met Fable 5.2 op een lager inspanningsniveau.
Minder geblokkeerde verzoeken
Fable 5.2 zou ongeveer 55% minder safety blocks moeten treffen dan Fable 5.1 (ongeveer 60% minder in cybersecurity en 40% minder in biologie). Dat is een groot verschil als de weigeringen van Fable 5.1 je in de weg zaten, maar de categorieën die worden geblokkeerd zijn niet veranderd: penetratietesten, exploitgeneratie en het meeste werk op biologisch onderzoeksniveau worden nog steeds doorverwezen naar oudere Claude-modellen.
Hoe presteert Claude Fable 5.2 op de benchmarks?
Hier zijn de belangrijkste resultaten. Ze komen allemaal uit Anthropics lanceringstabel, dus lees ze als Anthropics onderbouwing voor het model en niet als onafhankelijke resultaten. De Claude-scores zijn gedraaid met waarborgen aan. Tenzij anders vermeld, wordt elk model getoond op zijn hoogst beschikbare inspanningsniveau.
Agentic coding
Fable 5.2 leidt beide codingbenchmarks in de tabel. Op FrontierCode 2.0, dat meet of beheerders van open-sourceprojecten de codewijzigingen van een model zouden mergen, scoort het 49,1%, de hoogste in de tabel en ruim boven Fable 5.1's 32,4%. Op FrontierSWE v2 scoort het 69,9%, voor GPT-6 Astra (65,5%) en Opus 5.5 (62,3%).
De lanceervoorbeelden wijzen dezelfde kant op: agents die een vroege versie van Fable 5.2 draaiden, migreerden een productieservice van Python naar Rust, en die start nu ongeveer 26 keer sneller op.
Kenniswerk en onderzoek
De grootste relatieve sprong is op de Remote Labor Index, die meet hoe goed een model echte freelance-achtige projecten afrondt. Fable 5.2 scoort 41,3%, grofweg het dubbele van Opus 5.5 (21,3%) en GPT-6 Astra (20,8%). Het leidt ook op Humanity's Last Exam met tools (74,2%) en op Terminal-Bench-Science (74,6%, of 75,3% voor Mythos 5.2).
Bedrijfsautomatisering is het enige gebied waar het achterblijft. Op AutomationBench scoort Gemini 4 Carbon 53,9% tegenover Fable 5.2's 51,4%, al ligt Fable 5.2 nog steeds ver voor op Fable 5.1 (31,4%).
Buiten de hoofdtafel scoorde Fable 5.2 83,5 op de BenchCAD 2.1-hardware-engineeringbenchmark, vergeleken met 65,3 voor Opus 5.5. Het wordt ook gecrediteerd met het oplossen van twee open problemen in de zwartgatfysica, en die resultaten zijn gepost als preprints die andere fysici kunnen controleren.
Computergebruik, robotica en visie
Fable 5.2 scoort 89,3% op OSWorld 2.1, voor Opus 5.5 (87,2%) en GPT-6 Astra (79,5%). De sprong in robotica is de grootste in de tabel: 64,9% op RoboDojo Sim, meer dan het dubbele van Fable 5.1 en GPT-6 Astra. Op Chartography, dat het lezen van grafieken zonder tools test, blijft het net voor op Gemini 4 Carbon en GPT-6 Astra, nadat Fable 5.1 fors achterbleef op 44,8%.
Cybersecurity en biologie (Mythos 5.2)
De rijen over security en biologie gelden voor Mythos 5.2, aangezien de waarborgen van Fable 5.2 het merendeel van deze taken blokkeren. Mythos 5.2 scoort 76,3% op CyScenarioBench (vs 61,7% voor Mythos 5.1), 89,6% op CVE Rediscovery (vs 78,3%) en 85,1% op een 24-uurs taak voor het ontwerpen van eiwitbinders (vs 79,1%). Er is hier geen eerlijke vergelijking met OpenAI's securitymodel, omdat elk lab zijn eigen CyScenarioBench-taken draaide.
Wat is dit met Fermats laatste stelling?
Een team van Fable 5.2-agents formaliseerde het bewijs van Fermats laatste stelling in de Lean proof assistant in 30 uur. Je vraagt je misschien af: was de stelling niet al drie decennia geleden bewezen, wat valt er dan nog te doen?
De stelling is oud nieuws
Fermats laatste stelling zegt dat er geen positieve gehele getallen a, b en c zijn waarvoor an + bn = cn geldt voor enig n groter dan 2. Voor n = 2 zijn er genoeg oplossingen, zoals 32 + 42 = 52 (9 + 16 = 25). Maar probeer derde machten en je krijgt alleen bijna-treffers: 63 + 83 = 728, eentje minder dan 93 = 729.
Pierre de Fermat claimde in 1637 een bewijs maar schreef het nooit op, en het bleef meer dan 350 jaar onopgelost tot Andrew Wiles het in het midden van de jaren 90 bewees, met hulp van Richard Taylor.
Wat een Lean-formalisatie is
Het bewijs van Wiles beslaat meer dan 100 pagina's en steunt op decennia aan geavanceerde getaltheorie, dus heel weinig mensen kunnen het van begin tot eind controleren. Lean is een proof assistant: een programmeertaal waarin je een bewijs als code schrijft, en de software controleert elke logische stap helemaal terug tot aan de basisaxioma's van de wiskunde. Als het bewijs compileert, is het correct. Een stelling "formaliseren" betekent het mensgeschreven bewijs vertalen naar deze door machines verifieerbare vorm.
Voor Fermats laatste stelling is dat een enorme klus, omdat veel van de wiskunde waar het bewijs op steunt nog nooit in Lean was opgeschreven. Wiskundige Kevin Buzzard startte in 2024 een communityproject om dit te doen.
Waarom het interessant is voor een AI-model
De meeste AI-output wordt beoordeeld door mensen of door benchmarks die slechts een deel van het antwoord testen. Een Lean-bewijs is anders: de checker accepteert elke stap of niet, dus er is geen manier om subtiel fout te zijn. Dat maakt het een ongewoon zuivere test of een model een heel lang, heel moeilijk project tot een geverifieerd einde kan brengen.
Dit is niet de eerste keer dat Claude dit doet. In september publiceerde Anthropic het eerste volledig computer-gecontroleerde bewijs van de stelling, geschreven door tientallen agents die een intern researchmodel draaiden dat ruwweg vergelijkbaar is met Fable 5.1. Die inspanning duurde 11 dagen en ongeveer zes miljard outputtokens, leverde 13 miljoen regels Lean op en bouwde deels voort op stukken van Buzzards project. Fable 5.2 deed het in 30 uur, met minimale menselijke hulp.
De kanttekeningen
Het meest veelzeggende is echter wat er gebeurde toen Anthropic Claude Opus 5.5 dezelfde taak gaf.
Claude Fable 5.2 vs. Claude Opus 5.5
Twee modellen vergelijken betekent meestal benchmarkscores lezen en proberen af te leiden hoe het verschil er in de praktijk uitziet. Deze keer waardeer ik dat Anthropic met een verhaal begon, waardoor het verschil duidelijker wordt.
In dezelfde Lean-setup met 1.000 agents voltooide Opus 5.5 26% van het bewijs van Fermats laatste stelling in 18 uur en boekte daarna nauwelijks nog vooruitgang. Fable 5.2 rondde het geheel af in 30 uur. De conclusie: bij zeer lange projecten met meerdere agents kan Opus 5.5 vastlopen waar Fable 5.2 door blijft gaan.
Bij kortere taken is het verschil kleiner. Zo staan de twee naast elkaar:
Het patroon komt overeen met het Lean-resultaat. Bij computergebruik en coderen ligt Fable 5.2 maar een paar punten voor. Bij open-einde, meerstapswerk wordt de voorsprong groter: Fable 5.2 verdubbelt bijna de score van Opus 5.5 op de freelance-achtige projecten in de Remote Labor Index, en het ligt 25 punten voor bij robotbesturing.
De prijs is minder een kloof dan het lijkt. Fable 5.2 kost twee keer zoveel per token, maar het kan vaak de beste score van Opus 5.5 halen op een lager inspanningsniveau, met minder tokens. Op FrontierCode 2.0, bijvoorbeeld, evenaart Fable 5.2 bij hoge inspanning grofweg de beste score van Opus 5.5 tegen ongeveer de helft van de kosten per taak.
Dus Opus 5.5 blijft de logische standaard. Maar als een taak urenlang draait, veel agents omvat of steeds vastloopt op Opus, zal Fable 5.2 het waarschijnlijk afronden, en het hoeft niet zoveel duurder uit te vallen als de prijs per token doet vermoeden.
Veiligheid en beperkingen
Anthropic schat het risico dat deze modellen zich onveilig gedragen in situaties met hoge inzet als laag in.
Dat is van buitenaf lastig te controleren, dus de concretere cijfers zijn nuttig. Op een geautomatiseerde gedragsaudit van ongeveer 1.900 scenario's had Mythos 5.2 de laagste score voor misaligned gedrag van de vergeleken modellen. Het had ook minder kans om input te hallucineren, onterecht te beweren dat een taak klaar was of slecht werk te verbergen.
Er zijn nog een paar interessante punten het vermelden waard die je aan het denken zetten:
Welke Claude-modellen moet je gebruiken?
Mijn advies komt overeen met dat van Anthropic: begin met Opus 5.5 en stap alleen over als het nodig is. Zo ziet de line-up eruit:
Claude Fable 5.2: prijs en beschikbaarheid
We hadden net een tabel bekeken met benchmarkresultaten waarop Fable 5.2 Fable 5.1 op alles verslaat. Nu laat ik je een tabel zien waaruit blijkt dat Fable 5.2 goedkoper is dan 5.1. Dus is Fable 5.1 verouderd?
Voor nieuw werk: in feite wel. Als je toegang hebt tot Fable 5.2, is er weinig reden om iets nieuws op 5.1 te starten. Anthropic heeft echter geen einddatum voor 5.1 aangekondigd, en teams met prompts of agents die op Fable 5.1 zijn getuned, willen 5.2 testen voordat ze overschakelen. We weten dat een nieuwe versie zich anders kan gedragen, zelfs als hij beter scoort.
Hoe krijg je toegang tot Claude Fable 5.2
Claude-apps: Fable 5.2 is beschikbaar op in aanmerking komende betaalde abonnementen. Als lanceringspromo kunnen Pro-abonnementen en standaard Team-plekken Fable gebruiken voor tot 50% van hun wekelijkse gebruikslimieten, en abonnementen die Fable bevatten krijgen één tot drie gebruiksresets afhankelijk van de abonnementsduur.
API: Gebruik de model-ID
claude-fable-5-2op het Claude Platform.Cloudplatforms: Het is beschikbaar op Amazon Web Services, Google Cloud en Microsoft Azure.
Mythos 5.2: Dien een aanvraag in via het Cyber Verification Program of het Life Sciences Verification Program. Klanten van Claude Enterprise kunnen het ook gebruiken via Claude Security.
Enterprises met strikte data-eisen kunnen Enterprise Frontier Safeguards gebruiken, waarmee Anthropics veiligheidsmonitoring draait op data die is opgeslagen in de eigen infrastructuur van de klant en dat werkt met zero data retention. Andere klanten hebben 30 dagen dataretentie voor veiligheidsmonitoring.
Slotgedachten
Claude Fable 5.2 is een betekenisvolle stap vooruit ten opzichte van Fable 5.1. Het is goedkoper, sneller en minder geneigd legitiem werk te weigeren. De sprongen op Remote Labor Index, robotica en FrontierCode zijn bijzonder groot.
Dat gezegd, Opus 5.5 blijft voor de meeste alledaagse taken de betere waarde tegen de halve prijs. Het interessantste aan Fable 5.2 zijn misschien de efficiëntieclaims: als het echt de beste scores van Opus 5.5 evenaart op lage of middelhoge inspanning, krimpt de premie per token snel. Dat is het waard om te testen op je eigen workloads.
Wil je praktisch aan de slag met Claude? Onze Developing AI Applications-track is een goed startpunt.