Hari ini, Anthropic mengumumkan Fable 5.2 untuk semua orang dan Mythos 5.2 untuk organisasi yang telah diverifikasi. Keduanya adalah model dasar yang sama, tetapi versi Fable memiliki perlindungan tambahan untuk keamanan siber dan biologi.
Perubahan utama adalah:
- harga lebih rendah,
- keluaran lebih cepat, dan
- lonjakan besar pada tolok ukur paling menantang dari Anthropic.
Secara lebih spesifik, Fable 5.2 20% lebih murah daripada Fable 5.1, menghasilkan keluaran hingga 30% lebih cepat, dan mengungguli GPT-6 Astra dan Gemini 4 Carbon pada sebagian besar baris di tabel tolok ukur Anthropic.
Dalam artikel ini, saya akan membahas apa yang baru di Fable 5.2 dan Mythos 5.2, bagaimana kinerjanya pada tolok ukur, berapa biayanya, dan cara memutuskan apakah Anda memerlukannya dibandingkan Claude Opus 5.5.
Apa Itu Claude Fable 5.2?
Claude Fable 5.2 adalah model paling andal dari Anthropic yang tersedia secara umum. Model ini dibuat untuk pekerjaan teknis yang panjang dan menuntut: migrasi basis kode besar, menjalankan agen berhari-hari, masalah riset, dan perancangan rekayasa.
Fable 5.2 juga dapat bekerja berdampingan dengan model yang lebih kecil, baik sebagai penasihat yang mereka konsultasikan untuk masalah sulit atau sebagai pengatur yang meneruskan sub-tugas yang lebih sederhana kepada mereka.
Fable 5.2 mempertahankan jendela konteks 1 juta token dan keluaran maksimum 128K seperti pendahulunya, serta batas pengetahuan pada Juni 2026.
Apa Itu Claude Mythos 5.2?
Claude Mythos 5.2 adalah model yang sama dengan Fable 5.2 tetapi tanpa perlindungan yang memblokir sebagian besar pekerjaan keamanan siber dan pekerjaan biologi tingkat riset. Faktanya, Mythos 5.2 adalah model Anthropic yang paling andal untuk rekayasa keamanan siber. Karena kemampuan semacam ini bersifat ganda (dual-use), Anthropic hanya menawarkan Mythos 5.2 kepada organisasi yang telah diverifikasi melalui Cyber Verification Program dan Life Sciences Verification Program.
Apa yang Baru di Claude Fable 5.2?
Fable baru hadir sejak Juni, ketika Anthropic merilis Fable 5. Sejak itu, ada dua rilis titik, Fable 5.1 pada September dan kini Fable 5.2, dan keduanya tidak banyak menambahkan fitur baru. Keduanya terutama membuat model menjadi lebih murah, lebih cepat, dan lebih kuat, meskipun peningkatan kinerja tidak kecil: misalnya, Fable 5.2 lebih dari dua kali lipat skor Fable 5.1 pada Remote Labor Index.
Perbedaan yang lebih besar antara kedua rilis terletak pada bagaimana Anda diizinkan menggunakan model. Dengan Fable 5.1, Anthropic mempersempit perlindungan keamanan sibernya dan mulai mengizinkan model digunakan untuk menemukan kerentanan perangkat lunak, meski tidak untuk menulis eksploitnya, dan bersamaan dengan rilis tersebut, mengumumkan Enterprise Frontier Safeguards, opsi untuk menyimpan data di cloud Anda sendiri. Perubahan perlindungan di Fable 5.2 lebih kecil: ia memblokir lebih sedikit permintaan, tetapi jenis tugas yang dilarang tetap sama.
Cara baru yang disarankan Anthropic untuk menggunakannya, seperti menjadikan Fable 5.2 sebagai penasihat bagi model Claude yang lebih kecil, juga bukan hal baru, karena alat advisor Anthropic sudah mendukung Fable 5 dan 5.1. Dan demo peluncurannya, seperti sistem operasi yang dibangun dari folder kosong, menunjukkan model yang lebih kuat melakukan hal yang lebih sulit, bukan fitur baru yang bisa Anda aktifkan.
Meski begitu, jika saya harus menunjuk hal-hal baru, berikut yang saya sebutkan:
Harga lebih rendah
Fable 5.2 berharga $8 per juta token masukan dan $40 per juta token keluaran, 20% lebih rendah daripada harga Fable 5.1 sebesar $10/$50. Pemotongan 20% yang sama berlaku untuk pembacaan cache ($0,20), penulisan cache, dan pemrosesan batch. Lihat bagian harga di bawah untuk rincian lengkapnya.
Keluaran lebih cepat, dan mode cepat untuk Fable
Keluaran hingga 30% lebih cepat dari Fable 5.1, yang akan terasa pada proses agen yang panjang. Fable kini juga mendukung mode cepat, yang mempercepat keluaran hingga 2,5x dengan harga dua kali lipat ($16/$80).
Hasil lebih baik dengan upaya lebih rendah
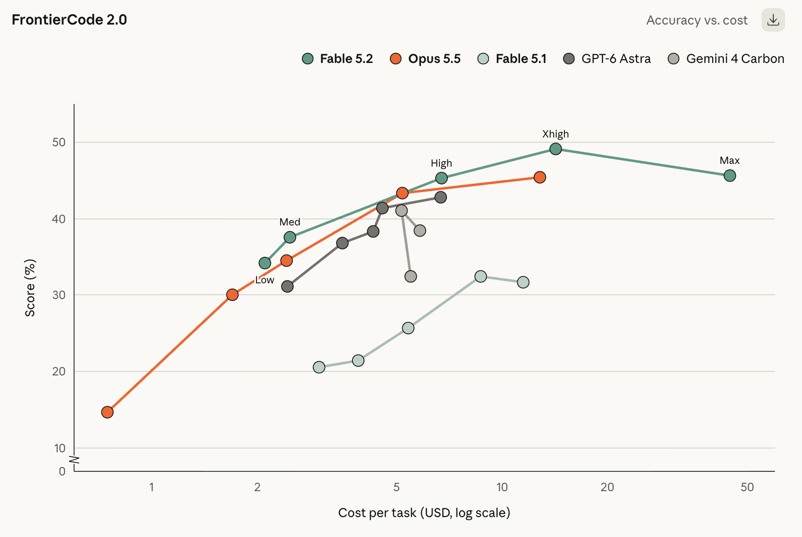
Inilah perubahan yang paling mungkin memengaruhi tagihan Anda. Pada upaya tinggi, Fable 5.2 mencetak 45,3% pada FrontierCode 2.0, setara dengan skor terbaik Opus 5.5, dengan kira-kira separuh biaya per tugas. Pada upaya rendah, model ini menyamai skor tertinggi Opus 5.5 pada Humanity's Last Exam dengan kurang dari sepersepuluh biaya per tugas. Pandangan saya: Jika Anda naik dari Opus 5.5, mulailah Fable 5.2 pada tingkat upaya yang lebih rendah.
Lebih sedikit permintaan yang diblokir
Fable 5.2 seharusnya mengalami sekitar 55% lebih sedikit blokir keamanan dibandingkan Fable 5.1 (sekitar 60% lebih sedikit di keamanan siber dan 40% lebih sedikit di biologi). Ini penting jika penolakan Fable 5.1 menghambat pekerjaan Anda, tetapi kategori yang diblokir tidak berubah: pengujian penetrasi, pembuatan eksploit, dan sebagian besar biologi tingkat riset masih dialihkan ke model Claude yang lebih lama.
Bagaimana Kinerja Claude Fable 5.2 pada Tolok Ukur?
Berikut hasil utamanya. Semuanya berasal dari tabel peluncuran Anthropic, jadi bacalah sebagai argumen Anthropic untuk model ini, bukan hasil independen. Skor Claude dijalankan dengan perlindungan aktif. Kecuali disebutkan, setiap model ditampilkan pada upaya tertinggi yang tersedia.
| Tolok ukur | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (pengodean agen) | 49,1% | 32,4% | 45,5% | 42,8% | 41,1% |
| FrontierSWE v2 (pengodean agen) | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench (alur kerja bisnis) | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Terminal-Bench-Science 0,1 | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| OSWorld 2.1 (penggunaan komputer) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| RoboDojo Sim (robotika) | 64,9% | 27,6% | 39,4% | 29,8% | Tidak dilaporkan |
| AA-Briefcase v1.1 (pekerjaan pengetahuan) | 66,1% | 61,5% | 61,2% | 52,0% | 61,8% |
| Remote Labor Index (pekerjaan pengetahuan) | 41,3% | 17,9% | 21,3% | 20,8% | Tidak dilaporkan |
| Humanity's Last Exam (dengan tools) | 74,2% | 65,6% | 67,7% | 57,2% | Tidak dilaporkan |
| WANDR (pencarian agen) | 82,1% | 68,7% | 72,3% | Tidak dilaporkan | Tidak dilaporkan |
| Chartography (tanpa tools) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
Pengodean agen
Fable 5.2 memimpin kedua tolok ukur pengodean di tabel. Pada FrontierCode 2.0, yang mengukur apakah pengelola open-source akan menggabungkan perubahan kode dari model, model ini mencetak 49,1%, tertinggi di tabel dan jauh di atas Fable 5.1 yang 32,4%. Pada FrontierSWE v2, model ini mencetak 69,9%, di depan GPT-6 Astra (65,5%) dan Opus 5.5 (62,3%).
Contoh peluncuran menunjukkan arah yang sama: agen yang menjalankan versi awal Fable 5.2 memigrasikan layanan produksi dari Python ke Rust, dan kini ia mulai sekitar 26 kali lebih cepat.
Pekerjaan pengetahuan dan riset
Lompatan relatif terbesar ada pada Remote Labor Index, yang mengukur seberapa baik model menyelesaikan proyek gaya freelance nyata. Fable 5.2 mencetak 41,3%, kira-kira dua kali lipat Opus 5.5 (21,3%) dan GPT-6 Astra (20,8%). Model ini juga memimpin pada Humanity's Last Exam dengan tools (74,2%) dan pada Terminal-Bench-Science (74,6%, atau 75,3% untuk Mythos 5.2).
Otomatisasi bisnis adalah satu area di mana ia tertinggal. Pada AutomationBench, Gemini 4 Carbon mencetak 53,9% dibandingkan 51,4% milik Fable 5.2, meskipun Fable 5.2 masih jauh di depan Fable 5.1 (31,4%).
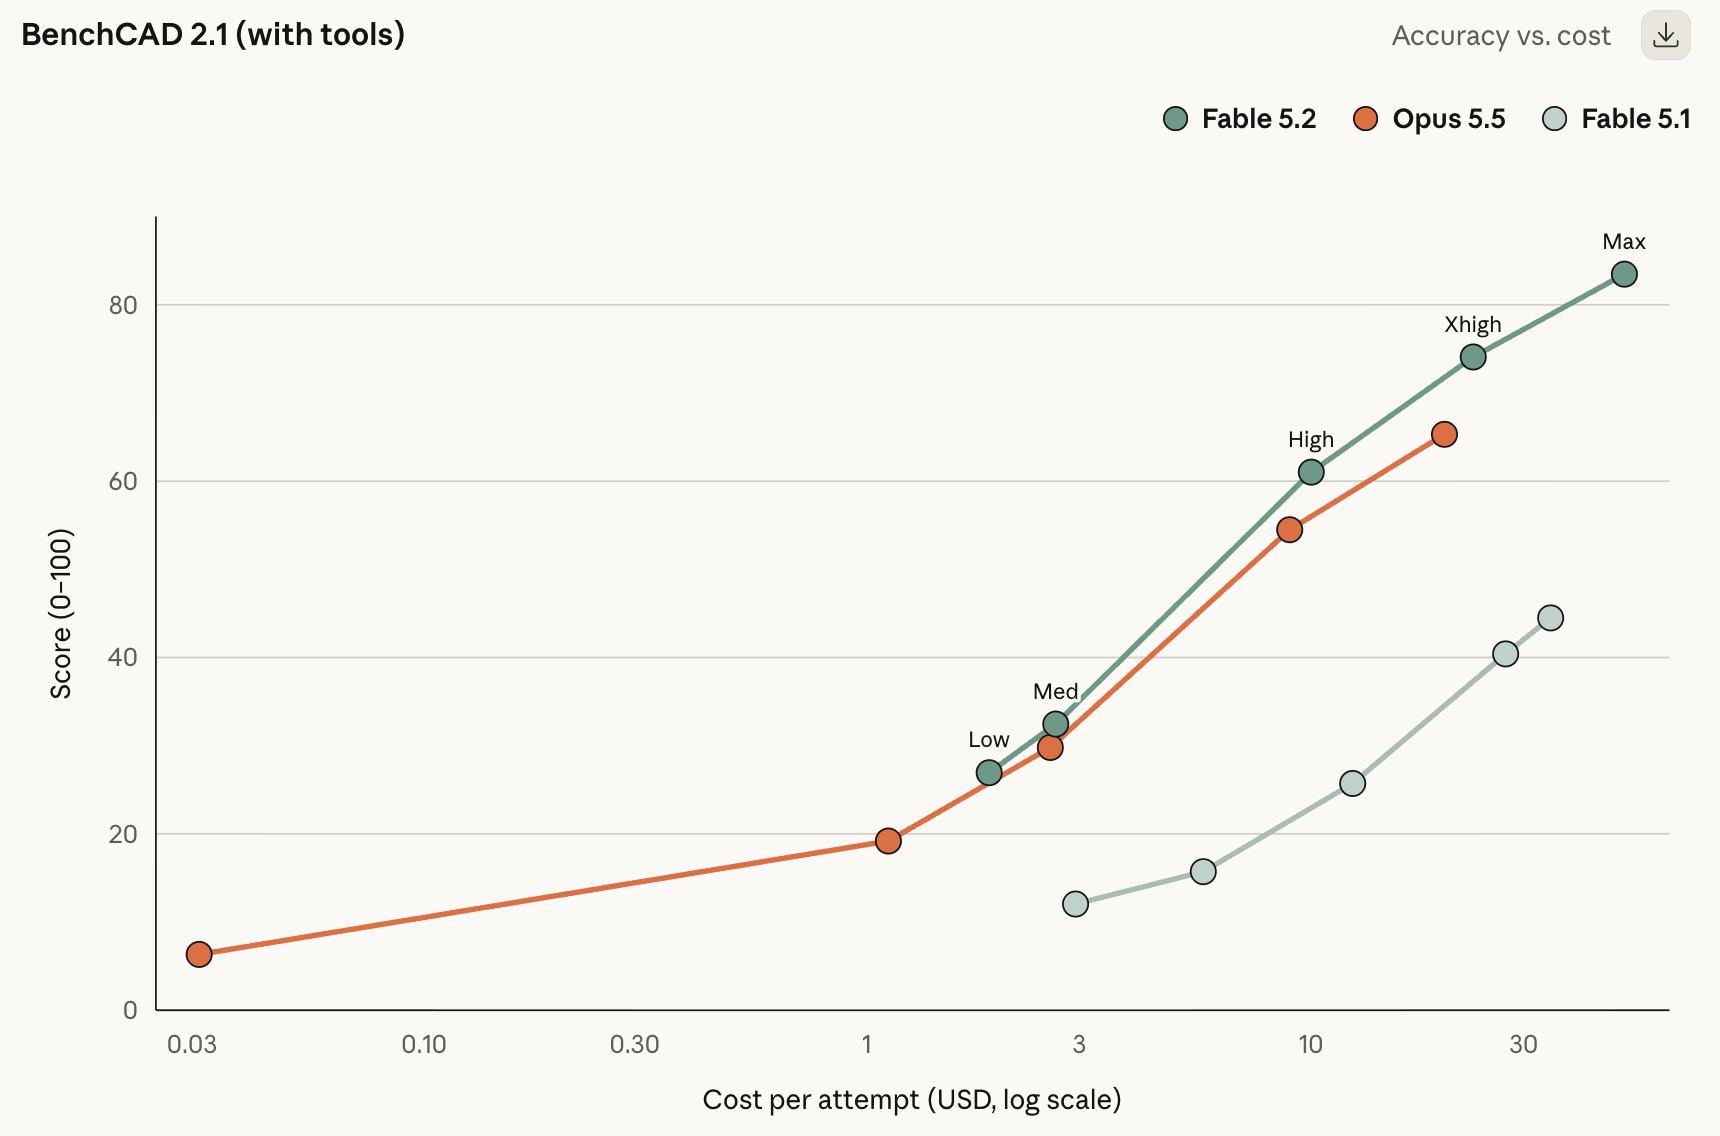
Di luar tabel utama, Fable 5.2 mencetak 83,5 pada tolok ukur rekayasa perangkat keras BenchCAD 2.1, dibandingkan 65,3 untuk Opus 5.5. Model ini juga dikreditkan menyelesaikan dua masalah terbuka dalam fisika lubang hitam, dan hasilnya diposting sebagai pracetak yang dapat diperiksa oleh fisikawan lain.
Penggunaan komputer, robotika, dan visi
Fable 5.2 mencetak 89,3% pada OSWorld 2.1, di depan Opus 5.5 (87,2%) dan GPT-6 Astra (79,5%). Lompatan robotikanya adalah yang terbesar di tabel: 64,9% pada RoboDojo Sim, lebih dari dua kali lipat Fable 5.1 dan GPT-6 Astra. Pada Chartography, yang menguji pembacaan bagan tanpa tools, model ini sedikit unggul atas Gemini 4 Carbon dan GPT-6 Astra, setelah Fable 5.1 tertinggal jauh di 44,8%.
Keamanan siber dan biologi (Mythos 5.2)
Baris keamanan dan biologi adalah untuk Mythos 5.2, karena perlindungan Fable 5.2 memblokir sebagian besar tugas ini. Mythos 5.2 mencetak 76,3% pada CyScenarioBench (vs 61,7% untuk Mythos 5.1), 89,6% pada CVE Rediscovery (vs 78,3%), dan 85,1% pada tugas perancangan pengikat protein 24 jam (vs 79,1%). Tidak ada perbandingan yang adil dengan model keamanan OpenAI di sini, karena masing-masing lab menjalankan tugas CyScenarioBench-nya sendiri.
Apa Ceritanya tentang Teorema Terakhir Fermat?
Tim agen Fable 5.2 memformalkan pembuktian Teorema Terakhir Fermat di asisten bukti Lean dalam 30 jam. Anda mungkin bertanya-tanya: bukankah teorema itu sudah dibuktikan tiga dekade lalu, jadi apa yang tersisa?
Teorema itu sudah lama diketahui
Teorema Terakhir Fermat menyatakan tidak ada bilangan bulat positif a, b, dan c di mana an + bn = cn untuk setiap n lebih besar dari 2. Untuk n = 2, ada banyak solusi, seperti 32 + 42 = 52 (9 + 16 = 25). Namun coba pangkat tiga dan Anda hanya mendapatkan hampir cocok: 63 + 83 = 728, kurang satu dari 93 = 729.
Pierre de Fermat mengklaim memiliki pembuktian pada 1637 tetapi tidak pernah menuliskannya, dan masalah ini tetap tidak terselesaikan lebih dari 350 tahun hingga Andrew Wiles membuktikannya pada pertengahan 1990-an, dengan bantuan Richard Taylor.
Pembuktian Wiles lebih dari 100 halaman dan bertumpu pada puluhan tahun teori bilangan tingkat lanjut, sehingga sangat sedikit orang yang dapat memeriksanya dari awal hingga akhir. Lean adalah asisten bukti: bahasa pemrograman di mana Anda menulis pembuktian sebagai kode, dan perangkat lunak memeriksa setiap langkah logis hingga ke aksioma dasar matematika. Jika pembuktian dapat di-compile, itu benar. "Memformalkan" sebuah teorema berarti menerjemahkan pembuktian yang ditulis manusia ke dalam bentuk yang dapat diperiksa mesin ini.
Untuk Teorema Terakhir Fermat, itu pekerjaan raksasa, karena banyak matematika yang menjadi dasar pembuktiannya belum pernah ditulis dalam Lean. Matematikawan Kevin Buzzard memulai sebuah proyek komunitas untuk melakukannya pada 2024.
Mengapa ini menarik bagi model AI
Kebanyakan keluaran AI dinilai oleh manusia atau oleh tolok ukur yang hanya menguji sebagian jawaban. Bukti Lean berbeda: pemeriksa either menerima setiap langkah atau tidak, jadi tidak ada cara untuk salah secara halus. Itu menjadikannya uji yang sangat bersih tentang apakah model dapat membawa proyek yang sangat panjang dan sangat sulit hingga selesai dengan verifikasi.
Ini bukan pertama kalinya Claude melakukan ini. Pada September, Anthropic mempublikasikan pembuktian lengkap pertama yang diperiksa komputer untuk teorema tersebut, ditulis oleh puluhan agen yang menjalankan model riset internal yang kira-kira sebanding dengan Fable 5.1. Upaya itu memakan waktu 11 hari dan sekitar enam miliar token keluaran, menghasilkan 13 juta baris Lean, dan sebagian dibangun dari potongan proyek Buzzard. Fable 5.2 melakukannya dalam 30 jam, dengan bantuan manusia minimal.
Keterbatasannya
- Ini tidak menambah apa pun pada matematika. Buzzard mengatakan hal serupa tentang formalisasi pertama Anthropic.
- Fable 5.2 diberi daftar pernyataan teorema perantara untuk melacak kemajuannya. Itu adalah peta jalan tentang apa yang harus dibuktikan, meski bukan bagaimana membuktikannya.
- Saya belum menemukan ulasan luar terhadap pembuktian baru ini, jadi untuk saat ini, angka 30 jam dan perbandingan dengan Opus 5.5 adalah klaim Anthropic.
Bagian yang paling mengena, bagaimanapun, adalah apa yang terjadi ketika Anthropic memberikan pekerjaan yang sama kepada Claude Opus 5.5.
Claude Fable 5.2 vs. Claude Opus 5.5
Membandingkan dua model biasanya berarti membaca skor tolok ukur dan mencoba menyimpulkan seperti apa perbedaannya dalam praktik. Kali ini, saya menghargai bahwa Anthropic memulai dengan sebuah kisah, yang membuat kesenjangannya lebih jelas.
Dalam setup Lean 1.000 agen yang sama, Opus 5.5 menyelesaikan 26% pembuktian Teorema Terakhir Fermat dalam 18 jam dan nyaris tidak maju setelah itu. Fable 5.2 menyelesaikan semuanya dalam 30 jam. Intinya: pada proyek yang sangat panjang dan multi-agen, Opus 5.5 dapat mandek sementara Fable 5.2 terus berjalan.
Pada tugas yang lebih pendek, selisihnya lebih kecil. Berikut perbandingan keduanya berdampingan:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| Harga (masukan / keluaran per 1M token) | $8 / $40 | $4 / $20 |
| Jendela konteks / keluaran maks | 1M / 128K | 1M / 128K |
| FrontierCode 2.0 (pengodean agen) | 49,1% | 45,5% |
| FrontierSWE v2 (pengodean agen) | 69,9% | 62,3% |
| OSWorld 2.1 (penggunaan komputer) | 89,3% | 87,2% |
| AutomationBench (alur kerja bisnis) | 51,4% | 42,5% |
| Humanity's Last Exam (dengan tools) | 74,2% | 67,7% |
| Remote Labor Index (pekerjaan pengetahuan) | 41,3% | 21,3% |
| RoboDojo Sim (robotika) | 64,9% | 39,4% |
Pola ini cocok dengan hasil Lean. Pada penggunaan komputer dan pengodean, Fable 5.2 hanya unggul beberapa poin. Pada pekerjaan terbuka bertahap banyak, keunggulannya tumbuh: Fable 5.2 hampir menggandakan skor Opus 5.5 pada proyek gaya freelance di Remote Labor Index, dan unggul 25 poin pada kendali robot.
Harga kurang menjadi jurang seperti yang terlihat. Fable 5.2 berbiaya dua kali lipat per token, tetapi sering kali dapat mencapai skor terbaik Opus 5.5 pada tingkat upaya yang lebih rendah, menggunakan lebih sedikit token. Pada FrontierCode 2.0, misalnya, Fable 5.2 pada upaya tinggi kira-kira menyamai skor terbaik Opus 5.5 dengan kira-kira separuh biaya per tugas.
Jadi Opus 5.5 tetap pilihan bawaan yang masuk akal. Namun jika sebuah tugas berjalan berjam-jam, melibatkan banyak agen, atau terus mandek di Opus, Fable 5.2 kemungkinan akan menyelesaikannya, dan biayanya mungkin tidak semahal yang disiratkan harga per token.
Keamanan dan Batasan
Anthropic menilai risiko model-model ini berperilaku tidak aman dalam situasi berisiko tinggi sebagai rendah.
Itu sulit diuji dari luar, jadi angka-angka yang lebih konkret berguna. Pada audit perilaku otomatis sekitar 1.900 skenario, Mythos 5.2 memiliki skor perilaku tidak selaras terendah dari model yang dibandingkan. Model ini juga lebih kecil kemungkinannya untuk berhalusinasi masukan, salah mengklaim tugas selesai, atau menyembunyikan pekerjaan buruk.
Ada beberapa hal menarik lain yang disebutkan, layak diketahui dan akan membuat Anda berpikir:
- Kesadaran evaluasi: Baik Fable 5.2 maupun Mythos 5.2 mengatakan mereka menduga sedang diuji lebih sering dibandingkan model sebelumnya, yang membuat evaluasi seperti di atas lebih sulit dipercaya.
- Kemampuan riset AI yang sengaja dibatasi: Anthropic membatasi peningkatan model pada dua area, optimisasi kernel akselerator dan peningkatan arsitektur LLM, sehingga kinerjanya kira-kira setingkat Opus 5.5 di sana.
- Fable 5.2 memiliki langkah anti-distilasi terkuat Anthropic sejauh ini, dan "preserved thinking," yang menghentikan pengguna API mengedit konteks sebelumnya untuk mengekstrak penalaran model, kini berlaku untuk semua akun.
Model Claude Mana yang Sebaiknya Anda Gunakan?
Saran saya sejalan dengan Anthropic: mulailah dengan Opus 5.5 dan naik hanya saat diperlukan. Berikut pembagian jajaran modelnya:
- Claude Opus 5.5 ($4/$20): Pilihan bawaan untuk sebagian besar pengodean, riset, dan pekerjaan pengetahuan. Harganya setengah dari Fable 5.2 per token dan tertinggal tipis pada banyak tolok ukur.
- Claude Fable 5.2 ($8/$40): Untuk masalah tersulit, proses multi-agen yang panjang, dan tugas yang mandek di Opus 5.5, seperti migrasi besar, penalaran tingkat riset, atau perancangan perangkat keras. Cobalah pada tingkat upaya lebih rendah sebelum berasumsi Anda memerlukan upaya maksimum.
- Claude Mythos 5.2: Untuk tim keamanan dan peneliti ilmu hayati yang telah diverifikasi yang memerlukan kemampuan yang diblokir oleh perlindungan Fable 5.2.
- Claude Sonnet 5.5 dan Haiku 5.5: Untuk tugas volume tinggi, lebih sederhana, atau sensitif latensi, atau sebagai model yang lebih kecil yang diorkestrasi oleh Fable 5.2.
Harga dan Ketersediaan Claude Fable 5.2
| Per 1M token | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Masukan | $8 | $10 | $4 |
| Keluaran | $40 | $50 | $20 |
| Pembacaan cache | $0,20 | $0,25 | $0,20 |
| Penulisan cache 5 menit | $10 | $12,50 | $5 |
| Batch (masukan / keluaran) | $4 / $20 | $5 / $25 | $2 / $10 |
| Mode cepat (masukan / keluaran) | $16 / $80 | Tidak tercantum | $8 / $40 |
Kita baru saja melihat tabel hasil tolok ukur yang menunjukkan Fable 5.2 mengalahkan Fable 5.1 pada semua yang tercantum. Sekarang, saya menunjukkan tabel bahwa Fable 5.2 lebih murah daripada 5.1. Jadi apakah Fable 5.1 menjadi usang?
Untuk pekerjaan baru, pada dasarnya ya. Jika Anda memiliki akses ke Fable 5.2, hampir tidak ada alasan untuk memulai apa pun yang baru di 5.1. Namun Anthropic belum mengumumkan tanggal penghentian, dan tim dengan prompt atau agen yang disetel pada Fable 5.1 akan ingin menguji 5.2 sebelum beralih. Kita tahu versi baru bisa berperilaku berbeda meski skornya lebih baik.
Cara Mendapatkan Akses ke Claude Fable 5.2
-
Aplikasi Claude: Fable 5.2 tersedia pada paket berbayar yang memenuhi syarat. Sebagai promosi peluncuran, paket Pro dan kursi Tim standar dapat menggunakan Fable hingga 50% dari batas penggunaan mingguan mereka, dan paket yang menyertakan Fable mendapatkan satu hingga tiga pengaturan ulang penggunaan tergantung pada lamanya langganan.
-
API: Gunakan ID model claude-fable-5-2 di Claude Platform.
-
Platform cloud: Tersedia di Amazon Web Services, Google Cloud, dan Microsoft Azure.
-
Mythos 5.2: Ajukan melalui Cyber Verification Program atau Life Sciences Verification Program. Pelanggan Claude Enterprise juga dapat menggunakannya melalui Claude Security.
Perusahaan dengan persyaratan data ketat dapat menggunakan Enterprise Frontier Safeguards, yang menjalankan pemantauan keamanan Anthropic pada data yang disimpan di infrastruktur milik pelanggan sendiri dan beroperasi dengan nol retensi data. Pelanggan lain memiliki retensi data 30 hari untuk pemantauan keamanan.
Pikiran Akhir
Claude Fable 5.2 merupakan peningkatan bermakna dari Fable 5.1. Model ini lebih murah, lebih cepat, dan lebih jarang menolak pekerjaan yang sah. Lompatan pada Remote Labor Index, robotika, dan FrontierCode sangat besar.
Meski begitu, Opus 5.5 tetap memiliki nilai lebih baik untuk sebagian besar pekerjaan sehari-hari dengan harga setengahnya. Hal paling menarik tentang Fable 5.2 mungkin klaim efisiensinya: jika benar menyamai skor terbaik Opus 5.5 pada upaya rendah atau sedang, premi per token cepat menyusut. Itu patut diuji pada beban kerja Anda sendiri.
Jika Anda ingin langsung praktik dengan Claude, jalur Developing AI Applications kami adalah tempat yang baik untuk memulai.




Hari ini, Anthropic mengumumkan Fable 5.2 untuk semua orang dan Mythos 5.2 untuk organisasi yang telah diverifikasi. Keduanya adalah model dasar yang sama, tetapi versi Fable memiliki perlindungan tambahan untuk keamanan siber dan biologi.
Perubahan utama adalah:
Secara lebih spesifik, Fable 5.2 20% lebih murah daripada Fable 5.1, menghasilkan keluaran hingga 30% lebih cepat, dan mengungguli GPT-6 Astra dan Gemini 4 Carbon pada sebagian besar baris di tabel tolok ukur Anthropic.
Dalam artikel ini, saya akan membahas apa yang baru di Fable 5.2 dan Mythos 5.2, bagaimana kinerjanya pada tolok ukur, berapa biayanya, dan cara memutuskan apakah Anda memerlukannya dibandingkan Claude Opus 5.5.
Apa Itu Claude Fable 5.2?
Claude Fable 5.2 adalah model paling andal dari Anthropic yang tersedia secara umum. Model ini dibuat untuk pekerjaan teknis yang panjang dan menuntut: migrasi basis kode besar, menjalankan agen berhari-hari, masalah riset, dan perancangan rekayasa.
Fable 5.2 juga dapat bekerja berdampingan dengan model yang lebih kecil, baik sebagai penasihat yang mereka konsultasikan untuk masalah sulit atau sebagai pengatur yang meneruskan sub-tugas yang lebih sederhana kepada mereka.
Fable 5.2 mempertahankan jendela konteks 1 juta token dan keluaran maksimum 128K seperti pendahulunya, serta batas pengetahuan pada Juni 2026.
Apa Itu Claude Mythos 5.2?
Claude Mythos 5.2 adalah model yang sama dengan Fable 5.2 tetapi tanpa perlindungan yang memblokir sebagian besar pekerjaan keamanan siber dan pekerjaan biologi tingkat riset. Faktanya, Mythos 5.2 adalah model Anthropic yang paling andal untuk rekayasa keamanan siber. Karena kemampuan semacam ini bersifat ganda (dual-use), Anthropic hanya menawarkan Mythos 5.2 kepada organisasi yang telah diverifikasi melalui Cyber Verification Program dan Life Sciences Verification Program.
Apa yang Baru di Claude Fable 5.2?
Fable baru hadir sejak Juni, ketika Anthropic merilis Fable 5. Sejak itu, ada dua rilis titik, Fable 5.1 pada September dan kini Fable 5.2, dan keduanya tidak banyak menambahkan fitur baru. Keduanya terutama membuat model menjadi lebih murah, lebih cepat, dan lebih kuat, meskipun peningkatan kinerja tidak kecil: misalnya, Fable 5.2 lebih dari dua kali lipat skor Fable 5.1 pada Remote Labor Index.
Perbedaan yang lebih besar antara kedua rilis terletak pada bagaimana Anda diizinkan menggunakan model. Dengan Fable 5.1, Anthropic mempersempit perlindungan keamanan sibernya dan mulai mengizinkan model digunakan untuk menemukan kerentanan perangkat lunak, meski tidak untuk menulis eksploitnya, dan bersamaan dengan rilis tersebut, mengumumkan Enterprise Frontier Safeguards, opsi untuk menyimpan data di cloud Anda sendiri. Perubahan perlindungan di Fable 5.2 lebih kecil: ia memblokir lebih sedikit permintaan, tetapi jenis tugas yang dilarang tetap sama.
Cara baru yang disarankan Anthropic untuk menggunakannya, seperti menjadikan Fable 5.2 sebagai penasihat bagi model Claude yang lebih kecil, juga bukan hal baru, karena alat advisor Anthropic sudah mendukung Fable 5 dan 5.1. Dan demo peluncurannya, seperti sistem operasi yang dibangun dari folder kosong, menunjukkan model yang lebih kuat melakukan hal yang lebih sulit, bukan fitur baru yang bisa Anda aktifkan.
Meski begitu, jika saya harus menunjuk hal-hal baru, berikut yang saya sebutkan:
Harga lebih rendah
Fable 5.2 berharga $8 per juta token masukan dan $40 per juta token keluaran, 20% lebih rendah daripada harga Fable 5.1 sebesar $10/$50. Pemotongan 20% yang sama berlaku untuk pembacaan cache ($0,20), penulisan cache, dan pemrosesan batch. Lihat bagian harga di bawah untuk rincian lengkapnya.
Keluaran lebih cepat, dan mode cepat untuk Fable
Keluaran hingga 30% lebih cepat dari Fable 5.1, yang akan terasa pada proses agen yang panjang. Fable kini juga mendukung mode cepat, yang mempercepat keluaran hingga 2,5x dengan harga dua kali lipat ($16/$80).
Hasil lebih baik dengan upaya lebih rendah
Inilah perubahan yang paling mungkin memengaruhi tagihan Anda. Pada upaya tinggi, Fable 5.2 mencetak 45,3% pada FrontierCode 2.0, setara dengan skor terbaik Opus 5.5, dengan kira-kira separuh biaya per tugas. Pada upaya rendah, model ini menyamai skor tertinggi Opus 5.5 pada Humanity's Last Exam dengan kurang dari sepersepuluh biaya per tugas. Pandangan saya: Jika Anda naik dari Opus 5.5, mulailah Fable 5.2 pada tingkat upaya yang lebih rendah.
Lebih sedikit permintaan yang diblokir
Fable 5.2 seharusnya mengalami sekitar 55% lebih sedikit blokir keamanan dibandingkan Fable 5.1 (sekitar 60% lebih sedikit di keamanan siber dan 40% lebih sedikit di biologi). Ini penting jika penolakan Fable 5.1 menghambat pekerjaan Anda, tetapi kategori yang diblokir tidak berubah: pengujian penetrasi, pembuatan eksploit, dan sebagian besar biologi tingkat riset masih dialihkan ke model Claude yang lebih lama.
Bagaimana Kinerja Claude Fable 5.2 pada Tolok Ukur?
Berikut hasil utamanya. Semuanya berasal dari tabel peluncuran Anthropic, jadi bacalah sebagai argumen Anthropic untuk model ini, bukan hasil independen. Skor Claude dijalankan dengan perlindungan aktif. Kecuali disebutkan, setiap model ditampilkan pada upaya tertinggi yang tersedia.
Pengodean agen
Fable 5.2 memimpin kedua tolok ukur pengodean di tabel. Pada FrontierCode 2.0, yang mengukur apakah pengelola open-source akan menggabungkan perubahan kode dari model, model ini mencetak 49,1%, tertinggi di tabel dan jauh di atas Fable 5.1 yang 32,4%. Pada FrontierSWE v2, model ini mencetak 69,9%, di depan GPT-6 Astra (65,5%) dan Opus 5.5 (62,3%).
Contoh peluncuran menunjukkan arah yang sama: agen yang menjalankan versi awal Fable 5.2 memigrasikan layanan produksi dari Python ke Rust, dan kini ia mulai sekitar 26 kali lebih cepat.
Pekerjaan pengetahuan dan riset
Lompatan relatif terbesar ada pada Remote Labor Index, yang mengukur seberapa baik model menyelesaikan proyek gaya freelance nyata. Fable 5.2 mencetak 41,3%, kira-kira dua kali lipat Opus 5.5 (21,3%) dan GPT-6 Astra (20,8%). Model ini juga memimpin pada Humanity's Last Exam dengan tools (74,2%) dan pada Terminal-Bench-Science (74,6%, atau 75,3% untuk Mythos 5.2).
Otomatisasi bisnis adalah satu area di mana ia tertinggal. Pada AutomationBench, Gemini 4 Carbon mencetak 53,9% dibandingkan 51,4% milik Fable 5.2, meskipun Fable 5.2 masih jauh di depan Fable 5.1 (31,4%).
Di luar tabel utama, Fable 5.2 mencetak 83,5 pada tolok ukur rekayasa perangkat keras BenchCAD 2.1, dibandingkan 65,3 untuk Opus 5.5. Model ini juga dikreditkan menyelesaikan dua masalah terbuka dalam fisika lubang hitam, dan hasilnya diposting sebagai pracetak yang dapat diperiksa oleh fisikawan lain.
Penggunaan komputer, robotika, dan visi
Fable 5.2 mencetak 89,3% pada OSWorld 2.1, di depan Opus 5.5 (87,2%) dan GPT-6 Astra (79,5%). Lompatan robotikanya adalah yang terbesar di tabel: 64,9% pada RoboDojo Sim, lebih dari dua kali lipat Fable 5.1 dan GPT-6 Astra. Pada Chartography, yang menguji pembacaan bagan tanpa tools, model ini sedikit unggul atas Gemini 4 Carbon dan GPT-6 Astra, setelah Fable 5.1 tertinggal jauh di 44,8%.
Keamanan siber dan biologi (Mythos 5.2)
Baris keamanan dan biologi adalah untuk Mythos 5.2, karena perlindungan Fable 5.2 memblokir sebagian besar tugas ini. Mythos 5.2 mencetak 76,3% pada CyScenarioBench (vs 61,7% untuk Mythos 5.1), 89,6% pada CVE Rediscovery (vs 78,3%), dan 85,1% pada tugas perancangan pengikat protein 24 jam (vs 79,1%). Tidak ada perbandingan yang adil dengan model keamanan OpenAI di sini, karena masing-masing lab menjalankan tugas CyScenarioBench-nya sendiri.
Apa Ceritanya tentang Teorema Terakhir Fermat?
Tim agen Fable 5.2 memformalkan pembuktian Teorema Terakhir Fermat di asisten bukti Lean dalam 30 jam. Anda mungkin bertanya-tanya: bukankah teorema itu sudah dibuktikan tiga dekade lalu, jadi apa yang tersisa?
Teorema itu sudah lama diketahui
Teorema Terakhir Fermat menyatakan tidak ada bilangan bulat positif a, b, dan c di mana an + bn = cn untuk setiap n lebih besar dari 2. Untuk n = 2, ada banyak solusi, seperti 32 + 42 = 52 (9 + 16 = 25). Namun coba pangkat tiga dan Anda hanya mendapatkan hampir cocok: 63 + 83 = 728, kurang satu dari 93 = 729.
Pierre de Fermat mengklaim memiliki pembuktian pada 1637 tetapi tidak pernah menuliskannya, dan masalah ini tetap tidak terselesaikan lebih dari 350 tahun hingga Andrew Wiles membuktikannya pada pertengahan 1990-an, dengan bantuan Richard Taylor.
Apa itu formalisasi Lean
Pembuktian Wiles lebih dari 100 halaman dan bertumpu pada puluhan tahun teori bilangan tingkat lanjut, sehingga sangat sedikit orang yang dapat memeriksanya dari awal hingga akhir. Lean adalah asisten bukti: bahasa pemrograman di mana Anda menulis pembuktian sebagai kode, dan perangkat lunak memeriksa setiap langkah logis hingga ke aksioma dasar matematika. Jika pembuktian dapat di-compile, itu benar. "Memformalkan" sebuah teorema berarti menerjemahkan pembuktian yang ditulis manusia ke dalam bentuk yang dapat diperiksa mesin ini.
Untuk Teorema Terakhir Fermat, itu pekerjaan raksasa, karena banyak matematika yang menjadi dasar pembuktiannya belum pernah ditulis dalam Lean. Matematikawan Kevin Buzzard memulai sebuah proyek komunitas untuk melakukannya pada 2024.
Mengapa ini menarik bagi model AI
Kebanyakan keluaran AI dinilai oleh manusia atau oleh tolok ukur yang hanya menguji sebagian jawaban. Bukti Lean berbeda: pemeriksa either menerima setiap langkah atau tidak, jadi tidak ada cara untuk salah secara halus. Itu menjadikannya uji yang sangat bersih tentang apakah model dapat membawa proyek yang sangat panjang dan sangat sulit hingga selesai dengan verifikasi.
Ini bukan pertama kalinya Claude melakukan ini. Pada September, Anthropic mempublikasikan pembuktian lengkap pertama yang diperiksa komputer untuk teorema tersebut, ditulis oleh puluhan agen yang menjalankan model riset internal yang kira-kira sebanding dengan Fable 5.1. Upaya itu memakan waktu 11 hari dan sekitar enam miliar token keluaran, menghasilkan 13 juta baris Lean, dan sebagian dibangun dari potongan proyek Buzzard. Fable 5.2 melakukannya dalam 30 jam, dengan bantuan manusia minimal.
Keterbatasannya
Bagian yang paling mengena, bagaimanapun, adalah apa yang terjadi ketika Anthropic memberikan pekerjaan yang sama kepada Claude Opus 5.5.
Claude Fable 5.2 vs. Claude Opus 5.5
Membandingkan dua model biasanya berarti membaca skor tolok ukur dan mencoba menyimpulkan seperti apa perbedaannya dalam praktik. Kali ini, saya menghargai bahwa Anthropic memulai dengan sebuah kisah, yang membuat kesenjangannya lebih jelas.
Dalam setup Lean 1.000 agen yang sama, Opus 5.5 menyelesaikan 26% pembuktian Teorema Terakhir Fermat dalam 18 jam dan nyaris tidak maju setelah itu. Fable 5.2 menyelesaikan semuanya dalam 30 jam. Intinya: pada proyek yang sangat panjang dan multi-agen, Opus 5.5 dapat mandek sementara Fable 5.2 terus berjalan.
Pada tugas yang lebih pendek, selisihnya lebih kecil. Berikut perbandingan keduanya berdampingan:
Pola ini cocok dengan hasil Lean. Pada penggunaan komputer dan pengodean, Fable 5.2 hanya unggul beberapa poin. Pada pekerjaan terbuka bertahap banyak, keunggulannya tumbuh: Fable 5.2 hampir menggandakan skor Opus 5.5 pada proyek gaya freelance di Remote Labor Index, dan unggul 25 poin pada kendali robot.
Harga kurang menjadi jurang seperti yang terlihat. Fable 5.2 berbiaya dua kali lipat per token, tetapi sering kali dapat mencapai skor terbaik Opus 5.5 pada tingkat upaya yang lebih rendah, menggunakan lebih sedikit token. Pada FrontierCode 2.0, misalnya, Fable 5.2 pada upaya tinggi kira-kira menyamai skor terbaik Opus 5.5 dengan kira-kira separuh biaya per tugas.
Jadi Opus 5.5 tetap pilihan bawaan yang masuk akal. Namun jika sebuah tugas berjalan berjam-jam, melibatkan banyak agen, atau terus mandek di Opus, Fable 5.2 kemungkinan akan menyelesaikannya, dan biayanya mungkin tidak semahal yang disiratkan harga per token.
Keamanan dan Batasan
Anthropic menilai risiko model-model ini berperilaku tidak aman dalam situasi berisiko tinggi sebagai rendah.
Itu sulit diuji dari luar, jadi angka-angka yang lebih konkret berguna. Pada audit perilaku otomatis sekitar 1.900 skenario, Mythos 5.2 memiliki skor perilaku tidak selaras terendah dari model yang dibandingkan. Model ini juga lebih kecil kemungkinannya untuk berhalusinasi masukan, salah mengklaim tugas selesai, atau menyembunyikan pekerjaan buruk.
Ada beberapa hal menarik lain yang disebutkan, layak diketahui dan akan membuat Anda berpikir:
Model Claude Mana yang Sebaiknya Anda Gunakan?
Saran saya sejalan dengan Anthropic: mulailah dengan Opus 5.5 dan naik hanya saat diperlukan. Berikut pembagian jajaran modelnya:
Harga dan Ketersediaan Claude Fable 5.2
Kita baru saja melihat tabel hasil tolok ukur yang menunjukkan Fable 5.2 mengalahkan Fable 5.1 pada semua yang tercantum. Sekarang, saya menunjukkan tabel bahwa Fable 5.2 lebih murah daripada 5.1. Jadi apakah Fable 5.1 menjadi usang?
Untuk pekerjaan baru, pada dasarnya ya. Jika Anda memiliki akses ke Fable 5.2, hampir tidak ada alasan untuk memulai apa pun yang baru di 5.1. Namun Anthropic belum mengumumkan tanggal penghentian, dan tim dengan prompt atau agen yang disetel pada Fable 5.1 akan ingin menguji 5.2 sebelum beralih. Kita tahu versi baru bisa berperilaku berbeda meski skornya lebih baik.
Cara Mendapatkan Akses ke Claude Fable 5.2
Aplikasi Claude: Fable 5.2 tersedia pada paket berbayar yang memenuhi syarat. Sebagai promosi peluncuran, paket Pro dan kursi Tim standar dapat menggunakan Fable hingga 50% dari batas penggunaan mingguan mereka, dan paket yang menyertakan Fable mendapatkan satu hingga tiga pengaturan ulang penggunaan tergantung pada lamanya langganan.
API: Gunakan ID model
claude-fable-5-2di Claude Platform.Platform cloud: Tersedia di Amazon Web Services, Google Cloud, dan Microsoft Azure.
Mythos 5.2: Ajukan melalui Cyber Verification Program atau Life Sciences Verification Program. Pelanggan Claude Enterprise juga dapat menggunakannya melalui Claude Security.
Perusahaan dengan persyaratan data ketat dapat menggunakan Enterprise Frontier Safeguards, yang menjalankan pemantauan keamanan Anthropic pada data yang disimpan di infrastruktur milik pelanggan sendiri dan beroperasi dengan nol retensi data. Pelanggan lain memiliki retensi data 30 hari untuk pemantauan keamanan.
Pikiran Akhir
Claude Fable 5.2 merupakan peningkatan bermakna dari Fable 5.1. Model ini lebih murah, lebih cepat, dan lebih jarang menolak pekerjaan yang sah. Lompatan pada Remote Labor Index, robotika, dan FrontierCode sangat besar.
Meski begitu, Opus 5.5 tetap memiliki nilai lebih baik untuk sebagian besar pekerjaan sehari-hari dengan harga setengahnya. Hal paling menarik tentang Fable 5.2 mungkin klaim efisiensinya: jika benar menyamai skor terbaik Opus 5.5 pada upaya rendah atau sedang, premi per token cepat menyusut. Itu patut diuji pada beban kerja Anda sendiri.
Jika Anda ingin langsung praktik dengan Claude, jalur Developing AI Applications kami adalah tempat yang baik untuk memulai.