Heute hat Anthropic Fable 5.2 für alle und Mythos 5.2 für geprüfte Organisationen angekündigt. Beides basiert auf demselben zugrunde liegenden Modell, aber die Fable-Version hat zusätzliche Sicherheitsmechanismen für Cybersicherheit und Biologie.
Die wichtigsten Änderungen sind:
- ein niedrigerer Preis,
- schnellere Ausgabe und
- deutliche Sprünge auf Anthropics anspruchsvollsten Benchmarks.
Konkret kostet Fable 5.2 20% weniger als Fable 5.1, erzeugt Ausgaben bis zu 30% schneller und übertrifft GPT-6 Astra und Gemini 4 Carbon auf den meisten Zeilen in Anthropics Benchmark-Tabelle.
In diesem Artikel zeige ich, was in Fable 5.2 und Mythos 5.2 neu ist, wie sie in Benchmarks abschneiden, was sie kosten und wie du entscheidest, ob du sie statt Claude Opus 5.5 brauchst.
Was ist Claude Fable 5.2?
Claude Fable 5.2 ist Anthropics leistungsstärkstes allgemein verfügbares Modell. Es ist für langwierige, anspruchsvolle technische Arbeit gemacht: große Codebase-Migrationen, mehrtägige Agentenläufe, Forschungsprobleme und Engineering-Design.
Fable 5.2 kann auch mit kleineren Modellen zusammenarbeiten, entweder als Berater für schwierige Probleme oder als Orchestrator, der einfachere Teilaufgaben an sie delegiert.
Fable 5.2 behält das 1M-Token-Kontextfenster und 128K maximale Ausgabe seines Vorgängers, und der Wissensstand liegt bei Juni 2026.
Was ist Claude Mythos 5.2?
Claude Mythos 5.2 ist dasselbe Modell wie Fable 5.2, jedoch ohne die Schutzmechanismen, die die meisten Cybersecurity-Aufgaben und biowissenschaftliche Arbeiten auf Forschungsniveau blockieren. Tatsächlich ist Mythos 5.2 Anthropics leistungsfähigstes Modell für Cybersecurity-Engineering. Weil diese Fähigkeiten doppelten Verwendungszwecken dienen können, bietet Anthropic Mythos 5.2 nur über das Cyber Verification Program und das Life Sciences Verification Program für geprüfte Organisationen an.
Was ist neu in Claude Fable 5.2?
Fable gibt es erst seit Juni, als Anthropic Fable 5 veröffentlichte. Seitdem gab es zwei Punkt-Releases, Fable 5.1 im September und jetzt Fable 5.2, und keines hat viele neue Features gebracht. Beide machten das Modell vor allem günstiger, schneller und stärker – und die Leistungszuwächse sind nicht klein: Fable 5.2 verdoppelt beispielsweise den Score von Fable 5.1 im Remote Labor Index deutlich.
Der größte Unterschied zwischen den Releases liegt in der erlaubten Nutzung. Mit Fable 5.1 hat Anthropic die Cybersecurity-Schutzmechanismen verengt und erlaubt, das Modell zum Finden von Software-Schwachstellen zu nutzen, nicht aber zum Schreiben von Exploits. Außerdem wurden parallel die Enterprise Frontier Safeguards angekündigt, eine Option, um deine Daten in deiner eigenen Cloud zu halten. Die Änderungen der Schutzmechanismen in Fable 5.2 sind kleiner: Es blockiert weniger Anfragen, aber die gleichen Aufgaben bleiben tabu.
Die neuen vorgeschlagenen Nutzungsszenarien, etwa Fable 5.2 als Berater für kleinere Claude-Modelle, sind ebenfalls nicht neu, da Anthropics Advisor-Tool bereits Fable 5 und 5.1 unterstützte. Und die Launch-Demos, wie das aus einem leeren Ordner aufgebaute Betriebssystem, zeigen ein stärkeres Modell bei schwierigeren Aufgaben, jedoch keine neuen umschaltbaren Features.
Wenn ich dennoch auf Neues zeigen soll, würde ich Folgendes hervorheben:
Ein niedrigerer Preis
Fable 5.2 kostet 8 $ pro Million Input-Token und 40 $ pro Million Output-Token, also 20% weniger als die 10 $/50 $ von Fable 5.1. Der gleiche 20%-Schnitt gilt für Cache-Lesezugriffe (0,20 $), Cache-Schreibzugriffe und Batch-Verarbeitung. Die komplette Übersicht findest du unten im Preisteil.
Schnellere Ausgabe und Fast Mode für Fable
Die Ausgabe ist bis zu 30% schneller als bei Fable 5.1, was sich bei langen Agentenläufen summiert. Fable unterstützt jetzt außerdem Fast Mode, der die Ausgabe um bis zu 2,5× beschleunigt – zum doppelten Preis (16 $/80 $).
Bessere Ergebnisse mit weniger Aufwand
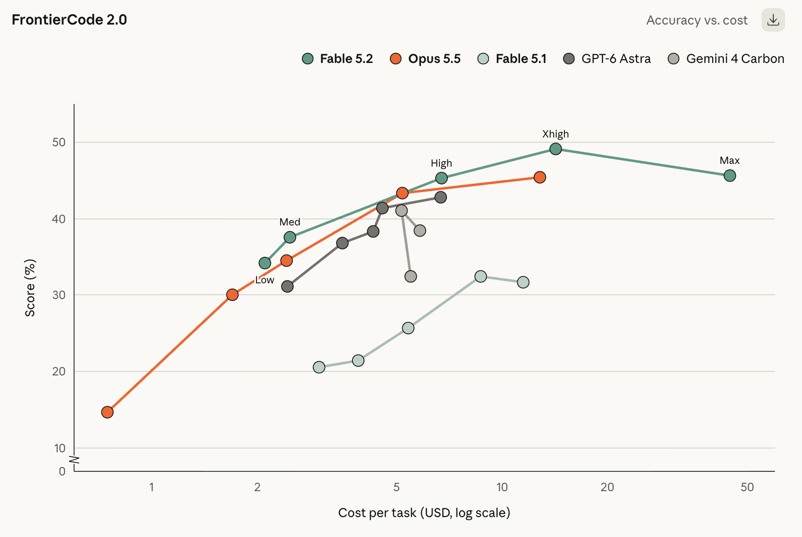
Das dürfte deine Rechnung am ehesten beeinflussen. Bei hohem Aufwand erzielt Fable 5.2 45,3% auf FrontierCode 2.0, in etwa auf Augenhöhe mit dem Bestwert von Opus 5.5, bei ungefähr halben Kosten pro Aufgabe. Bei geringem Aufwand erreicht es auf Humanity's Last Exam den Top-Score von Opus 5.5 bei weniger als einem Zehntel der Kosten pro Aufgabe. Mein Fazit: Wenn du von Opus 5.5 wechselst, starte Fable 5.2 mit geringerem Aufwand.
Weniger blockierte Anfragen
Fable 5.2 sollte etwa 55% weniger Safety-Blocks treffen als Fable 5.1 (etwa 60% weniger in Cybersecurity und 40% weniger in Biologie). Das ist großartig, wenn dich die Ablehnungen von Fable 5.1 ausgebremst haben, aber die gesperrten Kategorien haben sich nicht verändert: Penetrationstests, Exploit-Erstellung und die meisten Forschungsaufgaben in der Biologie werden weiterhin an ältere Claude-Modelle übergeben.
Wie schlägt sich Claude Fable 5.2 in Benchmarks?
Hier sind die wichtigsten Ergebnisse. Sie stammen alle aus Anthropics Launch-Tabelle – lies sie also als Anthropics Argument für das Modell, nicht als unabhängige Resultate. Die Claude-Scores wurden mit aktivierten Schutzmechanismen ermittelt. Außer wenn anders vermerkt, ist jedes Modell mit seinem höchsten verfügbaren Aufwand gezeigt.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (agentisches Coding) | 49,1% | 32,4% | 45,5% | 42,8% | 41,1% |
| FrontierSWE v2 (agentisches Coding) | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench (Geschäftsworkflows) | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Terminal-Bench-Science 0,1 | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| OSWorld 2.1 (Computerbedienung) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| RoboDojo Sim (Robotik) | 64,9% | 27,6% | 39,4% | 29,8% | Nicht berichtet |
| AA-Briefcase v1.1 (Wissensarbeit) | 66,1% | 61,5% | 61,2% | 52,0% | 61,8% |
| Remote Labor Index (Wissensarbeit) | 41,3% | 17,9% | 21,3% | 20,8% | Nicht berichtet |
| Humanity's Last Exam (mit Tools) | 74,2% | 65,6% | 67,7% | 57,2% | Nicht berichtet |
| WANDR (agentische Suche) | 82,1% | 68,7% | 72,3% | Nicht berichtet | Nicht berichtet |
| Chartography (ohne Tools) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
Agentisches Coding
Fable 5.2 führt beide Coding-Benchmarks in der Tabelle an. Auf FrontierCode 2.0, das misst, ob Open-Source-Maintainer Codeänderungen des Modells mergen würden, erzielt es 49,1% – der höchste Wert in der Tabelle und deutlich über den 32,4% von Fable 5.1. Auf FrontierSWE v2 erreicht es 69,9% und liegt damit vor GPT-6 Astra (65,5%) und Opus 5.5 (62,3%).
Die Launch-Beispiele zeigen das Gleiche: Agenten mit einer frühen Version von Fable 5.2 migrierten einen Produktivdienst von Python zu Rust, der nun etwa 26-mal schneller startet.
Wissensarbeit und Forschung
Den größten relativen Sprung gibt es beim Remote Labor Index, der misst, wie gut ein Modell echte Projekte im Freelancer-Stil erledigt. Fable 5.2 erreicht 41,3% und liegt damit ungefähr doppelt so hoch wie Opus 5.5 (21,3%) und GPT-6 Astra (20,8%). Es führt außerdem bei Humanity's Last Exam mit Tools (74,2%) und bei Terminal-Bench-Science (74,6% bzw. 75,3% für Mythos 5.2).
Geschäftsautomatisierung ist das eine Feld, in dem es zurückliegt. Auf AutomationBench erzielt Gemini 4 Carbon 53,9% gegenüber 51,4% für Fable 5.2, wobei Fable 5.2 immer noch deutlich vor Fable 5.1 (31,4%) liegt.
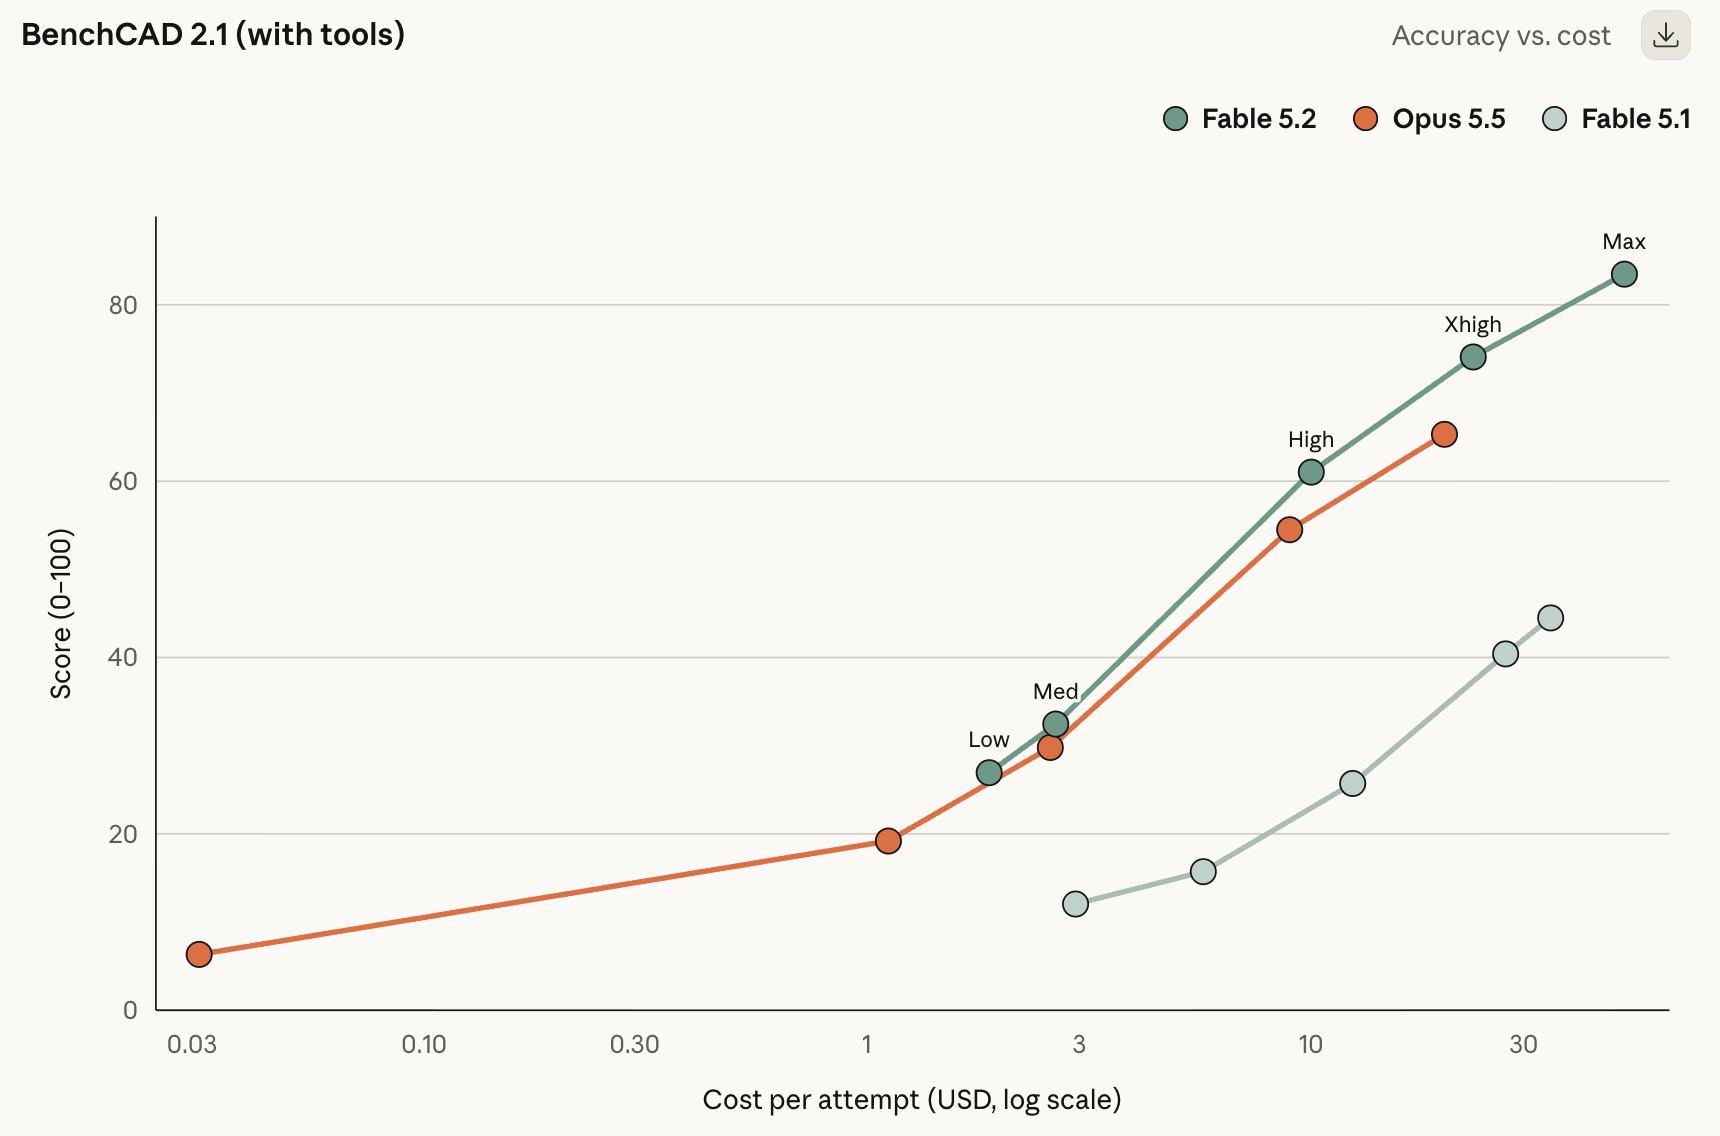
Außerhalb der Haupttabelle erzielte Fable 5.2 83,5 auf dem Hardware-Engineering-Benchmark BenchCAD 2.1, verglichen mit 65,3 für Opus 5.5. Ihm wird zudem zugeschrieben, zwei offene Probleme der Schwarze-Loch-Physik gelöst zu haben; die Ergebnisse sind als Preprints veröffentlicht, sodass andere Physiker sie überprüfen können.
Computerbedienung, Robotik und Vision
Fable 5.2 erreicht 89,3% auf OSWorld 2.1, vor Opus 5.5 (87,2%) und GPT-6 Astra (79,5%). Den größten Sprung in der Tabelle legt es in der Robotik hin: 64,9% auf RoboDojo Sim, mehr als doppelt so viel wie Fable 5.1 und GPT-6 Astra. Bei Chartography, das das Lesen von Diagrammen ohne Tools testet, liegt es knapp vor Gemini 4 Carbon und GPT-6 Astra, nachdem Fable 5.1 mit 44,8% deutlich zurücklag.
Cybersicherheit und Biologie (Mythos 5.2)
Die Zeilen zu Sicherheit und Biologie beziehen sich auf Mythos 5.2, da Fable 5.2 diese Aufgaben größtenteils blockiert. Mythos 5.2 erzielt 76,3% auf CyScenarioBench (vs. 61,7% für Mythos 5.1), 89,6% bei CVE Rediscovery (vs. 78,3%) und 85,1% bei einer 24-Stunden-Aufgabe zur Proteinbinder-Entwicklung (vs. 79,1%). Ein fairer Vergleich mit OpenAIs Sicherheitsmodell ist hier nicht möglich, da jedes Labor seine eigenen CyScenarioBench-Aufgaben verwendet hat.
Was hat es mit Fermats letztem Satz auf sich?
Ein Team aus Fable-5.2-Agenten hat den Beweis von Fermats letztem Satz in 30 Stunden im Proof-Assistenten Lean formalisiert. Du fragst dich vielleicht: Der Satz wurde doch schon vor drei Jahrzehnten bewiesen – was gibt es da noch zu tun?
Der Satz ist alter Hut
Fermats letzter Satz besagt, dass es keine positiven ganzen Zahlen a, b und c gibt, für die an + bn = cn mit n größer als 2 gilt. Für n = 2 gibt es viele Lösungen, etwa 32 + 42 = 52 (9 + 16 = 25). Bei Kuben bekommst du aber nur Beinahe-Treffer: 63 + 83 = 728, eins weniger als 93 = 729.
Pierre de Fermat behauptete 1637 einen Beweis, schrieb ihn aber nie auf. Das Problem blieb über 350 Jahre ungelöst, bis Andrew Wiles es Mitte der 1990er-Jahre mit Hilfe von Richard Taylor bewies.
Wiles' Beweis umfasst über 100 Seiten und baut auf Jahrzehnten fortgeschrittener Zahlentheorie auf, sodass ihn nur sehr wenige Menschen end-to-end überprüfen können. Lean ist ein Proof-Assistent: eine Programmiersprache, in der du einen Beweis als Code verfasst und die Software jeden logischen Schritt bis zu den grundlegenden Axiomen der Mathematik prüft. Wenn der Beweis kompiliert, ist er korrekt. Einen Satz zu „formalisieren“ bedeutet, den menschlich geschriebenen Beweis in diese maschinenprüfbare Form zu übersetzen.
Bei Fermats letztem Satz ist das eine Mammutaufgabe, denn vieles der benötigten Mathematik war zuvor nie in Lean niedergeschrieben worden. Der Mathematiker Kevin Buzzard startete 2024 ein Community-Projekt, um das zu übernehmen.
Warum das für ein KI-Modell spannend ist
Die meiste KI-Ausgabe wird von Menschen bewertet oder über Benchmarks, die nur Teile der Antwort prüfen. Ein Lean-Beweis ist anders: Der Checker akzeptiert jeden Schritt oder eben nicht – subtile Fehler sind ausgeschlossen. Das macht ihn zu einem außergewöhnlich sauberen Test dafür, ob ein Modell ein sehr langes, sehr schwieriges Projekt bis zum verifizierten Abschluss tragen kann.
Das ist nicht das erste Mal, dass Claude das schafft. Im September veröffentlichte Anthropic den ersten vollständig computergestützten, geprüften Beweis des Satzes, erstellt von Dutzenden Agenten mit einem internen Forschungsmodell, grob vergleichbar mit Fable 5.1. Dieser Durchlauf dauerte 11 Tage und etwa sechs Milliarden Output-Token, erzeugte 13 Millionen Zeilen Lean und baute teils auf Teilen von Buzzards Projekt auf. Fable 5.2 schaffte das in 30 Stunden mit minimaler menschlicher Hilfe.
Die Einschränkungen
- Es bringt der Mathematik nichts Neues. Buzzard sagte das bereits zur ersten Formalisierung von Anthropic.
- Fable 5.2 bekam eine Liste mit Zwischensätzen, um den Fortschritt zu tracken. Das ist ein Lernplan dessen, was zu beweisen ist, aber nicht, wie es zu beweisen ist.
- Ich habe bisher keine externe Begutachtung des neuen Beweises gefunden. Die 30 Stunden und der Vergleich mit Opus 5.5 sind vorerst Anthropics Angaben.
Am aufschlussreichsten ist, was passierte, als Anthropic Claude Opus 5.5 denselben Job gab.
Claude Fable 5.2 vs. Claude Opus 5.5
Oft vergleicht man Modelle über Benchmark-Scores und versucht daraus abzuleiten, wie der Unterschied in der Praxis aussieht. Dieses Mal gefällt mir, dass Anthropic mit einer Geschichte beginnt, die die Lücke deutlicher macht.
Im gleichen Lean-Setup mit 1.000 Agenten schaffte Opus 5.5 in 18 Stunden 26% des Beweises von Fermats letztem Satz und kam danach kaum voran. Fable 5.2 beendete die gesamte Aufgabe in 30 Stunden. Die Quintessenz: Bei sehr langen, multiagentischen Projekten kann Opus 5.5 steckenbleiben, wo Fable 5.2 weiterläuft.
Bei kürzeren Aufgaben ist der Abstand kleiner. Hier der Direktvergleich:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| Preis (Input / Output pro 1 Mio. Token) | 8 $ / 40 $ | 4 $ / 20 $ |
| Kontextfenster / max. Ausgabe | 1 Mio. / 128K | 1 Mio. / 128K |
| FrontierCode 2.0 (agentisches Coding) | 49,1% | 45,5% |
| FrontierSWE v2 (agentisches Coding) | 69,9% | 62,3% |
| OSWorld 2.1 (Computerbedienung) | 89,3% | 87,2% |
| AutomationBench (Geschäftsworkflows) | 51,4% | 42,5% |
| Humanity's Last Exam (mit Tools) | 74,2% | 67,7% |
| Remote Labor Index (Wissensarbeit) | 41,3% | 21,3% |
| RoboDojo Sim (Robotik) | 64,9% | 39,4% |
Das Muster passt zum Lean-Ergebnis. Bei Computerbedienung und Coding liegt Fable 5.2 nur wenige Punkte vorn. Bei offenen, mehrschrittigen Aufgaben wird der Vorsprung größer: Fable 5.2 verdoppelt nahezu Opus 5.5 beim Remote Labor Index und liegt bei der Robotersteuerung 25 Punkte vorn.
Beim Preis ist der Abstand geringer, als er aussieht. Fable 5.2 kostet pro Token doppelt so viel, erreicht aber häufig die Bestwerte von Opus 5.5 bei geringerem Aufwand und damit mit weniger Token. Auf FrontierCode 2.0 etwa erreicht Fable 5.2 bei hohem Aufwand ungefähr den Bestwert von Opus 5.5 – zu etwa halben Kosten pro Aufgabe.
Opus 5.5 bleibt also die sinnvolle Voreinstellung. Aber wenn eine Aufgabe stundenlang läuft, viele Agenten umfasst oder mit Opus immer wieder steckenbleibt, bringt Fable 5.2 sie wahrscheinlich zu Ende – und das möglicherweise günstiger, als es der Pro-Token-Preis vermuten lässt.
Sicherheit und Grenzen
Anthropic stuft das Risiko, dass sich diese Modelle in sicherheitskritischen Situationen unsicher verhalten, als gering ein.
Das ist von außen schwer zu überprüfen, daher sind die konkreten Zahlen hilfreich. In einem automatisierten Verhaltensaudit mit rund 1.900 Szenarien hatte Mythos 5.2 den niedrigsten Score für nicht-aufgabenorientiertes Verhalten unter den verglichenen Modellen. Es halluzinierte seltener Eingaben, behauptete seltener fälschlich, eine Aufgabe sei erledigt, oder versteckte schlechte Arbeit.
Ein paar weitere interessante Punkte, die du kennen solltest und die zum Nachdenken anregen:
- Bewertungsbewusstsein: Sowohl Fable 5.2 als auch Mythos 5.2 äußern häufiger als frühere Modelle den Verdacht, getestet zu werden, was Evaluierungen wie die oben genannte schwerer vertrauenswärdig macht.
- Gezielt gedeckelte KI-Forschungsfähigkeiten: Anthropic hat die Zugewinne der Modelle in zwei Bereichen begrenzt – Accelerator-Kernel-Optimierung und Verbesserung von LLM-Architekturen –, sodass sie dort in etwa auf dem Niveau von Opus 5.5 liegen.
- Distillationsschutz: Fable 5.2 verfügt über Anthropics bislang stärkste Anti-Distillations-Maßnahmen, und „preserved thinking“, das verhindert, dass API-Nutzer frühere Kontexte bearbeiten, um die Begründung des Modells zu extrahieren, gilt nun für alle Accounts.
Welches Claude-Modell solltest du verwenden?
Mein Rat deckt sich mit Anthropics Empfehlung: Starte mit Opus 5.5 und wechsle nur bei Bedarf nach oben. So ordnet sich die Reihe ein:
- Claude Opus 5.5 (4 $/20 $): Der Standard für die meisten Coding-, Forschungs- und Wissensarbeitsaufgaben. Es kostet pro Token halb so viel wie Fable 5.2 und liegt in vielen Benchmarks knapp dahinter.
- Claude Fable 5.2 (8 $/40 $): Für die härtesten Probleme, lange Multi-Agenten-Läufe und Aufgaben, bei denen Opus 5.5 ins Stocken gerät, etwa große Migrationen, Forschungsschlussfolgerungen oder Hardware-Design. Probiere niedrigere Aufwandsstufen, bevor du Maximalaufwand annimmst.
- Claude Mythos 5.2: Für geprüfte Security-Teams und Forschende in den Lebenswissenschaften, die Fähigkeiten benötigen, die Fable 5.2 aus Sicherheitsgründen blockiert.
- Claude Sonnet 5.5 und Haiku 5.5: Für hohes Volumen, einfachere oder latenzkritische Aufgaben oder als kleinere Modelle, die Fable 5.2 orchestriert.
Claude Fable 5.2: Preis und Verfügbarkeit
| Pro 1 Mio. Token | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Input | 8 $ | 10 $ | 4 $ |
| Output | 40 $ | 50 $ | 20 $ |
| Cache-Lesezugriffe | 0,20 $ | 0,25 $ | 0,20 $ |
| 5-Minuten-Cache-Schreibzugriffe | 10 $ | 12,50 $ | 5 $ |
| Batch (Input / Output) | 4 $ / 20 $ | 5 $ / 25 $ | 2 $ / 10 $ |
| Fast Mode (Input / Output) | 16 $ / 80 $ | Nicht aufgeführt | 8 $ / 40 $ |
Wir haben gerade eine Tabelle mit Benchmarks gesehen, in der Fable 5.2 Fable 5.1 in allen aufgeführten Punkten übertrifft. Jetzt zeige ich dir eine Tabelle, in der Fable 5.2 günstiger ist als 5.1. Also: Ist Fable 5.1 überholt?
Für neue Arbeiten im Grunde ja. Wenn du Zugang zu Fable 5.2 hast, gibt es wenig Grund, Neues auf 5.1 zu starten. Anthropic hat jedoch kein End-of-Life-Datum genannt, und Teams mit auf Fable 5.1 abgestimmten Prompts oder Agenten sollten 5.2 vor dem Wechsel testen. Wir wissen, dass sich eine neue Version trotz besserer Scores anders verhalten kann.
So bekommst du Zugriff auf Claude Fable 5.2
-
Claude-Apps: Fable 5.2 ist in geeigneten Bezahlplänen verfügbar. Als Launch-Promo können Pro-Pläne und Standard-Teamlizenzen Fable für bis zu 50% ihrer wöchentlichen Nutzungslimits verwenden, und Pläne mit Fable erhalten je nach Abo-Laufzeit ein bis drei Nutzungresets.
-
API: Verwende die Model-ID claude-fable-5-2 auf der Claude Platform.
-
Cloud-Plattformen: Verfügbar auf Amazon Web Services, Google Cloud und Microsoft Azure.
-
Mythos 5.2: Beantrage Zugriff über das Cyber Verification Program oder das Life Sciences Verification Program. Claude-Enterprise-Kunden können es auch über Claude Security nutzen.
Unternehmen mit strengen Datenanforderungen können Enterprise Frontier Safeguards nutzen. Dabei läuft Anthropics Sicherheitsmonitoring auf Daten, die in der eigenen Infrastruktur des Kunden gespeichert sind, und es funktioniert mit keiner Datenhaltung. Andere Kunden haben eine 30-tägige Datenhaltung für Sicherheitsmonitoring.
Fazit
Claude Fable 5.2 ist ein spürbares Upgrade gegenüber Fable 5.1. Es ist günstiger, schneller und lehnt legitime Arbeit seltener ab. Besonders groß sind die Sprünge beim Remote Labor Index, in der Robotik und bei FrontierCode.
Dennoch bleibt Opus 5.5 für die meisten Alltagsaufgaben zum halben Preis das bessere Angebot. Am spannendsten an Fable 5.2 sind vielleicht die Effizienzclaims: Wenn es die Bestwerte von Opus 5.5 bei geringem oder mittlerem Aufwand wirklich erreicht, schrumpft der Pro-Token-Aufpreis schnell. Das solltest du an deinen eigenen Workloads testen.
Wenn du Claude in der Praxis kennenlernen willst, ist unser Developing AI Applications-Lernpfad ein guter Start.




Heute hat Anthropic Fable 5.2 für alle und Mythos 5.2 für geprüfte Organisationen angekündigt. Beides basiert auf demselben zugrunde liegenden Modell, aber die Fable-Version hat zusätzliche Sicherheitsmechanismen für Cybersicherheit und Biologie.
Die wichtigsten Änderungen sind:
Konkret kostet Fable 5.2 20% weniger als Fable 5.1, erzeugt Ausgaben bis zu 30% schneller und übertrifft GPT-6 Astra und Gemini 4 Carbon auf den meisten Zeilen in Anthropics Benchmark-Tabelle.
In diesem Artikel zeige ich, was in Fable 5.2 und Mythos 5.2 neu ist, wie sie in Benchmarks abschneiden, was sie kosten und wie du entscheidest, ob du sie statt Claude Opus 5.5 brauchst.
Was ist Claude Fable 5.2?
Claude Fable 5.2 ist Anthropics leistungsstärkstes allgemein verfügbares Modell. Es ist für langwierige, anspruchsvolle technische Arbeit gemacht: große Codebase-Migrationen, mehrtägige Agentenläufe, Forschungsprobleme und Engineering-Design.
Fable 5.2 kann auch mit kleineren Modellen zusammenarbeiten, entweder als Berater für schwierige Probleme oder als Orchestrator, der einfachere Teilaufgaben an sie delegiert.
Fable 5.2 behält das 1M-Token-Kontextfenster und 128K maximale Ausgabe seines Vorgängers, und der Wissensstand liegt bei Juni 2026.
Was ist Claude Mythos 5.2?
Claude Mythos 5.2 ist dasselbe Modell wie Fable 5.2, jedoch ohne die Schutzmechanismen, die die meisten Cybersecurity-Aufgaben und biowissenschaftliche Arbeiten auf Forschungsniveau blockieren. Tatsächlich ist Mythos 5.2 Anthropics leistungsfähigstes Modell für Cybersecurity-Engineering. Weil diese Fähigkeiten doppelten Verwendungszwecken dienen können, bietet Anthropic Mythos 5.2 nur über das Cyber Verification Program und das Life Sciences Verification Program für geprüfte Organisationen an.
Was ist neu in Claude Fable 5.2?
Fable gibt es erst seit Juni, als Anthropic Fable 5 veröffentlichte. Seitdem gab es zwei Punkt-Releases, Fable 5.1 im September und jetzt Fable 5.2, und keines hat viele neue Features gebracht. Beide machten das Modell vor allem günstiger, schneller und stärker – und die Leistungszuwächse sind nicht klein: Fable 5.2 verdoppelt beispielsweise den Score von Fable 5.1 im Remote Labor Index deutlich.
Der größte Unterschied zwischen den Releases liegt in der erlaubten Nutzung. Mit Fable 5.1 hat Anthropic die Cybersecurity-Schutzmechanismen verengt und erlaubt, das Modell zum Finden von Software-Schwachstellen zu nutzen, nicht aber zum Schreiben von Exploits. Außerdem wurden parallel die Enterprise Frontier Safeguards angekündigt, eine Option, um deine Daten in deiner eigenen Cloud zu halten. Die Änderungen der Schutzmechanismen in Fable 5.2 sind kleiner: Es blockiert weniger Anfragen, aber die gleichen Aufgaben bleiben tabu.
Die neuen vorgeschlagenen Nutzungsszenarien, etwa Fable 5.2 als Berater für kleinere Claude-Modelle, sind ebenfalls nicht neu, da Anthropics Advisor-Tool bereits Fable 5 und 5.1 unterstützte. Und die Launch-Demos, wie das aus einem leeren Ordner aufgebaute Betriebssystem, zeigen ein stärkeres Modell bei schwierigeren Aufgaben, jedoch keine neuen umschaltbaren Features.
Wenn ich dennoch auf Neues zeigen soll, würde ich Folgendes hervorheben:
Ein niedrigerer Preis
Fable 5.2 kostet 8 $ pro Million Input-Token und 40 $ pro Million Output-Token, also 20% weniger als die 10 $/50 $ von Fable 5.1. Der gleiche 20%-Schnitt gilt für Cache-Lesezugriffe (0,20 $), Cache-Schreibzugriffe und Batch-Verarbeitung. Die komplette Übersicht findest du unten im Preisteil.
Schnellere Ausgabe und Fast Mode für Fable
Die Ausgabe ist bis zu 30% schneller als bei Fable 5.1, was sich bei langen Agentenläufen summiert. Fable unterstützt jetzt außerdem Fast Mode, der die Ausgabe um bis zu 2,5× beschleunigt – zum doppelten Preis (16 $/80 $).
Bessere Ergebnisse mit weniger Aufwand
Das dürfte deine Rechnung am ehesten beeinflussen. Bei hohem Aufwand erzielt Fable 5.2 45,3% auf FrontierCode 2.0, in etwa auf Augenhöhe mit dem Bestwert von Opus 5.5, bei ungefähr halben Kosten pro Aufgabe. Bei geringem Aufwand erreicht es auf Humanity's Last Exam den Top-Score von Opus 5.5 bei weniger als einem Zehntel der Kosten pro Aufgabe. Mein Fazit: Wenn du von Opus 5.5 wechselst, starte Fable 5.2 mit geringerem Aufwand.
Weniger blockierte Anfragen
Fable 5.2 sollte etwa 55% weniger Safety-Blocks treffen als Fable 5.1 (etwa 60% weniger in Cybersecurity und 40% weniger in Biologie). Das ist großartig, wenn dich die Ablehnungen von Fable 5.1 ausgebremst haben, aber die gesperrten Kategorien haben sich nicht verändert: Penetrationstests, Exploit-Erstellung und die meisten Forschungsaufgaben in der Biologie werden weiterhin an ältere Claude-Modelle übergeben.
Wie schlägt sich Claude Fable 5.2 in Benchmarks?
Hier sind die wichtigsten Ergebnisse. Sie stammen alle aus Anthropics Launch-Tabelle – lies sie also als Anthropics Argument für das Modell, nicht als unabhängige Resultate. Die Claude-Scores wurden mit aktivierten Schutzmechanismen ermittelt. Außer wenn anders vermerkt, ist jedes Modell mit seinem höchsten verfügbaren Aufwand gezeigt.
Agentisches Coding
Fable 5.2 führt beide Coding-Benchmarks in der Tabelle an. Auf FrontierCode 2.0, das misst, ob Open-Source-Maintainer Codeänderungen des Modells mergen würden, erzielt es 49,1% – der höchste Wert in der Tabelle und deutlich über den 32,4% von Fable 5.1. Auf FrontierSWE v2 erreicht es 69,9% und liegt damit vor GPT-6 Astra (65,5%) und Opus 5.5 (62,3%).
Die Launch-Beispiele zeigen das Gleiche: Agenten mit einer frühen Version von Fable 5.2 migrierten einen Produktivdienst von Python zu Rust, der nun etwa 26-mal schneller startet.
Wissensarbeit und Forschung
Den größten relativen Sprung gibt es beim Remote Labor Index, der misst, wie gut ein Modell echte Projekte im Freelancer-Stil erledigt. Fable 5.2 erreicht 41,3% und liegt damit ungefähr doppelt so hoch wie Opus 5.5 (21,3%) und GPT-6 Astra (20,8%). Es führt außerdem bei Humanity's Last Exam mit Tools (74,2%) und bei Terminal-Bench-Science (74,6% bzw. 75,3% für Mythos 5.2).
Geschäftsautomatisierung ist das eine Feld, in dem es zurückliegt. Auf AutomationBench erzielt Gemini 4 Carbon 53,9% gegenüber 51,4% für Fable 5.2, wobei Fable 5.2 immer noch deutlich vor Fable 5.1 (31,4%) liegt.
Außerhalb der Haupttabelle erzielte Fable 5.2 83,5 auf dem Hardware-Engineering-Benchmark BenchCAD 2.1, verglichen mit 65,3 für Opus 5.5. Ihm wird zudem zugeschrieben, zwei offene Probleme der Schwarze-Loch-Physik gelöst zu haben; die Ergebnisse sind als Preprints veröffentlicht, sodass andere Physiker sie überprüfen können.
Computerbedienung, Robotik und Vision
Fable 5.2 erreicht 89,3% auf OSWorld 2.1, vor Opus 5.5 (87,2%) und GPT-6 Astra (79,5%). Den größten Sprung in der Tabelle legt es in der Robotik hin: 64,9% auf RoboDojo Sim, mehr als doppelt so viel wie Fable 5.1 und GPT-6 Astra. Bei Chartography, das das Lesen von Diagrammen ohne Tools testet, liegt es knapp vor Gemini 4 Carbon und GPT-6 Astra, nachdem Fable 5.1 mit 44,8% deutlich zurücklag.
Cybersicherheit und Biologie (Mythos 5.2)
Die Zeilen zu Sicherheit und Biologie beziehen sich auf Mythos 5.2, da Fable 5.2 diese Aufgaben größtenteils blockiert. Mythos 5.2 erzielt 76,3% auf CyScenarioBench (vs. 61,7% für Mythos 5.1), 89,6% bei CVE Rediscovery (vs. 78,3%) und 85,1% bei einer 24-Stunden-Aufgabe zur Proteinbinder-Entwicklung (vs. 79,1%). Ein fairer Vergleich mit OpenAIs Sicherheitsmodell ist hier nicht möglich, da jedes Labor seine eigenen CyScenarioBench-Aufgaben verwendet hat.
Was hat es mit Fermats letztem Satz auf sich?
Ein Team aus Fable-5.2-Agenten hat den Beweis von Fermats letztem Satz in 30 Stunden im Proof-Assistenten Lean formalisiert. Du fragst dich vielleicht: Der Satz wurde doch schon vor drei Jahrzehnten bewiesen – was gibt es da noch zu tun?
Der Satz ist alter Hut
Fermats letzter Satz besagt, dass es keine positiven ganzen Zahlen a, b und c gibt, für die an + bn = cn mit n größer als 2 gilt. Für n = 2 gibt es viele Lösungen, etwa 32 + 42 = 52 (9 + 16 = 25). Bei Kuben bekommst du aber nur Beinahe-Treffer: 63 + 83 = 728, eins weniger als 93 = 729.
Pierre de Fermat behauptete 1637 einen Beweis, schrieb ihn aber nie auf. Das Problem blieb über 350 Jahre ungelöst, bis Andrew Wiles es Mitte der 1990er-Jahre mit Hilfe von Richard Taylor bewies.
Was eine Lean-Formalisation ist
Wiles' Beweis umfasst über 100 Seiten und baut auf Jahrzehnten fortgeschrittener Zahlentheorie auf, sodass ihn nur sehr wenige Menschen end-to-end überprüfen können. Lean ist ein Proof-Assistent: eine Programmiersprache, in der du einen Beweis als Code verfasst und die Software jeden logischen Schritt bis zu den grundlegenden Axiomen der Mathematik prüft. Wenn der Beweis kompiliert, ist er korrekt. Einen Satz zu „formalisieren“ bedeutet, den menschlich geschriebenen Beweis in diese maschinenprüfbare Form zu übersetzen.
Bei Fermats letztem Satz ist das eine Mammutaufgabe, denn vieles der benötigten Mathematik war zuvor nie in Lean niedergeschrieben worden. Der Mathematiker Kevin Buzzard startete 2024 ein Community-Projekt, um das zu übernehmen.
Warum das für ein KI-Modell spannend ist
Die meiste KI-Ausgabe wird von Menschen bewertet oder über Benchmarks, die nur Teile der Antwort prüfen. Ein Lean-Beweis ist anders: Der Checker akzeptiert jeden Schritt oder eben nicht – subtile Fehler sind ausgeschlossen. Das macht ihn zu einem außergewöhnlich sauberen Test dafür, ob ein Modell ein sehr langes, sehr schwieriges Projekt bis zum verifizierten Abschluss tragen kann.
Das ist nicht das erste Mal, dass Claude das schafft. Im September veröffentlichte Anthropic den ersten vollständig computergestützten, geprüften Beweis des Satzes, erstellt von Dutzenden Agenten mit einem internen Forschungsmodell, grob vergleichbar mit Fable 5.1. Dieser Durchlauf dauerte 11 Tage und etwa sechs Milliarden Output-Token, erzeugte 13 Millionen Zeilen Lean und baute teils auf Teilen von Buzzards Projekt auf. Fable 5.2 schaffte das in 30 Stunden mit minimaler menschlicher Hilfe.
Die Einschränkungen
Am aufschlussreichsten ist, was passierte, als Anthropic Claude Opus 5.5 denselben Job gab.
Claude Fable 5.2 vs. Claude Opus 5.5
Oft vergleicht man Modelle über Benchmark-Scores und versucht daraus abzuleiten, wie der Unterschied in der Praxis aussieht. Dieses Mal gefällt mir, dass Anthropic mit einer Geschichte beginnt, die die Lücke deutlicher macht.
Im gleichen Lean-Setup mit 1.000 Agenten schaffte Opus 5.5 in 18 Stunden 26% des Beweises von Fermats letztem Satz und kam danach kaum voran. Fable 5.2 beendete die gesamte Aufgabe in 30 Stunden. Die Quintessenz: Bei sehr langen, multiagentischen Projekten kann Opus 5.5 steckenbleiben, wo Fable 5.2 weiterläuft.
Bei kürzeren Aufgaben ist der Abstand kleiner. Hier der Direktvergleich:
Das Muster passt zum Lean-Ergebnis. Bei Computerbedienung und Coding liegt Fable 5.2 nur wenige Punkte vorn. Bei offenen, mehrschrittigen Aufgaben wird der Vorsprung größer: Fable 5.2 verdoppelt nahezu Opus 5.5 beim Remote Labor Index und liegt bei der Robotersteuerung 25 Punkte vorn.
Beim Preis ist der Abstand geringer, als er aussieht. Fable 5.2 kostet pro Token doppelt so viel, erreicht aber häufig die Bestwerte von Opus 5.5 bei geringerem Aufwand und damit mit weniger Token. Auf FrontierCode 2.0 etwa erreicht Fable 5.2 bei hohem Aufwand ungefähr den Bestwert von Opus 5.5 – zu etwa halben Kosten pro Aufgabe.
Opus 5.5 bleibt also die sinnvolle Voreinstellung. Aber wenn eine Aufgabe stundenlang läuft, viele Agenten umfasst oder mit Opus immer wieder steckenbleibt, bringt Fable 5.2 sie wahrscheinlich zu Ende – und das möglicherweise günstiger, als es der Pro-Token-Preis vermuten lässt.
Sicherheit und Grenzen
Anthropic stuft das Risiko, dass sich diese Modelle in sicherheitskritischen Situationen unsicher verhalten, als gering ein.
Das ist von außen schwer zu überprüfen, daher sind die konkreten Zahlen hilfreich. In einem automatisierten Verhaltensaudit mit rund 1.900 Szenarien hatte Mythos 5.2 den niedrigsten Score für nicht-aufgabenorientiertes Verhalten unter den verglichenen Modellen. Es halluzinierte seltener Eingaben, behauptete seltener fälschlich, eine Aufgabe sei erledigt, oder versteckte schlechte Arbeit.
Ein paar weitere interessante Punkte, die du kennen solltest und die zum Nachdenken anregen:
Welches Claude-Modell solltest du verwenden?
Mein Rat deckt sich mit Anthropics Empfehlung: Starte mit Opus 5.5 und wechsle nur bei Bedarf nach oben. So ordnet sich die Reihe ein:
Claude Fable 5.2: Preis und Verfügbarkeit
Wir haben gerade eine Tabelle mit Benchmarks gesehen, in der Fable 5.2 Fable 5.1 in allen aufgeführten Punkten übertrifft. Jetzt zeige ich dir eine Tabelle, in der Fable 5.2 günstiger ist als 5.1. Also: Ist Fable 5.1 überholt?
Für neue Arbeiten im Grunde ja. Wenn du Zugang zu Fable 5.2 hast, gibt es wenig Grund, Neues auf 5.1 zu starten. Anthropic hat jedoch kein End-of-Life-Datum genannt, und Teams mit auf Fable 5.1 abgestimmten Prompts oder Agenten sollten 5.2 vor dem Wechsel testen. Wir wissen, dass sich eine neue Version trotz besserer Scores anders verhalten kann.
So bekommst du Zugriff auf Claude Fable 5.2
Claude-Apps: Fable 5.2 ist in geeigneten Bezahlplänen verfügbar. Als Launch-Promo können Pro-Pläne und Standard-Teamlizenzen Fable für bis zu 50% ihrer wöchentlichen Nutzungslimits verwenden, und Pläne mit Fable erhalten je nach Abo-Laufzeit ein bis drei Nutzungresets.
API: Verwende die Model-ID
claude-fable-5-2auf der Claude Platform.Cloud-Plattformen: Verfügbar auf Amazon Web Services, Google Cloud und Microsoft Azure.
Mythos 5.2: Beantrage Zugriff über das Cyber Verification Program oder das Life Sciences Verification Program. Claude-Enterprise-Kunden können es auch über Claude Security nutzen.
Unternehmen mit strengen Datenanforderungen können Enterprise Frontier Safeguards nutzen. Dabei läuft Anthropics Sicherheitsmonitoring auf Daten, die in der eigenen Infrastruktur des Kunden gespeichert sind, und es funktioniert mit keiner Datenhaltung. Andere Kunden haben eine 30-tägige Datenhaltung für Sicherheitsmonitoring.
Fazit
Claude Fable 5.2 ist ein spürbares Upgrade gegenüber Fable 5.1. Es ist günstiger, schneller und lehnt legitime Arbeit seltener ab. Besonders groß sind die Sprünge beim Remote Labor Index, in der Robotik und bei FrontierCode.
Dennoch bleibt Opus 5.5 für die meisten Alltagsaufgaben zum halben Preis das bessere Angebot. Am spannendsten an Fable 5.2 sind vielleicht die Effizienzclaims: Wenn es die Bestwerte von Opus 5.5 bei geringem oder mittlerem Aufwand wirklich erreicht, schrumpft der Pro-Token-Aufpreis schnell. Das solltest du an deinen eigenen Workloads testen.
Wenn du Claude in der Praxis kennenlernen willst, ist unser Developing AI Applications-Lernpfad ein guter Start.