Hoje, a Anthropic anunciou o Fable 5.2 para todos e o Mythos 5.2 para organizações verificadas. Eles usam o mesmo modelo base, mas a versão Fable traz salvaguardas extras de cibersegurança e biologia.
As mudanças de destaque são:
- preço menor,
- saída mais rápida e
- grandes saltos nos benchmarks mais difíceis da Anthropic.
Mais especificamente, o Fable 5.2 custa 20% menos que o Fable 5.1, gera respostas até 30% mais rápido e supera o GPT-6 Astra e o Gemini 4 Carbon na maioria das linhas da tabela de benchmarks da Anthropic.
Neste artigo, vou cobrir o que há de novo no Fable 5.2 e no Mythos 5.2, como eles se saem nos benchmarks, quanto custam e como decidir se vale a pena escolhê-los em vez do Claude Opus 5.5.
O que é o Claude Fable 5.2?
O Claude Fable 5.2 é o modelo mais capaz da Anthropic disponível para uso geral. Ele foi feito para trabalhos técnicos longos e exigentes: migrações de grandes codebases, execuções de agentes por vários dias, problemas de pesquisa e projetos de engenharia.
O Fable 5.2 também pode trabalhar junto com modelos menores, seja como conselheiro para consultas em problemas difíceis ou como orquestrador que delega subtarefas simples para eles.
O Fable 5.2 mantém a janela de contexto de 1 milhão de tokens e o máximo de 128K tokens de saída do seu antecessor, e seu knowledge cutoff é junho de 2026.
O que é o Claude Mythos 5.2?
O Claude Mythos 5.2 é o mesmo modelo do Fable 5.2, mas sem as salvaguardas que bloqueiam a maior parte do trabalho de cibersegurança e a pesquisa em nível avançado de biologia. Na prática, o Mythos 5.2 é o modelo mais capaz da Anthropic para engenharia de segurança. Como essas capacidades têm uso dual, a Anthropic só oferece o Mythos 5.2 para organizações verificadas por meio do Cyber Verification Program e do Life Sciences Verification Program.
O que há de novo no Claude Fable 5.2?
O Fable existe só desde junho, quando a Anthropic lançou o Fable 5. Desde então, houve duas versões pontuais, o Fable 5.1 em setembro e agora o Fable 5.2, e nenhuma delas trouxe muitas funcionalidades inéditas. O foco foi tornar o modelo mais barato, rápido e potente, e os ganhos não foram pequenos: por exemplo, o Fable 5.2 mais do que dobrou a pontuação do Fable 5.1 no Remote Labor Index.
A maior diferença entre as duas versões está no que você tem permissão para fazer com o modelo. Com o Fable 5.1, a Anthropic afunilou as salvaguardas de cibersegurança e passou a permitir usar o modelo para encontrar vulnerabilidades de software, mas não para escrever exploits, e anunciou o Enterprise Frontier Safeguards, uma opção para manter seus dados na sua própria nuvem, junto com o lançamento. As mudanças de salvaguardas do Fable 5.2 são menores: ele bloqueia menos solicitações, mas os mesmos tipos de tarefas continuam proibidos.
Os novos jeitos sugeridos pela Anthropic de usá-lo, como fazer o Fable 5.2 aconselhar modelos Claude menores, também não são exatamente novos, já que a ferramenta advisor da Anthropic já suportava o Fable 5 e 5.1. E os demos de lançamento, como o sistema operacional construído a partir de uma pasta vazia, mostram um modelo mais forte fazendo tarefas mais difíceis, não recursos novos que você ativa com um botão.
Dito isso, se é para destacar novidades, eu citaria:
Preço mais baixo
O Fable 5.2 custa US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída, 20% menos que os US$ 10/US$ 50 do Fable 5.1. O mesmo corte de 20% vale para leituras de cache (US$ 0,20), gravações de cache e processamento em lote. Veja a seção de preços abaixo para o detalhamento completo.
Saída mais rápida e modo rápido para o Fable
A saída está até 30% mais rápida que no Fable 5.1, o que soma bastante em execuções longas de agentes. O Fable agora também tem fast mode, que acelera a saída em até 2,5x pelo dobro do preço (US$ 16/US$ 80).
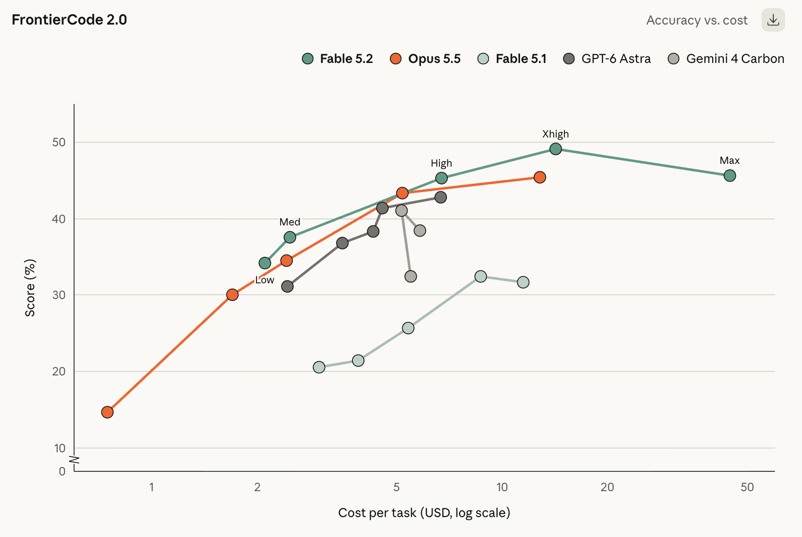
Essa é a mudança com mais chances de impactar sua conta. No esforço alto, o Fable 5.2 faz 45,3% no FrontierCode 2.0, na mesma faixa do melhor do Opus 5.5, por cerca de metade do custo por tarefa. No esforço baixo, ele iguala a melhor pontuação do Opus 5.5 no Humanity's Last Exam por menos de um décimo do custo por tarefa. Minha leitura: se você vier do Opus 5.5, comece o Fable 5.2 em um nível de esforço menor.
Menos solicitações bloqueadas
O Fable 5.2 deve sofrer cerca de 55% menos bloqueios de segurança que o Fable 5.1 (cerca de 60% menos em cibersegurança e 40% menos em biologia). Isso faz diferença se as recusas do Fable 5.1 estavam no seu caminho, mas as categorias bloqueadas não mudaram: testes de intrusão, geração de exploits e a maior parte da biologia em nível de pesquisa continuam sendo repassados para modelos Claude mais antigos.
Como o Claude Fable 5.2 se sai nos benchmarks?
Aqui estão os principais resultados. Todos vêm da tabela de lançamento da Anthropic, então leia como o argumento da Anthropic a favor do modelo, não como resultados independentes. As pontuações do Claude foram rodadas com salvaguardas ligadas. Salvo indicação, cada modelo aparece no maior nível de esforço disponível.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (codificação com agentes) | 49,1% | 32,4% | 45,5% | 42,8% | 41,1% |
| FrontierSWE v2 (codificação com agentes) | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench (fluxos de trabalho de negócios) | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Terminal-Bench-Science 0,1 | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| OSWorld 2.1 (uso de computador) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| RoboDojo Sim (robótica) | 64,9% | 27,6% | 39,4% | 29,8% | Não informado |
| AA-Briefcase v1.1 (trabalho do conhecimento) | 66,1% | 61,5% | 61,2% | 52,0% | 61,8% |
| Remote Labor Index (trabalho do conhecimento) | 41,3% | 17,9% | 21,3% | 20,8% | Não informado |
| Humanity's Last Exam (com ferramentas) | 74,2% | 65,6% | 67,7% | 57,2% | Não informado |
| WANDR (busca com agentes) | 82,1% | 68,7% | 72,3% | Não informado | Não informado |
| Chartography (sem ferramentas) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
O Fable 5.2 lidera os dois benchmarks de código na tabela. No FrontierCode 2.0, que mede se mantenedores de open source fariam merge das mudanças de código do modelo, ele marca 49,1%, a maior pontuação na tabela e bem acima dos 32,4% do Fable 5.1. No FrontierSWE v2, faz 69,9%, à frente do GPT-6 Astra (65,5%) e do Opus 5.5 (62,3%).
Os exemplos do lançamento apontam na mesma direção: agentes rodando uma versão inicial do Fable 5.2 migraram um serviço em produção de Python para Rust, e agora ele inicia cerca de 26 vezes mais rápido.
Trabalho do conhecimento e pesquisa
O maior salto relativo está no Remote Labor Index, que mede como o modelo conclui projetos reais no estilo freelancer. O Fable 5.2 faz 41,3%, aproximadamente o dobro do Opus 5.5 (21,3%) e do GPT-6 Astra (20,8%). Ele também lidera no Humanity's Last Exam com ferramentas (74,2%) e no Terminal-Bench-Science (74,6%, ou 75,3% para o Mythos 5.2).
Automação de negócios é a única área em que ele fica atrás. No AutomationBench, o Gemini 4 Carbon marca 53,9% contra 51,4% do Fable 5.2, embora o Fable 5.2 ainda esteja muito à frente do Fable 5.1 (31,4%).
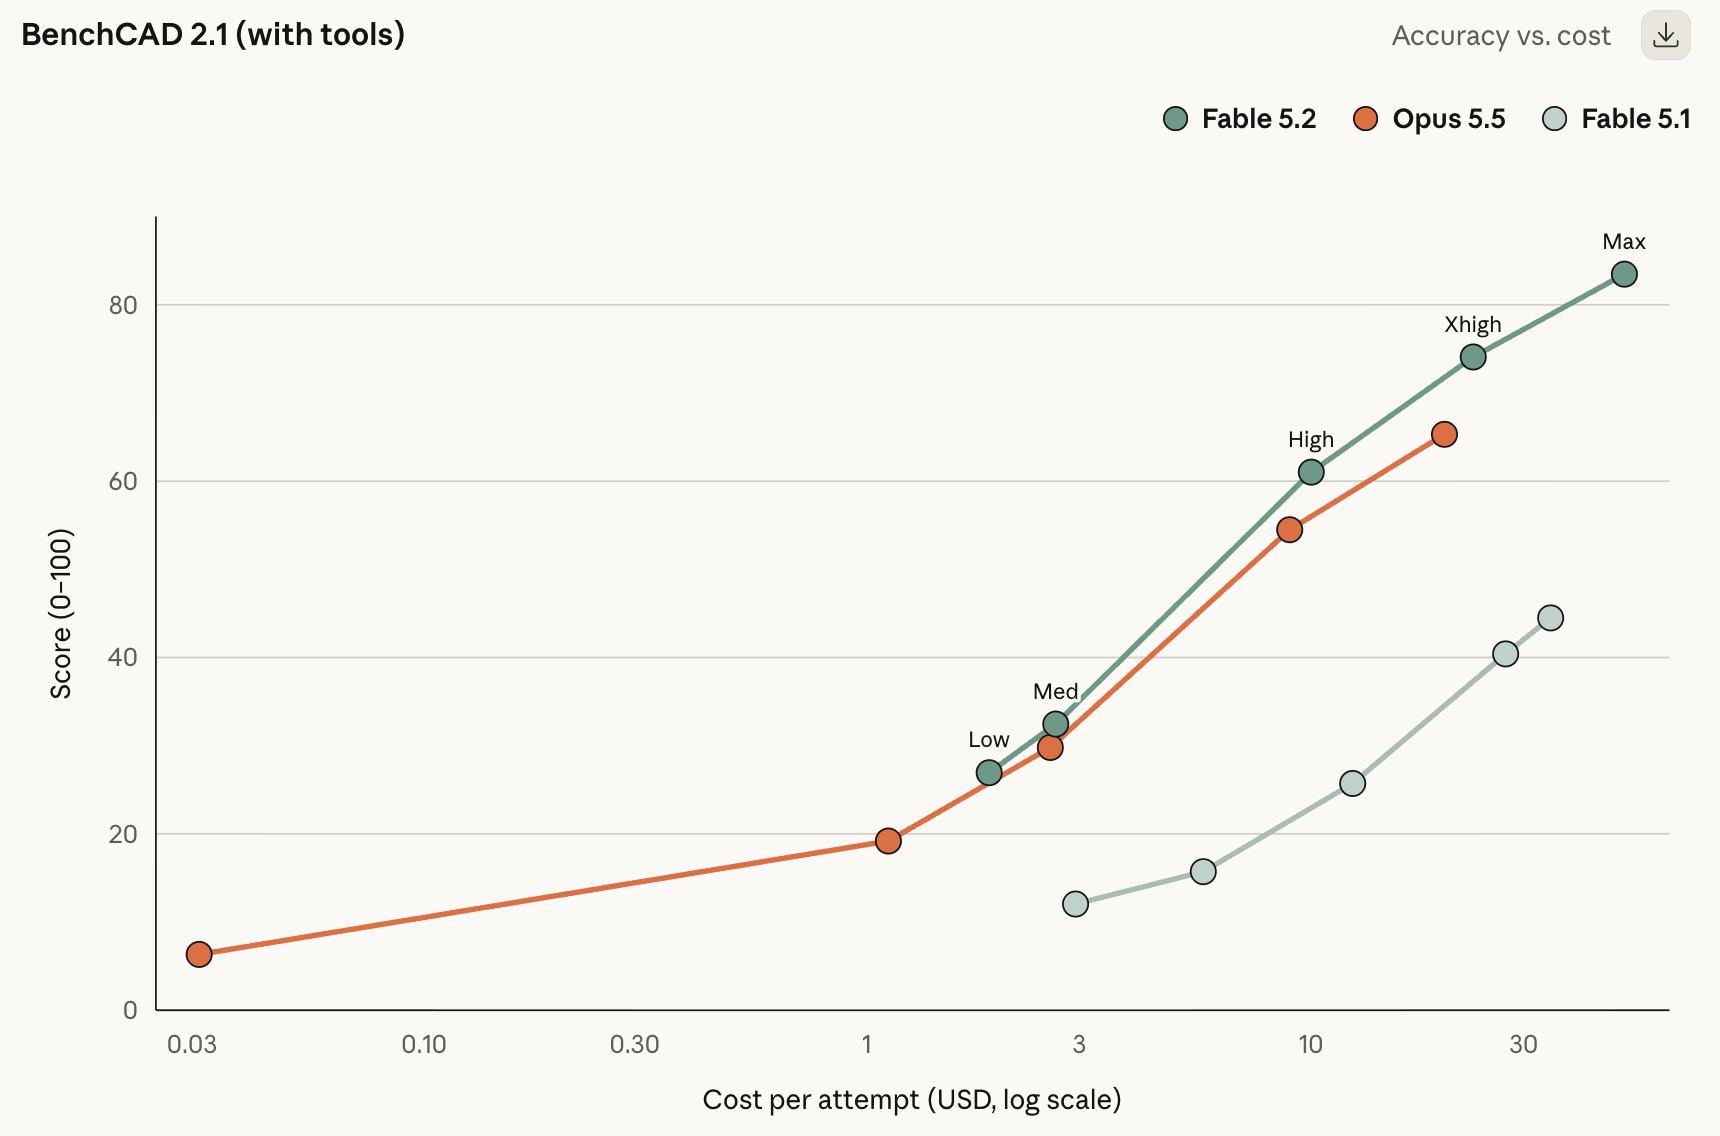
Fora da tabela principal, o Fable 5.2 marcou 83,5 no benchmark de engenharia de hardware BenchCAD 2.1, contra 65,3 do Opus 5.5. Ele também é creditado por resolver dois problemas em aberto em física de buracos negros, com resultados postados como preprints para revisão de outros físicos.
Uso de computador, robótica e visão
O Fable 5.2 faz 89,3% no OSWorld 2.1, à frente do Opus 5.5 (87,2%) e do GPT-6 Astra (79,5%). Seu salto em robótica é o maior da tabela: 64,9% no RoboDojo Sim, mais que o dobro do Fable 5.1 e do GPT-6 Astra. No Chartography, que testa leitura de gráficos sem ferramentas, ele supera por pouco o Gemini 4 Carbon e o GPT-6 Astra, depois de o Fable 5.1 ter ficado bem para trás com 44,8%.
Cibersegurança e biologia (Mythos 5.2)
As linhas de segurança e biologia são do Mythos 5.2, já que as salvaguardas do Fable 5.2 bloqueiam a maior parte dessas tarefas. O Mythos 5.2 faz 76,3% no CyScenarioBench (vs 61,7% do Mythos 5.1), 89,6% no CVE Rediscovery (vs 78,3%) e 85,1% em uma tarefa de design de protein binder de 24 horas (vs 79,1%). Não há comparação justa com o modelo de segurança da OpenAI aqui, já que cada laboratório executou suas próprias tarefas do CyScenarioBench.
O que é isso sobre o Último Teorema de Fermat?
Um time de agentes do Fable 5.2 formalizou a prova do Último Teorema de Fermat no assistente de provas Lean em 30 horas. Você pode estar pensando: o teorema não foi provado há três décadas? O que restava fazer?
O teorema em si não é novidade
O Último Teorema de Fermat diz que não existem números inteiros positivos a, b e c tais que an + bn = cn para qualquer n maior que 2. Para n = 2, há várias soluções, como 32 + 42 = 52 (9 + 16 = 25). Mas, com cubos, só aparecem quase-acertos: 63 + 83 = 728, um a menos que 93 = 729.
Pierre de Fermat afirmou ter uma prova em 1637, mas nunca a escreveu, e o problema ficou sem solução por mais de 350 anos, até Andrew Wiles prová-lo em meados dos anos 1990, com ajuda de Richard Taylor.
A prova de Wiles tem mais de 100 páginas e se apoia em décadas de teoria dos números avançada, então pouquíssimas pessoas conseguem verificá-la de ponta a ponta. O Lean é um assistente de provas: uma linguagem de programação em que você escreve a prova como código, e o software verifica cada passo lógico até os axiomas básicos da matemática. Se a prova compila, ela está correta. “Formalizar” um teorema significa traduzir a prova humana para essa forma verificável por máquina.
No caso do Último Teorema de Fermat, é um trabalhão, porque boa parte da matemática de suporte nunca tinha sido escrita em Lean. O matemático Kevin Buzzard iniciou um projeto comunitário para isso em 2024.
Por que isso é interessante para um modelo de IA
A maior parte das saídas de IA é julgada por pessoas ou por benchmarks que testam só uma parte da resposta. Uma prova em Lean é diferente: o verificador aceita cada passo ou não, então não há como errar “sutilmente”. Isso a torna um teste incomumente limpo de se o modelo consegue levar um projeto muito longo e difícil até uma conclusão verificada.
Não é a primeira vez que o Claude faz isso. Em setembro, a Anthropic publicou a primeira prova completa verificada por computador do teorema, escrita por dezenas de agentes rodando um modelo interno de pesquisa aproximadamente comparável ao Fable 5.1. Aquela empreitada levou 11 dias e cerca de seis bilhões de tokens de saída, produziu 13 milhões de linhas de Lean e se apoiou em partes do projeto do Buzzard. O Fable 5.2 fez em 30 horas, com ajuda humana mínima.
Os poréns
- Isso não acrescenta nada à matemática. O próprio Buzzard disse isso sobre a primeira formalização da Anthropic.
- O Fable 5.2 recebeu uma lista de enunciados intermediários para acompanhar o progresso. É um roadmap do que provar, embora não de como provar.
- Não encontrei revisão externa da nova prova ainda, então, por ora, o número de 30 horas e a comparação com o Opus 5.5 são alegações da Anthropic.
A parte mais reveladora, porém, é o que aconteceu quando a Anthropic deu ao Claude Opus 5.5 o mesmo trabalho.
Claude Fable 5.2 vs. Claude Opus 5.5
Comparar dois modelos geralmente significa ler pontuações de benchmark e tentar inferir como isso se traduz na prática. Desta vez, é útil que a Anthropic tenha começado com uma história, que deixa a diferença mais evidente.
No mesmo setup de Lean com 1.000 agentes, o Opus 5.5 concluiu 26% da prova do Último Teorema de Fermat em 18 horas e mal avançou depois disso. O Fable 5.2 terminou tudo em 30 horas. Conclusão: em projetos muito longos e multiagente, o Opus 5.5 pode travar onde o Fable 5.2 continua.
Em tarefas mais curtas, a diferença é menor. Veja a comparação lado a lado:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| Preço (entrada / saída por 1M tokens) | US$ 8 / US$ 40 | US$ 4 / US$ 20 |
| Janela de contexto / saída máxima | 1M / 128K | 1M / 128K |
| FrontierCode 2.0 (codificação com agentes) | 49,1% | 45,5% |
| FrontierSWE v2 (codificação com agentes) | 69,9% | 62,3% |
| OSWorld 2.1 (uso de computador) | 89,3% | 87,2% |
| AutomationBench (fluxos de trabalho de negócios) | 51,4% | 42,5% |
| Humanity's Last Exam (com ferramentas) | 74,2% | 67,7% |
| Remote Labor Index (trabalho do conhecimento) | 41,3% | 21,3% |
| RoboDojo Sim (robótica) | 64,9% | 39,4% |
O padrão combina com o resultado no Lean. Em uso de computador e código, o Fable 5.2 está apenas alguns pontos à frente. Em trabalho aberto e de múltiplas etapas, a vantagem cresce: o Fable 5.2 quase dobra a pontuação do Opus 5.5 nos projetos estilo freelancer do Remote Labor Index e fica 25 pontos à frente no controle de robôs.
O preço pesa menos do que parece. O Fable 5.2 custa o dobro por token, mas muitas vezes alcança a melhor pontuação do Opus 5.5 com um nível de esforço menor, usando menos tokens. No FrontierCode 2.0, por exemplo, o Fable 5.2 no esforço alto chega perto do melhor do Opus 5.5 por cerca de metade do custo por tarefa.
Então o Opus 5.5 ainda é o padrão sensato para o dia a dia. Mas se uma tarefa roda por horas, envolve muitos agentes ou vive empacando no Opus, o Fable 5.2 tende a concluir — e pode não sair tão mais caro quanto o preço por token sugere.
Segurança e limites
A Anthropic classifica como baixo o risco de comportamento inseguro desses modelos em situações críticas.
Isso é difícil de verificar de fora, então os números mais concretos ajudam. Em uma auditoria comportamental automatizada com cerca de 1.900 cenários, o Mythos 5.2 teve a menor pontuação de comportamento desalinhado entre os modelos comparados. Ele também foi menos propenso a alucinar entradas, afirmar falsamente que uma tarefa foi concluída ou esconder trabalho ruim.
Outros pontos interessantes que valem conhecer e fazem pensar:
- Consciência de avaliação: Fable 5.2 e Mythos 5.2 dizem suspeitar que estão sendo testados com mais frequência do que modelos anteriores, o que torna avaliações como a acima mais difíceis de confiar.
- Habilidades de pesquisa em IA propositalmente limitadas: A Anthropic limitou os ganhos dos modelos em duas áreas — otimização de kernels de aceleradores e melhoria de arquiteturas de LLM — para que desempenhem em nível semelhante ao do Opus 5.5.
- Proteções contra destilação: O Fable 5.2 tem as medidas anti-destilação mais fortes da Anthropic até agora, e o “preserved thinking”, que impede usuários da API de editar o contexto anterior para extrair o raciocínio do modelo, agora se aplica a todas as contas.
Qual modelo Claude você deve usar?
Meu conselho é o mesmo da Anthropic: comece com o Opus 5.5 e suba só quando precisar. A linha fica assim:
- Claude Opus 5.5 (US$ 4/US$ 20): O padrão para a maior parte de código, pesquisa e trabalho do conhecimento. Custa metade do Fable 5.2 por token e fica logo atrás em muitos benchmarks.
- Claude Fable 5.2 (US$ 8/US$ 40): Para os problemas mais difíceis, execuções longas e multiagente e tarefas em que o Opus 5.5 empaca, como migrações grandes, raciocínio em nível de pesquisa ou design de hardware. Experimente em níveis de esforço mais baixos antes de presumir que precisa do máximo.
- Claude Mythos 5.2: Para equipes de segurança e pesquisadores de ciências da vida verificados que precisam de capacidades bloqueadas pelas salvaguardas do Fable 5.2.
- Claude Sonnet 5.5 e Haiku 5.5: Para tarefas de grande volume, mais simples ou sensíveis à latência, ou como modelos menores que o Fable 5.2 orquestra.
Preços e disponibilidade do Claude Fable 5.2
| Por 1M tokens | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Entrada | US$ 8 | US$ 10 | US$ 4 |
| Saída | US$ 40 | US$ 50 | US$ 20 |
| Leituras de cache | US$ 0,20 | US$ 0,25 | US$ 0,20 |
| Gravações de cache de 5 minutos | US$ 10 | US$ 12,50 | US$ 5 |
| Lote (entrada / saída) | US$ 4 / US$ 20 | US$ 5 / US$ 25 | US$ 2 / US$ 10 |
| Fast mode (entrada / saída) | US$ 16 / US$ 80 | Não listado | US$ 8 / US$ 40 |
Tínhamos acabado de ver uma tabela com resultados de benchmark mostrando o Fable 5.2 superando o Fable 5.1 em tudo. Agora, mostro uma tabela em que o Fable 5.2 é mais barato que o 5.1. Então, o Fable 5.1 ficou obsoleto?
Para trabalhos novos, na prática, sim. Se você tem acesso ao Fable 5.2, há pouca razão para começar algo novo no 5.1. A Anthropic não anunciou uma data de aposentadoria, porém, e times com prompts ou agentes ajustados no Fable 5.1 vão querer testar o 5.2 antes de migrar. Sabemos que uma nova versão pode se comportar de forma diferente mesmo quando marca melhor.
Como obter acesso ao Claude Fable 5.2
-
Apps do Claude: O Fable 5.2 está disponível em planos pagos elegíveis. Como promoção de lançamento, planos Pro e assentos padrão de Team podem usar o Fable em até 50% de seus limites semanais, e planos que incluem o Fable ganham de um a três resets de uso, dependendo da duração da assinatura.
-
API: Use o ID de modelo claude-fable-5-2 na Claude Platform.
-
Nuvens: Disponível na Amazon Web Services, Google Cloud e Microsoft Azure.
-
Mythos 5.2: Inscreva-se pelos programas Cyber Verification ou Life Sciences Verification. Clientes do Claude Enterprise também podem usá-lo via Claude Security.
Empresas com requisitos rígidos de dados podem usar o Enterprise Frontier Safeguards, que executa o monitoramento de segurança da Anthropic em dados armazenados na própria infraestrutura do cliente e funciona com retenção zero de dados. Outros clientes têm retenção de dados de 30 dias para monitoramento de segurança.
Considerações finais
O Claude Fable 5.2 é um avanço significativo em relação ao Fable 5.1. É mais barato, mais rápido e menos propenso a recusar trabalho legítimo. Os saltos no Remote Labor Index, em robótica e no FrontierCode são especialmente grandes.
Dito isso, o Opus 5.5 continua sendo a melhor relação custo-benefício para a maioria das tarefas do dia a dia pela metade do preço. O mais interessante no Fable 5.2 pode ser a eficiência: se ele realmente iguala as melhores pontuações do Opus 5.5 com esforço baixo ou médio, o prêmio por token encolhe rápido. Vale testar nas suas próprias cargas.
Se você quer pôr a mão na massa com o Claude, nossa trilha Developing AI Applications é um ótimo ponto de partida.







Hoje, a Anthropic anunciou o Fable 5.2 para todos e o Mythos 5.2 para organizações verificadas. Eles usam o mesmo modelo base, mas a versão Fable traz salvaguardas extras de cibersegurança e biologia.
As mudanças de destaque são:
Mais especificamente, o Fable 5.2 custa 20% menos que o Fable 5.1, gera respostas até 30% mais rápido e supera o GPT-6 Astra e o Gemini 4 Carbon na maioria das linhas da tabela de benchmarks da Anthropic.
Neste artigo, vou cobrir o que há de novo no Fable 5.2 e no Mythos 5.2, como eles se saem nos benchmarks, quanto custam e como decidir se vale a pena escolhê-los em vez do Claude Opus 5.5.
O que é o Claude Fable 5.2?
O Claude Fable 5.2 é o modelo mais capaz da Anthropic disponível para uso geral. Ele foi feito para trabalhos técnicos longos e exigentes: migrações de grandes codebases, execuções de agentes por vários dias, problemas de pesquisa e projetos de engenharia.
O Fable 5.2 também pode trabalhar junto com modelos menores, seja como conselheiro para consultas em problemas difíceis ou como orquestrador que delega subtarefas simples para eles.
O Fable 5.2 mantém a janela de contexto de 1 milhão de tokens e o máximo de 128K tokens de saída do seu antecessor, e seu knowledge cutoff é junho de 2026.
O que é o Claude Mythos 5.2?
O Claude Mythos 5.2 é o mesmo modelo do Fable 5.2, mas sem as salvaguardas que bloqueiam a maior parte do trabalho de cibersegurança e a pesquisa em nível avançado de biologia. Na prática, o Mythos 5.2 é o modelo mais capaz da Anthropic para engenharia de segurança. Como essas capacidades têm uso dual, a Anthropic só oferece o Mythos 5.2 para organizações verificadas por meio do Cyber Verification Program e do Life Sciences Verification Program.
O que há de novo no Claude Fable 5.2?
O Fable existe só desde junho, quando a Anthropic lançou o Fable 5. Desde então, houve duas versões pontuais, o Fable 5.1 em setembro e agora o Fable 5.2, e nenhuma delas trouxe muitas funcionalidades inéditas. O foco foi tornar o modelo mais barato, rápido e potente, e os ganhos não foram pequenos: por exemplo, o Fable 5.2 mais do que dobrou a pontuação do Fable 5.1 no Remote Labor Index.
A maior diferença entre as duas versões está no que você tem permissão para fazer com o modelo. Com o Fable 5.1, a Anthropic afunilou as salvaguardas de cibersegurança e passou a permitir usar o modelo para encontrar vulnerabilidades de software, mas não para escrever exploits, e anunciou o Enterprise Frontier Safeguards, uma opção para manter seus dados na sua própria nuvem, junto com o lançamento. As mudanças de salvaguardas do Fable 5.2 são menores: ele bloqueia menos solicitações, mas os mesmos tipos de tarefas continuam proibidos.
Os novos jeitos sugeridos pela Anthropic de usá-lo, como fazer o Fable 5.2 aconselhar modelos Claude menores, também não são exatamente novos, já que a ferramenta advisor da Anthropic já suportava o Fable 5 e 5.1. E os demos de lançamento, como o sistema operacional construído a partir de uma pasta vazia, mostram um modelo mais forte fazendo tarefas mais difíceis, não recursos novos que você ativa com um botão.
Dito isso, se é para destacar novidades, eu citaria:
Preço mais baixo
O Fable 5.2 custa US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída, 20% menos que os US$ 10/US$ 50 do Fable 5.1. O mesmo corte de 20% vale para leituras de cache (US$ 0,20), gravações de cache e processamento em lote. Veja a seção de preços abaixo para o detalhamento completo.
Saída mais rápida e modo rápido para o Fable
A saída está até 30% mais rápida que no Fable 5.1, o que soma bastante em execuções longas de agentes. O Fable agora também tem fast mode, que acelera a saída em até 2,5x pelo dobro do preço (US$ 16/US$ 80).
Melhores resultados com menos esforço
Essa é a mudança com mais chances de impactar sua conta. No esforço alto, o Fable 5.2 faz 45,3% no FrontierCode 2.0, na mesma faixa do melhor do Opus 5.5, por cerca de metade do custo por tarefa. No esforço baixo, ele iguala a melhor pontuação do Opus 5.5 no Humanity's Last Exam por menos de um décimo do custo por tarefa. Minha leitura: se você vier do Opus 5.5, comece o Fable 5.2 em um nível de esforço menor.
Menos solicitações bloqueadas
O Fable 5.2 deve sofrer cerca de 55% menos bloqueios de segurança que o Fable 5.1 (cerca de 60% menos em cibersegurança e 40% menos em biologia). Isso faz diferença se as recusas do Fable 5.1 estavam no seu caminho, mas as categorias bloqueadas não mudaram: testes de intrusão, geração de exploits e a maior parte da biologia em nível de pesquisa continuam sendo repassados para modelos Claude mais antigos.
Como o Claude Fable 5.2 se sai nos benchmarks?
Aqui estão os principais resultados. Todos vêm da tabela de lançamento da Anthropic, então leia como o argumento da Anthropic a favor do modelo, não como resultados independentes. As pontuações do Claude foram rodadas com salvaguardas ligadas. Salvo indicação, cada modelo aparece no maior nível de esforço disponível.
Codificação com agentes
O Fable 5.2 lidera os dois benchmarks de código na tabela. No FrontierCode 2.0, que mede se mantenedores de open source fariam merge das mudanças de código do modelo, ele marca 49,1%, a maior pontuação na tabela e bem acima dos 32,4% do Fable 5.1. No FrontierSWE v2, faz 69,9%, à frente do GPT-6 Astra (65,5%) e do Opus 5.5 (62,3%).
Os exemplos do lançamento apontam na mesma direção: agentes rodando uma versão inicial do Fable 5.2 migraram um serviço em produção de Python para Rust, e agora ele inicia cerca de 26 vezes mais rápido.
Trabalho do conhecimento e pesquisa
O maior salto relativo está no Remote Labor Index, que mede como o modelo conclui projetos reais no estilo freelancer. O Fable 5.2 faz 41,3%, aproximadamente o dobro do Opus 5.5 (21,3%) e do GPT-6 Astra (20,8%). Ele também lidera no Humanity's Last Exam com ferramentas (74,2%) e no Terminal-Bench-Science (74,6%, ou 75,3% para o Mythos 5.2).
Automação de negócios é a única área em que ele fica atrás. No AutomationBench, o Gemini 4 Carbon marca 53,9% contra 51,4% do Fable 5.2, embora o Fable 5.2 ainda esteja muito à frente do Fable 5.1 (31,4%).
Fora da tabela principal, o Fable 5.2 marcou 83,5 no benchmark de engenharia de hardware BenchCAD 2.1, contra 65,3 do Opus 5.5. Ele também é creditado por resolver dois problemas em aberto em física de buracos negros, com resultados postados como preprints para revisão de outros físicos.
Uso de computador, robótica e visão
O Fable 5.2 faz 89,3% no OSWorld 2.1, à frente do Opus 5.5 (87,2%) e do GPT-6 Astra (79,5%). Seu salto em robótica é o maior da tabela: 64,9% no RoboDojo Sim, mais que o dobro do Fable 5.1 e do GPT-6 Astra. No Chartography, que testa leitura de gráficos sem ferramentas, ele supera por pouco o Gemini 4 Carbon e o GPT-6 Astra, depois de o Fable 5.1 ter ficado bem para trás com 44,8%.
Cibersegurança e biologia (Mythos 5.2)
As linhas de segurança e biologia são do Mythos 5.2, já que as salvaguardas do Fable 5.2 bloqueiam a maior parte dessas tarefas. O Mythos 5.2 faz 76,3% no CyScenarioBench (vs 61,7% do Mythos 5.1), 89,6% no CVE Rediscovery (vs 78,3%) e 85,1% em uma tarefa de design de protein binder de 24 horas (vs 79,1%). Não há comparação justa com o modelo de segurança da OpenAI aqui, já que cada laboratório executou suas próprias tarefas do CyScenarioBench.
O que é isso sobre o Último Teorema de Fermat?
Um time de agentes do Fable 5.2 formalizou a prova do Último Teorema de Fermat no assistente de provas Lean em 30 horas. Você pode estar pensando: o teorema não foi provado há três décadas? O que restava fazer?
O teorema em si não é novidade
O Último Teorema de Fermat diz que não existem números inteiros positivos a, b e c tais que an + bn = cn para qualquer n maior que 2. Para n = 2, há várias soluções, como 32 + 42 = 52 (9 + 16 = 25). Mas, com cubos, só aparecem quase-acertos: 63 + 83 = 728, um a menos que 93 = 729.
Pierre de Fermat afirmou ter uma prova em 1637, mas nunca a escreveu, e o problema ficou sem solução por mais de 350 anos, até Andrew Wiles prová-lo em meados dos anos 1990, com ajuda de Richard Taylor.
O que é uma formalização em Lean
A prova de Wiles tem mais de 100 páginas e se apoia em décadas de teoria dos números avançada, então pouquíssimas pessoas conseguem verificá-la de ponta a ponta. O Lean é um assistente de provas: uma linguagem de programação em que você escreve a prova como código, e o software verifica cada passo lógico até os axiomas básicos da matemática. Se a prova compila, ela está correta. “Formalizar” um teorema significa traduzir a prova humana para essa forma verificável por máquina.
No caso do Último Teorema de Fermat, é um trabalhão, porque boa parte da matemática de suporte nunca tinha sido escrita em Lean. O matemático Kevin Buzzard iniciou um projeto comunitário para isso em 2024.
Por que isso é interessante para um modelo de IA
A maior parte das saídas de IA é julgada por pessoas ou por benchmarks que testam só uma parte da resposta. Uma prova em Lean é diferente: o verificador aceita cada passo ou não, então não há como errar “sutilmente”. Isso a torna um teste incomumente limpo de se o modelo consegue levar um projeto muito longo e difícil até uma conclusão verificada.
Não é a primeira vez que o Claude faz isso. Em setembro, a Anthropic publicou a primeira prova completa verificada por computador do teorema, escrita por dezenas de agentes rodando um modelo interno de pesquisa aproximadamente comparável ao Fable 5.1. Aquela empreitada levou 11 dias e cerca de seis bilhões de tokens de saída, produziu 13 milhões de linhas de Lean e se apoiou em partes do projeto do Buzzard. O Fable 5.2 fez em 30 horas, com ajuda humana mínima.
Os poréns
A parte mais reveladora, porém, é o que aconteceu quando a Anthropic deu ao Claude Opus 5.5 o mesmo trabalho.
Claude Fable 5.2 vs. Claude Opus 5.5
Comparar dois modelos geralmente significa ler pontuações de benchmark e tentar inferir como isso se traduz na prática. Desta vez, é útil que a Anthropic tenha começado com uma história, que deixa a diferença mais evidente.
No mesmo setup de Lean com 1.000 agentes, o Opus 5.5 concluiu 26% da prova do Último Teorema de Fermat em 18 horas e mal avançou depois disso. O Fable 5.2 terminou tudo em 30 horas. Conclusão: em projetos muito longos e multiagente, o Opus 5.5 pode travar onde o Fable 5.2 continua.
Em tarefas mais curtas, a diferença é menor. Veja a comparação lado a lado:
O padrão combina com o resultado no Lean. Em uso de computador e código, o Fable 5.2 está apenas alguns pontos à frente. Em trabalho aberto e de múltiplas etapas, a vantagem cresce: o Fable 5.2 quase dobra a pontuação do Opus 5.5 nos projetos estilo freelancer do Remote Labor Index e fica 25 pontos à frente no controle de robôs.
O preço pesa menos do que parece. O Fable 5.2 custa o dobro por token, mas muitas vezes alcança a melhor pontuação do Opus 5.5 com um nível de esforço menor, usando menos tokens. No FrontierCode 2.0, por exemplo, o Fable 5.2 no esforço alto chega perto do melhor do Opus 5.5 por cerca de metade do custo por tarefa.
Então o Opus 5.5 ainda é o padrão sensato para o dia a dia. Mas se uma tarefa roda por horas, envolve muitos agentes ou vive empacando no Opus, o Fable 5.2 tende a concluir — e pode não sair tão mais caro quanto o preço por token sugere.
Segurança e limites
A Anthropic classifica como baixo o risco de comportamento inseguro desses modelos em situações críticas.
Isso é difícil de verificar de fora, então os números mais concretos ajudam. Em uma auditoria comportamental automatizada com cerca de 1.900 cenários, o Mythos 5.2 teve a menor pontuação de comportamento desalinhado entre os modelos comparados. Ele também foi menos propenso a alucinar entradas, afirmar falsamente que uma tarefa foi concluída ou esconder trabalho ruim.
Outros pontos interessantes que valem conhecer e fazem pensar:
Qual modelo Claude você deve usar?
Meu conselho é o mesmo da Anthropic: comece com o Opus 5.5 e suba só quando precisar. A linha fica assim:
Preços e disponibilidade do Claude Fable 5.2
Tínhamos acabado de ver uma tabela com resultados de benchmark mostrando o Fable 5.2 superando o Fable 5.1 em tudo. Agora, mostro uma tabela em que o Fable 5.2 é mais barato que o 5.1. Então, o Fable 5.1 ficou obsoleto?
Para trabalhos novos, na prática, sim. Se você tem acesso ao Fable 5.2, há pouca razão para começar algo novo no 5.1. A Anthropic não anunciou uma data de aposentadoria, porém, e times com prompts ou agentes ajustados no Fable 5.1 vão querer testar o 5.2 antes de migrar. Sabemos que uma nova versão pode se comportar de forma diferente mesmo quando marca melhor.
Como obter acesso ao Claude Fable 5.2
Apps do Claude: O Fable 5.2 está disponível em planos pagos elegíveis. Como promoção de lançamento, planos Pro e assentos padrão de Team podem usar o Fable em até 50% de seus limites semanais, e planos que incluem o Fable ganham de um a três resets de uso, dependendo da duração da assinatura.
API: Use o ID de modelo
claude-fable-5-2na Claude Platform.Nuvens: Disponível na Amazon Web Services, Google Cloud e Microsoft Azure.
Mythos 5.2: Inscreva-se pelos programas Cyber Verification ou Life Sciences Verification. Clientes do Claude Enterprise também podem usá-lo via Claude Security.
Empresas com requisitos rígidos de dados podem usar o Enterprise Frontier Safeguards, que executa o monitoramento de segurança da Anthropic em dados armazenados na própria infraestrutura do cliente e funciona com retenção zero de dados. Outros clientes têm retenção de dados de 30 dias para monitoramento de segurança.
Considerações finais
O Claude Fable 5.2 é um avanço significativo em relação ao Fable 5.1. É mais barato, mais rápido e menos propenso a recusar trabalho legítimo. Os saltos no Remote Labor Index, em robótica e no FrontierCode são especialmente grandes.
Dito isso, o Opus 5.5 continua sendo a melhor relação custo-benefício para a maioria das tarefas do dia a dia pela metade do preço. O mais interessante no Fable 5.2 pode ser a eficiência: se ele realmente iguala as melhores pontuações do Opus 5.5 com esforço baixo ou médio, o prêmio por token encolhe rápido. Vale testar nas suas próprias cargas.
Se você quer pôr a mão na massa com o Claude, nossa trilha Developing AI Applications é um ótimo ponto de partida.