Hôm nay, Anthropic công bố Fable 5.2 cho tất cả mọi người và Mythos 5.2 cho các tổ chức đã được thẩm định. Chúng là cùng một mô hình nền tảng, nhưng phiên bản Fable có thêm các biện pháp bảo vệ về an ninh mạng và sinh học.
Những thay đổi nổi bật là:
- giá thấp hơn,
- tốc độ xuất đầu ra nhanh hơn, và
- nhảy vọt trên các benchmark khó nhất của Anthropic.
Cụ thể hơn, Fable 5.2 rẻ hơn 20% so với Fable 5.1, tạo đầu ra nhanh hơn đến 30%, và vượt GPT-6 Astra cùng Gemini 4 Carbon ở phần lớn hạng mục trong bảng benchmark của Anthropic.
Trong bài viết này, tôi sẽ điểm qua những điểm mới ở Fable 5.2 và Mythos 5.2, cách chúng thể hiện trên các benchmark, chi phí, và cách quyết định liệu bạn có cần chúng thay vì Claude Opus 5.5 hay không.
Claude Fable 5.2 là gì?
Claude Fable 5.2 là mô hình mạnh nhất và sẵn sàng cho số đông của Anthropic. Nó được xây dựng cho công việc kỹ thuật dài hơi, đòi hỏi cao: chuyển đổi các codebase lớn, các phiên agent chạy nhiều ngày, bài toán nghiên cứu, và thiết kế kỹ thuật.
Fable 5.2 cũng có thể làm việc song song với các mô hình nhỏ hơn, hoặc như một cố vấn để họ tham khảo khi gặp vấn đề khó, hoặc như một bộ điều phối giao các tác vụ đơn giản hơn xuống cho chúng.
Fable 5.2 giữ nguyên cửa sổ ngữ cảnh 1 triệu token và tối đa đầu ra 128K như phiên bản tiền nhiệm, và mốc kiến thức là tháng 6 năm 2026.
Claude Mythos 5.2 là gì?
Claude Mythos 5.2 là cùng mô hình với Fable 5.2 nhưng không có các biện pháp bảo vệ chặn phần lớn công việc an ninh mạng và nghiên cứu sinh học trình độ cao. Thực tế, Mythos 5.2 là mô hình mạnh nhất của Anthropic cho kỹ thuật an ninh mạng. Vì các năng lực này có tính lưỡng dụng, Anthropic chỉ cung cấp Mythos 5.2 cho các tổ chức đã được thẩm định thông qua Chương trình Xác minh An ninh mạng và Chương trình Xác minh Khoa học Đời sống.
Có gì mới trong Claude Fable 5.2?
Fable mới chỉ xuất hiện từ tháng 6, khi Anthropic phát hành Fable 5. Từ đó đến nay có hai bản cập nhật nhỏ, Fable 5.1 vào tháng 9 và nay là Fable 5.2, và cả hai đều không thêm nhiều tính năng mới. Chủ yếu chúng khiến mô hình rẻ hơn, nhanh hơn, và mạnh hơn, dù mức cải thiện không hề nhỏ: chẳng hạn Fable 5.2 hơn gấp đôi điểm Remote Labor Index của Fable 5.1.
Điểm khác biệt lớn hơn giữa hai bản là ở phạm vi sử dụng được phép. Với Fable 5.1, Anthropic thu hẹp các biện pháp bảo vệ an ninh mạng và bắt đầu cho phép mô hình được dùng để tìm lỗ hổng phần mềm, dù không được viết exploit, và cùng lúc công bố Enterprise Frontier Safeguards, một tùy chọn lưu dữ liệu trong đám mây của chính bạn. Các thay đổi về bảo vệ của Fable 5.2 nhỏ hơn: nó chặn ít yêu cầu hơn, nhưng các loại tác vụ bị cấm vẫn như cũ.
Các cách dùng mới mà Anthropic gợi ý, như để Fable 5.2 cố vấn cho các mô hình Claude nhỏ hơn, cũng không hẳn là mới, vì công cụ advisor của Anthropic vốn đã hỗ trợ Fable 5 và 5.1. Và các bản demo ra mắt, như hệ điều hành được xây từ thư mục trống, cho thấy mô hình mạnh hơn làm được việc khó hơn, chứ không phải tính năng mới mà bạn có thể bật lên.
Dù vậy, nếu phải chỉ ra điểm mới, tôi sẽ nhắc đến những điều sau:
Giá thấp hơn
Fable 5.2 có giá $8 cho mỗi triệu token đầu vào và $40 cho mỗi triệu token đầu ra, rẻ hơn 20% so với mức $10/$50 của Fable 5.1. Mức cắt giảm 20% tương tự áp dụng cho đọc bộ nhớ đệm ($0,20), ghi bộ nhớ đệm, và xử lý theo lô. Xem phần giá bên dưới để biết chi tiết đầy đủ.
Đầu ra nhanh hơn, và chế độ nhanh cho Fable
Tốc độ đầu ra nhanh hơn đến 30% so với Fable 5.1, điều này cộng dồn đáng kể trong các phiên agent dài. Fable cũng hỗ trợ chế độ nhanh, tăng tốc đầu ra tới 2,5 lần với mức giá gấp đôi ($16/$80).
Kết quả tốt hơn với nỗ lực thấp hơn
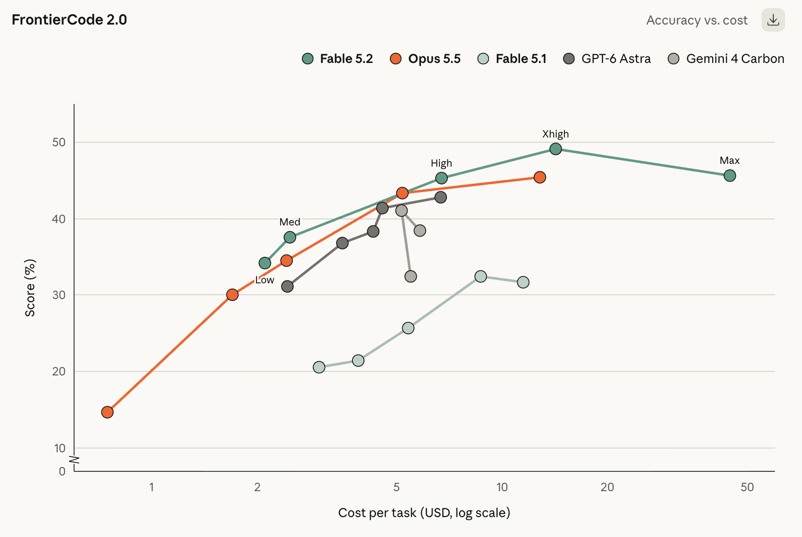
Đây là thay đổi có khả năng ảnh hưởng đến hóa đơn của bạn nhiều nhất. Ở mức nỗ lực cao, Fable 5.2 đạt 45,3% trên FrontierCode 2.0, xấp xỉ điểm tốt nhất của Opus 5.5, với chi phí mỗi tác vụ khoảng bằng một nửa. Ở mức nỗ lực thấp, nó đạt điểm cao nhất của Opus 5.5 trên Humanity's Last Exam với chi phí mỗi tác vụ chưa tới một phần mười. Theo tôi: Nếu bạn chuyển lên từ Opus 5.5, hãy bắt đầu Fable 5.2 ở mức nỗ lực thấp hơn.
Ít yêu cầu bị chặn hơn
Fable 5.2 sẽ gặp khoảng ít hơn 55% lần chặn an toàn so với Fable 5.1 (ít hơn khoảng 60% trong an ninh mạng và 40% trong sinh học). Điều này rất đáng chú ý nếu các từ chối của Fable 5.1 từng cản trở bạn, nhưng các loại tác vụ bị chặn không thay đổi: kiểm thử xâm nhập, tạo exploit, và phần lớn công việc sinh học trình độ nghiên cứu vẫn bị chuyển cho các mô hình Claude cũ hơn.
Claude Fable 5.2 thể hiện như thế nào trên các benchmark?
Dưới đây là các kết quả chính. Chúng đều từ bảng công bố khi ra mắt của Anthropic, nên hãy xem chúng như luận điểm của Anthropic cho mô hình này hơn là kết quả độc lập. Điểm số của Claude được chạy với các biện pháp bảo vệ bật. Trừ khi có ghi chú, mỗi mô hình được hiển thị ở mức nỗ lực cao nhất sẵn có.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (lập trình theo tác nhân) | 49,1% | 32,4% | 45,5% | 42,8% | 41,1% |
| FrontierSWE v2 (lập trình theo tác nhân) | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench (quy trình nghiệp vụ) | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Terminal-Bench-Science 0.1 | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| OSWorld 2.1 (sử dụng máy tính) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| RoboDojo Sim (robotics) | 64,9% | 27,6% | 39,4% | 29,8% | Không báo cáo |
| AA-Briefcase v1.1 (công việc tri thức) | 66,1% | 61,5% | 61,2% | 52,0% | 61,8% |
| Remote Labor Index (công việc tri thức) | 41,3% | 17,9% | 21,3% | 20,8% | Không báo cáo |
| Humanity's Last Exam (có công cụ) | 74,2% | 65,6% | 67,7% | 57,2% | Không báo cáo |
| WANDR (tìm kiếm theo tác nhân) | 82,1% | 68,7% | 72,3% | Không báo cáo | Không báo cáo |
| Chartography (không công cụ) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
Lập trình theo tác nhân
Fable 5.2 dẫn đầu cả hai benchmark lập trình trong bảng. Trên FrontierCode 2.0, đo lường việc người bảo trì mã nguồn mở có chấp nhận hợp nhất thay đổi mã của mô hình hay không, nó đạt 49,1%, cao nhất bảng và vượt xa 32,4% của Fable 5.1. Trên FrontierSWE v2, nó đạt 69,9%, vượt GPT-6 Astra (65,5%) và Opus 5.5 (62,3%).
Các ví dụ khi ra mắt cũng cho thấy điều tương tự: các agent chạy phiên bản đầu của Fable 5.2 đã chuyển một dịch vụ sản xuất từ Python sang Rust, và giờ nó khởi động nhanh hơn khoảng 26 lần.
Công việc tri thức và nghiên cứu
Mức tăng tương đối lớn nhất là ở Remote Labor Index, đo lường khả năng hoàn thành các dự án kiểu freelancer thực tế. Fable 5.2 đạt 41,3%, xấp xỉ gấp đôi Opus 5.5 (21,3%) và GPT-6 Astra (20,8%). Nó cũng dẫn đầu ở Humanity's Last Exam với công cụ (74,2%) và Terminal-Bench-Science (74,6%, hoặc 75,3% với Mythos 5.2).
Tự động hóa kinh doanh là mảng duy nhất nó tụt lại. Ở AutomationBench, Gemini 4 Carbon đạt 53,9% so với 51,4% của Fable 5.2, dù Fable 5.2 vẫn vượt xa Fable 5.1 (31,4%).
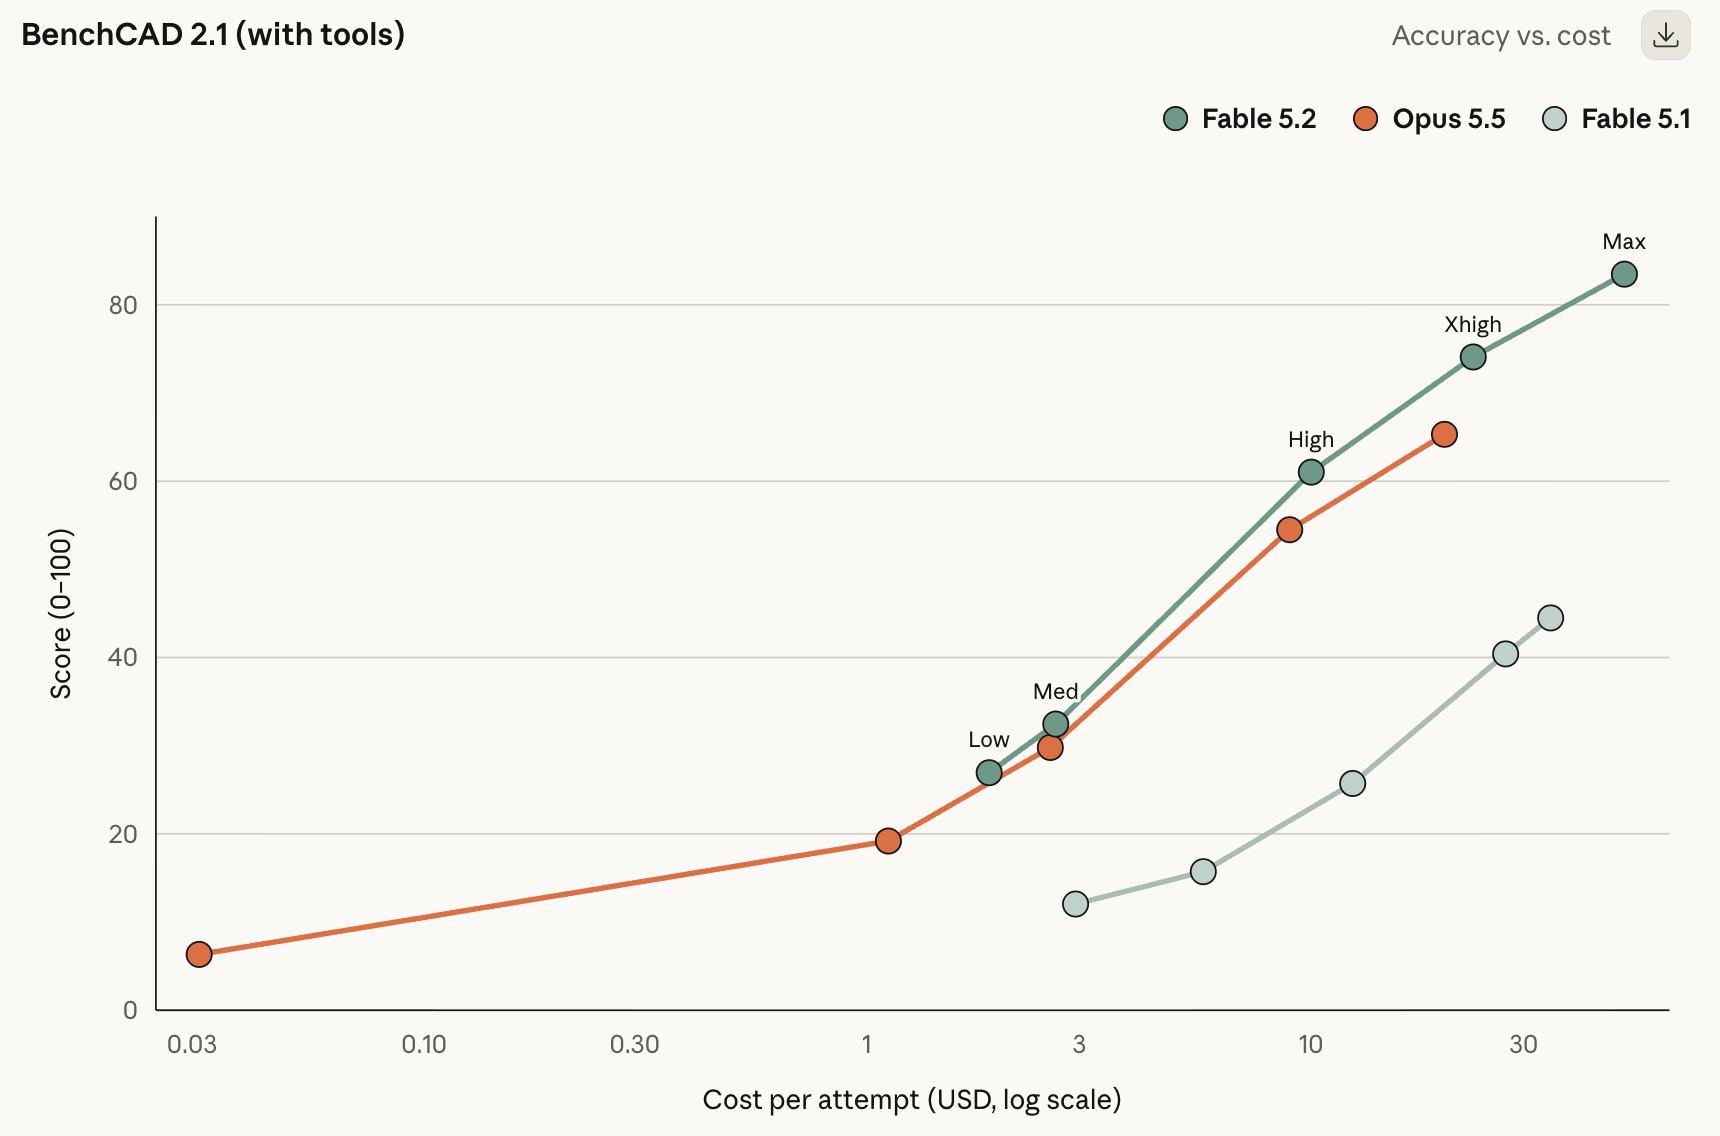
Ngoài bảng chính, Fable 5.2 đạt 83,5 trên benchmark kỹ thuật phần cứng BenchCAD 2.1, so với 65,3 của Opus 5.5. Nó cũng được ghi nhận là giải được hai bài toán mở trong vật lý lỗ đen, và các kết quả đó đã được đăng dạng preprint để các nhà vật lý khác kiểm chứng.
Sử dụng máy tính, robotics, và thị giác
Fable 5.2 đạt 89,3% trên OSWorld 2.1, vượt Opus 5.5 (87,2%) và GPT-6 Astra (79,5%). Mức nhảy vọt về robotics là lớn nhất trong bảng: 64,9% trên RoboDojo Sim, hơn gấp đôi Fable 5.1 và GPT-6 Astra. Trên Chartography, kiểm tra đọc biểu đồ không dùng công cụ, nó nhỉnh hơn Gemini 4 Carbon và GPT-6 Astra, sau khi Fable 5.1 từng tụt khá xa ở mức 44,8%.
An ninh mạng và sinh học (Mythos 5.2)
Các dòng về an ninh và sinh học là dành cho Mythos 5.2, vì biện pháp bảo vệ của Fable 5.2 chặn phần lớn tác vụ này. Mythos 5.2 đạt 76,3% trên CyScenarioBench (so với 61,7% của Mythos 5.1), 89,6% trên CVE Rediscovery (so với 78,3%), và 85,1% trên bài toán thiết kế protein binder trong 24 giờ (so với 79,1%). Không có so sánh công bằng với mô hình an ninh của OpenAI ở đây, vì mỗi phòng lab chạy bộ tác vụ CyScenarioBench riêng.
Chuyện gì với Định lý cuối cùng của Fermat?
Một nhóm agent Fable 5.2 đã hình thức hóa (formalize) chứng minh Định lý cuối cùng của Fermat trong trình trợ lý chứng minh Lean trong 30 giờ. Bạn có thể thắc mắc: chẳng phải định lý đã được chứng minh ba thập kỷ trước rồi sao, còn gì để làm?
Định lý này đã là chuyện cũ
Định lý cuối cùng của Fermat nói rằng không tồn tại các số nguyên dương a, b, và c sao cho an + bn = cn với mọi n lớn hơn 2. Với n = 2 thì có rất nhiều nghiệm, như 32 + 42 = 52 (9 + 16 = 25). Nhưng thử với lập phương thì chỉ có những trường hợp suýt đúng: 63 + 83 = 728, thiếu 1 so với 93 = 729.
Pierre de Fermat khẳng định có một chứng minh vào năm 1637 nhưng không bao giờ viết ra, và bài toán này treo hơn 350 năm cho đến khi Andrew Wiles chứng minh được vào giữa thập niên 1990, với sự hỗ trợ của Richard Taylor.
Hình thức hóa bằng Lean là gì
Chứng minh của Wiles dài hơn 100 trang và dựa trên hàng thập kỷ lý thuyết số cao cấp, nên rất ít người có thể kiểm tra trọn vẹn từ đầu đến cuối. Lean là một trình trợ lý chứng minh: một ngôn ngữ lập trình mà trong đó bạn viết chứng minh như mã, và phần mềm sẽ kiểm tra mọi bước logic đến tận các tiên đề cơ bản của toán học. Nếu chứng minh biên dịch được, nó là đúng. “Hình thức hóa” một định lý nghĩa là chuyển chứng minh do con người viết sang dạng có thể kiểm tra bằng máy này.
Với Định lý cuối cùng của Fermat, đó là một khối lượng công việc khổng lồ, vì nhiều phần toán học mà chứng minh dựa vào chưa từng được viết trong Lean. Nhà toán học Kevin Buzzard đã khởi động một dự án cộng đồng để làm việc này vào năm 2024.
Tại sao điều này thú vị với một mô hình AI
Phần lớn đầu ra của AI được con người đánh giá hoặc bởi các benchmark chỉ kiểm tra một phần câu trả lời. Chứng minh Lean thì khác: bộ kiểm tra hoặc chấp nhận mọi bước hoặc không, nên không có chỗ cho sai lệch tinh vi. Điều đó khiến nó trở thành một phép thử đặc biệt “sạch” về việc liệu mô hình có thể theo đuổi một dự án rất dài, rất khó đến đích đã được kiểm chứng hay không.
Đây không phải lần đầu Claude làm được điều này. Vào tháng 9, Anthropic công bố chứng minh đầu tiên hoàn chỉnh được máy tính kiểm tra cho định lý này, do hàng chục agent chạy một mô hình nghiên cứu nội bộ xấp xỉ Fable 5.1 viết. Nỗ lực đó mất 11 ngày và khoảng sáu tỷ token đầu ra, tạo ra 13 triệu dòng Lean, và một phần dựa trên các mảnh ghép từ dự án của Buzzard. Fable 5.2 làm được trong 30 giờ, với hỗ trợ tối thiểu của con người.
Các lưu ý
- Nó không bổ sung gì cho toán học. Buzzard cũng đã nói như vậy về lần hình thức hóa đầu tiên của Anthropic.
- Fable 5.2 được cung cấp danh sách các mệnh đề định lý trung gian để theo dõi tiến độ. Đó là lộ trình về cái gì cần chứng minh, dù không phải cách chứng minh.
- Tôi chưa thấy bất kỳ đánh giá độc lập nào về chứng minh mới, nên hiện tại, con số 30 giờ và so sánh với Opus 5.5 là tuyên bố từ Anthropic.
Điều đáng chú ý nhất, tuy nhiên, là những gì xảy ra khi Anthropic giao cùng công việc đó cho Claude Opus 5.5.
Claude Fable 5.2 so với Claude Opus 5.5
So sánh hai mô hình thường là đọc điểm benchmark và cố suy ra khác biệt sẽ trông thế nào trong thực tế. Lần này, tôi đánh giá cao việc Anthropic dẫn bằng một câu chuyện, khiến khoảng cách trở nên rõ ràng hơn.
Trong cùng thiết lập Lean với 1.000 agent, Opus 5.5 hoàn thành 26% chứng minh Định lý cuối cùng của Fermat trong 18 giờ và hầu như không tiến triển sau đó. Fable 5.2 hoàn thành toàn bộ trong 30 giờ. Kết luận: với các dự án rất dài, nhiều tác nhân, Opus 5.5 có thể bị chững lại nơi Fable 5.2 vẫn tiếp tục.
Với các tác vụ ngắn hơn, khoảng cách nhỏ hơn. Đây là so sánh trực tiếp giữa hai mô hình:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| Giá (đầu vào / đầu ra mỗi 1M token) | $8 / $40 | $4 / $20 |
| Cửa sổ ngữ cảnh / đầu ra tối đa | 1M / 128K | 1M / 128K |
| FrontierCode 2.0 (lập trình theo tác nhân) | 49,1% | 45,5% |
| FrontierSWE v2 (lập trình theo tác nhân) | 69,9% | 62,3% |
| OSWorld 2.1 (sử dụng máy tính) | 89,3% | 87,2% |
| AutomationBench (quy trình nghiệp vụ) | 51,4% | 42,5% |
| Humanity's Last Exam (có công cụ) | 74,2% | 67,7% |
| Remote Labor Index (công việc tri thức) | 41,3% | 21,3% |
| RoboDojo Sim (robotics) | 64,9% | 39,4% |
Mẫu số chung khớp với kết quả Lean. Ở sử dụng máy tính và lập trình, Fable 5.2 chỉ nhỉnh hơn vài điểm. Ở công việc mở, nhiều bước, khoảng cách tăng: Fable 5.2 gần như gấp đôi điểm Opus 5.5 trên các dự án kiểu freelancer trong Remote Labor Index, và hơn 25 điểm ở điều khiển robot.
Giá cả ít chênh hơn nhìn bề ngoài. Fable 5.2 đắt gấp đôi mỗi token, nhưng thường có thể đạt điểm tốt nhất của Opus 5.5 ở mức nỗ lực thấp hơn, dùng ít token hơn. Trên FrontierCode 2.0, chẳng hạn, Fable 5.2 ở nỗ lực cao xấp xỉ điểm tốt nhất của Opus 5.5 với khoảng nửa chi phí mỗi tác vụ.
Vì vậy Opus 5.5 vẫn là lựa chọn mặc định hợp lý. Nhưng nếu một tác vụ chạy hàng giờ, có nhiều agent, hoặc thường xuyên bị chững lại trên Opus, Fable 5.2 nhiều khả năng sẽ hoàn thành, và chi phí có thể không cao như mức giá theo token gợi ý.
An toàn và giới hạn
Anthropic đánh giá rủi ro các mô hình này hành xử không an toàn trong bối cảnh rủi ro cao là thấp.
Điều đó khó kiểm chứng từ bên ngoài, nên các con số cụ thể sẽ hữu ích hơn. Trên một bài kiểm toán hành vi tự động với khoảng 1.900 kịch bản, Mythos 5.2 có điểm hành vi sai lệch thấp nhất trong các mô hình so sánh. Nó cũng ít có khả năng bịa đầu vào, tuyên bố sai là đã hoàn thành tác vụ, hoặc che giấu công việc kém chất lượng.
Có vài điểm thú vị khác đáng biết và sẽ khiến bạn phải suy ngẫm:
- Nhận biết bị đánh giá: Cả Fable 5.2 và Mythos 5.2 đều nói rằng chúng nghi ngờ mình đang bị kiểm tra thường xuyên hơn so với các mô hình trước, điều này khiến các đánh giá như trên khó tin cậy hơn.
- Cố ý giới hạn kỹ năng nghiên cứu AI: Anthropic đã giới hạn mức tăng của mô hình ở hai mảng, tối ưu hóa kernel cho bộ tăng tốc và cải thiện kiến trúc LLM, để chúng thể hiện xấp xỉ mức của Opus 5.5.
- Bảo vệ chống chưng cất: Fable 5.2 có các biện pháp chống chưng cất mạnh nhất của Anthropic đến nay, và “preserved thinking” (bảo toàn lập luận), vốn ngăn người dùng API chỉnh sửa ngữ cảnh trước đó để trích xuất lý luận của mô hình, nay áp dụng cho tất cả tài khoản.
Nên dùng mô hình Claude nào?
Lời khuyên của tôi trùng với Anthropic: bắt đầu với Opus 5.5 và chỉ nâng cấp khi cần. Tổng quan đội hình như sau:
- Claude Opus 5.5 ($4/$20): Mặc định cho hầu hết công việc lập trình, nghiên cứu, và công việc tri thức. Giá bằng một nửa Fable 5.2 tính theo token và chỉ kém chút ít ở nhiều benchmark.
- Claude Fable 5.2 ($8/$40): Dành cho các bài toán khó nhất, các phiên nhiều tác nhân kéo dài, và những tác vụ mà Opus 5.5 bị chững lại, như các đợt chuyển đổi lớn, suy luận ở mức nghiên cứu, hoặc thiết kế phần cứng. Hãy thử ở mức nỗ lực thấp trước khi mặc định dùng mức tối đa.
- Claude Mythos 5.2: Dành cho các đội an ninh mạng và nhà nghiên cứu khoa học đời sống đã được thẩm định, những người cần các năng lực bị chặn bởi biện pháp bảo vệ của Fable 5.2.
- Claude Sonnet 5.5 và Haiku 5.5: Dành cho khối lượng lớn, tác vụ đơn giản hơn hoặc nhạy về độ trễ, hoặc làm các mô hình nhỏ để Fable 5.2 điều phối.
Giá và khả dụng của Claude Fable 5.2
| Trên mỗi 1M token | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Đầu vào | $8 | $10 | $4 |
| Đầu ra | $40 | $50 | $20 |
| Đọc bộ nhớ đệm | $0,20 | $0,25 | $0,20 |
| Ghi bộ nhớ đệm 5 phút | $10 | $12,50 | $5 |
| Xử lý theo lô (đầu vào / đầu ra) | $4 / $20 | $5 / $25 | $2 / $10 |
| Chế độ nhanh (đầu vào / đầu ra) | $16 / $80 | Không liệt kê | $8 / $40 |
Chúng ta vừa xem một bảng kết quả benchmark cho thấy Fable 5.2 vượt Fable 5.1 ở mọi hạng mục được liệt kê. Giờ, tôi cho bạn xem một bảng cho thấy Fable 5.2 rẻ hơn 5.1. Vậy Fable 5.1 đã lỗi thời?
Với công việc mới, về cơ bản là đúng. Nếu bạn có quyền dùng Fable 5.2, hầu như không có lý do để bắt đầu việc mới trên 5.1. Tuy nhiên, Anthropic chưa công bố ngày ngừng hỗ trợ, và các nhóm có prompt hoặc agent tinh chỉnh trên Fable 5.1 sẽ muốn thử 5.2 trước khi chuyển. Chúng ta biết rằng một phiên bản mới có thể hành xử khác dù điểm số tốt hơn.
Cách truy cập Claude Fable 5.2
-
Ứng dụng Claude: Fable 5.2 có sẵn trên các gói trả phí đủ điều kiện. Như một ưu đãi ra mắt, gói Pro và các ghế Team tiêu chuẩn có thể dùng Fable tới 50% hạn mức sử dụng hàng tuần, và các gói bao gồm Fable sẽ nhận 1 đến 3 lần đặt lại hạn mức tùy thời hạn đăng ký.
-
API: Dùng ID mô hình claude-fable-5-2 trên Claude Platform.
-
Nền tảng đám mây: Có sẵn trên Amazon Web Services, Google Cloud, và Microsoft Azure.
-
Mythos 5.2: Nộp đơn qua Chương trình Xác minh An ninh mạng hoặc Chương trình Xác minh Khoa học Đời sống. Khách hàng Claude Enterprise cũng có thể dùng qua Claude Security.
Các doanh nghiệp có yêu cầu nghiêm ngặt về dữ liệu có thể dùng Enterprise Frontier Safeguards, cho phép chạy giám sát an toàn của Anthropic trên dữ liệu lưu trong hạ tầng của chính khách hàng và hoạt động với chế độ không lưu dữ liệu. Khách hàng khác có thời hạn lưu dữ liệu 30 ngày cho mục đích giám sát an toàn.
Kết luận
Claude Fable 5.2 là một bước tiến đáng kể so với Fable 5.1. Nó rẻ hơn, nhanh hơn, ít từ chối công việc hợp lệ hơn. Các bước nhảy ở Remote Labor Index, robotics, và FrontierCode đặc biệt lớn.
Tuy vậy, Opus 5.5 vẫn là lựa chọn đáng giá hơn cho hầu hết công việc thường ngày với mức giá bằng một nửa. Điểm thú vị nhất về Fable 5.2 có thể là các tuyên bố về hiệu suất chi phí: nếu nó thực sự đạt các điểm tốt nhất của Opus 5.5 ở mức nỗ lực thấp hoặc trung bình, chênh lệch giá theo token sẽ nhanh chóng thu hẹp. Điều đó đáng để bạn thử trên khối lượng công việc của riêng mình.
Nếu bạn muốn trực tiếp trải nghiệm Claude, lộ trình Phát triển Ứng dụng AI của chúng tôi là một điểm khởi đầu tốt.


Hôm nay, Anthropic công bố Fable 5.2 cho tất cả mọi người và Mythos 5.2 cho các tổ chức đã được thẩm định. Chúng là cùng một mô hình nền tảng, nhưng phiên bản Fable có thêm các biện pháp bảo vệ về an ninh mạng và sinh học.
Những thay đổi nổi bật là:
Cụ thể hơn, Fable 5.2 rẻ hơn 20% so với Fable 5.1, tạo đầu ra nhanh hơn đến 30%, và vượt GPT-6 Astra cùng Gemini 4 Carbon ở phần lớn hạng mục trong bảng benchmark của Anthropic.
Trong bài viết này, tôi sẽ điểm qua những điểm mới ở Fable 5.2 và Mythos 5.2, cách chúng thể hiện trên các benchmark, chi phí, và cách quyết định liệu bạn có cần chúng thay vì Claude Opus 5.5 hay không.
Claude Fable 5.2 là gì?
Claude Fable 5.2 là mô hình mạnh nhất và sẵn sàng cho số đông của Anthropic. Nó được xây dựng cho công việc kỹ thuật dài hơi, đòi hỏi cao: chuyển đổi các codebase lớn, các phiên agent chạy nhiều ngày, bài toán nghiên cứu, và thiết kế kỹ thuật.
Fable 5.2 cũng có thể làm việc song song với các mô hình nhỏ hơn, hoặc như một cố vấn để họ tham khảo khi gặp vấn đề khó, hoặc như một bộ điều phối giao các tác vụ đơn giản hơn xuống cho chúng.
Fable 5.2 giữ nguyên cửa sổ ngữ cảnh 1 triệu token và tối đa đầu ra 128K như phiên bản tiền nhiệm, và mốc kiến thức là tháng 6 năm 2026.
Claude Mythos 5.2 là gì?
Claude Mythos 5.2 là cùng mô hình với Fable 5.2 nhưng không có các biện pháp bảo vệ chặn phần lớn công việc an ninh mạng và nghiên cứu sinh học trình độ cao. Thực tế, Mythos 5.2 là mô hình mạnh nhất của Anthropic cho kỹ thuật an ninh mạng. Vì các năng lực này có tính lưỡng dụng, Anthropic chỉ cung cấp Mythos 5.2 cho các tổ chức đã được thẩm định thông qua Chương trình Xác minh An ninh mạng và Chương trình Xác minh Khoa học Đời sống.
Có gì mới trong Claude Fable 5.2?
Fable mới chỉ xuất hiện từ tháng 6, khi Anthropic phát hành Fable 5. Từ đó đến nay có hai bản cập nhật nhỏ, Fable 5.1 vào tháng 9 và nay là Fable 5.2, và cả hai đều không thêm nhiều tính năng mới. Chủ yếu chúng khiến mô hình rẻ hơn, nhanh hơn, và mạnh hơn, dù mức cải thiện không hề nhỏ: chẳng hạn Fable 5.2 hơn gấp đôi điểm Remote Labor Index của Fable 5.1.
Điểm khác biệt lớn hơn giữa hai bản là ở phạm vi sử dụng được phép. Với Fable 5.1, Anthropic thu hẹp các biện pháp bảo vệ an ninh mạng và bắt đầu cho phép mô hình được dùng để tìm lỗ hổng phần mềm, dù không được viết exploit, và cùng lúc công bố Enterprise Frontier Safeguards, một tùy chọn lưu dữ liệu trong đám mây của chính bạn. Các thay đổi về bảo vệ của Fable 5.2 nhỏ hơn: nó chặn ít yêu cầu hơn, nhưng các loại tác vụ bị cấm vẫn như cũ.
Các cách dùng mới mà Anthropic gợi ý, như để Fable 5.2 cố vấn cho các mô hình Claude nhỏ hơn, cũng không hẳn là mới, vì công cụ advisor của Anthropic vốn đã hỗ trợ Fable 5 và 5.1. Và các bản demo ra mắt, như hệ điều hành được xây từ thư mục trống, cho thấy mô hình mạnh hơn làm được việc khó hơn, chứ không phải tính năng mới mà bạn có thể bật lên.
Dù vậy, nếu phải chỉ ra điểm mới, tôi sẽ nhắc đến những điều sau:
Giá thấp hơn
Fable 5.2 có giá $8 cho mỗi triệu token đầu vào và $40 cho mỗi triệu token đầu ra, rẻ hơn 20% so với mức $10/$50 của Fable 5.1. Mức cắt giảm 20% tương tự áp dụng cho đọc bộ nhớ đệm ($0,20), ghi bộ nhớ đệm, và xử lý theo lô. Xem phần giá bên dưới để biết chi tiết đầy đủ.
Đầu ra nhanh hơn, và chế độ nhanh cho Fable
Tốc độ đầu ra nhanh hơn đến 30% so với Fable 5.1, điều này cộng dồn đáng kể trong các phiên agent dài. Fable cũng hỗ trợ chế độ nhanh, tăng tốc đầu ra tới 2,5 lần với mức giá gấp đôi ($16/$80).
Kết quả tốt hơn với nỗ lực thấp hơn
Đây là thay đổi có khả năng ảnh hưởng đến hóa đơn của bạn nhiều nhất. Ở mức nỗ lực cao, Fable 5.2 đạt 45,3% trên FrontierCode 2.0, xấp xỉ điểm tốt nhất của Opus 5.5, với chi phí mỗi tác vụ khoảng bằng một nửa. Ở mức nỗ lực thấp, nó đạt điểm cao nhất của Opus 5.5 trên Humanity's Last Exam với chi phí mỗi tác vụ chưa tới một phần mười. Theo tôi: Nếu bạn chuyển lên từ Opus 5.5, hãy bắt đầu Fable 5.2 ở mức nỗ lực thấp hơn.
Ít yêu cầu bị chặn hơn
Fable 5.2 sẽ gặp khoảng ít hơn 55% lần chặn an toàn so với Fable 5.1 (ít hơn khoảng 60% trong an ninh mạng và 40% trong sinh học). Điều này rất đáng chú ý nếu các từ chối của Fable 5.1 từng cản trở bạn, nhưng các loại tác vụ bị chặn không thay đổi: kiểm thử xâm nhập, tạo exploit, và phần lớn công việc sinh học trình độ nghiên cứu vẫn bị chuyển cho các mô hình Claude cũ hơn.
Claude Fable 5.2 thể hiện như thế nào trên các benchmark?
Dưới đây là các kết quả chính. Chúng đều từ bảng công bố khi ra mắt của Anthropic, nên hãy xem chúng như luận điểm của Anthropic cho mô hình này hơn là kết quả độc lập. Điểm số của Claude được chạy với các biện pháp bảo vệ bật. Trừ khi có ghi chú, mỗi mô hình được hiển thị ở mức nỗ lực cao nhất sẵn có.
Lập trình theo tác nhân
Fable 5.2 dẫn đầu cả hai benchmark lập trình trong bảng. Trên FrontierCode 2.0, đo lường việc người bảo trì mã nguồn mở có chấp nhận hợp nhất thay đổi mã của mô hình hay không, nó đạt 49,1%, cao nhất bảng và vượt xa 32,4% của Fable 5.1. Trên FrontierSWE v2, nó đạt 69,9%, vượt GPT-6 Astra (65,5%) và Opus 5.5 (62,3%).
Các ví dụ khi ra mắt cũng cho thấy điều tương tự: các agent chạy phiên bản đầu của Fable 5.2 đã chuyển một dịch vụ sản xuất từ Python sang Rust, và giờ nó khởi động nhanh hơn khoảng 26 lần.
Công việc tri thức và nghiên cứu
Mức tăng tương đối lớn nhất là ở Remote Labor Index, đo lường khả năng hoàn thành các dự án kiểu freelancer thực tế. Fable 5.2 đạt 41,3%, xấp xỉ gấp đôi Opus 5.5 (21,3%) và GPT-6 Astra (20,8%). Nó cũng dẫn đầu ở Humanity's Last Exam với công cụ (74,2%) và Terminal-Bench-Science (74,6%, hoặc 75,3% với Mythos 5.2).
Tự động hóa kinh doanh là mảng duy nhất nó tụt lại. Ở AutomationBench, Gemini 4 Carbon đạt 53,9% so với 51,4% của Fable 5.2, dù Fable 5.2 vẫn vượt xa Fable 5.1 (31,4%).
Ngoài bảng chính, Fable 5.2 đạt 83,5 trên benchmark kỹ thuật phần cứng BenchCAD 2.1, so với 65,3 của Opus 5.5. Nó cũng được ghi nhận là giải được hai bài toán mở trong vật lý lỗ đen, và các kết quả đó đã được đăng dạng preprint để các nhà vật lý khác kiểm chứng.
Sử dụng máy tính, robotics, và thị giác
Fable 5.2 đạt 89,3% trên OSWorld 2.1, vượt Opus 5.5 (87,2%) và GPT-6 Astra (79,5%). Mức nhảy vọt về robotics là lớn nhất trong bảng: 64,9% trên RoboDojo Sim, hơn gấp đôi Fable 5.1 và GPT-6 Astra. Trên Chartography, kiểm tra đọc biểu đồ không dùng công cụ, nó nhỉnh hơn Gemini 4 Carbon và GPT-6 Astra, sau khi Fable 5.1 từng tụt khá xa ở mức 44,8%.
An ninh mạng và sinh học (Mythos 5.2)
Các dòng về an ninh và sinh học là dành cho Mythos 5.2, vì biện pháp bảo vệ của Fable 5.2 chặn phần lớn tác vụ này. Mythos 5.2 đạt 76,3% trên CyScenarioBench (so với 61,7% của Mythos 5.1), 89,6% trên CVE Rediscovery (so với 78,3%), và 85,1% trên bài toán thiết kế protein binder trong 24 giờ (so với 79,1%). Không có so sánh công bằng với mô hình an ninh của OpenAI ở đây, vì mỗi phòng lab chạy bộ tác vụ CyScenarioBench riêng.
Chuyện gì với Định lý cuối cùng của Fermat?
Một nhóm agent Fable 5.2 đã hình thức hóa (formalize) chứng minh Định lý cuối cùng của Fermat trong trình trợ lý chứng minh Lean trong 30 giờ. Bạn có thể thắc mắc: chẳng phải định lý đã được chứng minh ba thập kỷ trước rồi sao, còn gì để làm?
Định lý này đã là chuyện cũ
Định lý cuối cùng của Fermat nói rằng không tồn tại các số nguyên dương a, b, và c sao cho an + bn = cn với mọi n lớn hơn 2. Với n = 2 thì có rất nhiều nghiệm, như 32 + 42 = 52 (9 + 16 = 25). Nhưng thử với lập phương thì chỉ có những trường hợp suýt đúng: 63 + 83 = 728, thiếu 1 so với 93 = 729.
Pierre de Fermat khẳng định có một chứng minh vào năm 1637 nhưng không bao giờ viết ra, và bài toán này treo hơn 350 năm cho đến khi Andrew Wiles chứng minh được vào giữa thập niên 1990, với sự hỗ trợ của Richard Taylor.
Hình thức hóa bằng Lean là gì
Chứng minh của Wiles dài hơn 100 trang và dựa trên hàng thập kỷ lý thuyết số cao cấp, nên rất ít người có thể kiểm tra trọn vẹn từ đầu đến cuối. Lean là một trình trợ lý chứng minh: một ngôn ngữ lập trình mà trong đó bạn viết chứng minh như mã, và phần mềm sẽ kiểm tra mọi bước logic đến tận các tiên đề cơ bản của toán học. Nếu chứng minh biên dịch được, nó là đúng. “Hình thức hóa” một định lý nghĩa là chuyển chứng minh do con người viết sang dạng có thể kiểm tra bằng máy này.
Với Định lý cuối cùng của Fermat, đó là một khối lượng công việc khổng lồ, vì nhiều phần toán học mà chứng minh dựa vào chưa từng được viết trong Lean. Nhà toán học Kevin Buzzard đã khởi động một dự án cộng đồng để làm việc này vào năm 2024.
Tại sao điều này thú vị với một mô hình AI
Phần lớn đầu ra của AI được con người đánh giá hoặc bởi các benchmark chỉ kiểm tra một phần câu trả lời. Chứng minh Lean thì khác: bộ kiểm tra hoặc chấp nhận mọi bước hoặc không, nên không có chỗ cho sai lệch tinh vi. Điều đó khiến nó trở thành một phép thử đặc biệt “sạch” về việc liệu mô hình có thể theo đuổi một dự án rất dài, rất khó đến đích đã được kiểm chứng hay không.
Đây không phải lần đầu Claude làm được điều này. Vào tháng 9, Anthropic công bố chứng minh đầu tiên hoàn chỉnh được máy tính kiểm tra cho định lý này, do hàng chục agent chạy một mô hình nghiên cứu nội bộ xấp xỉ Fable 5.1 viết. Nỗ lực đó mất 11 ngày và khoảng sáu tỷ token đầu ra, tạo ra 13 triệu dòng Lean, và một phần dựa trên các mảnh ghép từ dự án của Buzzard. Fable 5.2 làm được trong 30 giờ, với hỗ trợ tối thiểu của con người.
Các lưu ý
Điều đáng chú ý nhất, tuy nhiên, là những gì xảy ra khi Anthropic giao cùng công việc đó cho Claude Opus 5.5.
Claude Fable 5.2 so với Claude Opus 5.5
So sánh hai mô hình thường là đọc điểm benchmark và cố suy ra khác biệt sẽ trông thế nào trong thực tế. Lần này, tôi đánh giá cao việc Anthropic dẫn bằng một câu chuyện, khiến khoảng cách trở nên rõ ràng hơn.
Trong cùng thiết lập Lean với 1.000 agent, Opus 5.5 hoàn thành 26% chứng minh Định lý cuối cùng của Fermat trong 18 giờ và hầu như không tiến triển sau đó. Fable 5.2 hoàn thành toàn bộ trong 30 giờ. Kết luận: với các dự án rất dài, nhiều tác nhân, Opus 5.5 có thể bị chững lại nơi Fable 5.2 vẫn tiếp tục.
Với các tác vụ ngắn hơn, khoảng cách nhỏ hơn. Đây là so sánh trực tiếp giữa hai mô hình:
Mẫu số chung khớp với kết quả Lean. Ở sử dụng máy tính và lập trình, Fable 5.2 chỉ nhỉnh hơn vài điểm. Ở công việc mở, nhiều bước, khoảng cách tăng: Fable 5.2 gần như gấp đôi điểm Opus 5.5 trên các dự án kiểu freelancer trong Remote Labor Index, và hơn 25 điểm ở điều khiển robot.
Giá cả ít chênh hơn nhìn bề ngoài. Fable 5.2 đắt gấp đôi mỗi token, nhưng thường có thể đạt điểm tốt nhất của Opus 5.5 ở mức nỗ lực thấp hơn, dùng ít token hơn. Trên FrontierCode 2.0, chẳng hạn, Fable 5.2 ở nỗ lực cao xấp xỉ điểm tốt nhất của Opus 5.5 với khoảng nửa chi phí mỗi tác vụ.
Vì vậy Opus 5.5 vẫn là lựa chọn mặc định hợp lý. Nhưng nếu một tác vụ chạy hàng giờ, có nhiều agent, hoặc thường xuyên bị chững lại trên Opus, Fable 5.2 nhiều khả năng sẽ hoàn thành, và chi phí có thể không cao như mức giá theo token gợi ý.
An toàn và giới hạn
Anthropic đánh giá rủi ro các mô hình này hành xử không an toàn trong bối cảnh rủi ro cao là thấp.
Điều đó khó kiểm chứng từ bên ngoài, nên các con số cụ thể sẽ hữu ích hơn. Trên một bài kiểm toán hành vi tự động với khoảng 1.900 kịch bản, Mythos 5.2 có điểm hành vi sai lệch thấp nhất trong các mô hình so sánh. Nó cũng ít có khả năng bịa đầu vào, tuyên bố sai là đã hoàn thành tác vụ, hoặc che giấu công việc kém chất lượng.
Có vài điểm thú vị khác đáng biết và sẽ khiến bạn phải suy ngẫm:
Nên dùng mô hình Claude nào?
Lời khuyên của tôi trùng với Anthropic: bắt đầu với Opus 5.5 và chỉ nâng cấp khi cần. Tổng quan đội hình như sau:
Giá và khả dụng của Claude Fable 5.2
Chúng ta vừa xem một bảng kết quả benchmark cho thấy Fable 5.2 vượt Fable 5.1 ở mọi hạng mục được liệt kê. Giờ, tôi cho bạn xem một bảng cho thấy Fable 5.2 rẻ hơn 5.1. Vậy Fable 5.1 đã lỗi thời?
Với công việc mới, về cơ bản là đúng. Nếu bạn có quyền dùng Fable 5.2, hầu như không có lý do để bắt đầu việc mới trên 5.1. Tuy nhiên, Anthropic chưa công bố ngày ngừng hỗ trợ, và các nhóm có prompt hoặc agent tinh chỉnh trên Fable 5.1 sẽ muốn thử 5.2 trước khi chuyển. Chúng ta biết rằng một phiên bản mới có thể hành xử khác dù điểm số tốt hơn.
Cách truy cập Claude Fable 5.2
Ứng dụng Claude: Fable 5.2 có sẵn trên các gói trả phí đủ điều kiện. Như một ưu đãi ra mắt, gói Pro và các ghế Team tiêu chuẩn có thể dùng Fable tới 50% hạn mức sử dụng hàng tuần, và các gói bao gồm Fable sẽ nhận 1 đến 3 lần đặt lại hạn mức tùy thời hạn đăng ký.
API: Dùng ID mô hình
claude-fable-5-2trên Claude Platform.Nền tảng đám mây: Có sẵn trên Amazon Web Services, Google Cloud, và Microsoft Azure.
Mythos 5.2: Nộp đơn qua Chương trình Xác minh An ninh mạng hoặc Chương trình Xác minh Khoa học Đời sống. Khách hàng Claude Enterprise cũng có thể dùng qua Claude Security.
Các doanh nghiệp có yêu cầu nghiêm ngặt về dữ liệu có thể dùng Enterprise Frontier Safeguards, cho phép chạy giám sát an toàn của Anthropic trên dữ liệu lưu trong hạ tầng của chính khách hàng và hoạt động với chế độ không lưu dữ liệu. Khách hàng khác có thời hạn lưu dữ liệu 30 ngày cho mục đích giám sát an toàn.
Kết luận
Claude Fable 5.2 là một bước tiến đáng kể so với Fable 5.1. Nó rẻ hơn, nhanh hơn, ít từ chối công việc hợp lệ hơn. Các bước nhảy ở Remote Labor Index, robotics, và FrontierCode đặc biệt lớn.
Tuy vậy, Opus 5.5 vẫn là lựa chọn đáng giá hơn cho hầu hết công việc thường ngày với mức giá bằng một nửa. Điểm thú vị nhất về Fable 5.2 có thể là các tuyên bố về hiệu suất chi phí: nếu nó thực sự đạt các điểm tốt nhất của Opus 5.5 ở mức nỗ lực thấp hoặc trung bình, chênh lệch giá theo token sẽ nhanh chóng thu hẹp. Điều đó đáng để bạn thử trên khối lượng công việc của riêng mình.
Nếu bạn muốn trực tiếp trải nghiệm Claude, lộ trình Phát triển Ứng dụng AI của chúng tôi là một điểm khởi đầu tốt.