Bugün Anthropic, herkes için Fable 5.2’yi ve doğrulanmış kuruluşlar için Mythos 5.2’yi duyurdu. Temelde aynı model, ancak Fable sürümünde siber güvenlik ve biyoloji için ek güvenlik önlemleri bulunuyor.
Öne çıkan değişiklikler şunlar:
- daha düşük fiyat,
- daha hızlı çıktı ve
- Anthropic’in en zorlu kıyaslamalarında büyük sıçramalar.
Daha somut olarak, Fable 5.2, Fable 5.1’den %20 daha ucuz, çıktıları %30’a kadar daha hızlı üretiyor ve Anthropic’in kıyaslama tablosundaki satırların çoğunda GPT-6 Astra ve Gemini 4 Carbon’u geride bırakıyor.
Bu yazıda, Fable 5.2 ve Mythos 5.2’de neler yeni, kıyaslamalardaki performansları, maliyetleri ve Claude Opus 5.5 yerine hangisini seçmeniz gerektiğine nasıl karar vereceğinizi ele alacağım.
Claude Fable 5.2 Nedir?
Claude Fable 5.2, Anthropic’in genel kullanıma sunulan en yetenekli modeli. Uzun, zorlu teknik işler için tasarlandı: büyük kod tabanı geçişleri, günler süren ajan çalışmaları, araştırma problemleri ve mühendislik tasarımı.
Fable 5.2 ayrıca daha küçük modellerle birlikte çalışabilir; zor sorunlarda danışılan bir danışman olarak veya daha basit alt görevleri onlara devreden bir orkestratör olarak.
Fable 5.2, selefinin 1M token bağlam penceresini ve 128K maksimum çıktısını koruyor; bilgi kesimi Haziran 2026’dır.
Claude Mythos 5.2 Nedir?
Claude Mythos 5.2, çoğu siber güvenlik çalışmasını ve araştırma düzeyinde biyoloji çalışmalarını engelleyen güvenlik önlemleri olmayan, Fable 5.2 ile aynı modeldir. Aslında Mythos 5.2, Anthropic’in siber güvenlik mühendisliği için en yetenekli modelidir. Bu tür yetenekler çift kullanımlı olduğundan, Anthropic Mythos 5.2’yi yalnızca Siber Doğrulama Programı ve Yaşam Bilimleri Doğrulama Programı aracılığıyla doğrulanmış kuruluşlara sunuyor.
Claude Fable 5.2’de Neler Yeni?
Fable yalnızca Haziran’da, Anthropic’in Fable 5’i yayımlamasıyla hayatımıza girdi. O zamandan beri iki nokta sürümü geldi: Eylül’de Fable 5.1 ve şimdi Fable 5.2; her ikisi de çok fazla yeni özellik eklemedi. Çoğunlukla modeli daha ucuz, daha hızlı ve daha güçlü hale getirdiler; performans kazanımları da küçük değil: Örneğin Fable 5.2, Remote Labor Index’te Fable 5.1’in puanını ikiye katlıyor.
İki sürüm arasındaki asıl fark, modeli nasıl kullanmanıza izin verildiğinde. Fable 5.1 ile Anthropic siber güvenlik önlemlerini daralttı ve modeli yazılım açıklarını bulmak için kullanmaya izin vermeye başladı, ancak bu açıklar için exploit yazmaya izin vermedi; ayrıca sürümle birlikte verilerinizi kendi bulutunuzda tutma seçeneği olan Enterprise Frontier Safeguards’ı duyurdu. Fable 5.2’deki güvenlik önlemi değişiklikleri ise daha küçük: daha az isteği engelliyor, ancak aynı tür görevler hâlâ yasak.
Onu kullanmanın önerilen yeni yolları, örneğin Fable 5.2’nin daha küçük Claude modellerine danışmanlık yapması, aslında yeni değil; çünkü Anthropic’in danışman aracı zaten Fable 5 ve 5.1’i destekliyordu. Lansman demoları da, boş bir klasörden işletim sistemi kurmak gibi, açıp kapatabileceğiniz yeni özellikler değil; daha güçlü bir modelin daha zor şeyleri yaptığını gösteriyor.
Yine de, yeni şeylere işaret edeceksem, şunları anabilirim:
Daha düşük fiyat
Fable 5.2, milyon başına giriş token’ı için 8 ABD doları ve milyon başına çıkış token’ı için 40 ABD doları; Fable 5.1’in 10/50 ABD dolarından %20 daha az. Aynı %20’lik indirim önbellek okumalarına (0,20 ABD doları), önbellek yazımlarına ve toplu işleme de uygulanıyor. Tam döküm için aşağıdaki fiyatlandırma bölümüne bakın.
Daha hızlı çıktı ve Fable için hızlı mod
Çıktı, Fable 5.1’e göre %30’a kadar daha hızlı; bu da uzun bir ajan çalışmasında birikir. Fable artık hızlı modu da destekliyor; bu mod, fiyatı iki katına çıkarırken (16/80 ABD doları) çıktıyı 2,5 kata kadar hızlandırıyor.
Daha az çabayla daha iyi sonuçlar
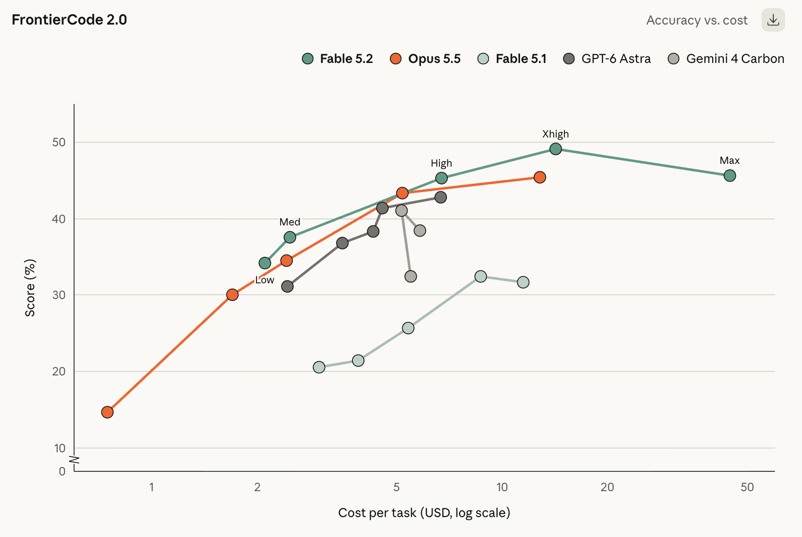
Faturanızı en çok etkilemesi muhtemel değişiklik bu. Yüksek çabada, Fable 5.2 FrontierCode 2.0’da %45,3 puan alıyor; yaklaşık yarı maliyetle Opus 5.5’in en iyi puanına yakın. Düşük çabada ise Humanity’s Last Exam’de Opus 5.5’in en iyi puanını, görev başına maliyetin onda birinden daha azıyla yakalıyor. Benim yorumum: Opus 5.5’ten yükseliyorsanız, Fable 5.2’yi daha düşük çaba düzeyinde başlatın.
Daha az engellenen istek
Fable 5.2, Fable 5.1’e kıyasla yaklaşık %55 daha az güvenlik engeliyle karşılaşmalı (siber güvenlikte yaklaşık %60, biyolojide %40 daha az). Fable 5.1’in reddetmeleri işinizi engelliyorsa bu önemli, ancak engellenen kategoriler değişmedi: sızma testleri, exploit üretimi ve araştırma düzeyindeki biyolojinin çoğu hâlâ daha eski Claude modellere devrediliyor.
İşte başlıca sonuçlar. Hepsi Anthropic’in lansman tablosundan geldiği için bunları bağımsız sonuçlar yerine model için Anthropic’in argümanı olarak okuyun. Claude puanları güvenlik önlemleri açıkken alındı. Aksi belirtilmedikçe, her model en yüksek mevcut çaba düzeyinde gösterilmiştir.
| Kıyaslama | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (ajan temelli kodlama) | %49,1 | %32,4 | %45,5 | %42,8 | %41,1 |
| FrontierSWE v2 (ajan temelli kodlama) | %69,9 | %56,3 | %62,3 | %65,5 | %61,2 |
| AutomationBench (iş akışları) | %51,4 | %31,4 | %42,5 | %41,4 | %53,9 |
| Terminal-Bench-Science 0.1 | %74,6 | %52,6 | %58,7 | %68,1 | %64,8 |
| OSWorld 2.1 (bilgisayar kullanımı) | %89,3 | %83,5 | %87,2 | %79,5 | %81,5 |
| RoboDojo Sim (robotik) | %64,9 | %27,6 | %39,4 | %29,8 | Bildirilmedi |
| AA-Briefcase v1.1 (bilgi çalışması) | %66,1 | %61,5 | %61,2 | %52,0 | %61,8 |
| Remote Labor Index (bilgi çalışması) | %41,3 | %17,9 | %21,3 | %20,8 | Bildirilmedi |
| Humanity's Last Exam (araçlarla) | %74,2 | %65,6 | %67,7 | %57,2 | Bildirilmedi |
| WANDR (ajan temelli arama) | %82,1 | %68,7 | %72,3 | Bildirilmedi | Bildirilmedi |
| Chartography (araçsız) | %73,4 | %44,8 | %64,4 | %71,0 | %72,5 |
Ajan temelli kodlama
Fable 5.2, tablodaki her iki kodlama kıyaslamasında da lider. Açık kaynak bakıcılarının bir modelin kod değişikliklerini birleştirip birleştirmeyeceğini ölçen FrontierCode 2.0’da %49,1 puanla tablonun en yükseğinde ve Fable 5.1’in %32,4’ünün oldukça üzerinde. FrontierSWE v2’de %69,9 puanla GPT-6 Astra (%65,5) ve Opus 5.5’in (%62,3) önünde.
Lansman örnekleri de aynı yönde: Fable 5.2’nin erken bir sürümünü çalıştıran ajanlar, üretimdeki bir hizmeti Python’dan Rust’a taşıdı ve artık yaklaşık 26 kat daha hızlı başlıyor.
Bilgi çalışması ve araştırma
En büyük göreli sıçrama, bir modelin serbest çalışmaya benzeyen gerçek projeleri ne kadar iyi tamamladığını ölçen Remote Labor Index’te. Fable 5.2, %41,3 puanla Opus 5.5’i (%21,3) ve GPT-6 Astra’yı (%20,8) kabaca ikiye katlıyor. Ayrıca araçlarla Humanity’s Last Exam’de (%74,2) ve Terminal-Bench-Science’da (%74,6; Mythos 5.2 için %75,3) lider.
Geri kaldığı tek alan iş otomasyonu. AutomationBench’te Gemini 4 Carbon %53,9 puan alırken Fable 5.2 %51,4’te kalıyor; yine de Fable 5.1’in (%31,4) çok ilerisinde.
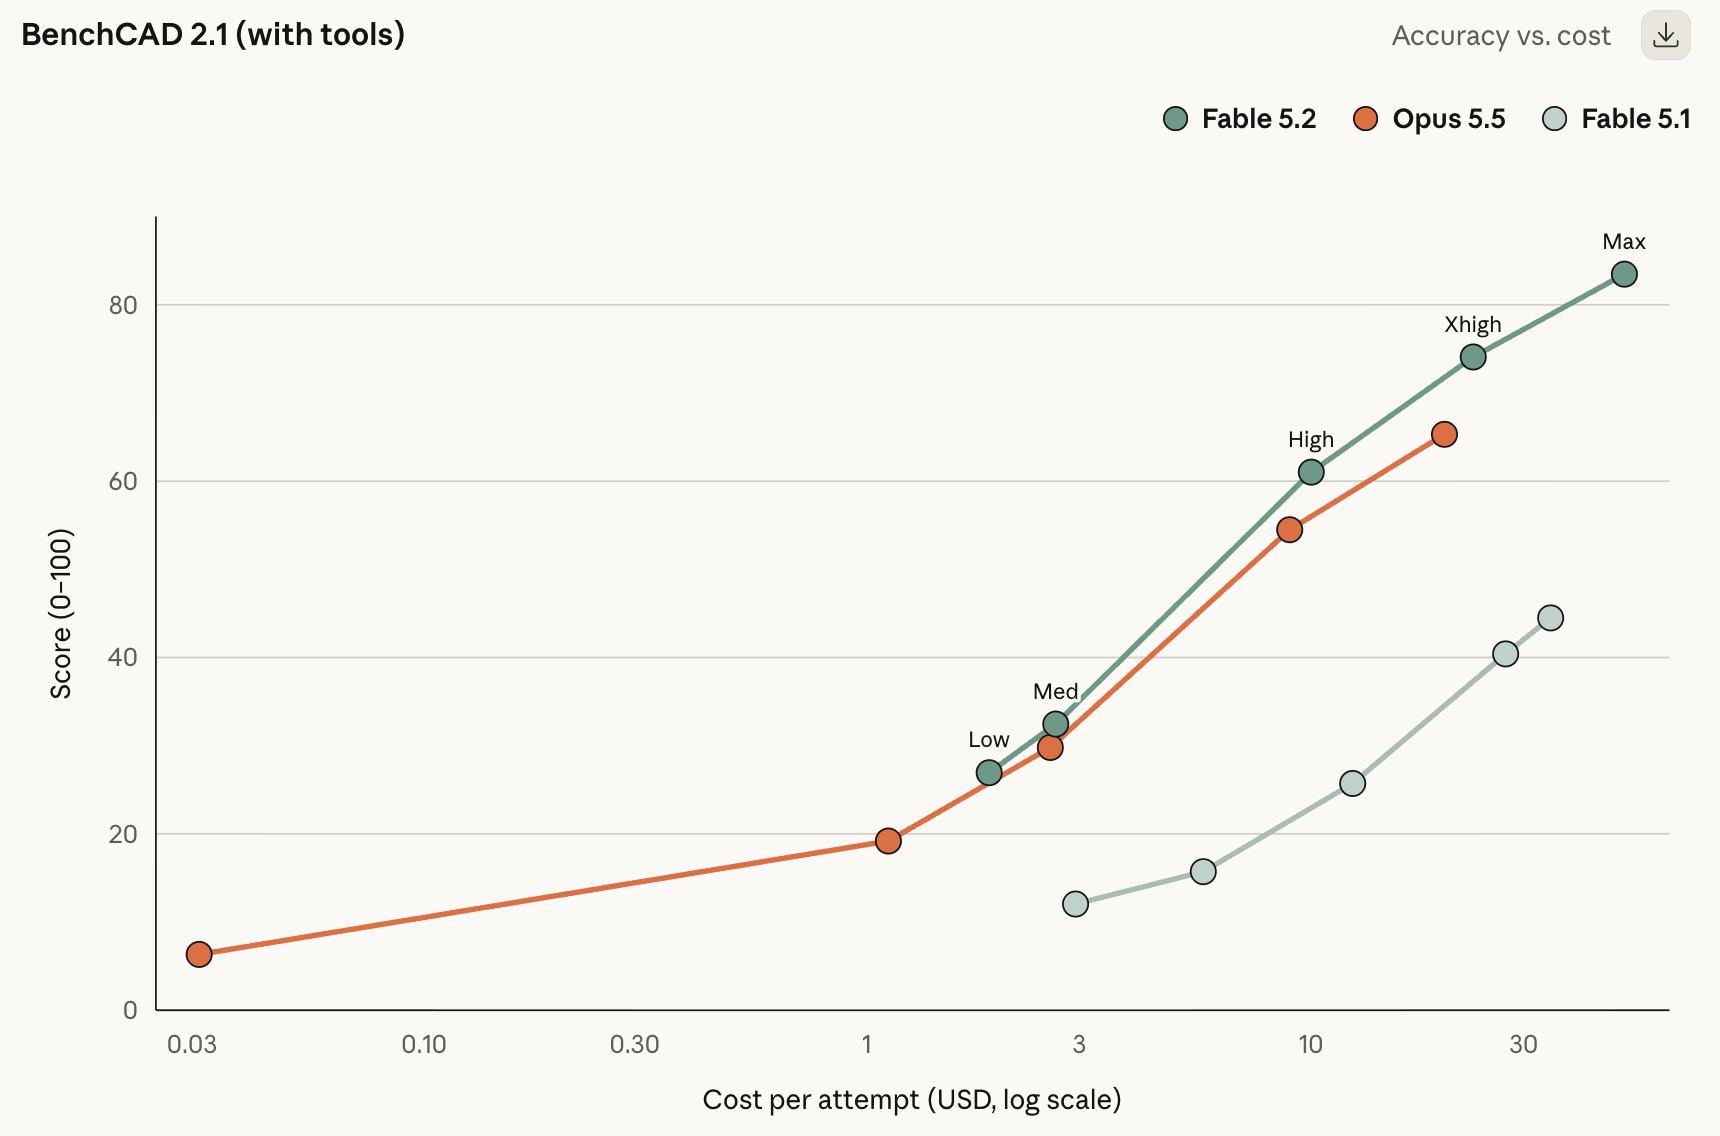
Ana tablonun dışında, Fable 5.2 donanım mühendisliği kıyaslaması BenchCAD 2.1’de 83,5 puan aldı; Opus 5.5 için bu puan 65,3’tü. Ayrıca kara delik fiziğinde iki açık problemi çözmekle de kredilendiriliyor ve bu sonuçlar diğer fizikçilerin kontrol edebilmesi için ön baskı olarak paylaşıldı.
Bilgisayar kullanımı, robotik ve görme
Fable 5.2, OSWorld 2.1’de %89,3 puan alarak Opus 5.5’i (%87,2) ve GPT-6 Astra’yı (%79,5) geçti. Robotikteki sıçrama tablodaki en büyük: RoboDojo Sim’de %64,9; Fable 5.1 ve GPT-6 Astra’nın iki katından fazla. Araçsız grafik okuma testi olan Chartography’de de, Fable 5.1’in %44,8 ile geride kalmasının ardından, Gemini 4 Carbon ve GPT-6 Astra’yı kıl payı geride bırakıyor.
Siber güvenlik ve biyoloji (Mythos 5.2)
Güvenlik ve biyoloji satırları Mythos 5.2’ye ait; çünkü Fable 5.2’nin güvenlik önlemleri bu görevlerin çoğunu engelliyor. Mythos 5.2, CyScenarioBench’te %76,3 (Mythos 5.1 için %61,7’ye karşı), CVE Rediscovery’de %89,6 (%78,3’e karşı) ve 24 saatlik protein bağlayıcı tasarım görevinde %85,1 (%79,1’e karşı) puan alıyor. Burada OpenAI’nin güvenlik modeliyle adil bir karşılaştırma yok; çünkü her laboratuvar kendi CyScenarioBench görevlerini çalıştırdı.
Fermat’ın Son Teoremi Ne Alaka?
Bir Fable 5.2 ajan ekibi, Fermat’ın Son Teoremi’nin ispatını 30 saatte Lean ispat asistanında biçimselleştirdi. Şunu merak ediyor olabilirsiniz: Teorem zaten üç on yıl önce ispatlanmadı mı; peki geriye ne kaldı?
Teorem eski haber
Fermat’ın Son Teoremi, 2’den büyük herhangi bir n için an + bn = cn denklemini sağlayan pozitif tam sayılar a, b ve c olmadığını söyler. n = 2 için pek çok çözüm vardır; örneğin 32 + 42 = 52 (9 + 16 = 25). Ancak küpleri deneyin, yalnızca ıskalamalar elde edersiniz: 63 + 83 = 728, 93 = 729’un bir eksiği.
Pierre de Fermat 1637’de bir ispat iddia etti ama yazıya dökmedi ve konu, Andrew Wiles’ın Richard Taylor’ın yardımıyla 1990’ların ortasında ispatlayana kadar 350 yıldan uzun süre çözülemedi.
Lean biçimselleştirmesi nedir
Wiles’ın ispatı 100 sayfayı aşıyor ve onlarca yıllık ileri sayı teorisine dayanıyor; bu nedenle çok az kişi baştan sona kontrol edebiliyor. Lean bir ispat asistanıdır: İspatı kod olarak yazdığınız bir programlama dili; yazılım, matematiğin temel aksiyomlarına kadar her mantıksal adımı denetler. Eğer ispat derlenirse doğrudur. Bir teoremi “biçimselleştirmek”, insan tarafından yazılmış ispatı bu makine tarafından denetlenebilir forma çevirmek demektir.
Fermat’ın Son Teoremi için bu devasa bir iştir; çünkü ispatın dayandığı matematiğin çoğu Lean’de hiç yazılmamıştı. Matematikçi Kevin Buzzard, bunu yapmak için 2024’te bir topluluk projesi başlattı.
Bir yapay zekâ modeli için neden ilginç
Çoğu yapay zekâ çıktısı insanlar tarafından ya da yalnızca cevabın bir kısmını test eden kıyaslamalarla değerlendirilir. Lean ispatı farklıdır: denetleyici ya her adımı kabul eder ya da etmez; bu yüzden ince ince yanlış olmanın yolu yoktur. Bu, bir modelin çok uzun ve çok zor bir projeyi doğrulanmış bir sona taşıyıp taşıyamadığının olağanüstü temiz bir testi olur.
Bu, Claude’un bunu ilk yapışı değil. Eylül’de Anthropic, onlarca ajanın Fable 5.1’e kabaca denk dahili bir araştırma modeliyle yazdığı ilk eksiksiz, bilgisayarla denetlenmiş ispatı yayımladı. O çalışma 11 gün sürdü ve yaklaşık altı milyar çıkış token’ı, 13 milyon satır Lean üretti ve kısmen Buzzard’ın projesinin parçaları üzerine inşa edildi. Fable 5.2 bunu 30 saatte, asgari insan yardımıyla yaptı.
Çekinceler
- Matematiğe bir şey katmıyor. Buzzard, Anthropic’in ilk biçimselleştirmesi için de aynı şeyi söylemişti.
- Fable 5.2’ye ilerlemesini takip etmek için ara teorem ifadelerinin bir listesi verildi. Bu, nasıl ispatlanacağını değil, neyin ispatlanacağını gösteren bir yol haritasıdır.
- Yeni ispatla ilgili dışarıdan bir değerlendirme bulamadım; bu nedenle şimdilik 30 saatlik süre ve Opus 5.5 karşılaştırması Anthropic’in iddialarıdır.
Ancak en çarpıcı olan, Anthropic aynı işi Claude Opus 5.5’e verdiğinde olanlar.
Claude Fable 5.2 vs. Claude Opus 5.5
İki modeli karşılaştırmak genellikle kıyaslama puanlarını okumak ve pratikte farkın nasıl görüneceğini çıkarsamaya çalışmak demektir. Bu kez, aradaki farkı daha belirgin kılan bir hikâyeyle başlamasını takdir ediyorum.
Aynı 1.000 ajanlık Lean kurulumunda Opus 5.5, 18 saatte Fermat’ın Son Teoremi ispatının %26’sını tamamladı ve sonrasında zar zor ilerledi. Fable 5.2 ise tamamını 30 saatte bitirdi. Çıkarım: Çok uzun, çok ajanlı projelerde Opus 5.5 takılabilirken Fable 5.2 ilerlemeye devam ediyor.
Daha kısa görevlerde fark daha küçük. İşte yan yana karşılaştırma:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| Fiyat (giriş / çıkış, 1M token başına) | $8 / $40 | $4 / $20 |
| Bağlam penceresi / maksimum çıktı | 1M / 128K | 1M / 128K |
| FrontierCode 2.0 (ajan temelli kodlama) | %49,1 | %45,5 |
| FrontierSWE v2 (ajan temelli kodlama) | %69,9 | %62,3 |
| OSWorld 2.1 (bilgisayar kullanımı) | %89,3 | %87,2 |
| AutomationBench (iş akışları) | %51,4 | %42,5 |
| Humanity's Last Exam (araçlarla) | %74,2 | %67,7 |
| Remote Labor Index (bilgi çalışması) | %41,3 | %21,3 |
| RoboDojo Sim (robotik) | %64,9 | %39,4 |
Bu desen, Lean sonucuyla uyumlu. Bilgisayar kullanımı ve kodlamada Fable 5.2 yalnızca birkaç puan önde. Ucu açık, çok adımlı işlerde ise fark büyüyor: Fable 5.2, Remote Labor Index’te serbest proje tarzı görevlerde Opus 5.5’in puanını neredeyse ikiye katlıyor ve robot kontrolünde 25 puan fark atıyor.
Fiyat, göründüğü kadar büyük bir fark değil. Fable 5.2, token başına iki kat daha pahalı, ancak sıklıkla daha düşük çaba düzeyinde Opus 5.5’in en iyi puanına ulaşabiliyor ve daha az token kullanıyor. Örneğin FrontierCode 2.0’da, Fable 5.2 yüksek çabada, görev başına maliyetin yaklaşık yarısında Opus 5.5’in en iyisini kabaca yakalıyor.
Dolayısıyla, Opus 5.5 hâlâ çoğu günlük iş için mantıklı varsayılandır. Ancak bir görev saatlerce sürüyorsa, çok sayıda ajan içeriyorsa veya Opus üzerinde sürekli takılıyorsa, Fable 5.2 muhtemelen bitirecektir ve token başına fiyatın işaret ettiğinden daha pahalıya da gelmeyebilir.
Güvenlik ve Sınırlar
Anthropic, bu modellerin yüksek riskli durumlarda güvensiz davranma riskini düşük olarak değerlendiriyor.
Dışarıdan bunu doğrulamak zor, bu yüzden daha somut sayılar faydalı. Yaklaşık 1.900 senaryoluk otomatik bir davranış denetiminde, Mythos 5.2 karşılaştırılan modeller arasında en düşük hizasız davranış puanına sahipti. Girdileri halüsinasyon görme, bir görevin tamamlandığını asılsız iddia etme veya kötü işi gizleme olasılığı da daha düşüktü.
Bahsedilen ve bilmeye değer, düşündürücü bazı başka noktalar da var:
- Değerlendirme farkındalığı: Fable 5.2 ve Mythos 5.2, önceki modellere göre test edildiklerinden daha sık şüphelendiklerini söylüyor; bu da yukarıdakine benzer değerlendirmelere güvenmeyi zorlaştırıyor.
- Kasıtlı olarak sınırlandırılmış yapay zekâ araştırma becerileri: Anthropic, modellerin iki alandaki kazanımlarını sınırladı: hızlandırıcı çekirdeği optimizasyonu ve LLM mimarilerini iyileştirme; böylece bu alanlarda yaklaşık Opus 5.5 düzeyinde performans gösteriyorlar.
- Damıtma korumaları: Fable 5.2, Anthropic’in bugüne kadarki en güçlü anti-damıtma önlemlerine sahip ve “korunmuş düşünme” — API kullanıcılarının modelin muhakemesini çıkarmak için önceki bağlamı düzenlemesini engelleyen özellik — artık tüm hesaplar için geçerli.
Hangi Claude Modelini Kullanmalısınız?
Benim önerim Anthropic’inkiyle aynı: Opus 5.5 ile başlayın ve yalnızca ihtiyaç duyduğunuzda yükseltin. Dizilim şöyle ayrışıyor:
- Claude Opus 5.5 (4/20 ABD doları): Çoğu kodlama, araştırma ve bilgi çalışması için varsayılan. Token başına, Fable 5.2’nin yarı fiyatına ve birçok kıyaslamada hemen arkasında.
- Claude Fable 5.2 (8/40 ABD doları): En zor problemler, uzun çok ajanlı çalıştırmalar ve Opus 5.5’in takıldığı büyük geçişler, araştırma düzeyinde akıl yürütme veya donanım tasarımı gibi görevler için. Maksimum çabaya ihtiyacınız olduğunu varsaymadan önce daha düşük çaba düzeylerinde deneyin.
- Claude Mythos 5.2: Fable 5.2’nin güvenlik önlemlerinin engellediği yeteneklere ihtiyaç duyan doğrulanmış güvenlik ekipleri ve yaşam bilimleri araştırmacıları için.
- Claude Sonnet 5.5 ve Haiku 5.5: Yüksek hacimli, daha basit veya gecikmeye duyarlı görevler için ya da Fable 5.2’nin orkestre ettiği daha küçük modeller olarak.
Claude Fable 5.2 Fiyatlandırma ve Kullanılabilirlik
| 1M token başına | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Giriş | $8 | $10 | $4 |
| Çıkış | $40 | $50 | $20 |
| Önbellek okumaları | $0.20 | $0.25 | $0.20 |
| 5 dakikalık önbellek yazımları | $10 | $12.50 | $5 |
| Toplu (giriş / çıkış) | $4 / $20 | $5 / $25 | $2 / $10 |
| Hızlı mod (giriş / çıkış) | $16 / $80 | Liste dışı | $8 / $40 |
Az önce Fable 5.2’nin listelenen her ölçütte Fable 5.1’i geçtiğini gösteren bir tabloya bakmıştık. Şimdi de Fable 5.2’nin 5.1’den daha ucuz olduğunu gösteren bir tablo gösteriyorum. O hâlde Fable 5.1 modası geçti mi?
Yeni işler için, fiilen evet. Fable 5.2’ye erişiminiz varsa, 5.1 üzerinde yeni bir şeye başlamanız için pek az neden var. Yine de Anthropic bunun için bir emeklilik tarihi duyurmadı ve Fable 5.1’e göre ayarlanmış komutlar veya ajanları olan ekipler, geçmeden önce 5.2’yi test etmek isteyecek. Daha iyi puan alsa bile yeni bir sürümün farklı davranabileceğini biliyoruz.
Claude Fable 5.2’ye Nasıl Erişilir?
-
Claude uygulamaları: Fable 5.2, uygun ücretli planlarda mevcut. Lansman promosyonu olarak, Pro planları ve standart Ekip koltukları haftalık kullanım limitlerinin %50’sine kadar Fable kullanabilir ve Fable içeren planlar, abonelik süresine bağlı olarak bir ila üç kullanım sıfırlaması alır.
-
API: Claude Platform’da claude-fable-5-2 model kimliğini kullanın.
-
Bulut platformları: Amazon Web Services, Google Cloud ve Microsoft Azure’da kullanılabilir.
-
Mythos 5.2: Siber Doğrulama Programı veya Yaşam Bilimleri Doğrulama Programı aracılığıyla başvurun. Claude Enterprise müşterileri ayrıca Claude Security üzerinden kullanabilir.
Sıkı veri gereksinimleri olan işletmeler, Anthropic’in güvenlik izlemesini müşterinin kendi altyapısında depolanan veriler üzerinde çalıştıran ve sıfır veri saklama ile çalışan Enterprise Frontier Safeguards’ı kullanabilir. Diğer müşterilerde güvenlik izlemesi için 30 günlük veri saklama uygulanır.
Son Düşünceler
Claude Fable 5.2, Fable 5.1’e göre anlamlı bir adım. Daha ucuz, daha hızlı ve meşru işleri reddetme olasılığı daha düşük. Remote Labor Index, robotik ve FrontierCode’daki sıçramalar özellikle büyük.
Öte yandan, Opus 5.5 yarı fiyatına çoğu günlük iş için daha iyi bir değer olmaya devam ediyor. Fable 5.2 ile ilgili en ilginç şey verimlilik iddiaları olabilir: Eğer gerçekten düşük veya orta çabada Opus 5.5’in en iyi puanlarını yakalıyorsa, token başına prim hızla küçülür. Bunu kendi iş yüklerinizde test etmeye değer.
Claude ile bizzat çalışmak istiyorsanız, Yapay Zeka Uygulamaları Geliştirme eğitim yolu iyi bir başlangıç noktasıdır.







Bugün Anthropic, herkes için Fable 5.2’yi ve doğrulanmış kuruluşlar için Mythos 5.2’yi duyurdu. Temelde aynı model, ancak Fable sürümünde siber güvenlik ve biyoloji için ek güvenlik önlemleri bulunuyor.
Öne çıkan değişiklikler şunlar:
Daha somut olarak, Fable 5.2, Fable 5.1’den %20 daha ucuz, çıktıları %30’a kadar daha hızlı üretiyor ve Anthropic’in kıyaslama tablosundaki satırların çoğunda GPT-6 Astra ve Gemini 4 Carbon’u geride bırakıyor.
Bu yazıda, Fable 5.2 ve Mythos 5.2’de neler yeni, kıyaslamalardaki performansları, maliyetleri ve Claude Opus 5.5 yerine hangisini seçmeniz gerektiğine nasıl karar vereceğinizi ele alacağım.
Claude Fable 5.2 Nedir?
Claude Fable 5.2, Anthropic’in genel kullanıma sunulan en yetenekli modeli. Uzun, zorlu teknik işler için tasarlandı: büyük kod tabanı geçişleri, günler süren ajan çalışmaları, araştırma problemleri ve mühendislik tasarımı.
Fable 5.2 ayrıca daha küçük modellerle birlikte çalışabilir; zor sorunlarda danışılan bir danışman olarak veya daha basit alt görevleri onlara devreden bir orkestratör olarak.
Fable 5.2, selefinin 1M token bağlam penceresini ve 128K maksimum çıktısını koruyor; bilgi kesimi Haziran 2026’dır.
Claude Mythos 5.2 Nedir?
Claude Mythos 5.2, çoğu siber güvenlik çalışmasını ve araştırma düzeyinde biyoloji çalışmalarını engelleyen güvenlik önlemleri olmayan, Fable 5.2 ile aynı modeldir. Aslında Mythos 5.2, Anthropic’in siber güvenlik mühendisliği için en yetenekli modelidir. Bu tür yetenekler çift kullanımlı olduğundan, Anthropic Mythos 5.2’yi yalnızca Siber Doğrulama Programı ve Yaşam Bilimleri Doğrulama Programı aracılığıyla doğrulanmış kuruluşlara sunuyor.
Claude Fable 5.2’de Neler Yeni?
Fable yalnızca Haziran’da, Anthropic’in Fable 5’i yayımlamasıyla hayatımıza girdi. O zamandan beri iki nokta sürümü geldi: Eylül’de Fable 5.1 ve şimdi Fable 5.2; her ikisi de çok fazla yeni özellik eklemedi. Çoğunlukla modeli daha ucuz, daha hızlı ve daha güçlü hale getirdiler; performans kazanımları da küçük değil: Örneğin Fable 5.2, Remote Labor Index’te Fable 5.1’in puanını ikiye katlıyor.
İki sürüm arasındaki asıl fark, modeli nasıl kullanmanıza izin verildiğinde. Fable 5.1 ile Anthropic siber güvenlik önlemlerini daralttı ve modeli yazılım açıklarını bulmak için kullanmaya izin vermeye başladı, ancak bu açıklar için exploit yazmaya izin vermedi; ayrıca sürümle birlikte verilerinizi kendi bulutunuzda tutma seçeneği olan Enterprise Frontier Safeguards’ı duyurdu. Fable 5.2’deki güvenlik önlemi değişiklikleri ise daha küçük: daha az isteği engelliyor, ancak aynı tür görevler hâlâ yasak.
Onu kullanmanın önerilen yeni yolları, örneğin Fable 5.2’nin daha küçük Claude modellerine danışmanlık yapması, aslında yeni değil; çünkü Anthropic’in danışman aracı zaten Fable 5 ve 5.1’i destekliyordu. Lansman demoları da, boş bir klasörden işletim sistemi kurmak gibi, açıp kapatabileceğiniz yeni özellikler değil; daha güçlü bir modelin daha zor şeyleri yaptığını gösteriyor.
Yine de, yeni şeylere işaret edeceksem, şunları anabilirim:
Daha düşük fiyat
Fable 5.2, milyon başına giriş token’ı için 8 ABD doları ve milyon başına çıkış token’ı için 40 ABD doları; Fable 5.1’in 10/50 ABD dolarından %20 daha az. Aynı %20’lik indirim önbellek okumalarına (0,20 ABD doları), önbellek yazımlarına ve toplu işleme de uygulanıyor. Tam döküm için aşağıdaki fiyatlandırma bölümüne bakın.
Daha hızlı çıktı ve Fable için hızlı mod
Çıktı, Fable 5.1’e göre %30’a kadar daha hızlı; bu da uzun bir ajan çalışmasında birikir. Fable artık hızlı modu da destekliyor; bu mod, fiyatı iki katına çıkarırken (16/80 ABD doları) çıktıyı 2,5 kata kadar hızlandırıyor.
Daha az çabayla daha iyi sonuçlar
Faturanızı en çok etkilemesi muhtemel değişiklik bu. Yüksek çabada, Fable 5.2 FrontierCode 2.0’da %45,3 puan alıyor; yaklaşık yarı maliyetle Opus 5.5’in en iyi puanına yakın. Düşük çabada ise Humanity’s Last Exam’de Opus 5.5’in en iyi puanını, görev başına maliyetin onda birinden daha azıyla yakalıyor. Benim yorumum: Opus 5.5’ten yükseliyorsanız, Fable 5.2’yi daha düşük çaba düzeyinde başlatın.
Daha az engellenen istek
Fable 5.2, Fable 5.1’e kıyasla yaklaşık %55 daha az güvenlik engeliyle karşılaşmalı (siber güvenlikte yaklaşık %60, biyolojide %40 daha az). Fable 5.1’in reddetmeleri işinizi engelliyorsa bu önemli, ancak engellenen kategoriler değişmedi: sızma testleri, exploit üretimi ve araştırma düzeyindeki biyolojinin çoğu hâlâ daha eski Claude modellere devrediliyor.
Claude Fable 5.2 Kıyaslamalarda Nasıl Performans Gösteriyor?
İşte başlıca sonuçlar. Hepsi Anthropic’in lansman tablosundan geldiği için bunları bağımsız sonuçlar yerine model için Anthropic’in argümanı olarak okuyun. Claude puanları güvenlik önlemleri açıkken alındı. Aksi belirtilmedikçe, her model en yüksek mevcut çaba düzeyinde gösterilmiştir.
Ajan temelli kodlama
Fable 5.2, tablodaki her iki kodlama kıyaslamasında da lider. Açık kaynak bakıcılarının bir modelin kod değişikliklerini birleştirip birleştirmeyeceğini ölçen FrontierCode 2.0’da %49,1 puanla tablonun en yükseğinde ve Fable 5.1’in %32,4’ünün oldukça üzerinde. FrontierSWE v2’de %69,9 puanla GPT-6 Astra (%65,5) ve Opus 5.5’in (%62,3) önünde.
Lansman örnekleri de aynı yönde: Fable 5.2’nin erken bir sürümünü çalıştıran ajanlar, üretimdeki bir hizmeti Python’dan Rust’a taşıdı ve artık yaklaşık 26 kat daha hızlı başlıyor.
Bilgi çalışması ve araştırma
En büyük göreli sıçrama, bir modelin serbest çalışmaya benzeyen gerçek projeleri ne kadar iyi tamamladığını ölçen Remote Labor Index’te. Fable 5.2, %41,3 puanla Opus 5.5’i (%21,3) ve GPT-6 Astra’yı (%20,8) kabaca ikiye katlıyor. Ayrıca araçlarla Humanity’s Last Exam’de (%74,2) ve Terminal-Bench-Science’da (%74,6; Mythos 5.2 için %75,3) lider.
Geri kaldığı tek alan iş otomasyonu. AutomationBench’te Gemini 4 Carbon %53,9 puan alırken Fable 5.2 %51,4’te kalıyor; yine de Fable 5.1’in (%31,4) çok ilerisinde.
Ana tablonun dışında, Fable 5.2 donanım mühendisliği kıyaslaması BenchCAD 2.1’de 83,5 puan aldı; Opus 5.5 için bu puan 65,3’tü. Ayrıca kara delik fiziğinde iki açık problemi çözmekle de kredilendiriliyor ve bu sonuçlar diğer fizikçilerin kontrol edebilmesi için ön baskı olarak paylaşıldı.
Bilgisayar kullanımı, robotik ve görme
Fable 5.2, OSWorld 2.1’de %89,3 puan alarak Opus 5.5’i (%87,2) ve GPT-6 Astra’yı (%79,5) geçti. Robotikteki sıçrama tablodaki en büyük: RoboDojo Sim’de %64,9; Fable 5.1 ve GPT-6 Astra’nın iki katından fazla. Araçsız grafik okuma testi olan Chartography’de de, Fable 5.1’in %44,8 ile geride kalmasının ardından, Gemini 4 Carbon ve GPT-6 Astra’yı kıl payı geride bırakıyor.
Siber güvenlik ve biyoloji (Mythos 5.2)
Güvenlik ve biyoloji satırları Mythos 5.2’ye ait; çünkü Fable 5.2’nin güvenlik önlemleri bu görevlerin çoğunu engelliyor. Mythos 5.2, CyScenarioBench’te %76,3 (Mythos 5.1 için %61,7’ye karşı), CVE Rediscovery’de %89,6 (%78,3’e karşı) ve 24 saatlik protein bağlayıcı tasarım görevinde %85,1 (%79,1’e karşı) puan alıyor. Burada OpenAI’nin güvenlik modeliyle adil bir karşılaştırma yok; çünkü her laboratuvar kendi CyScenarioBench görevlerini çalıştırdı.
Fermat’ın Son Teoremi Ne Alaka?
Bir Fable 5.2 ajan ekibi, Fermat’ın Son Teoremi’nin ispatını 30 saatte Lean ispat asistanında biçimselleştirdi. Şunu merak ediyor olabilirsiniz: Teorem zaten üç on yıl önce ispatlanmadı mı; peki geriye ne kaldı?
Teorem eski haber
Fermat’ın Son Teoremi, 2’den büyük herhangi bir n için an + bn = cn denklemini sağlayan pozitif tam sayılar a, b ve c olmadığını söyler. n = 2 için pek çok çözüm vardır; örneğin 32 + 42 = 52 (9 + 16 = 25). Ancak küpleri deneyin, yalnızca ıskalamalar elde edersiniz: 63 + 83 = 728, 93 = 729’un bir eksiği.
Pierre de Fermat 1637’de bir ispat iddia etti ama yazıya dökmedi ve konu, Andrew Wiles’ın Richard Taylor’ın yardımıyla 1990’ların ortasında ispatlayana kadar 350 yıldan uzun süre çözülemedi.
Lean biçimselleştirmesi nedir
Wiles’ın ispatı 100 sayfayı aşıyor ve onlarca yıllık ileri sayı teorisine dayanıyor; bu nedenle çok az kişi baştan sona kontrol edebiliyor. Lean bir ispat asistanıdır: İspatı kod olarak yazdığınız bir programlama dili; yazılım, matematiğin temel aksiyomlarına kadar her mantıksal adımı denetler. Eğer ispat derlenirse doğrudur. Bir teoremi “biçimselleştirmek”, insan tarafından yazılmış ispatı bu makine tarafından denetlenebilir forma çevirmek demektir.
Fermat’ın Son Teoremi için bu devasa bir iştir; çünkü ispatın dayandığı matematiğin çoğu Lean’de hiç yazılmamıştı. Matematikçi Kevin Buzzard, bunu yapmak için 2024’te bir topluluk projesi başlattı.
Bir yapay zekâ modeli için neden ilginç
Çoğu yapay zekâ çıktısı insanlar tarafından ya da yalnızca cevabın bir kısmını test eden kıyaslamalarla değerlendirilir. Lean ispatı farklıdır: denetleyici ya her adımı kabul eder ya da etmez; bu yüzden ince ince yanlış olmanın yolu yoktur. Bu, bir modelin çok uzun ve çok zor bir projeyi doğrulanmış bir sona taşıyıp taşıyamadığının olağanüstü temiz bir testi olur.
Bu, Claude’un bunu ilk yapışı değil. Eylül’de Anthropic, onlarca ajanın Fable 5.1’e kabaca denk dahili bir araştırma modeliyle yazdığı ilk eksiksiz, bilgisayarla denetlenmiş ispatı yayımladı. O çalışma 11 gün sürdü ve yaklaşık altı milyar çıkış token’ı, 13 milyon satır Lean üretti ve kısmen Buzzard’ın projesinin parçaları üzerine inşa edildi. Fable 5.2 bunu 30 saatte, asgari insan yardımıyla yaptı.
Çekinceler
Ancak en çarpıcı olan, Anthropic aynı işi Claude Opus 5.5’e verdiğinde olanlar.
Claude Fable 5.2 vs. Claude Opus 5.5
İki modeli karşılaştırmak genellikle kıyaslama puanlarını okumak ve pratikte farkın nasıl görüneceğini çıkarsamaya çalışmak demektir. Bu kez, aradaki farkı daha belirgin kılan bir hikâyeyle başlamasını takdir ediyorum.
Aynı 1.000 ajanlık Lean kurulumunda Opus 5.5, 18 saatte Fermat’ın Son Teoremi ispatının %26’sını tamamladı ve sonrasında zar zor ilerledi. Fable 5.2 ise tamamını 30 saatte bitirdi. Çıkarım: Çok uzun, çok ajanlı projelerde Opus 5.5 takılabilirken Fable 5.2 ilerlemeye devam ediyor.
Daha kısa görevlerde fark daha küçük. İşte yan yana karşılaştırma:
Bu desen, Lean sonucuyla uyumlu. Bilgisayar kullanımı ve kodlamada Fable 5.2 yalnızca birkaç puan önde. Ucu açık, çok adımlı işlerde ise fark büyüyor: Fable 5.2, Remote Labor Index’te serbest proje tarzı görevlerde Opus 5.5’in puanını neredeyse ikiye katlıyor ve robot kontrolünde 25 puan fark atıyor.
Fiyat, göründüğü kadar büyük bir fark değil. Fable 5.2, token başına iki kat daha pahalı, ancak sıklıkla daha düşük çaba düzeyinde Opus 5.5’in en iyi puanına ulaşabiliyor ve daha az token kullanıyor. Örneğin FrontierCode 2.0’da, Fable 5.2 yüksek çabada, görev başına maliyetin yaklaşık yarısında Opus 5.5’in en iyisini kabaca yakalıyor.
Dolayısıyla, Opus 5.5 hâlâ çoğu günlük iş için mantıklı varsayılandır. Ancak bir görev saatlerce sürüyorsa, çok sayıda ajan içeriyorsa veya Opus üzerinde sürekli takılıyorsa, Fable 5.2 muhtemelen bitirecektir ve token başına fiyatın işaret ettiğinden daha pahalıya da gelmeyebilir.
Güvenlik ve Sınırlar
Anthropic, bu modellerin yüksek riskli durumlarda güvensiz davranma riskini düşük olarak değerlendiriyor.
Dışarıdan bunu doğrulamak zor, bu yüzden daha somut sayılar faydalı. Yaklaşık 1.900 senaryoluk otomatik bir davranış denetiminde, Mythos 5.2 karşılaştırılan modeller arasında en düşük hizasız davranış puanına sahipti. Girdileri halüsinasyon görme, bir görevin tamamlandığını asılsız iddia etme veya kötü işi gizleme olasılığı da daha düşüktü.
Bahsedilen ve bilmeye değer, düşündürücü bazı başka noktalar da var:
Hangi Claude Modelini Kullanmalısınız?
Benim önerim Anthropic’inkiyle aynı: Opus 5.5 ile başlayın ve yalnızca ihtiyaç duyduğunuzda yükseltin. Dizilim şöyle ayrışıyor:
Claude Fable 5.2 Fiyatlandırma ve Kullanılabilirlik
Az önce Fable 5.2’nin listelenen her ölçütte Fable 5.1’i geçtiğini gösteren bir tabloya bakmıştık. Şimdi de Fable 5.2’nin 5.1’den daha ucuz olduğunu gösteren bir tablo gösteriyorum. O hâlde Fable 5.1 modası geçti mi?
Yeni işler için, fiilen evet. Fable 5.2’ye erişiminiz varsa, 5.1 üzerinde yeni bir şeye başlamanız için pek az neden var. Yine de Anthropic bunun için bir emeklilik tarihi duyurmadı ve Fable 5.1’e göre ayarlanmış komutlar veya ajanları olan ekipler, geçmeden önce 5.2’yi test etmek isteyecek. Daha iyi puan alsa bile yeni bir sürümün farklı davranabileceğini biliyoruz.
Claude Fable 5.2’ye Nasıl Erişilir?
Claude uygulamaları: Fable 5.2, uygun ücretli planlarda mevcut. Lansman promosyonu olarak, Pro planları ve standart Ekip koltukları haftalık kullanım limitlerinin %50’sine kadar Fable kullanabilir ve Fable içeren planlar, abonelik süresine bağlı olarak bir ila üç kullanım sıfırlaması alır.
API: Claude Platform’da
claude-fable-5-2model kimliğini kullanın.Bulut platformları: Amazon Web Services, Google Cloud ve Microsoft Azure’da kullanılabilir.
Mythos 5.2: Siber Doğrulama Programı veya Yaşam Bilimleri Doğrulama Programı aracılığıyla başvurun. Claude Enterprise müşterileri ayrıca Claude Security üzerinden kullanabilir.
Sıkı veri gereksinimleri olan işletmeler, Anthropic’in güvenlik izlemesini müşterinin kendi altyapısında depolanan veriler üzerinde çalıştıran ve sıfır veri saklama ile çalışan Enterprise Frontier Safeguards’ı kullanabilir. Diğer müşterilerde güvenlik izlemesi için 30 günlük veri saklama uygulanır.
Son Düşünceler
Claude Fable 5.2, Fable 5.1’e göre anlamlı bir adım. Daha ucuz, daha hızlı ve meşru işleri reddetme olasılığı daha düşük. Remote Labor Index, robotik ve FrontierCode’daki sıçramalar özellikle büyük.
Öte yandan, Opus 5.5 yarı fiyatına çoğu günlük iş için daha iyi bir değer olmaya devam ediyor. Fable 5.2 ile ilgili en ilginç şey verimlilik iddiaları olabilir: Eğer gerçekten düşük veya orta çabada Opus 5.5’in en iyi puanlarını yakalıyorsa, token başına prim hızla küçülür. Bunu kendi iş yüklerinizde test etmeye değer.
Claude ile bizzat çalışmak istiyorsanız, Yapay Zeka Uygulamaları Geliştirme eğitim yolu iyi bir başlangıç noktasıdır.