आज, Anthropic ने सभी के लिए Fable 5.2 और सत्यापित संगठनों के लिए Mythos 5.2 की घोषणा की। ये एक ही आधारभूत मॉडल हैं, लेकिन Fable संस्करण में अतिरिक्त साइबरसुरक्षा और जैविकी सुरक्षा उपाय हैं।
मुख्य बदलाव हैं:
- कम कीमत,
- तेज़ आउटपुट, और
- Anthropic के सबसे कठिन बेंचमार्क पर बड़े उछाल।
विशेष रूप से, Fable 5.2 की कीमत Fable 5.1 से 20% कम है, यह आउटपुट को 30% तक तेज़ी से जनरेट करता है, और Anthropic की बेंचमार्क तालिका की अधिकांश पंक्तियों पर GPT-6 Astra और Gemini 4 Carbon को मात देता है।
इस लेख में, मैं बताऊंगा कि Fable 5.2 और Mythos 5.2 में क्या नया है, ये बेंचमार्क पर कैसा प्रदर्शन करते हैं, इनकी कीमत क्या है, और यह कैसे तय करें कि आपको इन्हें Claude Opus 5.5 पर प्राथमिकता देनी चाहिए या नहीं।
Claude Fable 5.2 क्या है?
Claude Fable 5.2 Anthropic का सबसे सक्षम, सामान्य रूप से उपलब्ध मॉडल है। इसे लंबे, चुनौतीपूर्ण तकनीकी कार्यों के लिए बनाया गया है: बड़े कोडबेस माइग्रेशन, कई दिनों तक चलने वाले एजेंट रन, शोध समस्याएँ, और इंजीनियरिंग डिज़ाइन।
Fable 5.2 छोटे मॉडलों के साथ मिलकर भी काम कर सकता है—या तो एक सलाहकार के रूप में, जिनसे वे कठिन समस्याओं पर परामर्श लें, या एक ऑर्केस्ट्रेटर के रूप में जो सरल उप-कार्य उन्हें सौंप दे।
Fable 5.2 अपने पूर्ववर्ती की तरह 1M-टोकन कॉन्टेक्स्ट विंडो और 128K अधिकतम आउटपुट बनाए रखता है, और इसका नॉलेज कटऑफ जून 2026 है।
Claude Mythos 5.2 क्या है?
Claude Mythos 5.2 वही मॉडल है जो Fable 5.2 है, लेकिन उन सुरक्षा उपायों के बिना जो अधिकांश साइबरसुरक्षा कार्यों और शोध-स्तरीय जैविकी कार्यों को ब्लॉक करते हैं। वास्तव में, Mythos 5.2 साइबरसुरक्षा इंजीनियरिंग के लिए Anthropic का सबसे सक्षम मॉडल है। क्योंकि इस तरह की क्षमताएँ द्वि-उपयोगी होती हैं, Anthropic Mythos 5.2 केवल अपने Cyber Verification Program और Life Sciences Verification Program के माध्यम से सत्यापित संस्थाओं को ही प्रदान करता है।
Claude Fable 5.2 में क्या नया है?
Fable जून से ही मौजूद है, जब Anthropic ने Fable 5 जारी किया था। तब से दो पॉइंट रिलीज़ आए हैं—सितंबर में Fable 5.1 और अब Fable 5.2—और दोनों में नई सुविधाएँ बहुत अधिक नहीं जोड़ी गईं। ज़्यादातर बदलाव मॉडल को सस्ता, तेज़ और मज़बूत बनाते हैं, हालांकि प्रदर्शन में उछाल छोटे नहीं रहे: उदाहरण के लिए, Fable 5.2 ने Remote Labor Index पर Fable 5.1 के स्कोर से दोगुने से भी अधिक अंक अर्जित किए हैं।
दोनों रिलीज़ के बीच बड़ा अंतर इस बात में है कि आप मॉडल का उपयोग कैसे कर सकते हैं। Fable 5.1 के साथ, Anthropic ने अपनी साइबरसुरक्षा सुरक्षा को संकुचित किया और मॉडल को सॉफ्टवेयर कमजोरियाँ खोजने के लिए उपयोग करने की अनुमति देना शुरू किया, हालांकि उनके लिए एक्सप्लॉइट लिखना अभी भी अनुमत नहीं था, और इसी के साथ Enterprise Frontier Safeguards—एक विकल्प जो आपके डेटा को आपकी ही क्लाउड में रखने देता है—की घोषणा भी की गई। Fable 5.2 की सुरक्षा में बदलाव छोटे हैं: यह कम अनुरोधों को ब्लॉक करता है, लेकिन वही प्रकार के कार्य अभी भी प्रतिबंधित हैं।
Anthropic द्वारा सुझाए गए नए उपयोग, जैसे छोटे Claude मॉडलों को Fable 5.2 से सलाह दिलवाना, भी वास्तव में नए नहीं हैं, क्योंकि Anthropic का advisor टूल पहले से Fable 5 और 5.1 को सपोर्ट करता था। और लॉन्च डेमो, जैसे खाली फ़ोल्डर से बनाया गया ऑपरेटिंग सिस्टम, नए चालू करने योग्य फ़ीचरों के बजाय सिर्फ़ एक मज़बूत मॉडल को कठिन काम करते हुए दिखाते हैं।
फिर भी, अगर मुझे नई बातों की ओर इशारा करना हो, तो मैं ये कहूंगा:
कम कीमत
Fable 5.2 की कीमत प्रति दस लाख इनपुट टोकन $8 और प्रति दस लाख आउटपुट टोकन $40 है, जो Fable 5.1 की $10/$50 से 20% कम है। यही 20% कटौती कैश रीड्स ($0.20), कैश राइट्स और बैच प्रोसेसिंग पर भी लागू होती है। पूरी जानकारी के लिए नीचे की प्राइसिंग सेक्शन देखें।
तेज़ आउटपुट, और Fable के लिए फास्ट मोड
आउटपुट Fable 5.1 से 30% तक तेज़ है, जो लंबे एजेंट रन में जोड़कर बड़ा फर्क डालता है। Fable अब फास्ट मोड को भी सपोर्ट करता है, जो आउटपुट को दोगुनी कीमत ($16/$80) पर अधिकतम 2.5x तक तेज़ कर देता है।
कम प्रयास पर बेहतर नतीजे
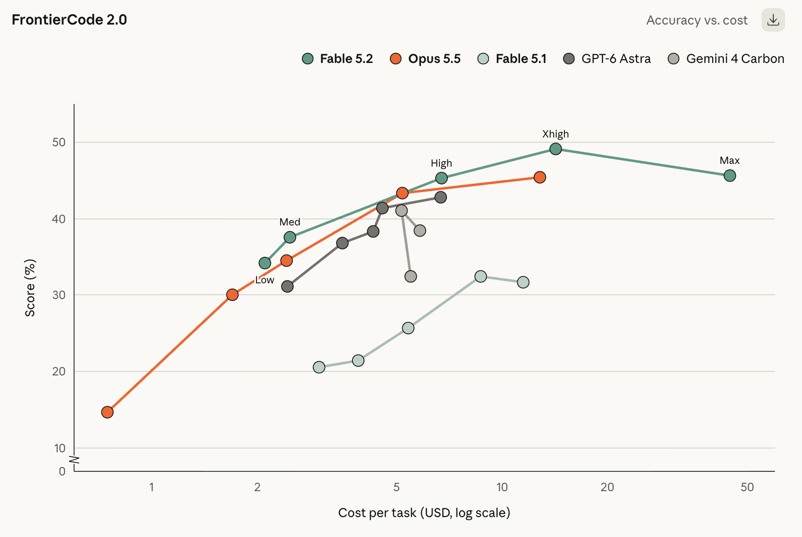
यह बदलाव आपके बिल को सबसे ज़्यादा प्रभावित कर सकता है। हाई एफर्ट पर, Fable 5.2 FrontierCode 2.0 पर 45.3% स्कोर करता है, जो Opus 5.5 के सर्वश्रेष्ठ स्कोर के बराबर है, और प्रति कार्य लगभग आधी लागत पर। लो एफर्ट पर, यह Humanity's Last Exam पर Opus 5.5 के टॉप स्कोर से मेल खाता है, और प्रति कार्य लागत का दसवां हिस्सा भी नहीं लगता। मेरा सुझाव: अगर आप Opus 5.5 से ऊपर आ रहे हैं, तो Fable 5.2 को कम एफर्ट लेवल से शुरू करें।
कम ब्लॉक हुए अनुरोध
Fable 5.2 को Fable 5.1 की तुलना में लगभग 55% कम सेफ्टी ब्लॉक्स का सामना करना चाहिए (साइबरसुरक्षा में लगभग 60% कम और जैविकी में 40% कम)। अगर Fable 5.1 की अस्वीकृतियाँ आपको रोक रही थीं, तो यह बड़ी बात है, लेकिन जो श्रेणियाँ ब्लॉक हैं, वे नहीं बदलीं: पेनिट्रेशन टेस्टिंग, एक्सप्लॉइट जनरेशन, और अधिकांश शोध-स्तरीय जैविकी अब भी पुराने Claude मॉडलों को सौंप दिए जाते हैं।
Claude Fable 5.2 बेंचमार्क पर कैसा करता है?
मुख्य नतीजे यहाँ हैं। ये सभी Anthropic की लॉन्च तालिका से आते हैं, इसलिए इन्हें स्वतंत्र नतीजों के बजाय मॉडल के पक्ष में Anthropic के तर्क के रूप में पढ़ें। Claude के स्कोर सुरक्षा उपाय चालू रखकर चलाए गए थे। जब तक अलग से उल्लेख न हो, हर मॉडल अपने उपलब्ध उच्चतम प्रयास स्तर पर दिखाया गया है।
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (agentic coding) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2 (agentic coding) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench (business workflows) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| OSWorld 2.1 (computer use) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| RoboDojo Sim (robotics) | 64.9% | 27.6% | 39.4% | 29.8% | Not reported |
| AA-Briefcase v1.1 (knowledge work) | 66.1% | 61.5% | 61.2% | 52.0% | 61.8% |
| Remote Labor Index (knowledge work) | 41.3% | 17.9% | 21.3% | 20.8% | Not reported |
| Humanity's Last Exam (with tools) | 74.2% | 65.6% | 67.7% | 57.2% | Not reported |
| WANDR (agentic search) | 82.1% | 68.7% | 72.3% | Not reported | Not reported |
| Chartography (no tools) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
एजेंटिक कोडिंग
तालिका के दोनों कोडिंग बेंचमार्क पर Fable 5.2 आगे है। FrontierCode 2.0 पर, जो मापता है कि क्या ओपन-सोर्स मेंटेनर किसी मॉडल के कोड बदलावों को मर्ज करेंगे, इसका स्कोर 49.1% है—तालिका में सबसे ऊँचा और Fable 5.1 के 32.4% से काफी ऊपर। FrontierSWE v2 पर, यह 69.9% स्कोर करता है, जो GPT-6 Astra (65.5%) और Opus 5.5 (62.3%) से आगे है।
लॉन्च के उदाहरण भी यही दिशा दिखाते हैं: Fable 5.2 के एक शुरुआती संस्करण पर चल रहे एजेंटों ने एक प्रोडक्शन सेवा को Python से Rust में माइग्रेट किया, और अब यह लगभग 26 गुना तेज़ शुरू होती है।
नॉलेज वर्क और रिसर्च
सबसे बड़ा सापेक्ष उछाल Remote Labor Index पर है, जो मापता है कि कोई मॉडल वास्तविक फ्रीलांस-शैली की परियोजनाएँ कितनी अच्छी तरह पूरी करता है। Fable 5.2 का स्कोर 41.3% है, जो Opus 5.5 (21.3%) और GPT-6 Astra (20.8%) से लगभग दोगुना है। यह टूल्स के साथ Humanity's Last Exam (74.2%) और Terminal-Bench-Science (74.6%, या Mythos 5.2 के लिए 75.3%) पर भी अग्रणी है।
व्यवसाय ऑटोमेशन एक क्षेत्र है जहाँ यह पिछड़ता है। AutomationBench पर, Gemini 4 Carbon का स्कोर 53.9% है, जबकि Fable 5.2 का 51.4%—हालाँकि Fable 5.2 अब भी Fable 5.1 (31.4%) से बहुत आगे है।
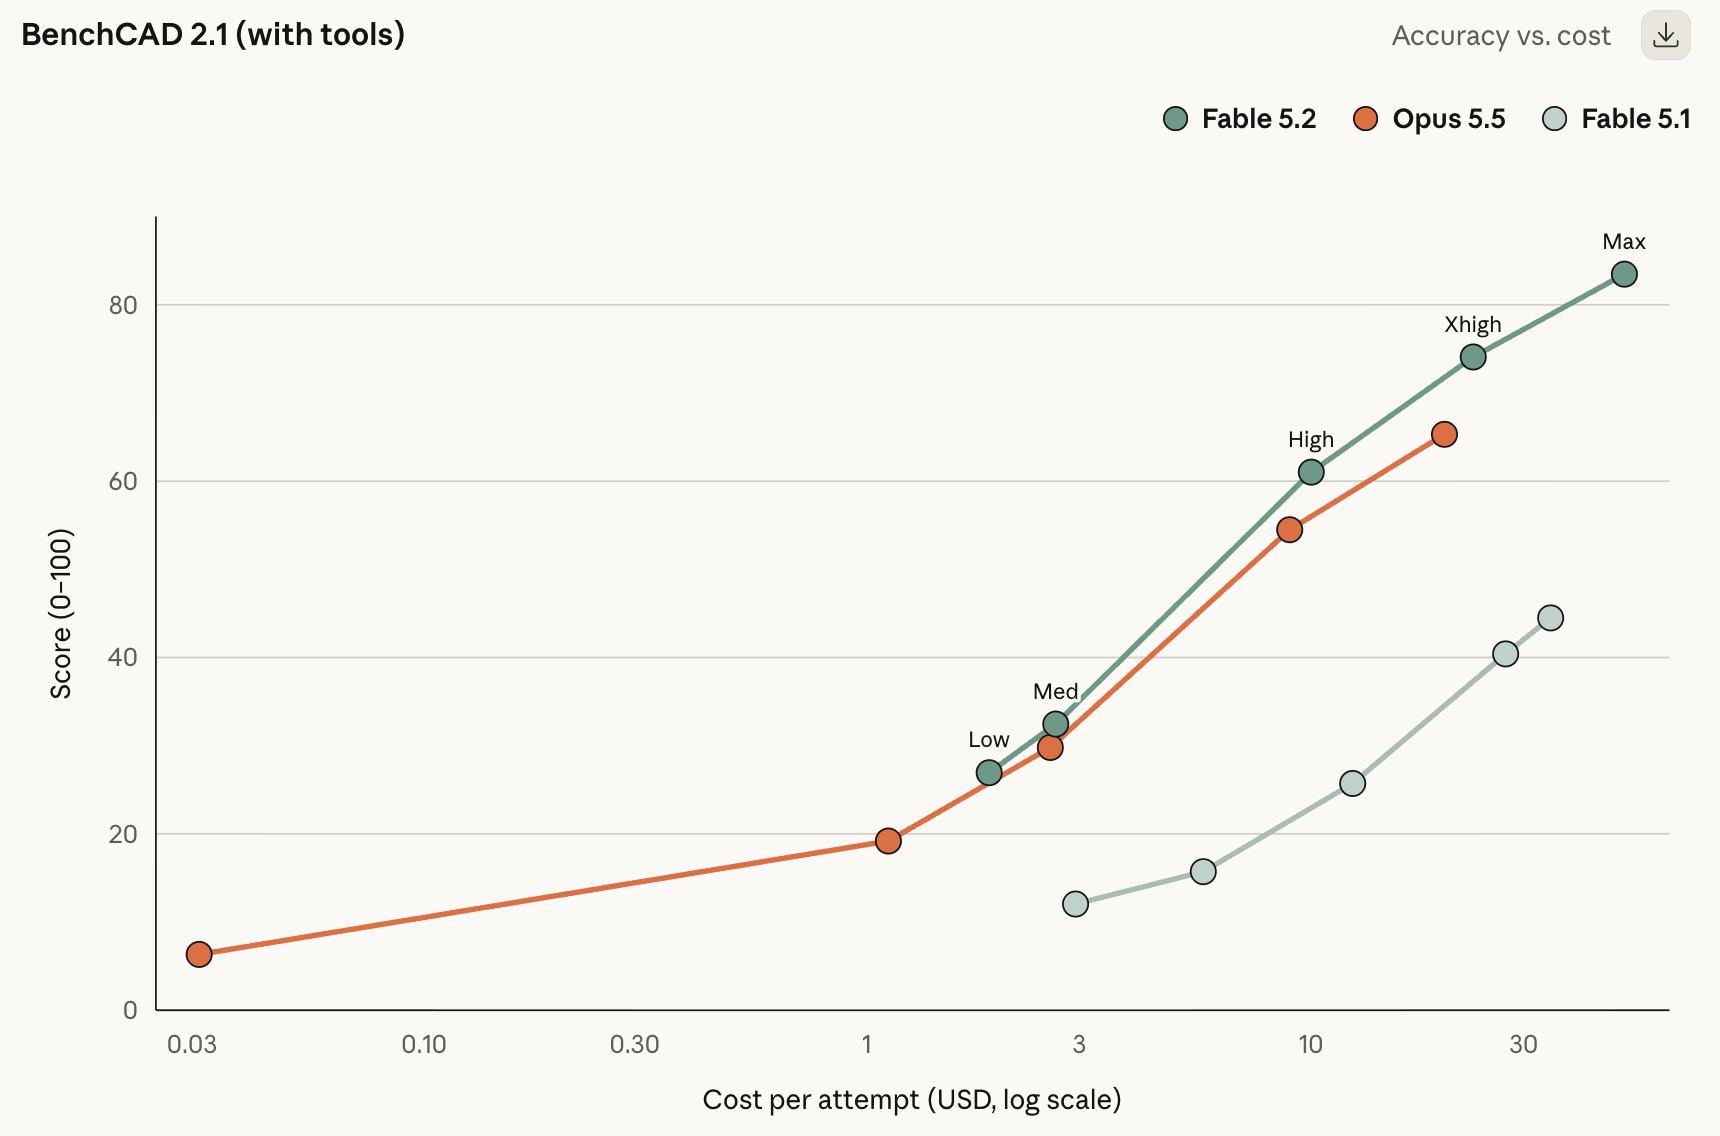
मुख्य तालिका से बाहर, Fable 5.2 ने BenchCAD 2.1 हार्डवेयर-इंजीनियरिंग बेंचमार्क पर 83.5 स्कोर किया, जबकि Opus 5.5 ने 65.3। इसे ब्लैक-होल भौतिकी की दो ओपन समस्याएँ हल करने का श्रेय भी दिया गया है, और वे नतीजे ऐसे प्री-प्रिंट्स के रूप में पोस्ट किए गए हैं जिन्हें अन्य भौतिकविद जाँच सकते हैं।
कंप्यूटर उपयोग, रोबोटिक्स, और विज़न
Fable 5.2 का OSWorld 2.1 पर स्कोर 89.3% है, जो Opus 5.5 (87.2%) और GPT-6 Astra (79.5%) से आगे है। रोबोटिक्स में इसका उछाल तालिका में सबसे बड़ा है: RoboDojo Sim पर 64.9%, जो Fable 5.1 और GPT-6 Astra से दोगुने से भी अधिक है। Chartography पर, जो बिना टूल के चार्ट पढ़ने की जाँच करता है, यह Gemini 4 Carbon और GPT-6 Astra से थोड़ा आगे निकल जाता है, जबकि Fable 5.1 44.8% पर काफी पीछे था।
साइबरसुरक्षा और जैविकी (Mythos 5.2)
सुरक्षा और जैविकी से संबंधित पंक्तियाँ Mythos 5.2 के लिए हैं, क्योंकि Fable 5.2 के सुरक्षा उपाय इनमें से अधिकांश कार्यों को ब्लॉक करते हैं। Mythos 5.2 CyScenarioBench पर 76.3% (vs 61.7% Mythos 5.1), CVE Rediscovery पर 89.6% (vs 78.3%), और 24-घंटे के प्रोटीन बाइंडर डिज़ाइन कार्य पर 85.1% (vs 79.1%) स्कोर करता है। यहाँ OpenAI के सुरक्षा मॉडल के साथ कोई निष्पक्ष तुलना नहीं है, क्योंकि हर लैब ने अपनी-अपनी CyScenarioBench टास्क्स चलाईं।
Fermat's Last Theorem की बात क्या है?
Fable 5.2 एजेंटों की एक टीम ने 30 घंटों में Lean प्रूफ़ असिस्टेंट में Fermat's Last Theorem के प्रूफ़ का औपचारिक रूप बनाया। आप सोच सकते हैं: यह प्रमेय तो तीन दशक पहले सिद्ध हो चुका है, तो अब करने को क्या बचा?
प्रमेय पुरानी खबर है
Fermat's Last Theorem कहता है कि कोई भी धनात्मक पूर्णांक a, b, और c ऐसे नहीं हैं कि an + bn = cn हो किसी भी n के लिए जो 2 से बड़ा हो। n = 2 पर बहुत से हल हैं, जैसे 32 + 42 = 52 (9 + 16 = 25)। लेकिन घनों पर कोशिश करें तो सिर्फ़ करीब-करीब चूक मिलती है: 63 + 83 = 728, जो 93 = 729 से एक कम है।
Pierre de Fermat ने 1637 में एक प्रूफ़ का दावा किया था लेकिन उसे कभी लिखा नहीं, और यह 350 साल से ज़्यादा अनसुलझा रहा, जब तक कि Andrew Wiles ने 1990 के दशक के मध्य में, Richard Taylor की मदद से, इसे सिद्ध नहीं कर दिया।
Lean औपचारिककरण क्या होता है
Wiles का प्रूफ़ 100 से अधिक पृष्ठों का है और दशकों की उन्नत संख्या सिद्धांत पर आधारित है, इसलिए बहुत कम लोग इसे शुरू से अंत तक जाँच सकते हैं। Lean एक प्रूफ़ असिस्टेंट है: एक प्रोग्रामिंग भाषा जिसमें आप प्रूफ़ को कोड के रूप में लिखते हैं, और सॉफ़्टवेयर हर तार्किक चरण की जाँच करता है, गणित के बुनियादी स्वयंसिद्धों तक। अगर प्रूफ़ कम्पाइल हो जाता है, तो वह सही है। किसी प्रमेय का "औपचारिककरण" करने का मतलब है मानव-लिखित प्रूफ़ को इस मशीन-चेक योग्य रूप में अनुवादित करना।
Fermat's Last Theorem के लिए यह बहुत बड़ा काम है, क्योंकि जिस गणित पर प्रूफ़ निर्भर करता है, उसका बहुत सा हिस्सा पहले Lean में लिखा ही नहीं गया था। गणितज्ञ Kevin Buzzard ने 2024 में इसे करने के लिए एक सामुदायिक परियोजना शुरू की।
AI मॉडल के लिए यह रुचिकर क्यों है
अधिकांश AI आउटपुट का आकलन लोग करते हैं या ऐसे बेंचमार्क करते हैं जो उत्तर के सिर्फ़ एक हिस्से की जाँच करते हैं। Lean प्रूफ़ अलग है: चेकर या तो हर कदम को स्वीकार करता है या नहीं करता, इसलिए चुपचाप गलत होने का रास्ता नहीं है। यह असामान्य रूप से साफ़-सुथरा परीक्षण बन जाता है कि कोई मॉडल बहुत लंबी, बहुत कठिन परियोजना को सत्यापित समापन तक ले जा सकता है या नहीं।
यह पहली बार नहीं है जब Claude ने ऐसा किया। सितंबर में, Anthropic ने प्रमेय का पहला पूर्ण, कंप्यूटर-चेक्ड प्रूफ़ प्रकाशित किया, जो दर्जनों एजेंटों ने एक आंतरिक रिसर्च मॉडल पर लिखा था, जो मोटे तौर पर Fable 5.1 के तुलनीय था। उस प्रयास में 11 दिन और लगभग छह अरब आउटपुट टोकन लगे, 1.3 करोड़ पंक्तियों का Lean कोड बना, और आंशिक रूप से Buzzard की परियोजना के हिस्सों पर आधारित था। Fable 5.2 ने यह 30 घंटों में, न्यूनतम मानवीय मदद के साथ किया।
एहतियातें
- यह गणित में कुछ नया नहीं जोड़ता। Buzzard ने Anthropic के पहले औपचारिककरण के बारे में भी यही कहा था।
- Fable 5.2 को प्रगति ट्रैक करने के लिए मध्यवर्ती प्रमेय कथनों की सूची दी गई थी। यह क्या-क्या सिद्ध करना है, उसका रोडमैप है—कैसे सिद्ध करना है, यह नहीं।
- मुझे अभी तक नए प्रूफ़ की कोई बाहरी समीक्षा नहीं मिली, इसलिए फिलहाल, 30 घंटे का आँकड़ा और Opus 5.5 की तुलना Anthropic के दावे हैं।
सबसे बताने वाली बात, हालांकि, यह है कि जब Anthropic ने Claude Opus 5.5 को वही काम दिया, तो क्या हुआ।
Claude Fable 5.2 बनाम Claude Opus 5.5
दो मॉडलों की तुलना आम तौर पर बेंचमार्क स्कोर पढ़ने और यह अंदाज़ा लगाने का मतलब होता है कि व्यवहार में फर्क कैसा दिखेगा। इस बार, मुझे अच्छा लगा कि Anthropic ने एक कहानी से शुरुआत की, जिससे अंतर ज़्यादा साफ़ दिखता है।
उसी 1,000-एजेंट Lean सेटअप में, Opus 5.5 ने 18 घंटों में Fermat's Last Theorem के प्रूफ़ का 26% पूरा किया और उसके बाद मुश्किल से ही कोई प्रगति हुई। Fable 5.2 ने पूरा काम 30 घंटों में पूरा कर दिया। निष्कर्ष: बहुत लंबी, बहु-एजेंट परियोजनाओं पर, जहाँ Opus 5.5 अटक सकता है, Fable 5.2 आगे बढ़ता रहता है।
छोटे कार्यों पर, अंतर कम है। दोनों की साइड-बाय-साइड तुलना यूँ है:
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| कीमत (1M टोकन प्रति इनपुट / आउटपुट) | $8 / $40 | $4 / $20 |
| कॉन्टेक्स्ट विंडो / अधिकतम आउटपुट | 1M / 128K | 1M / 128K |
| FrontierCode 2.0 (agentic coding) | 49.1% | 45.5% |
| FrontierSWE v2 (agentic coding) | 69.9% | 62.3% |
| OSWorld 2.1 (computer use) | 89.3% | 87.2% |
| AutomationBench (business workflows) | 51.4% | 42.5% |
| Humanity's Last Exam (with tools) | 74.2% | 67.7% |
| Remote Labor Index (knowledge work) | 41.3% | 21.3% |
| RoboDojo Sim (robotics) | 64.9% | 39.4% |
पैटर्न Lean के परिणाम से मेल खाता है। कंप्यूटर उपयोग और कोडिंग पर, Fable 5.2 केवल कुछ अंकों से आगे है। खुले-समाप्त, बहु-चरणीय कार्यों पर बढ़त बढ़ती है: Remote Labor Index की फ्रीलांस-शैली परियोजनाओं में Fable 5.2 का स्कोर Opus 5.5 का लगभग दोगुना है, और रोबोट नियंत्रण में यह 25 अंक आगे है।
कीमत उतना बड़ा अंतर नहीं है जितना दिखता है। Fable 5.2 प्रति टोकन दोगुना महंगा है, लेकिन यह अक्सर कम प्रयास स्तर पर ही Opus 5.5 के सर्वश्रेष्ठ स्कोर तक पहुँच सकता है, यानी कम टोकन इस्तेमाल होते हैं। उदाहरण के लिए FrontierCode 2.0 पर, हाई एफर्ट पर Fable 5.2, Opus 5.5 के सर्वश्रेष्ठ के लगभग बराबर है और प्रति कार्य लगभग आधी लागत पर।
तो Opus 5.5 अभी भी अधिकांश रोज़मर्रा के काम के लिए समझदारी भरा डिफॉल्ट है। लेकिन अगर कोई कार्य घंटों चलता है, कई एजेंट शामिल हैं, या Opus पर बार-बार अटकता है, तो Fable 5.2 के इसे पूरा करने की संभावना ज़्यादा है—और इसकी लागत प्रति-टोकन कीमत जितनी नहीं बढ़ सकती।
सुरक्षा और सीमाएँ
Anthropic के अनुसार, उच्च-दांव वाली स्थितियों में इन मॉडलों के असुरक्षित व्यवहार करने का जोखिम कम है।
इसे बाहर से जाँचना कठिन है, इसलिए ठोस आँकड़े उपयोगी हैं। लगभग 1,900 परिदृश्यों के एक स्वचालित व्यवहार ऑडिट में, तुलना किए गए मॉडलों में Mythos 5.2 का गलत-संरेखित-व्यवहार स्कोर सबसे कम था। यह इनपुट्स को भ्रमित करने, झूठा दावा करने कि कार्य पूरा हो गया, या खराब काम छिपाने की संभावना भी कम थी।
कुछ और रुचिकर बातें भी हैं जिनका उल्लेख किया गया है, जो जानने योग्य हैं और सोचने पर मजबूर करती हैं:
- मूल्यांकन-जागरूकता: Fable 5.2 और Mythos 5.2 दोनों कहते हैं कि उन्हें पहले के मॉडलों की तुलना में अधिक बार संदेह होता है कि उनका परीक्षण किया जा रहा है, जिससे ऊपर जैसा मूल्यांकन भरोसेमंद करना कठिन हो जाता है।
- जानबूझकर सीमित AI रिसर्च कौशल: Anthropic ने दो क्षेत्रों—एक्सेलेरेटर कर्नेल ऑप्टिमाइज़ेशन और LLM आर्किटेक्चर में सुधार—में मॉडलों की बढ़त को सीमित किया, ताकि वहाँ वे लगभग Opus 5.5 के स्तर पर प्रदर्शन करें।
- डिस्टिलेशन सुरक्षा: Fable 5.2 में अब तक के सबसे मज़बूत एंटी-डिस्टिलेशन उपाय हैं, और "preserved thinking," जो API उपयोगकर्ताओं को मॉडल के रीज़निंग को निकालने के लिए पहले के संदर्भ को संपादित करने से रोकता है, अब सभी खातों पर लागू होता है।
आप किस Claude मॉडल का उपयोग करें?
मेरा सुझाव Anthropic से मेल खाता है: Opus 5.5 से शुरू करें और ज़रूरत होने पर ही ऊपर जाएँ। लाइनअप इस तरह टूटता है:
- Claude Opus 5.5 ($4/$20): अधिकांश कोडिंग, रिसर्च, और नॉलेज वर्क के लिए डिफॉल्ट। यह प्रति टोकन Fable 5.2 की आधी कीमत है और कई बेंचमार्क पर क़रीब है।
- Claude Fable 5.2 ($8/$40): सबसे कठिन समस्याओं, लंबे बहु-एजेंट रन, और ऐसे कार्यों के लिए जहाँ Opus 5.5 अटकता है, जैसे बड़े माइग्रेशन, शोध-स्तरीय तर्क, या हार्डवेयर डिज़ाइन। अधिकतम प्रयास मानने से पहले इसे कम प्रयास स्तरों पर आज़माएँ।
- Claude Mythos 5.2: सत्यापित सुरक्षा टीमों और जीवन-विज्ञान शोधकर्ताओं के लिए, जिन्हें ऐसी क्षमताएँ चाहिए जिन्हें Fable 5.2 के सुरक्षा उपाय ब्लॉक करते हैं।
- Claude Sonnet 5.5 और Haiku 5.5: उच्च-वॉल्यूम, सरल, या कम-विलंबता वाले कार्यों के लिए, या छोटे मॉडल के रूप में जिन्हें Fable 5.2 ऑर्केस्ट्रेट करता है।
Claude Fable 5.2 की कीमत और उपलब्धता
| 1M टोकन प्रति | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| इनपुट | $8 | $10 | $4 |
| आउटपुट | $40 | $50 | $20 |
| कैश रीड्स | $0.20 | $0.25 | $0.20 |
| 5-मिनट कैश राइट्स | $10 | $12.50 | $5 |
| बैच (इनपुट / आउटपुट) | $4 / $20 | $5 / $25 | $2 / $10 |
| फास्ट मोड (इनपुट / आउटपुट) | $16 / $80 | Not listed | $8 / $40 |
अभी हमने एक तालिका देखी जिसमें बेंचमार्क नतीजे दिखा रहे थे कि Fable 5.2, Fable 5.1 को हर सूचीबद्ध चीज़ पर पछाड़ता है। अब, मैं आपको एक तालिका दिखा रहा हूँ जिसमें Fable 5.2, 5.1 से सस्ता है। तो क्या Fable 5.1 अप्रचलित हो गया?
नए काम के लिए, व्यवहार में हाँ। यदि आपके पास Fable 5.2 की पहुँच है, तो 5.1 पर कुछ नया शुरू करने का बहुत कम कारण है। हालाँकि, Anthropic ने अभी इसके रिटायरमेंट की तारीख़ की घोषणा नहीं की है, और वे टीमें जिनके प्रॉम्प्ट या एजेंट Fable 5.1 पर ट्यून हैं, स्विच करने से पहले 5.2 का परीक्षण करना चाहेंगी। हमें पता है कि नया संस्करण बेहतर स्कोर करते हुए भी अलग तरह से व्यवहार कर सकता है।
Claude Fable 5.2 तक पहुँच कैसे पाएँ
-
Claude ऐप्स: Fable 5.2 योग्य पेड प्लान्स पर उपलब्ध है। लॉन्च प्रमोशन के रूप में, Pro प्लान्स और स्टैंडर्ड Team सीट्स अपनी साप्ताहिक उपयोग-सीमाओं के 50% तक Fable का उपयोग कर सकते हैं, और जिन प्लान्स में Fable शामिल है उन्हें सदस्यता अवधि के आधार पर एक से तीन उपयोग रीसेट मिलते हैं।
-
API: Claude Platform पर मॉडल ID claude-fable-5-2 का उपयोग करें।
-
क्लाउड प्लेटफ़ॉर्म: यह Amazon Web Services, Google Cloud, और Microsoft Azure पर उपलब्ध है।
-
Mythos 5.2: Cyber Verification Program या Life Sciences Verification Program के माध्यम से आवेदन करें। Claude Enterprise ग्राहक इसे Claude Security के माध्यम से भी उपयोग कर सकते हैं।
कड़े डेटा आवश्यकताओं वाले एंटरप्राइज़ Enterprise Frontier Safeguards का उपयोग कर सकते हैं, जो ग्राहक के अपने इन्फ्रास्ट्रक्चर में संग्रहीत डेटा पर Anthropic की सेफ्टी मॉनिटरिंग चलाता है और शून्य डेटा रिटेंशन के साथ काम करता है। अन्य ग्राहकों के लिए सेफ्टी मॉनिटरिंग हेतु 30-दिवसीय डेटा रिटेंशन है।
अंतिम विचार
Claude Fable 5.2, Fable 5.1 से अर्थपूर्ण उन्नयन है। यह सस्ता, तेज़, और वैध काम को अस्वीकार करने की संभावना कम रखता है। Remote Labor Index, रोबोटिक्स, और FrontierCode में उछाल विशेष रूप से बड़े हैं।
फिर भी, आधी कीमत पर Opus 5.5 अधिकांश रोज़मर्रा के काम के लिए बेहतर वैल्यू बना रहता है। Fable 5.2 की सबसे दिलचस्प बात शायद दक्षता के दावे हैं: अगर यह सच में कम या मध्यम प्रयास पर Opus 5.5 के सर्वश्रेष्ठ स्कोर तक पहुँचता है, तो प्रति-टोकन प्रीमियम जल्दी सिमट जाता है। इसे अपने वर्कलोड पर जाँचना फ़ायदेमंद होगा।
यदि आप Claude के साथ हाथों-हाथ शुरुआत करना चाहते हैं, तो हमारा Developing AI Applications ट्रैक एक अच्छा स्थान है।


आज, Anthropic ने सभी के लिए Fable 5.2 और सत्यापित संगठनों के लिए Mythos 5.2 की घोषणा की। ये एक ही आधारभूत मॉडल हैं, लेकिन Fable संस्करण में अतिरिक्त साइबरसुरक्षा और जैविकी सुरक्षा उपाय हैं।
मुख्य बदलाव हैं:
विशेष रूप से, Fable 5.2 की कीमत Fable 5.1 से 20% कम है, यह आउटपुट को 30% तक तेज़ी से जनरेट करता है, और Anthropic की बेंचमार्क तालिका की अधिकांश पंक्तियों पर GPT-6 Astra और Gemini 4 Carbon को मात देता है।
इस लेख में, मैं बताऊंगा कि Fable 5.2 और Mythos 5.2 में क्या नया है, ये बेंचमार्क पर कैसा प्रदर्शन करते हैं, इनकी कीमत क्या है, और यह कैसे तय करें कि आपको इन्हें Claude Opus 5.5 पर प्राथमिकता देनी चाहिए या नहीं।
Claude Fable 5.2 क्या है?
Claude Fable 5.2 Anthropic का सबसे सक्षम, सामान्य रूप से उपलब्ध मॉडल है। इसे लंबे, चुनौतीपूर्ण तकनीकी कार्यों के लिए बनाया गया है: बड़े कोडबेस माइग्रेशन, कई दिनों तक चलने वाले एजेंट रन, शोध समस्याएँ, और इंजीनियरिंग डिज़ाइन।
Fable 5.2 छोटे मॉडलों के साथ मिलकर भी काम कर सकता है—या तो एक सलाहकार के रूप में, जिनसे वे कठिन समस्याओं पर परामर्श लें, या एक ऑर्केस्ट्रेटर के रूप में जो सरल उप-कार्य उन्हें सौंप दे।
Fable 5.2 अपने पूर्ववर्ती की तरह 1M-टोकन कॉन्टेक्स्ट विंडो और 128K अधिकतम आउटपुट बनाए रखता है, और इसका नॉलेज कटऑफ जून 2026 है।
Claude Mythos 5.2 क्या है?
Claude Mythos 5.2 वही मॉडल है जो Fable 5.2 है, लेकिन उन सुरक्षा उपायों के बिना जो अधिकांश साइबरसुरक्षा कार्यों और शोध-स्तरीय जैविकी कार्यों को ब्लॉक करते हैं। वास्तव में, Mythos 5.2 साइबरसुरक्षा इंजीनियरिंग के लिए Anthropic का सबसे सक्षम मॉडल है। क्योंकि इस तरह की क्षमताएँ द्वि-उपयोगी होती हैं, Anthropic Mythos 5.2 केवल अपने Cyber Verification Program और Life Sciences Verification Program के माध्यम से सत्यापित संस्थाओं को ही प्रदान करता है।
Claude Fable 5.2 में क्या नया है?
Fable जून से ही मौजूद है, जब Anthropic ने Fable 5 जारी किया था। तब से दो पॉइंट रिलीज़ आए हैं—सितंबर में Fable 5.1 और अब Fable 5.2—और दोनों में नई सुविधाएँ बहुत अधिक नहीं जोड़ी गईं। ज़्यादातर बदलाव मॉडल को सस्ता, तेज़ और मज़बूत बनाते हैं, हालांकि प्रदर्शन में उछाल छोटे नहीं रहे: उदाहरण के लिए, Fable 5.2 ने Remote Labor Index पर Fable 5.1 के स्कोर से दोगुने से भी अधिक अंक अर्जित किए हैं।
दोनों रिलीज़ के बीच बड़ा अंतर इस बात में है कि आप मॉडल का उपयोग कैसे कर सकते हैं। Fable 5.1 के साथ, Anthropic ने अपनी साइबरसुरक्षा सुरक्षा को संकुचित किया और मॉडल को सॉफ्टवेयर कमजोरियाँ खोजने के लिए उपयोग करने की अनुमति देना शुरू किया, हालांकि उनके लिए एक्सप्लॉइट लिखना अभी भी अनुमत नहीं था, और इसी के साथ Enterprise Frontier Safeguards—एक विकल्प जो आपके डेटा को आपकी ही क्लाउड में रखने देता है—की घोषणा भी की गई। Fable 5.2 की सुरक्षा में बदलाव छोटे हैं: यह कम अनुरोधों को ब्लॉक करता है, लेकिन वही प्रकार के कार्य अभी भी प्रतिबंधित हैं।
Anthropic द्वारा सुझाए गए नए उपयोग, जैसे छोटे Claude मॉडलों को Fable 5.2 से सलाह दिलवाना, भी वास्तव में नए नहीं हैं, क्योंकि Anthropic का advisor टूल पहले से Fable 5 और 5.1 को सपोर्ट करता था। और लॉन्च डेमो, जैसे खाली फ़ोल्डर से बनाया गया ऑपरेटिंग सिस्टम, नए चालू करने योग्य फ़ीचरों के बजाय सिर्फ़ एक मज़बूत मॉडल को कठिन काम करते हुए दिखाते हैं।
फिर भी, अगर मुझे नई बातों की ओर इशारा करना हो, तो मैं ये कहूंगा:
कम कीमत
Fable 5.2 की कीमत प्रति दस लाख इनपुट टोकन $8 और प्रति दस लाख आउटपुट टोकन $40 है, जो Fable 5.1 की $10/$50 से 20% कम है। यही 20% कटौती कैश रीड्स ($0.20), कैश राइट्स और बैच प्रोसेसिंग पर भी लागू होती है। पूरी जानकारी के लिए नीचे की प्राइसिंग सेक्शन देखें।
तेज़ आउटपुट, और Fable के लिए फास्ट मोड
आउटपुट Fable 5.1 से 30% तक तेज़ है, जो लंबे एजेंट रन में जोड़कर बड़ा फर्क डालता है। Fable अब फास्ट मोड को भी सपोर्ट करता है, जो आउटपुट को दोगुनी कीमत ($16/$80) पर अधिकतम 2.5x तक तेज़ कर देता है।
कम प्रयास पर बेहतर नतीजे
यह बदलाव आपके बिल को सबसे ज़्यादा प्रभावित कर सकता है। हाई एफर्ट पर, Fable 5.2 FrontierCode 2.0 पर 45.3% स्कोर करता है, जो Opus 5.5 के सर्वश्रेष्ठ स्कोर के बराबर है, और प्रति कार्य लगभग आधी लागत पर। लो एफर्ट पर, यह Humanity's Last Exam पर Opus 5.5 के टॉप स्कोर से मेल खाता है, और प्रति कार्य लागत का दसवां हिस्सा भी नहीं लगता। मेरा सुझाव: अगर आप Opus 5.5 से ऊपर आ रहे हैं, तो Fable 5.2 को कम एफर्ट लेवल से शुरू करें।
कम ब्लॉक हुए अनुरोध
Fable 5.2 को Fable 5.1 की तुलना में लगभग 55% कम सेफ्टी ब्लॉक्स का सामना करना चाहिए (साइबरसुरक्षा में लगभग 60% कम और जैविकी में 40% कम)। अगर Fable 5.1 की अस्वीकृतियाँ आपको रोक रही थीं, तो यह बड़ी बात है, लेकिन जो श्रेणियाँ ब्लॉक हैं, वे नहीं बदलीं: पेनिट्रेशन टेस्टिंग, एक्सप्लॉइट जनरेशन, और अधिकांश शोध-स्तरीय जैविकी अब भी पुराने Claude मॉडलों को सौंप दिए जाते हैं।
Claude Fable 5.2 बेंचमार्क पर कैसा करता है?
मुख्य नतीजे यहाँ हैं। ये सभी Anthropic की लॉन्च तालिका से आते हैं, इसलिए इन्हें स्वतंत्र नतीजों के बजाय मॉडल के पक्ष में Anthropic के तर्क के रूप में पढ़ें। Claude के स्कोर सुरक्षा उपाय चालू रखकर चलाए गए थे। जब तक अलग से उल्लेख न हो, हर मॉडल अपने उपलब्ध उच्चतम प्रयास स्तर पर दिखाया गया है।
एजेंटिक कोडिंग
तालिका के दोनों कोडिंग बेंचमार्क पर Fable 5.2 आगे है। FrontierCode 2.0 पर, जो मापता है कि क्या ओपन-सोर्स मेंटेनर किसी मॉडल के कोड बदलावों को मर्ज करेंगे, इसका स्कोर 49.1% है—तालिका में सबसे ऊँचा और Fable 5.1 के 32.4% से काफी ऊपर। FrontierSWE v2 पर, यह 69.9% स्कोर करता है, जो GPT-6 Astra (65.5%) और Opus 5.5 (62.3%) से आगे है।
लॉन्च के उदाहरण भी यही दिशा दिखाते हैं: Fable 5.2 के एक शुरुआती संस्करण पर चल रहे एजेंटों ने एक प्रोडक्शन सेवा को Python से Rust में माइग्रेट किया, और अब यह लगभग 26 गुना तेज़ शुरू होती है।
नॉलेज वर्क और रिसर्च
सबसे बड़ा सापेक्ष उछाल Remote Labor Index पर है, जो मापता है कि कोई मॉडल वास्तविक फ्रीलांस-शैली की परियोजनाएँ कितनी अच्छी तरह पूरी करता है। Fable 5.2 का स्कोर 41.3% है, जो Opus 5.5 (21.3%) और GPT-6 Astra (20.8%) से लगभग दोगुना है। यह टूल्स के साथ Humanity's Last Exam (74.2%) और Terminal-Bench-Science (74.6%, या Mythos 5.2 के लिए 75.3%) पर भी अग्रणी है।
व्यवसाय ऑटोमेशन एक क्षेत्र है जहाँ यह पिछड़ता है। AutomationBench पर, Gemini 4 Carbon का स्कोर 53.9% है, जबकि Fable 5.2 का 51.4%—हालाँकि Fable 5.2 अब भी Fable 5.1 (31.4%) से बहुत आगे है।
मुख्य तालिका से बाहर, Fable 5.2 ने BenchCAD 2.1 हार्डवेयर-इंजीनियरिंग बेंचमार्क पर 83.5 स्कोर किया, जबकि Opus 5.5 ने 65.3। इसे ब्लैक-होल भौतिकी की दो ओपन समस्याएँ हल करने का श्रेय भी दिया गया है, और वे नतीजे ऐसे प्री-प्रिंट्स के रूप में पोस्ट किए गए हैं जिन्हें अन्य भौतिकविद जाँच सकते हैं।
कंप्यूटर उपयोग, रोबोटिक्स, और विज़न
Fable 5.2 का OSWorld 2.1 पर स्कोर 89.3% है, जो Opus 5.5 (87.2%) और GPT-6 Astra (79.5%) से आगे है। रोबोटिक्स में इसका उछाल तालिका में सबसे बड़ा है: RoboDojo Sim पर 64.9%, जो Fable 5.1 और GPT-6 Astra से दोगुने से भी अधिक है। Chartography पर, जो बिना टूल के चार्ट पढ़ने की जाँच करता है, यह Gemini 4 Carbon और GPT-6 Astra से थोड़ा आगे निकल जाता है, जबकि Fable 5.1 44.8% पर काफी पीछे था।
साइबरसुरक्षा और जैविकी (Mythos 5.2)
सुरक्षा और जैविकी से संबंधित पंक्तियाँ Mythos 5.2 के लिए हैं, क्योंकि Fable 5.2 के सुरक्षा उपाय इनमें से अधिकांश कार्यों को ब्लॉक करते हैं। Mythos 5.2 CyScenarioBench पर 76.3% (vs 61.7% Mythos 5.1), CVE Rediscovery पर 89.6% (vs 78.3%), और 24-घंटे के प्रोटीन बाइंडर डिज़ाइन कार्य पर 85.1% (vs 79.1%) स्कोर करता है। यहाँ OpenAI के सुरक्षा मॉडल के साथ कोई निष्पक्ष तुलना नहीं है, क्योंकि हर लैब ने अपनी-अपनी CyScenarioBench टास्क्स चलाईं।
Fermat's Last Theorem की बात क्या है?
Fable 5.2 एजेंटों की एक टीम ने 30 घंटों में Lean प्रूफ़ असिस्टेंट में Fermat's Last Theorem के प्रूफ़ का औपचारिक रूप बनाया। आप सोच सकते हैं: यह प्रमेय तो तीन दशक पहले सिद्ध हो चुका है, तो अब करने को क्या बचा?
प्रमेय पुरानी खबर है
Fermat's Last Theorem कहता है कि कोई भी धनात्मक पूर्णांक a, b, और c ऐसे नहीं हैं कि an + bn = cn हो किसी भी n के लिए जो 2 से बड़ा हो। n = 2 पर बहुत से हल हैं, जैसे 32 + 42 = 52 (9 + 16 = 25)। लेकिन घनों पर कोशिश करें तो सिर्फ़ करीब-करीब चूक मिलती है: 63 + 83 = 728, जो 93 = 729 से एक कम है।
Pierre de Fermat ने 1637 में एक प्रूफ़ का दावा किया था लेकिन उसे कभी लिखा नहीं, और यह 350 साल से ज़्यादा अनसुलझा रहा, जब तक कि Andrew Wiles ने 1990 के दशक के मध्य में, Richard Taylor की मदद से, इसे सिद्ध नहीं कर दिया।
Lean औपचारिककरण क्या होता है
Wiles का प्रूफ़ 100 से अधिक पृष्ठों का है और दशकों की उन्नत संख्या सिद्धांत पर आधारित है, इसलिए बहुत कम लोग इसे शुरू से अंत तक जाँच सकते हैं। Lean एक प्रूफ़ असिस्टेंट है: एक प्रोग्रामिंग भाषा जिसमें आप प्रूफ़ को कोड के रूप में लिखते हैं, और सॉफ़्टवेयर हर तार्किक चरण की जाँच करता है, गणित के बुनियादी स्वयंसिद्धों तक। अगर प्रूफ़ कम्पाइल हो जाता है, तो वह सही है। किसी प्रमेय का "औपचारिककरण" करने का मतलब है मानव-लिखित प्रूफ़ को इस मशीन-चेक योग्य रूप में अनुवादित करना।
Fermat's Last Theorem के लिए यह बहुत बड़ा काम है, क्योंकि जिस गणित पर प्रूफ़ निर्भर करता है, उसका बहुत सा हिस्सा पहले Lean में लिखा ही नहीं गया था। गणितज्ञ Kevin Buzzard ने 2024 में इसे करने के लिए एक सामुदायिक परियोजना शुरू की।
AI मॉडल के लिए यह रुचिकर क्यों है
अधिकांश AI आउटपुट का आकलन लोग करते हैं या ऐसे बेंचमार्क करते हैं जो उत्तर के सिर्फ़ एक हिस्से की जाँच करते हैं। Lean प्रूफ़ अलग है: चेकर या तो हर कदम को स्वीकार करता है या नहीं करता, इसलिए चुपचाप गलत होने का रास्ता नहीं है। यह असामान्य रूप से साफ़-सुथरा परीक्षण बन जाता है कि कोई मॉडल बहुत लंबी, बहुत कठिन परियोजना को सत्यापित समापन तक ले जा सकता है या नहीं।
यह पहली बार नहीं है जब Claude ने ऐसा किया। सितंबर में, Anthropic ने प्रमेय का पहला पूर्ण, कंप्यूटर-चेक्ड प्रूफ़ प्रकाशित किया, जो दर्जनों एजेंटों ने एक आंतरिक रिसर्च मॉडल पर लिखा था, जो मोटे तौर पर Fable 5.1 के तुलनीय था। उस प्रयास में 11 दिन और लगभग छह अरब आउटपुट टोकन लगे, 1.3 करोड़ पंक्तियों का Lean कोड बना, और आंशिक रूप से Buzzard की परियोजना के हिस्सों पर आधारित था। Fable 5.2 ने यह 30 घंटों में, न्यूनतम मानवीय मदद के साथ किया।
एहतियातें
सबसे बताने वाली बात, हालांकि, यह है कि जब Anthropic ने Claude Opus 5.5 को वही काम दिया, तो क्या हुआ।
Claude Fable 5.2 बनाम Claude Opus 5.5
दो मॉडलों की तुलना आम तौर पर बेंचमार्क स्कोर पढ़ने और यह अंदाज़ा लगाने का मतलब होता है कि व्यवहार में फर्क कैसा दिखेगा। इस बार, मुझे अच्छा लगा कि Anthropic ने एक कहानी से शुरुआत की, जिससे अंतर ज़्यादा साफ़ दिखता है।
उसी 1,000-एजेंट Lean सेटअप में, Opus 5.5 ने 18 घंटों में Fermat's Last Theorem के प्रूफ़ का 26% पूरा किया और उसके बाद मुश्किल से ही कोई प्रगति हुई। Fable 5.2 ने पूरा काम 30 घंटों में पूरा कर दिया। निष्कर्ष: बहुत लंबी, बहु-एजेंट परियोजनाओं पर, जहाँ Opus 5.5 अटक सकता है, Fable 5.2 आगे बढ़ता रहता है।
छोटे कार्यों पर, अंतर कम है। दोनों की साइड-बाय-साइड तुलना यूँ है:
पैटर्न Lean के परिणाम से मेल खाता है। कंप्यूटर उपयोग और कोडिंग पर, Fable 5.2 केवल कुछ अंकों से आगे है। खुले-समाप्त, बहु-चरणीय कार्यों पर बढ़त बढ़ती है: Remote Labor Index की फ्रीलांस-शैली परियोजनाओं में Fable 5.2 का स्कोर Opus 5.5 का लगभग दोगुना है, और रोबोट नियंत्रण में यह 25 अंक आगे है।
कीमत उतना बड़ा अंतर नहीं है जितना दिखता है। Fable 5.2 प्रति टोकन दोगुना महंगा है, लेकिन यह अक्सर कम प्रयास स्तर पर ही Opus 5.5 के सर्वश्रेष्ठ स्कोर तक पहुँच सकता है, यानी कम टोकन इस्तेमाल होते हैं। उदाहरण के लिए FrontierCode 2.0 पर, हाई एफर्ट पर Fable 5.2, Opus 5.5 के सर्वश्रेष्ठ के लगभग बराबर है और प्रति कार्य लगभग आधी लागत पर।
तो Opus 5.5 अभी भी अधिकांश रोज़मर्रा के काम के लिए समझदारी भरा डिफॉल्ट है। लेकिन अगर कोई कार्य घंटों चलता है, कई एजेंट शामिल हैं, या Opus पर बार-बार अटकता है, तो Fable 5.2 के इसे पूरा करने की संभावना ज़्यादा है—और इसकी लागत प्रति-टोकन कीमत जितनी नहीं बढ़ सकती।
सुरक्षा और सीमाएँ
Anthropic के अनुसार, उच्च-दांव वाली स्थितियों में इन मॉडलों के असुरक्षित व्यवहार करने का जोखिम कम है।
इसे बाहर से जाँचना कठिन है, इसलिए ठोस आँकड़े उपयोगी हैं। लगभग 1,900 परिदृश्यों के एक स्वचालित व्यवहार ऑडिट में, तुलना किए गए मॉडलों में Mythos 5.2 का गलत-संरेखित-व्यवहार स्कोर सबसे कम था। यह इनपुट्स को भ्रमित करने, झूठा दावा करने कि कार्य पूरा हो गया, या खराब काम छिपाने की संभावना भी कम थी।
कुछ और रुचिकर बातें भी हैं जिनका उल्लेख किया गया है, जो जानने योग्य हैं और सोचने पर मजबूर करती हैं:
आप किस Claude मॉडल का उपयोग करें?
मेरा सुझाव Anthropic से मेल खाता है: Opus 5.5 से शुरू करें और ज़रूरत होने पर ही ऊपर जाएँ। लाइनअप इस तरह टूटता है:
Claude Fable 5.2 की कीमत और उपलब्धता
अभी हमने एक तालिका देखी जिसमें बेंचमार्क नतीजे दिखा रहे थे कि Fable 5.2, Fable 5.1 को हर सूचीबद्ध चीज़ पर पछाड़ता है। अब, मैं आपको एक तालिका दिखा रहा हूँ जिसमें Fable 5.2, 5.1 से सस्ता है। तो क्या Fable 5.1 अप्रचलित हो गया?
नए काम के लिए, व्यवहार में हाँ। यदि आपके पास Fable 5.2 की पहुँच है, तो 5.1 पर कुछ नया शुरू करने का बहुत कम कारण है। हालाँकि, Anthropic ने अभी इसके रिटायरमेंट की तारीख़ की घोषणा नहीं की है, और वे टीमें जिनके प्रॉम्प्ट या एजेंट Fable 5.1 पर ट्यून हैं, स्विच करने से पहले 5.2 का परीक्षण करना चाहेंगी। हमें पता है कि नया संस्करण बेहतर स्कोर करते हुए भी अलग तरह से व्यवहार कर सकता है।
Claude Fable 5.2 तक पहुँच कैसे पाएँ
Claude ऐप्स: Fable 5.2 योग्य पेड प्लान्स पर उपलब्ध है। लॉन्च प्रमोशन के रूप में, Pro प्लान्स और स्टैंडर्ड Team सीट्स अपनी साप्ताहिक उपयोग-सीमाओं के 50% तक Fable का उपयोग कर सकते हैं, और जिन प्लान्स में Fable शामिल है उन्हें सदस्यता अवधि के आधार पर एक से तीन उपयोग रीसेट मिलते हैं।
API: Claude Platform पर मॉडल ID
claude-fable-5-2का उपयोग करें।क्लाउड प्लेटफ़ॉर्म: यह Amazon Web Services, Google Cloud, और Microsoft Azure पर उपलब्ध है।
Mythos 5.2: Cyber Verification Program या Life Sciences Verification Program के माध्यम से आवेदन करें। Claude Enterprise ग्राहक इसे Claude Security के माध्यम से भी उपयोग कर सकते हैं।
कड़े डेटा आवश्यकताओं वाले एंटरप्राइज़ Enterprise Frontier Safeguards का उपयोग कर सकते हैं, जो ग्राहक के अपने इन्फ्रास्ट्रक्चर में संग्रहीत डेटा पर Anthropic की सेफ्टी मॉनिटरिंग चलाता है और शून्य डेटा रिटेंशन के साथ काम करता है। अन्य ग्राहकों के लिए सेफ्टी मॉनिटरिंग हेतु 30-दिवसीय डेटा रिटेंशन है।
अंतिम विचार
Claude Fable 5.2, Fable 5.1 से अर्थपूर्ण उन्नयन है। यह सस्ता, तेज़, और वैध काम को अस्वीकार करने की संभावना कम रखता है। Remote Labor Index, रोबोटिक्स, और FrontierCode में उछाल विशेष रूप से बड़े हैं।
फिर भी, आधी कीमत पर Opus 5.5 अधिकांश रोज़मर्रा के काम के लिए बेहतर वैल्यू बना रहता है। Fable 5.2 की सबसे दिलचस्प बात शायद दक्षता के दावे हैं: अगर यह सच में कम या मध्यम प्रयास पर Opus 5.5 के सर्वश्रेष्ठ स्कोर तक पहुँचता है, तो प्रति-टोकन प्रीमियम जल्दी सिमट जाता है। इसे अपने वर्कलोड पर जाँचना फ़ायदेमंद होगा।
यदि आप Claude के साथ हाथों-हाथ शुरुआत करना चाहते हैं, तो हमारा Developing AI Applications ट्रैक एक अच्छा स्थान है।